Ultralytics YOLO 与 NVIDIA Cosmos Data Factory:用于缺陷检测的合成数据
来自 NVIDIA Cosmos Data Factory 的合成数据,以及由 NVIDIA 提供支持的自动化智能体数据增强训练闭环,帮助 Ultralytics YOLO 仅用少量标注就达到全数据集精度。
Ultralytics 与 NVIDIA 携手展示了针对性训练数据的作用。Ultralytics YOLO 由 NVIDIA 的智能体数据增强训练闭环识别模型所需的图像,NVIDIA Cosmos Data Factory 生成尚不存在的图像,而 Ultralytics YOLO 则使用这些数据进行训练。我们的机器学习 (ML) 团队在 19 个公开工业检测基准上测试了这一组合,将使用 NVIDIA 智能体流程和 Cosmos Data Factory 合成数据训练的 Ultralytics YOLO26,与使用传统方式训练的同一模型进行比较。本文将分享测试结果。
更多数据并非答案,正确的数据才是。#
每个检测团队都熟悉这种情况:缺陷检测模型能够很好地识别见过多次的缺陷,却会漏掉生产线上最关键的罕见划痕、特殊光照条件或奇怪的摄像头角度。常见的解决办法是收集并标注更多各种各样的数据,但这既缓慢又昂贵,而且大多只是增加模型已经能够很好处理的图像。
由 NVIDIA 提供支持的自动化智能体训练采用了不同的方法:它会找出数据集中的具体薄弱环节并加以弥补,使用现有的真实图像,或在缺少真实示例时使用 Cosmos Data Factory 生成的合成图像。与 Ultralytics YOLO 配合后,模型就能用自己确实缺少的数据进行训练。
NVIDIA 的数据增强训练闭环如何运作?#
NVIDIA 为 Ultralytics YOLO 提供的智能体数据增强训练闭环是一条模型改进流程,它包裹在训练循环之外,并决定模型接下来需要哪些数据:
• 挖掘真实数据。它会在现有图像池中搜索真实示例,以填补训练集中的具体缺口。
• 生成合成数据。如果没有真实示例,它会使用 Cosmos Data Factory 生成边缘案例图像。
• 自动标注。名为 AnomalyGen 的组件会为合成图像添加标签,因此重新训练前无需手动标注。
核心理念是有针对性地获取数据,而不是追求数据效率。目标不只是用更少的数据来训练,而是通过挖掘或生成数据,精准填补数据集中模型表现薄弱之处的缺口,再用这个增强后的数据集重新训练。如下方结果所示,做好这项工作往往也会带来减少训练图像数量的效果。
该流程已使用 Ultralytics YOLO 进行了深入基准测试,本文中的所有结果均采用 Ultralytics YOLO26。
NVIDIA Cosmos Data Factory 的作用#
Cosmos Data Factory 是 NVIDIA 的数据整理、处理和生成平台,基于其 Cosmos 世界模型构建。在智能体训练闭环中,它负责为真实数据集覆盖不足的场景生成图像,例如制造业中的特定缺陷类型,或交通影像中的鱼眼镜头畸变。
交接过程很简单:Cosmos 生成边缘案例图像,AnomalyGen 为图像添加标签,然后使用标准的 Ultralytics 训练流程在真实数据与合成数据组成的集合上重新训练 Ultralytics YOLO。
在 19 个公开数据集上测试 Cosmos Data Factory#
为了了解 Cosmos Data Factory + Ultralytics YOLO 能发挥多大作用,我们的 ML 团队在涵盖钢材、PCB、织物、金属表面和消费品的 19 个公开工业检测数据集上运行了智能体数据增强微调流程,训练图像总数约为 91,000 张。每次运行都使用一台配备 8 块 GPU 的主机。
这项比较刻意采用了严格标准。基线模型和 Cosmos Data Factory 模型使用完全相同的配置进行训练:Ultralytics YOLO26x、100 个 epoch,以及相同的优化器、学习率和随机种子;两者也都在同一留出测试集上评估。唯一的区别是每个模型使用的训练图像不同。基线模型使用所有已标注图像进行训练(在合成数据测试中则只使用真实图像)。
1. 只用部分标注,达到同等精度#
在 19 个数据集中的 11 个上,使用智能体流程训练的 Ultralytics YOLO26x 达到了与使用完整数据集训练的同一模型相同的精度。在这 11 个数据集中,有 53% 的已标注图像完全没有用到。
| 数据集 | 已标注 | 已使用 | 无需使用 | 完整数据 mAP@0.5 | 精选数据 mAP@0.5 |
|---|---|---|---|---|---|
| dagm 类别 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm 类别 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm 类别 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm 类别 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm 类别 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm 类别 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm 类别 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm 类别 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
表 1. Cosmos Data Factory 达到完整数据模型水平的数据集。在同一留出数据集上的 mAP@0.5。
在 DAGM 数据集上,智能体流程只使用十分之一的标注就达到了相同的 mAP@0.5,并且在两个类别上略微超过了完整数据模型。在 pcb-defect 上,该流程舍弃了 20,924 张图像中的 7,000 张,而精度差异仅为多次运行间波动的四分之一。
对于需要为标注付费的团队来说,重点在于:这些数据集中的大部分标注预算都花在了不会改变结果的图像上。
2. 训练速度最高提升 74%#
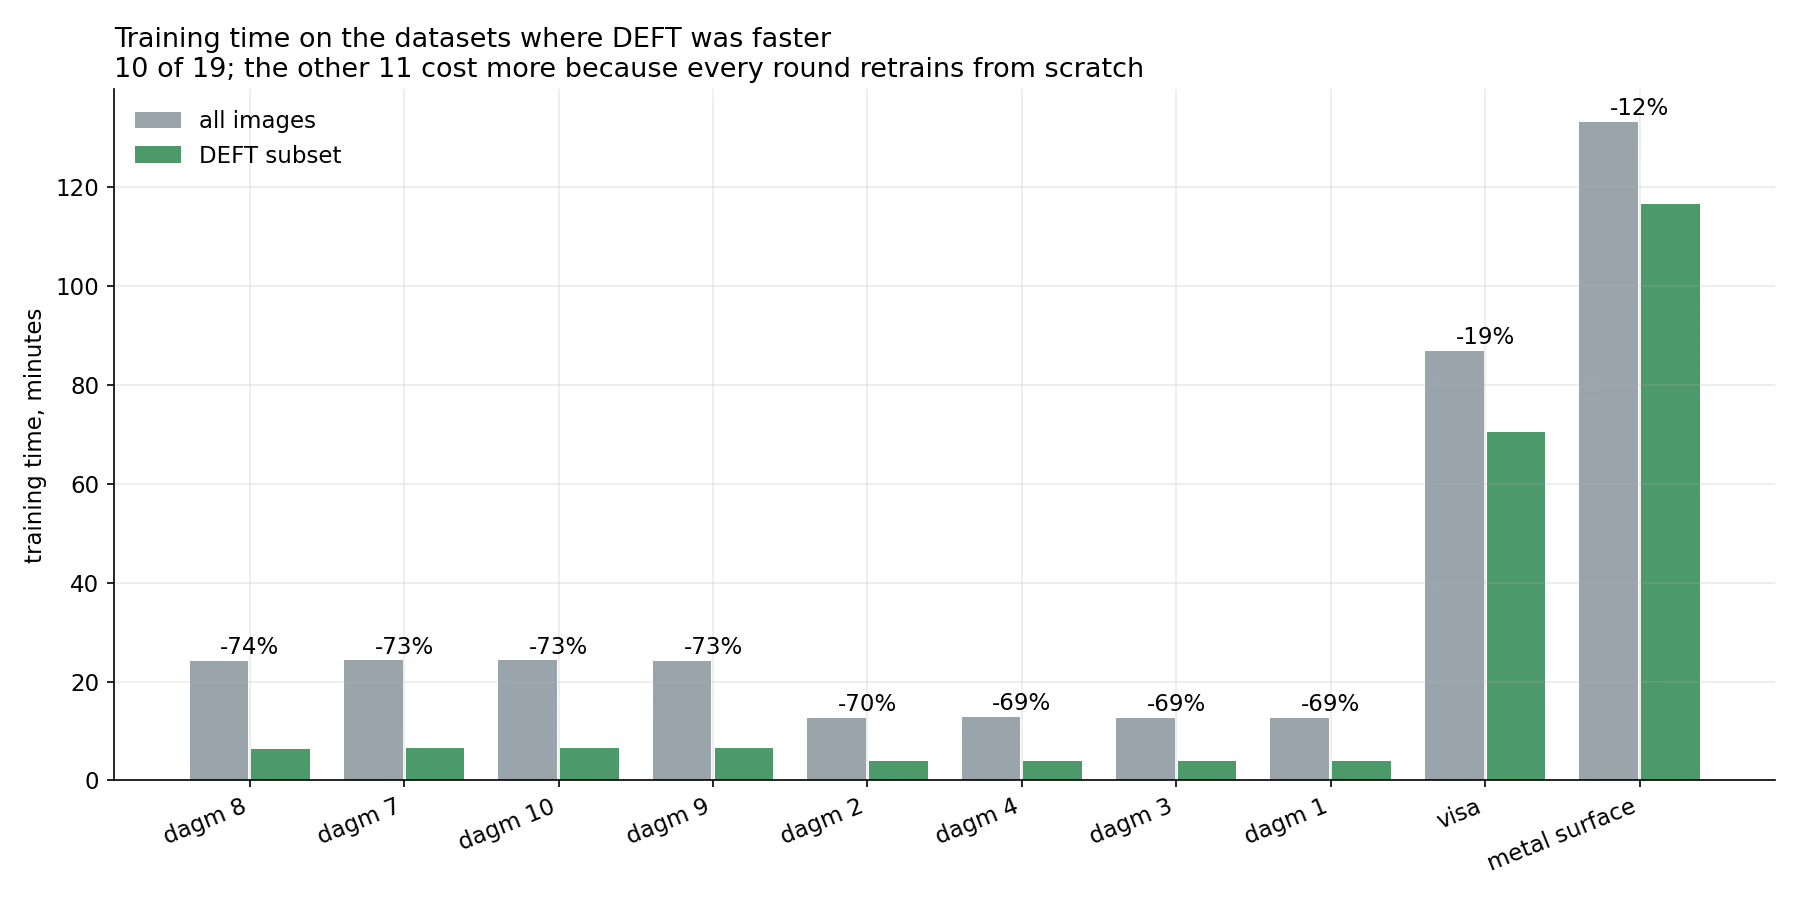
图 1. Cosmos Data Factory 更快的数据集上,完整数据集与 Cosmos Data Factory 子集的训练时间对比。
使用规模更小、针对性更强的数据集训练 Ultralytics YOLO,也能降低计算开销。19 个数据集中有 10 个使用智能体流程训练得更快。在 DAGM 上,训练时间从 13–24 分钟降至 4–7 分钟,缩短了 69–74%。较大的数据集虽然节省幅度较小,但同样有所改善:VisA 缩短了 19%,metal-surface-defect 缩短了 12%。
这种节省并非普遍适用。在其余 9 个数据集上,智能体流程比单次完整数据训练耗时更长,因为每一轮精选数据训练都会从头开始。如果精选子集与原始数据集的规模相差不大,额外训练轮次带来的开销就会超过节省的时间。
3. 生成的缺陷让边界框更精准#
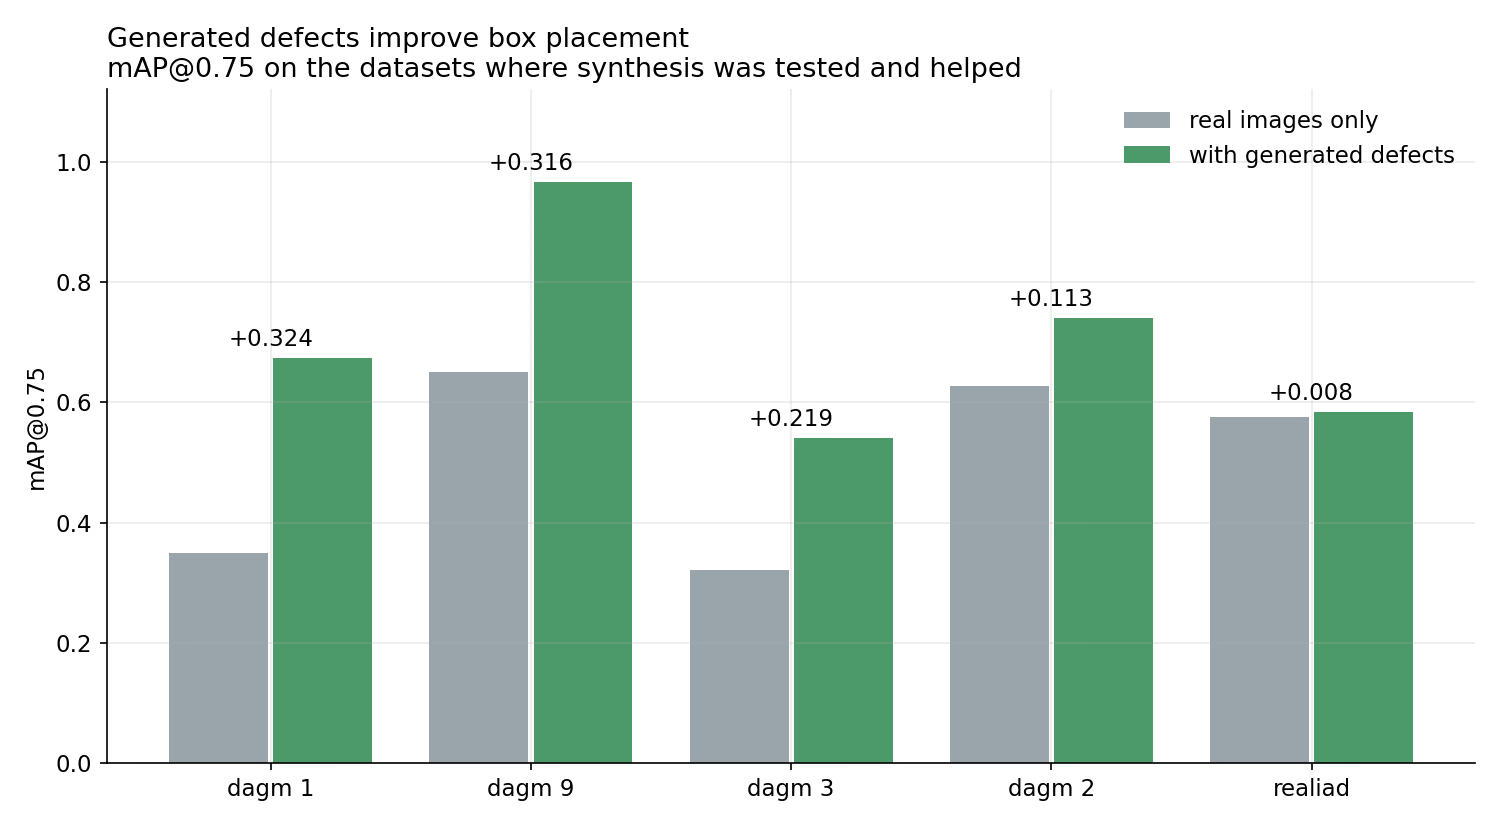
图 2. 在测试并验证合成数据有效的数据集上,仅用真实图像与加入生成缺陷时的 mAP@0.75 对比。
第三项测试单独考察了合成数据。对于带有多边形标注的数据集,我们加入了 Cosmos Data Factory 生成、由 AnomalyGen 标注的缺陷,并将由此训练出的 Ultralytics YOLO 模型与仅使用真实图像训练的模型进行比较。
我们报告 mAP@0.75,这是一项比 mAP@0.5 更严格的指标:只有当预测框与真实缺陷的重叠度至少达到 75% 时,预测才计为正确。它衡量的是模型定位缺陷的精确程度,而不仅仅是能否发现缺陷。加入生成的缺陷后,DAGM 各类别的 mAP@0.75 提升了 0.11 至 0.32,并且所有受测数据集的召回率都有所提高。提升最大的是 DAGM 类别 9,从 0.650 升至 0.966。在 Real-IAD 上,增益较小(+0.008)。
缺陷本身就很罕见,因此某种缺陷类型的真实示例总是供不应求。生成已经标注好的缺陷图像,能让 Ultralytics YOLO 学会缺陷的精确形状和范围,无需任何人手动绘制多边形。
合成数据的用量#
每次生成分为三个步骤。Cosmos Data Factory 首先在真实图像上寻找可能出现缺陷的位置(placed),生成器随后在这些位置绘制缺陷图像(generated),最后只有不超过设定上限的图像会进入训练集(kept)。我们测试了两个上限:合成图像数量分别相当于训练集中真实图像数量的 25% 或 100%。
在 18 轮生成(9 轮基线和 9 轮合成数据)中,流程共生成了 11,448 张图像。其中只有 1,481 张(约八分之一)被保留,因此,限制条件决定了每个 Ultralytics YOLO 模型能看到多少合成数据,而非生成器的输出量。在 100% 上限下,每个训练集中的真实图像都对应一张合成图像;在 25% 上限下,大约每四张真实图像对应一张合成图像。从绝对数量来看,这些数据并不多:在 DAGM 上,真实图像为 90–180 张,最多再加上同样数量的合成图像。
| 数据集 | 上限 | 已放置 | 已生成 | 已拦截 | 已保留 | 真实 | 比例 |
|---|---|---|---|---|---|---|---|
| dagm 类别 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm 类别 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm 类别 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm 类别 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm 类别 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm 类别 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm 类别 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| 总计 | 11,448 | 0 | 1,481 |
表 2. 根据每次运行的生成记录和纳入记录统计的生成图像数量及真实图像与合成图像的比例。
这对构建检测模型的团队意味着什么#
对于已经在训练 Ultralytics YOLO 的团队来说,Cosmos Data Factory 和由 NVIDIA 提供支持的自动化智能体训练流程可以融入现有且熟悉的工作流:使用相同的模型和训练配置,只是输入的数据更智能。
• 覆盖无法采集的边缘案例。自动标注的合成缺陷有助于 Ultralytics YOLO 在真实示例稀缺时定位缺陷。
• 把标注预算花在关键之处。在测试的数据集中,超过一半的数据集存在大量冗余标注。针对性筛选能够找出真正重要的图像。
• 加快迭代。规模更小、经过精选的训练集意味着 Ultralytics YOLO 训练耗时更短,也能在许多数据集上更快开展实验。
可用性#
基于 Cosmos 的合成数据生成步骤目前以示例和演示的形式提供,尚未作为正式集成发布。
如果你想将 Cosmos Data Factory 用于自己的 Ultralytics YOLO 模型,请联系 Ultralytics 团队。随着合成数据生成步骤逐步迈向完整集成,我们会继续与 NVIDIA 合作。
附录:测试设置与数据集#
所有运行均使用 Ultralytics YOLO26x、100 个 epoch,基线模型和 Cosmos Data Factory 模型使用相同的优化器、学习率和随机种子;使用一台配备 8 块 GPU 的主机;每个数据集均使用相同的留出测试集。11 个带有多边形标注的数据集可使用生成的缺陷。
| 数据集 | 训练图像 | 标注 | 来源 |
|---|---|---|---|
| dagm 类别 1、2、3、4 | 每类 1,035 张 | 多边形 | DAGM 2007 |
| dagm 类别 7、8、9、10 | 每类 2,070 张 | 多边形 | DAGM 2007 |
| pcb-defect | 20,924 | 边界框 | PCB 缺陷 |
| dspcbsd | 6,575 | 边界框 | DsPCBSD+ |
| deeppcb | 1,000 | 边界框 | DeepPCB |
| hripcb | 559 | 边界框 | HRIPCB |
| metal-surface-defect | 11,845 | 边界框 | NEU 表面缺陷 |
| tianchifabric | 10,332 | 边界框 | Tianchi 织物 |
| severstal | 10,061 | 多边形 | Severstal 钢材 |
| mvtec-ad | 4,637 | 边界框 | MVTec AD |
| visa | 7,794 | 多边形 | VisA |
| realiad-bottle-cap | 3,581 | 多边形 | Real-IAD |
| 裂纹 | 1,290 | 边界框 | 裂纹分割 |
表 3。19 个数据集(DAGM 按八个计算,每个类别一个)。









