Ultralytics-YOLO-Segmentierung in dicht besetzten Szenen: 1.000 Masken
In Ultralytics 8.4.213 sagt YOLO26n-seg auf einem synthetischen 1080p-Bild 1.000 Masken voraus und fasst sie in 56,4 ms zusammen – auf einer RTX PRO 6000, statt zuvor in 821,2 ms.
 Glenn Jocher12 Min. Lesezeit
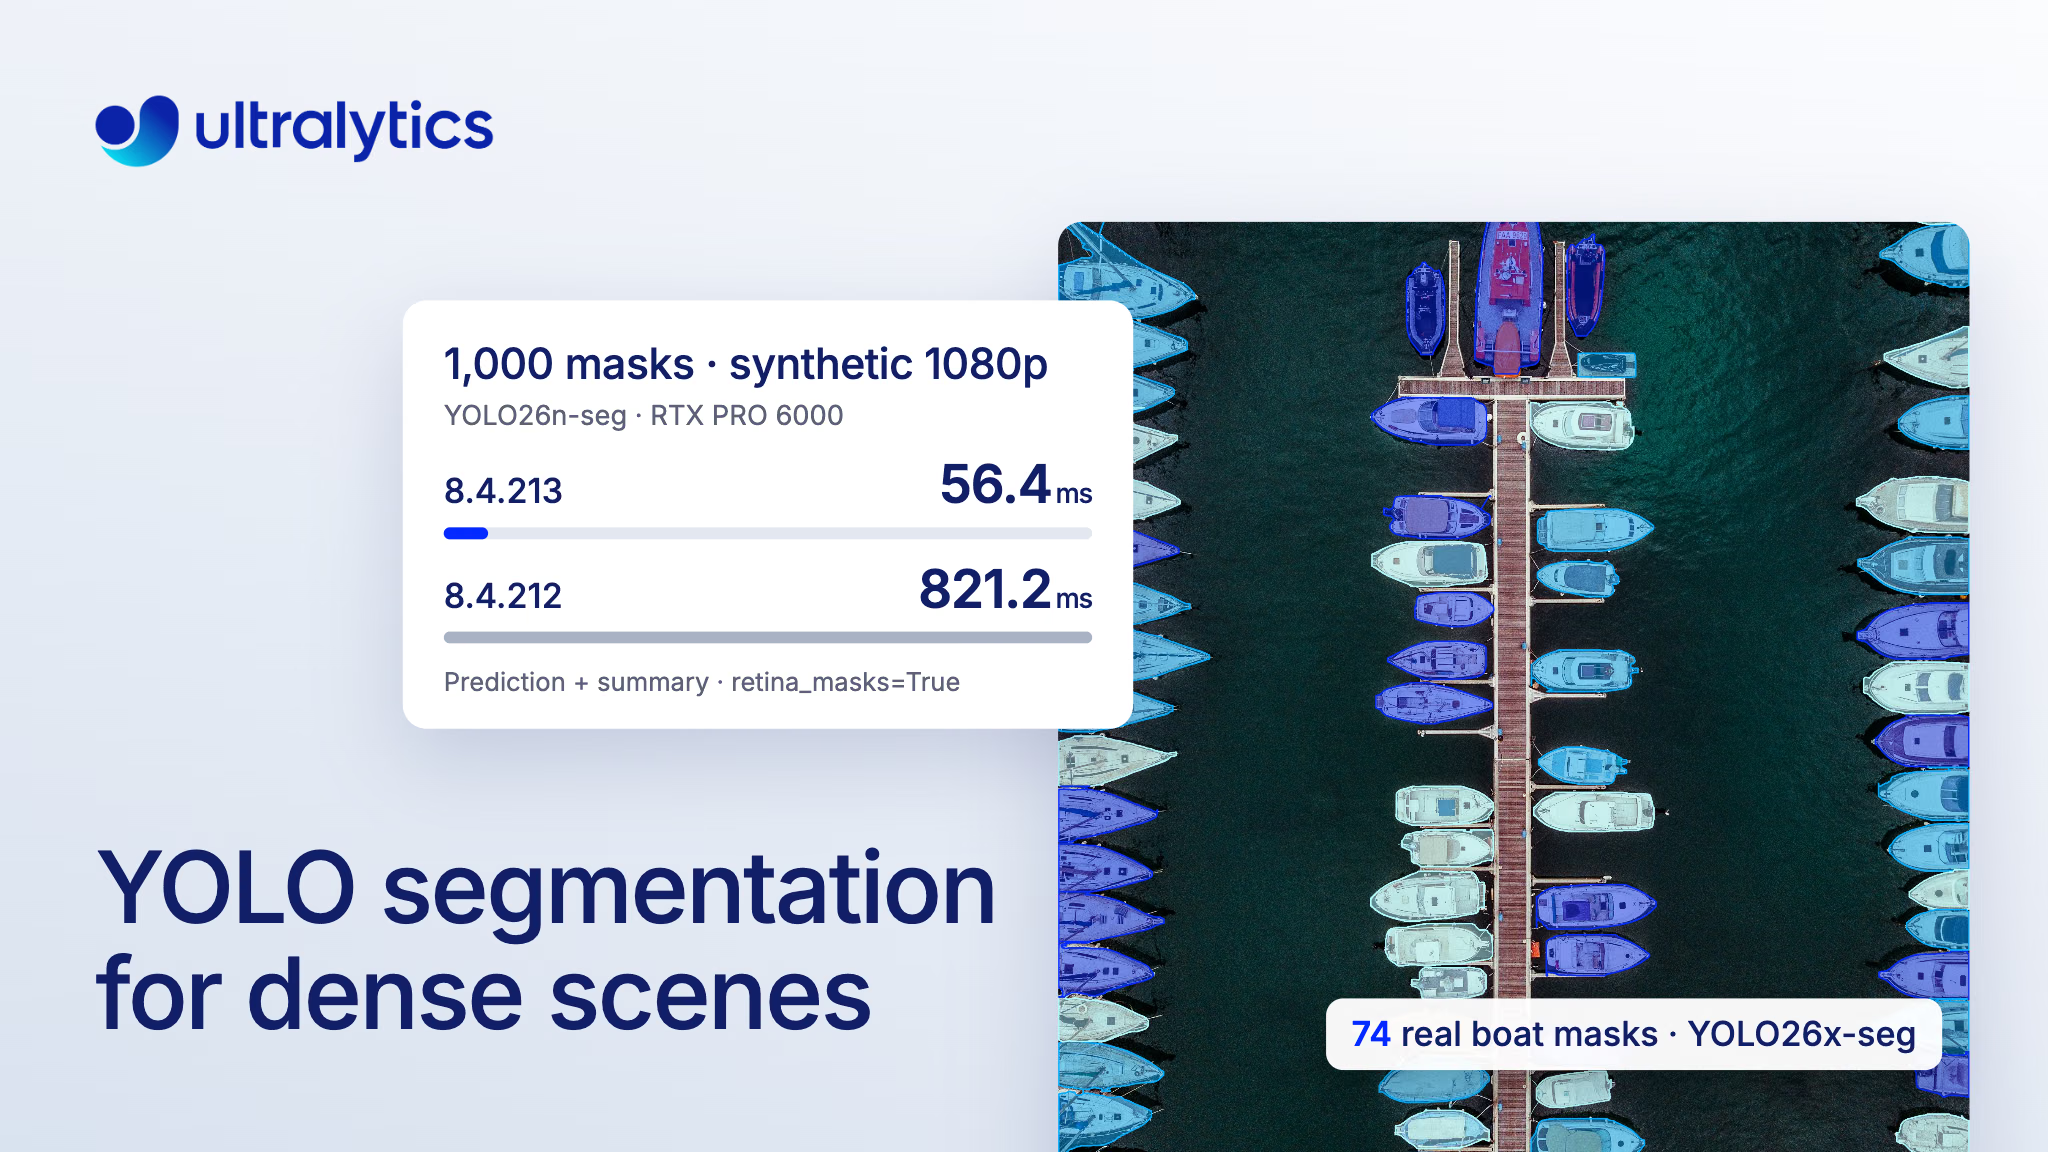
Ultralytics 8.4.213, veröffentlicht am 14. November 2026, beschleunigt die YOLO-Segmentierung in dicht besetzten Szenen, indem große Maskenstapel innerhalb jeder Erkennungsbox dekodiert werden. Wenn du Regale, Pakete, Menschenmengen oder Luftbilder segmentierst, bist du wahrscheinlich schon an den Punkt gelangt, an dem ein Segmentierungsmodell zwar Objekte findet, die anschließende Maskenverarbeitung aber zu viel Zeit oder Speicher benötigt. Diese Version verschiebt diese Grenze deutlich nach hinten. In unserem Benchmark mit einem synthetischen, dicht gekachelten 1080p-Bild gab YOLO26n-seg 1.000 Instanzmasken in voller Auflösung (retina_masks=True) samt Vorhersage und Ergebniszusammenfassung in 56,4 ms zurück und benötigte auf einer RTX PRO 6000 maximal 321 MiB GPU-Speicher. In Version 8.4.212 waren es noch 821,2 ms und 4.291 MiB.
Das Modell selbst hat sich nicht geändert. Geändert hat sich, wie YOLO-Segmentierung die Modellausgabe in Masken umwandelt: Große Maskenstapel werden jetzt innerhalb der Box jedes Objekts statt über das gesamte Bild dekodiert. In der Ultralytics Platform liefern der Tab „Predict“ und die API bis zu 1.000 Ergebnisse pro Bild zurück. Dieser Beitrag erläutert, warum dichte Szenen bisher aufwendig waren, was 8.4.213 anders macht, welche Ergebnisse gemessen wurden und wie du selbst Vorhersagen mit 1.000 Masken ausführst.
In dichten Szenen wurden bisher auch Pixel außerhalb jeder Box verarbeitet#
Die Instanzsegmentierung weist jedem Objekt eine eigene Maske zu. Das brauchst du, um Flächen zu messen, Objekte freizustellen oder sich berührende Elemente voneinander zu unterscheiden. Ein YOLO-Segmentierungsmodell sagt eine kleine Anzahl gemeinsamer Prototypmasken sowie einige Koeffizienten pro Erkennung voraus. Bei der Nachverarbeitung werden daraus einzelne Masken für jedes Objekt erstellt.
Bisher wurde bei diesem Schritt jede Maske in Bildgröße erstellt: standardmäßig in der Inferenzgröße des Modells oder mit retina_masks=True beziehungsweise Kachelung in der Originalbildgröße. Für N Objekte in einem H x W großen Bild wurden ein N x H x W großer Stapel angelegt, zugeschnitten, gefiltert und durchsucht, obwohl jede Maske außerhalb ihrer Begrenzungsbox überall null ist. In einer dichten 1080p-Szene ist die aufsummierte Fläche von 1.000 Boxen einschließlich Überlappungen etwa doppelt so groß wie die Bildfläche, doch der Stapel war 1.000-mal so groß wie die Bildfläche. Der Aufwand stieg mit max_det und der Bildgröße statt mit der Anzahl der Boxen im Bild.
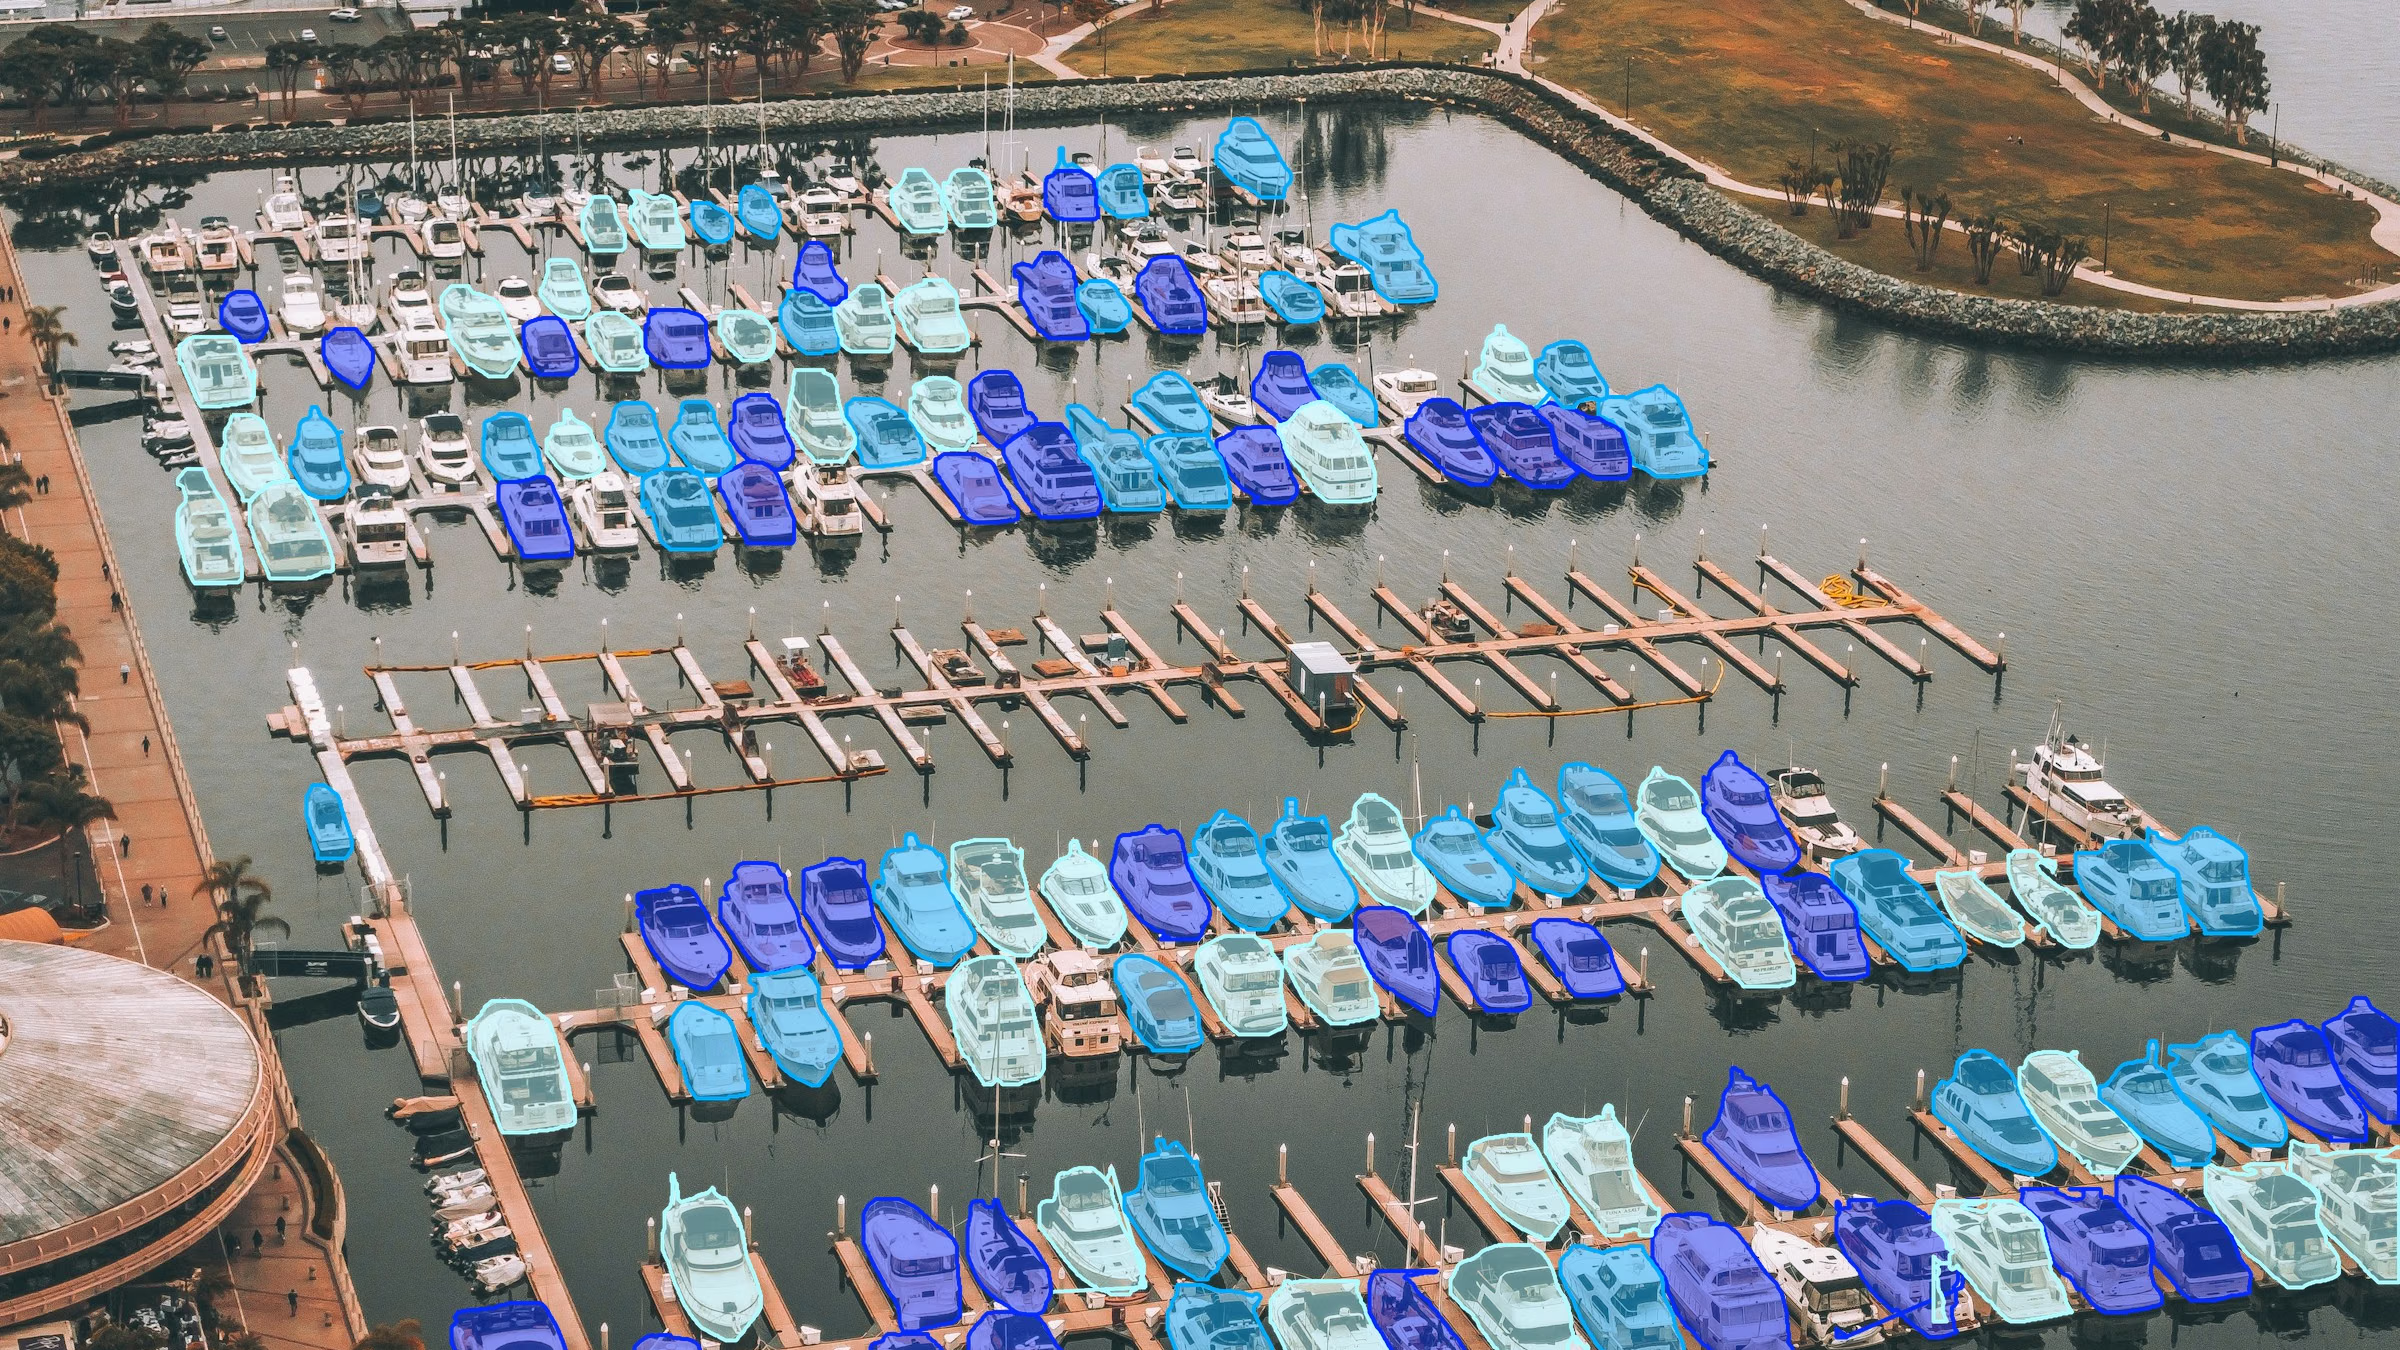
YOLO26x-seg gab in diesem Foto des Jachthafens 127 Boots-Masken zurück, hier zugeschnitten (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Foto: Unsplash.
Deshalb war es für die Segmentierung unpraktisch, max_det über den Standardwert 300 hinaus zu erhöhen. Große Bilder mit vielen Instanzen konnten außerdem den Speicher erschöpfen. Dichte Verkaufsregale wie SKU-110K, Paketstapel und Luftaufnahmen sind genau die Szenen, in denen du mehr als 300 Objekte verarbeiten möchtest.
Ultralytics 8.4.213 dekodiert große Maskenstapel innerhalb jeder Box#
Der neue Verarbeitungspfad aus PR #27197 interpoliert die Prototyp-Logits nur an den Pixeln jeder Box. Dabei kommt separables bilineares Sampling zum Einsatz, wie bei der Interpolation von PyTorch, und Boxen ähnlicher Größe werden gemeinsam verarbeitet. Bei großen Stapeln richtet sich der Dekodierungsaufwand nun nach der aufsummierten Fläche der Boxen.
Drei Details sind in der Praxis wichtig:
- Der neue Pfad wird ab einer festen Größe des Maskenstapels verwendet. Der Segmentierungsvorhersager nutzt Masken innerhalb der Boxen, wenn der dichte Stapel auf CUDA mehr als 33.554.432 Pixel oder auf CPU und anderen Geräten mehr als 4.194.304 Pixel umfassen würde. Bei kleineren Stapeln bleibt es beim bisherigen dichten Pfad, der bei wenigen Masken genauso schnell oder schneller ist.
- Bei diesem Pfad werden Umrisse direkt aus den Masken innerhalb der Boxen erstellt.
masks.xyundmasks.xynverfolgen Polygone für jede Box, sodasssummary(),to_json()undsave_txtnicht den vollständigen Stapel erstellen. - Das Ausgabeformat bleibt unverändert.
masks.datagibt weiterhin einen dichten N x H x W-Tensor zurück. Beim Pfad mit Masken innerhalb der Boxen wird dieser Tensor erst erstellt, wenn du ihn zum ersten Mal ausliest.
Das Auslesen des dichten Tensors kostet weiterhin Speicher für seine Erstellung, doch laut Messung im PR ist der Aufwand geringer: Auf der GPU sank das Auslesen von masks.data für 300 Masken bei 1080p mit retina_masks=True von 14,1 ms und 1.366 MiB auf 9,1 ms und 795 MiB.
1.000 Masken bei 1080p: auf der GPU von 821,2 ms auf 56,4 ms#
Der PR vergleicht YOLO26n-seg bei der vollständigen Verarbeitung von model.predict(...) plus result.summary() (Boxen und Polygone) und gibt den Median aufgewärmter Läufe mit einem Prozess pro Zeile an. Für die dichten Szenen wurde ein synthetisches gekacheltes Bild mit conf=0.01 und imgsz=1280 verwendet. Die typische Szene ist das standardmäßige bus.jpg mit 5 Masken. „Vorher“ bezeichnet Version 8.4.212. Dies sind Messungen mit hohem Nachverarbeitungsaufwand für Vorhersage und Zusammenfassung, keine allgemeingültigen Angaben zur Inferenzgeschwindigkeit.
| Szene (GPU, RTX PRO 6000) | Masken | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Typisch (bus.jpg) | 5 | Falsch | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Falsch | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Wahr | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Wahr | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Wahr | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Wahr | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Laufzeit und maximaler GPU-Speicherverbrauch, PyTorch 2.15.0 mit CUDA 13.2. Quelle: PR #27197.
Wie vorgesehen, bleibt das Bild mit fünf typischen Masken unverändert. Die Vorteile zeigen sich dort, wo der alte Stapel groß wurde, und sind bei Masken in voller Auflösung am größten, da diese zuvor den höchsten Aufwand verursachten.
Große Bilder benötigen nur einen Bruchteil des Speichers#
Bei 4000 x 3000 Pixeln und 1.000 vorhergesagten Masken erreichte der alte Pfad einen Spitzenwert von 23.305 MiB GPU-Speicher. Der neue Pfad kam auf 258 MiB und war in 130,7 ms statt 4.323,1 ms fertig. Dadurch bleibt mehr GPU-Speicher für den Rest der Verarbeitungskette, wenn du mit Drohnen-, Satelliten- und Inspektionsaufnahmen mit 12 Megapixeln arbeitest.
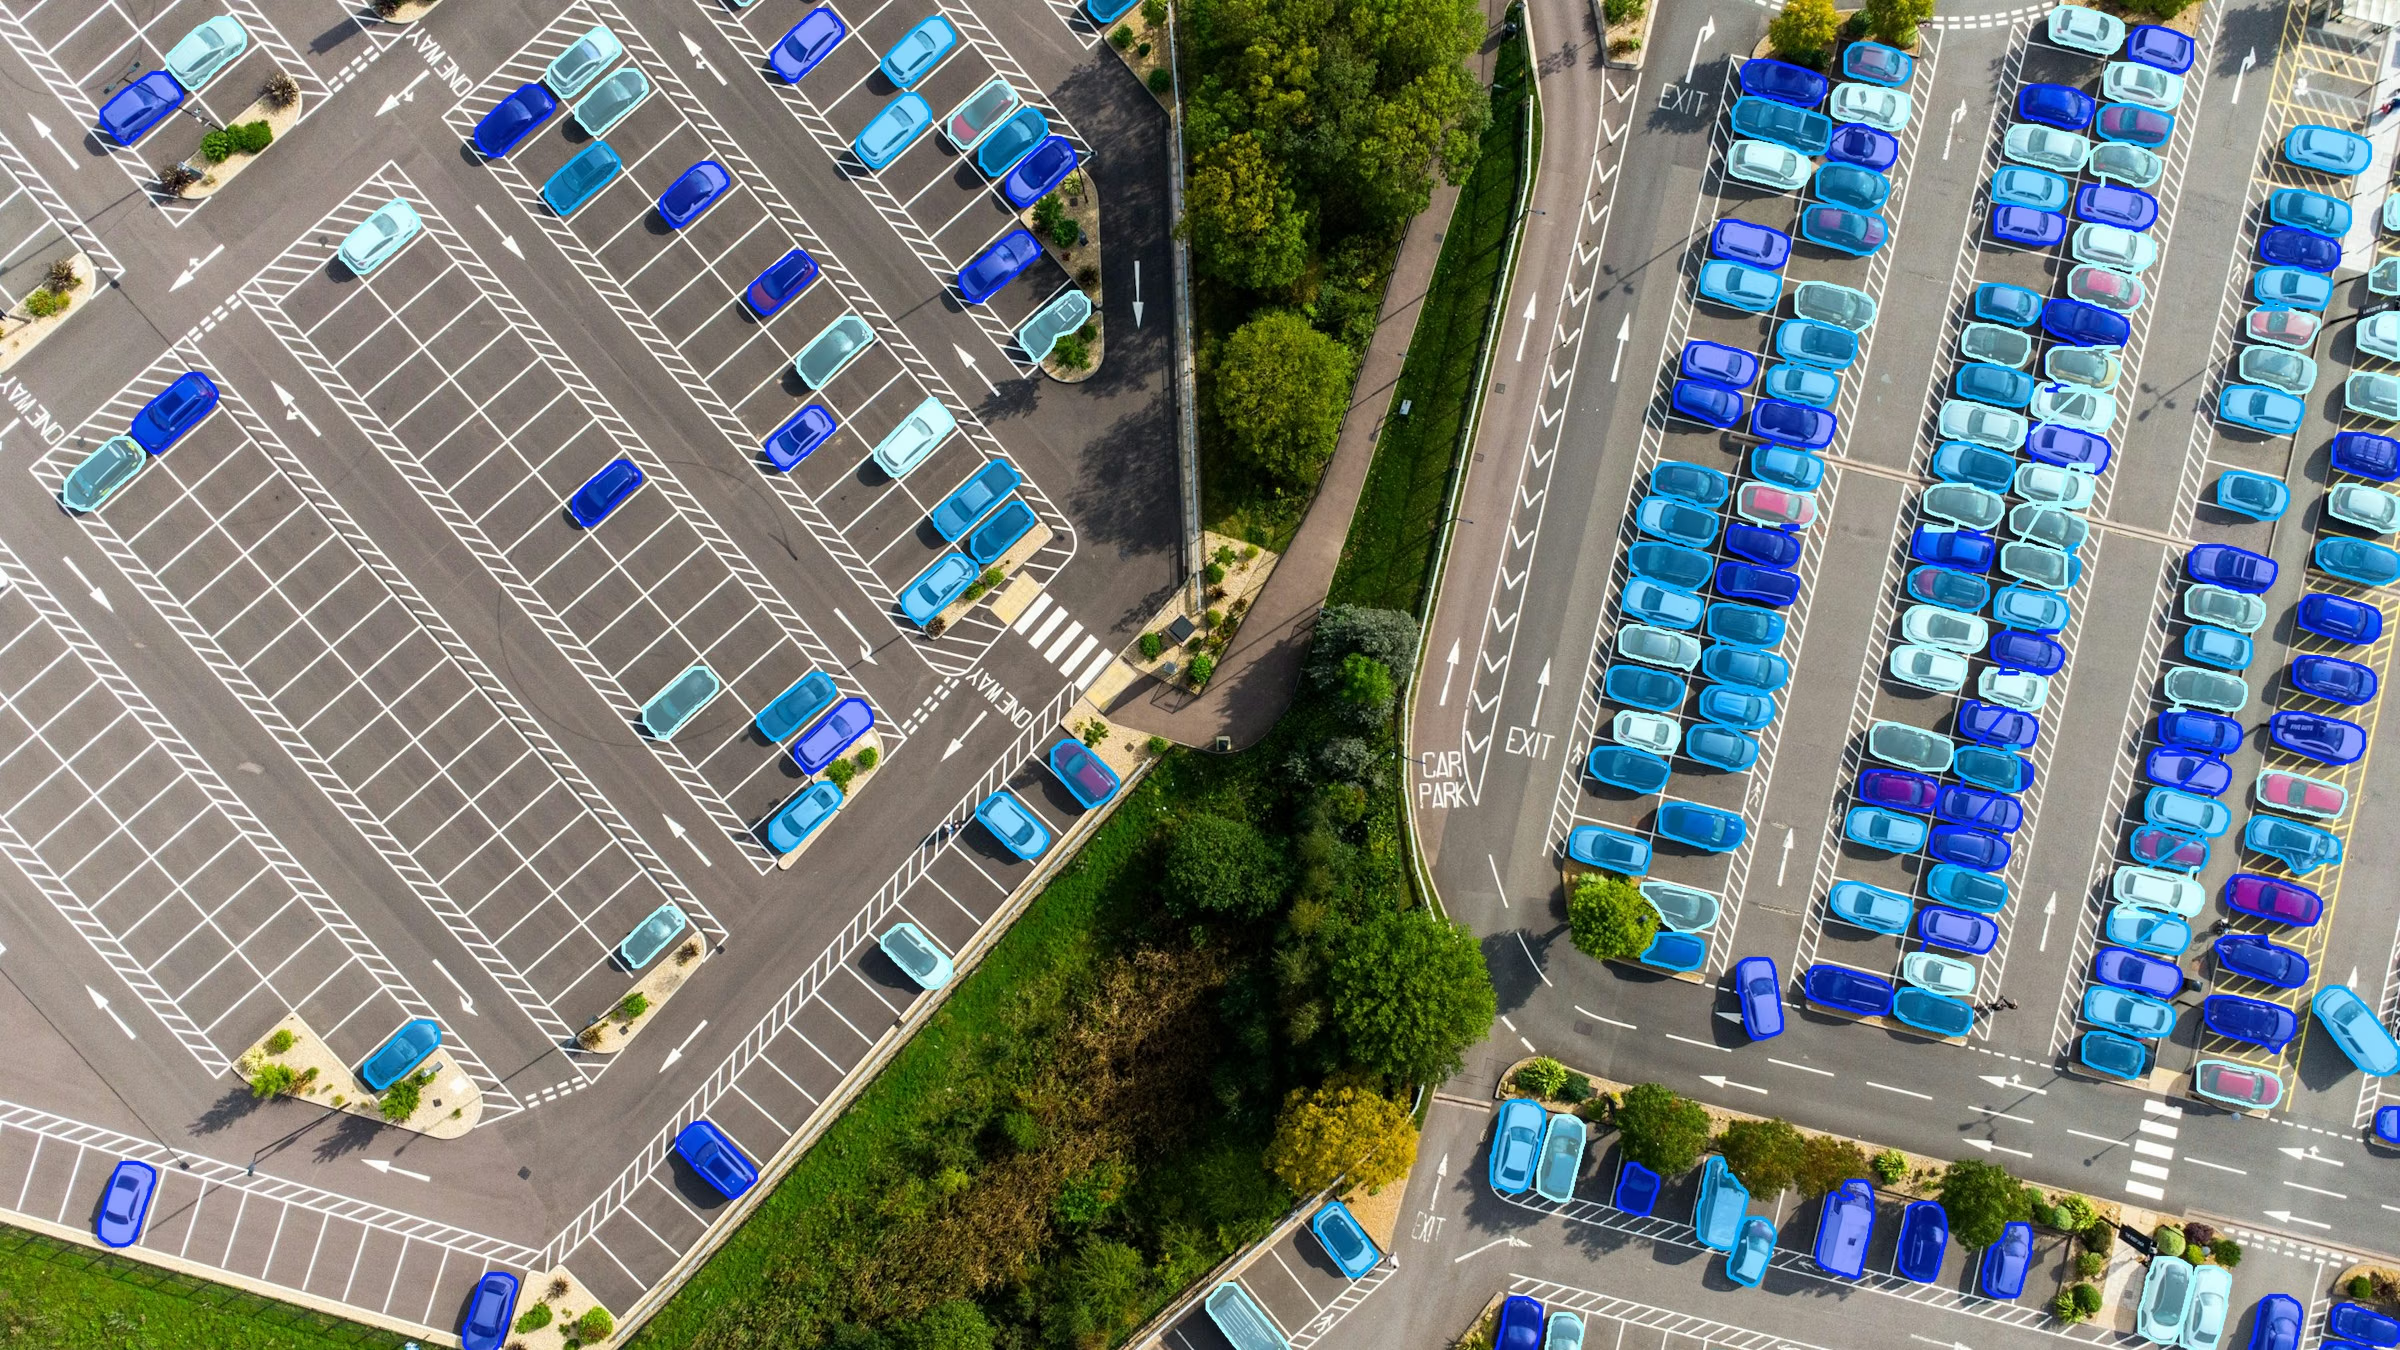
YOLO26x-seg gab in dieser Luftaufnahme 222 Auto-Masken zurück (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Foto: Unsplash.
Vorhersagen auf der CPU werden ebenfalls deutlich schneller#
Auf einer Linux-x86-CPU mit 8 Threads belegt der Prozess etwa 840 MiB, bevor Masken erstellt werden. Bei 1080p mit 1.000 Masken in voller Auflösung sank der maximale Prozessspeicher von 5.217 MiB auf 1.072 MiB. Die Laufzeit sank wie unten gezeigt.
300 und 1.000 Masken bei 1920 x 1080 sowie 300 Masken bei 4000 x 3000 (12 MP). YOLO26n-seg, Vorhersage plus Zusammenfassung, 8.4.212 vorher und 8.4.213 nachher. Quelle: PR #27197.
Die Masken stimmen mit 8.4.212 überein, mit winzigen Abweichungen an den Kanten in einem Modus#
Ein schnellerer Pfad ist nur dann nützlich, wenn er dasselbe Ergebnis liefert. Im PR wurden 8.4.213 und 8.4.212 anhand von 96 Vorhersagen verglichen: mit YOLO26n-seg und YOLO11n-seg auf zwei Bildern in sechs Größen, conf von 0.25 und 0.01, in beiden Maskenmodi und bei erzwungener Verwendung des Pfads mit Masken innerhalb der Boxen:
- Standardmasken (
retina_masks=False): Boxen, Masken und Polygone sind identisch; 0 von 7,6 Millionen Maskenpixeln weichen ab. - Masken in voller Auflösung (
retina_masks=True): identisch, wenn der alte Code einmal interpoliert hat. Bei den anderen Bildformen weichen 0,07 % der Maskenpixel ab (18.105 von 24,8 Millionen), alle an Maskenkanten. Der Grund: Der alte Code interpolierte dort zweimal, während der neue Code die Prototypen einmal an den exakten Koordinaten abtastet. - Apple MPS: Masken, Boxen und Polygone sind bei einer dichten 1080p-Szene mit 179 Masken in beiden Maskenmodi identisch.
So segmentierst du 1.000 Objekte pro Bild in Python#
Führe mit pip install -U ultralytics ein Upgrade auf Version 8.4.213 oder höher durch und erhöhe dann max_det über den Standardwert 300 hinaus. Der Rest deines Codes bleibt unverändert.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # COCO-Klassen; lade dein eigenes trainiertes Modell für Regale oder Pakete
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # Ein (P, 2)-Array pro Objekt, in Pixeln des Originalbildes
rows = r.summary()  # Boxen und Polygone
max_det ist ein Höchstwert, kein Zielwert: Wie viele Objekte zurückgegeben werden, hängt weiterhin vom Modell, vom Bild und von deinem Konfidenzschwellwert ab. So holst du das Beste aus der Änderung heraus:
- Lies nach Möglichkeit die Umrisse aus.
masks.xy(Pixel) undmasks.xyn(normalisiert) stammen beim Pfad für große Stapel aus Masken innerhalb der Boxen, ebenso wieto_json()undsave_txt. Die Referenz zu Results führt alle Attribute auf. - Lies
masks.datafür direkte Pixelberechnungen aus. Flächen und Überlappungen lassen sich am einfachsten mit dem dichten Tensor berechnen; Freistellungen können auch aus den Konturen vonmasks.xyerstellt werden. Unsere Academy-Lektion zur Verwendung von Masken im Code zeigt, wann die jeweilige Ansicht sinnvoll ist. Die Anleitung zur Objektfreistellung erstellt Freistellungen aus Konturen. - Verwende
retina_masks=True, wenn du Masken in der Auflösung des Quellbildes brauchst. Im GPU-Benchmark mit 300 Masken bei 1080p kostet diese Einstellung jetzt 18,0 ms, verglichen mit 16,3 ms für Standardmasken. Für kleine Objekte in sehr großen Bildern findest du in unserem Beitrag zur Erkennung kleiner Objekte mit Bildkachelung und in der Anleitung zur Kachelung hochauflösender Bilder weitere Informationen. Die Vorhersage mit Kachelung gibt Masken in der Größe des Quellbildes zurück. Daher bleibt der Speicherbedarf bei einem gekachelten Durchlauf proportional zur Größe des Originalbildes. - Stimme
confundiouauf dichte Szenen ab. Wenn dumax_deterhöhst, bleiben mehr Erkennungen erhalten, dieconfbereits bestehen; durch Senken vonconfwerden auch Erkennungen mit geringerer Konfidenz berücksichtigt. Die Vorhersageeinstellungen erläuternconf,iouundmax_det. Unsere Anleitung zum NMS-IoU-Schwellenwert erklärt, wie du mit sich berührenden Objekten umgehst.
Die Änderung betrifft die Nachverarbeitung in Python und gilt daher für das PyTorch-Modell sowie für exportierte Modelle, die über die Ultralytics-predict-API ausgeführt werden. Im PR wurden YOLO26n-seg und YOLO11n-seg getestet. Dieselbe Nachverarbeitung gilt für alle YOLO26- und YOLO11-Segmentierungsmodelle, von YOLO26n-seg mit 2,7 Mio. fusionierten Parametern bis YOLO26x-seg mit 62,8 Mio. Wenn du ein Modell mit deinen eigenen dichten Daten trainieren möchtest, folge unserer Anleitung zum Training von YOLO26 für die Instanzsegmentierung mit eigenen Daten.
Die Ultralytics Platform liefert jetzt bis zu 1.000 Ergebnisse pro Bild zurück#
Derselbe Höchstwert gilt jetzt auch in der Ultralytics Platform. Der Tab „Predict“ eines Modells gibt bis zu 1.000 Ergebnisse pro Bild zurück, ebenso die dahinterliegende REST API. RT-DETR-Modelle sind auf 300 begrenzt, entsprechend der Anzahl der Abfragen in ihrem Decoder.
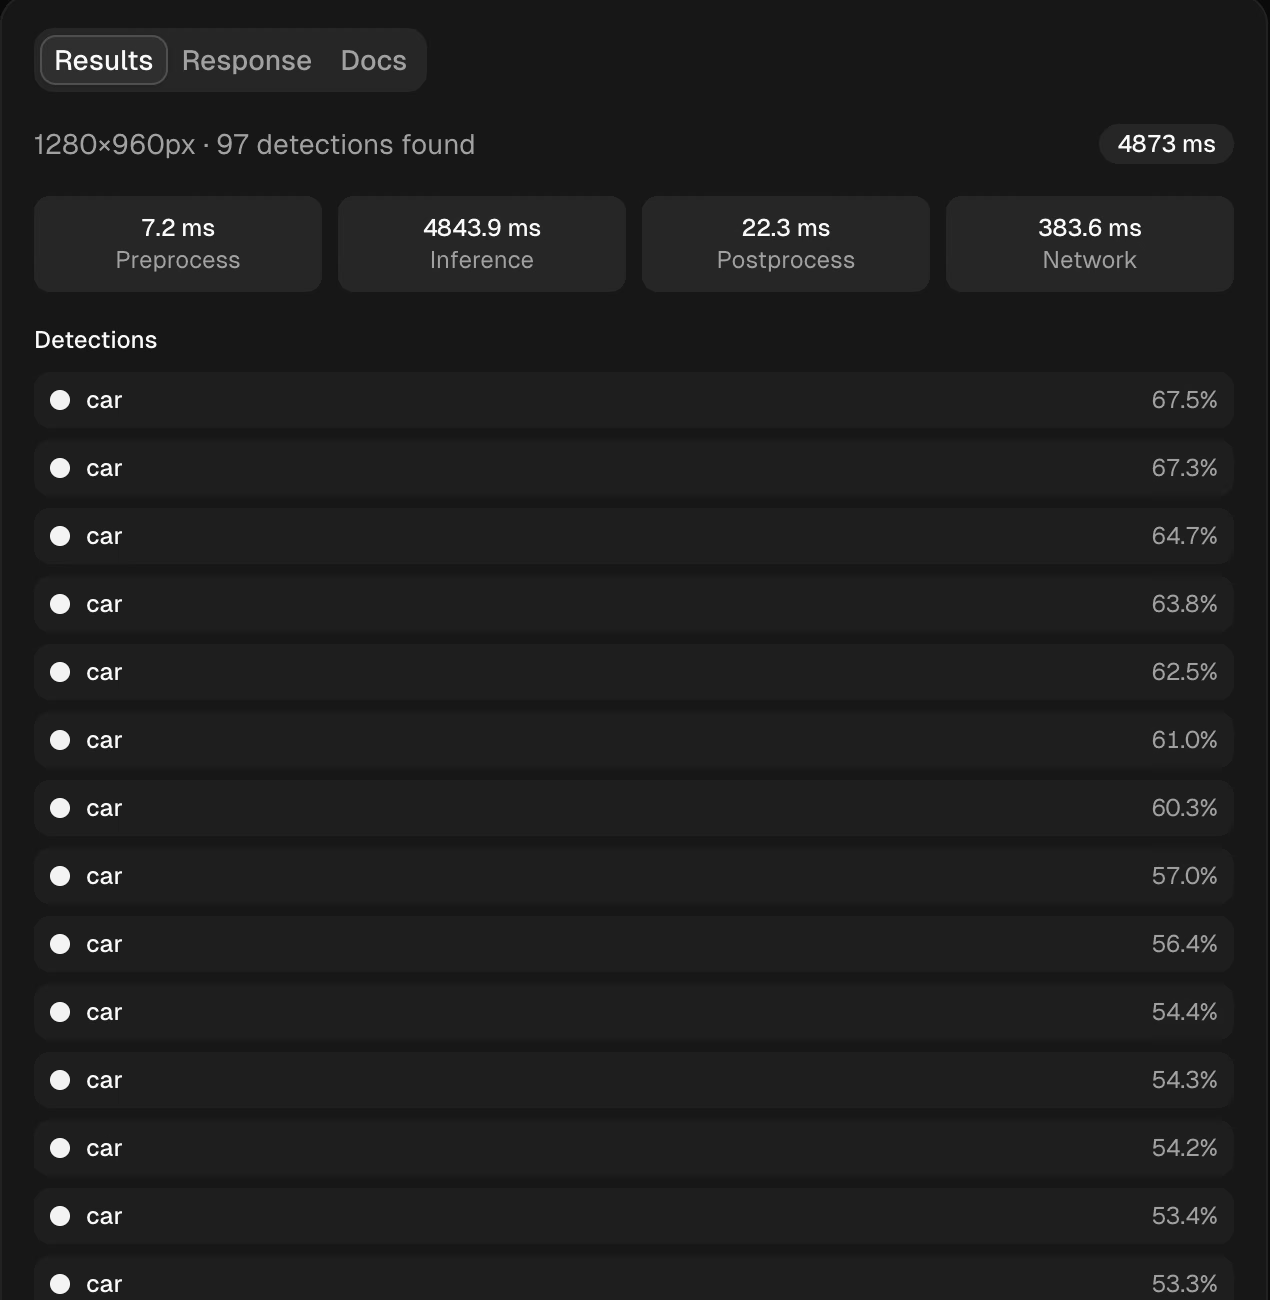
Der Predict-Tab für YOLO26x-seg bei einer Bildgröße von 1280 mit 97 erkannten Autos in der Luftaufnahme oben. Die Dokumentation zur Inferenz in der Platform beschreibt die Übersicht im Detail.
Die Ergebnisübersicht ist für lange Listen ausgelegt. Bei mehr als 10 Ergebnissen zeigt das Bild Boxen ohne Beschriftungen, damit die Objekte sichtbar bleiben. Die Liste benennt jedes Ergebnis, und das vergrößerte Bild zeigt die Beschriftungen. Fahre mit der Maus über eine Zeile, um das zugehörige Objekt hervorzuheben, oder über ein Objekt, um die zugehörige Zeile zu finden.
Um die Funktion mit deinen eigenen Daten auszuprobieren, starte mit dem Paketsegmentierungsdatensatz Package-Seg, trainiere in der Cloud und führe das Ergebnis im Predict-Tab oder über einen dedizierten Endpunkt aus.
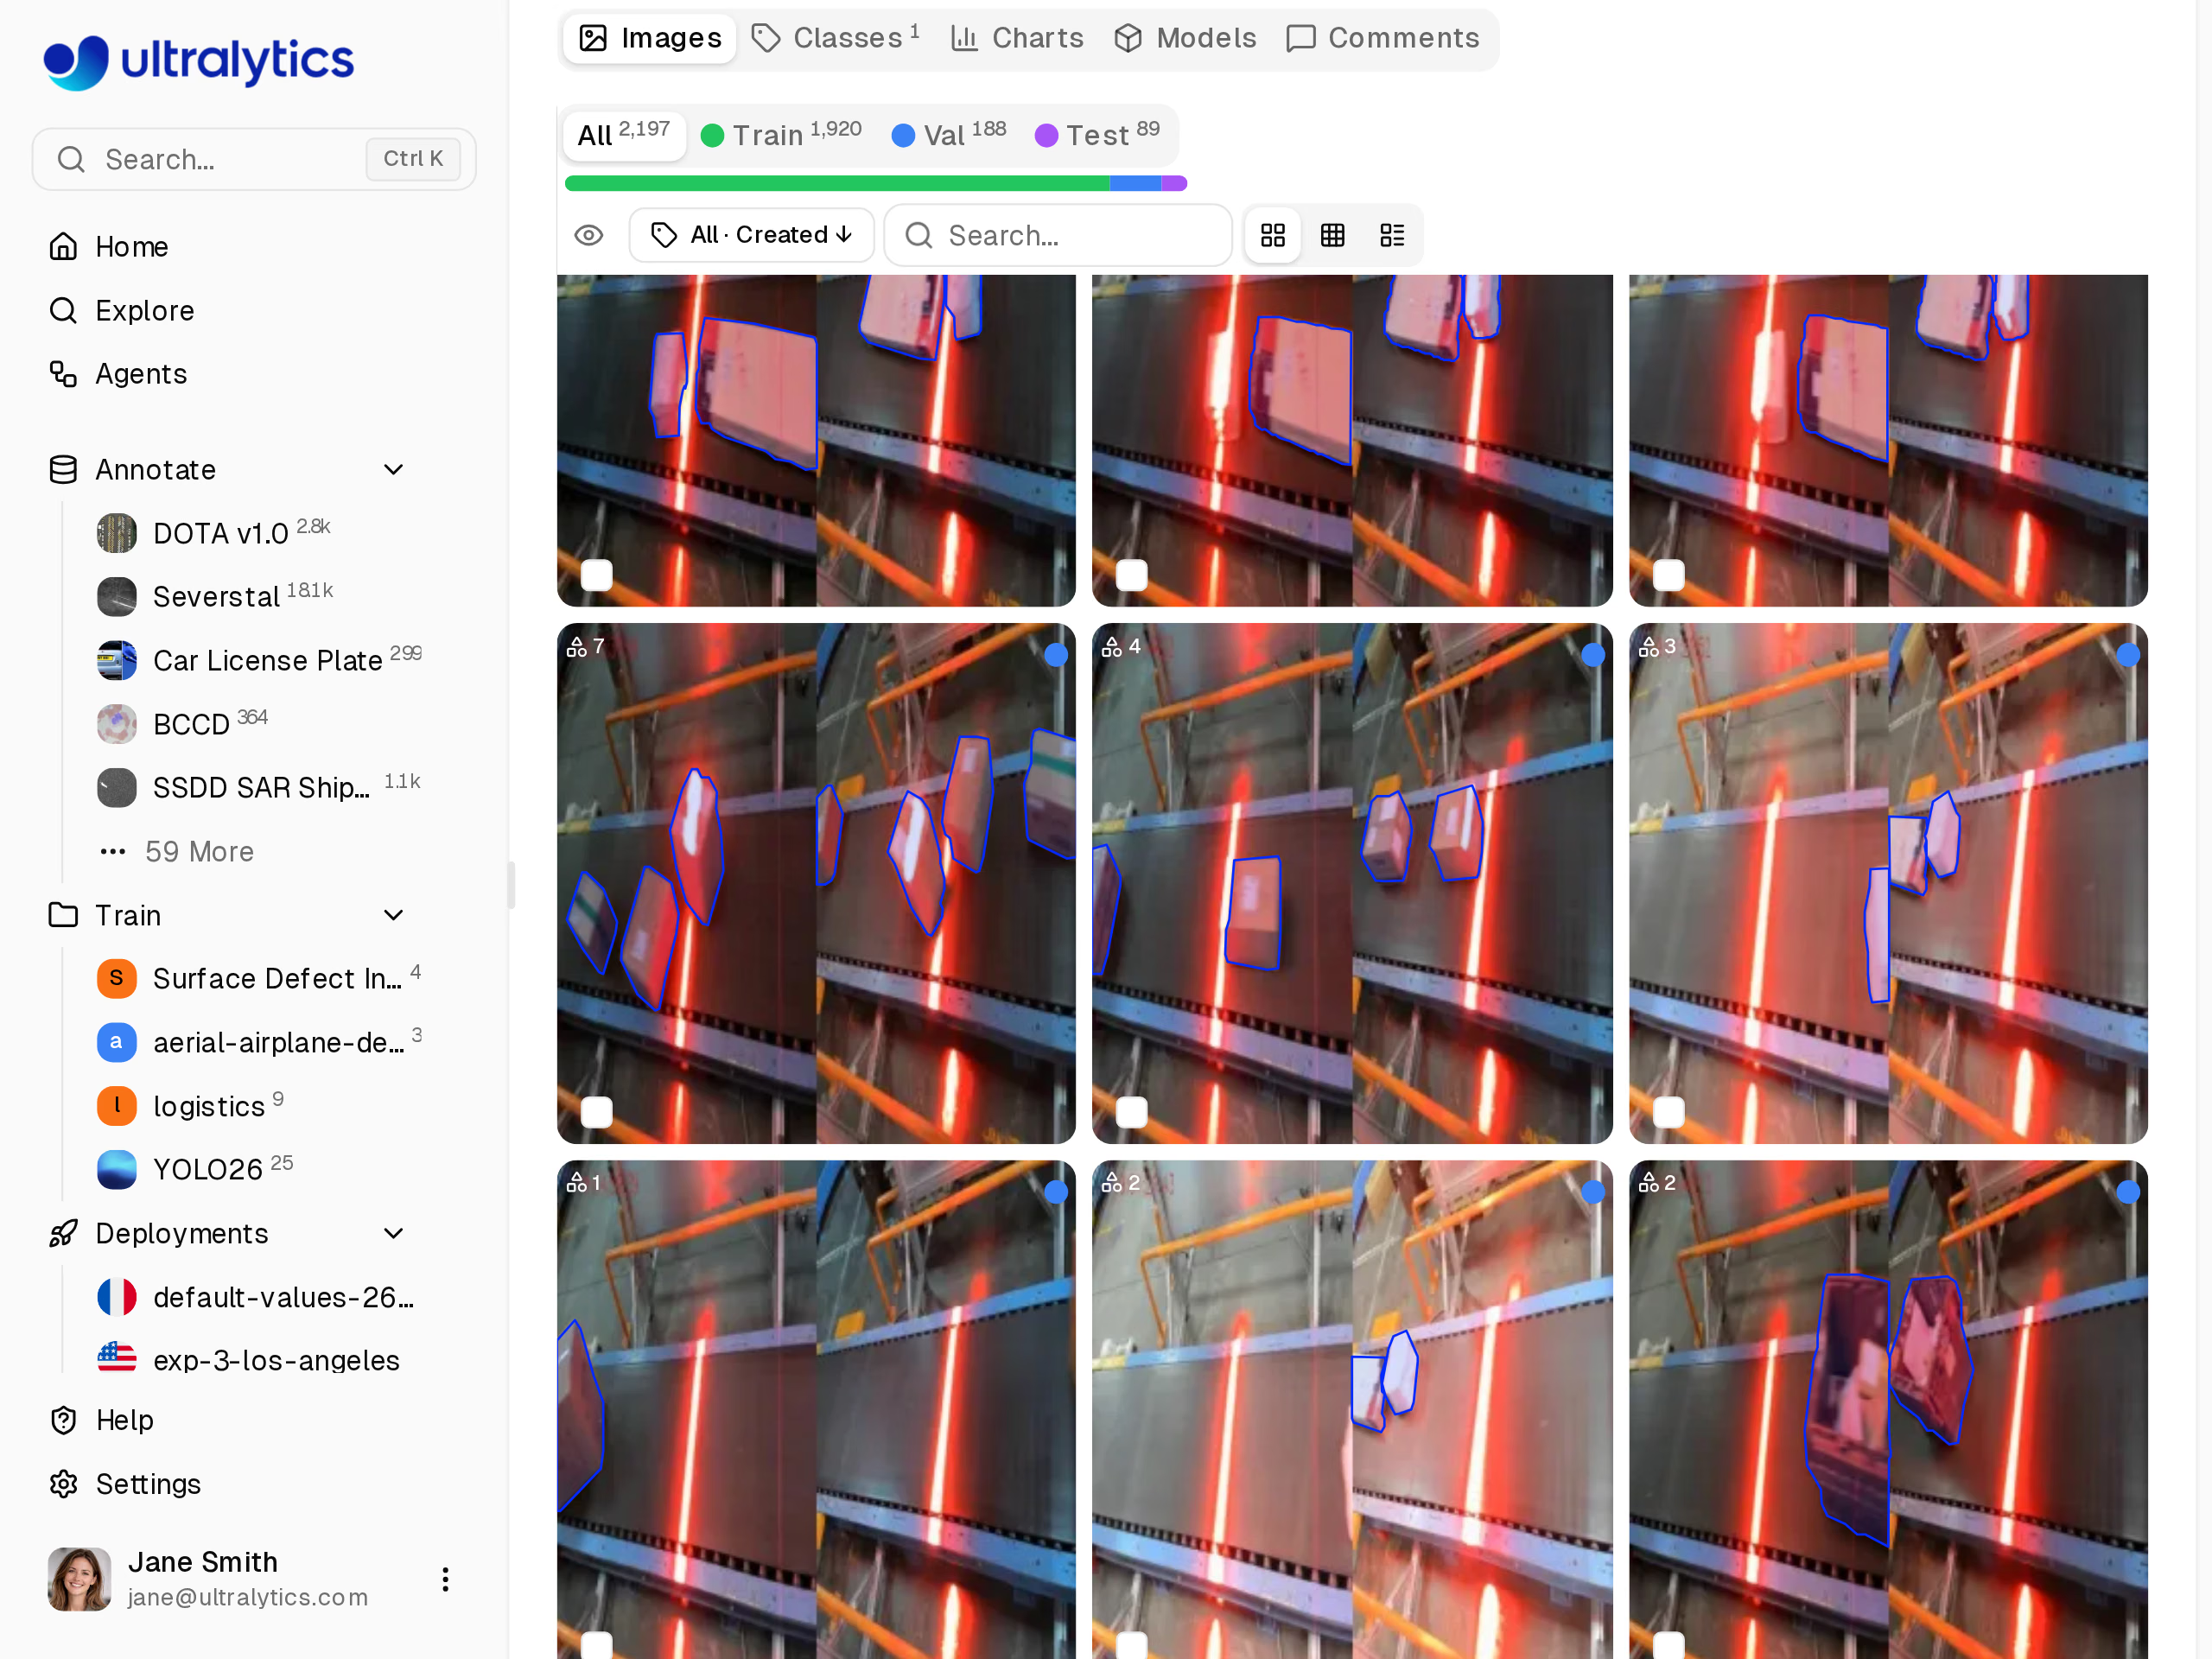
Der Datensatz Package-Seg in der Ultralytics Platform als fertiger Ausgangspunkt für die Segmentierung in der Logistik.
Wer sollte ein Upgrade durchführen?#
Führe jetzt ein Upgrade durch, wenn du dichte Szenen oder große Bilder segmentierst: Verkaufsregale, Paketsortierung, Luft- und Drohnenaufnahmen, Zellmikroskopie oder andere Bereiche, in denen du max_det begrenzen, die Bildgröße reduzieren oder retina_masks deaktivieren musstest, um im Speicherlimit zu bleiben. Diese Umgehungslösungen kannst du jetzt erneut prüfen.
Wenn deine Maskenstapel unter dem Schwellenwert bleiben, wird weiterhin der bestehende dichte Pfad verwendet. Beachte, dass der Schwellenwert die Anzahl der Objekte multipliziert mit der Bildgröße berücksichtigt. Daher kann er auch bei wenigen Masken in einem sehr großen Bild überschritten werden. Wenn deine Verarbeitungskette immer masks.data ausliest, wird der dichte Tensor weiterhin erstellt. Im GPU-Test des PR mit 300 Masken bei 1080p waren Zeit- und Speicherbedarf dennoch geringer als zuvor. Eine Auffrischung dazu, ob du überhaupt Instanzmasken benötigst, bietet der Beitrag zur semantischen Segmentierung im Vergleich zur Instanzsegmentierung.
Häufig gestellte Fragen
YOLO-Segmentierung ist die Aufgabe der Instanzsegmentierung in Ultralytics YOLO: Für jedes Objekt gibt das Modell eine Klasse, eine Box, einen Konfidenzwert und eine Pixelmaske zurück. YOLO26-Segmentierungsmodelle sind in fünf Größen erhältlich, von YOLO26n-seg bis YOLO26x-seg. Sie wurden mit den 80 COCO-Klassen vortrainiert und können mit deinen eigenen Daten feinabgestimmt werden.
max_detlegt den Höchstwert fest, standardmäßig 300. Die Anzahl der zurückgegebenen Objekte hängt außerdem vom Modell, vom Bild und vom Konfidenzschwellwert ab. Seit Version 8.4.213 ist ein Höchstwert von 1.000 für Arbeitslasten wie im Benchmark praktikabel: Auf einem synthetischen 1080p-Bild sagte YOLO26n-seg 1.000 Masken in voller Auflösung voraus und fasste sie auf einer RTX PRO 6000 in 56,4 ms bei einem maximalen Speicherverbrauch von 321 MiB zusammen. Die Ultralytics Platform gibt bis zu 1.000 Ergebnisse pro Bild zurück.In früheren Versionen wurde jede Maske in Bildgröße erstellt. Der Speicherbedarf wuchs deshalb mit der Anzahl der Objekte multipliziert mit der Bildfläche. Im synthetischen Benchmark mit 4000 x 3000 Pixeln und 1.000 Masken in voller Auflösung erreichte der GPU-Speicherverbrauch einen Spitzenwert von 23.305 MiB. Version 8.4.213 dekodiert große Stapel innerhalb jeder Box und kam im selben Fall auf einen Spitzenwert von 258 MiB.
Führe ein Upgrade auf
ultralyticsVersion 8.4.213 oder höher durch. Weitere Codeänderungen sind nicht nötig, da der Pfad mit Masken innerhalb der Boxen bei großen Maskenstapeln automatisch aktiviert wird.masks.databehält dasselbe dichte Format bei, sodass dein bestehender Code weiterhin funktioniert. Wenn du stattdessenmasks.xyausliest odersummary()aufrufst, wird der Tensor bei diesem Pfad nicht erstellt.retina_masks=Truegibt Masken in der Originalauflösung des Bildes statt in der Inferenzgröße des Modells zurück. Dadurch wird die dichte Maske am Originalbild ausgerichtet. Bei 300 Masken in einem synthetischen 1080p-Bild dauerte die Vorhersage samt Zusammenfassung durch YOLO26n-seg auf einer RTX PRO 6000 mit aktivierter Einstellung in Version 8.4.212 248,7 ms und in Version 8.4.213 18,0 ms.
Verfasst von
Gründer und CEO · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









