Data Curation
Datenkuratierung ist der fortlaufende Prozess, zuverlässige Datensätze für maschinelles Lernen und Evaluierung zu organisieren, zu validieren, zu dokumentieren und zu pflegen.
Datenkuratierung ist der fortlaufende Prozess, Daten auszuwählen, zu organisieren, zu prüfen, zu dokumentieren und zu pflegen, damit sie für einen bestimmten Zweck nützlich bleiben. Beim maschinellen Lernen bestimmt sie, aus welchen Beispielen ein Modell lernt und auf welche Belege seine Bewertung gestützt wird. Ein kuratierter Datensatz vereint relevante Stichproben, einheitliche Labels für überwachte Aufgaben, Kontextinformationen und nachvollziehbare Versionen.
Kuratierung, Bereinigung und Vorverarbeitung#
Die Kuratierung umfasst den gesamten Lebenszyklus eines Datensatzes. Die Datenbereinigung korrigiert Fehler und entfernt unbrauchbare Datensätze; die Datenvorverarbeitung verändert Eingaben durch Vorgänge wie Größenanpassung oder Normalisierung. Bei der Datenannotation, auch Datenbeschriftung genannt, werden die Zielwerte für überwachtes Lernen hinzugefügt. Die Kuratierung koordiniert diese Aktivitäten und legt zugleich fest, welche Stichproben dazugehören, wie Kategorien definiert werden und wie sich die Sammlung im Laufe der Zeit verändert. Einheitliche Kategoriedefinitionen und Beschriftungsregeln helfen Modellen, zuverlässige Zusammenhänge zwischen Bildern und Zielwerten zu lernen.
Damit ist die Kuratierung ein praktischer Bestandteil der datenzentrierten KI, bei der Systeme durch die Verbesserung ihrer Daten verbessert werden.
So funktioniert Datenkuratierung#
Der Prozess beginnt mit einer Spezifikation des Datensatzes: der Vorhersageaufgabe, den Zielkategorien, den Betriebsbedingungen und den Aufnahmekriterien. Bei der Objekterkennung umfasst dies Regeln für Begrenzungsrahmen und teilweise sichtbare Objekte. Die Überprüfung der Kategorienhäufigkeiten und Aufnahmebedingungen deckt Verzerrungen im Datensatz auf, etwa unterrepräsentierte Klassen oder Umgebungen.
Qualitätsprüfungen kombinieren automatische Inspektion mit menschlicher Überprüfung. Dateiüberprüfungen finden unlesbare Bilder; Annotationsprüfungen erkennen ungültige Koordinaten und uneinheitliche Klassen. Hashes für exakte Dateien erkennen identische Kopien, während Embeddings – numerische Darstellungen des Bildinhalts – helfen, visuell ähnliche Stichproben zu finden. Bei der Überprüfung werden behebbare Fehler von unbrauchbaren Datensätzen unterschieden. Gültige, schwierige und für die Aufgabe repräsentative Beispiele bleiben erhalten.
Bei einer Prüfung anhand von Datei-Hashes kann für jede eindeutige Datei ein Pfad beibehalten werden. Dieses Beispiel prüft die im Paket ultralytics enthaltenen Bilder, das mit pip install ultralytics installiert wird:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
Die Zählwerte zeigen, wie viele Dateien nach dem Entfernen exakter Duplikate verbleiben; gleiche Zählwerte bedeuten, dass alle geprüften Dateien unterschiedliche Hashes haben.
Die Aufteilung schützt die Unabhängigkeit der Trainingsdaten, Validierungsdaten und Testdaten. Benachbarte Videobilder enthalten dieselben Szenen, daher führt ihre Verteilung auf verschiedene Teilmengen zu Datenlecks und lässt die Bewertungswerte zu hoch ausfallen. Eine Gruppierung nach Aufnahmesitzung, Kamera oder Standort sorgt dafür, dass die Bewertung die vorgesehene Generalisierungsaufgabe widerspiegelt. Eine feste Datensatzversion bewahrt diese Zuordnungen zusammen mit den Labels.
Die Ultralytics Platform unterstützt die Kuratierung mit Diagrammen zur Klassenverteilung und einer Bildgruppierung, die Lücken in der Abdeckung, Duplikate und Ausreißer sichtbar machen. Mit den Werkzeugen zur Datensatzverwaltung können Teams diese Gruppen prüfen und Bilder, Labels sowie Zuordnungen zu den Teilmengen aktualisieren.
Aufgaben einer Datenkuratorin oder eines Datenkurators#
Eine Datenkuratorin oder ein Datenkurator bewahrt die Bedeutung und Nutzbarkeit der Sammlung. Zu den Aufgaben gehören die Dokumentation der Quellen, die Abstimmung von Annotationsrichtlinien, die Klärung von Meinungsverschiedenheiten bei der Beschriftung und die Erfassung von Änderungen. Metadaten – Informationen, die die Stichproben beschreiben – halten Aufnahmezeitpunkt, Sensor, Standort und Annotationsstatus fest. Die Pflege wiederverwendbarer Daten umfasst auch das Bewahren von Beschreibungen und unterstützender Dokumentation.
Die Datenherkunft dokumentiert, woher Stichproben stammen und wie sie verändert wurden. Werden Datensatzversionen mit der Experimentverfolgung verknüpft, lassen sich Modellvergleiche reproduzieren. Nach der Bereitstellung priorisiert aktives Lernen informative Stichproben zur Überprüfung; die Überwachung erkennt Datenverschiebungen, die eine neue Datenerhebung auslösen können.
Beispiele aus der Computer Vision#
Im Bereich der automobilen Wahrnehmung umfasst die ursprüngliche BDD100K-Sammlung 100.000 Fahrvideos aus verschiedenen US-amerikanischen Regionen, Wetterbedingungen sowie Tages- und Nachtaufnahmen. Ihre Angaben zu Umgebungsbedingungen ermöglichen die Bewertung unter verschiedenen Aufnahmebedingungen. Die Platform-Ausgabe umfasst 99.996 Schlüsselbilder für die Objekterkennung.
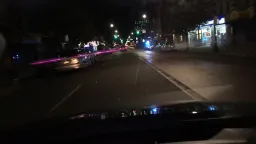 Vorschau 1 von BDD100K
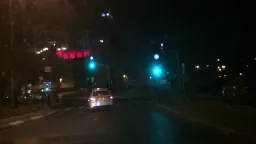 Vorschau 2 von BDD100K
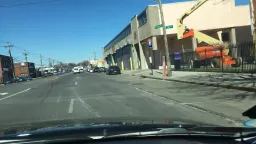 Vorschau 3 von BDD100K
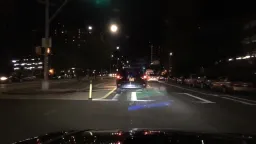 Vorschau 4 von BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Bei der Bildklassifizierung wurden durch die ciFAIR-Korrektur nahezu identische Bilder in den ursprünglichen Testmengen von CIFAR-10 und CIFAR-100 ersetzt. Übereinstimmungen mit Trainingsbildern oder anderen Testbildern betrafen 3,25 % bzw. 10 % der ursprünglichen Testmengen. Bei unveränderten Trainingsdaten stieg der Klassifizierungsfehler von ResNeXt-29 (8x64d) auf CIFAR-10 von 3,56 % auf 3,95 % auf ciFAIR-10.









