Aprovechar el aprendizaje por refuerzo en proyectos de visión artificial
Descubre cómo funciona el aprendizaje por refuerzo y cómo se combina con la visión artificial en robots de almacén, vehículos autónomos y robótica quirúrgica, además de conocer sus ventajas e inconvenientes.
 Abirami Vina10 min de lectura
Una forma sencilla de explicar la inteligencia artificial (AI) es decir que es un campo centrado en reproducir la manera en que las personas piensan y aprenden. De ahí surge la idea de las técnicas de aprendizaje en IA: distintos métodos que permiten a las máquinas mejorar su rendimiento con el tiempo, igual que las personas.
Anteriormente, exploramos técnicas clave de aprendizaje de IA, como el aprendizaje supervisado, no supervisado, por refuerzo y por transferencia, y vimos cómo cada una desempeña un papel importante para ayudar a los modelos de IA a procesar información y tomar decisiones.
Hoy veremos más de cerca el aprendizaje por refuerzo, una técnica que enseña a los sistemas de IA a aprender mediante la experiencia, al interactuar con un entorno y mejorar a partir de las respuestas recibidas. En concreto, exploraremos cómo puede aplicarse el aprendizaje por refuerzo a las aplicaciones de visión artificial, es decir, a los sistemas que permiten a las máquinas interpretar y comprender la información visual del mundo.
Combinar conceptos como el aprendizaje por refuerzo y la visión artificial abre nuevas posibilidades interesantes y es un área de investigación activa. Permite que los sistemas de IA reconozcan lo que ven y tomen decisiones fundamentadas a partir de esa información visual.
¿Qué es el aprendizaje por refuerzo?#
El aprendizaje por refuerzo es una rama del aprendizaje automático en la que un agente de IA aprende realizando acciones y recibiendo comentarios en forma de recompensas o penalizaciones. El objetivo es averiguar qué acciones conducen a los mejores resultados con el tiempo.
Puedes imaginar el aprendizaje por refuerzo como el adiestramiento de un perro. Cuando el perro se sienta al oír una orden, le das una golosina. Al cabo de un tiempo, aprende que sentarse le reporta una recompensa. En el aprendizaje por refuerzo, el agente o modelo de IA es como el perro; el entorno es el mundo que lo rodea y la recompensa le ayuda a entender si ha actuado correctamente.
Esto es distinto del aprendizaje supervisado, en el que se muestran al modelo de IA muchos ejemplos de las respuestas correctas. Por ejemplo, se le podría mostrar una imagen de un perro y decirle: «Esto es un perro».
En cambio, el aprendizaje por refuerzo no depende de datos etiquetados. En su lugar, consiste en aprender probando distintas acciones y aprendiendo de los resultados, como cuando juegas a un juego y averiguas qué movimientos te ayudan a ganar.
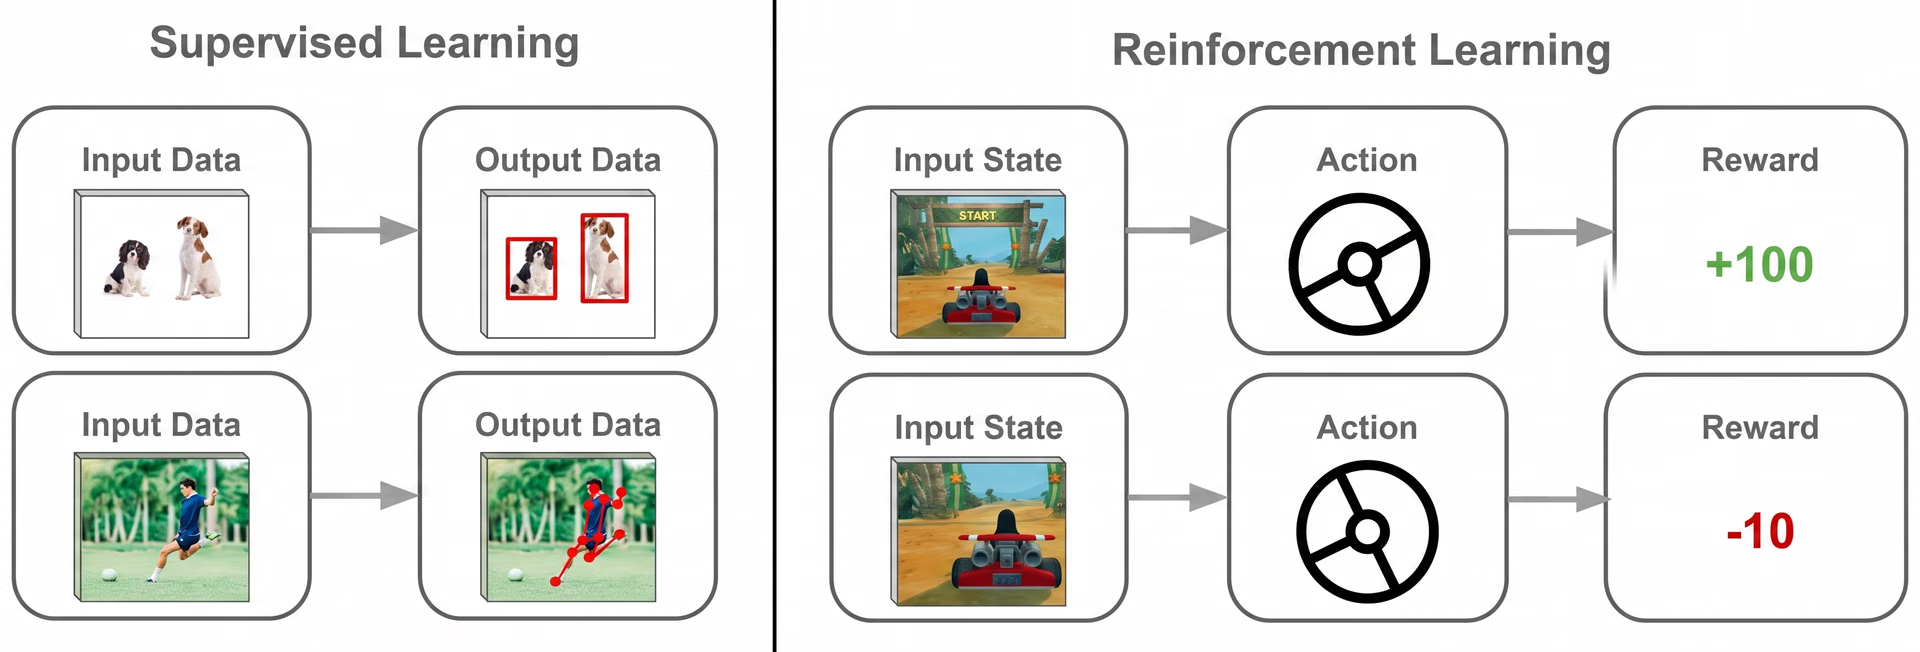
Fig. 1. Aprendizaje por refuerzo frente a aprendizaje supervisado.
El aprendizaje por refuerzo es fundamental para las tareas en las que las decisiones se toman paso a paso y cada elección cambia lo que ocurre después. Este tipo de aprendizaje se utiliza en videojuegos de estrategia para que las partidas sean más desafiantes y atractivas para los jugadores.
Cómo funciona el aprendizaje por refuerzo en las soluciones de IA#
Piensa en cómo aprendes a montar en bicicleta. Al principio, puede que te caigas. Pero, con la práctica, empiezas a descubrir qué te ayuda a mantener el equilibrio. Cuanto más montas, mejor lo haces. Aprendes practicando, no solo porque te digan qué hacer.
El aprendizaje por refuerzo funciona de forma parecida en la IA. Aprende mediante la experiencia: prueba distintas acciones, observa lo que sucede y mejora gradualmente su capacidad para tomar las decisiones adecuadas.
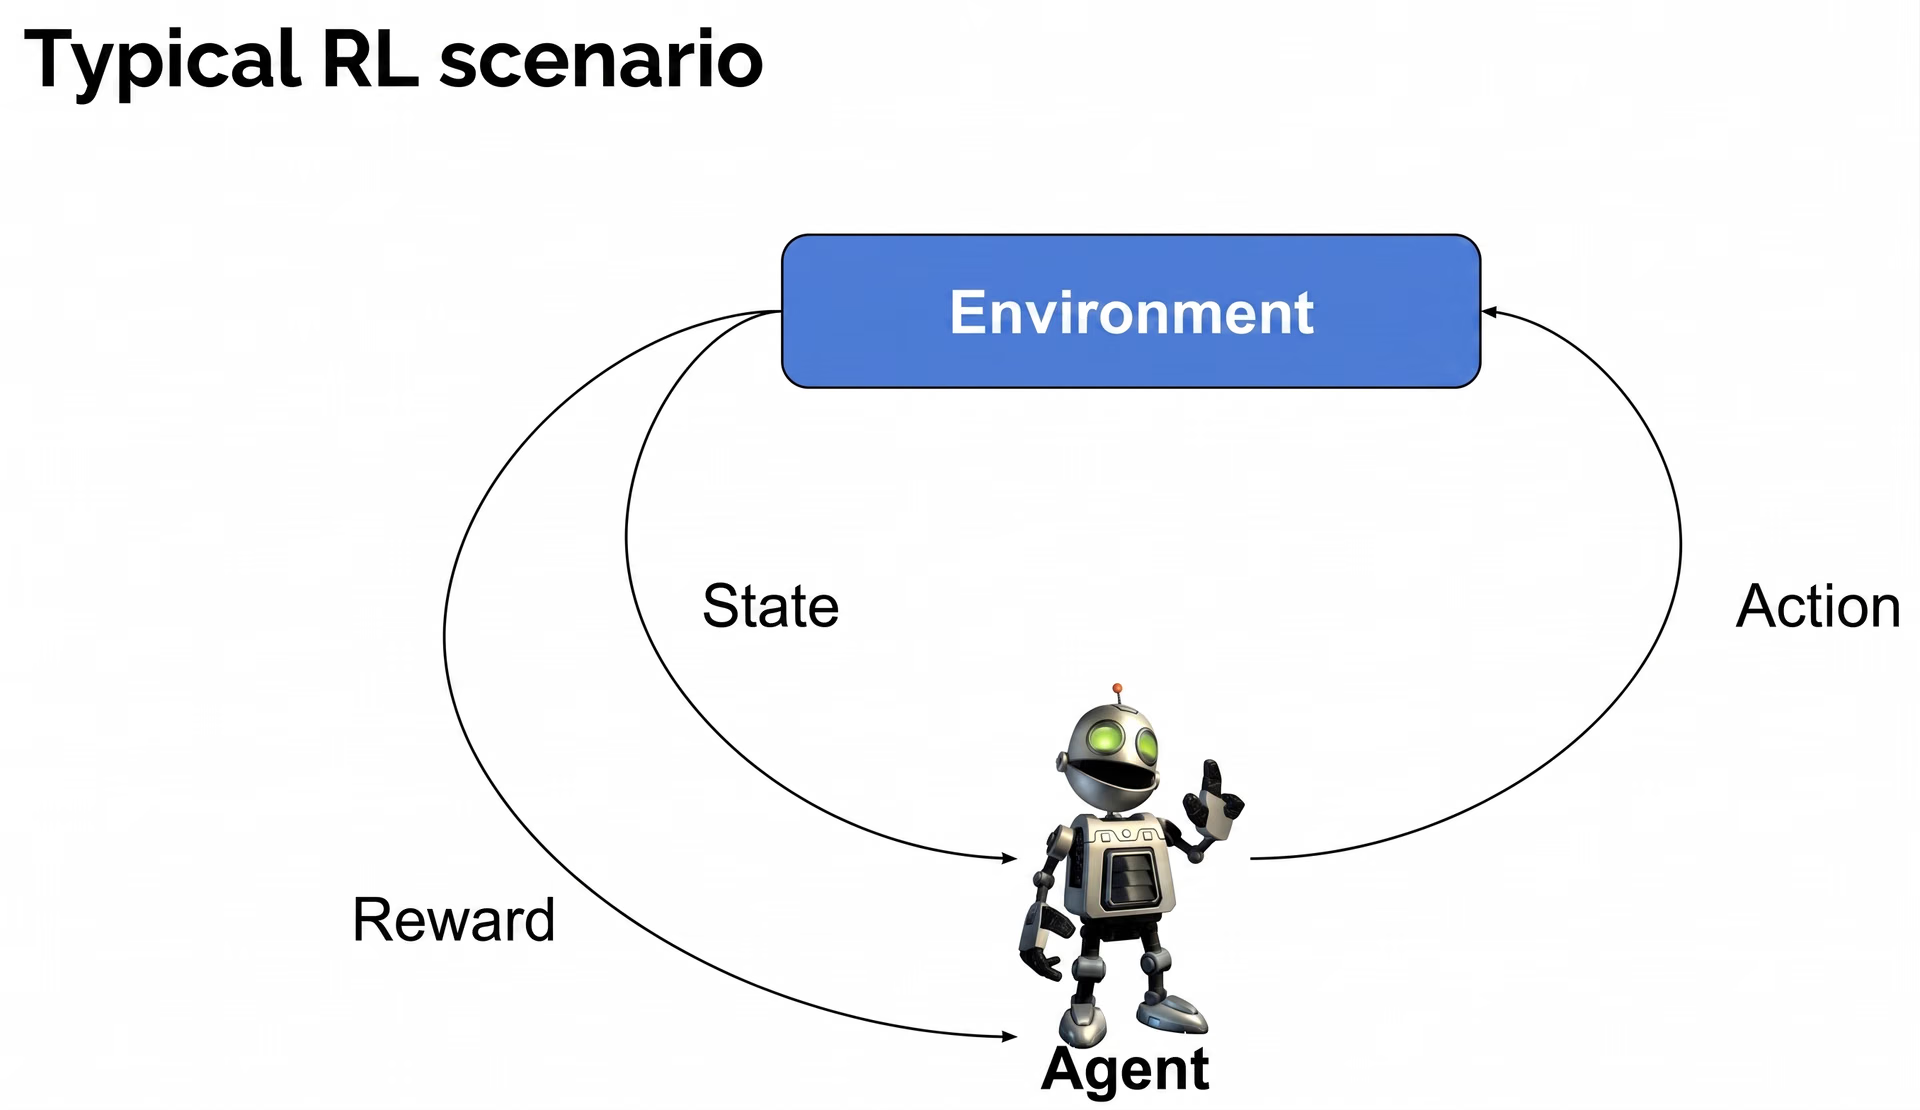
Fig. 2. Cómo funciona el aprendizaje por refuerzo.
Aquí tienes un resumen de algunos de los componentes clave del aprendizaje por refuerzo:
- Agente: El agente es quien aprende o toma las decisiones. Interactúa con el entorno realizando acciones y su objetivo es alcanzar una meta concreta.
- Entorno: El entorno incluye todo aquello con lo que interactúa el agente. Cambia en respuesta a las acciones del agente y proporciona información según los resultados.
- Estado: Un estado representa una instantánea de la situación actual del entorno. El agente observa el estado para comprender lo que le rodea y decidir qué acción realizar a continuación.
- Acción: Una acción es un movimiento o una decisión del agente que afecta al entorno. Cada acción conduce a un nuevo estado y puede influir en las recompensas futuras.
- Recompensa: Una recompensa es simplemente la información que proporciona el entorno para indicar al agente si su acción ha sido beneficiosa o no. Las recompensas positivas animan al agente a repetir las buenas acciones, mientras que las negativas lo disuaden de realizar acciones inadecuadas.
- Política: Una política es la estrategia que sigue el agente para elegir acciones en función del estado actual. Con el tiempo, el agente perfecciona su política para maximizar las recompensas totales que puede obtener.
Al combinar estos componentes, el aprendizaje por refuerzo permite que los sistemas de IA aprendan comportamientos eficaces mediante un proceso continuo de ensayo y error. Con cada intento, el agente mejora su capacidad para elegir acciones que proporcionan mayores recompensas y mejores resultados.
Innovaciones del aprendizaje por refuerzo en visión artificial#
La visión artificial se utiliza en tareas como la detección de objetos en imágenes, la clasificación de lo que aparece en una imagen y la segmentación de una imagen en distintas partes. Los modelos de visión artificial, como Ultralytics YOLO11, permiten realizar estas tareas y pueden utilizarse para crear aplicaciones de gran impacto que obtengan información visual.
Sin embargo, al combinar estas tareas de IA visual con el aprendizaje por refuerzo, se obtiene una solución de IA que no solo ve, sino que también aprende a actuar a partir de la información visual y mejora con el tiempo.
Un ejemplo interesante de aprendizaje por refuerzo en aplicaciones de visión artificial es el uso de robots en almacenes. Los robots equipados con cámaras y sistemas de visión artificial pueden analizar lo que los rodea, detectar dónde está cada artículo, identificar su forma y tamaño, y entender cómo está colocado en la estantería.
Cada vez que el robot intenta recoger un artículo, recibe una respuesta: acierta si lo recoge correctamente y falla si se le cae. Con el tiempo, el robot aprende qué acciones funcionan mejor con cada tipo de artículo. En vez de seguir un conjunto fijo de instrucciones, mejora continuamente con la experiencia.
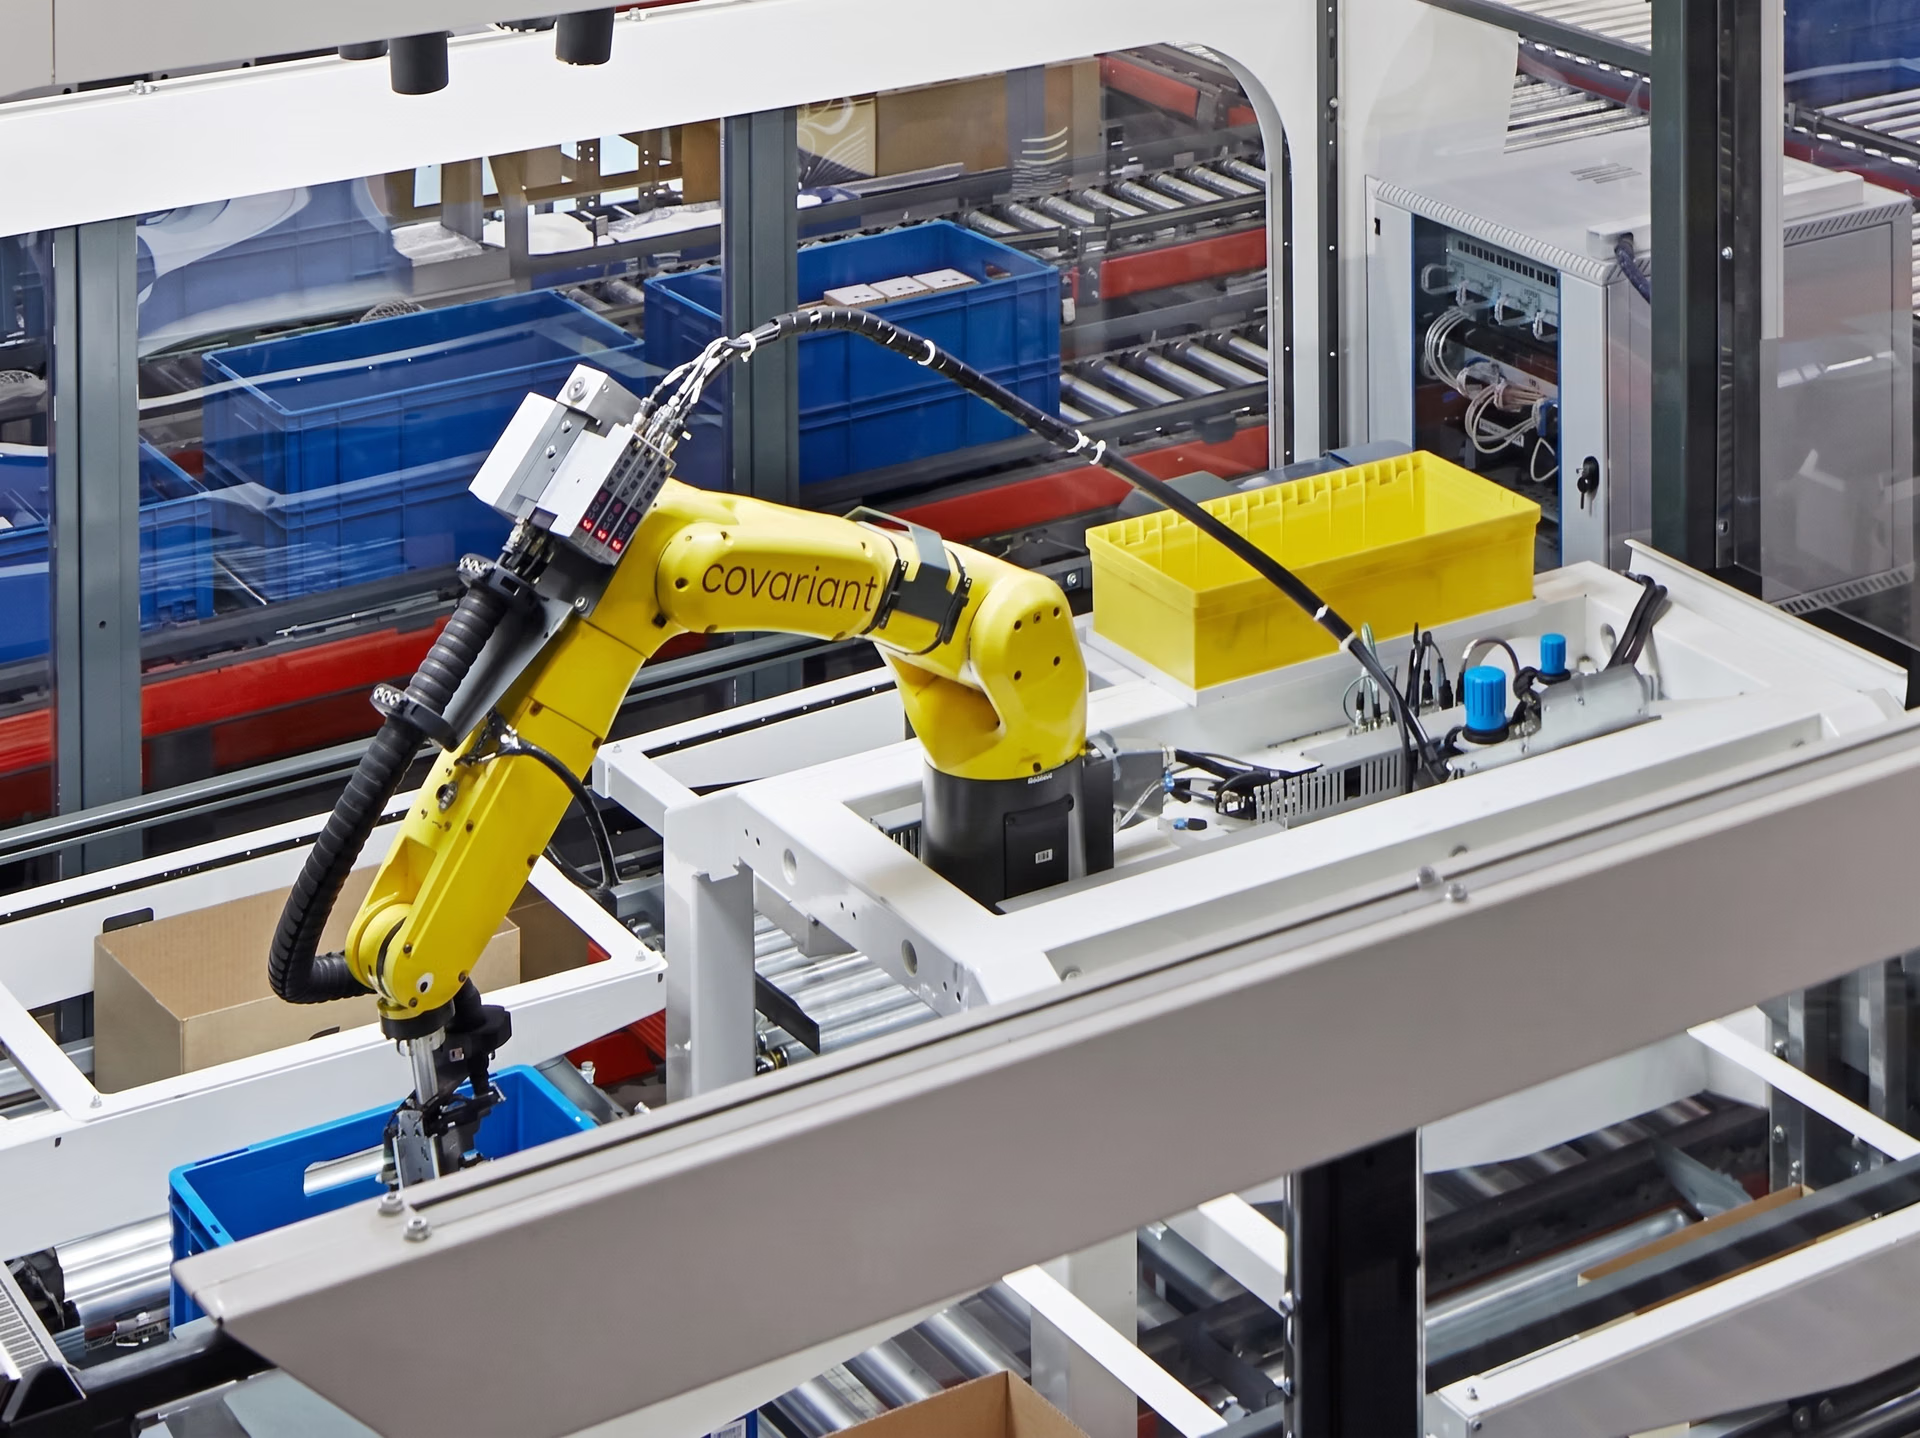
Fig. 3 Un brazo robótico que utiliza IA visual y aprendizaje por refuerzo para recoger objetos.
Aplicaciones del aprendizaje por refuerzo en visión artificial#
Ahora que entendemos mejor qué es el aprendizaje por refuerzo y qué papel desempeña en la visión artificial, veamos algunos ejemplos de cómo se utilizan conjuntamente el aprendizaje por refuerzo y la visión artificial.
Integración de la IA visual y el aprendizaje por refuerzo para crear vehículos más inteligentes#
Los vehículos autónomos pueden recurrir tanto a la IA visual para comprender su entorno como al aprendizaje por refuerzo para tomar decisiones basadas en lo que ven. AWS DeepRacer es un buen ejemplo de esta aplicación.
AWS DeepRacer es un coche de carreras totalmente autónomo a escala 1/18 que aprende a conducir mediante una cámara y el aprendizaje por refuerzo. En lugar de recibir instrucciones, descubre cómo hacerlo por sí mismo: prueba, se equivoca y aprende de sus errores.
La cámara de este pequeño coche funciona como un par de ojos y capta la pista que tiene delante. A partir de lo que ve, el coche aprende a girar y a qué velocidad ir. Mejora con cada vuelta. Por ejemplo, puede aprender a tomar curvas más abiertas o a reducir la velocidad antes de las curvas cerradas a partir de intentos anteriores.
El entrenamiento de DeepRacer empieza en un entorno virtual, donde el modelo practica y perfecciona sus habilidades al volante. Cuando alcanza un determinado nivel de rendimiento, esas habilidades se transfieren a circuitos reales con coches físicos.
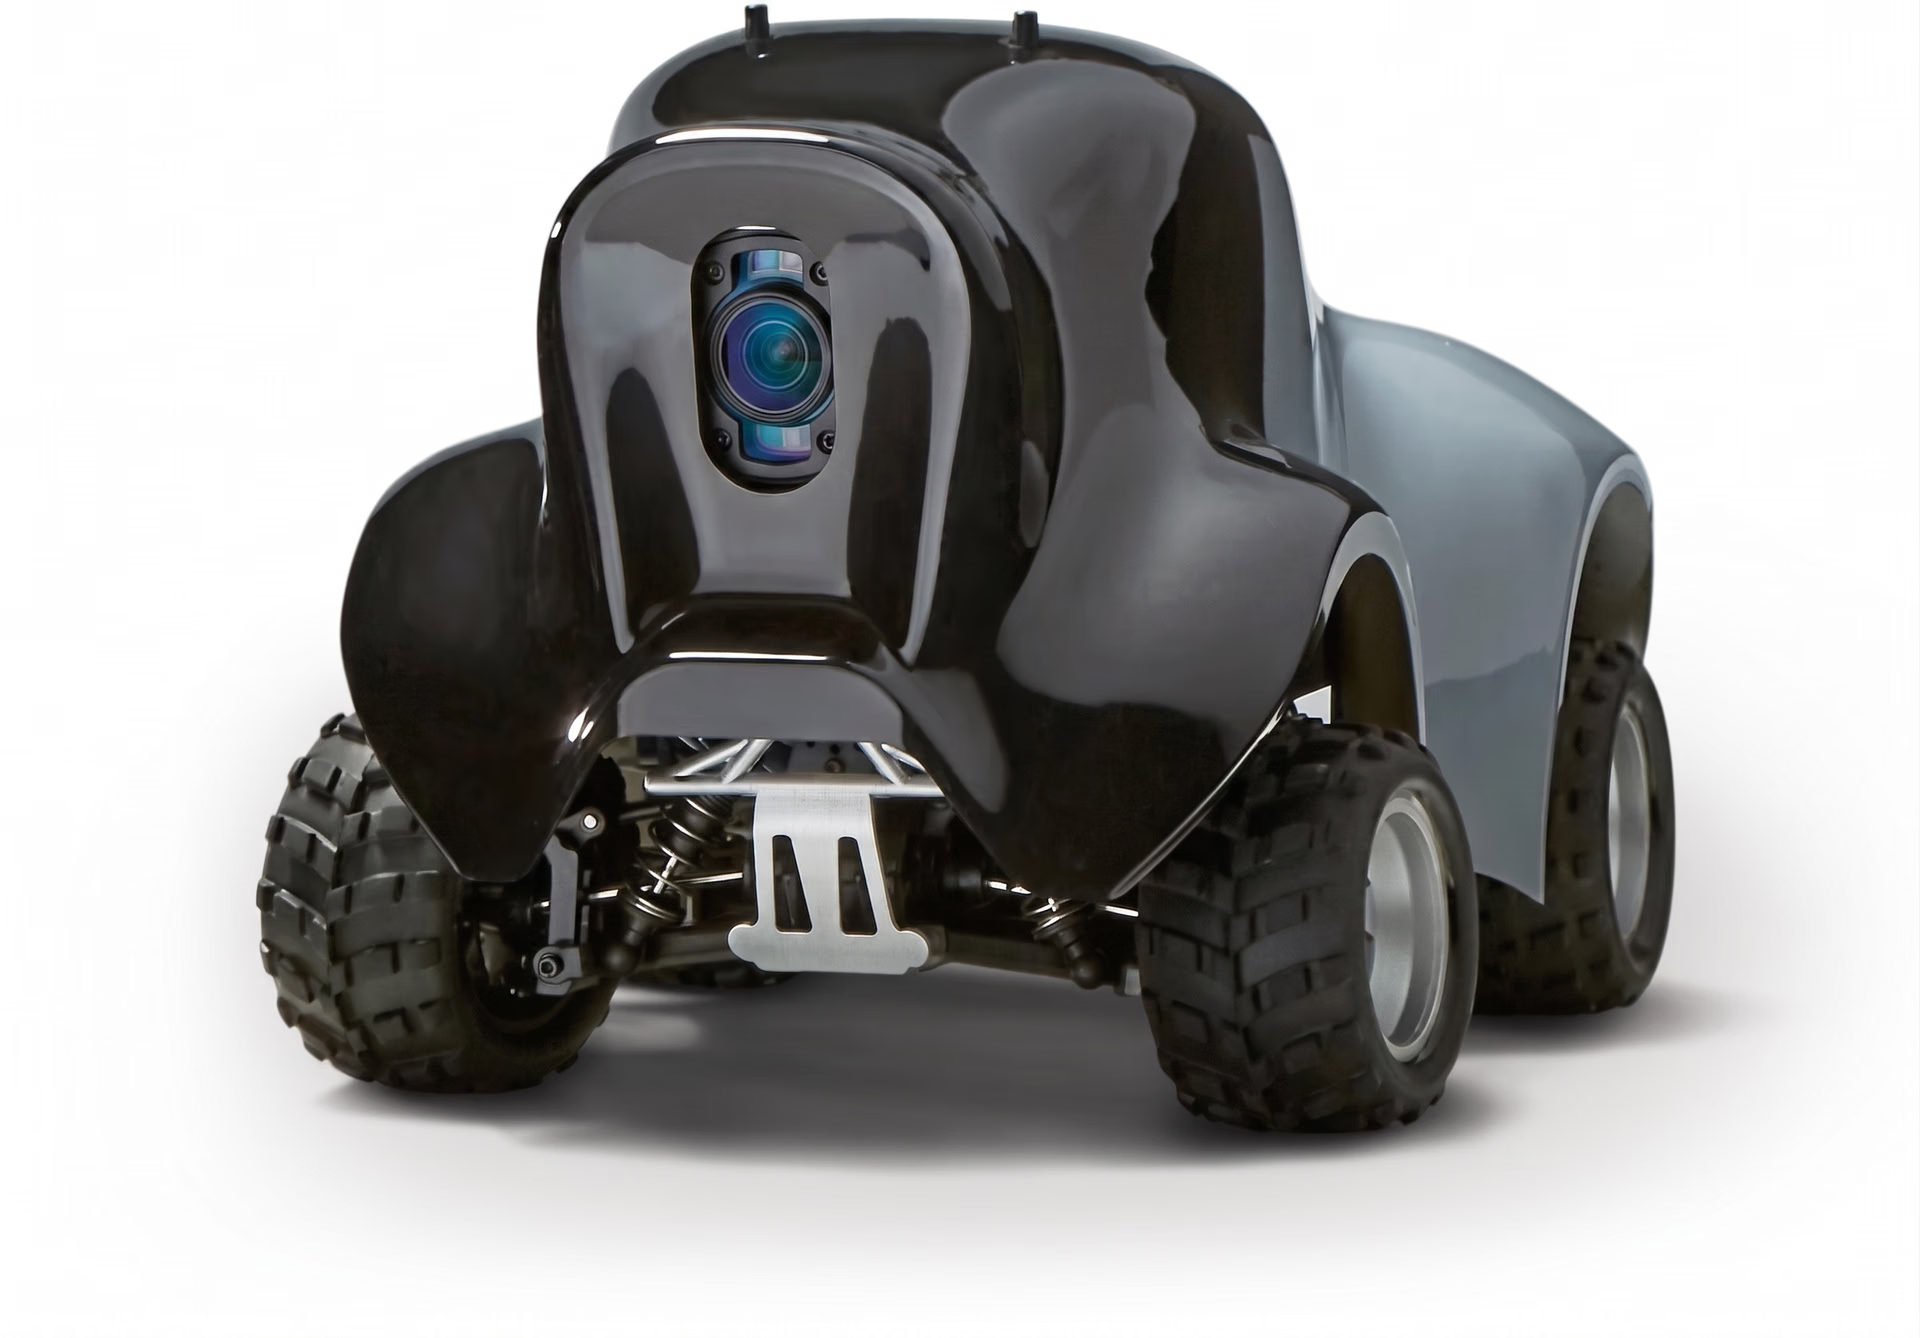
Fig. 4 AWS DeepRacer utiliza visión y aprendizaje por refuerzo para conducir de forma autónoma. Fuente de la imagen: Amazon.
El avance hacia los robots quirúrgicos autónomos#
Un campo de investigación emergente que está ganando interés es la integración de la IA visual y el aprendizaje por refuerzo en la cirugía robótica. Por ahora, esta aplicación sigue siendo en gran medida teórica. Los investigadores están realizando simulaciones en entornos virtuales.
Sin embargo, los primeros experimentos están dando resultados prometedores y sugieren que, con el tiempo, los robots quirúrgicos podrían realizar procedimientos complejos y delicados con mayor precisión y adaptabilidad, y con una intervención humana mínima.
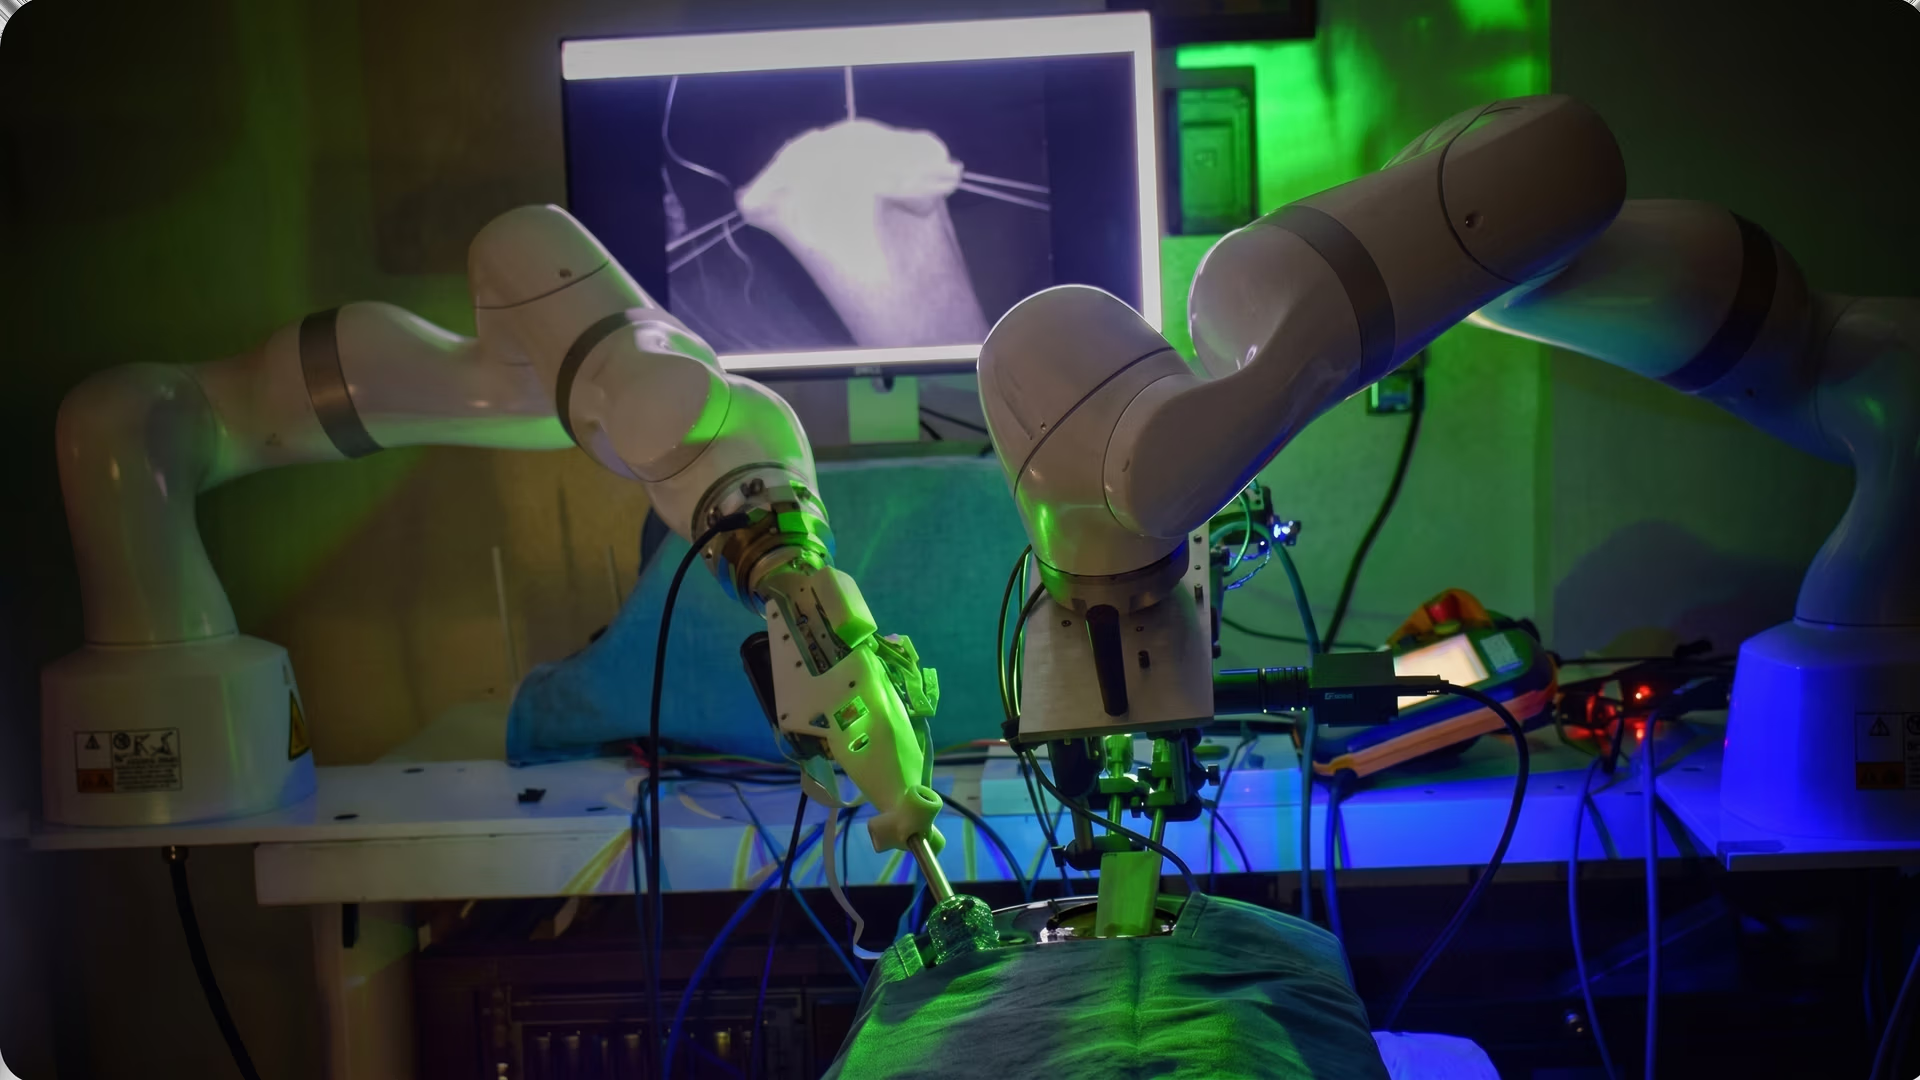
Fig. 5 Los robots quirúrgicos son cada vez más avanzados.
Por ejemplo, imagina que hay que levantar con cuidado una gasa de una zona quirúrgica. Un robot equipado con IA visual analizaría primero la escena y utilizaría la segmentación para identificar la gasa y los tejidos circundantes.
El aprendizaje por refuerzo ayudaría entonces al robot quirúrgico a decidir cómo abordar la tarea, determinando el mejor ángulo para sujetar la gasa, cuánta presión aplicar y cómo levantarla sin alterar las zonas sensibles cercanas. Con el tiempo y mediante la práctica repetida en entornos simulados, el robot podría aprender a realizar estos movimientos sutiles y cruciales con cada vez más destreza y confianza.
Ventajas e inconvenientes del aprendizaje por refuerzo en IA visual#
El aprendizaje por refuerzo permite que los sistemas de IA visual vayan más allá del simple reconocimiento y empiecen a tomar decisiones basadas en lo que ven. Esto abre nuevas posibilidades en ámbitos como la robótica, la automatización y la interacción en tiempo real.
Estas son algunas de las principales ventajas de integrar el aprendizaje por refuerzo en los flujos de trabajo de IA visual:
- Menor dependencia de datos etiquetados: Estos sistemas pueden aprender mediante la interacción, por lo que no necesitan grandes conjuntos de datos etiquetados para empezar.
- Gestión más eficaz de la incertidumbre: El aprendizaje por refuerzo puede gestionar información visual incompleta o ruidosa ajustando las acciones según la información recibida, en lugar de depender únicamente de datos perfectos.
- Favorece el aprendizaje a largo plazo: Ayuda a los modelos a mejorar con el tiempo mediante el aprendizaje a partir de secuencias de acciones, no solo de decisiones aisladas.
Por otro lado, estas son algunas de las limitaciones del aprendizaje por refuerzo que debes tener en cuenta:
- Problema de asignación de crédito: Al agente le puede resultar difícil determinar qué acciones concretas han contribuido al resultado final, sobre todo en secuencias largas de decisiones.
- Riesgo de exploración insegura: Durante el entrenamiento, el agente puede probar acciones inseguras o indeseables que no serían aceptables en aplicaciones reales, como la asistencia sanitaria o la conducción autónoma.
- Convergencia lenta: El modelo puede tardar mucho en alcanzar un buen rendimiento, especialmente en tareas complejas.
Conclusiones clave#
Los proyectos de visión artificial que utilizan aprendizaje por refuerzo permiten que los sistemas de IA comprendan su entorno y aprendan a actuar a partir de la experiencia. Con modelos como Ultralytics YOLO11 para la detección de objetos en tiempo real, el sistema puede tomar decisiones fundamentadas en lo que ve.
Este método va más allá de los enfoques tradicionales, ya que permite que la IA mejore mediante pruebas y comentarios, en lugar de depender únicamente de datos etiquetados. Favorece el aprendizaje continuo y ayuda a crear sistemas de IA visual más flexibles, adaptables e inteligentes que mejoran con el tiempo.
Únete a nuestra creciente comunidad. Visita nuestro repositorio de GitHub para profundizar en la IA. ¿Quieres empezar tus propios proyectos de visión artificial? Explora nuestras opciones de licencia. Descubre más sobre la IA en la fabricación y la IA visual en el sector automovilístico en nuestras páginas de soluciones.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









