Accelerare Ultralytics YOLO26 con OpenVINO su Intel Core Ultra Series 3 (Panther Lake)
Scopri come esportare i modelli Ultralytics YOLO26 in formato OpenVINO e accelerare l'inferenza sull'hardware Intel, inclusi CPU, GPU e NPU.
Negli ultimi anni, l’AI e la computer vision sono passate dalla fase sperimentale a diventare una componente essenziale delle attività aziendali quotidiane. Infatti, le indagini mostrano che circa l’88% delle organizzazioni utilizza già l’AI in almeno un’area della propria attività.
Tuttavia, trasformare questa adozione in valore concreto, nei sistemi di produzione o nei progetti personali, spesso dipende da quanto bene funzionano davvero i modelli una volta distribuiti. In molti scenari reali, i modelli di computer vision come Ultralytics YOLO26 vengono distribuiti su dispositivi edge e su diversi tipi di hardware, spesso CPU, GPU integrate o NPU, anziché su GPU di fascia alta.
È qui che le prestazioni possono iniziare a variare e l’ottimizzazione diventa fondamentale. Un modello che funziona bene in un ambiente può avere difficoltà in un altro se non è ottimizzato correttamente per l’hardware sottostante.
Per semplificare il processo, il pacchetto Python Ultralytics supporta l’esportazione dei modelli YOLO26 in formati ottimizzati come OpenVINO, così possono funzionare senza problemi sull’hardware Intel senza richiedere modifiche al tuo workflow.
Per esempio, esportando un modello Ultralytics YOLO26 in formato OpenVINO, è possibile eseguirlo in modo più efficiente sui processori Intel Core Ultra Series 3, con velocità di inferenza su GPU fino a tre volte superiori.
In questo articolo vedremo come l’integrazione aggiornata tra Ultralytics e OpenVINO semplifica il deployment dei modelli YOLO26 sull’hardware Intel Core Ultra Series 3. Iniziamo!
Panoramica dell’integrazione tra Ultralytics e OpenVINO#
Il pacchetto Python Ultralytics offre un’unica interfaccia per addestrare, eseguire inferenze e distribuire modelli Ultralytics YOLO come YOLO26. Supporta diverse integrazioni utili nelle varie fasi del workflow di AI per la visione, dall’addestramento e dalla sperimentazione al deployment e all’ottimizzazione.
Una delle integrazioni pensate per il deployment è quella con il toolkit OpenVINO, che ti permette di esportare i modelli Ultralytics YOLO26 in un formato ottimizzato per l’hardware Intel. Questo processo converte i modelli YOLO in un formato che funziona in modo più efficiente su CPU, GPU e NPU Intel, inclusi i sistemi basati sui processori Intel® Core™ Ultra™.
In questo modo è più semplice eseguire i modelli su diversi dispositivi Intel senza doverli modificare manualmente per ogni configurazione. Che tu lavori su una macchina locale, un dispositivo edge o un deployment più ampio, puoi riutilizzare lo stesso modello esportato.
Questa integrazione è particolarmente pratica perché si inserisce in modo naturale nel workflow Ultralytics esistente. Puoi esportare un modello usando la stessa interfaccia che utilizzi per l’addestramento e l’inferenza, senza strumenti aggiuntivi né configurazioni complesse.
Una volta esportato, puoi usare il modello per l’inferenza tramite il pacchetto Python Ultralytics oppure OpenVINO Runtime, a seconda del livello di controllo e flessibilità di cui hai bisogno.
Uno sguardo più approfondito a OpenVINO e all’hardware Intel Panther Lake per l’inferenza AI#
Prima di vedere quanto efficientemente può funzionare un modello Ultralytics YOLO26 esportato sull’hardware Intel, facciamo un passo indietro per capire come collaborano OpenVINO e l’hardware Intel per rendere efficiente l’inferenza.
OpenVINO è un toolkit open source progettato per ottimizzare ed eseguire inferenze AI sull’hardware Intel, comprese CPU, GPU integrate e NPU. Offre un runtime unificato, così lo stesso modello può funzionare su queste diverse unità di calcolo senza dover essere riscritto.
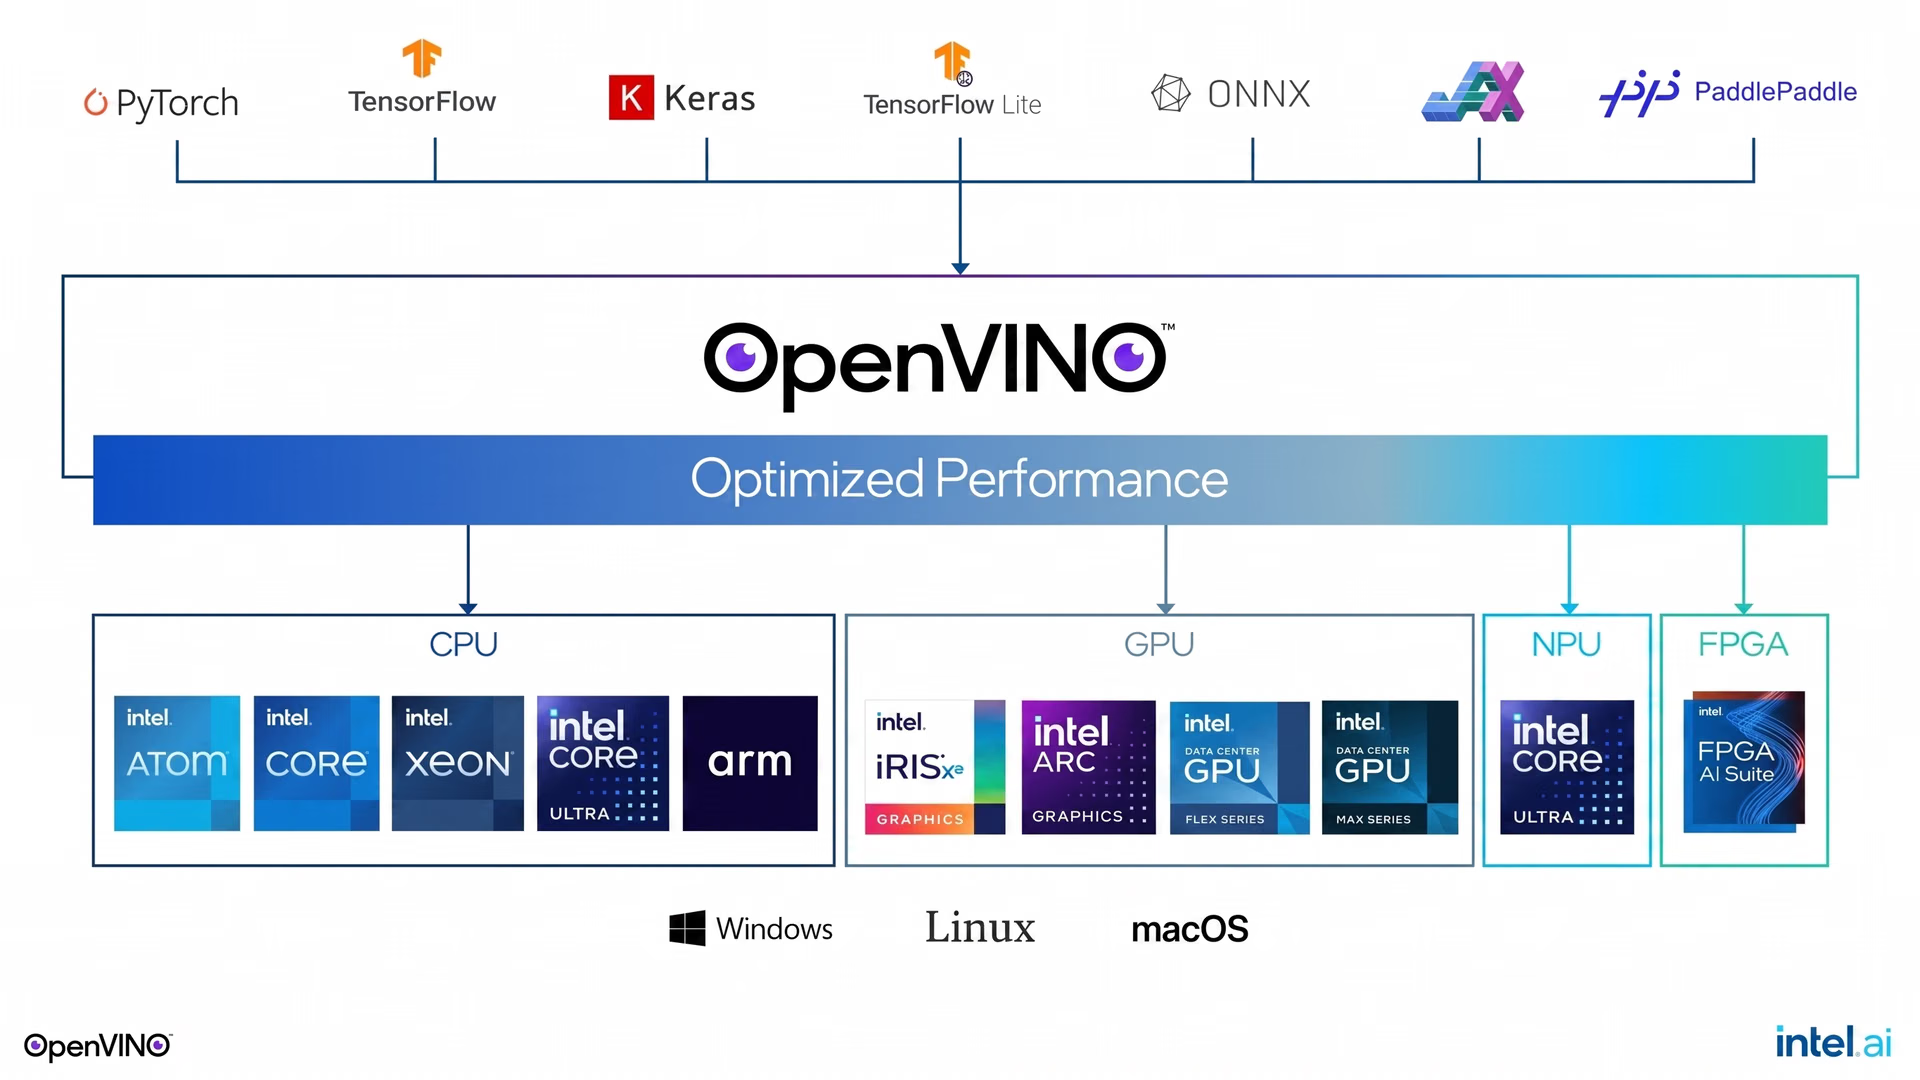
Fig. 1. OpenVINO semplifica il deployment dei modelli su più piattaforme hardware. (Fonte)
Sui nuovi processori Intel® Core™ Ultra™ Series 3 (nome in codice Panther Lake), i carichi di lavoro AI vengono eseguiti su più unità di calcolo all’interno dello stesso processore. Ogni chip combina core CPU per le attività generiche, una GPU integrata per l’elaborazione parallela e una NPU dedicata, progettata appositamente per l’inferenza AI.
OpenVINO offre un’API unificata che ti permette di usare una qualsiasi di queste unità di calcolo, CPU, GPU o NPU, senza modificare il codice. Ti basta specificare su quale dispositivo eseguire l’inferenza al runtime, così puoi passare facilmente da un’unità all’altra in base alle tue esigenze di prestazioni ed efficienza.
Benchmark di Ultralytics YOLO26 sulla serie Intel® Core™ Ultra™#
Mentre esplori l’integrazione tra Ultralytics e OpenVINO, potresti chiederti quali miglioramenti delle prestazioni del modello puoi aspettarti esportando YOLO26 in formato OpenVINO.
La differenza nella velocità di inferenza è evidente quando si confrontano i modelli YOLO26 in formati e livelli di precisione diversi. Per esempio, eseguendo la variante nano di YOLO26 (YOLO26n) su un Intel Core Ultra X7 358H, un processore Panther Lake, il tempo di inferenza scende da 25,18 ms per immagine con PyTorch a precisione FP32 a 2,64 ms con OpenVINO alla stessa precisione, usando la NPU integrata.
È più veloce del riferimento originale PyTorch FP32 e può fare una differenza notevole nelle applicazioni in tempo reale e edge, dove la latenza è fondamentale. Questi miglioramenti diventano ancora più evidenti eseguendo lo stesso modello sulla GPU Intel Arc integrata.
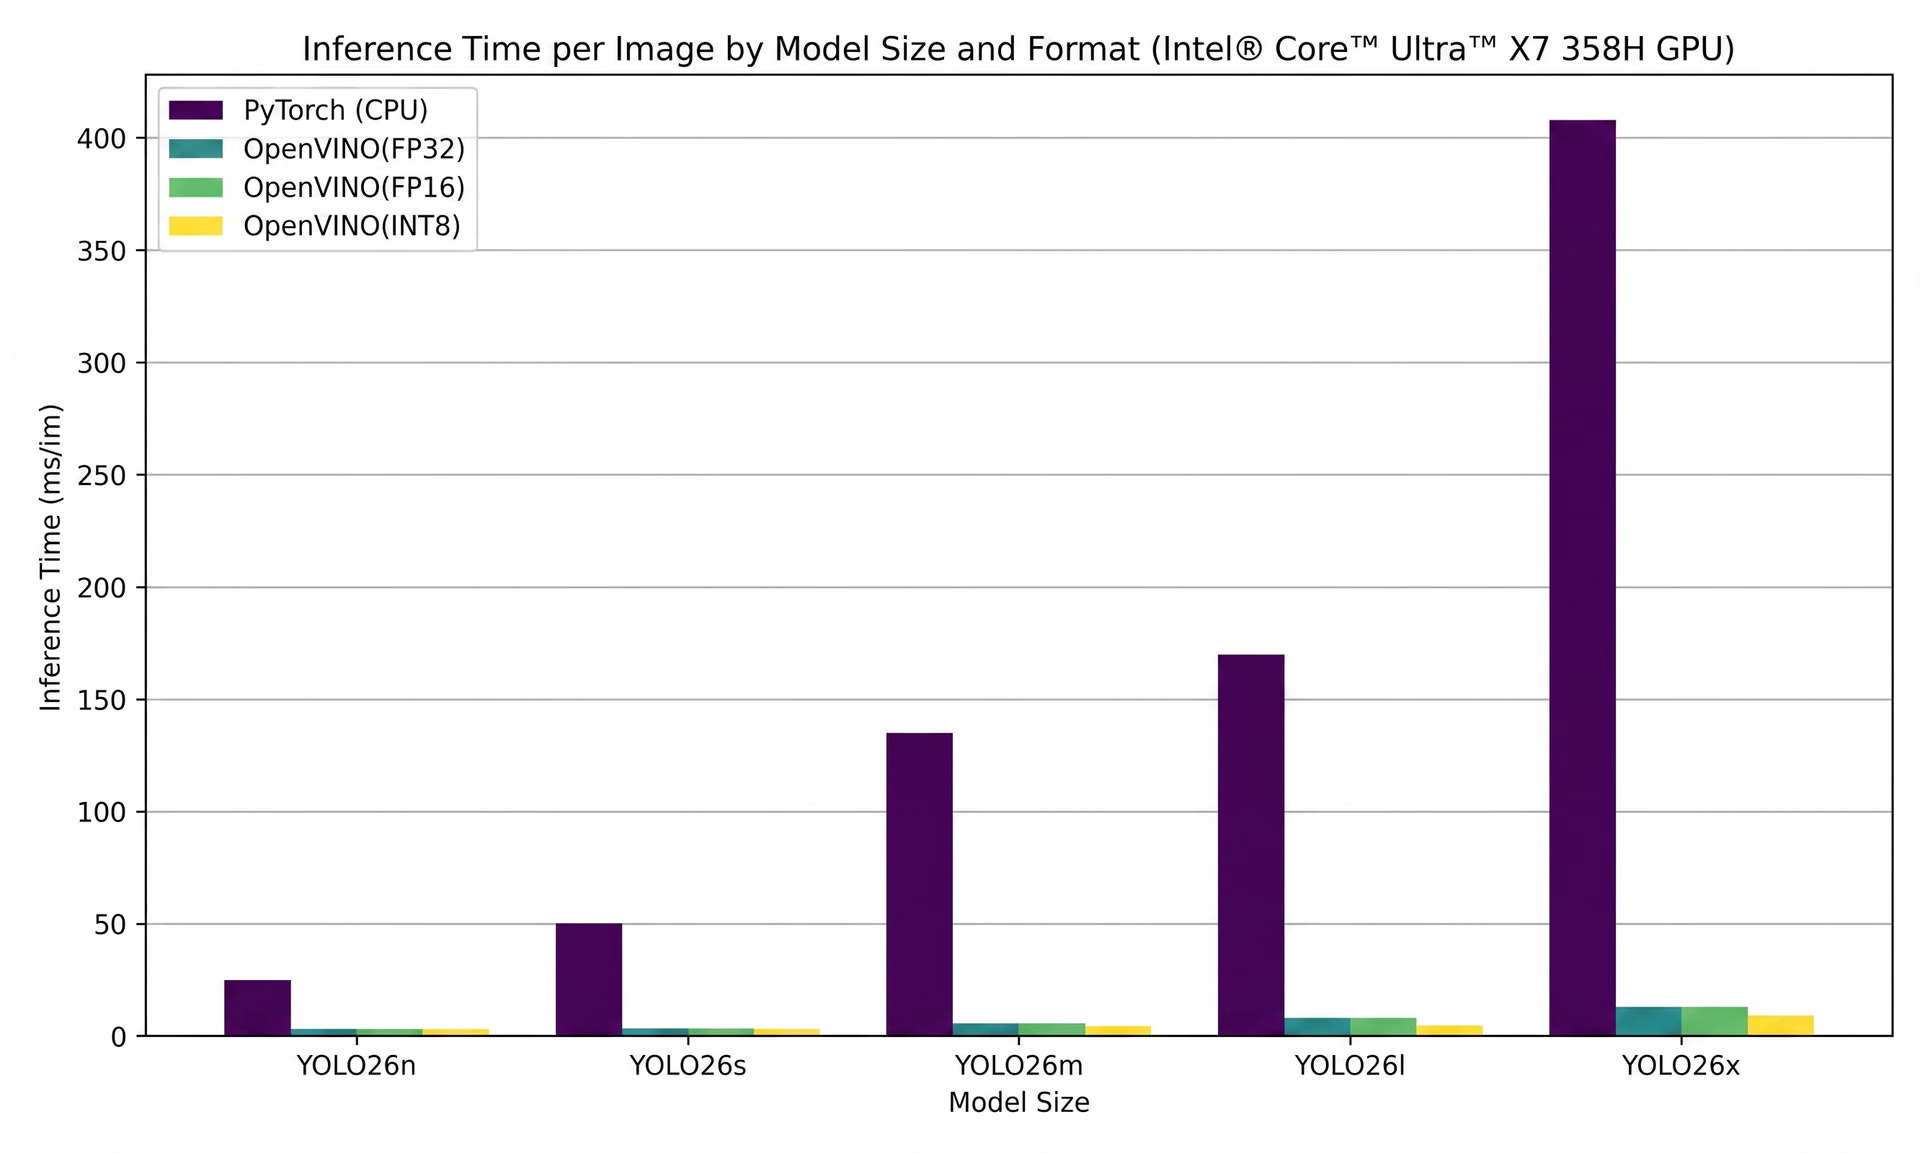
Fig. 2. Benchmark dell’inferenza di Ultralytics YOLO26 sulla GPU Intel Panther Lake con OpenVINO (Fonte)
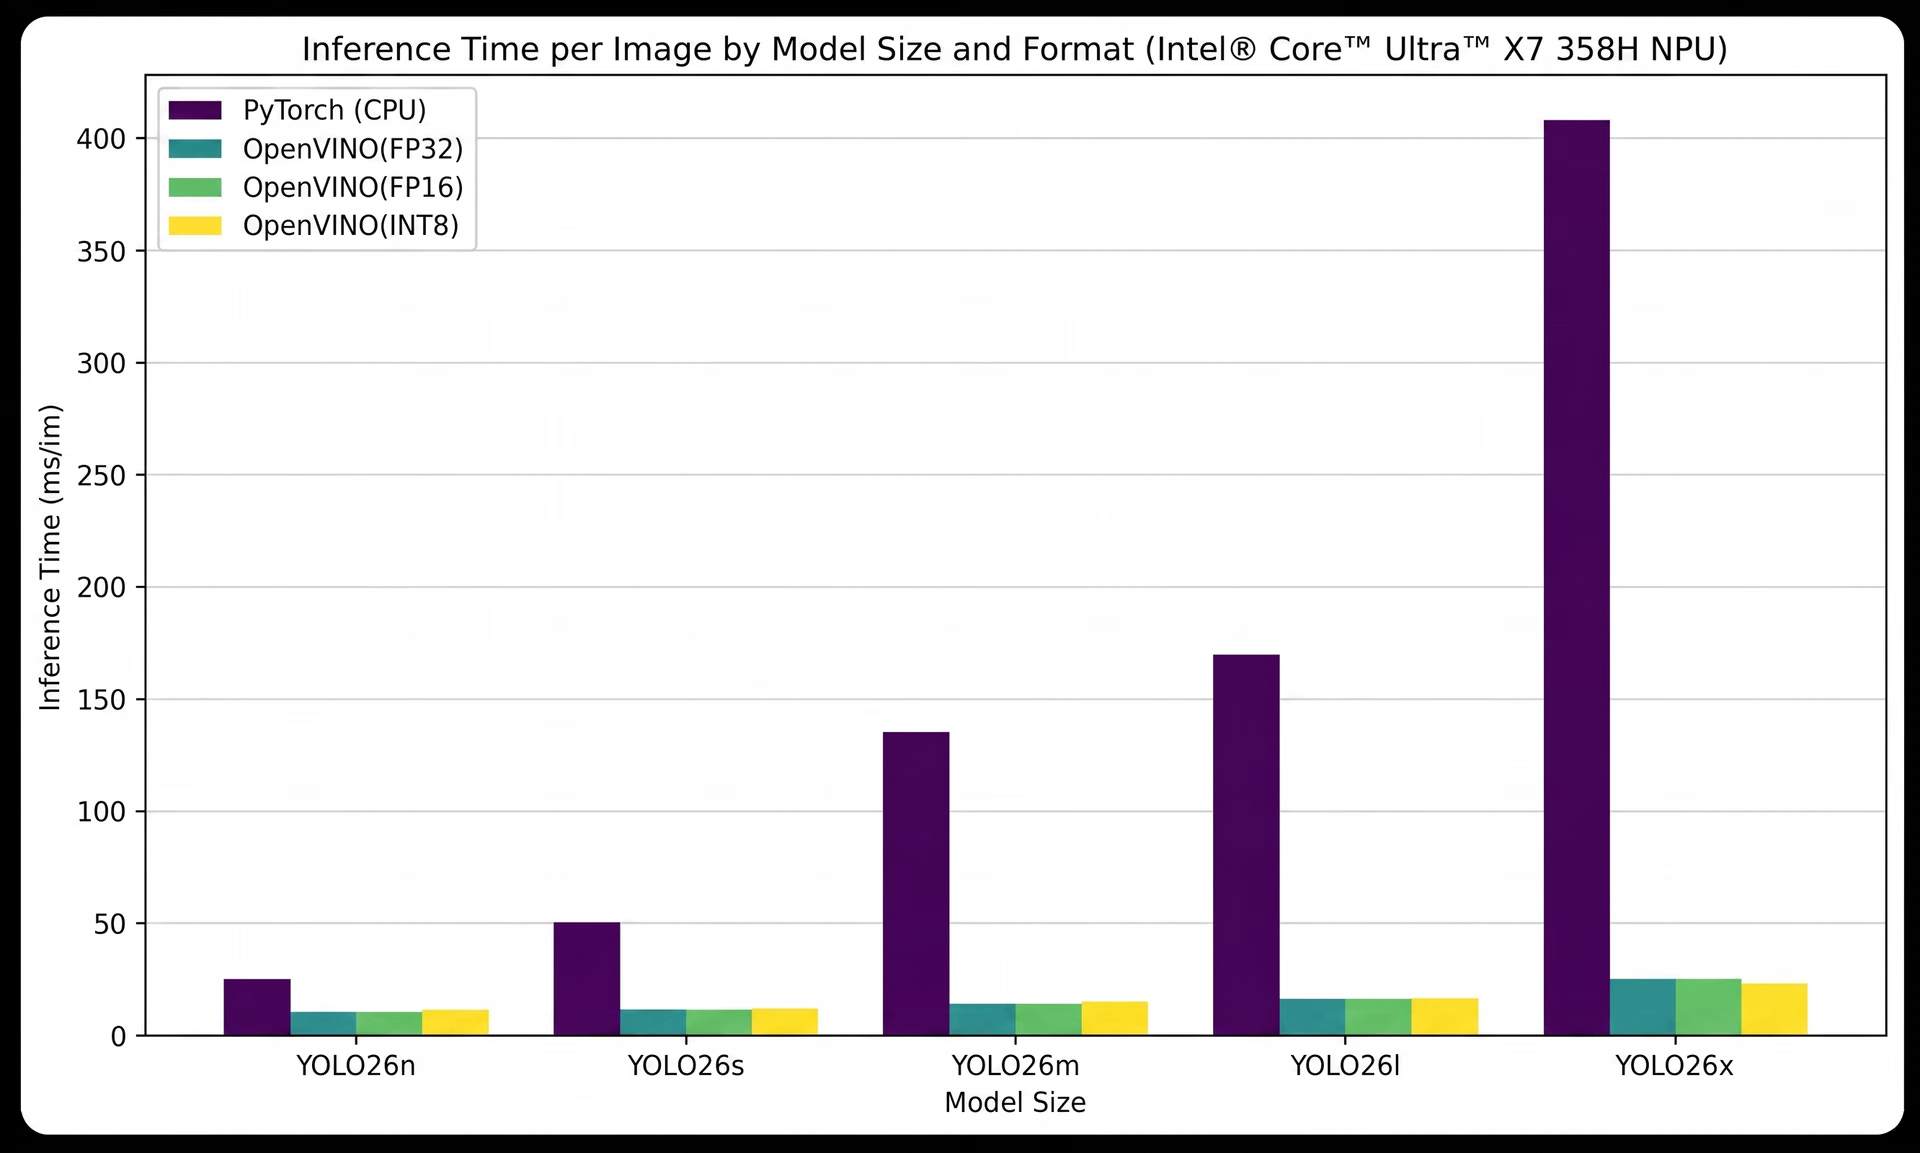
Fig. 3. Benchmark dell’inferenza di Ultralytics YOLO26 sulla NPU Intel Panther Lake con OpenVINO (Fonte)
Due modi per esportare Ultralytics YOLO26 in formato OpenVINO#
Esistono due modi principali per esportare i modelli YOLO26 in formato OpenVINO. Puoi usare il pacchetto Python Ultralytics oppure esportare direttamente tramite Ultralytics Platform, un workspace end-to-end per creare e gestire workflow di computer vision da un unico ambiente. Vediamo entrambi gli approcci.
Esportare YOLO26 con il pacchetto Python Ultralytics#
Il pacchetto Python Ultralytics offre un metodo semplice per esportare i modelli YOLO26 in formato OpenVINO all’interno di un workflow basato sul codice. Poiché l’interfaccia è la stessa usata per l’addestramento e l’inferenza, l’esportazione si integra naturalmente nelle pipeline esistenti, senza richiedere strumenti aggiuntivi.
Per iniziare, puoi installare il pacchetto Ultralytics. Ti basta eseguire il comando “pip install ultralytics” in un terminale o prompt dei comandi. Se lavori in un ambiente interattivo come Jupyter Notebook o Google Colab, puoi eseguire lo stesso comando anteponendo un punto esclamativo.
Una volta installato il pacchetto, puoi caricare un modello YOLO26 addestrato ed esportarlo direttamente in formato OpenVINO. Come mostrato di seguito, viene caricato un modello YOLO26n preaddestrato (yolo26n.pt), poi convertito nel formato OpenVINO usando il metodo export.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
Al termine dell’esecuzione del codice, il modello convertito viene salvato in una nuova directory, dove può essere usato per il deployment.
Esportare YOLO26 su Ultralytics Platform#
Se cerchi un approccio più semplice e senza codice, puoi esportare i modelli YOLO26 direttamente tramite Ultralytics Platform. La piattaforma riunisce l’intero workflow di computer vision in un unico workspace, semplificando il passaggio dall’addestramento al deployment senza configurazioni aggiuntive.
Quando il modello è pronto, puoi aprirlo sulla piattaforma e andare alla scheda Export. Da lì puoi selezionare OpenVINO come formato di esportazione e, se vuoi, modificare impostazioni come le dimensioni dell’immagine o la precisione.
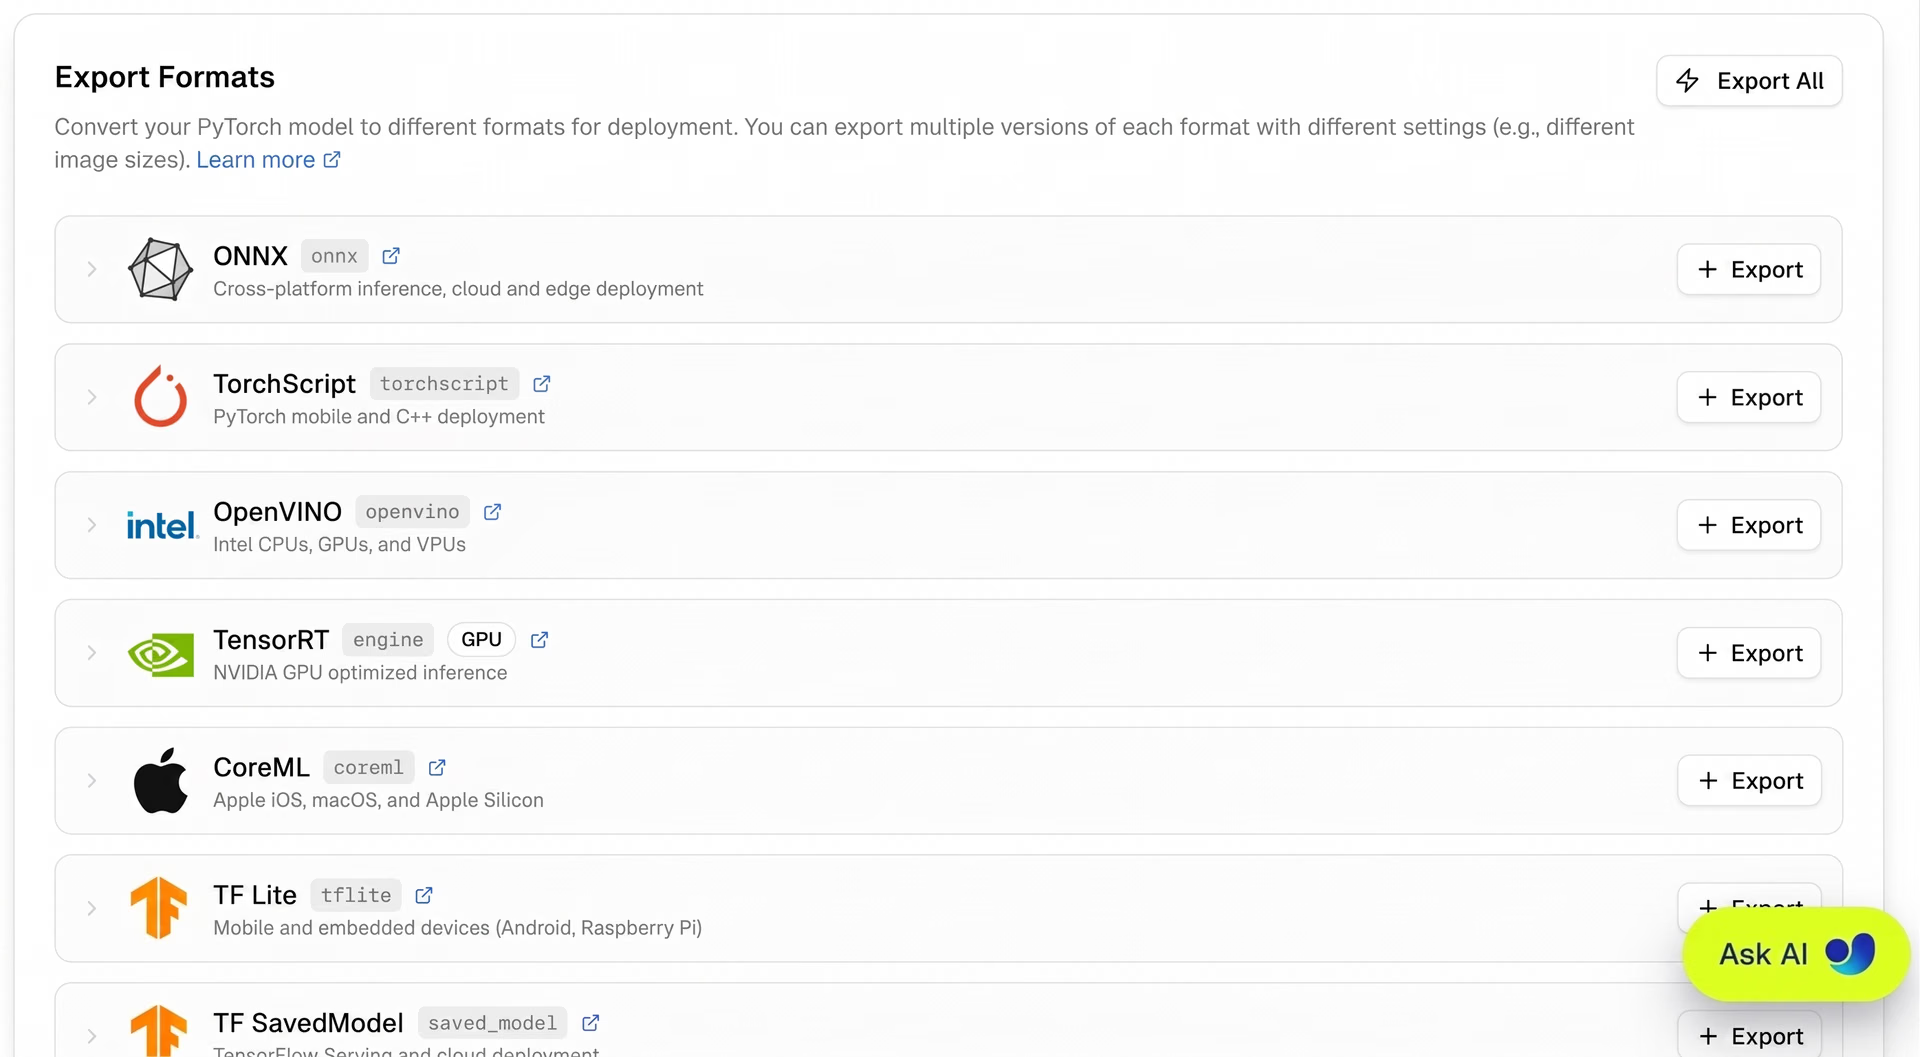
Fig. 4. Esportazione di YOLO26 su Ultralytics Platform
La piattaforma gestisce automaticamente la conversione, quindi non devi occuparti di script, dipendenze o configurazione dell’ambiente. Una volta completata l’esportazione, puoi scaricare il modello ottimizzato e usarlo per il deployment su CPU, GPU e NPU Intel.
Opzioni di deployment abilitate dall’integrazione tra Ultralytics e OpenVINO#
Dopo aver esportato un modello YOLO26 in formato OpenVINO, puoi eseguire inferenze in due modi, a seconda del workflow e del livello di controllo necessario. Puoi usare il pacchetto Python Ultralytics per un approccio più semplice e integrato oppure il runtime nativo OpenVINO per maggiore flessibilità e controllo.
Eseguire inferenze con il pacchetto Python Ultralytics#
Dopo aver esportato il modello in formato OpenVINO, puoi eseguire inferenze con il pacchetto Python Ultralytics. Questo approccio è ideale per test rapidi e un deployment semplificato, perché usa la stessa interfaccia dell’addestramento e dell’esportazione.
Con questo approccio puoi caricare il modello OpenVINO esportato dalla relativa directory ed eseguire inferenze su un input, come un’immagine o un video. Puoi anche scegliere il dispositivo su cui eseguire il modello specificando opzioni come "intel:cpu", "intel:gpu" o "intel:npu", in base all’hardware disponibile nel tuo sistema.
Il frammento di codice qui sotto mostra come caricare il modello esportato ed eseguire l’inferenza su un’immagine usando la GPU. Al termine dell’inferenza, l’immagine di output viene salvata nella directory “runs/detect/predict”.
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
Usare il pacchetto OpenVINO nativo per l’inferenza#
Se hai bisogno di un controllo maggiore sull’esecuzione del modello in produzione, puoi usare il runtime OpenVINO nativo per l’inferenza. Questo metodo è utile quando integri i modelli in applicazioni più ampie o vuoi ottimizzare l’esecuzione dell’inferenza su hardware specifico.
OpenVINO offre un metodo unificato per eseguire modelli su CPU, GPU e NPU Intel, oltre a funzionalità come l’esecuzione asincrona e l’uso efficiente delle risorse di calcolo disponibili. Per configurarlo, puoi lavorare direttamente con i file del modello esportato, incluso il file .xml che definisce la struttura del modello e il file .bin che contiene i pesi addestrati.
A seconda del tuo caso d’uso, puoi anche modificare impostazioni come le dimensioni dell’input o le fasi di preelaborazione. Per configurare l’inferenza, inizializza il runtime OpenVINO, carica e compila il modello per un dispositivo di destinazione, prepara i dati di input e infine esegui l’inferenza.
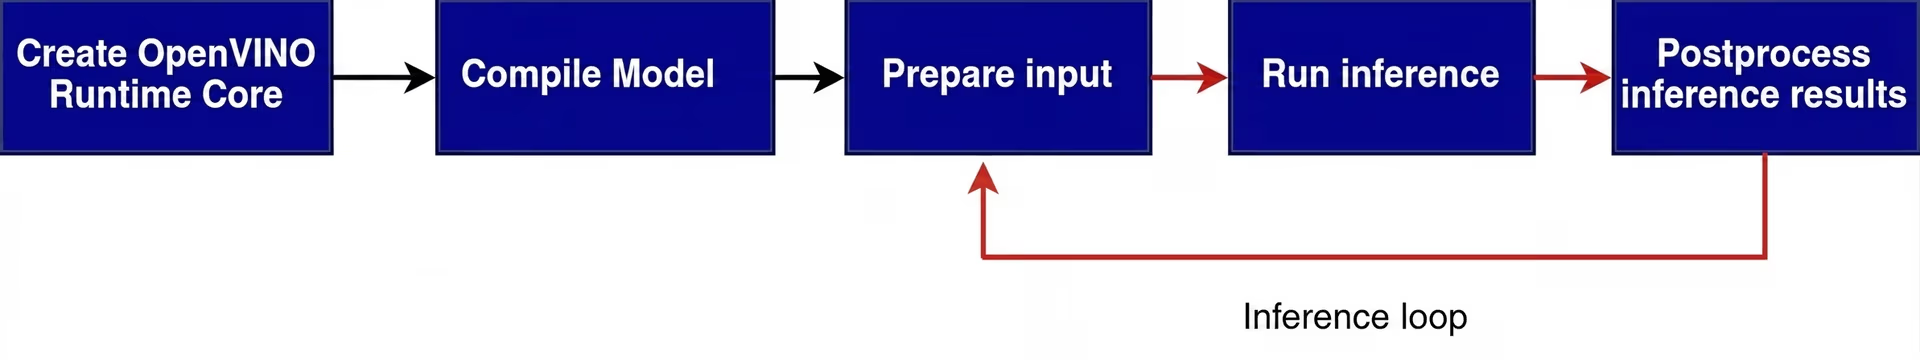
Fig. 5. Esempio di una tipica pipeline di inferenza con OpenVINO (Fonte)
Questo ti permette di controllare l’esecuzione del modello e il modo in cui si integra nel deployment complessivo. Per saperne di più sulla configurazione e l’esecuzione dell’inferenza con il runtime OpenVINO, consulta la documentazione ufficiale di Ultralytics.
Applicazioni nel mondo reale di Ultralytics YOLO26 su hardware Intel#
Il valore concreto dell’integrazione tra Ultralytics e OpenVINO emerge in produzione, dove un’inferenza affidabile e a bassa latenza può fare una differenza tangibile. Ecco alcuni settori chiave in cui questa integrazione porta risultati significativi:
-
Produzione: esportando Ultralytics YOLO26 in OpenVINO, i sistemi delle linee di produzione possono rilevare automaticamente difetti visivi come componenti mancanti, disallineamenti o danni superficiali sull’hardware Intel, contribuendo a migliorare la qualità dei prodotti e a ridurre gli errori costosi.
-
Sanità: i sistemi di diagnostica per immagini e monitoraggio dei pazienti possono eseguire localmente modelli Ultralytics YOLO26 esportati sull’hardware Intel, rispettando i rigorosi requisiti di privacy dei dati e mantenendo prestazioni di inferenza affidabili.
-
Città intelligenti: il monitoraggio del traffico e l’analisi della folla possono essere realizzati usando modelli Ultralytics YOLO26 esportati su telecamere edge basate su Intel, per ottenere informazioni in tempo reale come il conteggio dei veicoli, il tracciamento dei pedoni e il rilevamento degli incidenti.
-
Settore automobilistico: la bassa latenza e l’efficienza energetica sono fondamentali per il monitoraggio del conducente e il rilevamento all’interno dell’abitacolo. Per questo, l’hardware Intel abbinato ai modelli Ultralytics YOLO26 esportati è una soluzione ideale per i sistemi automobilistici embedded.
Per saperne di più su questa integrazione, partecipa alla serie di workshop OpenVINO DevCon di Intel, “Dall’annotazione al deployment: creare una pipeline di rilevamento degli oggetti con Geti, Ultralytics YOLO26 e OpenVINO™”. Il nostro responsabile delle partnership e dell’ecosistema, Francesco Mattioli, affiancherà l’AI Software Evangelist di Intel, Adrian Boguszewski, per una dimostrazione dal vivo e una guida alla creazione di pipeline di computer vision pronte per la produzione e destinate a scenari industriali reali. Il workshop presenterà un workflow completo end-to-end per il rilevamento degli oggetti, dalla creazione del dataset e dall’addestramento del modello fino all’ottimizzazione e al deployment edge.
Vantaggi del formato di esportazione OpenVINO#
Ecco alcuni dei principali vantaggi del formato di esportazione OpenVINO:
-
Accessibile e facile da integrare: con un’API unificata e oltre 80 notebook didattici, OpenVINO semplifica il passaggio dalla sperimentazione al deployment, senza aggiungere complessità significative.
-
Esegui lo stesso modello su hardware diverso: OpenVINO ti permette di usare un unico modello esportato su hardware Intel supportato, distribuendolo su CPU, GPU o NPU senza doverlo riscrivere o adattare per ogni dispositivo.
-
Ottimizzazione integrata durante l’esportazione: l’esportazione in OpenVINO converte i modelli dai framework più diffusi, come PyTorch e TensorFlow, in un formato ottimizzato e pronto per l’inferenza, eliminando la necessità di passaggi di conversione separati.
-
Migliore utilizzo delle risorse hardware: OpenVINO supporta l’inferenza asincrona e il bilanciamento del carico sull’hardware Intel, contribuendo a migliorare l’efficienza nelle applicazioni reali.
Eseguire Ultralytics YOLO26 con ExecuTorch e il backend OpenVINO#
Se distribuisci Ultralytics YOLO26 in ambienti di produzione più impegnativi, hai a disposizione un’altra opzione che combina l’efficienza sul dispositivo con tecniche avanzate di compressione dei modelli.
ExecuTorch, il framework di PyTorch per l’inferenza on-device, supporta un backend OpenVINO che ti permette di distribuire Ultralytics YOLO26 sull’hardware Intel seguendo un percorso alternativo di esportazione e runtime.
ExecuTorch gestisce l’esportazione del modello e l’esecuzione nel runtime, mentre OpenVINO funge da livello sottostante di accelerazione hardware e gestisce i calcoli effettivi su CPU, GPU o NPU Intel. I due strumenti collaborano per offrirti la portabilità e l’efficienza on-device di ExecuTorch, insieme alle ottimizzazioni specifiche per l’hardware fornite da OpenVINO.
Per saperne di più sul funzionamento e su come iniziare a usare Ultralytics YOLO26 con ExecuTorch e il backend OpenVINO, consulta il blog di Intel con gli ultimi aggiornamenti su ExecuTorch e OpenVINO.
Punti chiave#
Esportare i modelli YOLO26 con l’integrazione tra Ultralytics e OpenVINO migliora le prestazioni sull’hardware Intel senza aggiungere complessità al workflow. Puoi passare dall’addestramento al deployment senza rielaborare la pipeline. In generale, è un modo semplice per eseguire i modelli in modo efficiente su CPU, GPU e NPU Intel nelle applicazioni reali.
Unisciti alla nostra community ed esplora il nostro repository GitHub per saperne di più sull’AI per la visione. Dai un’occhiata alle nostre opzioni di licenza per avviare i tuoi progetti di computer vision. Ti interessano innovazioni come l’AI nella produzione o la computer vision nel settore automobilistico? Visita le pagine dedicate alle nostre soluzioni per saperne di più.









