Come scegliere una GPU cloud per l'addestramento di modelli di IA per la visione su Ultralytics Platform
Scopri come scegliere la GPU cloud giusta per addestrare modelli di computer vision su Ultralytics Platform in base a fattori come le dimensioni del dataset, la complessità del modello e i costi.
Il mese scorso abbiamo presentato Ultralytics Platform, un ambiente end-to-end progettato per semplificare l'intero flusso di lavoro della visione artificiale, dalla gestione dei dataset all'addestramento e all'implementazione dei modelli. Ultralytics Platform riunisce in un'unica esperienza tutte le risorse necessarie per creare e scalare modelli di AI visiva.
Una parte fondamentale di questo flusso di lavoro è l'addestramento dei modelli, durante il quale le reti neurali apprendono schemi dai dati per formulare predizioni accurate; l'accesso alle giuste risorse di calcolo è essenziale. In precedenza abbiamo visto come Ultralytics Platform supporti l'addestramento dei modelli nel cloud con unità di elaborazione grafica (GPU), consentendo agli utenti di addestrare modelli di visione artificiale senza gestire un'infrastruttura locale.
Grazie all'accesso on demand a potenti GPU NVIDIA, utenti che vanno da studenti e startup a ricercatori e grandi organizzazioni possono eseguire carichi di lavoro AI in modo più efficiente che mai. Iniziare ad addestrare nel cloud è semplice, ma per scegliere la GPU giusta bisogna considerare fattori come le dimensioni del dataset, la complessità del modello e i costi.
Oggi sono disponibili numerose opzioni, dalle GPU RTX economiche alle NVIDIA H100 ad alte prestazioni e all'hardware Blackwell di nuova generazione; scegliere la configurazione giusta può influire notevolmente sia sullo sviluppo del modello sia sui costi.
In questo articolo vedremo come addestrare modelli di visione artificiale con GPU cloud su Ultralytics Platform e come scegliere l'hardware più adatto al tuo carico di lavoro. Iniziamo!
Panoramica dell'addestramento nel cloud su Ultralytics Platform#
Prima di approfondire come selezionare una GPU per l'addestramento nel cloud su Ultralytics Platform, facciamo un passo indietro e vediamo come funziona l'addestramento nel cloud.
Che cos'è l'addestramento nel cloud con GPU?#
L'addestramento nel cloud con GPU consiste nell'utilizzare GPU ospitate in un ambiente di cloud computing per addestrare modelli di machine learning e deep learning, anziché affidarsi al proprio hardware locale o alla propria workstation. Su Ultralytics Platform, puoi accedere a potenti GPU on demand ed eseguire da remoto i processi di addestramento senza dover configurare un ambiente personale.
Questo semplifica la scalabilità delle risorse in base al carico di lavoro. Puoi scegliere GPU più potenti o aumentare la capacità quando serve, senza essere limitato dalle capacità del tuo sistema. Puoi immaginarlo come l'accesso a potenti macchine, o nodi, nei data center remoti, con la possibilità di aumentare o ridurre le risorse secondo necessità.
Inoltre, non devi configurare e mantenere hardware costoso. Non devi acquistare GPU, installare driver o affrontare problemi di compatibilità.
Ultralytics Platform gestisce tutto tramite servizi cloud gestiti, dal provisioning delle risorse alla configurazione dell'ambiente, all'orchestrazione e all'esecuzione dei processi di addestramento, così puoi concentrarti sull'addestramento, sulla sperimentazione e sul miglioramento dei tuoi modelli.
Come funziona l'addestramento dei modelli su Ultralytics Platform#
Su Ultralytics Platform, il flusso di lavoro di addestramento accelerato con GPU è semplice. Puoi iniziare importando il tuo dataset in diversi modi.
Puoi caricare i tuoi dati, usare i dataset pubblici disponibili sulla piattaforma o clonare dataset condivisi dalla community per partire dal lavoro già svolto. Clonare un dataset ne crea una copia nel tuo spazio di lavoro, che puoi modificare e ampliare lasciando invariato l'originale.
Dopo aver selezionato un dataset, puoi esaminare e organizzare immagini e annotazioni per assicurarti che tutto sia strutturato correttamente. La piattaforma include anche strumenti di annotazione integrati che ti consentono di etichettare i dati per attività come il rilevamento di oggetti, la segmentazione e la classificazione, oppure di accelerare il processo con funzionalità assistite dall'AI.
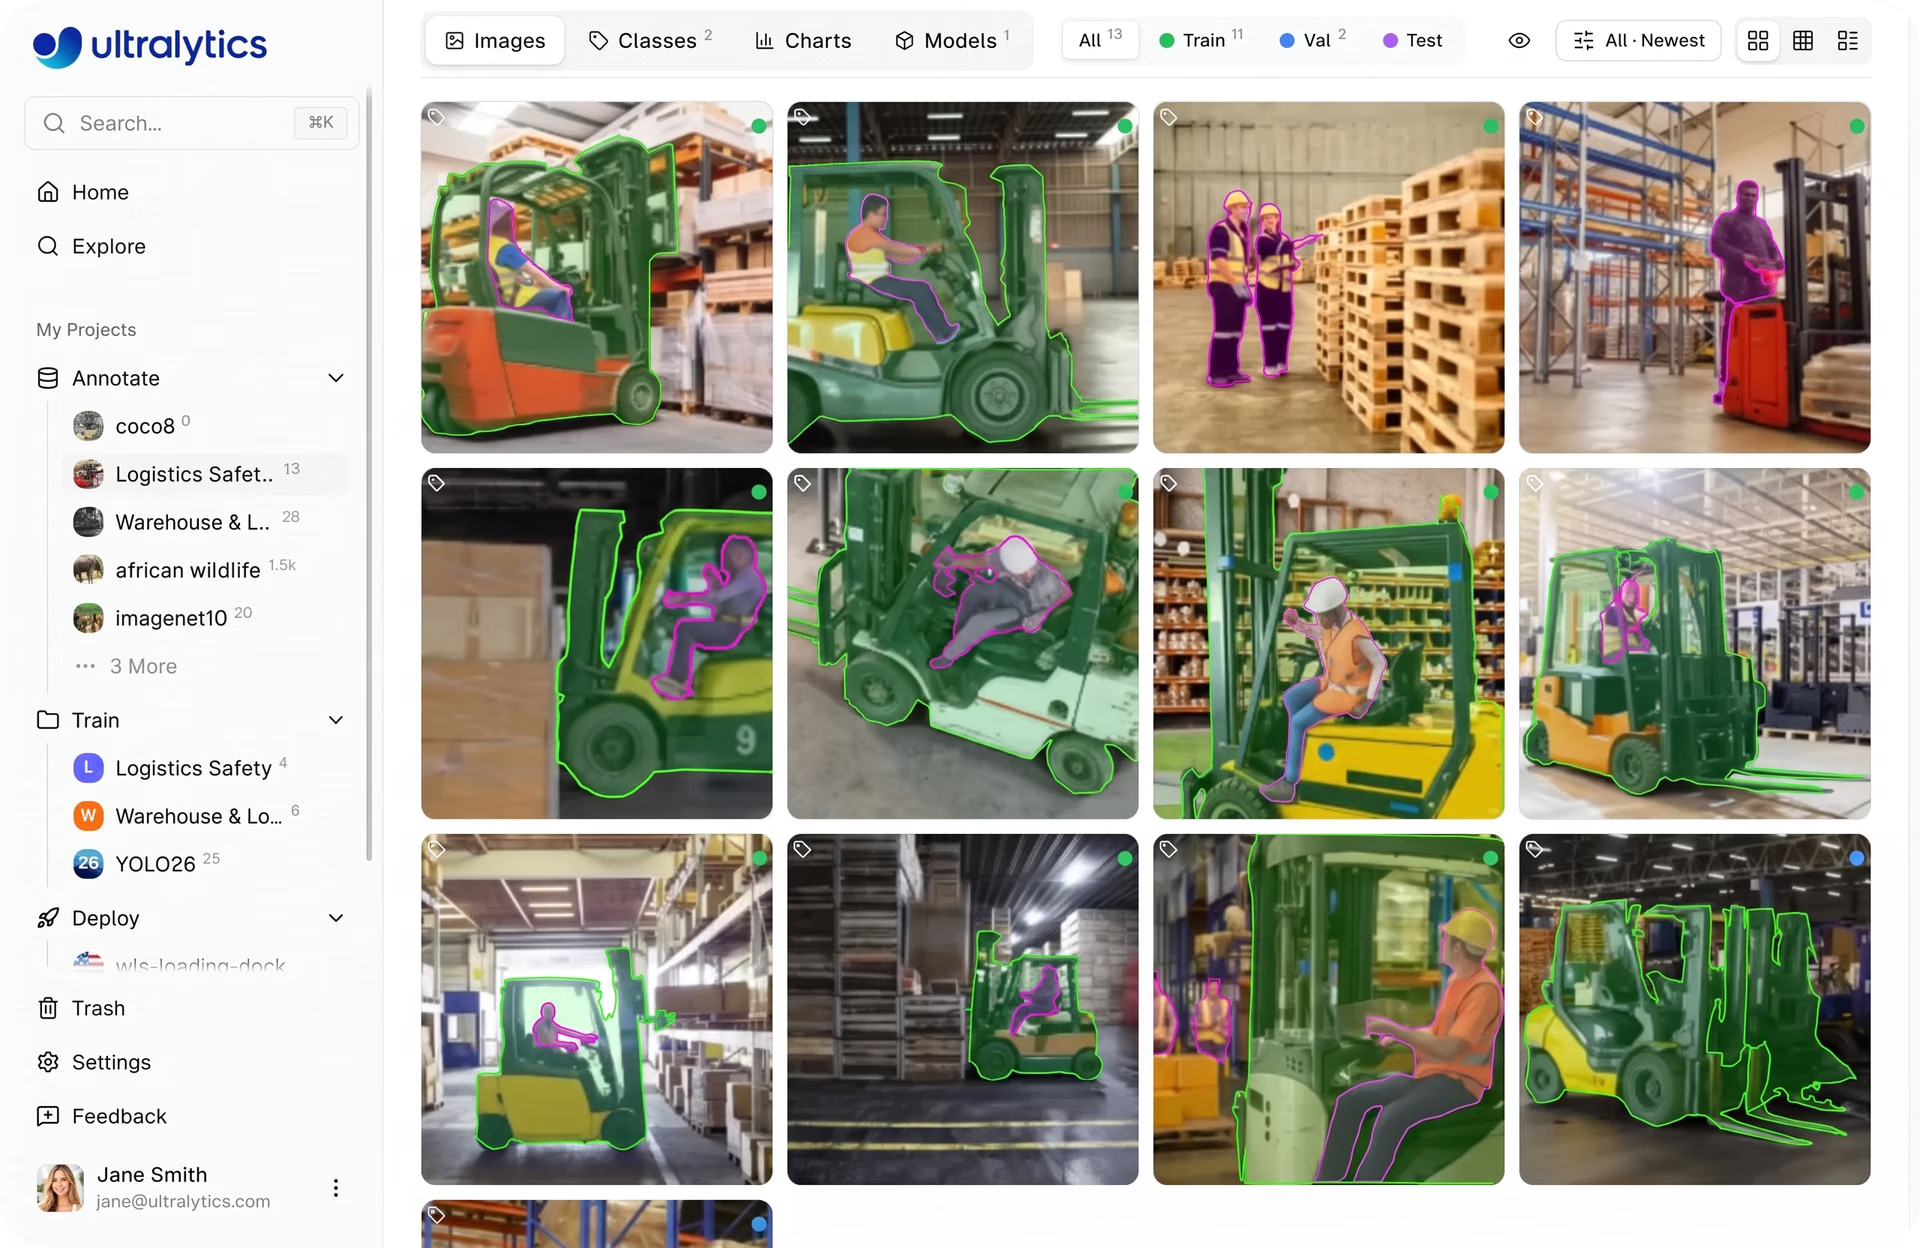
Fig. 1. Visualizzazione di un dataset in Ultralytics Platform (Fonte)
Poi puoi selezionare o creare un progetto per gestire le sessioni di addestramento. I progetti ti aiutano a organizzare e confrontare i modelli, monitorare le metriche di prestazione e raccogliere gli esperimenti correlati in un unico posto.
Da qui puoi passare all'addestramento nel cloud, dove scegli un modello, configuri i parametri e selezioni una GPU in base alle tue esigenze di prestazioni e al tuo budget. La piattaforma gestisce per te l'infrastruttura cloud sottostante.
La piattaforma prepara l'istanza GPU selezionata, predispone il dataset ed esegue il processo di addestramento nel cloud. Durante l'addestramento puoi monitorare in tempo reale le metriche, i log e le prestazioni del sistema, senza dover gestire la configurazione, gli ambienti CUDA, framework come PyTorch o TensorFlow o l'hardware.
Funzionalità principali per l'addestramento con GPU su Ultralytics Platform#
Ecco alcune funzionalità principali dell'addestramento nel cloud con GPU su Ultralytics Platform:
- Addestramento con un clic: avvia i processi di addestramento con una configurazione minima e passa rapidamente dal dataset all'addestramento del modello, senza configurazioni complesse.
- GPU on demand: scegli tra diverse GPU in base alle tue esigenze e scala le risorse quando serve, senza impegni a lungo termine.
- Monitoraggio in tempo reale: segui l'avanzamento dell'addestramento con grafici e log aggiornati in tempo reale e consulta metriche di sistema come l'utilizzo della GPU e della memoria.
- Checkpoint automatici: l'avanzamento dell'addestramento viene salvato a intervalli regolari, così puoi riprendere o recuperare facilmente il lavoro, se necessario.
- Semplicità di implementazione: una volta completato l'addestramento, puoi distribuire i modelli addestrati e usarli nelle applicazioni o nei flussi di lavoro tramite API di inferenza condivise, endpoint dedicati oppure esportandoli per l'uso su sistemi esterni. Queste opzioni di implementazione consentono un'inferenza a bassa latenza, utile per alimentare applicazioni in tempo reale come l'analisi video, i sistemi di automazione e le soluzioni AI interattive.
Le diverse opzioni di GPU cloud disponibili su Ultralytics Platform#
Ora che abbiamo visto come funziona l'addestramento sulla piattaforma, esaminiamo le diverse GPU disponibili. La GPU che scegli può influire sulla velocità di addestramento del modello, sulle sue prestazioni e sui costi.
Ultralytics Platform offre un'ampia gamma di GPU: dalle opzioni come RTX 2000 Ada e RTX A4500, passando per GPU come RTX 4000 Ada, RTX A5000, RTX 3090 e RTX A6000, fino ad arrivare alle opzioni più potenti come RTX 4090 e RTX PRO 6000.
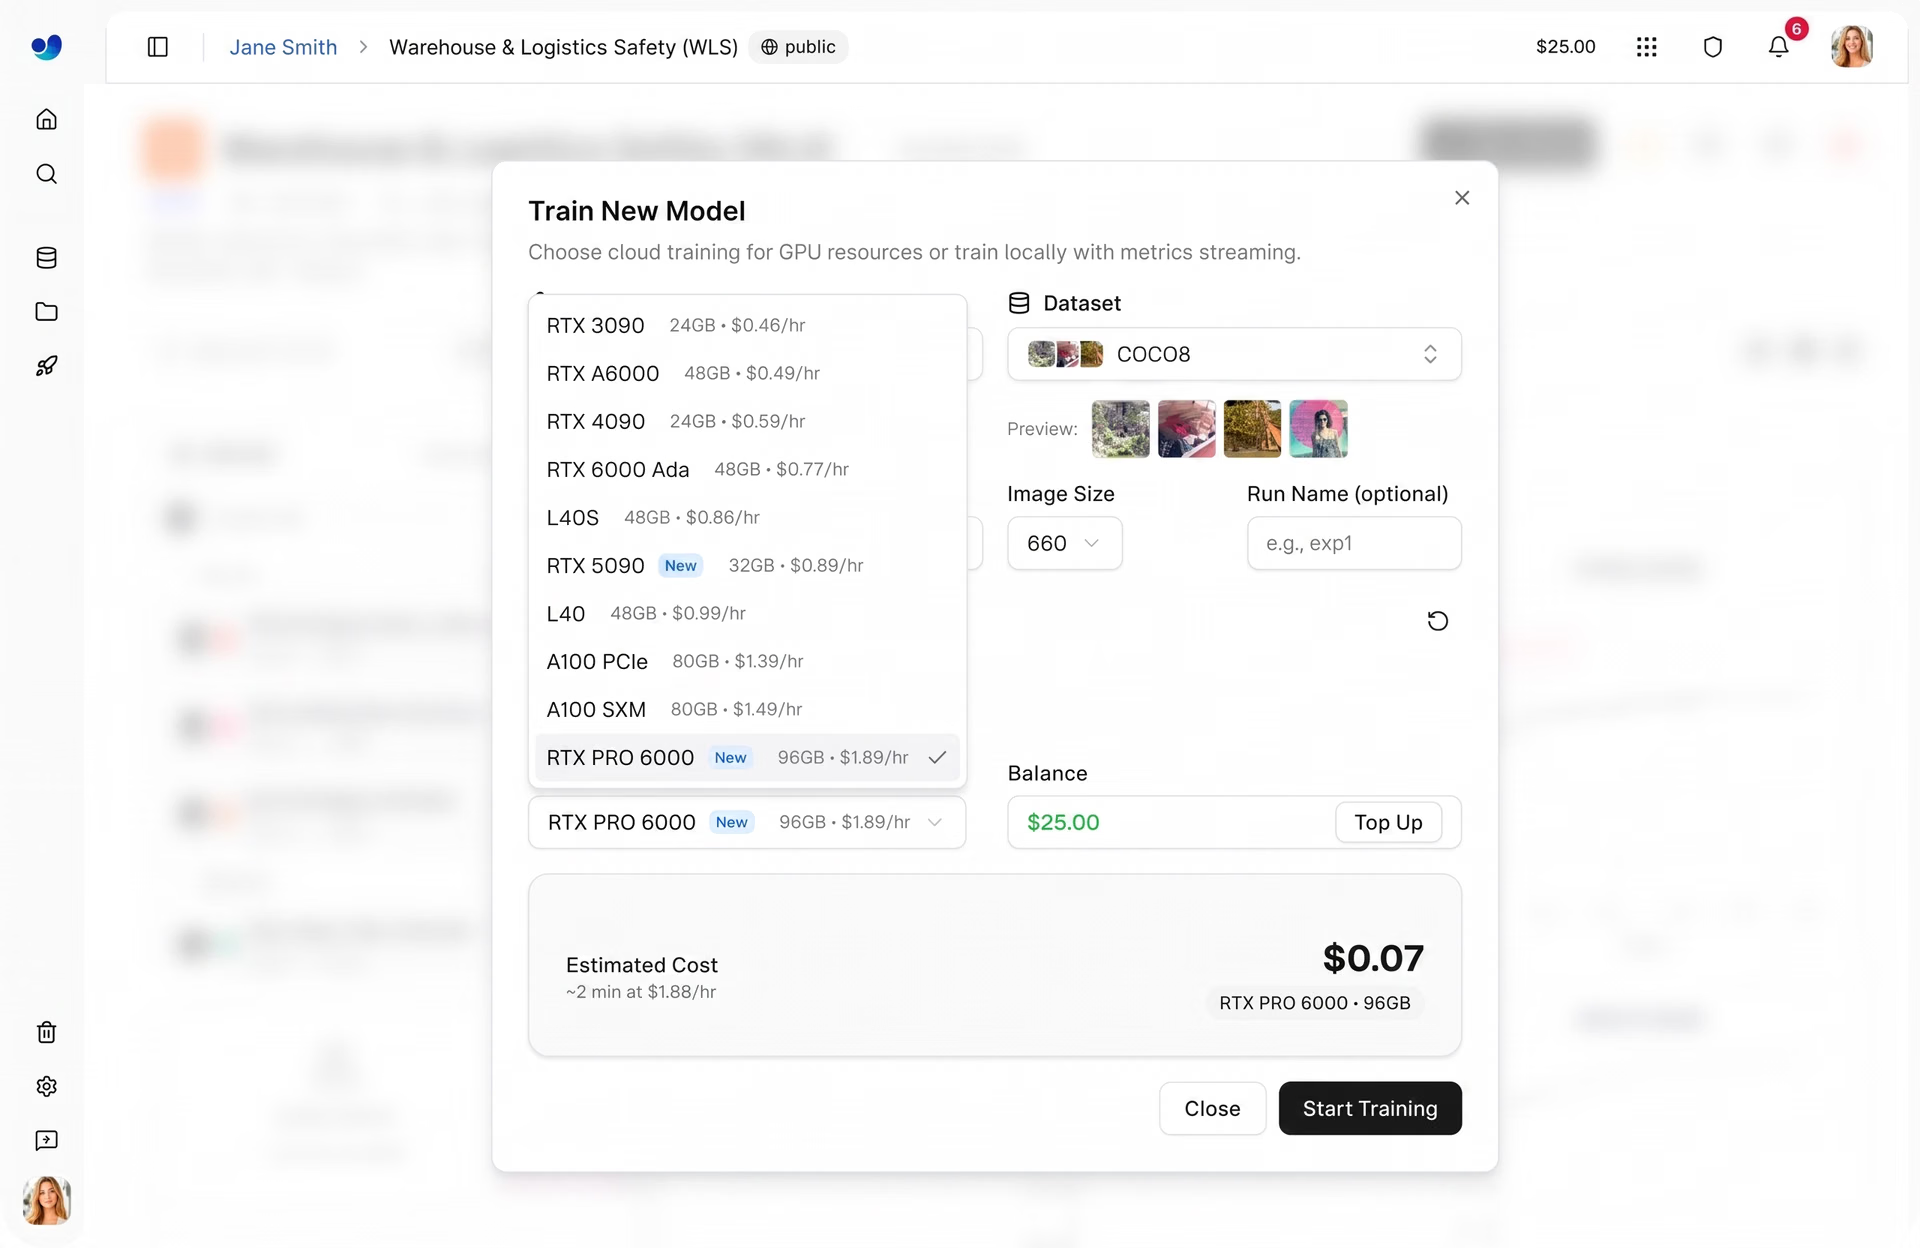
Fig. 2. Un esempio delle diverse opzioni GPU supportate da Ultralytics Platform (Fonte)
Per la maggior parte degli utenti, RTX PRO 6000 è una scelta predefinita equilibrata. Offre prestazioni affidabili per diversi carichi di lavoro senza richiedere molte regolazioni. RTX 4090 è un'altra opzione apprezzata, con prestazioni elevate rispetto al prezzo.
Per attività più semplici, come esperimenti rapidi, prototipazione o lavoro con dataset leggeri, GPU come RTX 2000 Ada e RTX A4500 sono un buon punto di partenza. Quando il carico di lavoro cresce, opzioni come RTX 4000 Ada, RTX A5000 e RTX 3090 offrono prestazioni più costanti per l'addestramento generico.
Nella fascia alta, GPU come A100 (Ampere), H100 e H200 (Hopper) e B200 (Blackwell) sono progettate per carichi di lavoro su larga scala. Sono ideali per addestrare modelli molto grandi, gestire dataset enormi o eseguire processi in cui velocità e prestazioni sono fondamentali.
Tipi di GPU e relativi casi d'uso#
Vediamo ora come si confrontano i diversi tipi di GPU e quali sono gli ambiti più adatti a ciascuno.
Le GPU RTX di NVIDIA sono generalmente più economiche e vengono usate spesso per l'addestramento quotidiano, la sperimentazione e carichi di lavoro piccoli o medi. Offrono un equilibrio tra prestazioni e accessibilità, risultando adatte a un'ampia varietà di casi d'uso.
Al contrario, GPU come A100, A40 e L40 sono progettate per carichi di lavoro più pesanti e addestramento su scala più ampia. Offrono maggiore stabilità e scalabilità, soprattutto con dataset più grandi o modelli più complessi.
Nella fascia alta, GPU come H100 e quelle basate sull'architettura Blackwell di NVIDIA rappresentano hardware AI più recente. Sono progettate per carichi di lavoro ad alte prestazioni e vengono usate in genere per l'addestramento su larga scala, la ricerca avanzata o le attività con vincoli di tempo.
La gamma di GPU disponibile su Ultralytics Platform offre flessibilità per diversi carichi di lavoro. In base alle tue esigenze, puoi iniziare con configurazioni più contenute e aumentare le risorse quando serve.
Come scegliere la GPU cloud giusta per il tuo progetto#
Quando selezioni una GPU per l'addestramento nel cloud su Ultralytics Platform, devi considerare diversi fattori, tra cui le dimensioni del dataset, la complessità del modello e i costi. Esaminiamoli uno per uno.
Adattare la potenza della GPU alle dimensioni del dataset#
Uno dei principali fattori da considerare nella scelta di una GPU è la dimensione del dataset, poiché influisce sulla durata dell'addestramento e sulla potenza di calcolo necessaria.
Per i dataset piccoli, in genere con meno di 1.000 immagini, spesso basta una GPU leggera come RTX 2000. È adatta agli esperimenti rapidi e alle sessioni di addestramento più brevi.
Per i dataset di medie dimensioni, con circa 1.000-10.000 immagini, GPU come RTX 4090 o RTX A6000 offrono un equilibrio migliore tra prestazioni ed efficienza, consentendoti di addestrare i modelli più agevolmente e senza lunghe attese.
Per i dataset più grandi, con oltre 10.000 immagini, probabilmente ti servirà hardware più potente per mantenere ragionevoli i tempi di addestramento. GPU come H100 sono più adatte a gestire carichi di lavoro impegnativi e a scalare in modo efficace.
In definitiva, si tratta di adattare le dimensioni del dataset alla potenza di calcolo e alla capacità di elaborazione parallela di cui hai bisogno.
Scegliere una GPU in base alle dimensioni e alla complessità del modello#
Un altro fattore importante nella scelta di una GPU è la dimensione e la complessità del tuo modello di AI visiva. Modelli di dimensioni diverse richiedono potenze di calcolo diverse.
Per esempio, i modelli più piccoli richiedono meno potenza di calcolo della GPU e possono funzionare in modo efficiente su GPU come RTX 2000 Ada, RTX A4500 o persino RTX 4090, se vuoi ottenere risultati più rapidamente. Sono ideali per esperimenti rapidi, prototipazione e attività più semplici, perché ti permettono di iterare più velocemente e testare idee senza costi di calcolo elevati.
I modelli più grandi e complessi, invece, richiedono molta più memoria e potenza di elaborazione. GPU come RTX A6000, RTX PRO 6000 e opzioni di fascia alta come H100 sono più adatte a questi carichi di lavoro. Possono gestire architetture più grandi, ridurre i tempi di addestramento e prevenire problemi di memoria, un aspetto particolarmente importante con immagini ad alta risoluzione, batch di grandi dimensioni o modelli più avanzati.
Confronto tra dimensione del batch e memoria della GPU#
Anche la dimensione del batch svolge un ruolo importante nell'addestramento dei modelli. Indica il numero di campioni di addestramento elaborati dal modello contemporaneamente in un singolo passaggio.
Batch di dimensioni maggiori possono migliorare l'efficienza dell'addestramento elaborando più dati alla volta, ma richiedono anche più memoria della GPU (VRAM). In generale, le GPU con maggiore larghezza di banda della memoria possono supportare batch più grandi, mentre quelle con meno memoria potrebbero richiedere batch più piccoli.
Per esempio, GPU come RTX A6000, RTX PRO 6000 o A100 possono gestire più facilmente batch di dimensioni maggiori grazie alla maggiore quantità di memoria, mentre opzioni come RTX 4090 o RTX 2000 Ada potrebbero richiedere batch più piccoli a seconda del carico di lavoro.
Tuttavia, non è sempre necessario usare la GPU più potente. Le GPU di fascia alta possono aumentare velocità e capacità, ma hanno anche costi più elevati. In molti casi, regolare la dimensione del batch su una GPU più piccola può essere una scelta più efficiente.
L'obiettivo è trovare il giusto equilibrio tra dimensione del batch, memoria GPU disponibile e costi, in base al modello e al dataset.
L'impatto della configurazione di addestramento sulle prestazioni della GPU#
Un altro fattore che influisce sulle prestazioni della GPU è la configurazione di addestramento. Include parametri come il numero di epoche, la dimensione delle immagini e altre impostazioni che determinano il modo in cui viene addestrato un modello.
Per esempio, immagini di dimensioni maggiori aumentano la quantità di calcoli necessari per ogni passaggio. Questo può rallentare l'addestramento e richiedere più potenza di calcolo o memoria per mantenere buone prestazioni.
Allo stesso modo, aumentare il numero di epoche prolunga la durata complessiva dell'addestramento, soprattutto con hardware meno potente. Un'epoca corrisponde a un passaggio completo attraverso l'intero dataset durante l'addestramento.
Anche tecniche come l'aumento dei dati aggiungono ulteriori operazioni durante l'addestramento. L'aumento dei dati applica trasformazioni come ribaltamento, rotazione o ridimensionamento per aumentare la varietà dei dati e migliorare le prestazioni del modello. Pur potendo migliorare la robustezza del modello, può anche ridurre la velocità di addestramento.
In generale, le GPU più potenti possono gestire queste maggiori esigenze in modo più efficiente, ma l'impatto dipende dalla configurazione complessiva e dal carico di lavoro.
Trovare un equilibrio tra costi e tempi di addestramento#
Quando scegli una GPU per il tuo progetto, spesso devi trovare un compromesso tra la velocità di addestramento e il prezzo della GPU.
Ultralytics Platform semplifica la stima e la comprensione dei costi prima di avviare un processo di addestramento. In base alla configurazione, comprese le dimensioni del dataset, il modello e la GPU, puoi conoscere in anticipo il costo e la durata stimati.
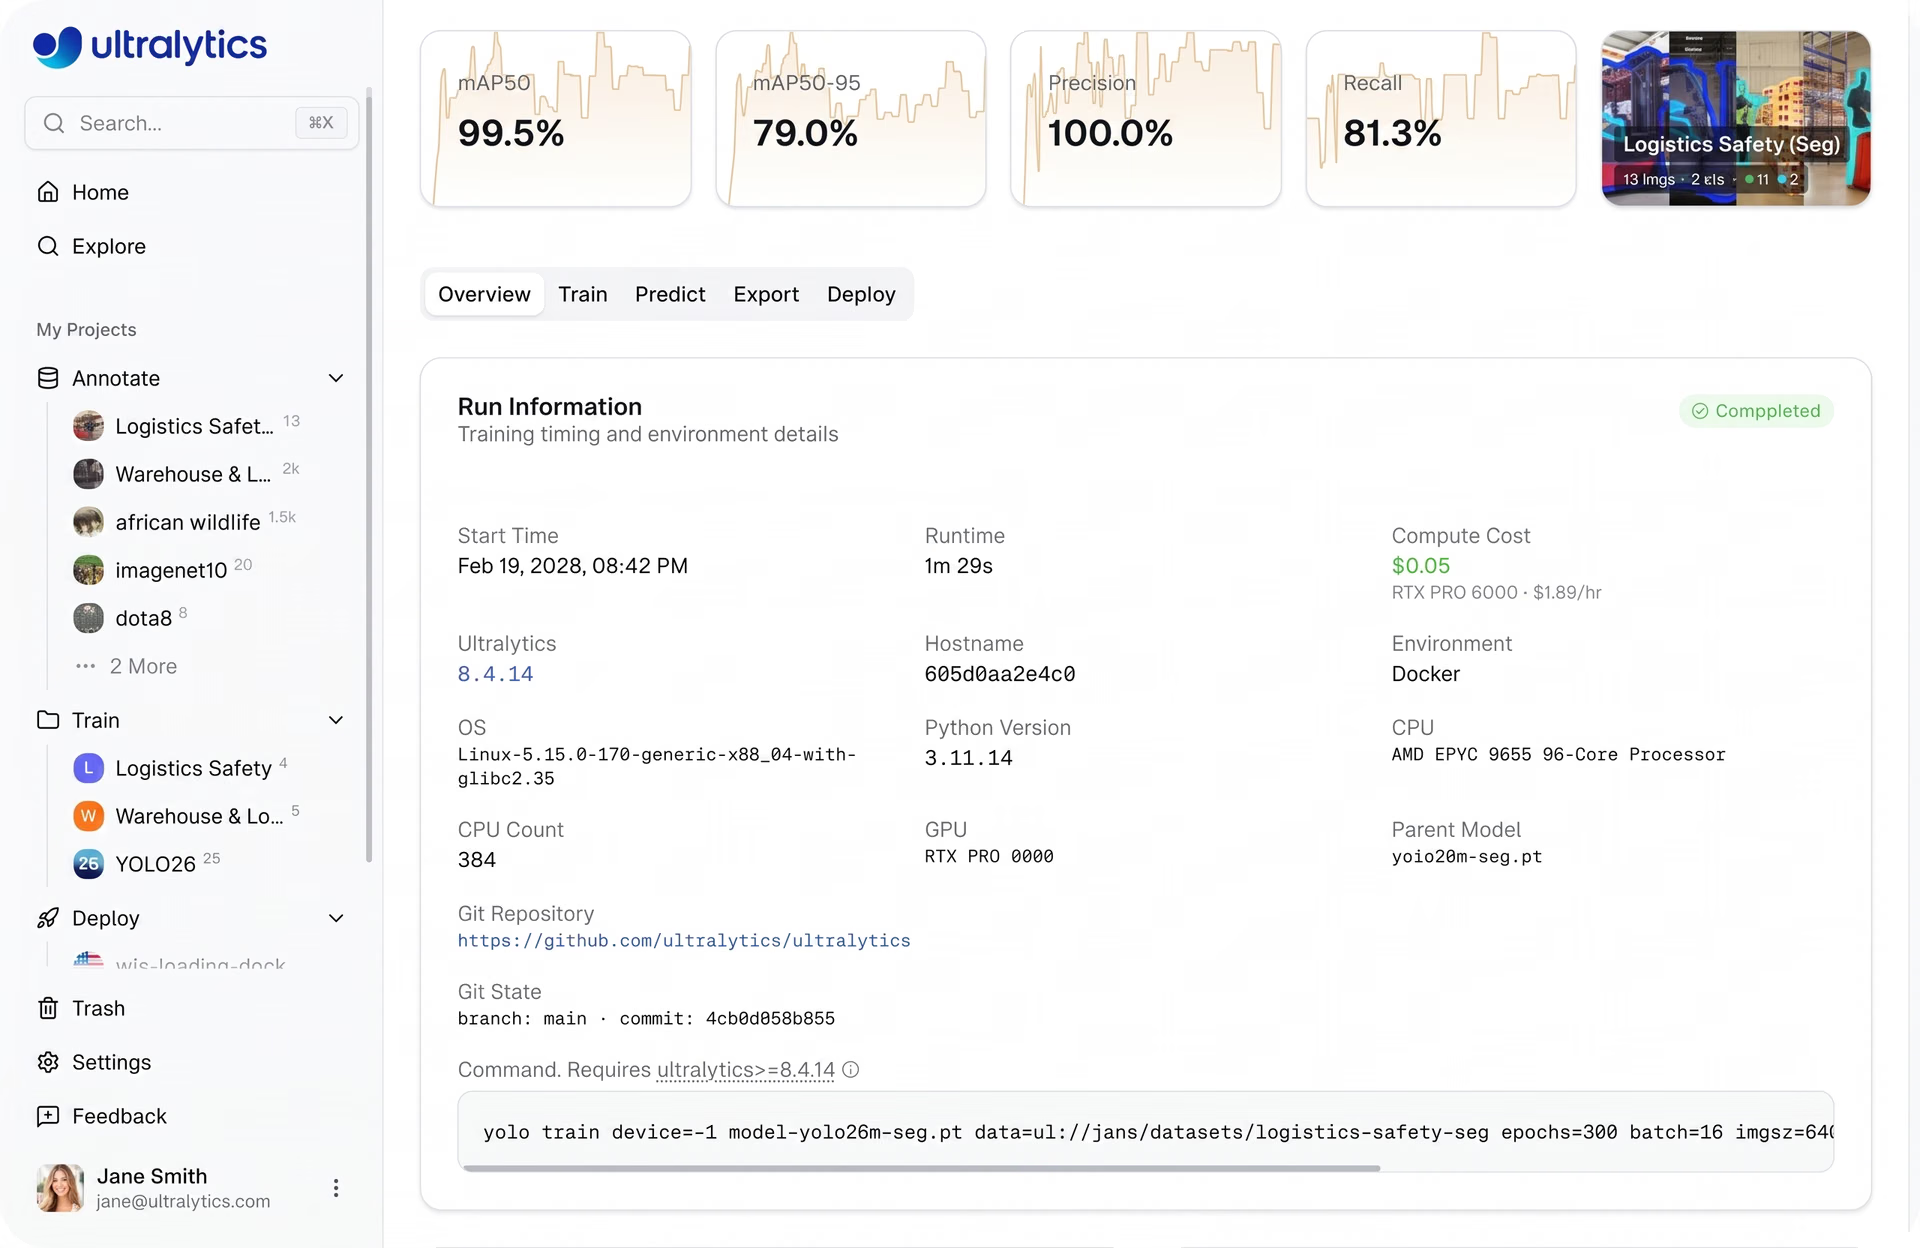
Fig. 3. Ultralytics Platform semplifica la stima e la comprensione dei costi del cloud. (Fonte)
Le GPU più veloci hanno in genere un costo orario più elevato, ma possono ridurre il tempo complessivo di addestramento. GPU come RTX 4090, RTX PRO 6000 e H100 riescono generalmente a completare l'addestramento più rapidamente grazie alle loro prestazioni superiori.
Le GPU più lente tendono ad avere un costo orario inferiore, ma richiedono più tempo per completare l'addestramento. Per esempio, GPU come RTX 2000 Ada e RTX A4500 vengono spesso usate per carichi di lavoro più piccoli o processi più lunghi, quando si dà priorità ai costi contenuti.
Inoltre, alcune delle GPU più potenti, come H200 e B200, sono disponibili solo con i piani Pro o Enterprise, mentre la maggior parte delle altre opzioni è accessibile anche con il piano Free.
Strategie per ottimizzare i costi#
Oltre a scegliere la GPU giusta, ci sono alcuni accorgimenti pratici per tenere sotto controllo i costi di addestramento. Uno degli approcci più efficaci consiste nell'iniziare con brevi esecuzioni di prova prima di aumentare la scala.
Invece di passare subito a un addestramento completo, inizia con un numero inferiore di epoche per assicurarti che la configurazione funzioni come previsto. In questo modo puoi convalidare rapidamente i dati, le annotazioni e la configurazione del modello, evitando di sprecare tempo e risorse di calcolo in esecuzioni che potrebbero non produrre risultati utili.
Man mano che l'addestramento procede, tieni d'occhio le metriche e interrompi le esecuzioni in anticipo se le prestazioni si stabilizzano o smettono di migliorare. Monitorare le curve di addestramento può aiutarti a decidere se continuare o modificare la configurazione.
Puoi anche ottimizzare parametri come la dimensione del batch e quella delle immagini. Valori più bassi riducono l'utilizzo di memoria e risorse di calcolo, rendendo più pratico sperimentare, provare diverse configurazioni o eseguire simulazioni su piccola scala prima di aumentare la scala.
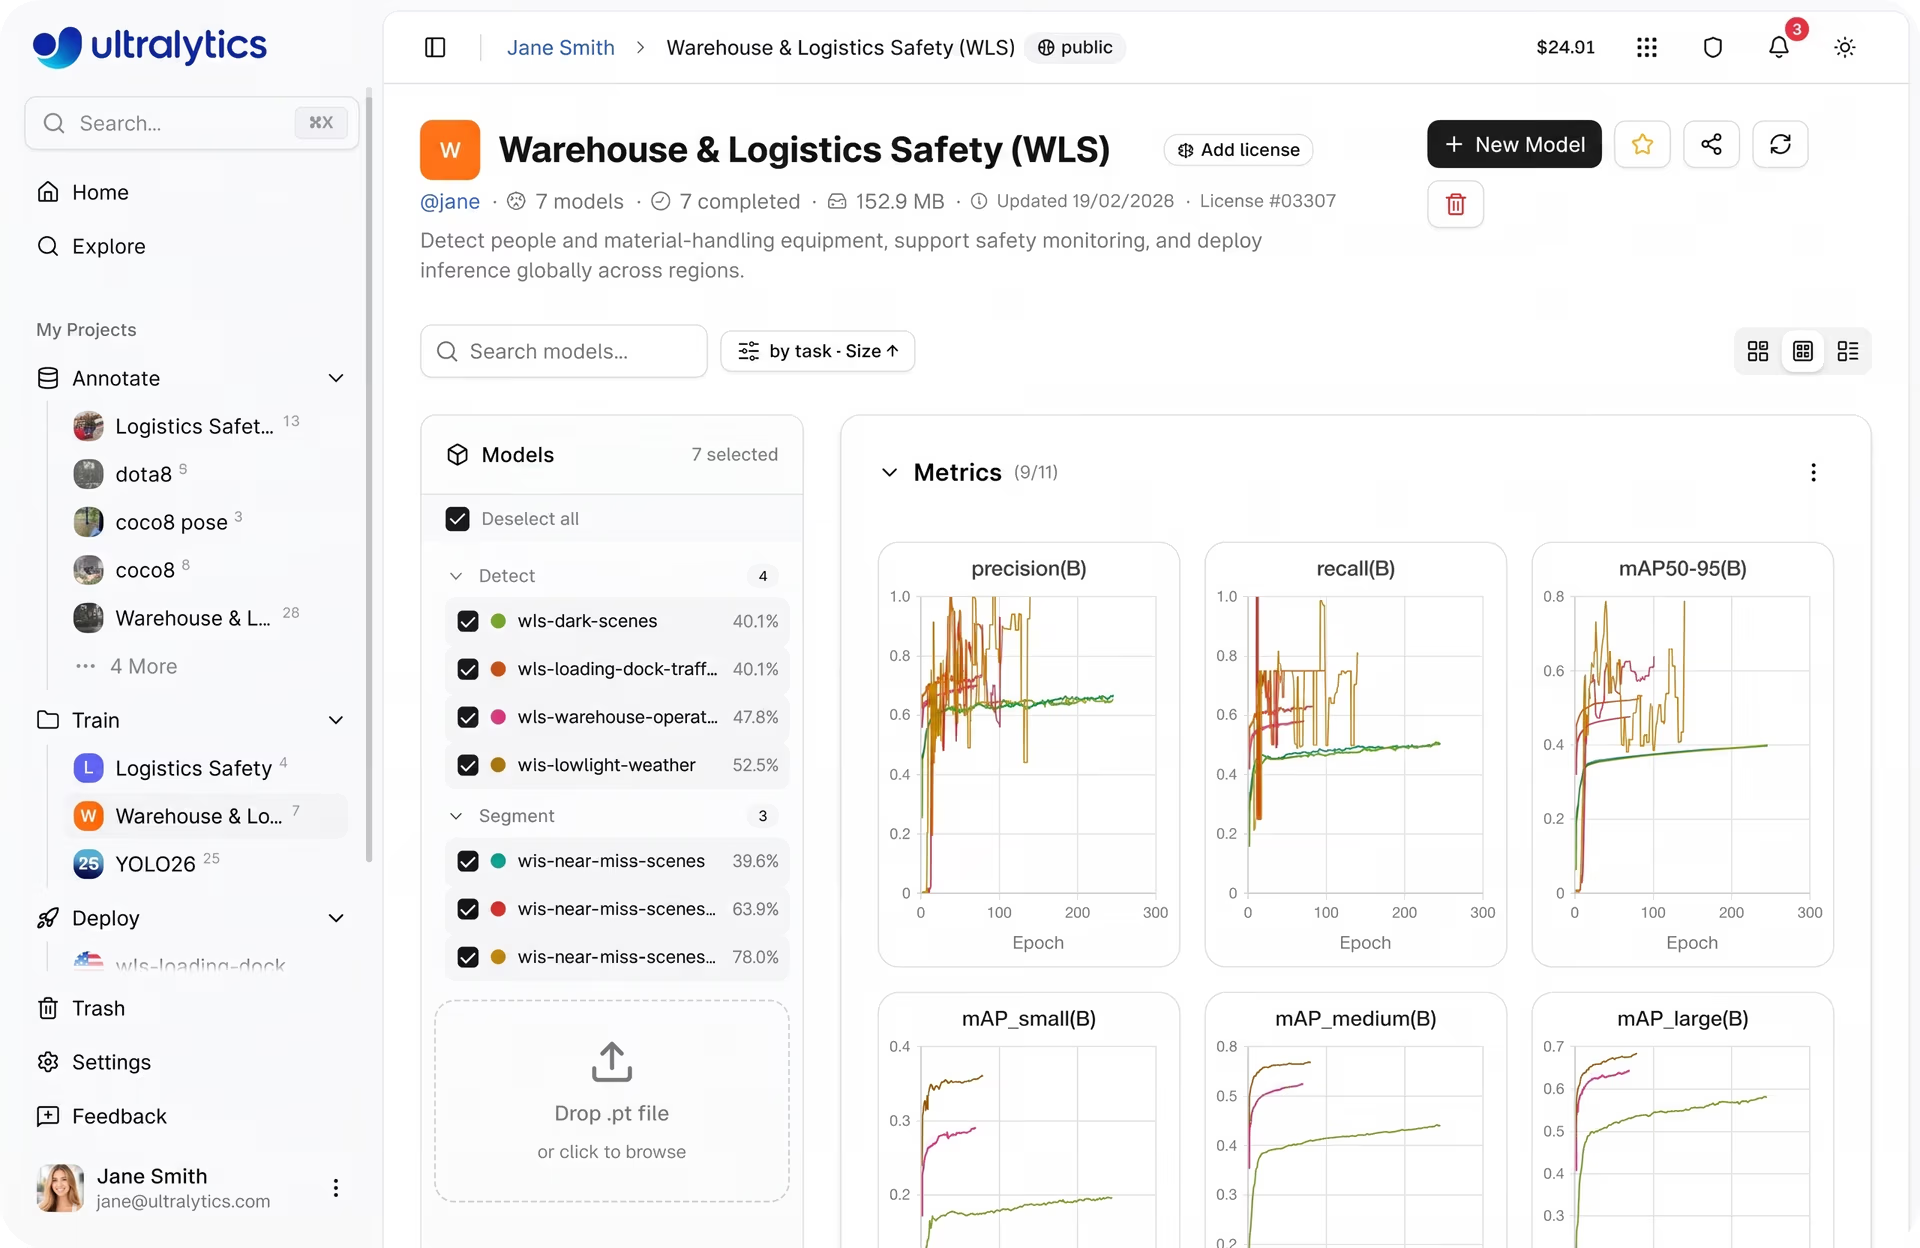
Fig. 4. Visualizzazioni delle metriche di addestramento su Ultralytics Platform (Fonte)
Inoltre, Ultralytics Platform semplifica la gestione dei costi. Offre una stima dei costi integrata, così puoi conoscere le spese previste prima di avviare un'attività.
Con un sistema basato su crediti e pagamento a consumo, paghi solo il tempo di calcolo che utilizzi effettivamente. Questo ti aiuta a rispettare il budget e ad aumentare la scala quando hai acquisito fiducia nella configurazione di addestramento.
Buone pratiche per l'addestramento di modelli di computer vision su GPU cloud#
Ecco alcune buone pratiche da tenere a mente per l'addestramento su GPU cloud con Ultralytics Platform:
- Convalida i dataset prima dell'addestramento: assicurati che il dataset sia pulito, annotato con cura e coerente prima di iniziare. Individuare i problemi in anticipo aiuta a evitare sprechi di risorse di calcolo e migliora le prestazioni del modello.
- Esegui prima esperimenti rapidi: inizia con brevi esecuzioni di prova e un numero inferiore di epoche per verificare la configurazione. In questo modo puoi individuare subito i problemi, senza impegnarti in lunghi e costosi processi di addestramento. In un certo senso, crei un modello riutilizzabile e scalabile quando tutto funziona come previsto.
- Monitora le metriche principali: tieni traccia di metriche come loss, mAP, precisione e richiamo durante tutto l'addestramento. Queste metriche fungono da parametri di riferimento per valutare le prestazioni del modello e ti aiutano a decidere quando apportare modifiche o interrompere l'esecuzione.
- Mantieni efficienti le pipeline di elaborazione dei dati: assicurati che il caricamento e il preelaborazione dei dati siano efficienti, poiché queste operazioni utilizzano risorse della CPU e possono diventare colli di bottiglia che compromettono le prestazioni complessive dell'addestramento.
- Usa gli strumenti integrati: utilizza grafici, log della console e metriche di sistema per monitorare l'addestramento in tempo reale e prendere rapidamente decisioni consapevoli.
Punti chiave#
Scegliere la GPU cloud giusta per la computer vision su Ultralytics Platform significa comprendere il tuo carico di lavoro, incluse le dimensioni del dataset, la complessità del modello e la configurazione di addestramento. Con una gamma di GPU disponibili, supportate da infrastrutture cloud e macchine virtuali, puoi iniziare con una scelta equilibrata e aumentare la scala man mano che crescono le esigenze di addestramento o fine-tuning del modello. Combinando l'hardware giusto con buone pratiche, come il monitoraggio e il controllo dei costi, puoi addestrare in modo efficiente modelli di intelligenza artificiale all'avanguardia, sfruttando al meglio la flessibilità del calcolo ad alte prestazioni.
Scopri la nostra community in continua crescita e il nostro repository GitHub per saperne di più sulla computer vision. Se vuoi sviluppare soluzioni di visione artificiale, dai un'occhiata alle nostre opzioni di licenza. Esplora le pagine dedicate alle nostre soluzioni per scoprire i vantaggi della computer vision nel settore manifatturiero e dell'IA in agricoltura.









