Intel Core Ultra Series 3(Panther Lake)上でOpenVINOを使用してUltralytics YOLO26を高速化
Ultralytics YOLO26モデルをOpenVINO形式にエクスポートし、CPU、GPU、NPUを含むIntelハードウェアで推論を高速化する方法をご紹介します。
ここ数年で、AIとコンピュータービジョンは実験段階から、日々のビジネス運営に欠かせない要素へと変化しました。実際、調査によると、すでに約88%の組織が、ビジネスの少なくとも一部でAIを活用しています。
しかし、その導入を本番システムや個人プロジェクトで実際の価値につなげられるかどうかは、多くの場合、デプロイ後にモデルがどれだけ適切に動作するかにかかっています。多くの実環境では、コンピュータービジョンモデルのようなUltralytics YOLO26は、ハイエンドGPUではなく、エッジデバイスやCPU、内蔵GPU、NPUなどさまざまなハードウェアにデプロイされます。
こうした環境では性能に差が生じることがあり、最適化が重要になります。基盤となるハードウェアに合わせて適切に最適化されていないモデルは、ある環境で良好に動作しても、別の環境では性能が低下する可能性があります。
このプロセスを効率化するため、Ultralytics PythonパッケージではYOLO26モデルをOpenVINOなどの最適化済みフォーマットにエクスポートできます。ワークフローを変更することなく、Intelハードウェア上でスムーズに実行できます。
たとえば、Ultralytics YOLO26モデルをOpenVINOフォーマットにエクスポートすると、Intel Core Ultra Series 3プロセッサー上でより効率的に実行でき、GPU推論速度は最大3倍向上します。
この記事では、更新されたUltralyticsとOpenVINOの統合によって、Intel Core Ultra Series 3ハードウェア全体へのYOLO26モデルのデプロイがどのように容易になるかを紹介します。それでは始めましょう。
UltralyticsとOpenVINOの統合の概要#
Ultralytics Pythonパッケージは、YOLO26などのUltralytics YOLOモデルのトレーニング、推論、デプロイに対応する単一のインターフェースを提供します。トレーニングや実験からデプロイや最適化まで、ビジョンAIワークフローのさまざまな工程を支援する幅広い統合機能に対応しています。
デプロイに重点を置いた統合機能の一つがOpenVINOツールキットとの連携です。これにより、Ultralytics YOLO26モデルを最適化済みフォーマットにエクスポートし、Intelハードウェアで実行できます。このプロセスでは、YOLOモデルをIntel CPU、GPU、NPU上でより効率的に動作するフォーマットに変換します。Intel® Core™ Ultra™シリーズプロセッサーを搭載したシステムも対象です。
これにより、セットアップごとに手動で調整することなく、さまざまなIntelデバイス上でモデルをより簡単に実行できます。ローカルマシン、エッジデバイス、大規模なデプロイのいずれで作業する場合でも、同じエクスポート済みモデルを再利用できます。
この統合が特に実用的なのは、既存のUltralyticsワークフローにシームレスに組み込める点です。トレーニングや推論に使用するものと同じインターフェースでモデルをエクスポートできるため、追加ツールや複雑なセットアップは必要ありません。
エクスポート後のモデルは、必要な制御性や柔軟性に応じて、Ultralytics PythonパッケージまたはOpenVINO Runtimeを使って推論に利用できます。
AI推論向けOpenVINOとIntel Panther Lakeハードウェアを詳しく見る#
エクスポートしたUltralytics YOLO26モデルがIntelハードウェア上でどれほど効率的に動作するかを見る前に、OpenVINOとIntelハードウェアが連携して効率的な推論を実現する仕組みを確認しましょう。
OpenVINOは、CPU、内蔵GPU、NPUなどのIntelハードウェア全体でAI推論を最適化し、実行するために設計されたオープンソースツールキットです。統合ランタイムを提供しているため、モデルを書き換えることなく、これらの異なる演算ユニット上で同じモデルを実行できます。
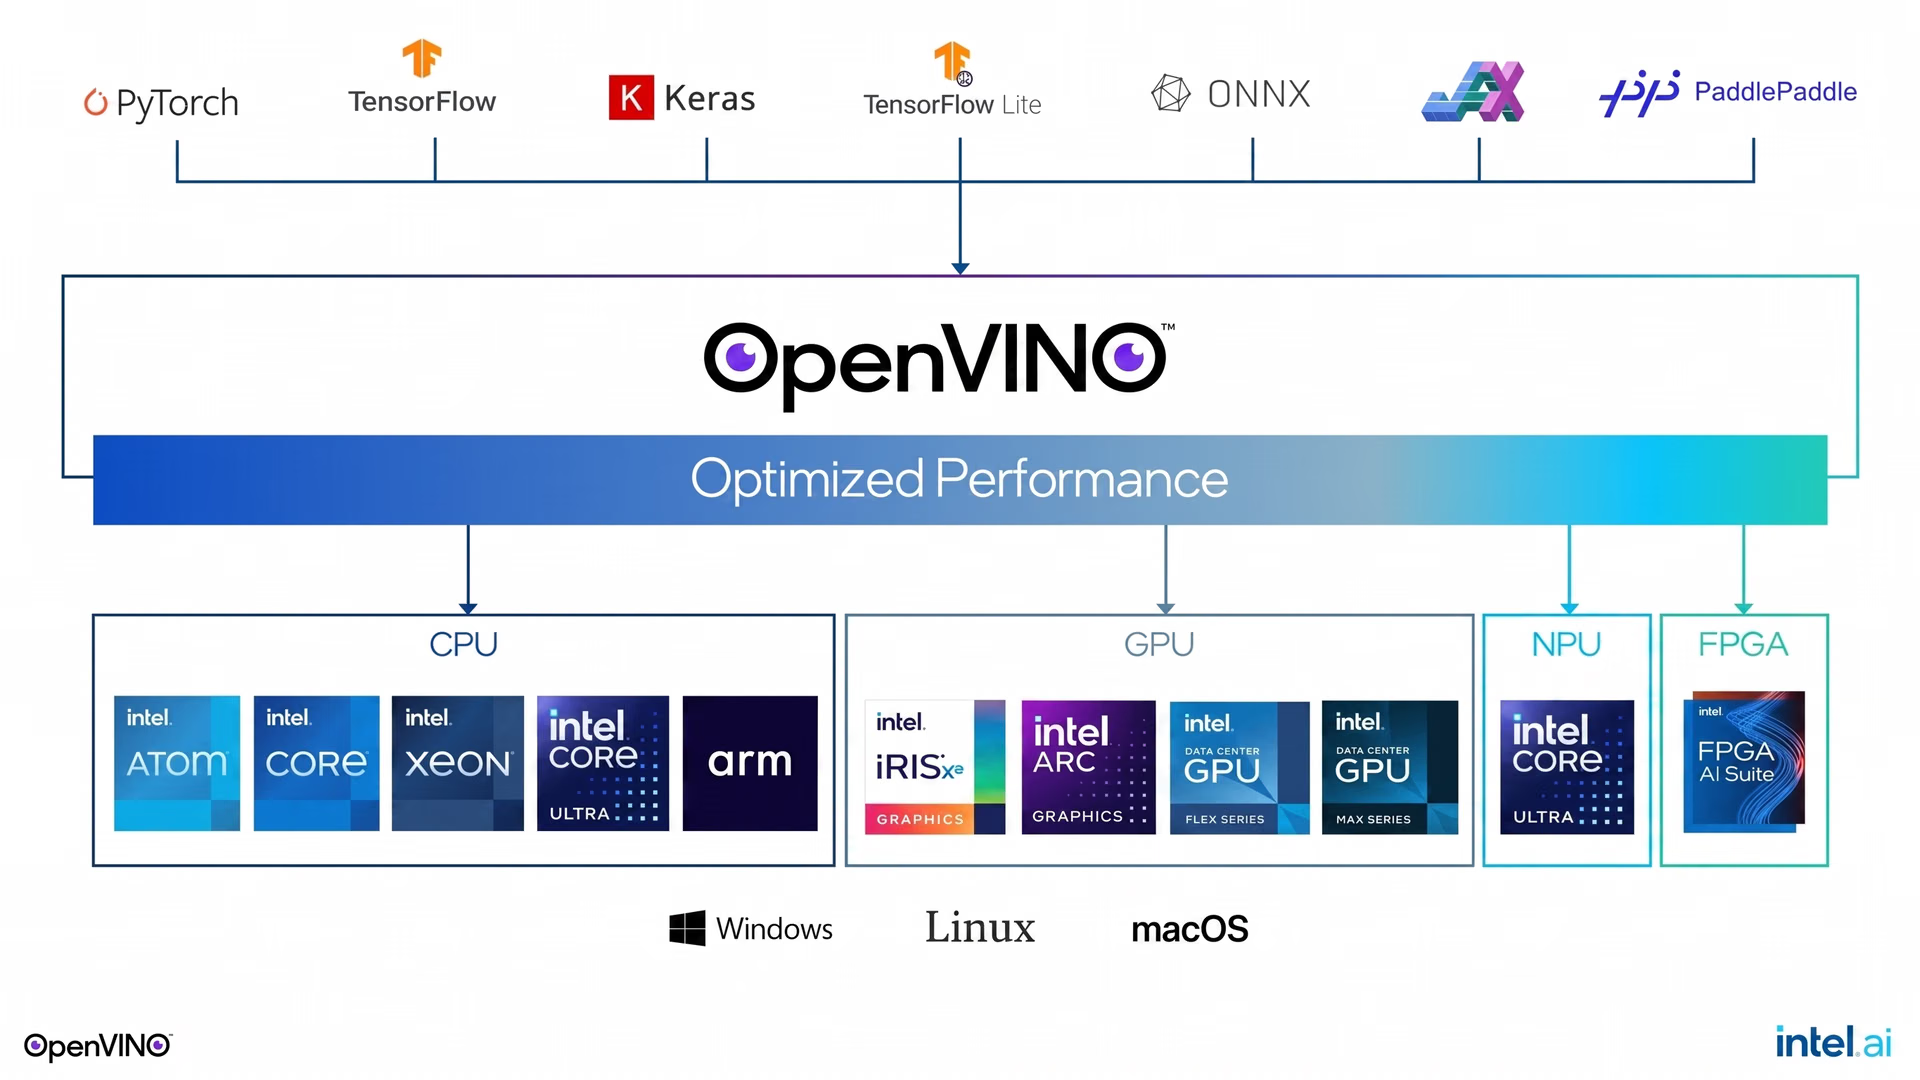
図1. OpenVINOを使うと、複数のハードウェアターゲットにモデルを簡単にデプロイできます。(出典)
新しいIntel® Core™ Ultra™ Series 3プロセッサー(コードネーム:Panther Lake)では、AIワークロードは同じプロセッサー内の複数の演算ユニットで実行されます。各チップは、汎用タスク向けのCPUコア、並列処理向けの内蔵GPU、AI推論専用に設計されたNPUを組み合わせています。
OpenVINOは統合APIを提供しており、コードを変更せずにCPU、GPU、NPUのいずれの演算ユニットも対象にできます。実行時に推論を実行するデバイスを指定するだけで、性能や効率のニーズに応じて3種類すべてを簡単に切り替えられます。
Intel® Core™ Ultra™シリーズでUltralytics YOLO26をベンチマーク#
UltralyticsとOpenVINOの統合を試すなかで、YOLO26をOpenVINOフォーマットにエクスポートすると、どのような性能向上が期待できるのか気になるかもしれません。
異なるフォーマットや精度でYOLO26モデルをベンチマークすると、推論速度の違いが明確になります。たとえば、Panther LakeプロセッサーのIntel Core Ultra X7 358H上でYOLO26のnanoバリアント(YOLO26n)を実行した場合、FP32精度のPyTorchでは画像1枚あたり25.18 msだった推論時間が、同じ精度で内蔵NPUを使用するOpenVINOでは2.64 msに短縮されます。
これはPyTorch FP32の元のベースラインよりも高速であり、レイテンシが重要となるリアルタイムアプリケーションやエッジアプリケーションで大きな違いを生みます。同じモデルを内蔵Intel Arc GPUで実行すると、こうした性能向上はさらに明らかになります。
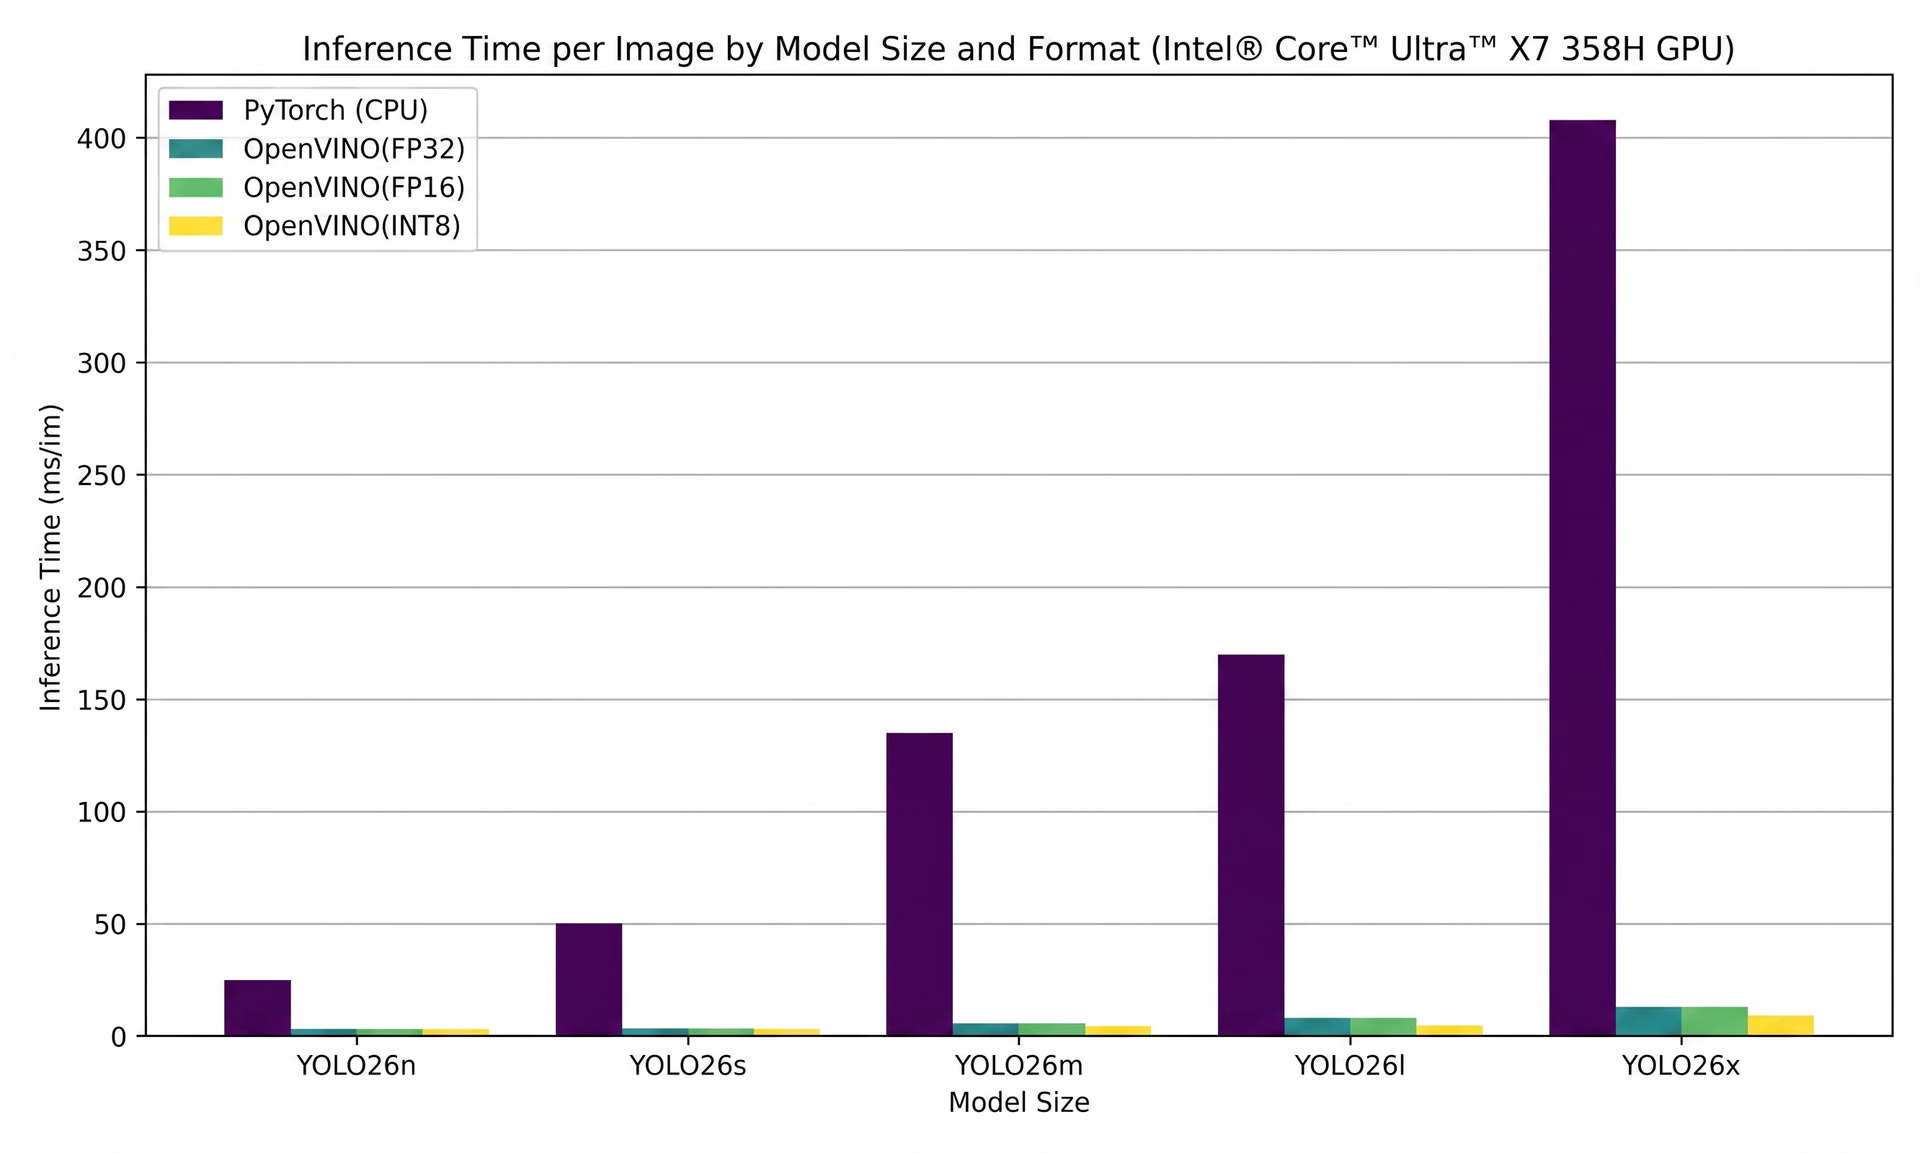
図2. OpenVINOを使用したIntel Panther Lake GPU上でのUltralytics YOLO26推論のベンチマーク(出典)
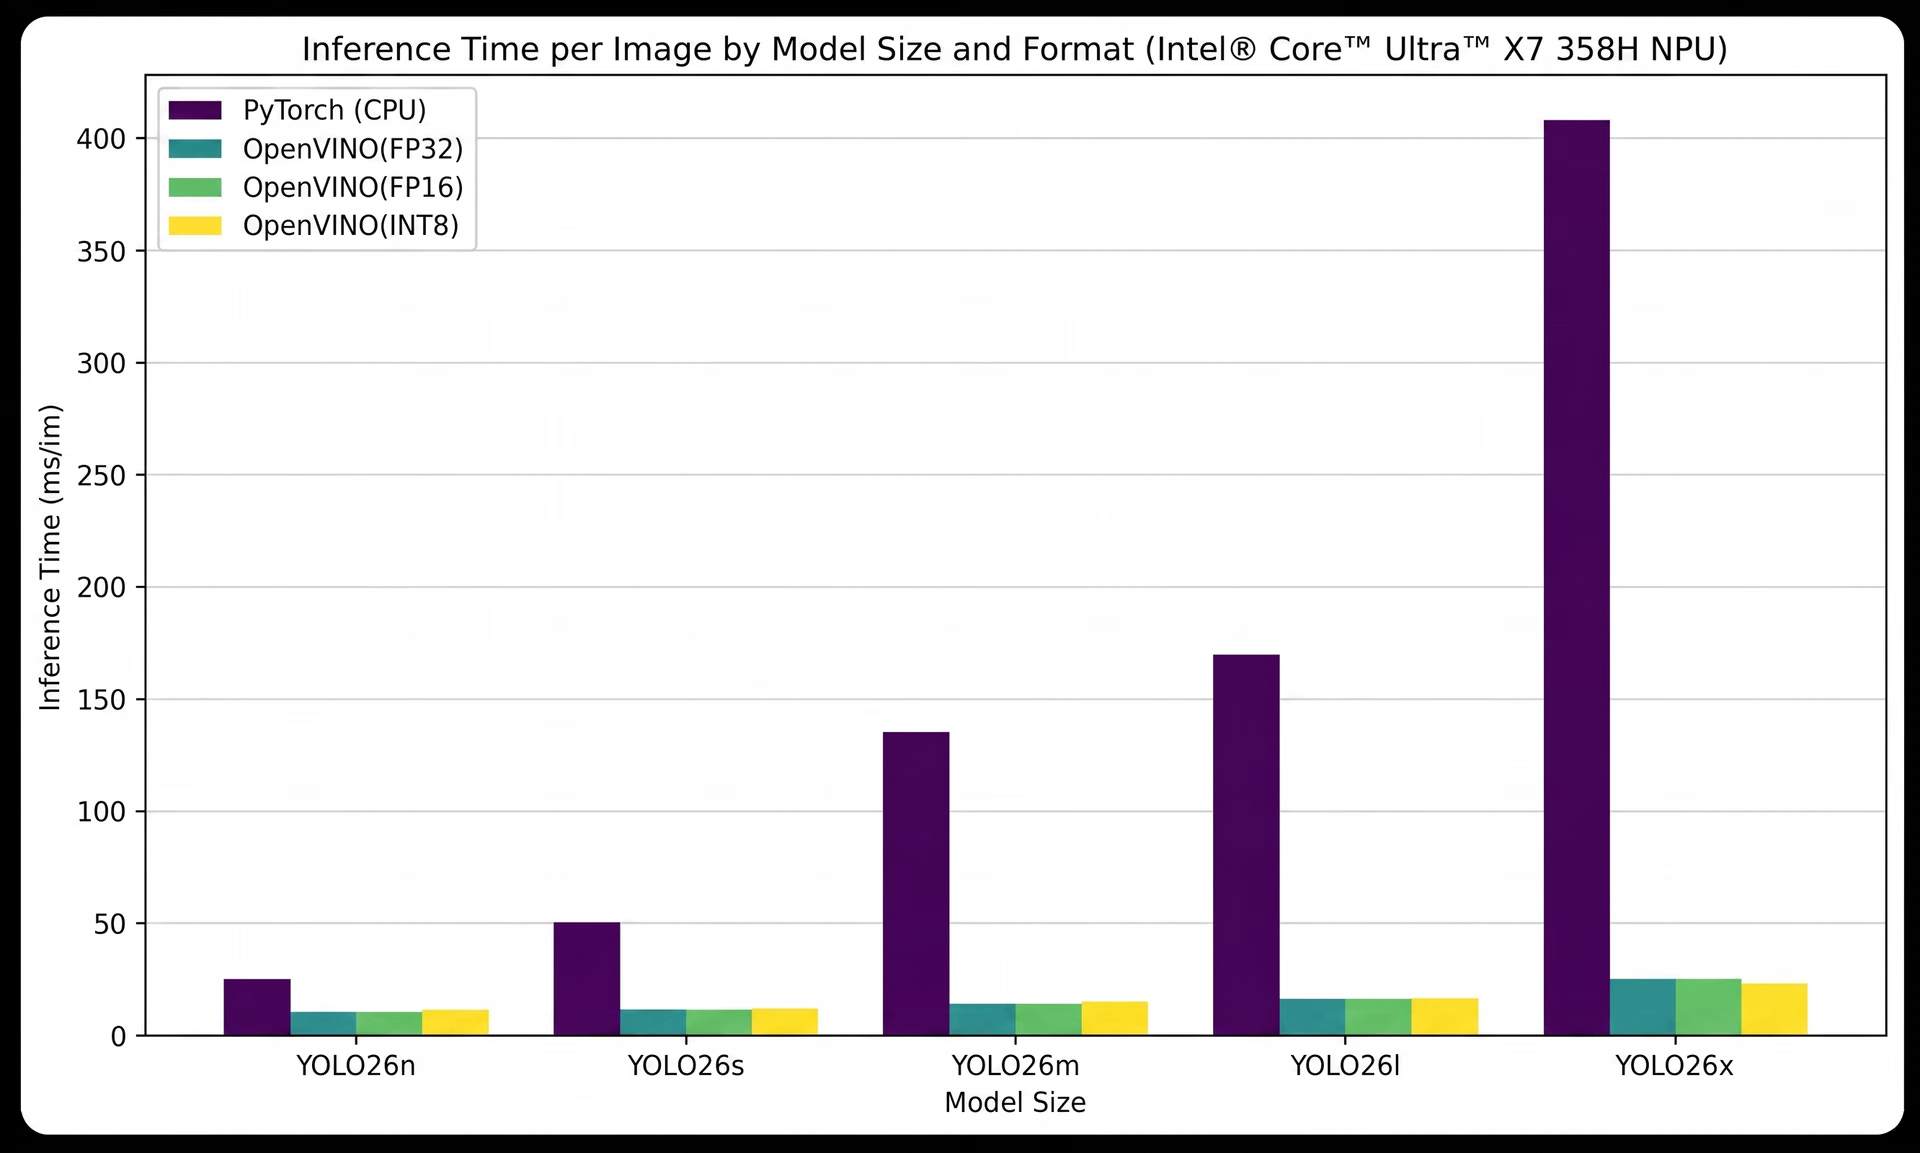
図3. OpenVINOを使用したIntel Panther Lake NPU上でのUltralytics YOLO26推論のベンチマーク(出典)
Ultralytics YOLO26をOpenVINOフォーマットにエクスポートする2つの方法#
YOLO26モデルをOpenVINOフォーマットにエクスポートする方法は主に2つあります。Ultralytics Pythonパッケージを使う方法と、コンピュータービジョンワークフローを一か所で構築・管理できるエンドツーエンドのワークスペースであるUltralytics Platformから直接エクスポートする方法です。以下では、両方の方法を説明します。
Ultralytics Pythonパッケージを使ったYOLO26のエクスポート#
Ultralytics Pythonパッケージを使うと、コードベースのワークフロー内でYOLO26モデルをOpenVINOフォーマットに簡単にエクスポートできます。トレーニングと推論で同じインターフェースを使用するため、追加ツールを導入せずに既存のパイプラインへ自然に組み込めます。
まず、Ultralyticsパッケージをインストールします。ターミナルまたはコマンドプロンプトで「pip install ultralytics」コマンドを実行してください。Jupyter NotebookやGoogle Colabなどの対話型環境を使用している場合は、同じコマンドの先頭に感嘆符を付けて実行できます。
インストール後、トレーニング済みのYOLO26モデルを読み込み、OpenVINOフォーマットに直接エクスポートできます。以下の例では、事前トレーニング済みのYOLO26nモデル(yolo26n.pt)を読み込み、exportメソッドを使ってOpenVINOフォーマットに変換しています。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
コードを実行すると、変換後のモデルが新しいディレクトリに保存され、デプロイに利用できます。
Ultralytics PlatformでYOLO26をエクスポートする#
よりシンプルなノーコードの方法をお探しの場合は、Ultralytics Platformから直接YOLO26モデルをエクスポートできます。このプラットフォームは、コンピュータービジョンのワークフロー全体を単一のワークスペースに集約しているため、追加のセットアップなしでトレーニングからデプロイへ簡単に移行できます。
モデルの準備ができたら、プラットフォーム上でモデルを開き、Exportタブに移動します。そこでエクスポートフォーマットとしてOpenVINOを選択し、必要に応じて画像サイズや精度などの設定を調整できます。
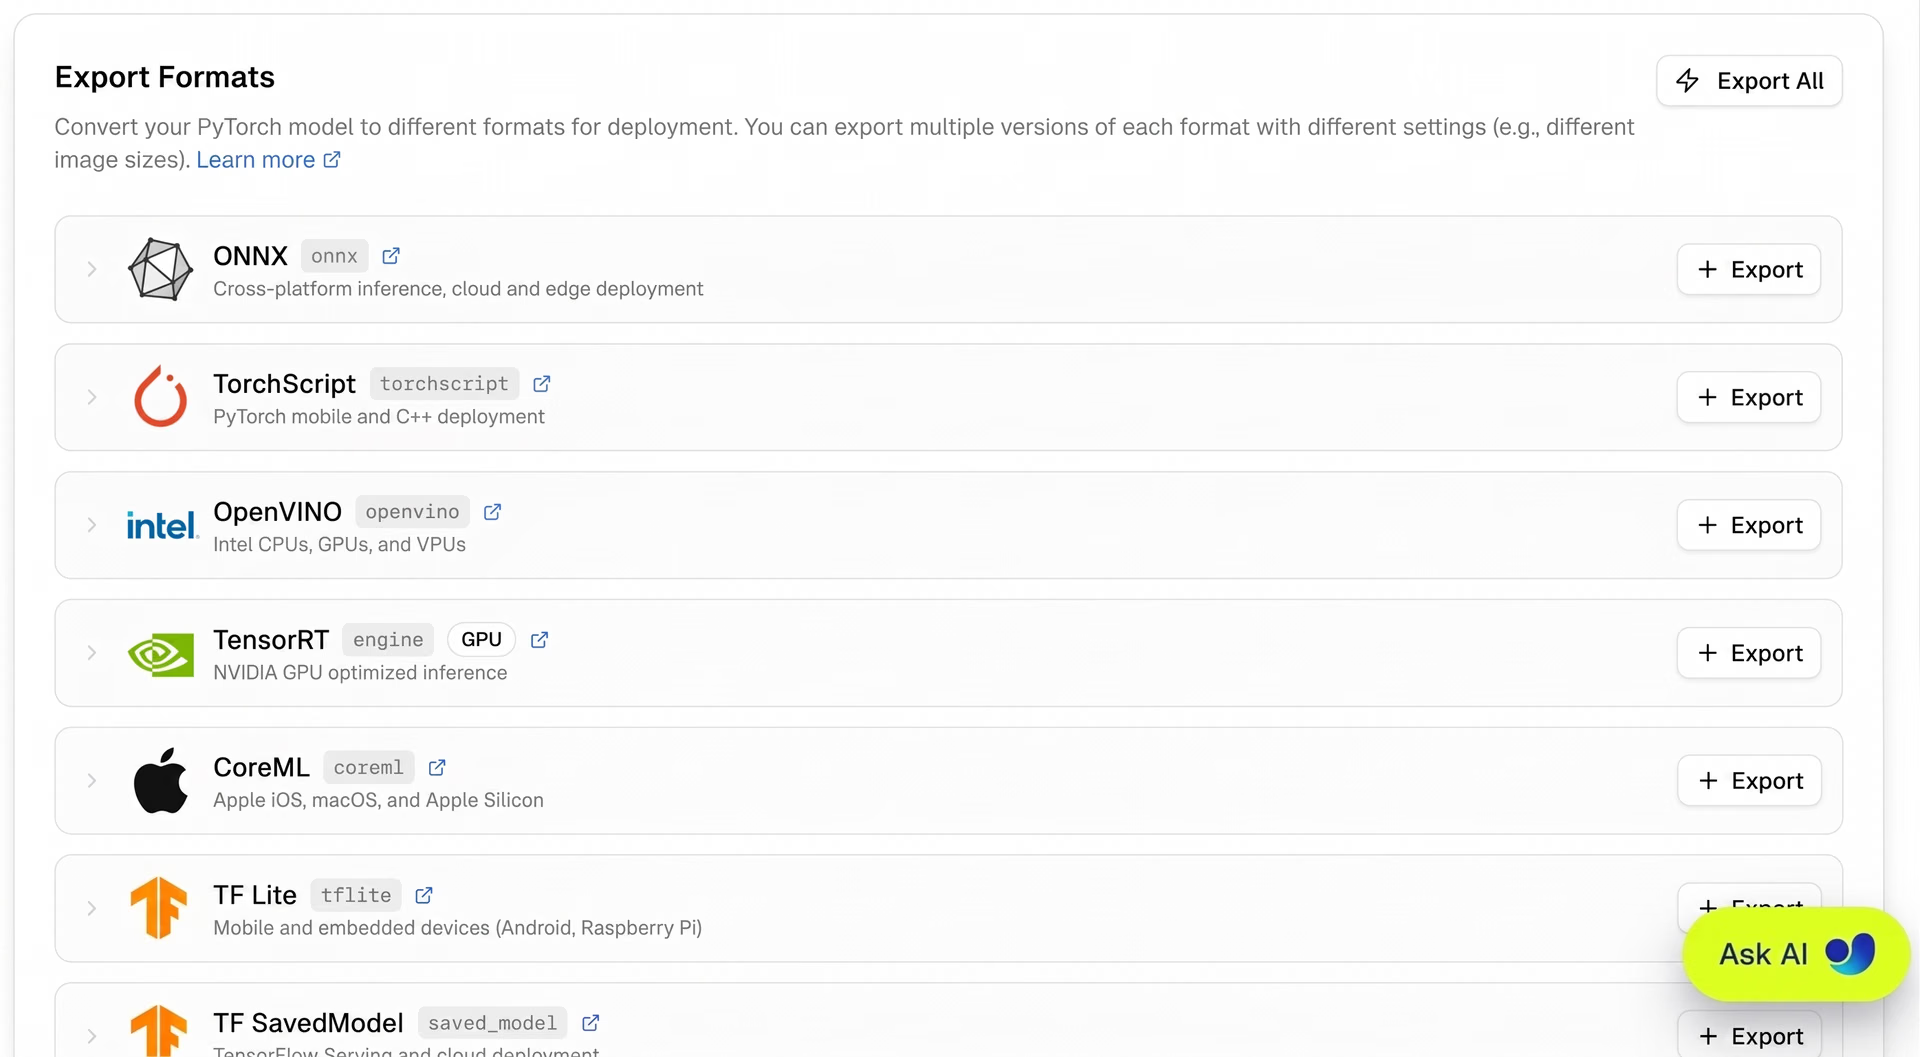
図4. Ultralytics PlatformでYOLO26をエクスポートする画面
プラットフォームが自動的に変換を処理するため、スクリプトや依存関係、環境設定を管理する必要はありません。エクスポートが完了したら、最適化済みモデルをダウンロードし、Intel CPU、GPU、NPUへのデプロイに利用できます。
UltralyticsとOpenVINOの統合によって実現するデプロイ方法#
YOLO26モデルをOpenVINOフォーマットにエクスポートした後は、ワークフローや必要な制御性に応じて、いくつかの方法で推論を実行できます。シンプルで統合された方法としてUltralytics Pythonパッケージを使うか、柔軟性と制御性を高めるためにネイティブのOpenVINOランタイムを使うことができます。
Ultralytics Pythonパッケージを使った推論の実行#
モデルをOpenVINOフォーマットにエクスポートした後は、Ultralytics Pythonパッケージを使って推論を実行できます。トレーニングやエクスポートと同じインターフェースを使用するため、迅速なテストや効率的なデプロイに最適です。
この方法では、ディレクトリからエクスポート済みのOpenVINOモデルを読み込み、画像や動画などの入力に対して推論を実行できます。また、システムで利用可能なハードウェアに応じて、「intel:cpu」、「intel:gpu」、「intel:npu」などのオプションを指定し、実行デバイスを選択できます。
以下のコードスニペットでは、エクスポート済みモデルを読み込み、GPUを指定して画像に対する推論を実行する方法を示しています。推論の完了後、出力画像は「runs/detect/predict」ディレクトリに保存されます。
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")ネイティブOpenVINOパッケージを活用した推論#
本番環境でのモデルの実行方法をより細かく制御する必要がある場合は、推論にネイティブのOpenVINOランタイムを使用できます。この方法は、モデルを大規模なアプリケーションに統合する場合や、特定のハードウェアで推論が実行される方法を細かく調整する場合に便利です。
OpenVINOは、Intel CPU、GPU、NPU全体でモデルを実行する統一的な方法を提供し、非同期実行や利用可能な演算リソースの効率的な活用などの機能にも対応しています。セットアップでは、エクスポートしたモデルファイルを直接使用できます。モデル構造を定義する.xmlファイルと、トレーニング済みの重みを含む.binファイルが含まれます。
用途に応じて、入力サイズや前処理の手順などの設定も調整できます。推論をセットアップするには、OpenVINOランタイムを初期化し、対象デバイス向けにモデルを読み込んでコンパイルし、入力データを準備してから推論を実行します。
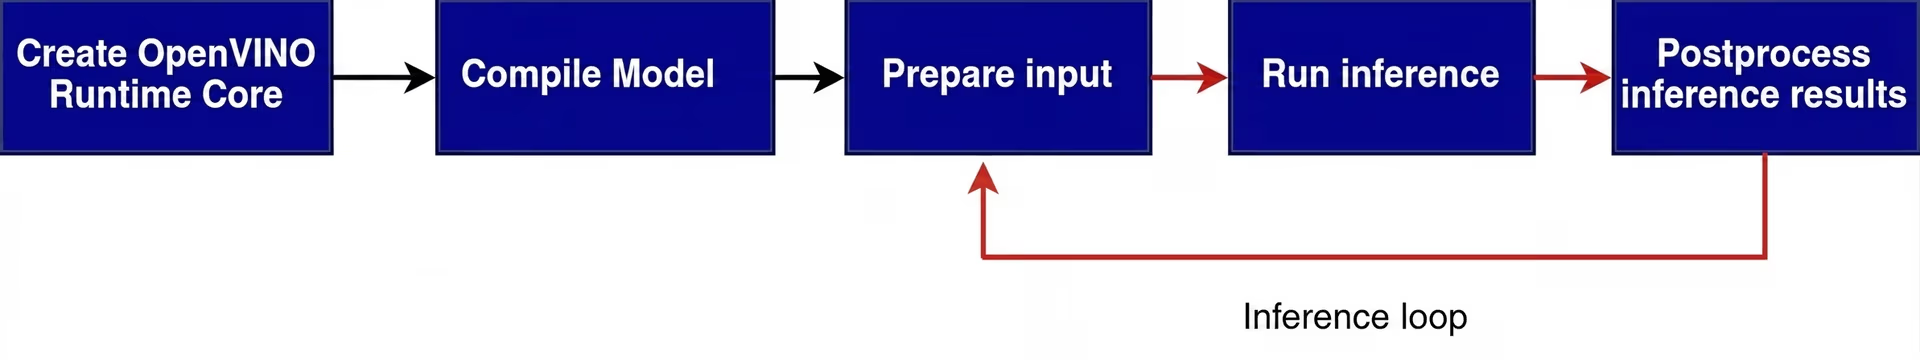
図5. OpenVINOを使った一般的な推論パイプラインの例(出典)
これにより、モデルの実行方法や、全体的なデプロイ環境への組み込み方を制御できます。OpenVINOランタイムを使った推論のセットアップと実行について詳しくは、公式のUltralyticsドキュメントをご覧ください。
Intelハードウェア上でのUltralytics YOLO26の実用例#
UltralyticsとOpenVINOの統合が真価を発揮するのは本番環境です。信頼性の高い低レイテンシ推論が、目に見える成果につながります。この統合が大きな効果をもたらす主な業界をいくつか紹介します。
-
製造業:Ultralytics YOLO26をOpenVINOにエクスポートすると、生産ラインのシステムがIntelハードウェア上で、部品の欠落、位置ずれ、表面の損傷などの外観上の欠陥を自動検出できるため、製品品質の向上とコストのかかるミスの削減に役立ちます。
-
医療:医用画像処理システムや患者モニタリングシステムは、エクスポート済みのUltralytics YOLO26モデルをIntelハードウェア上でローカルに実行できます。これにより、信頼性の高い推論性能を維持しながら、厳格なデータプライバシー要件に対応できます。
-
スマートシティ:交通監視や群衆分析は、Intel搭載のエッジカメラ上でエクスポート済みのUltralytics YOLO26モデルを使って導入できます。車両のカウント、歩行者の追跡、インシデントの検出など、リアルタイムの分析が可能になります。
-
自動車:ドライバーモニタリングや車内センシングでは、低レイテンシと電力効率が重要です。そのため、エクスポート済みのUltralytics YOLO26モデルと組み合わせたIntelハードウェアは、車載組み込みシステムに適しています。
この統合について詳しく知りたい方は、IntelのOpenVINO DevConワークショップシリーズ「アノテーションからデプロイまで:Geti、Ultralytics YOLO26、OpenVINO™を使った物体検出パイプラインの構築」にご参加ください。パートナーシップ&エコシステムマネージャーのFrancesco Mattioliが、IntelのAIソフトウェアエバンジェリストであるAdrian Boguszewskiとともに、実際の産業シナリオ向けに本番環境対応のコンピュータービジョンパイプラインを構築する方法を、ライブデモとウォークスルーで紹介します。このワークショップでは、データセットの作成やモデルのトレーニングから、最適化やエッジデプロイまで、エンドツーエンドの物体検出ワークフローを一通り取り上げます。
OpenVINOエクスポートフォーマットを使用するメリット#
OpenVINOエクスポートフォーマットを使用する主なメリットをいくつか紹介します。
-
導入しやすく、統合も簡単:統合APIと80種類を超えるチュートリアルノートブックにより、OpenVINOを使うと、複雑さを大幅に増すことなく、実験からデプロイへ簡単に移行できます。
-
同じモデルをさまざまなハードウェアで実行:OpenVINOでは、単一のエクスポート済みモデルをサポート対象のIntelハードウェア全体で使用できます。デバイスごとに書き換えたり調整したりする必要はなく、CPU、GPU、NPUにデプロイできます。
-
エクスポート時の最適化を内蔵:OpenVINOにエクスポートすると、PyTorchやTensorFlowなどの一般的なフレームワークのモデルが推論向けの最適化済みフォーマットに変換されるため、別途変換する必要がありません。
-
ハードウェアリソースをより有効に活用:OpenVINOは、Intelハードウェア全体での非同期推論と負荷分散に対応しており、実環境のアプリケーションの効率向上に役立ちます。
ExecuTorchとOpenVINOバックエンドを使ったUltralytics YOLO26の実行#
より厳しい本番環境にUltralytics YOLO26をデプロイする場合は、デバイス上での効率と高度なモデル圧縮を組み合わせた別の選択肢もあります。
デバイス上での推論向けフレームワークであるExecuTorchは、OpenVINOバックエンドに対応しています。これにより、別のエクスポートおよびランタイム経路を通じて、IntelハードウェアにUltralytics YOLO26をデプロイできます。
ExecuTorchがモデルのエクスポートとランタイムでの実行を担当し、OpenVINOがその下層でハードウェアアクセラレーション層として機能して、Intel CPU、GPU、NPU全体で実際の計算を処理します。両者が連携することで、ExecuTorchのポータビリティとデバイス上での効率性に、OpenVINOが提供するハードウェア固有の最適化を組み合わせられます。
この仕組みや、ExecuTorchとOpenVINOバックエンドでUltralytics YOLO26を使い始める方法について詳しくは、最新のExecuTorchとOpenVINOのアップデートを紹介するIntelのブログをご覧ください。
重要なポイント#
UltralyticsとOpenVINOの統合を通じてYOLO26モデルをエクスポートすると、ワークフローを複雑化することなく、Intelハードウェア全体で性能を向上できます。パイプラインを作り直すことなく、トレーニングからデプロイへ移行できます。これにより、実環境のアプリケーションでIntel CPU、GPU、NPU全体にわたってモデルを効率的に実行する、シンプルな方法が実現します。
コミュニティに参加し、GitHubリポジトリを見て、Vision AIについて詳しく学びましょう。コンピュータービジョンプロジェクトを始めるには、ライセンスの選択肢をご覧ください。製造業におけるAIや自動車業界におけるコンピュータービジョンなどのイノベーションに関心がありますか?ソリューションページで詳細をご確認ください。









