Apple Siliconチップ搭載のiOSアプリに最適な物体検出モデル
Apple Silicon搭載のiOSアプリに最適な物体検出モデルを比較します。Ultralytics YOLO26、EfficientDet、MobileNet SSD、CenterNet、NanoDetを取り上げます。
 Abirami Vina11 分で読めます
AndroidデバイスやiPhoneは、日常生活に欠かせない存在になっています。人々は買い物やナビゲーション、写真撮影、製品のスキャン、アプリの利用などに、日々これらのデバイスを使っています。
人工知能の急速な進歩に伴い、多くのスマートフォンに、デバイスのカメラで撮影した画像や動画を認識する機能が搭載されるようになりました。こうした機能を効率よく実行できるかどうかは、基盤となるハードウェアに大きく左右されます。
たとえばAppleのエコシステムでは、iPhone、iPad、Macなどのデバイスに、AシリーズやMシリーズを含むApple Siliconチップが搭載されています。これらのシステムオンチップ(SoC)設計には、中央処理装置(CPU)、グラフィックス処理装置(GPU)、専用の機械学習アクセラレーターが統合されており、AIワークロードのオンデバイス推論を可能にします。
特に、画像分析機能は、画像や動画の視覚情報を機械が解釈・理解できるようにするAI分野であるコンピュータービジョンによって実現されています。これは、物体検出などのタスクを用いて行われます。
具体的には、物体検出モデルは画像を分析し、対象物の周囲にバウンディングボックスを描画して物体を特定します。これらのモデルは、Apple Siliconチップなどのモバイルハードウェア上で効率的に動作するよう最適化できるため、iOSデバイス上でリアルタイムに視覚情報を直接分析できます。
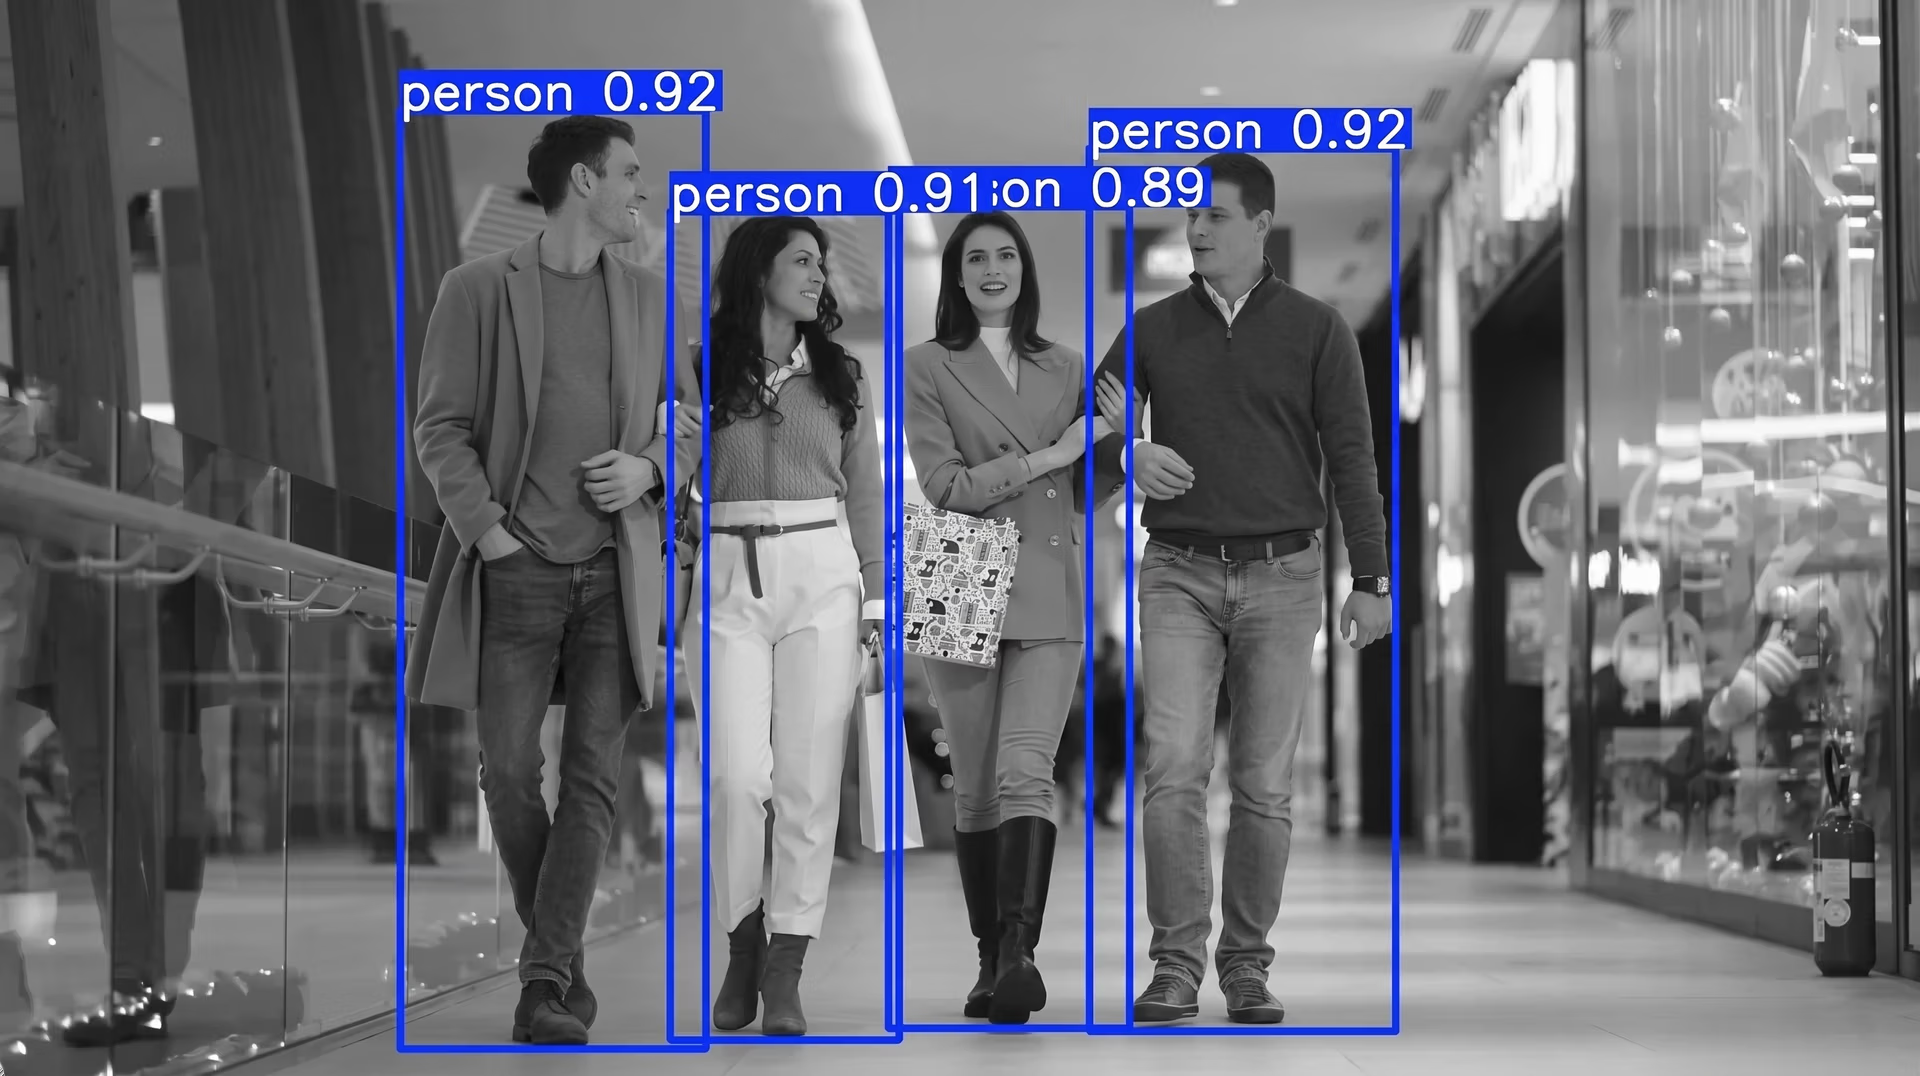
図1. バウンディングボックスで物体を特定する物体検出の例。(出典)
この記事では、高速なリアルタイムiOSアプリの構築に適した、優れた物体検出モデルをいくつか紹介します。
iOSデバイスでの物体検出の仕組み#
物体検出は、アプリが画像内の物体を認識し、その位置を特定するのに役立ちます。アプリが入力画像を処理すると、物体検出モデルはシーンを分析し、物体の周囲にバウンディングボックスを配置してラベルを付けることで、さまざまな物体を特定できます。
ほとんどの物体検出システムは、学習データ内のパターンを認識できるニューラルネットワークを基盤としています。画像タスクでは、これらのモデルは大規模な学習データセットのピクセルレベルの情報を分析し、視覚表現を学習します。
畳み込みニューラルネットワーク(CNNs)は、物体検出モデルのバックボーンとしてよく使われます。CNNsは、エッジ、形状、テクスチャなどの階層的な視覚特徴を学習するため、画像予測に適しています。こうした特徴により、モデルはシーン内の物体を認識できます。
研究者は、コンピュータービジョンタスク向けのTransformerベースのアーキテクチャも研究しています。これらのモデルは、画像内の異なる領域間の関係を分析し、シーン全体のより広範なコンテキスト情報を捉えます。
モデルアーキテクチャの種類に加え、iOSデバイスでの物体検出では効率性も重要な考慮事項です。これらのモデルはモバイルデバイス上で直接実行されるため、限られた計算リソースを使いながら画像を高速に処理する必要があります。
効率的なモデルはレイテンシを低く保ち、モバイルアプリでのリアルタイム物体検出を可能にします。特に、カメラからの連続入力を分析する場合に効果を発揮します。
iOSに適した物体検出モデルとは?#
iOS向けの優れた物体検出モデルをいくつか紹介する前に、まずモバイルアプリケーションに適したモデルの条件を確認しましょう。
iOSアプリに最適な物体検出モデルは、性能、効率性、信頼性のバランスが取れています。iOSへのデプロイに適したモデルを見極める主な要素は次のとおりです。
- 低レイテンシ: 特にカメラからの連続入力に依存するアプリケーションでは、リアルタイムの物体検出を可能にするため、モデルが画像を高速に処理できる必要があります。
- 効率的なモデルサイズ: コンパクトなモデルはモバイルデバイス上でより効率的に動作し、通常、必要なメモリや計算リソースも少なくて済みます。
- 検出精度: 高精度な検出により、物体が正しく分類され、さまざまなシーン、物体のスケール、照明条件においてバウンディングボックスの精度が保たれます。
- 推論の安定性: リアルタイムアプリケーションでは、フレーム間で推論時間が一貫していることが重要です。処理時間が大きく変動すると、フレーム落ちやカメラ体験の不安定さにつながる可能性があります。
- メモリ使用量: 推論時に必要なRAM容量は、iOSデバイス上で他のアプリプロセスと並行してモデルをどれだけスムーズに実行できるかに影響します。
iOSに最適な物体検出モデルを紹介#
次に、iOSデバイスで広く使われている物体検出モデルをいくつか見ていきましょう。
1. Ultralytics YOLOモデル#
Ultralytics YOLOモデルは、リアルタイムのコンピュータービジョンアプリケーション向けに設計された、人気の高い物体検出モデルファミリーです。Ultralyticsはこれまで、Ultralytics YOLOv5、Ultralytics YOLOv8、Ultralytics YOLO11、そして最新の最先端モデルであるUltralytics YOLO26など、さまざまなビジョンモデルをリリースしてきました。
新しいリリースごとに、検出精度、モデル効率、ランタイム性能が改善されています。こうしたアップデートにより、Ultralytics YOLOモデルはスマートフォンなどのエッジデバイスにますます適したものになっています。
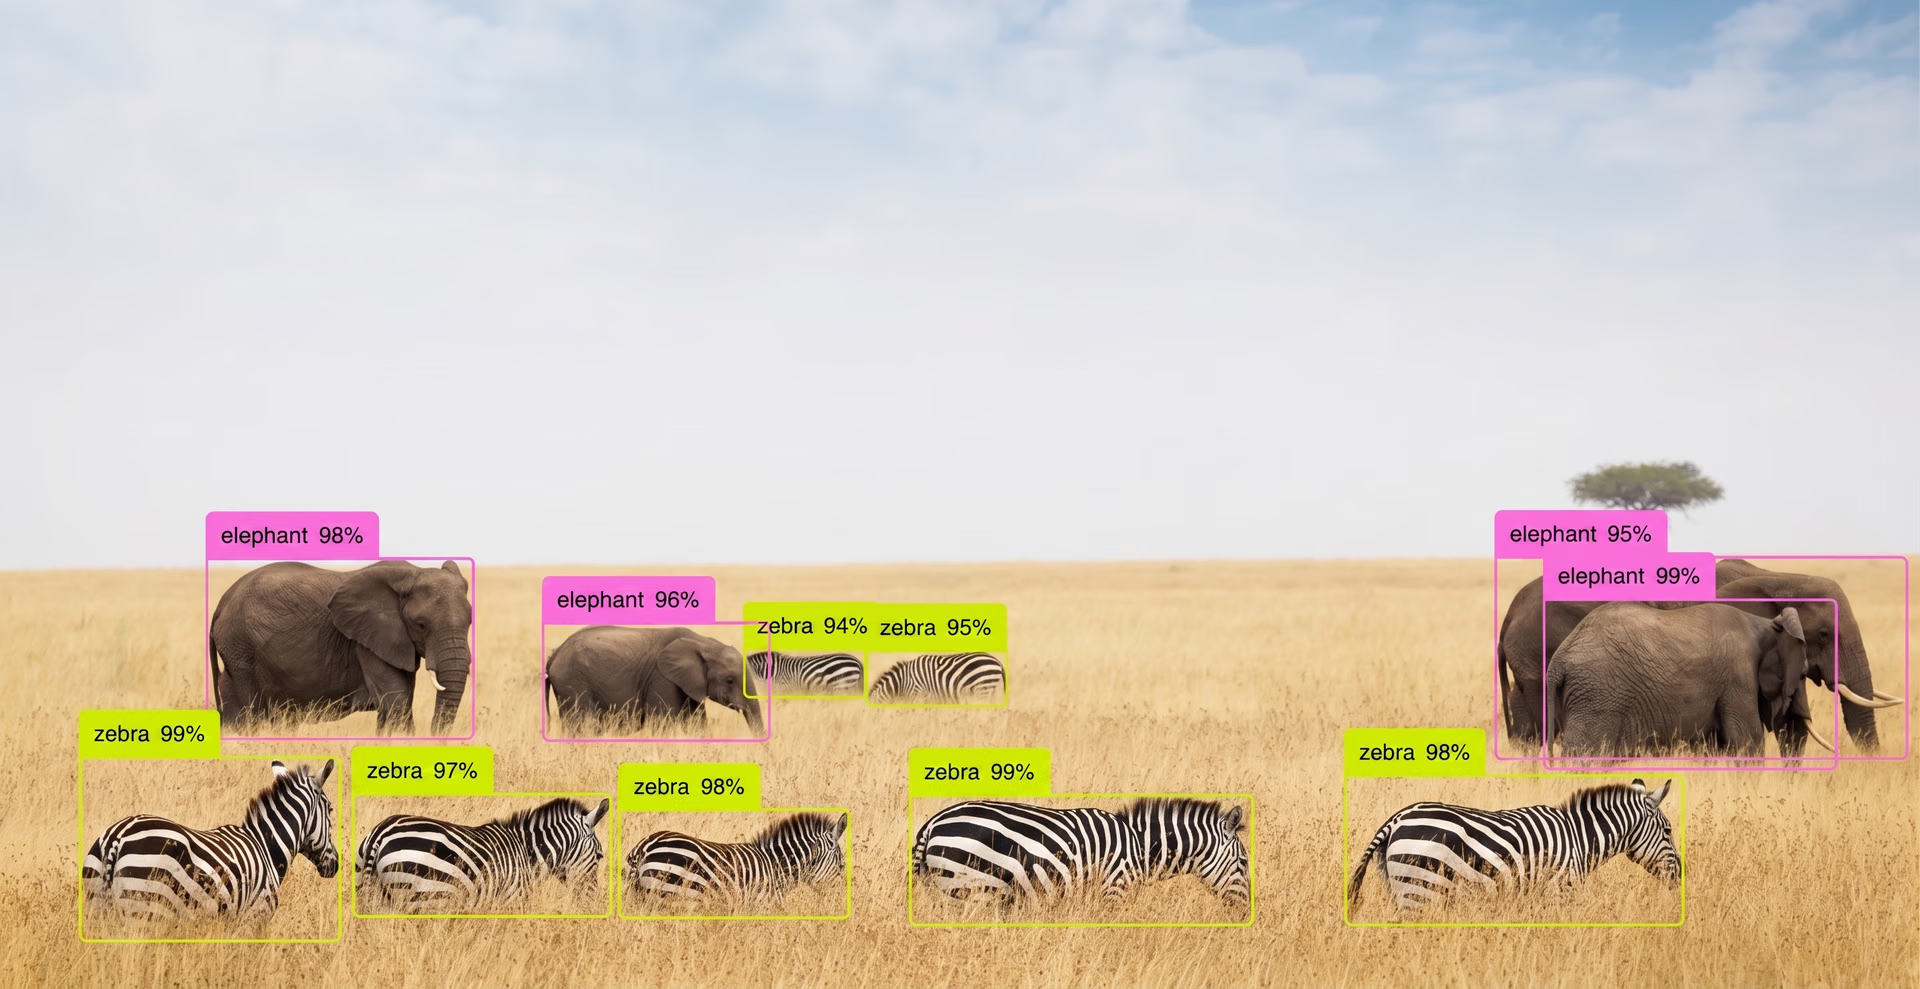
図2. YOLO26を使うと、実環境のシーンで複数の物体を検出できます。(出典)
iOSアプリでUltralytics YOLOモデルを使う主な利点の1つは、Ultralytics Pythonパッケージを通じて提供されるCoreMLとの統合です。このオープンソースライブラリを使うと、シンプルなワークフローでUltralytics YOLOモデルの学習、テスト、エクスポートを行えます。
このパッケージは、Appleの機械学習フォーマットであるCoreMLへのトレーニング済みモデルのエクスポートに対応しており、iOSデバイス上でのモデルのデプロイに使用できます。エクスポート後、CoreMLモデルをアプリに統合し、CPU、GPU、Apple Neural Engineなどのハードウェアを使ってデバイス上で直接実行できます。Ultralyticsモデルは、iOS 27およびmacOS 27向けのAppleの新しいCore AIフォーマットにもエクスポートできますが、Ultralytics iOS SDKでは引き続きCoreMLがデフォルトです。
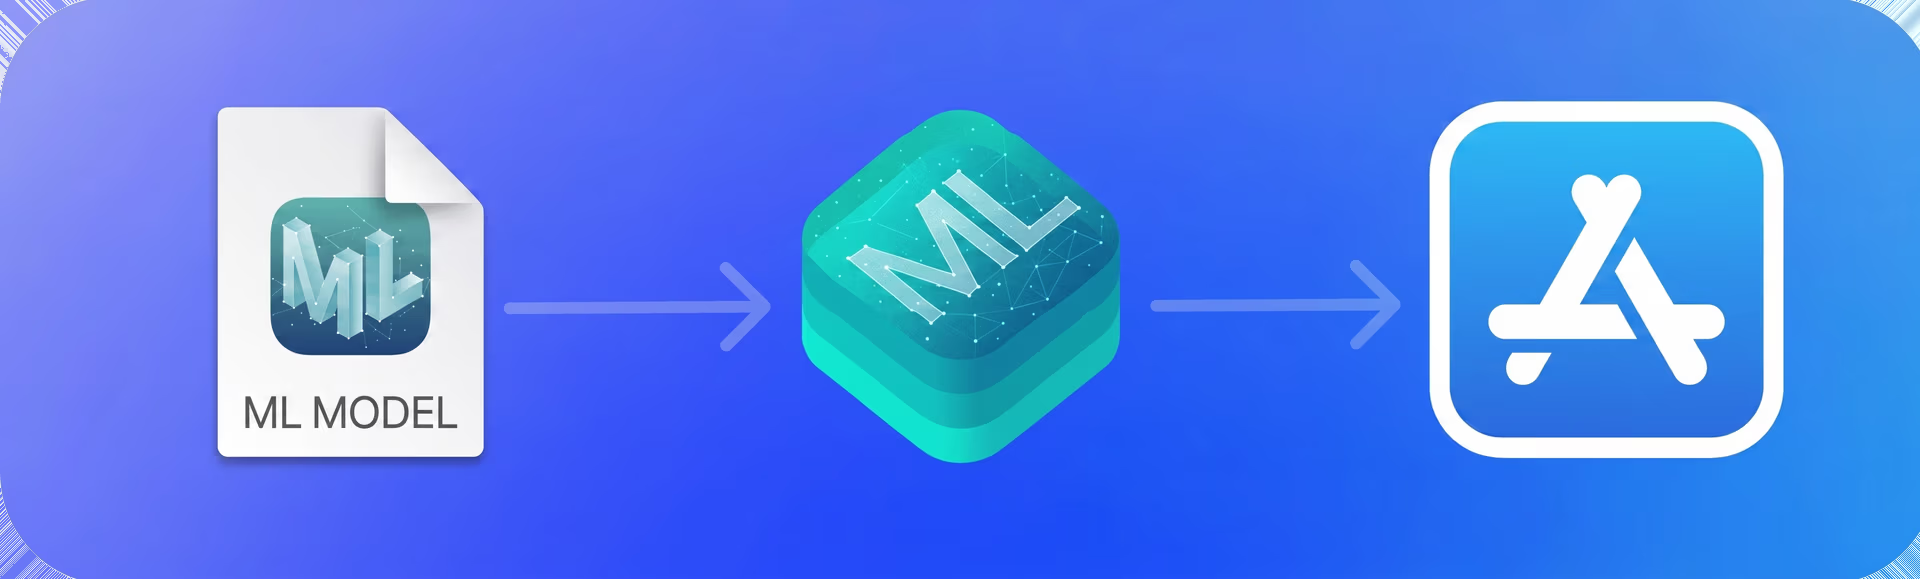
図3. CoreMLは、アプリ内でAIモデルを統合・実行するためのAppleのフレームワークです。(出典)
これにより、モデル推論をデバイス上に保ちながら、iOSアプリにリアルタイム物体検出を簡単に統合できます。
Apple SiliconでのUltralytics YOLOモデルのデプロイ方法#
モデル自体に加えて、Ultralyticsエコシステムには、Apple SiliconチップへのYOLOモデルのデプロイを容易にするさまざまな選択肢があります。
たとえば、Ultralyticsは最近Ultralytics Platformを導入しました。このプラットフォームでは、データセット管理、モデルの学習、検証、デプロイを単一の環境にまとめています。この統合ワークフローにより、複数のツールを使う必要性が減り、実験から実環境のアプリケーションまでの流れを効率化できます。
プラットフォームの機能として、トレーニング済みモデルはAppleデバイス向けのCoreMLなど、複数のフォーマットにエクスポートできます。これにより、数回のクリックでUltralytics YOLOモデルをエクスポートし、デバイス上で推論を実行できます。
エクスポート機能に加え、UltralyticsはiOS向けにオープンソースのSwift(iOSアプリの開発に使われるAppleのプログラミング言語)実装を提供しています。これにはSwiftで記述されたすぐに使えるYOLO iOSアプリが含まれており、CoreMLモデルを統合してカメラ入力で実行し、リアルタイム物体検出に利用する方法を示しています。
Ultralytics YOLOモデルのその他の利点#
Ultralytics YOLOモデルがiOSアプリケーションの開発に適している理由となる、その他の主な特徴を紹介します。
- 幅広いビジョンタスクに対応: Ultralytics YOLOモデルは、物体検出に加えて、インスタンスセグメンテーション、画像分類、姿勢推定、回転バウンディングボックス(OBB)検出、物体追跡にも使用でき、YOLO26はセマンティックセグメンテーションと深度推定にも対応しています。
- 複数のモデルサイズ: Ultralyticsは、開発者がモバイルデバイスの性能制約に合ったバージョンを選べるよう、nano、small、medium、large、extra-largeなど、さまざまなモデルバリアントを提供しています。
- 事前トレーニング済みモデル: Ultralytics YOLOモデルは事前トレーニング済みモデルとして提供され、そのまま使用することも、特定のタスク向けにファインチューニングすることもできるため、開発時間を短縮できます。
2. EfficientDet#
EfficientDetは、Googleの研究者が2019年に発表した物体検出アーキテクチャです。検出精度と計算効率のバランスを取るよう設計されており、リソースが限られた環境に適しています。並列ベンチマークについては、YOLO26とEfficientDetの比較をご覧ください。
EfficientDetの中心的なアイデアは、複合スケーリングと呼ばれるスケーリング手法です。ネットワークの深さや画像解像度など、モデルの一部分だけを拡大するのではなく、この手法ではアーキテクチャの複数の構成要素をまとめてスケーリングします。
これらの要素を同時に調整することで、高精度を重視する構成でも、軽量なデプロイ向けに最適化した構成でも、安定した性能を維持できます。
このアーキテクチャにはEfficientDet-D0からEfficientDet-D7まで複数のバリアントがあります。小型モデルは推論の高速化とリソース使用量の削減を目的としており、大型モデルはより高い検出精度を目指しています。
3. MobileNet SSD#
MobileNet SSDは、モバイルデバイスやエッジデバイス上で効率的に動作するよう設計された軽量な物体検出モデルです。2017年頃に広く普及しました。
このモデルは、効率的な特徴抽出に重点を置くMobileNetバックボーンと、物体検出のためのSSD(Single Shot Detector)方式を組み合わせています。SSD方式では、1回のフォワードパスで物体を検出し、バウンディングボックスを生成します。
この設計によりモデルは比較的高速でシンプルなため、検出結果をすばやく得る必要があるアプリケーションに役立ちます。MobileNet SSDは、モデルサイズの小ささと推論速度の速さが重要な場面でよく使われます。
MobileNetアーキテクチャは必要な計算量を削減するため、処理能力が限られたデバイスでもモデルを実行しやすくなります。MobileNet SSDは新しい検出アーキテクチャの一部ほど高精度ではない場合がありますが、一般的な多くの物体検出タスクで優れた性能を発揮します。
4. CenterNet#
CenterNetは、物体の中心点を予測して物体を特定する物体検出モデルです。2019年に発表されました。
多数の候補領域を生成する代わりに、このモデルは物体の中心を検出し、その周囲のバウンディングボックスのサイズを予測します。この手法により検出パイプラインが簡素化され、推論時に必要な処理ステップが減少します。
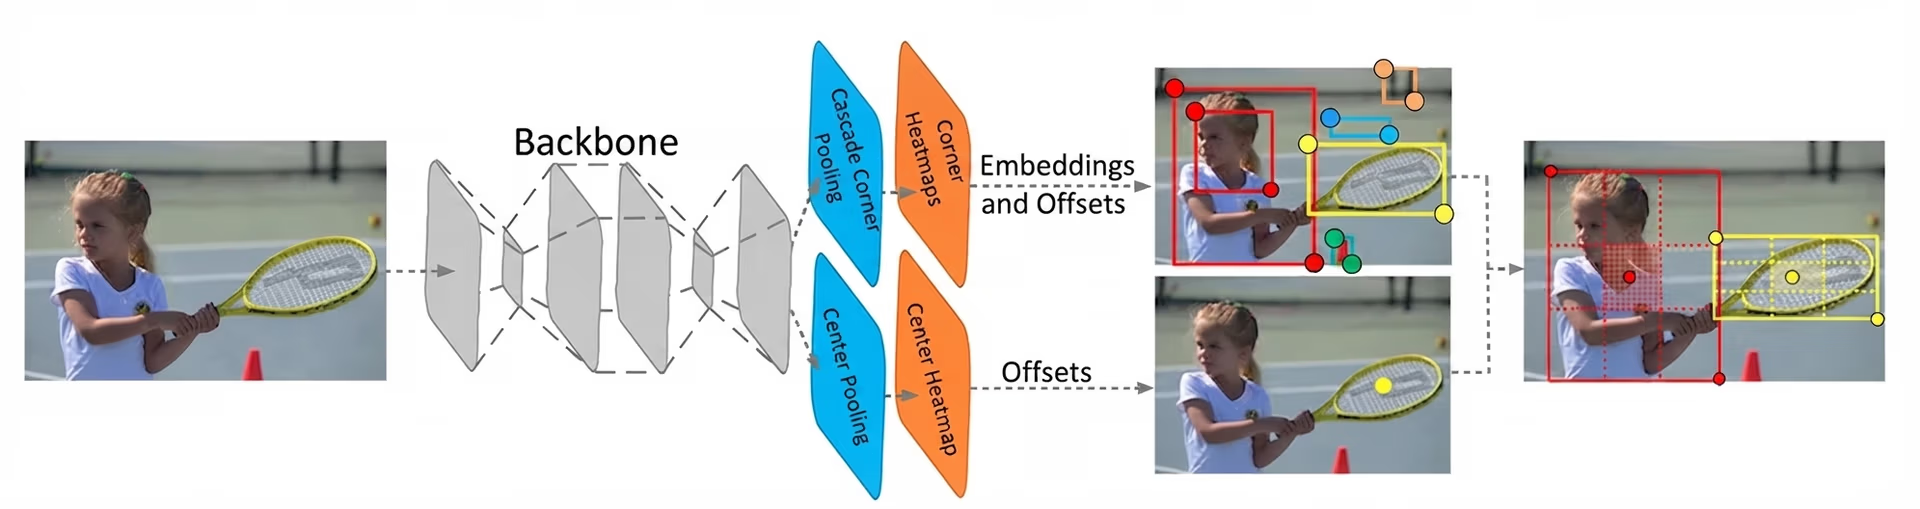
図4. CenterNetにおける物体検出ステージの概要(出典)
CenterNetはリアルタイム検出タスクに利用でき、一部の多段検出器と比べて比較的シンプルなアーキテクチャで知られています。ResNetバックボーンを使ったCenterNetなどのバリアントは、さまざまなコンピュータービジョンアプリケーションで一般的に使われています。
効率的な設計により、CenterNetはiOSデバイス上で動作するアプリケーションなど、高速な物体検出が必要なシステムに適しています。
5. NanoDet#
NanoDetは、エッジデバイスやモバイルデバイス上のリアルタイムアプリケーション向けに設計された軽量な物体検出モデルです。モデルサイズと計算要件を非常に小さく保ちながら効率的な物体検出を実現することを目指し、2020年に発表されました。
このモデルは1段階の検出アーキテクチャを採用しており、ネットワークを1回通過するだけで物体の位置とカテゴリを予測できます。この設計によりモデルの高速性が保たれ、ハードウェアリソースが限られたシステムにも適しています。
NanoDetはコンパクトなバックボーンと最適化された検出ヘッドを使用し、推論時に必要なパラメーター数と計算量を削減します。これらの設計により、速度と効率性を重視しながら、妥当な検出精度を維持できます。
iOSアプリに適した物体検出モデルの選び方#
iOSアプリ向けの物体検出モデルを選ぶ際は、多くの場合、ユースケース固有の要件が判断基準となります。これらのモデルはiPhoneやiPadなどのデバイス上で直接実行されるため、どの選択肢が最適かは複数の要素によって決まります。
考慮すべき主なポイントは次のとおりです。
- 電力効率: 消費電力の少ないモデルはバッテリーを長持ちさせます。これは、カメラ映像を継続的に処理するモバイルアプリにとって重要です。
- モデル最適化のサポート: 一部のモデルは、量子化やプルーニングなどの最適化手法に対応しており、モデルサイズの縮小やiOSデバイスでのパフォーマンス向上に役立ちます。
- ハードウェア互換性: 選択するモデルアーキテクチャは、CPU、GPU、AppleのNeural Engineなど、iOSハードウェア上で効率的に動作する必要があります。
- スケーラビリティ: アーキテクチャによっては、複数のモデルサイズやバリアントが用意されています。これにより、開発者は性能要件とハードウェア要件に最適なバージョンを選べます。
重要なポイント#
物体検出モデルは、スマートモバイルアプリに高度なコンピュータービジョン機能をもたらします。iOSデバイス上で直接動作するこれらのモデルを使うと、アプリはデバイスのカメラから取得した画像や動画をリアルタイムに分析できます。適切なモデルを選ぶことで、信頼性の高いリアルタイム性能を発揮する、応答性に優れたビジョン活用型モバイルアプリを開発できます。
成長を続けるコミュニティに参加し、実践的なAIリソースについてはGitHubリポジトリをご覧ください。今すぐビジョンAIを活用した開発を始めるには、ライセンスの選択肢をご確認ください。農業におけるAIが農業をどのように変革しているか、またロボット工学におけるビジョンAIが未来をどのように形作っているかについては、ソリューションページをご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









