自然言語処理とコンピュータービジョンをつなぐ
自然言語処理(NLP)とコンピュータービジョン(CV)が連携し、よりスマートなクロスモーダルAIシステムで産業をどのように変革できるかをご紹介します。
 Abirami Vina8 分で読めます

自然言語処理(NLP)とコンピュータービジョン(CV)は、近年大きな注目を集めている人工知能(AI)の異なる2つの分野です。AIの進歩により、この2つの分野はかつてないほど密接に結びついています。
その好例が自動画像キャプション生成です。コンピュータービジョンを使って画像の内容を分析し、理解する一方で、自然言語処理を使って画像を説明するキャプションを生成できます。自動画像キャプション生成は、アクセシビリティ向上のためにソーシャルメディアプラットフォームで、また画像の効率的な整理やタグ付けのためにコンテンツ管理システムで広く利用されています。
NLPとビジョンAIの革新により、さまざまな業界で多くのユースケースが生まれています。この記事では、NLPとコンピュータービジョンについて詳しく見て、それぞれの仕組みを解説します。また、これら2つのテクノロジーを組み合わせて活用するアプリケーションも紹介します。
NLPとビジョンAIを理解する#
NLPは、コンピューターと人間の言語とのやり取りに焦点を当てています。機械が意味のある形でテキストや音声を理解、解釈、生成できるようにします。翻訳、感情分析、要約などのタスクに利用できます。
一方、コンピュータービジョンは、機械が画像や動画を分析し、処理するのに役立ちます。写真内の物体検出、顔認識、物体追跡、画像分類などのタスクに利用できます。ビジョンAI技術により、機械は視覚世界をより深く理解し、視覚世界とやり取りできるようになります。
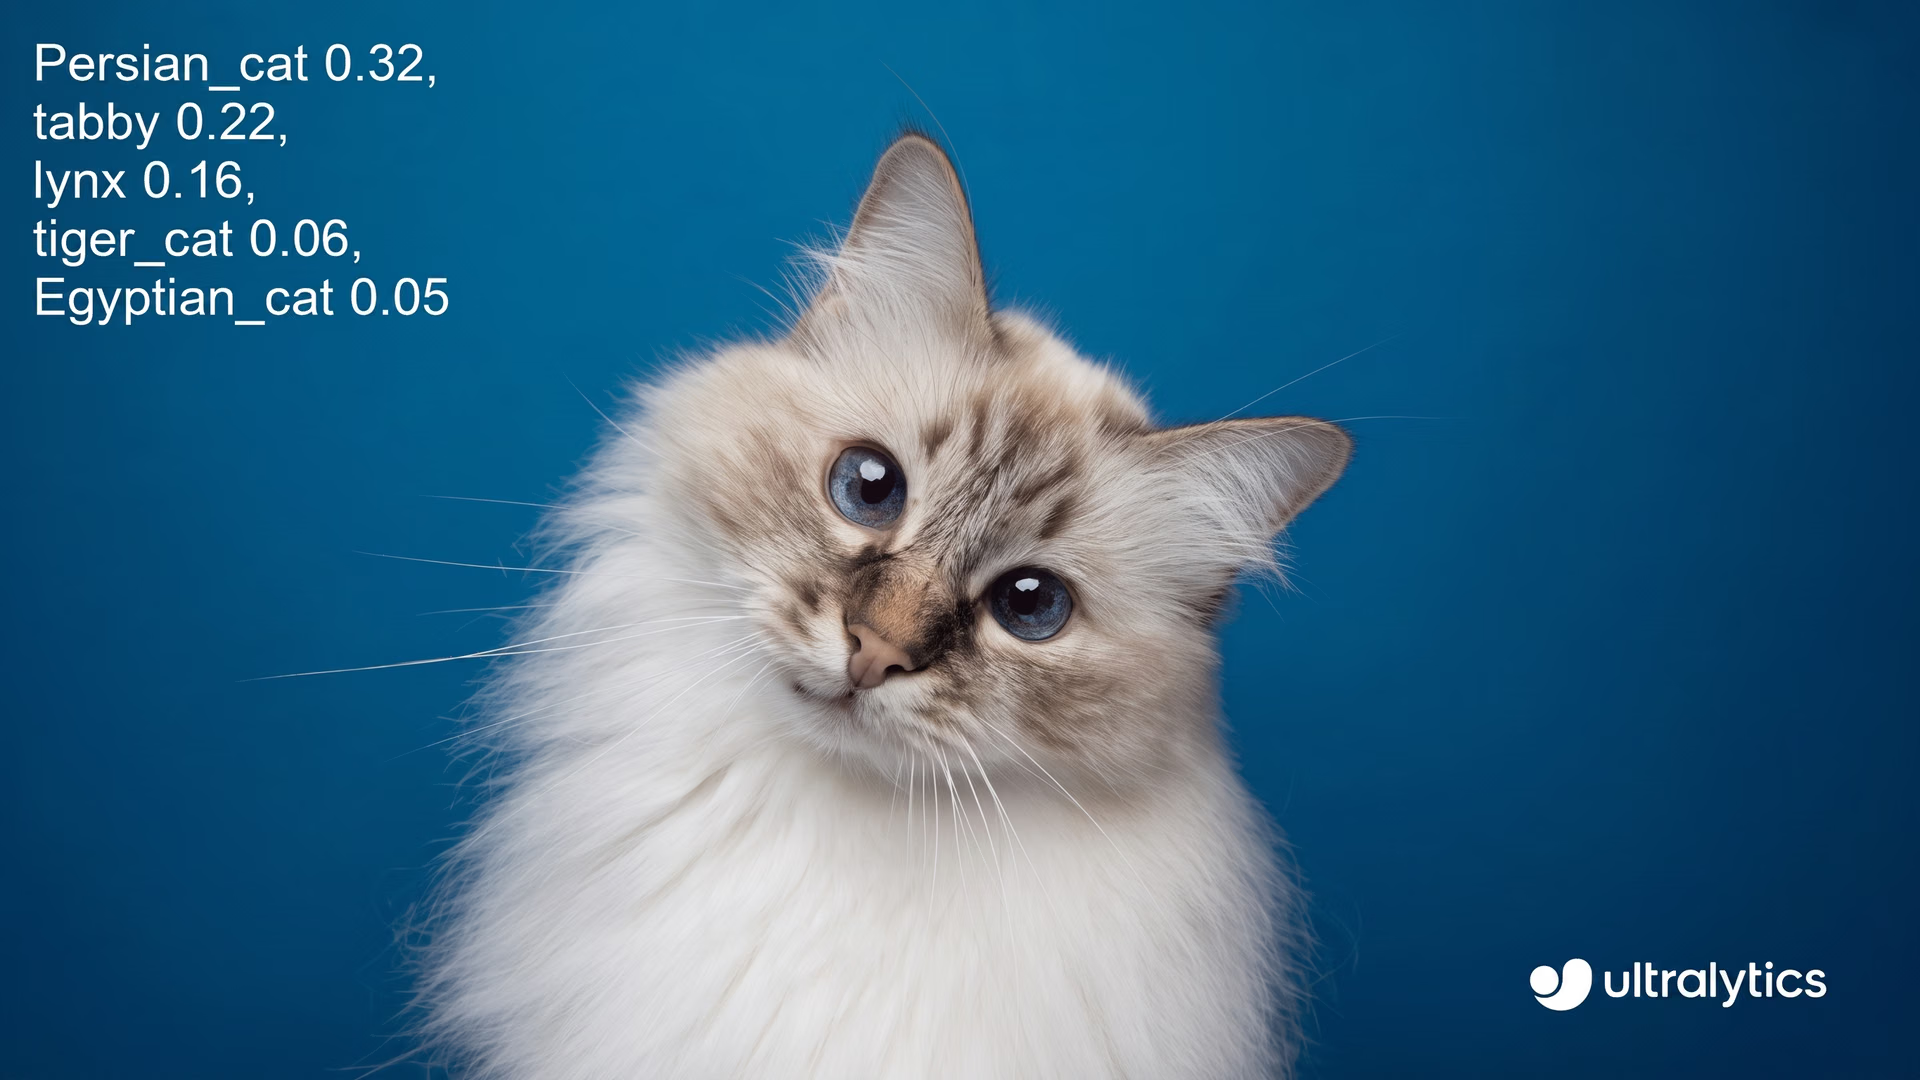
図1. 画像分類の例。
コンピュータービジョンと統合すると、NLPはテキストと画像を組み合わせて視覚データに意味を加え、より深い理解を可能にします。「百聞は一見にしかず」と言われるように、画像にテキストを組み合わせると、さらに強力になり、より豊かな洞察が得られます。
NLPとコンピュータービジョンの連携例#
スマートフォンが画像内のテキストを翻訳する機能など、NLPとコンピュータービジョンが連携する様子を、気づかないうちに日常のツールで目にしているかもしれません。
実際、Google翻訳は自然言語処理とコンピュータービジョンの両方を使って画像内のテキストを翻訳します。別の言語で書かれた道路標識を撮影すると、コンピュータービジョンがテキストを識別して抽出し、NLPが希望する言語に翻訳します。
NLPとCVは連携して処理をスムーズかつ効率的にし、ユーザーが言語を問わず情報をリアルタイムで理解し、やり取りできるようにします。この統合はコミュニケーションの障壁を取り除くのに役立ちます。

図2。Google 翻訳の機能。
NLPとコンピュータービジョンが連携するその他の活用例を紹介します。
- 自動運転車: CVは道路標識、車線、障害物の検出に使えます。一方、NLPは音声コマンドや道路標識のテキストを処理できます。
- 文書リーダー: ビジョンAIはスキャンした文書や手書き文字のテキストを認識し、自然言語処理はその情報を解釈して要約できます。
- ショッピングアプリのビジュアル検索: コンピュータービジョンは写真内の商品を識別し、NLPは検索語を処理しておすすめの精度を高めます。
- 教育ツール: CVは手書きのノートや視覚入力を認識し、NLPはその内容に基づいて説明やフィードバックを提供できます。
コンピュータービジョンとNLPを結び付ける主要概念#
コンピュータービジョンと自然言語処理の活用方法を確認したところで、クロスモーダルAIを可能にする両者の連携について見ていきましょう。
クロスモーダルAIは、コンピュータービジョンによる視覚理解とNLPによる言語理解を組み合わせ、テキストと画像にまたがる情報を処理し、関連付けます。たとえば医療分野では、クロスモーダルAIがX線画像を分析し、潜在的な問題を明確な文章で要約することで、医師がより迅速かつ正確に判断するのに役立ちます。
自然言語理解 (NLU)#
自然言語理解はNLPの一分野であり、意図、文脈、意味、トーン、構造を分析して、テキストを解釈し、その意味を抽出することに焦点を当てています。NLPが生のテキストを処理するのに対し、NLUは機械が人間の言語をより効果的に理解できるようにします。たとえば、構文解析は文章を機械が理解できる構造化形式に変換するNLUの手法です。

図3。NLPとNLUの関係。
視覚データに理解が必要なテキストが含まれている場合、NLUはコンピュータービジョンと連携します。コンピュータービジョンは、光学式文字認識 (OCR)などの技術を使って、画像、文書、動画からテキストを抽出します。レシートのスキャン、標識の文字の読み取り、手書きのメモのデジタル化などのタスクが含まれます。
続いてNLUが抽出したテキストを処理し、その意味、文脈、意図を理解します。この組み合わせにより、システムはテキストを認識するだけでなく、さらに多くのことができるようになります。レシートから経費を分類したり、口調や感情を分析したりできます。コンピュータービジョンとNLUを組み合わせることで、視覚的なテキストを意味のある実用的な情報に変換できます。
プロンプトエンジニアリング#
プロンプトエンジニアリングとは、大規模言語モデル(LLM)や視覚言語モデル(VLM)などの生成AIシステムに望ましい出力を生成させるため、明確で正確かつ詳細な入力プロンプトを設計するプロセスです。プロンプトは指示として機能し、AIモデルがユーザーの意図を理解するのに役立ちます。
効果的なプロンプトエンジニアリングには、モデルの能力を理解し、正確で創造的、あるいは洞察に富んだ回答を生成する能力を最大限に引き出す入力を作成することが必要です。テキストと画像の両方を扱うマルチモーダルモデルでは、特に重要です。
OpenAIのテキスト画像変換モデルDALL·Eを例に考えてみましょう。「馬に乗る宇宙飛行士のフォトリアルな画像を作成して」と指示すると、その説明に基づいてまさにその画像を生成できます。これはグラフィックデザインなどの分野で役立ち、専門家はテキストのアイデアをすばやくビジュアルモックアップに変換して、時間を節約し、生産性を高められます。

図4。OpenAIのDALL-Eを使用して作成した画像。
これがコンピュータービジョンとどう関係するのか、疑問に思うかもしれません。これは単なる生成AIではないのでしょうか。実際、この2つは密接に関係しています。生成AIはコンピュータービジョンの基盤を活用し、まったく新しい視覚的な出力を作成します。
テキストプロンプトから画像を作成する生成AIモデルは、テキストの説明と画像を組み合わせた大規模なデータセットで学習します。これにより、言語と、物体、質感、空間的な関係性などの視覚的な概念との関連性を学習できます。
これらのモデルは、現実世界の画像内の物体を認識する従来のコンピュータービジョンシステムと同じ方法で視覚データを解釈するわけではありません。その代わり、学習した概念の理解を使い、プロンプトに基づいて新しいビジュアルを生成します。この知識と適切に作成されたプロンプトを組み合わせることで、生成AIはユーザーの入力に合った、リアルで詳細な画像を作成できます。
質問応答 (QA)#
質問応答システムは、自然言語の質問を理解し、正確で関連性の高い回答を提供するように設計されています。情報検索、意味理解、ディープラーニングなどの技術を使って、質問を解釈し、回答します。
OpenAIのGPT-4oのような高度なモデルは、視覚的質問応答(VQA)に対応し、画像を分析して質問に回答できます。ただし、GPT-4oはコンピュータービジョンタスクを直接実行するわけではありません。専用の画像エンコーダーを使って画像を処理し、特徴を抽出して、言語理解と組み合わせることで回答を提供します。

図5. ChatGPTの視覚的な質問応答機能。画像は著者によるものです。
コンピュータービジョン機能を完全に統合し、さらに高度な処理を行えるシステムもあります。こうしたシステムは画像や動画を直接分析し、物体、シーン、テキストを識別できます。自然言語処理と組み合わせると、視覚コンテンツに関するより複雑な質問にも対応できます。たとえば、視覚要素を検出して解釈し、「この画像には何が写っていますか?」や「この映像に映っているのは誰ですか?」といった質問に回答できます。現在の視覚言語モデルが画像内の物体をどの程度正確に特定できるかは、VLMリーダーボードをご覧ください。
ゼロショット学習 (ZSL)#
ゼロショット学習(ZSL)は、AIモデルが特定のタスクについてトレーニングされていなくても、未知の新しいタスクに対応できる機械学習手法です。説明や意味的な関係などの追加情報を使って、モデルがすでに知っている情報(既知クラス)と、未知の新しいカテゴリを結び付けます。
自然言語処理では、ZSLは単語と概念の関係を利用し、モデルがトレーニングされていないトピックを理解して扱えるようにします。同様に、コンピュータービジョンでは、翼や羽毛などの視覚的特徴を鳥などの既知の概念と関連付けることで、これまで見たことのない物体やシーンを認識できます。
ZSLは言語理解と視覚認識を組み合わせてNLPとCVを結び付けるため、両方を必要とするタスクで特に役立ちます。たとえば、視覚的な質問応答では、モデルが画像を分析しながら関連する質問も理解し、正確に回答できます。画像キャプション生成などのタスクにも有用です。
重要なポイント#
自然言語処理とコンピュータービジョンを組み合わせることで、テキストと画像の両方を理解できるAIシステムが生まれました。この組み合わせは、自動運転車による道路標識の読み取りから、医療診断の改善、ソーシャルメディアの安全性向上まで、さまざまな業界で活用されています。これらのテクノロジーが進歩するにつれて、暮らしをより便利にし、幅広い分野で新たな機会を生み出し続けるでしょう。詳しくは、GitHubリポジトリをご覧になり、コミュニティにご参加ください。ソリューションページでは、自動運転車や農業におけるAIの活用例をご覧いただけます。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









