YOLO26の物体検出におけるJetson Orin Nano SuperとRaspberry Pi 5の比較
YOLO26nの推論時間は、別々のテストでJetson Orin Nano Super(TensorRT FP16)では4.57 ms、Pi 5のCPUでは67.03 msです。モデル、FPS、カメラの台数に応じて選択してください。
 Onuralp Sezer16 分で読めます
物体検出をRaspberry Pi 5とNVIDIA Jetson Orin Nanoのどちらで実行すべきでしょうか。カメラが1台で、目標フレームレートが低く、小型モデルを使う場合は、Pi 5のCPUで十分なことがあります。公開ベンチマークでは、NCNNにエクスポートしたUltralytics YOLO26nは、4つのArmコアで画像1枚あたり67.03 ms、推論FPSにして約15 FPSです。Piで実現できる値よりも多くのカメラ、大きなモデル、または高いフレームレートの余裕が必要な場合は、Jetsonが適しています。Jetson Orin Nano Super Developer Kitでは、同じモデルのTensorRT FP16エンジンの処理時間は4.57 msです。
Ultralyticsはこの比較を公開し、両方のボードで動作するYOLO26を開発していますが、どちらのボードも製造していません。Jetsonの数値はNVIDIAのエントリーレベルのOrin開発キットであるOrin Nano Super Developer Kit、Piの数値はRaspberry Pi 5で、それぞれ別々に測定したものです。現在も、2019年に発売された初代ボードの「Jetson Nano」を検索する人は多くいます。JetPack 4を介してYOLO26を実行できますが、JetsonガイドにはこのボードのYOLO26ベンチマークがないため、ここでは仕様のみを掲載しています。
以下では、モデルサイズ、目標フレームレート、カメラストリーム数によるボードの比較、カメラを増やすとFPSが低下する理由、両方のボードを自分で測定する方法、プロジェクトに適したボードについて説明します。セットアップ手順はNVIDIA JetsonガイドとRaspberry Piガイドに記載しています。また、Raspberry Pi 5のCPUで物体検出を行う方法の解説では、Pi側について詳しく説明しています。
Pi 5はCPUでYOLOを実行し、Orin Nano SuperはGPUを搭載しています#
両ボードは異なるシリコンで同じ課題を解決します。Raspberry Pi 5は4つのArm Cortex-A76コアを備えた汎用コンピューターで、専用のAIアクセラレーターはありません。そのため、PiのベンチマークではCPU上でYOLOを実行します。Jetson Orin Nano Super Developer Kitは、Ampere GPUを搭載したOrin Nanoモジュールとキャリアボードを組み合わせています。NVIDIAのTensorRTランタイムは、このGPU向けにモデルをコンパイルします。これは、この種のワークロード向けに設計されたエッジAIプラットフォームです。
| Jetson Nano 4GB(2019年) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| YOLO向けコンピューティング性能 | 128コアMaxwell GPU | 1024コアAmpere GPU、Tensor Core 32基 | 4コアArm Cortex-A76 CPU |
| CPU | 4コアCortex-A57、1.43 GHz | 6コアCortex-A78AE、最大1.7 GHz | 4コアCortex-A76、最大2.4 GHz |
| メモリ | 4 GB LPDDR4、25.6 GB/s | 8 GB LPDDR5、102 GB/s | モデルによって異なります |
| AI性能(NVIDIAのピーク値) | 472 GFLOPS | 67スパースINT8 TOPS | — |
| JetPack / OS | JetPack 4のみ | JetPack 5~7 | Raspberry Pi OS |
| Ultralyticsのデプロイ方法 | DeepStreamを含むTensorRT | TensorRT(当社のベンチマークで最速) | NCNN(当社のベンチマークで最速) |
仕様であり、測定値ではありません。2026年11月19日に確認しました。NVIDIAのピーク値は数値の形式が異なるため、直接比較できません。Orin Nano Superの67 TOPSはsparse INT8の値です。NVIDIAはdenseで33 TOPSとしています。Jetsonの各項目はNVIDIA Jetsonガイドの比較表とJetPack表、およびDeepStreamガイドに基づいています。Pi 5の各項目はRaspberry Piのドキュメントに基づいています。
消費電力も選択の際に考慮する必要があります。NVIDIAはOrin Nano Super Developer Kitの消費電力を7 W~25 Wとしています。Super対応構成を書き込んだボードでは、Orin Nano 8GBは15 W、25 W、MAXN SUPERの電力モードを使用できます。デフォルト構成では、従来の7 Wおよび15 Wモードが維持されます。どちらのボードを選ぶ場合も、カメラを接続した状態でシステム全体の消費電力を測定してください。電源と筐体が処理する必要があるのは、その総消費電力です。
ボード単体ではなく、ストレージ、電源、冷却機構、カメラを含めたシステム全体の費用を見積もってください。どちらの場合も、これらの費用は積み重なります。Raspberry Piは、メモリ価格の上昇に伴い、2026年にPi 5の価格を複数回引き上げました。2026年11月時点で、2GB版Pi 5の価格は77.50ドル、16GBボードの価格は385ドルです。Jetsonの最新価格と在庫状況は、NVIDIAの開発キットページで確認してください。また、Piに必要なアクセラレーター(Raspberry Pi AI HAT+など)の費用も加算してください。本番環境向けに、NVIDIAは独自のキャリアボードに搭載するJetsonモジュールを販売しています。ベンチマークに使用した開発キットは、開発およびプロトタイピング向けです。
Pi 5のCPUは低FPSのYOLO26nワークロードに適しています#
必要なフレームレートが低ければ、Pi 5は追加のハードウェアなしで単眼カメラの検出に対応できます。Ultralyticsのベンチマーク(FP32エクスポート、入力サイズ640ピクセル、COCO128、Ultralytics 8.4.108、推論時間のみ)では、NCNNが最速のエクスポート形式で、YOLO26nは画像1枚あたり67.03 ms、mAP50-95は0.4784でした。これは推論FPSにして約15 FPSであり、高速な動体を必要としない計数ステーション、棚の監視カメラ、ロボットのプロトタイプなどに適しています。推論時間だけでなく、カメラパイプライン全体を検証してください。ArmもPi 5上でYOLO26nを実行するオープンソースのランタイムを公開しており、独自のテストではNCNNより高速と測定しています。Raspberry Pi 5の解説では、両者を比較しています。
Piでは、モデルサイズが大きくなると処理が難しくなります。より大きなYOLO26sは、Pi 5上でNCNNを使うと172.88 msかかり、推論FPSは6 FPS未満です。Raspberry Piガイドの複数形式の比較(Ultralytics 8.4.108)の対象は、nとsのみです。古いONNX比較(Ultralytics 8.4.14)ではm、l、xも測定しており、YOLO26mは993.78 msでした。小さな物体や識別が難しいクラスのために大きなモデルや高い入力サイズが必要な場合は、採用を決める前にそのモデルをボードでテストしてください。
Pi 5にAI HAT+を追加する#
検討すべき構成がもう1つあります。Raspberry PiのAI HAT+をPi 5に追加すると、13 TOPS版または26 TOPS版のHailoアクセラレーターを利用できます。UltralyticsのHailo統合ベンチマーク(Ultralytics 8.4.174、COCO128)では、26 TOPSのHailo-8版向けにエクスポートしたYOLO26nは、画像1枚あたり21.7 ms、mAP50-95は0.455でした。同じPiで、エクスポートしていないPyTorchモデルを実行した場合は364.6 msでした。このテストでは入力サイズが記載されておらず、INT8で実行されています。そのため、以下の比較表の項目とは別のベンチマークとして扱ってください。Hailoモデルにはコンパイル工程が必要なので、エクスポート後に独自の画像で精度を確認してください。
Orin Nano Superでは、YOLO26nからYOLO26lまでの推論時間が18 ms未満です#
Jetsonでは、より大きなモデルも実用的になります。Orin Nano Super Developer KitでのUltralyticsベンチマーク(入力サイズ640ピクセル、COCO128、Ultralytics 8.4.33、推論のみ)では、nからlまでのすべてのサイズが、TensorRT FP16エンジンで画像1枚あたり18 ms未満でした。
| YOLO26モデル | Raspberry Pi 5のCPU(ms/画像) | Orin Nano Super、TensorRT FP16(ms/画像) | Orin Nano SuperのmAP50-95、FP16 |
|---|---|---|---|
| YOLO26n | 67.03(NCNN FP32、8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88(NCNN FP32、8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78(旧ONNXテスト、8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46(旧ONNXテスト、8.4.14) | 17.42 | 0.6225 |
公開結果は別々のテストに基づいています。Orin Nano Super:Ultralytics 8.4.33。すべて入力サイズ640ピクセル、推論時間のみで、前処理と後処理は含みません。
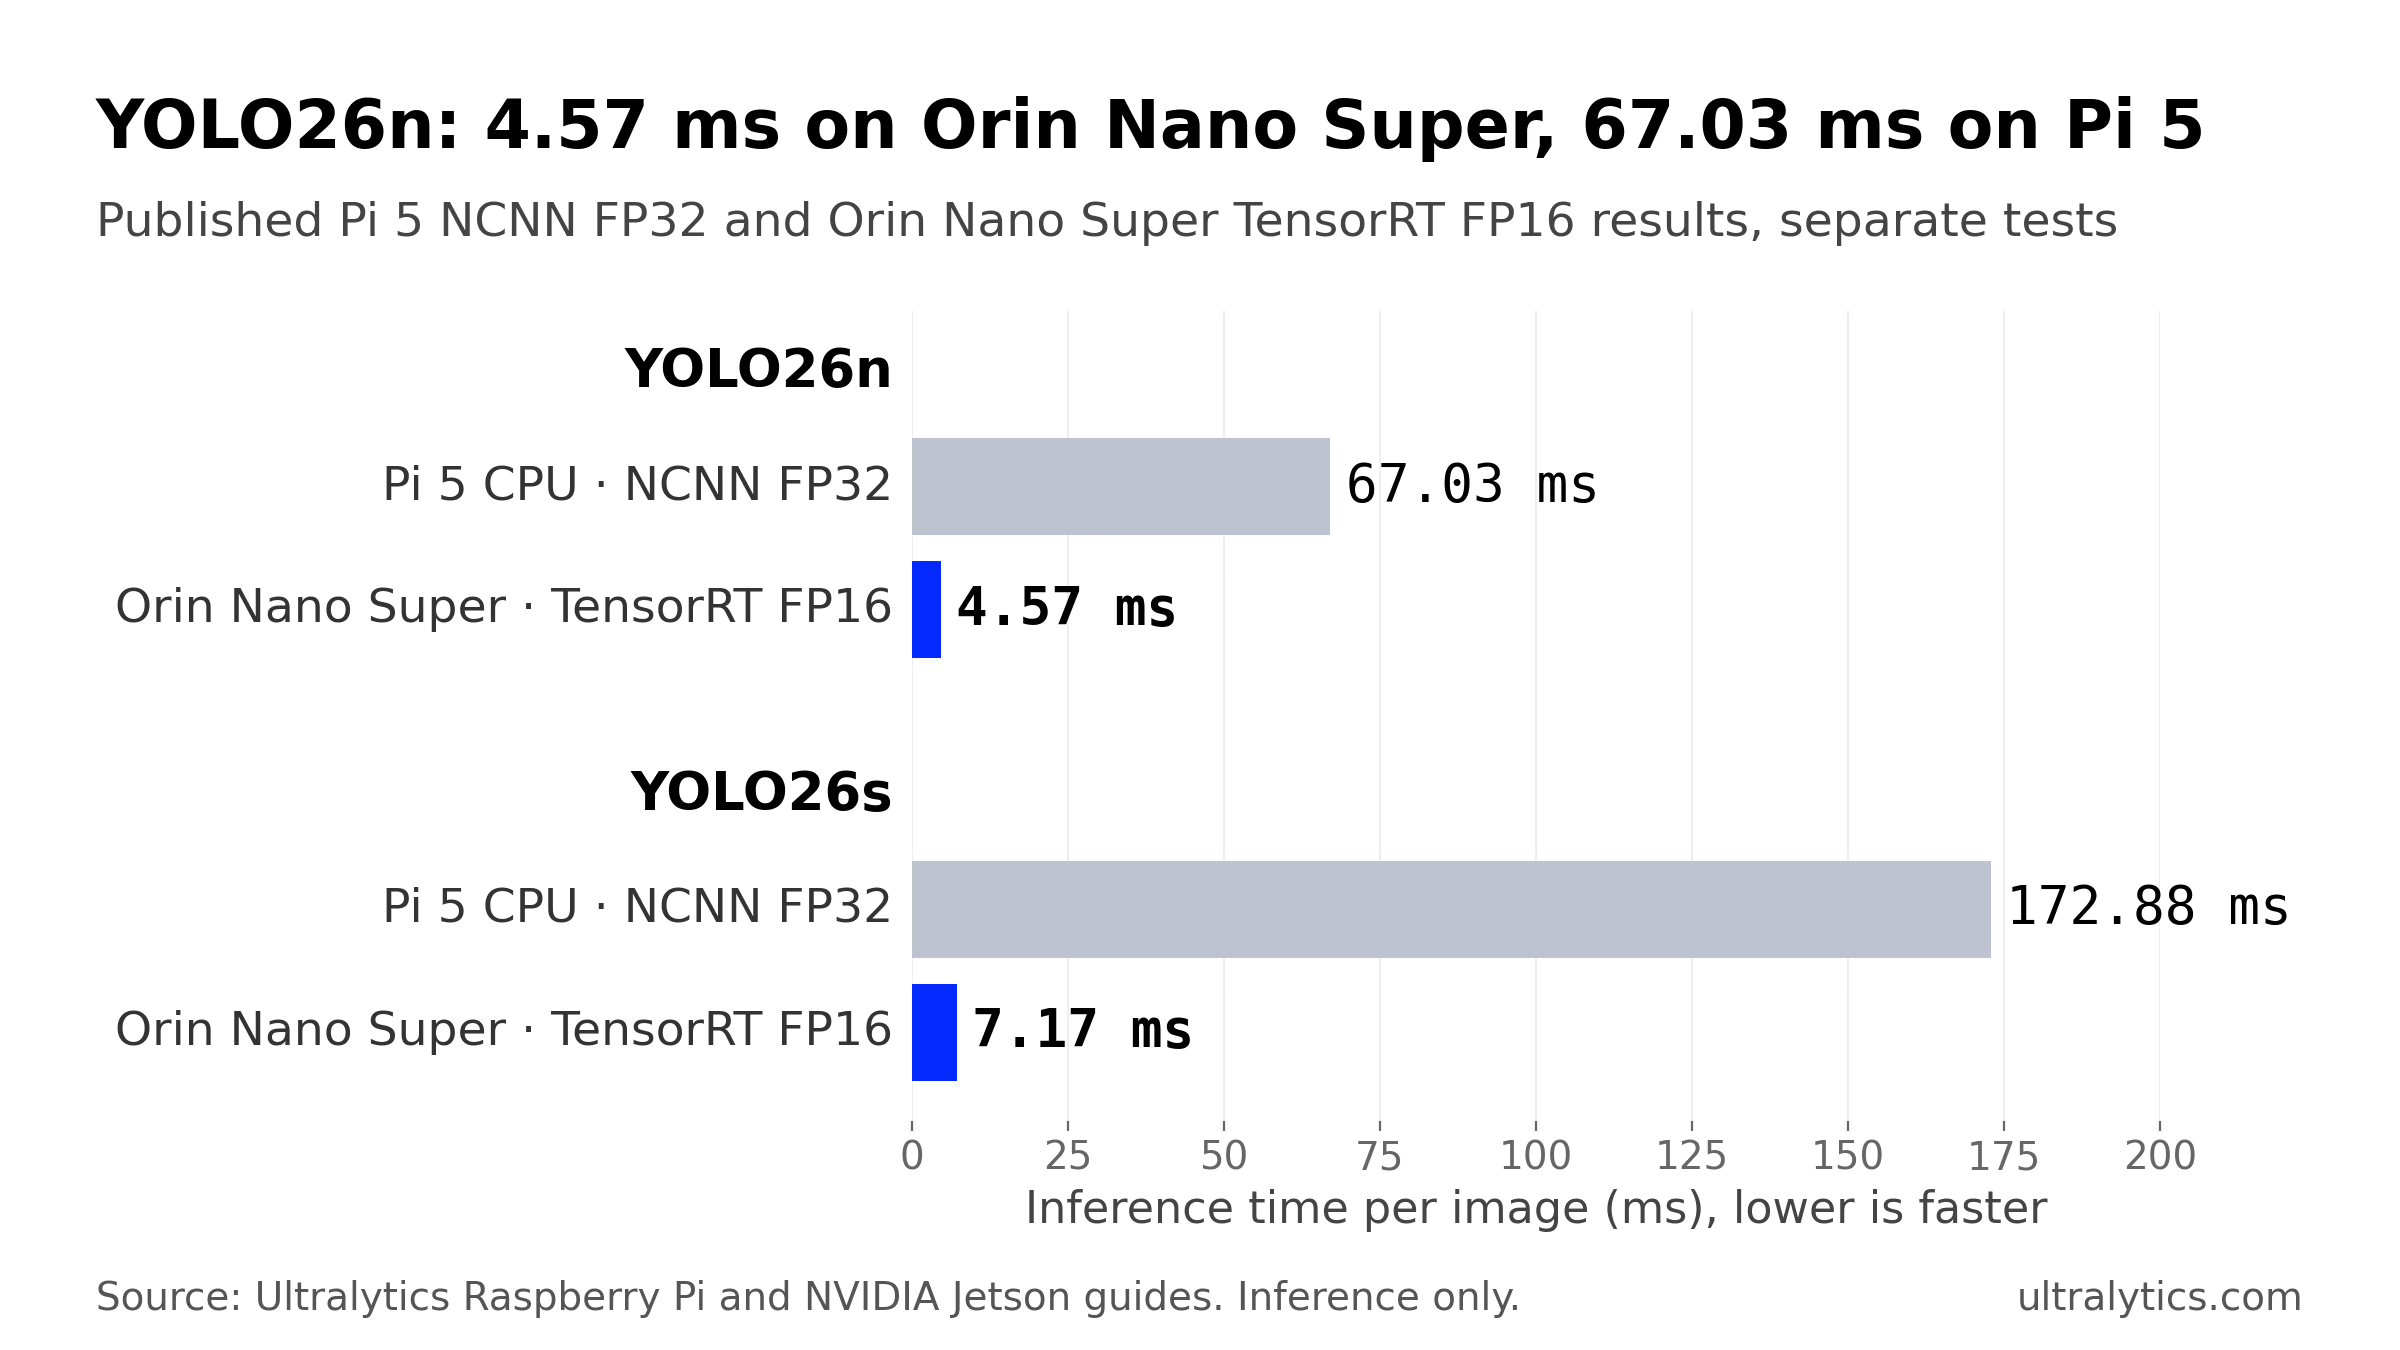
公開されているNCNN FP32とTensorRT FP16の結果は、別々のテストに基づいています。Raspberry Pi 5はUltralytics 8.4.108、Orin Nano Super Developer KitはUltralytics 8.4.33を使用しました。推論のみで、前処理と後処理は含みません。出典:Ultralytics Raspberry PiガイドおよびNVIDIA Jetsonガイド。
YOLO26nの場合、Pi 5のCPUより推論時間が約93%短縮されます。この差には精度の違いも影響するため、FP32エクスポート同士でも比較してください。Orin Nano SuperのFP32 TensorRTエンジンは7.53 msで、ランタイムとテストのバージョンは異なるものの、PiのFP32 NCNNエクスポートよりも依然として約9倍高速です。より注目すべきはYOLO26mで、mAP50-95は0.6225、推論時間は13.59 msです。古いONNXテストでPi 5のCPUが約1 FPSで実行したモデルです。
INT8ではさらに少し高速になります。YOLO26nのINT8エンジンの処理時間は3.80 msに短縮されますが、COCO128でのmAP50-95は0.4800から0.4490に低下します。まずFP16から始め、FP16では目標を達成できず、独自のカメラ画像でキャリブレーションできる場合に限り、INT8量子化に進んでください。TensorRTによる最適化に関するAcademyのレッスンでは、この判断手順を説明しています。
すべてのストリームが同じ処理能力を共有するため、カメラを追加するとFPSが低下します#
規模を拡大するとよく見られるのが、カメラ1台ではスムーズに動作するものの、3台目や4台目を追加すると処理フレームレートが低下するパターンです。各フレームの処理にはデコード、前処理、推論、後処理が必要で、すべてのカメラが同じコンピューティングリソースを共有します。Pi 5では、同じ4つのCPUコアで動画のデコードとモデルの実行を行うため、ストリームを追加するたびに両方の処理に使える時間が減ります。
Ultralyticsが処理を担います。.streamsファイルにソースを1行ずつ記述し、Predictモードに渡します。各ストリームには専用のリーダースレッドが割り当てられ、ローダーは各カメラの最新フレームを1つのバッチにまとめるため、遅いソースやフレームが欠落したソースがバッチ全体を待たせることがあります。バッチを受け付けるバックエンドは1回のフォワードパスとして処理します。NCNNはフレームを1つずつ処理し、固定形状のTensorRTエンジンでは、エクスポートサイズに合わせてバッチを分割またはパディングします。デフォルト(stream_buffer=False)では、モデルの処理が遅い場合、古いフレームをキューに追加せずスキップするため、アプリケーション内の滞留を抑えられます。ただし、カメラ、デコーダー、ネットワークでのバッファリングによって、遅延が増えることがあります。
単一画像のレイテンシは出発点であり、カメラの台数を示す値ではありません。バッチ処理によってスループットは変化し、デコード、トラッキング、描画にもそれぞれ処理コストがかかります。Ultralytics Academyのマルチストリーム推論レッスンでは、デバイスあたりのストリーム数を、実際のバッチサイズでの持続可能なスループットを各ストリームに必要なFPSで割った値とし、ピークに備えて20~30%の余裕を持たせるという目安を紹介しています。以下の実践セクションで説明するように、カメラを接続した状態でボードのスループットを測定してください。Jetsonで複数カメラのパイプラインを構築する場合、DeepStreamでは1つのタイル状アプリケーション内で、複数のソースを1つのTensorRTエンジンに通して処理できます。
カメラごとの実測FPS、モデルサイズ、精度に基づいて選択してください#
まず、動作する可能性がある最も安価なボードで測定し、自分のカメラでテストして、性能が足りない場合にのみ上位のボードに移行してください。
| 測定結果が次のような場合… | まずは次から |
|---|---|
| YOLO26nが精度目標とカメラごとのFPSを満たす | NCNNを使ったPi 5のCPUを選択します。低FPSの用途なら、複数のカメラにも対応できる可能性があります。 |
| フレームレートがPiでは足りないものの、Piを使い続けたい | Hailo-8 AI HAT+やDEEPX DX-M1などのアクセラレーターを搭載したPi 5を選びます。どちらも量子化モデルを実行し、コンパイル工程が必要なため、エクスポート後に精度を確認してください。 |
| より高いFPSで大きなモデルを実行する必要がある、Piで処理できる以上のストリームが必要である、または他のソフトウェア用にCPU時間を確保したい | TensorRTを搭載したJetson Orin Nano Superを選択します。実測スループットが足りない場合は、Orin NXまたはAGX Orinに移行してください。 |
フレームレートは、ベンチマーク上の数値である前に、ビジネス要件です。コンピュータービジョンにおけるFPSのガイドでは、監視対象の動作速度に基づいた設定方法を説明しています。適切なエッジデバイスの選び方では、この2機種以外のボードも取り上げています。
自分のカメラを使って両方のボードを測定する#
上記の数値は一定の条件下で測定したものであり、冷却、電力モード、OSイメージ、ソフトウェアのバージョン、使用するモデルによって結果は異なります。Ultralyticsパッケージは両方のボードで同じAPIを使うため、同じ測定をそれぞれで実行できます。以下のコマンドはUltralytics 8.4.215で確認しました。
手順1:各ボードでエクスポート形式をベンチマークする#
ボード上でyolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640を実行します。Benchmarkモードでは、ボードがサポートする各エクスポート形式について、モデルサイズ、mAP50-95、推論時間が表示されます。形式が対応している場合は、quantize=16またはquantize=8を追加してFP16またはINT8を測定します。Super対応構成を書き込んだOrin Nano Super Developer Kitでは、まずMAXN SUPER電力モードを選択してください。Orin Nano上のJetPack 6.2については、NVIDIAのSuper Modeに関する投稿で説明されているとおり、sudo nvpmodel -m 2を設定します。その後、sudo jetson_clocksを実行します。長時間の実行中は温度を監視してください。
手順2:各ボードで最速の形式にエクスポートする#
Raspberry Pi 5では、Raspberry Pi 5の解説に示す手順でNCNNにエクスポートします。Jetsonでは、TensorRTエンジンはビルド時に使用したGPUとTensorRTのバージョンに依存するため、デバイス上でエンジンをビルドしてください。dynamicを指定せずにエクスポートしたエンジンは、入力形状が固定されます。選択肢の1つは、batchをカメラの台数に設定し、速度がさらに必要な場合は小さいimgszで再エクスポートすることです。
from ultralytics import YOLO

# Jetsonのみ:NVIDIA GPUが必要です。FP16 TensorRTエンジン、640ピクセル、カメラ4台分のバッチ
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4) # yolo26n.engineを書き出します手順3:カメラごとの処理FPSを測定する#
cams.streamsにRTSP URLを1行ずつ記述し、ボード上でモデルを約1分間実行します。各カメラの処理FPSを、カメラが送信するフレームレートと比較してください。ストリームが接続され、モデルがウォームアップした後、最初の完全なバッチの処理が終わった時点でタイマーを開始し、完全なバッチの処理が終わった時点で停止します。
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")この測定で得られるのは、このパイプラインの処理済み結果のスループットです。ストリームを追加するにつれてカメラの処理FPSがフレームレートを大きく下回る場合、ボードの処理が追いついていません。Academyのマルチストリームレッスンにあるプロデューサー・コンシューマーの例でストリームごとのドロップ数を明示的に確認し、アプリケーションに必要なトラッキングや描画を追加してから、より小さいimgszで再エクスポートする、小さいモデルまたはより高速なエクスポート形式に切り替える、あるいは上位のハードウェアに移行して再測定してください。
ビルド環境を設定せずに済ませたい場合は、Ultralytics PlatformのExportタブで、Orin Nano 8GB Superを含むJetson向けTensorRTエンジンをビルドできます。Orinの各設定はAGX Orin上でビルドされており、Orin Nano本体での検証はまだ完了していません。そのため、デバイスのTensorRTおよびCUDAランタイムがエンジンと互換性があることを確認し、デプロイするデバイス上で各エンジンを検証してください。NVIDIA GPUにおけるONNX RuntimeとTensorRTの比較については、ONNXとTensorRTの比較を参照してください。
選ぶべきボード#
YOLO26nが精度目標を満たし、ボード上で測定した処理FPSが必要なすべてのカメラに対応できる場合は、Raspberry Pi 5を選択してください。推論FPSが約15 FPSのため、小売店のレジ、コンベヤー上の計数、野生動物や家庭のカメラ、初期段階のロボットのプロトタイプなどに適したシンプルな構成です。より多くのフレームが必要でもPiを使い続けたい場合は、アクセラレーターを追加してください。
nanoより大きなモデルを実用的なフレームレートで使いたい、Piで処理できる以上のストリームが必要、またはトラッキング、ナビゲーションなどのアプリケーション用にCPU時間を確保したい場合は、Jetson Orin Nano Superを選択してください。YOLO26sからYOLO26lまでの推論時間は18 ms未満であり、カメラを追加するときに活用できるのがこの処理能力の余裕です。確認のため、アプリケーション全体を測定してください。
Ultralyticsの活用方法#
Ultralyticsはどちらのボードも製造していません。両方で動作するモデルとツールを開発しています。同じYOLO26の重みをPi 5向けのNCNN、AI HAT+を搭載したPi向けのHailo、Jetson向けのTensorRTにエクスポートできます。そのため、再トレーニングせずにPiでプロトタイプを作成し、ワークロードが増えたらJetsonに移行できます。各エクスポートの後に精度を検証してください。Ultralytics Platformでは、デプロイ前の工程を実行できます。データセットにアノテーションを付け、ローカル環境のトレーニング用コンピューティングリソースが不足している場合はクラウドでトレーニングし、どちらのボード向けにもエクスポートできます。
制約事項:公開ベンチマークは推論のみを対象とし、記載したテストデバイスで測定しています。お客様のカメラ、筐体、本番用モジュールで測定したものではありません。また、Jetsonガイドには初代Jetson NanoのYOLO26の結果は含まれていません。Ultralytics YOLOはAGPL-3.0またはUltralytics Enterprise Licenseで利用できます。デプロイに必要な条件については、Ultralyticsのライセンスをご確認ください。
よくある質問
画像1枚あたりの処理は大幅に高速です。別々のテストによる公開ベンチマークでは、YOLO26nはJetson Orin Nano Super Developer Kit上のTensorRT FP16エンジンで4.57 ms、Raspberry Pi 5のCPU上のNCNNで67.03 msでした(入力サイズ640ピクセル、推論のみ)。YOLO26mはJetson上で13.59 msです。この性能が必要かどうかは、モデル、カメラの台数、目標FPSによって異なります。Pi 5が独自の測定で要件を満たすなら、よりシンプルな構成になります。
いいえ。初代Jetson Nanoは2019年に発売され、128コアMaxwell GPUと4 GBのメモリを搭載しており、JetPack 4のみをサポートします。Jetson Orin Nanoは、1024コアAmpere GPUを搭載した新しいモジュールです。ベンチマークに使用したOrin Nano Super Developer Kitは8 GBのメモリを搭載し、JetPack 5~7をサポートします。この記事の性能比較はOrin Nano Superを対象としており、初代Nanoは対象外です。
はい。2019年版のJetson NanoはJetPack 4をサポートしており、UltralyticsはJetPack 4用のDockerイメージを提供しています。また、TensorRTを使ったYOLO26向けのDeepStreamガイドは、JetPack 4.6.4を搭載したJetson Nano 4GBでテスト済みです。JetsonガイドにはこのボードのYOLO26ベンチマークは含まれておらず、ハードウェア性能はOrin Nano Superを大きく下回ります。
すべてのストリームがボードの処理能力を共有します。カメラを追加するたびに、それぞれのカメラでデコード、前処理、推論、後処理が必要です。
.streamsファイルを使うと、Ultralyticsはすべてのカメラのフレームをバッチにまとめ、モデルの処理が追いつかない場合は古いフレームをスキップします。そのため、共有パイプラインがボトルネックになると、カメラごとの処理FPSが低下します。より高速なエクスポート形式、小さいモデル、imgsz、またはより高性能なハードウェアを使うと改善できます。はい。1度トレーニングし、Pi 5向けには
format="ncnn"、Jetson向けにはformat="engine"を使って同じ重みをエクスポートします。TensorRTエンジンはターゲットデバイス上で、またはターゲットデバイス向けにビルドしてください。各エクスポートの後に、独自のデータで精度を検証してください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









