Claude Fable 5.2가 출시됐지만 보안 X선을 보기를 거부합니다
Claude Fable 5.2가 출시됐지만 Ultralytics Platform에서 보안 X선 데이터셋 IEDXray에 라벨을 지정하지 않습니다. 10개 스캔 모두를 차단한 반면, 오픈 모델들은 응답했습니다.
 Glenn Jocher14 분 읽기
Anthropic은 2026년 11월 9일 Claude Fable 5.2를 출시하며, "평가한 거의 모든 역량에서 Opus 5.5보다 한 단계 앞선다"고 밝혔습니다. 같은 날 36개 데이터셋으로 구성된 탐지 벤치마크 UL37에서 테스트했습니다. 해당 데이터셋 중 하나에서는 이미지 한 장도 보기를 거부했습니다.
첫 번째 스캔에는 가방 안에 넣은 노트북이 보입니다. 케이스 너머로 회로 기판이 보이고, 배터리 두 개가 옆에 끼워져 있습니다. Claude Fable 5.2에 이 물체들 주위에 바운딩 박스를 그려 달라고 요청했습니다. 2초도 지나지 않아 Anthropic의 API는 다음과 같은 차단 메시지를 반환했습니다. "이 요청은 고위력 폭발물 개발과 관련된 콘텐츠 제한을 유발했으며 Anthropic 사용 정책에 따라 차단되었습니다."
데이터셋의 보안 X선 스캔 10개 모두에서 같은 일이 발생했습니다. 여기에는 평범한 휴대전화, 노트북, 호출기 또는 무전기만 들어 있는 스캔 다섯 개도 포함됩니다. 테스트한 다른 모델은 단 한 건의 스캔도 거부하지 않았습니다. GPT-6.1, Gemini, Grok은 물론 오픈 웨이트 모델이나 중국 모델도 거부하지 않았고, Anthropic 자체의 Claude Opus 5.5, Sonnet 5.5, Haiku 5.5도 거부하지 않았습니다.
그 밖의 모든 작업에서 Claude Fable 5.2의 자동 주석 성능은 뛰어납니다. 0.544 mAP50을 기록해 VLM 리더보드에서 44개 모델 중 GPT-6.1 Terra에 이어 2위를 차지했으며, 측정한 모델 중 가장 정밀한 박스를 생성합니다. 현재 Ultralytics Platform에서 사용할 수 있습니다. 아래에서는 무엇을 거부하는지, 어떤 작업을 훌륭하게 수행하는지, 라벨링 워크플로에 적합한지 살펴봅니다.
Anthropic의 필터가 UL37의 모든 보안 X선을 차단했습니다#
UL37은 36개의 실제 객체 감지 데이터셋에서 각각 10장씩, 총 360장의 이미지에 대해 모델의 박스가 사람의 라벨과 얼마나 일치하는지 측정합니다. 그중 하나인 IEDXray는 공항, 국경, 행사 보안에서 위협 탐지기를 훈련하기 위해 구축된 수하물 스캐너 X선 데이터셋입니다. 11개 클래스는 일상적인 전자기기(노트북, 휴대전화, 호출기, 무전기, 배터리), 각 기기의 개조 버전, 폭발물을 포함합니다.
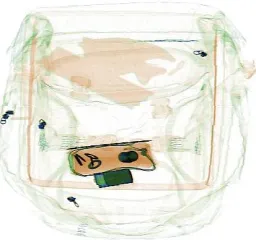 IEDXray Improvised Device X-ray 미리보기 1주석 오버레이에 라벨 2개 표시
 IEDXray Improvised Device X-ray 미리보기 2주석 오버레이에 라벨 1개 표시
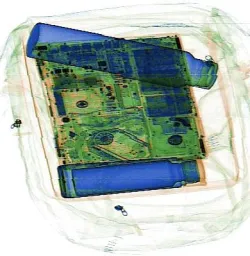 IEDXray Improvised Device X-ray 미리보기 3주석 오버레이에 라벨 1개 표시
 IEDXray Improvised Device X-ray 미리보기 4주석 오버레이에 라벨 1개 표시
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2는 이미지 10개를 모두 거부했습니다. 각 요청은 1.0~4.7초 만에 Anthropic의 refusal 중단 사유와 함께 돌아왔으며, 박스는 생성되지 않았습니다. Platform에는 사용자가 "탐지를 완료하기 전에 중단되었습니다(거부). 다른 모델을 사용해 보세요."라는 메시지를 표시합니다.
정확한 원인을 확인하기 위해 11월 10일 Platform의 프로덕션 요청을 재현해 스캔 10개 모두를 Anthropic의 API에 직접 전송했습니다. 10개 모두 동일한 응답을 받았습니다. 중단 사유는 refusal, 카테고리는 general_harms, 출력 토큰은 0개였으며, 위에서 인용한 "고위력 폭발물" 메시지가 표시됐습니다. 이 메시지는 Anthropic 도움말 센터를 통해 "Claude 사용 방식에 따른 예외"를 요청하라고 안내합니다. API 통합 개발자에게는 대체 모델 설정을 권장하는 Anthropic의 거부 관련 문서를 안내합니다.
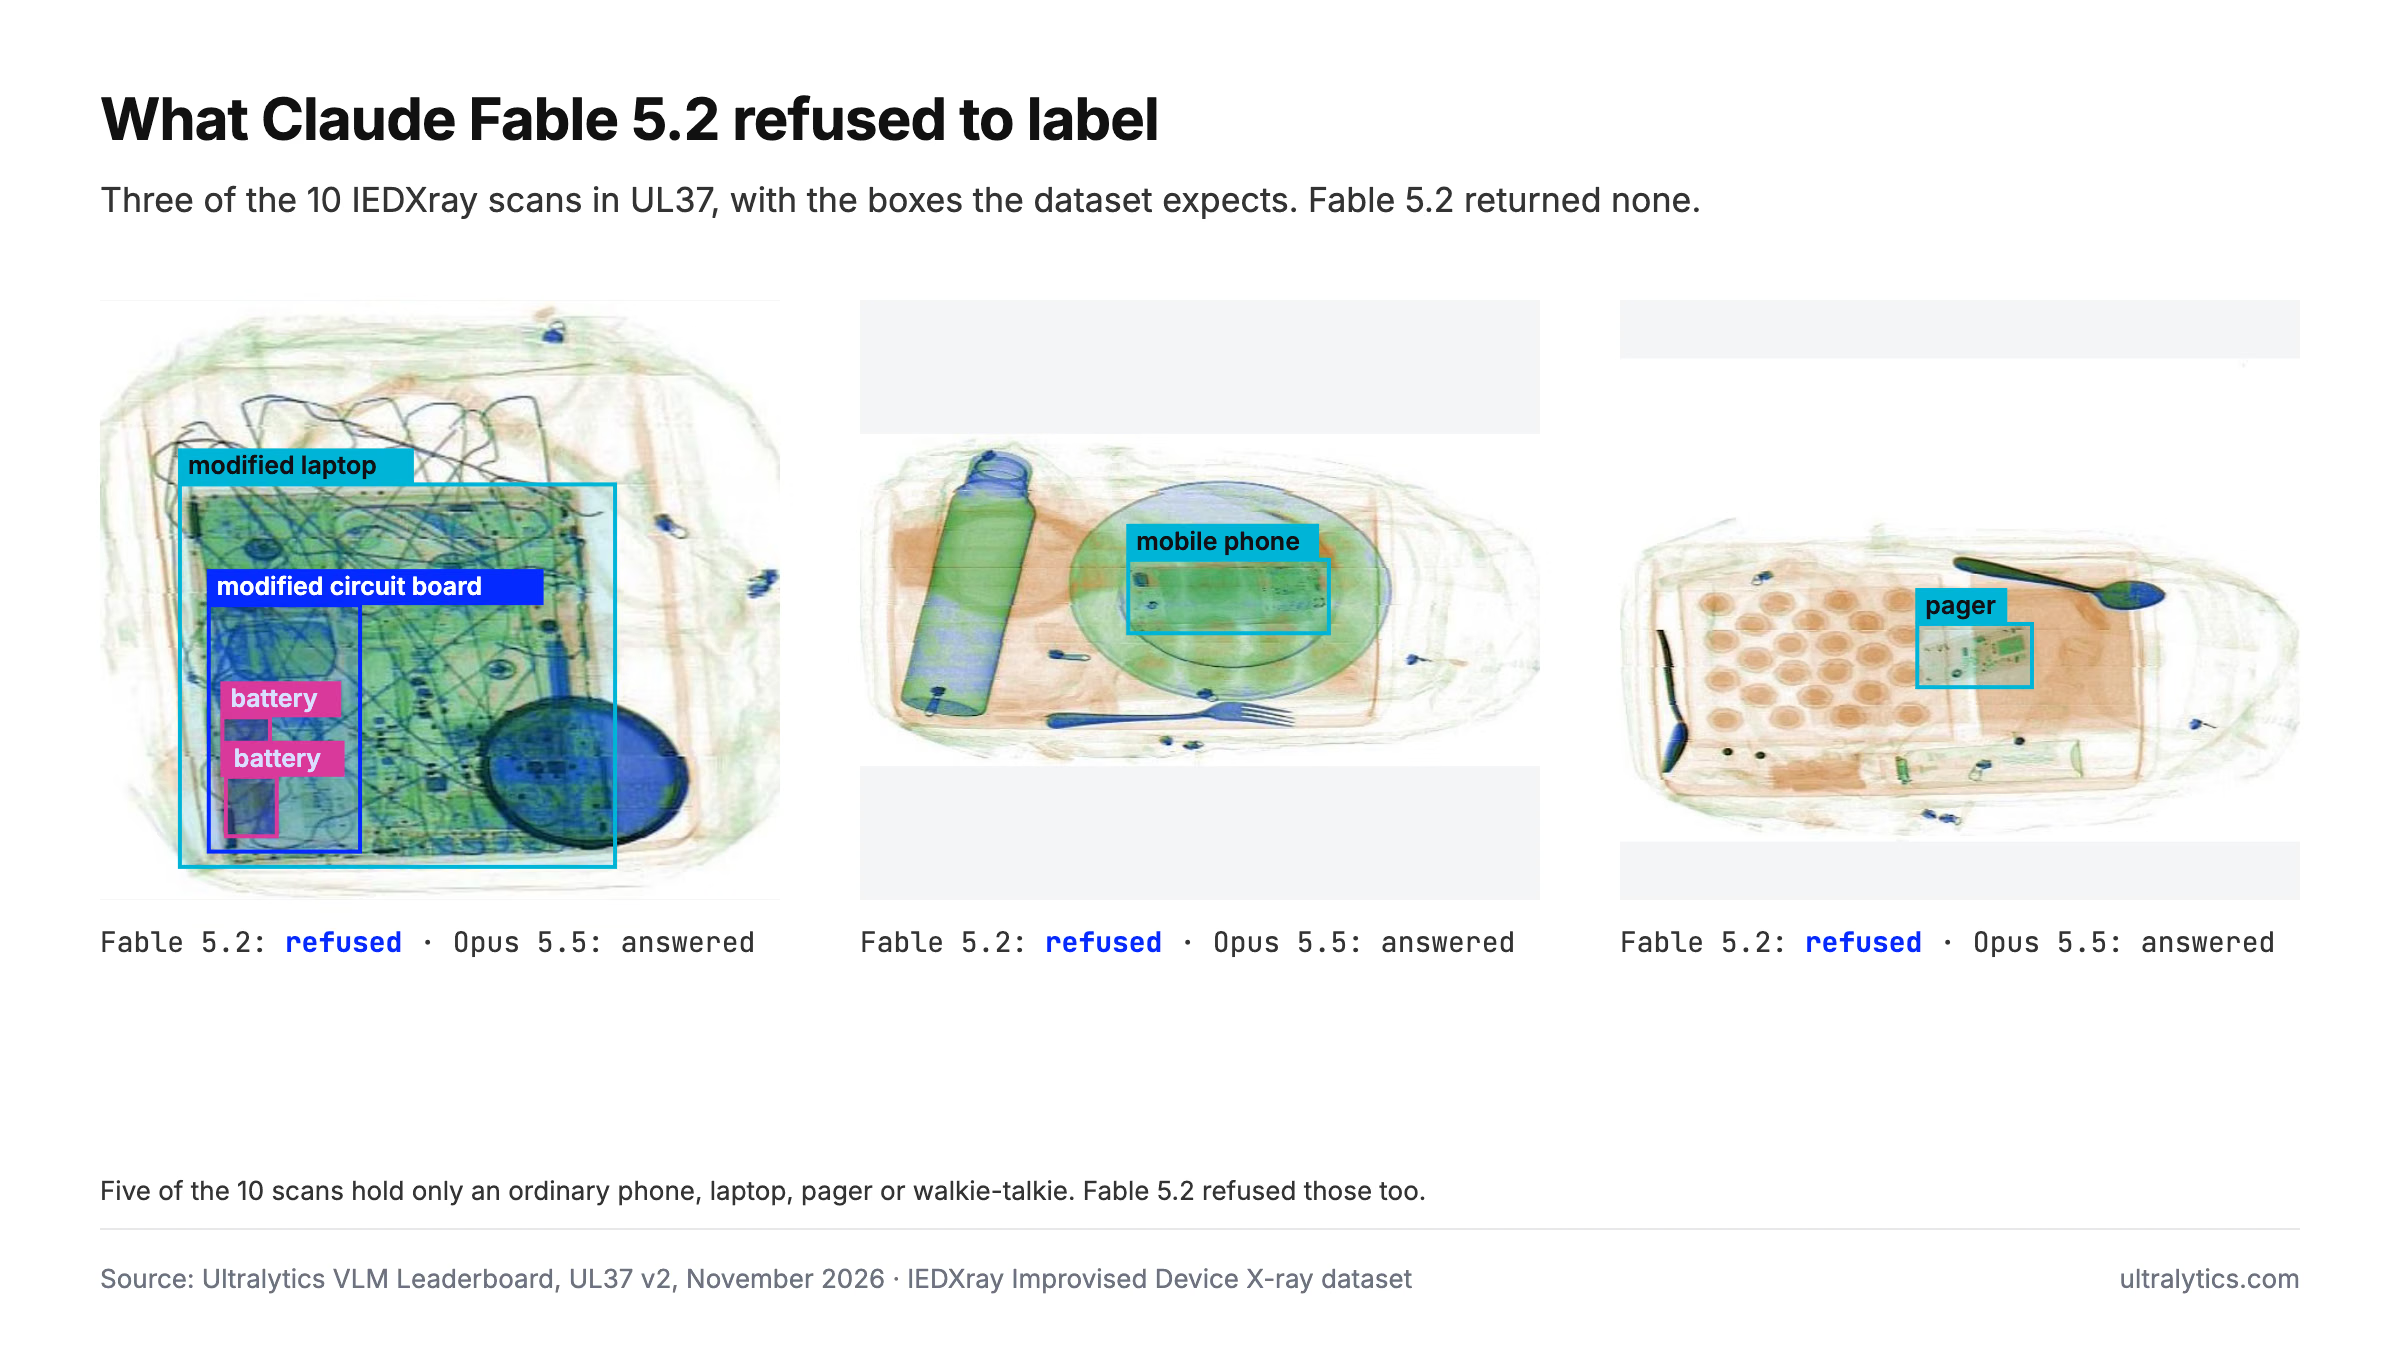
기대 박스가 표시된 IEDXray 스캔 10장 중 세 장입니다. Claude Fable 5.2는 세 장 모두를 거부했으며, 같은 실행에서 Claude Opus 5.5는 스캔 10장 모두에 응답했습니다.
차단은 사진 속 물체 때문이 아닙니다. 가운데 있는 휴대전화는 그저 휴대전화일 뿐입니다. 스캔 10장 중 다섯 장에는 개조 장치도 폭발물도 없지만, Fable 5.2는 모두 거부했습니다. 필터는 작업 자체, 즉 클래스 목록에 폭발물이 포함된 보안 데이터셋에 반응하는 것으로 보입니다.
Fable 5.2는 Fable 5.1보다 덜 거부하는 것이 아니라 더 많이 거부합니다#
Anthropic의 출시 발표에 따르면 Fable 5.2의 사이버 보안 및 생물학 보호 장치는 Fable 5.1보다 "불필요한 차단을 줄이며", 초기 테스트에서는 약 55% 감소했습니다. 보안 X선에서는 정반대였습니다. Fable 5.1은 스캔 10장 중 한 장을 거부했고, Fable 5.2는 10장 모두를 거부했습니다.
Anthropic은 Fable 5.2와 Claude Mythos 5.2가 동일한 기반 모델이라고도 밝혔습니다. Mythos 5.2는 일부 사이버 보안 및 생물학 보호 장치 없이 제공되며 Anthropic이 검증한 조직만 사용할 수 있습니다. 즉, 보호 장치는 모델의 시각 능력과는 별개로 공급업체가 결정하는 계층입니다. Fable 5.1은 동일한 스캔 중 9장에 응답해 0.15점을 기록했습니다.
수하물 검색 탐지기를 개발하는 팀이 얻을 실질적인 결론은 단순합니다. 가장 비싼 Claude 모델도 데이터 라벨링에 도움이 되지 않으며, 정책은 버전이 바뀌면서 달라졌습니다.
오픈 웨이트 모델은 모두 Fable이 거부한 스캔에 라벨을 지정했습니다#
리더보드의 모델 44개 중 IEDXray 스캔을 한 번이라도 거부한 모델은 단 두 개이며, 둘 다 Claude Fable입니다. 5.1은 한 장을, 5.2는 열 장을 거부했습니다. OpenAI, Google, xAI, Meta, 중국 연구소의 모델은 물론 Anthropic 자체의 Opus, Sonnet, Haiku 라인업까지 다른 모델은 하나도 거부하지 않았습니다.
여기에는 Platform 자체 서버에서 호스팅하는 모델 19개 모두와 Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text, Moondream 3.1 같은 오픈 웨이트 모델이 포함됩니다. 이 모델들은 단 한 장의 스캔도 거부하지 않았습니다. Platform에서 API 키 없이 사용할 수 있는 오픈 웨이트 모델 Moondream 3.1은 IEDXray에서 0.27 mAP50을 기록해 Gemini 4 Argon의 0.30에 이어 2위를 차지했으며, 모든 Claude 모델보다 앞섰습니다.
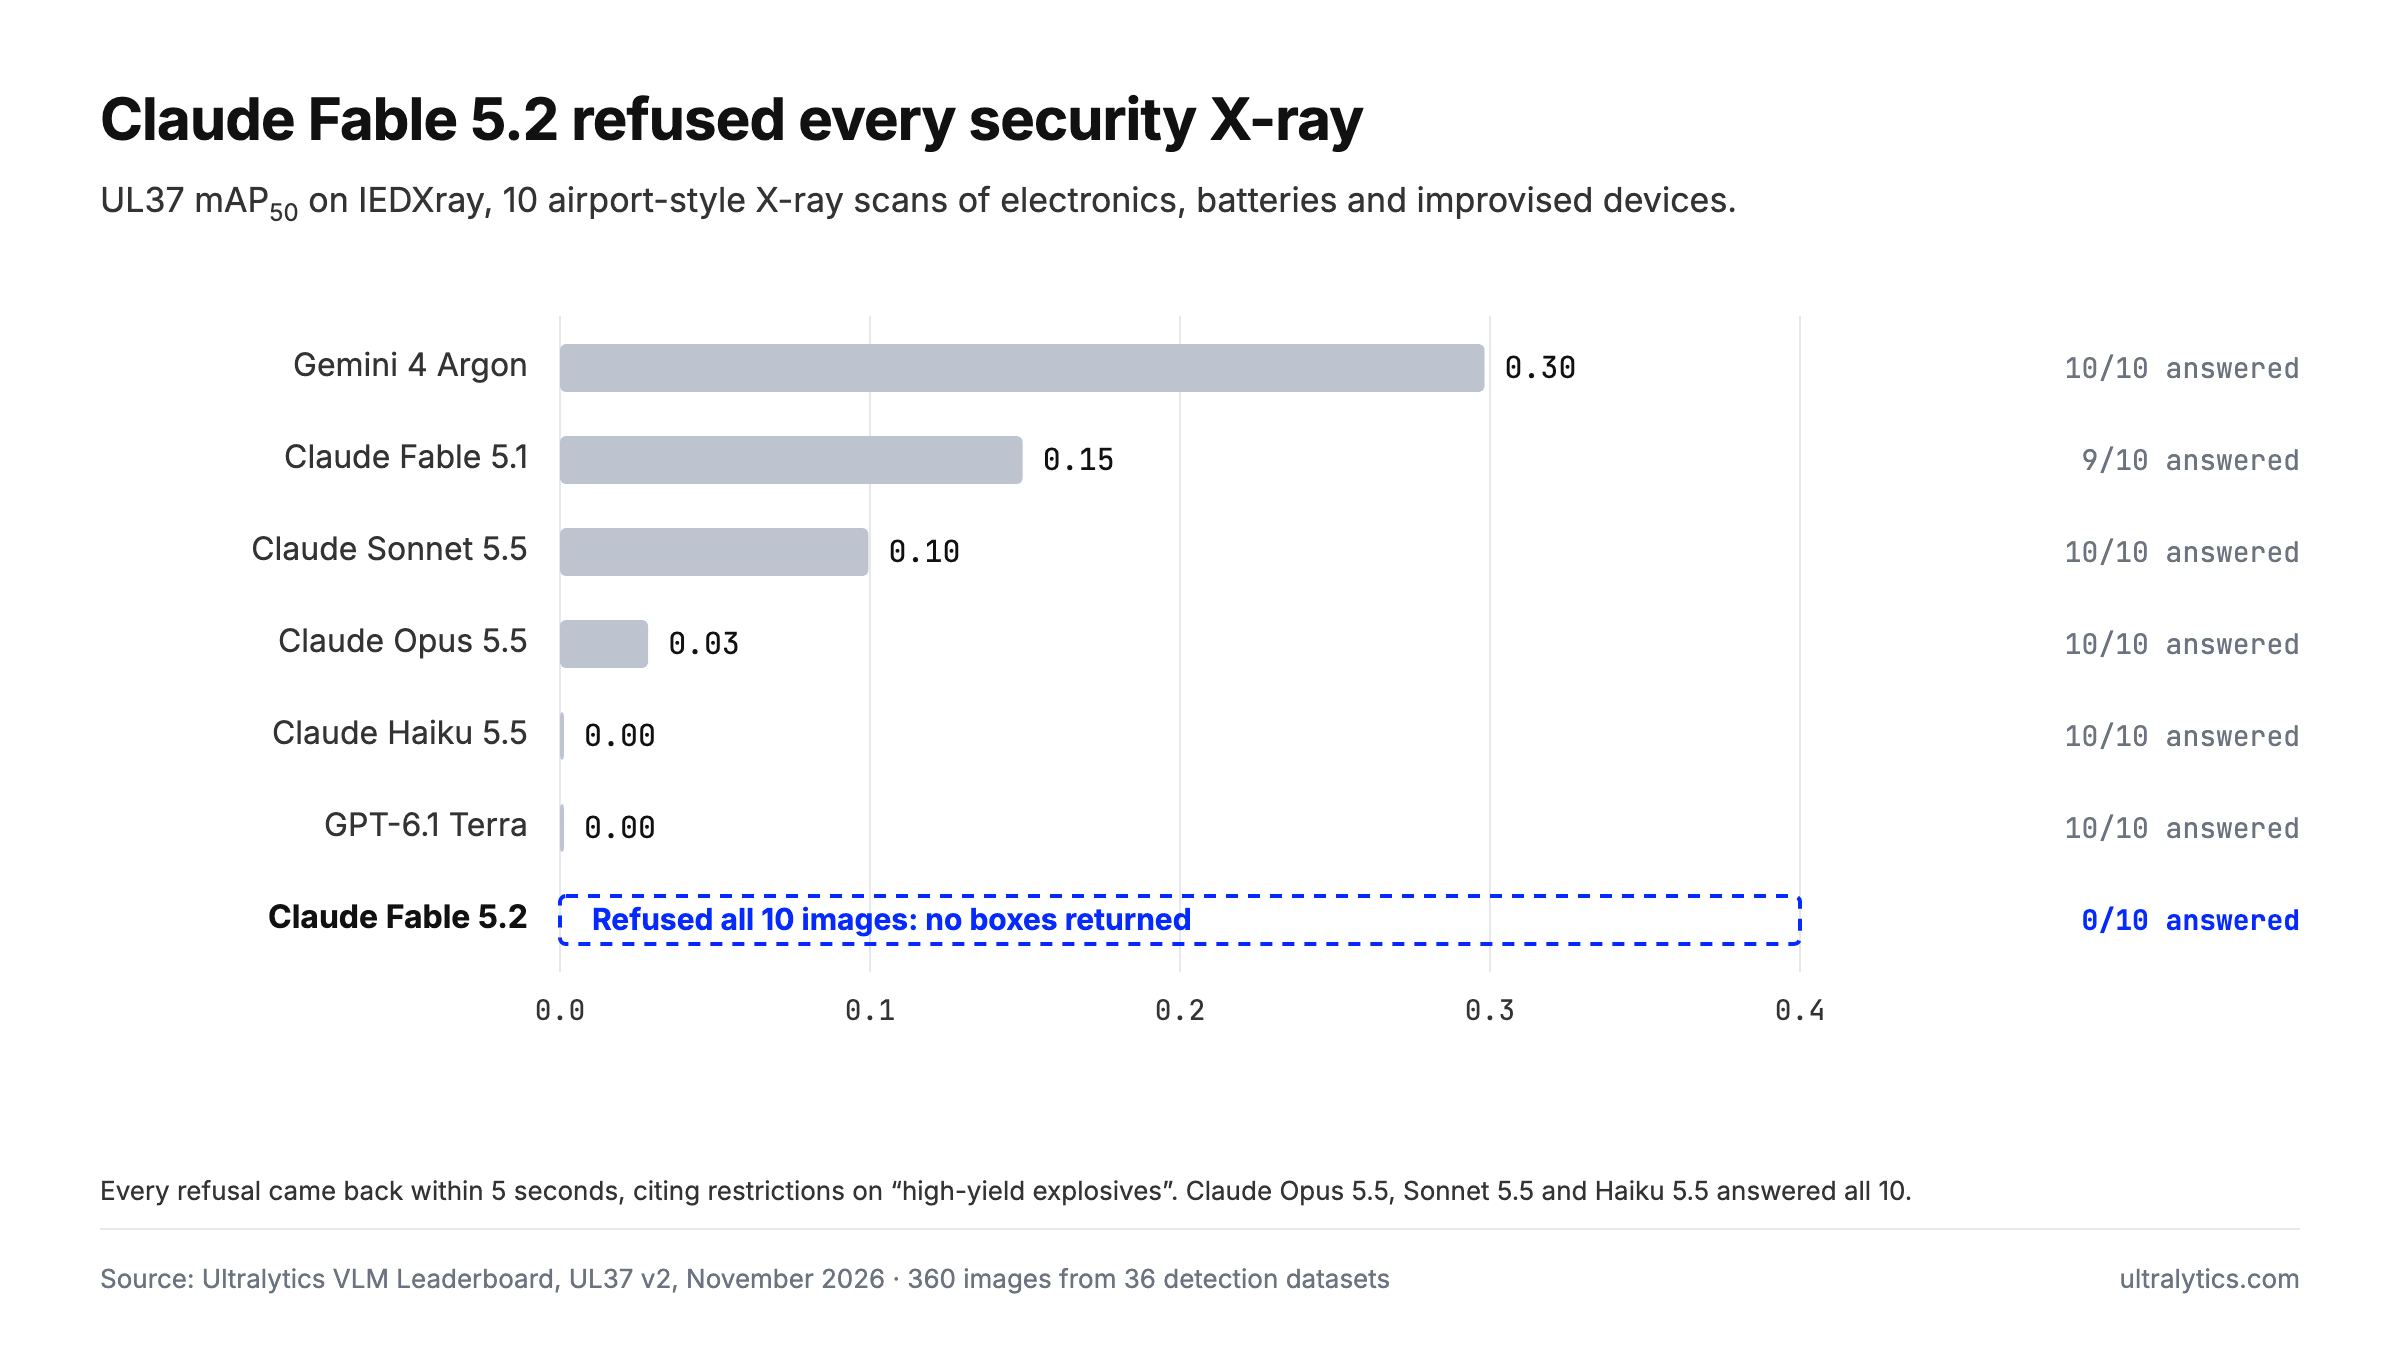
Anthropic 라인업과 리더보드 상위 두 모델의 IEDXray mAP50, UL37 v2, 기본 추론 강도 기준입니다. Fable 5.2는 스캔 10장 중 하나도 처리하지 못했습니다.
중국 모델은 보통 말하지 않는 내용으로 주목받습니다. 이번에는 상황이 반대였습니다. 선도적인 미국 연구소는 결과를 검열했지만, 테스트한 모든 중국 모델은 기꺼이 응답했습니다. Alibaba의 Qwen, Moonshot의 Kimi, DeepSeek, Zhipu의 GLM, Xiaomi의 MiMo, MiniMax, Tencent의 HY4는 스캔 10장 중 하나도 거부하지 않았고, 호스팅 중인 오픈 웨이트 Qwen 모델도 모두 응답했습니다. 입력 토큰 100만 개당 8달러인 Anthropic의 플래그십 모델은 보기를 거부했습니다.
보안 X선은 모든 모델에 어려운 작업입니다. 대부분 IEDXray에서 0.15 미만을 기록하므로 어떤 모델의 박스든 초안으로 간주해야 합니다. 하지만 주석 편집기에서 초안을 수정할 수 있습니다. 거부당하면 모든 박스를 직접 그려야 합니다. 오픈 웨이트 모델은 공급업체 정책이 출력에 개입하지 않으므로 오늘 검증한 모델이 내일도 같은 방식으로 작동합니다. 데이터에 라벨을 지정한 후 자체 Ultralytics YOLO26 탐지기를 훈련하면 배포된 모델도 완전히 제어할 수 있습니다.
보안 X선 이외의 작업에서 Claude Fable 5.2는 테스트한 모델 중 두 번째로 우수한 주석 모델입니다#
모든 UL37 이미지는 Platform 사용자가 이용하는 것과 동일한 프로덕션 파이프라인을 거치며, 데이터셋 자체의 클래스 이름을 사용하고 SAM 3.1이 모든 박스를 다듬습니다. 방법론은 공개되어 있습니다. Fable 5.2의 성적은 다음과 같습니다.
- mAP50: 0.544, 44개 중 2위
- mAP50-95: 0.347, 44개 중 1위, GPT-6.1 Terra의 0.345보다 근소하게 높음
- 정밀도 및 재현율: 0.602 및 0.620
- 공급업체 비용: 이미지 1,000장당 $37.55
- 이미지당 중앙값 처리 시간: 4.6초
- 실패한 요청: 360건 중 11건. 거부 10건과 Platform의 115초 제한 시간을 초과한 요청 1건입니다.
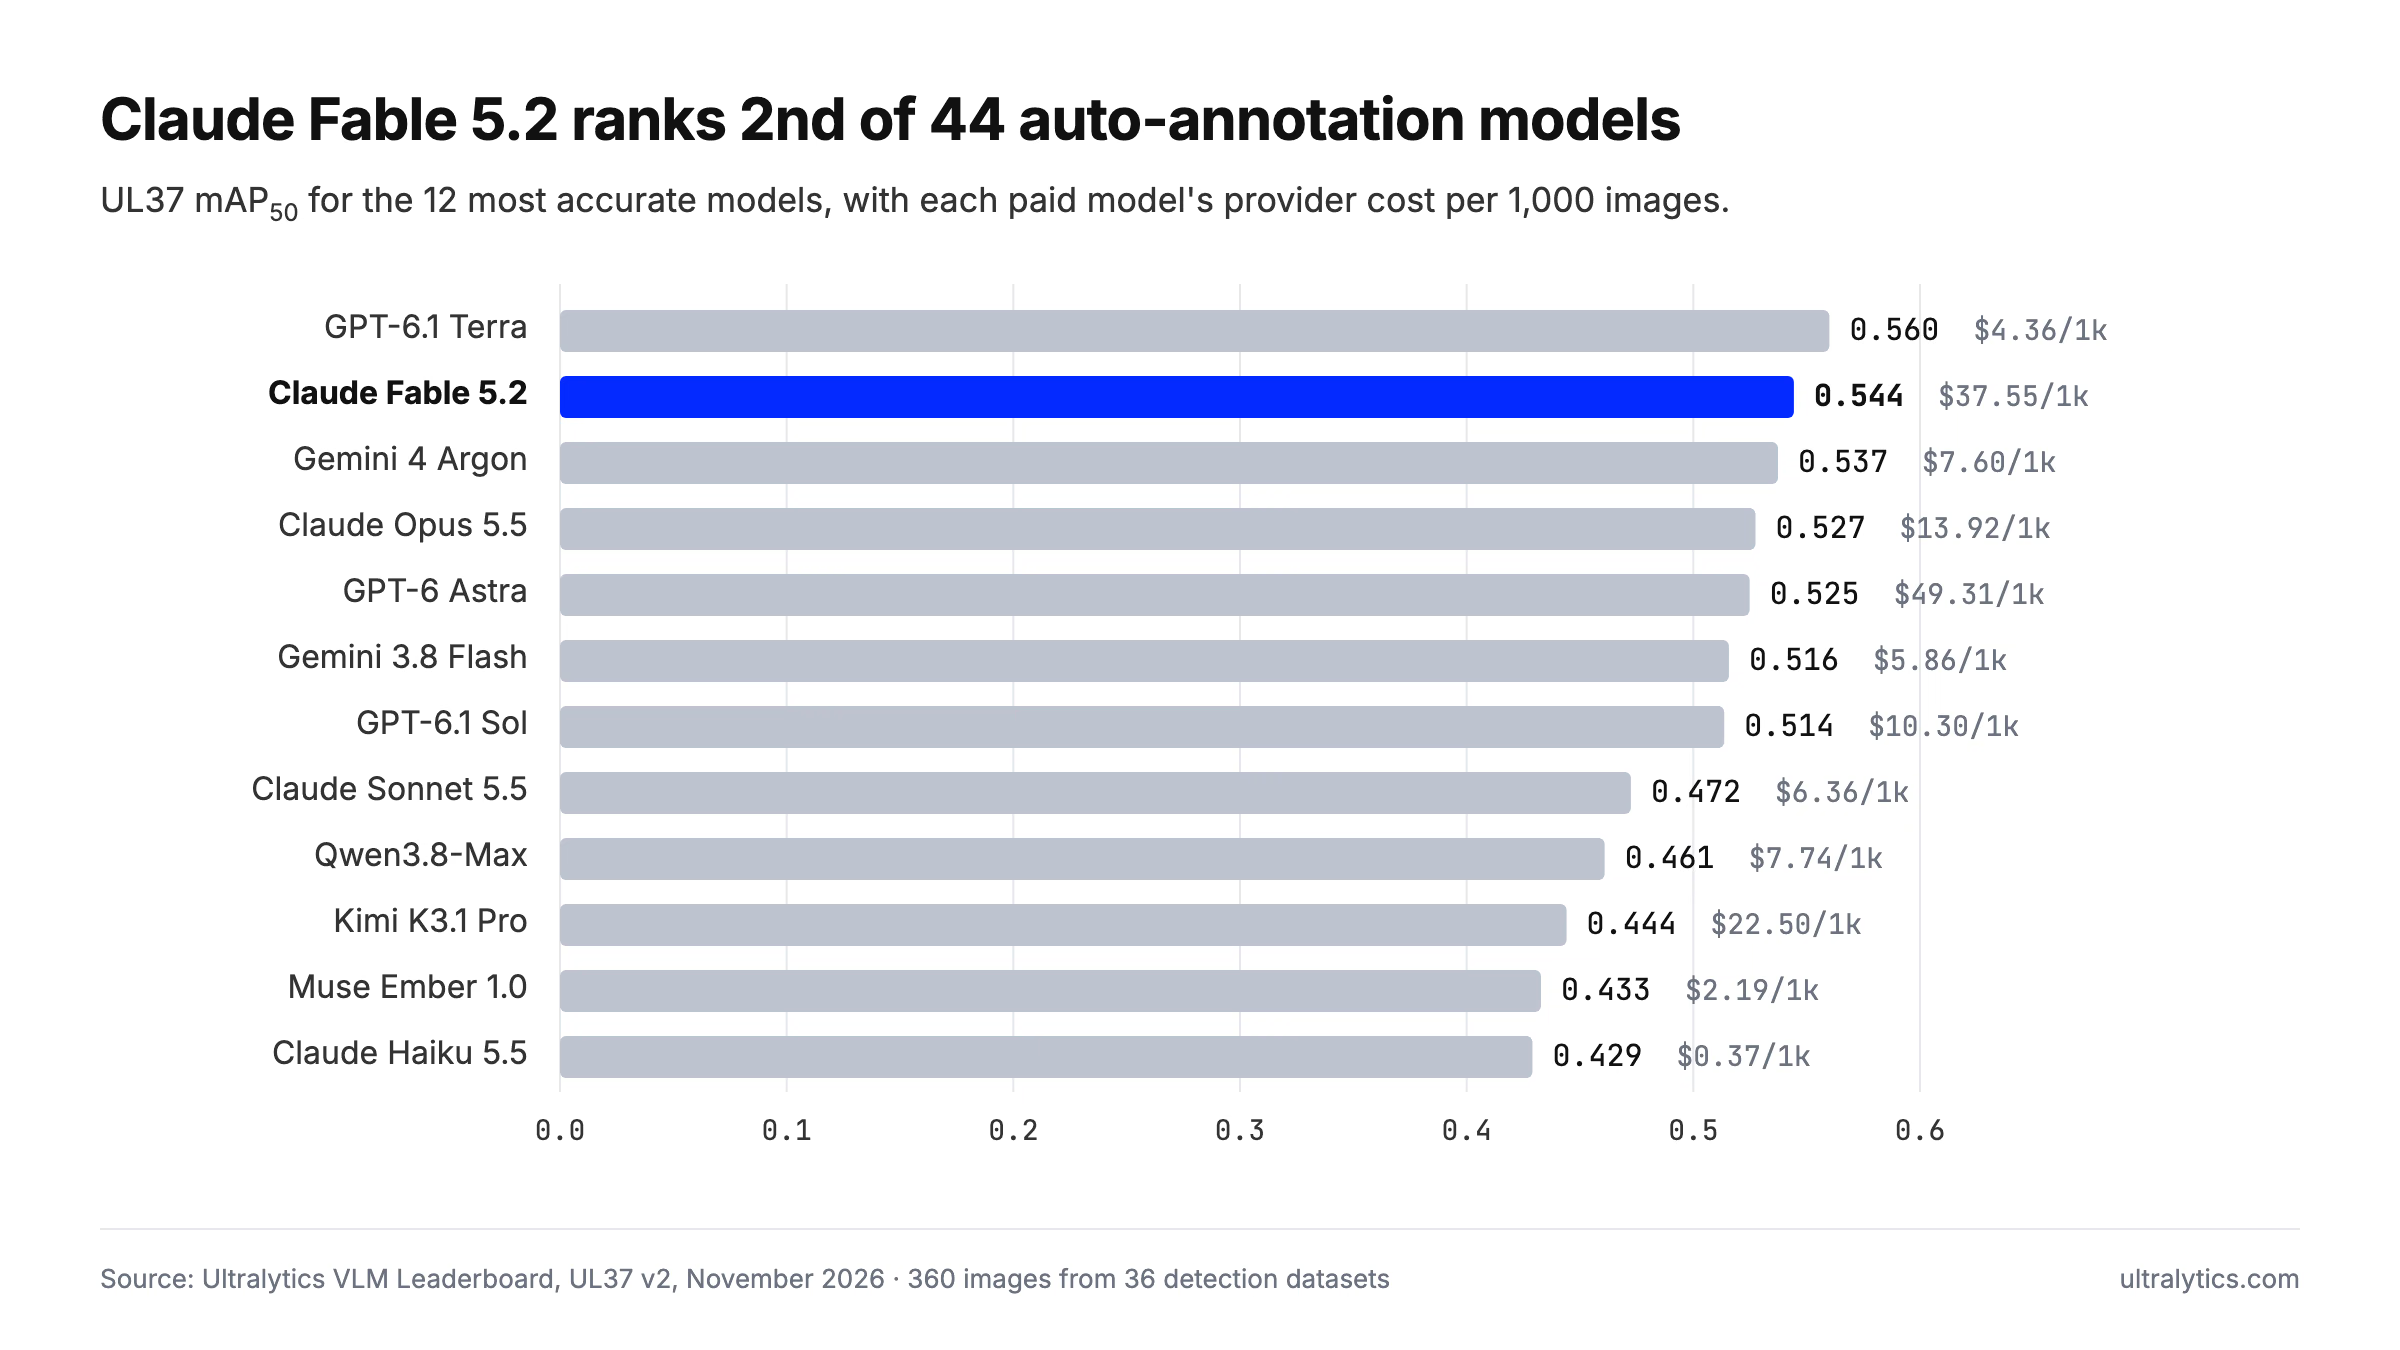
44개 모델 중 정확도가 가장 높은 12개의 UL37 mAP50 및 이미지 1,000장당 공급업체 비용, 2026년 11월 10일 기준입니다.
1위를 차지한 mAP50-95 점수가 중요합니다. 이 엄격한 점수는 50%에서 95%까지의 박스 중첩 임계값을 평균하므로, 대략 물체를 덮는 박스보다 각 물체의 윤곽에 꼭 맞는 박스에 더 높은 점수를 줍니다. Fable 5.2의 원시 박스는 SAM 3.1 정제 전에도 0.538 mAP50을 기록하며, 정제 후에는 0.544로 상승합니다.
36개 데이터셋 중 22개에서 상위 5위 안에 들고, UEC 학교 급식 쟁반(0.96), 농구공 및 골대 감지(0.85), PlantDoc 식물 잎 질병(0.52) 등 세 데이터셋에서 단독 1위를 차지합니다. 도메인별로는 소매 분야에서 1위이며, 자연 및 농업 분야에서는 Claude Opus 5.5를 근소하게 앞서 1위를 차지합니다. 별도로 평가한 COCO 2017 참조 이미지 10장에서는 0.686을 기록해 언어 모델 중 최고 성능을 보였으며, SAM 3 및 SAM 3.1 Text 분할 모델만 앞섰습니다.
거부로 인해 Fable 5.2는 한 데이터셋에서 0점을 받았지만, 1위 자리까지 내주지는 않았습니다. IEDXray를 제외하면 Fable 5.2의 평균은 0.560이며, 거부하지는 않았지만 해당 데이터셋에서 역시 0점을 받은 Terra의 평균은 0.576입니다.
Claude Fable 5.1보다 크게 향상된 성능#
Fable 5.2는 36개 데이터셋 중 31개에서 Claude Fable 5.1을 앞서며 이미지당 비용도 더 낮습니다.
| UL37 결과 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| 정밀도 / 재현율 | 0.602 / 0.620 | 0.506 / 0.485 |
| 리더보드 순위 | 44개 중 2위 | 44개 중 13위 |
| 제공업체 비용(이미지 1,000장당) | $37.55 | $43.75 |
| 이미지당 중앙값 처리 시간 | 4.6 s | 2.6초 |
| 거부된 IEDXray 이미지 | 10 | 1 |
정밀도와 재현율이 함께 상승했습니다. 이는 삭제해야 하는 오탐 박스가 줄고, 그려야 할 누락된 물체도 줄었다는 뜻입니다. 가장 큰 개선 폭은 놀랍습니다. GWHD 밀 이삭에서 Fable 5.1은 0.24를 기록했지만 Fable 5.2는 0.77을 기록합니다. RPC 소매 계산대 제품은 0.57에서 0.90으로, HIT-UAV 열화상 드론 이미지는 0.17에서 0.48로, TN5000 갑상선 초음파는 0.03에서 0.44로 상승했습니다.
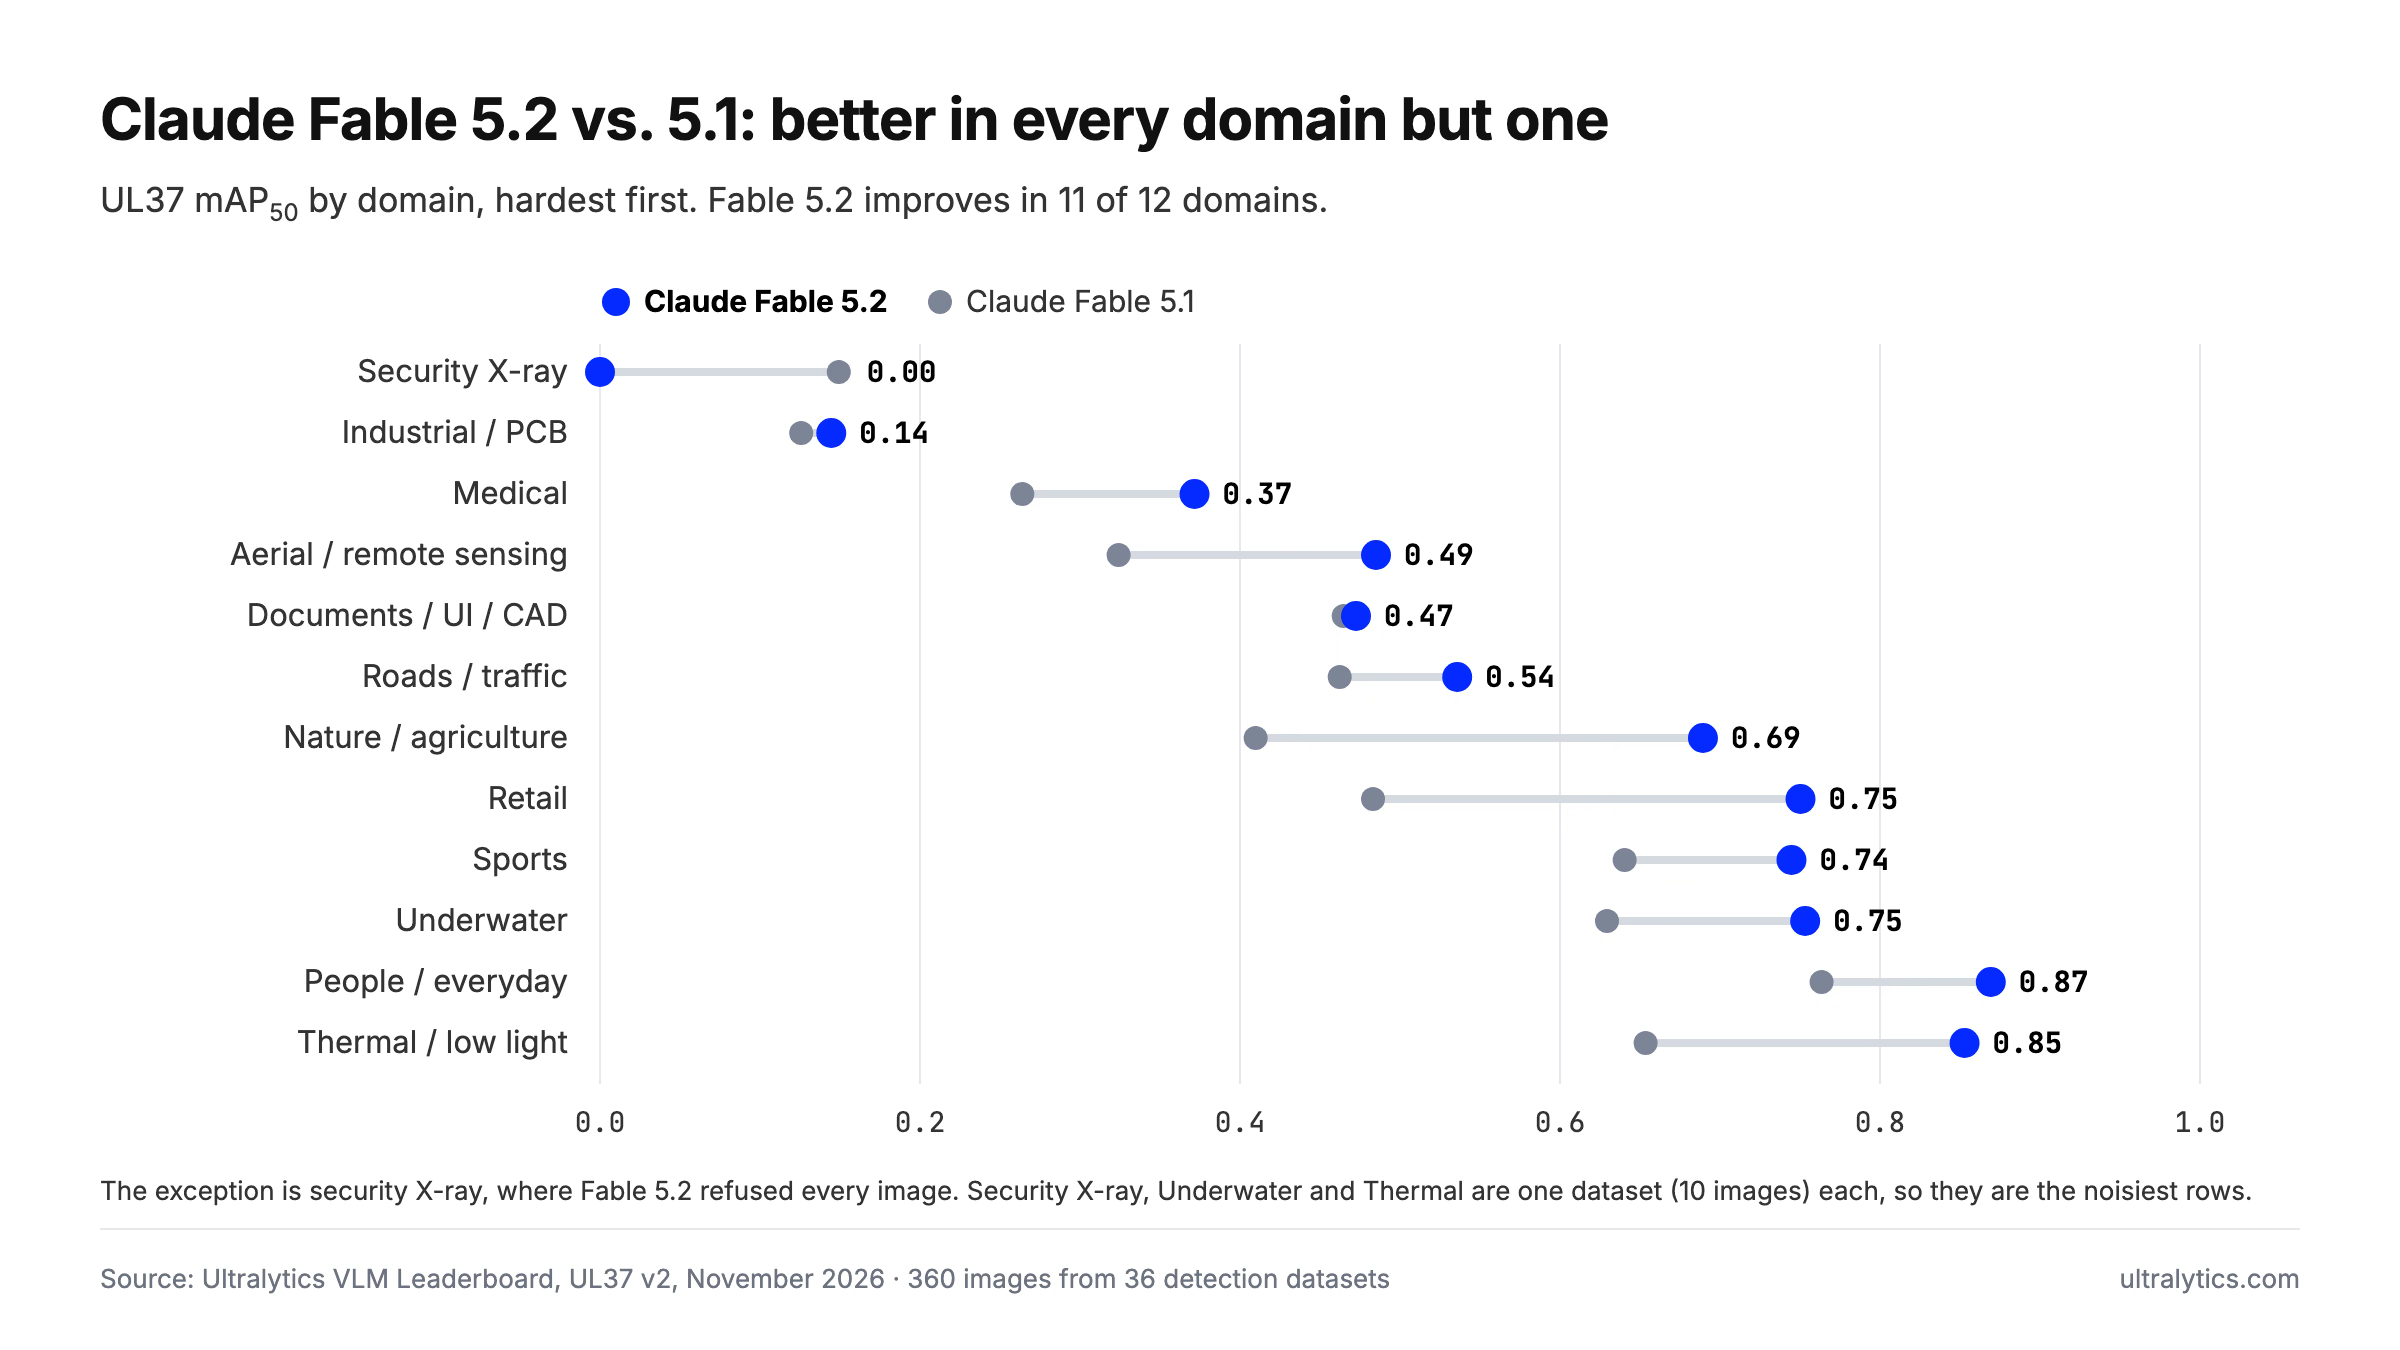
난이도가 높은 도메인부터 표시한 도메인별 UL37 mAP50, Anthropic의 기본 추론 강도 설정에서 Claude Fable 5.2와 Claude Fable 5.1 비교.
12개 도메인 중 11개에서 성능이 향상됐습니다. 유일하게 하락한 보안 X선의 점수는 0.15에서 0으로 떨어졌지만, 이는 시각 능력이 아니라 거부 때문입니다. CeyMo 도로 표식도 0.85에서 0.74로 하락했습니다.
Claude Fable 5.2와 GPT-6.1 Terra, Gemini 4 Argon, Claude Opus 5.5 비교#
| 모델 | UL37 mAP50 | mAP50-95 | 정밀도 | 재현율 | 이미지 1,000장당 비용 | 이미지당 중앙값 처리 시간 |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2.7초 |
일대일 비교에서 Fable 5.2는 Terra를 데이터셋 18개에서 앞서고 16개에서 뒤지며, 두 데이터셋에서는 동률입니다. Argon을 21대 15로, Opus 5.5를 22대 14로 앞섭니다. 네 모델 중 재현율이 가장 높아 누락하는 물체가 가장 적지만, 정밀도는 가장 낮으므로 삭제해야 할 박스가 조금 더 많을 수 있습니다. 정밀도와 재현율을 기준으로 VLM을 선택하는 방법 가이드에서 데이터에 맞게 이러한 절충점을 평가하는 방법을 설명합니다.
X선 외에 Fable 5.2가 뒤처지는 분야는 의료 영상입니다. 8개 데이터셋에서 평균 0.372를 기록해 Terra의 0.505보다 낮으며, 회로 기판 분야에서는 DeepPCB에서 0.00을 기록합니다. 각 데이터셋에는 이미지가 10장뿐이므로 단일 데이터셋 점수는 결론이 아니라 참고 지표로 보아야 합니다.
Anthropic 자체는 대부분의 작업을 "일상적인 작업에 가장 적합한" 모델인 Claude Opus 5.5로 시작하고, 작업에 필요한 경우에만 Fable로 전환하라고 권장합니다. 주석 작업에도 이 조언이 유효합니다. Opus 5.5는 Fable 5.2의 mAP50의 97%를 37%의 비용으로 달성하고, 2.7초 만에 응답하며, X선을 하나도 거부하지 않았습니다.
Claude Fable 5.2 배치 실행 비용#
이미지 1,000장당 $37.55는 공급업체 요금이며, Anthropic이 보고한 토큰 사용량과 입력 토큰 100만 개당 $8, 출력 토큰 100만 개당 $40의 정가를 기준으로 계산했습니다. 자세한 내용은 Anthropic의 가격 페이지를 참조하세요. Fable 5.2는 Anthropic의 기본 높은 추론 강도로 실행됩니다. Batch Annotation에는 이미지 1,000장당 Platform 처리 수수료 $1.00이 추가되므로, 이미지 1,000장 실행 비용은 약 $38.55입니다.
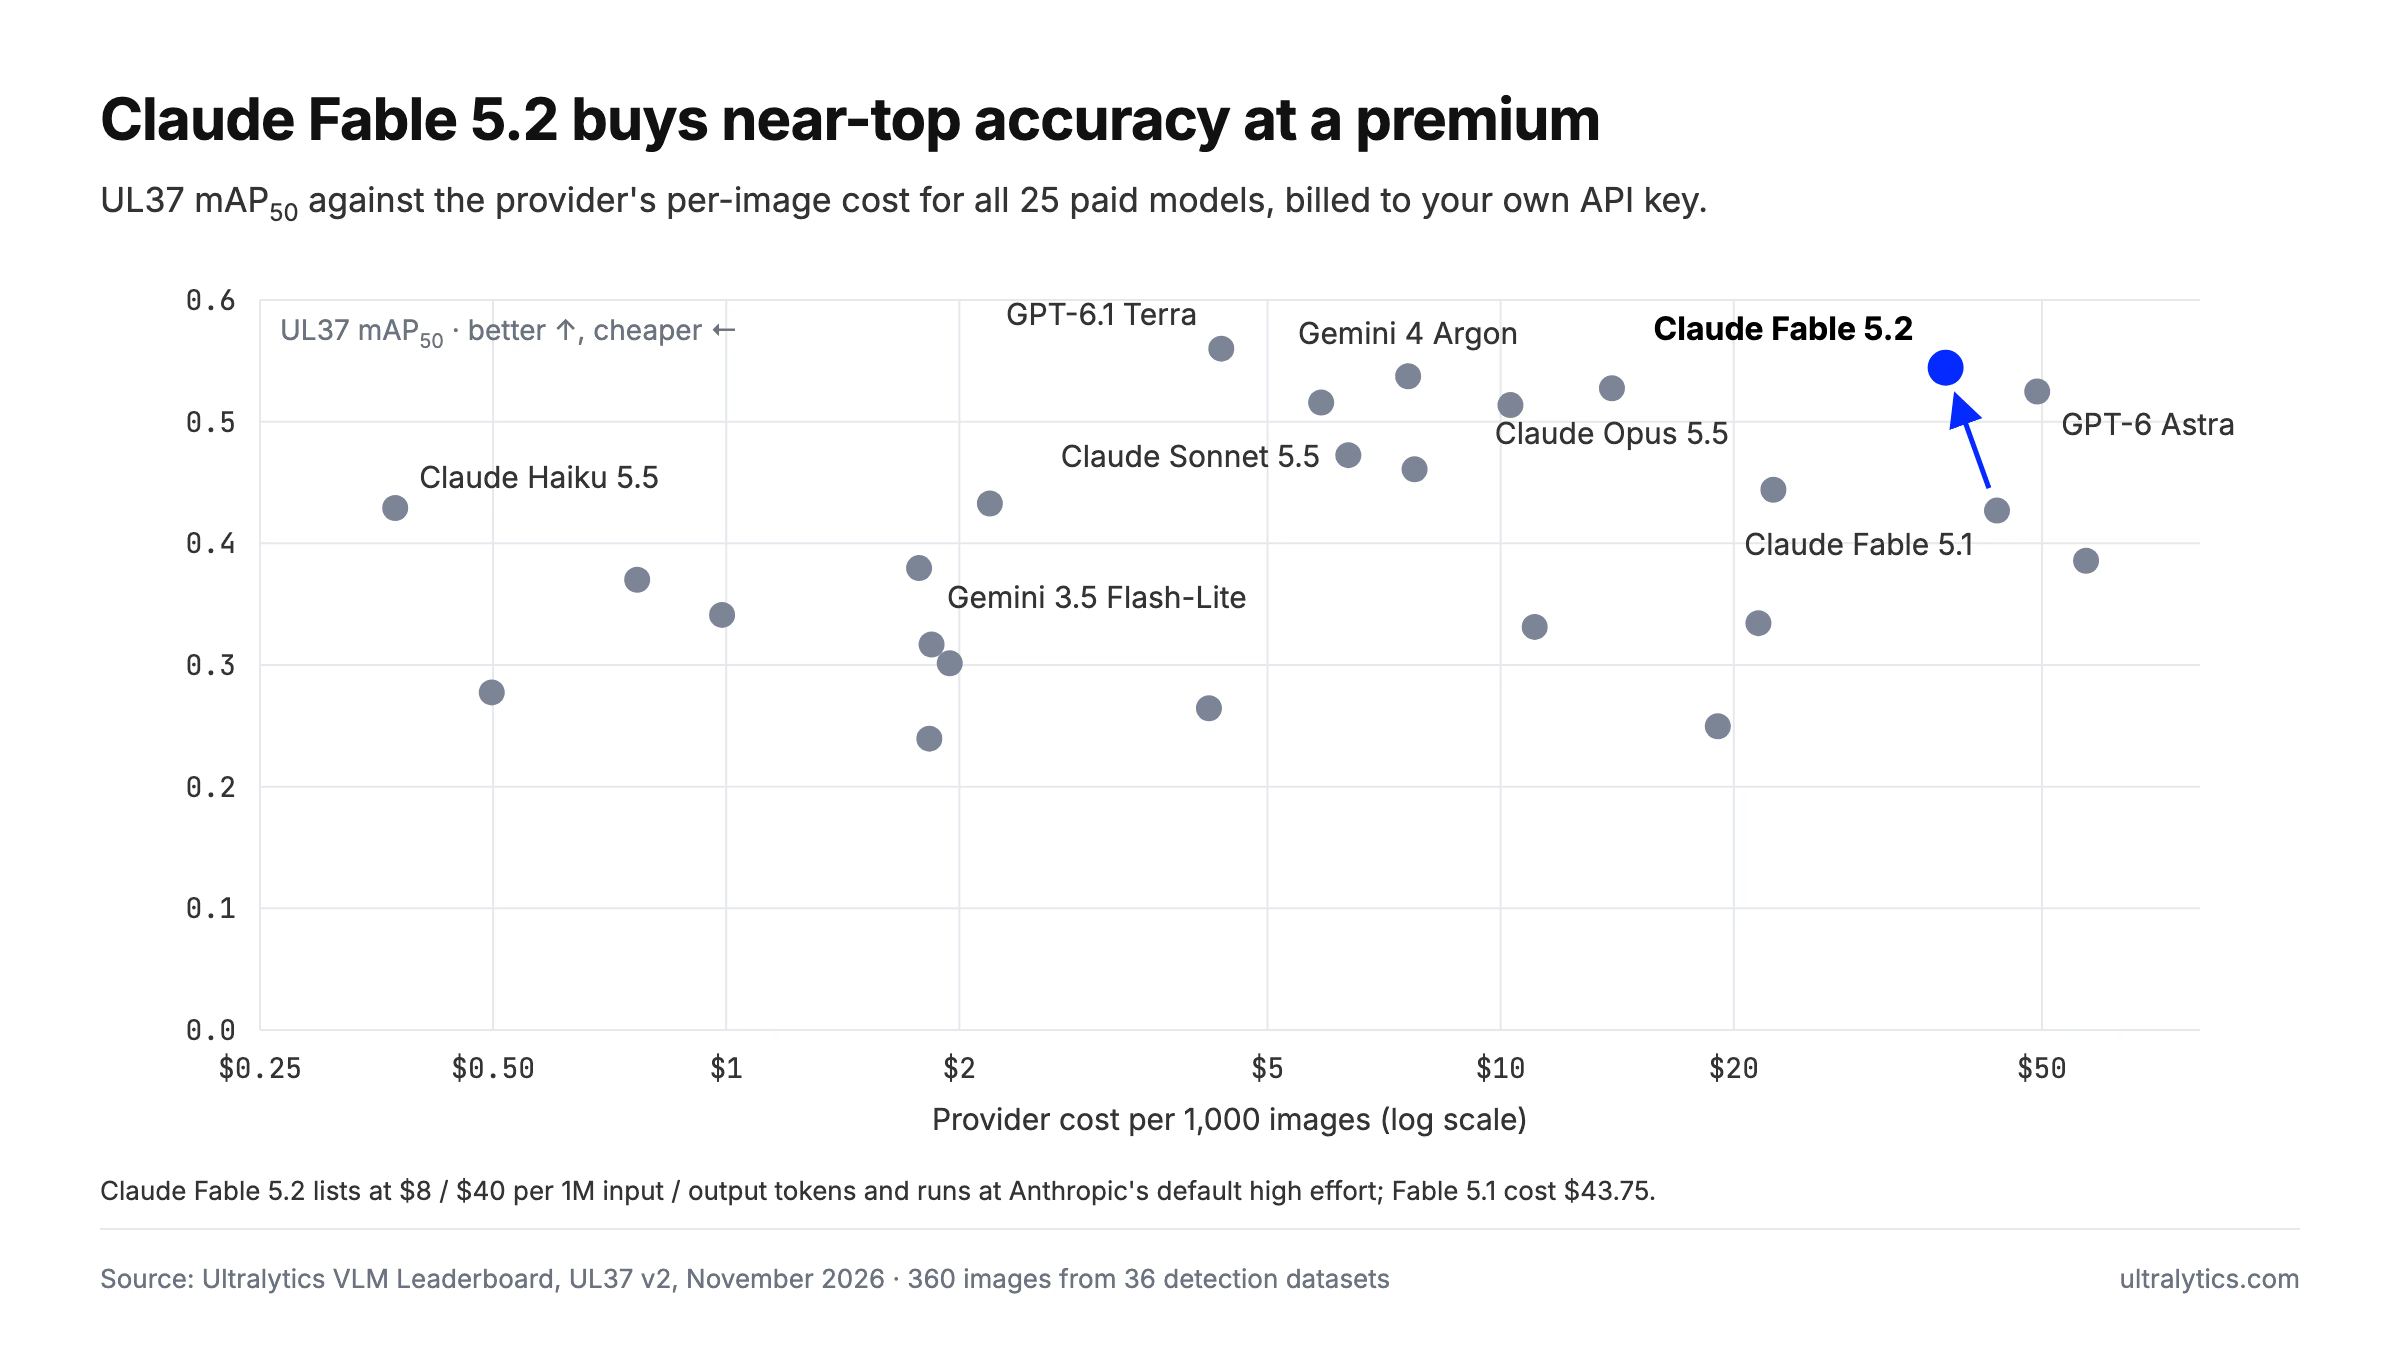
유료 모델 25개의 UL37 mAP50과 이미지 1,000장당 공급업체 비용, 정가 기준, 2026년 11월 10일.
이는 mAP50이 0.016 낮은 Terra의 $4.36보다 8배 이상 비쌉니다. Fable 5.2는 정밀한 박스가 예산보다 중요한 경우에만 비용을 정당화합니다. 비용이 중요하다면 Claude Haiku 5.5는 $0.37에 0.429를 기록하며, 호스팅된 오픈 웨이트 모델은 API 키가 전혀 필요하지 않습니다.
데이터셋에서 Claude Fable 5.2로 자동 주석을 실행하는 방법#
Fable 5.2는 클래스가 1~200개인 객체 감지 데이터셋을 위한 클래스 프롬프트 기반 모델입니다. 데이터셋 자체의 클래스 이름으로 박스를 반환하며, 저장하기 전에 검토할 수 있습니다.
- Claude API 키 페이지에서 키를 생성합니다.
- 데이터셋을 소유한 Platform 워크스페이스의 설정 > API 키에 키를 추가합니다. Anthropic이 직접 요금을 청구하며, Ultralytics는 토큰에 추가 요금을 부과하지 않습니다. 자세한 내용은 공급업체 키 문서를 참조하세요.
- 주석 편집기에서 Smart 모드로 전환하고 Anthropic 아래에서 Claude Fable 5.2를 선택합니다. Predict 또는
P을 눌러 현재 이미지에 라벨을 지정합니다. - 라벨이 없는 이미지를 모두 처리하려면 데이터셋 페이지에서 더 많은 작업 > 일괄 주석을 선택합니다. Platform은 먼저 데이터셋 버전을 저장하므로 이전 상태로 되돌릴 수 있습니다.
- 이미지 중 거부된 것이 있으면 다른 모델(예: Gemini 4 Argon 또는 호스팅된 오픈 웨이트 모델)을 사용해 Batch Annotation을 다시 실행합니다. 아직 라벨이 없는 이미지에만 라벨을 지정합니다.
- 박스를 검토하고 저장한 다음, 동일한 워크스페이스에서 결과를 사용해 YOLO26 모델을 훈련합니다.
대규모 데이터셋에 적용하기 전에 모델 페이지를 확인하세요. 이 페이지에서는 모든 벤치마크 데이터셋에서 Fable 5.2가 기록한 박스를 기대 박스와 함께 재생하고, 각 데이터셋의 점수를 표시합니다.
이 모델들이 편집기에서 작동하는 방식에 관한 자세한 내용은 Ultralytics Platform이 AI로 주석 작업을 자동화하는 방법과 사람이 참여하는 검토가 여전히 필수적인 이유를 참조하세요.
Claude Fable 5.2를 사용해야 하는 경우#
박스의 정밀도가 가장 중요하고 예산은 덜 중요하다면 Claude Fable 5.2를 선택하세요. 스포츠, 소매, 농업, 일상적인 장면에서 테스트한 모델 중 항상 최상위권 또는 그에 가까운 성능을 보입니다. mAP50-95에서 선두를 차지하므로 엄격한 IoU 임계값으로 훈련할 데이터셋의 강력한 초안 생성 모델입니다.
보안, 방위, 검색 데이터에는 사용하지 마세요. Anthropic의 필터는 휴대전화만 들어 있는 스캔까지 포함해 보안 X선 데이터셋의 모든 스캔을 거부했으며, Platform에서 이를 우회할 방법은 없습니다. 이러한 프로젝트에는 Gemini 4 Argon 또는 직접 제어할 수 있는 오픈 웨이트 모델을 사용하세요. 그 밖의 대부분의 라벨링 작업에서는 GPT-6.1 Terra 또는 Claude Opus 5.5가 훨씬 저렴한 비용으로 거의 동일한 박스를 제공합니다.
자주 묻는 질문
Anthropic의 API는 폭발물 클래스가 포함된 보안 X선 주석 요청을 차단합니다. 벤치마크의 IEDXray 스캔 10개 모두에서 일반 휴대전화나 노트북만 포함된 스캔까지 "고위력 폭발물 개발과 관련된 콘텐츠 제한"을 사유로
general_harms카테고리와 함께refusal중단 사유를 반환했습니다. Predict를 다시 눌러도 해결되지 않으므로 해당 이미지에는 다른 모델을 사용하세요.리더보드의 다른 모델은 IEDXray 스캔을 거부하지 않았습니다. 여기에는 호스팅된 모델 19개 모두, 중국 연구소의 모든 모델, Anthropic 자체의 Claude Opus 5.5, Sonnet 5.5, Haiku 5.5가 포함됩니다. Gemini 4 Argon이 0.30 mAP50으로 가장 높은 점수를 기록했고, 오픈 웨이트 모델 Moondream 3.1이 0.27로 그 뒤를 이었습니다. 보안 X선에서 모든 모델의 정확도는 낮으므로 모든 박스를 검토하세요.
예. 실제 객체 감지 데이터셋 36개에서 0.544 mAP50을 기록해 모델 44개 중 2위이며, 더 엄격한 mAP50-95 기준으로는 0.347을 기록해 1위입니다. 소매, 스포츠, 농업, 일상적인 장면에서 가장 강력하며, 보안 X선, 의료 영상, 회로 기판 결함에서는 가장 취약합니다.
Fable 5.1의 0.427에 비해 0.544 mAP50을 기록하고 36개 데이터셋 중 31개에서 앞서며, 이미지 1,000장당 비용도 $43.75에서 $37.55로 낮아졌습니다. 하지만 이미지당 4.6초로 2.6초인 Fable 5.1보다 느리고, Fable 5.1이 보안 X선 한 장을 거부한 것과 달리 10장 모두를 거부했습니다.
공급업체가 보고한 토큰 사용량을 바탕으로 입력 토큰 100만 개당 $8, 출력 토큰 100만 개당 $40을 적용하면 Anthropic 요금은 약 $37.55입니다. Ultralytics Platform의 Batch Annotation에는 이미지 1,000장당 처리 수수료 $1.00이 추가됩니다. 본인의 API 키를 사용해 Anthropic에 직접 결제합니다.
Terra는 0.560 대 0.544로 mAP50 점수가 더 높고 비용은 약 8분의 1입니다. Fable 5.2는 0.347 mAP50-95로 Terra의 0.345보다 박스가 약간 더 정밀하며, 데이터셋 18개에서 이기고 Terra는 16개에서 이깁니다. 대부분의 팀에는 Terra가 더 나은 기본 선택이며, 박스 정밀도가 비용보다 중요할 때는 Fable 5.2가 적합합니다.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









