YOLO26 객체 감지를 위한 Jetson Orin Nano Super와 Raspberry Pi 5 비교
YOLO26n 추론: 별도의 테스트에서 Jetson Orin Nano Super(TensorRT FP16)는 4.57 ms, Pi 5 CPU는 67.03 ms입니다. 모델, FPS, 카메라 수를 기준으로 선택하세요.
 Onuralp Sezer15 분 읽기
Raspberry Pi 5 또는 NVIDIA Jetson Orin Nano에서 객체 감지를 실행해야 할까요? 카메라 한 대를 사용하고 목표 프레임 레이트가 낮으며 작은 모델을 사용하는 경우에는 Pi 5 CPU로 충분할 수 있습니다. 공개된 벤치마크에서 Ultralytics YOLO26n을 NCNN으로 내보내면 4개의 Arm 코어에서 이미지당 추론 시간이 67.03 ms, 즉 추론 FPS 약 15를 기록합니다. Pi에서 제공하는 것보다 더 많은 카메라, 더 큰 모델 또는 더 높은 프레임 레이트 여유가 필요하다면 Jetson을 선택할 만합니다. Jetson Orin Nano Super Developer Kit에서는 동일한 모델이 TensorRT FP16 엔진으로 4.57 ms가 걸립니다.
Ultralytics는 이 비교를 게시하고 두 보드에서 모두 실행되는 YOLO26을 제작하지만, 어느 보드도 제조하지 않습니다. Jetson 수치는 NVIDIA의 보급형 Orin 개발 키트인 Orin Nano Super Developer Kit에서, Pi 수치는 Raspberry Pi 5에서 각각 별도로 테스트한 결과입니다. 많은 사용자가 여전히 2019년에 출시된 원래 보드인 "Jetson Nano"를 검색합니다. JetPack 4를 통해 YOLO26을 실행할 수 있지만, Jetson 가이드에는 이 보드의 YOLO26 벤치마크가 포함되어 있지 않으므로 여기서는 사양만 소개합니다.
아래에서는 모델 크기, 목표 프레임 레이트와 카메라 스트림 수에 따른 보드 비교, 카메라를 추가할 때 FPS가 떨어지는 이유, 두 보드를 직접 측정하는 방법, 프로젝트에 적합한 보드를 설명합니다. 설정 방법은 NVIDIA Jetson 가이드와 Raspberry Pi 가이드에 있으며, Raspberry Pi 5 CPU에서 객체 감지하기 안내에서는 Pi 관련 내용을 자세히 다룹니다.
Pi 5는 CPU에서 YOLO를 실행하고, Orin Nano Super는 GPU를 제공합니다.#
두 보드는 서로 다른 실리콘으로 같은 문제를 해결합니다. Raspberry Pi 5는 Arm Cortex-A76 코어 4개를 갖춘 범용 컴퓨터이며 전용 AI 가속기가 없으므로 Pi 벤치마크에서는 CPU에서 YOLO를 실행합니다. Jetson Orin Nano Super Developer Kit은 Ampere GPU를 기반으로 하는 Orin Nano 모듈과 캐리어 보드를 결합하며, NVIDIA TensorRT 런타임은 해당 GPU용으로 모델을 컴파일합니다. 이는 이러한 워크로드를 위해 설계된 엣지 AI 플랫폼입니다.
| Jetson Nano 4GB(2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| YOLO용 컴퓨팅 | 128코어 Maxwell GPU | 1024코어 Ampere GPU, Tensor Core 32개 | 4코어 Arm Cortex-A76 CPU |
| CPU | 4코어 Cortex-A57, 1.43 GHz | 6코어 Cortex-A78AE, 최대 1.7 GHz | 4코어 Cortex-A76, 최대 2.4 GHz |
| 메모리 | 4 GB LPDDR4, 25.6 GB/s | 8 GB LPDDR5, 102 GB/s | 모델에 따라 다름 |
| AI 성능(NVIDIA 최고 성능 수치) | 472 GFLOPS | 67 sparse INT8 TOPS | — |
| JetPack / OS | JetPack 4만 지원 | JetPack 5~7 | Raspberry Pi OS |
| Ultralytics 배포 경로 | DeepStream을 포함한 TensorRT | TensorRT(벤치마크에서 가장 빠름) | NCNN(벤치마크에서 가장 빠름) |
사양이며 측정값이 아닙니다. 2026년 11월 19일 확인. NVIDIA의 최고 성능 수치는 서로 다른 숫자 형식을 사용하므로 직접 비교할 수 없습니다. Orin Nano Super의 67 TOPS는 sparse INT8 수치이며, NVIDIA는 dense 성능을 33 TOPS로 표기합니다. Jetson 행은 NVIDIA Jetson 가이드의 비교 및 JetPack 표와 DeepStream 가이드를 참조했으며, Pi 5 행은 Raspberry Pi 문서를 참조했습니다.
전력도 선택의 한 요소입니다. NVIDIA는 Orin Nano Super Developer Kit의 전력을 7 W~25 W로 표기합니다. 보드에 Super 지원 구성을 플래시하면 Orin Nano 8GB는 15 W, 25 W, MAXN SUPER 전력 모드를 제공하며, 기본 구성에서는 기존 7 W 및 15 W 모드를 유지합니다. 어떤 보드를 선택하든 카메라를 연결한 전체 시스템의 소비 전력을 측정해야 전원 공급 장치와 케이스가 감당해야 할 전력을 파악할 수 있습니다.
보드 가격만 보지 말고 스토리지, 전원, 냉각 장치, 카메라를 포함한 전체 시스템의 비용을 계산하세요. 두 플랫폼 모두 관련 비용이 더해집니다. 메모리 비용이 상승하면서 Raspberry Pi는 2026년에 Pi 5 가격을 여러 차례 인상했습니다. 2026년 11월 기준 2GB Pi 5의 가격은 $77.50, 16GB 보드의 가격은 $385입니다. 최신 Jetson 가격 및 재고는 NVIDIA 개발 키트 페이지에서 확인하고, Pi에 필요한 Raspberry Pi AI HAT+와 같은 가속기 비용도 더하세요. 생산용으로 NVIDIA는 자체 캐리어 보드에 장착할 Jetson 모듈을 판매합니다. 벤치마크에 사용한 개발 키트는 개발 및 프로토타이핑용입니다.
낮은 FPS의 YOLO26n 워크로드에는 Pi 5 CPU가 적합합니다.#
필요한 프레임 레이트가 낮다면 Pi 5는 추가 하드웨어 없이 단일 카메라 감지를 처리할 수 있습니다. Ultralytics 벤치마크(FP32 내보내기, 640픽셀 입력, COCO128, Ultralytics 8.4.108, 추론 시간만 측정)에서 NCNN이 가장 빠른 내보내기 형식이었습니다. YOLO26n은 이미지당 67.03 ms, mAP50-95 0.4784를 기록했습니다. 추론 FPS로 환산하면 약 15이며, 빠른 움직임이 필요하지 않은 계수 스테이션, 선반 카메라 또는 로봇 프로토타입에 적합할 수 있습니다. 추론 시간만이 아니라 전체 카메라 파이프라인을 검증하세요. Arm은 Pi 5에서 YOLO26n을 위한 오픈 소스 런타임도 공개했으며, 자체 테스트에서 NCNN보다 빠른 것으로 측정했습니다. Raspberry Pi 5 안내에서 두 런타임을 비교합니다.
Pi의 한계는 모델 크기에서 드러납니다. 더 큰 YOLO26s는 Pi 5에서 NCNN으로 172.88 ms가 걸려 추론 FPS가 6 미만입니다. Raspberry Pi 가이드의 다중 형식 비교(Ultralytics 8.4.108)는 n 및 s 모델만 다룹니다. 이전 ONNX 비교(Ultralytics 8.4.14)에는 m, l, x 모델도 포함되며, 해당 테스트에서 YOLO26m은 993.78 ms를 기록했습니다. 작은 객체나 구분하기 어려운 클래스 때문에 더 큰 모델이나 높은 입력 크기가 필요하다면, 도입하기 전에 해당 보드에서 모델을 테스트하세요.
Pi 5에 AI HAT+ 추가하기#
세 번째 구성도 고려할 수 있습니다. Raspberry Pi의 AI HAT+를 Pi 5에 장착하면 13 TOPS 또는 26 TOPS 버전의 Hailo 가속기를 추가할 수 있습니다. Ultralytics Hailo 통합 벤치마크(Ultralytics 8.4.174, COCO128)에서 26 TOPS Hailo-8 버전용으로 내보낸 YOLO26n은 이미지당 21.7 ms, mAP50-95 0.455를 기록했습니다. 같은 Pi에서 내보내지 않은 PyTorch 모델은 364.6 ms가 걸렸습니다. 해당 테스트에는 입력 크기가 명시되지 않았고 INT8로 실행되었으므로 아래 비교표의 행과는 별개인 벤치마크로 보아야 합니다. Hailo 모델은 컴파일 단계가 필요하므로 내보낸 후 자체 이미지로 정확도를 확인하세요.
Orin Nano Super에서 YOLO26n부터 YOLO26l까지 18 ms 미만의 추론 시간을 기록합니다.#
Jetson에서는 더 큰 모델을 실용적으로 사용할 수 있습니다. Orin Nano Super Developer Kit에서 수행한 Ultralytics 벤치마크(640픽셀 입력, COCO128, Ultralytics 8.4.33, 추론만 측정)에서 n부터 l까지 모든 모델 크기의 이미지당 추론 시간이 TensorRT FP16 엔진으로 18 ms 미만이었습니다.
| YOLO26 모델 | Raspberry Pi 5 CPU(ms/이미지) | Orin Nano Super, TensorRT FP16(ms/이미지) | Orin Nano Super mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67.03(NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88(NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78(이전 ONNX 테스트, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46(이전 ONNX 테스트, 8.4.14) | 17.42 | 0.6225 |
별도로 수행한 테스트의 공개 결과입니다. Orin Nano Super: Ultralytics 8.4.33. 모든 행은 640픽셀 입력 기준이며 전처리 및 후처리를 제외한 추론 시간만 나타냅니다.
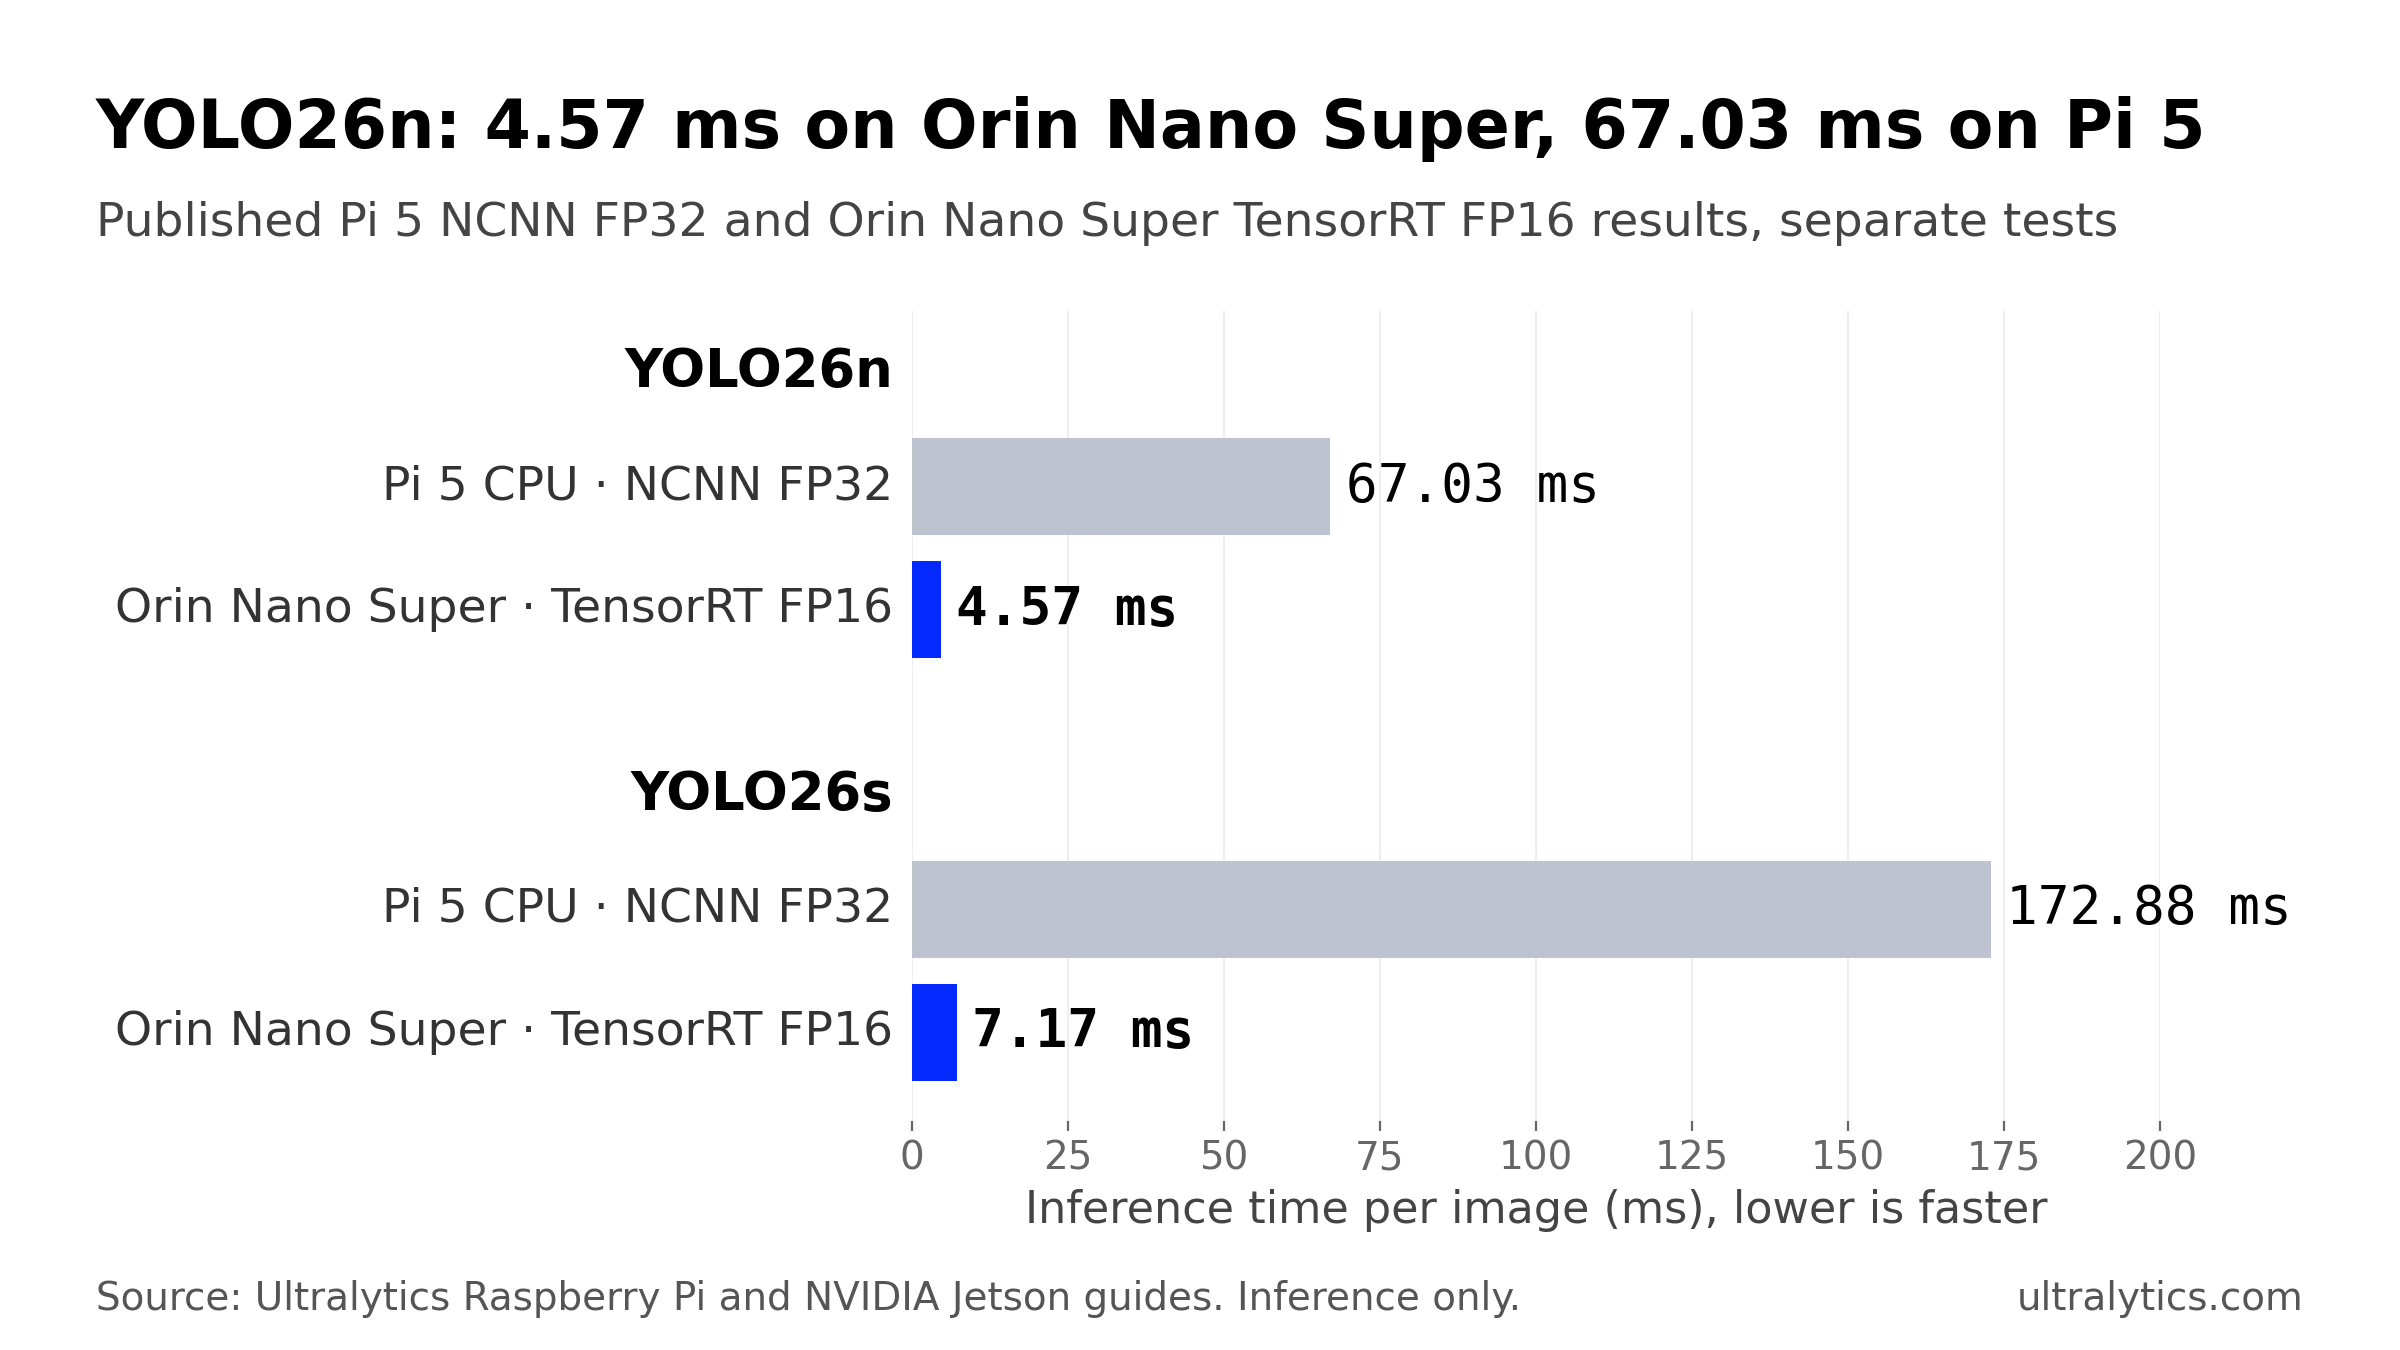
별도로 수행한 테스트에서 공개된 NCNN FP32 및 TensorRT FP16 결과입니다. Raspberry Pi 5는 Ultralytics 8.4.108, Orin Nano Super Developer Kit은 Ultralytics 8.4.33을 사용했습니다. 전처리 및 후처리를 제외한 추론만 측정했습니다. 출처: Ultralytics Raspberry Pi 및 NVIDIA Jetson 가이드.
YOLO26n의 경우 Pi 5 CPU보다 추론 시간이 약 93% 짧습니다. 성능 차이에는 정밀도 차이도 영향을 주므로 FP32 내보내기도 비교해 보세요. Orin Nano Super의 FP32 TensorRT 엔진은 7.53 ms가 걸립니다. 런타임과 테스트 버전은 다르지만, Pi의 FP32 NCNN 내보내기보다 여전히 거의 9배 빠릅니다. 더 중요한 차이는 YOLO26m입니다. mAP50-95 0.6225에서 13.59 ms를 기록하며, Pi 5 CPU에서는 이전 ONNX 테스트 기준 초당 약 한 프레임으로 실행되는 모델입니다.
INT8을 사용하면 시간이 조금 더 줄어듭니다. YOLO26n은 INT8 엔진으로 3.80 ms까지 단축되지만, COCO128에서 mAP50-95는 0.4800에서 0.4490으로 낮아집니다. FP16부터 시작하고, FP16이 성능 예산을 충족하지 못하며 자체 카메라의 이미지로 보정할 수 있는 경우에만 INT8 양자화를 적용하세요. Ultralytics Academy의 TensorRT 최적화 강의에서 이 선택 과정을 자세히 설명합니다.
카메라를 추가하면 모든 스트림이 하나의 연산 예산을 공유하므로 FPS가 낮아집니다.#
시스템을 확장할 때 흔히 나타나는 현상입니다. 카메라 한 대에서는 원활하게 실행되지만 세 번째 또는 네 번째 카메라를 추가하면 처리 프레임 레이트가 낮아집니다. 각 프레임에는 디코딩, 전처리, 추론, 후처리가 필요하며 모든 카메라가 같은 연산 자원을 공유합니다. Pi 5에서는 동일한 CPU 코어 4개가 영상 디코딩과 모델 실행을 모두 처리하므로, 스트림을 추가할 때마다 양쪽 작업에 할당되는 시간이 줄어듭니다.
Ultralytics가 스트림 처리를 담당합니다. .streams 파일에 소스를 한 줄에 하나씩 나열하고 Predict 모드에 전달하세요. 각 스트림에는 자체 리더 스레드가 할당되며, 로더는 각 카메라의 최신 프레임을 하나의 배치로 묶습니다. 따라서 속도가 느리거나 프레임이 누락된 소스 하나가 배치 처리를 지연할 수 있습니다. 배치를 지원하는 백엔드는 한 번의 순전파로 배치를 처리하며, NCNN은 프레임을 하나씩 처리합니다. 고정 입력 형태의 TensorRT 엔진은 내보내기 크기에 맞추도록 배치를 분할하거나 패딩합니다. 기본 설정(stream_buffer=False)에서는 모델이 느릴 때 오래된 프레임을 대기열에 쌓는 대신 건너뛰므로 애플리케이션 내 백로그가 짧게 유지됩니다. 다만 카메라, 디코더 또는 네트워크의 버퍼링은 여전히 지연을 추가할 수 있습니다.
단일 이미지 지연 시간은 카메라 수를 정하기 위한 출발점일 뿐입니다. 배칭은 처리량을 바꾸며, 디코딩, 트래킹, 화면 표시에도 각각 비용이 발생합니다. Ultralytics Academy의 다중 스트림 추론 강의에서는 장치당 스트림 수를 실제 배치 크기에서의 지속 처리량을 각 스트림에 필요한 FPS로 나눈 값으로 산정하고, 피크에 대비해 20~30%의 여유를 두도록 안내합니다. 아래 실습 섹션에서 설명하듯 카메라를 연결한 상태로 보드의 처리량을 측정하세요. Jetson에서 다중 카메라 파이프라인을 구축할 때 DeepStream은 하나의 타일형 애플리케이션에서 여러 소스를 단일 TensorRT 엔진으로 처리합니다.
측정한 카메라별 FPS, 모델 크기, 정확도를 기준으로 선택하세요.#
작동 가능성이 있는 가장 저렴한 보드부터 시작해 자체 카메라로 측정하고, 성능이 부족한 경우에만 상위 보드로 전환하세요.
| 측정 결과가 다음과 같다면… | 다음으로 시작하세요: |
|---|---|
| YOLO26n이 정확도 목표와 카메라별 FPS를 충족합니다. | NCNN을 사용하는 Pi 5 CPU입니다. FPS가 낮은 작업이라면 카메라를 두 대 이상 연결해도 적합할 수 있습니다. |
| Pi의 프레임 레이트가 부족하지만 Pi를 계속 사용하고 싶습니다. | Hailo-8 AI HAT+ 또는 DEEPX DX-M1과 같은 가속기를 장착한 Pi 5입니다. 두 장치 모두 양자화 모델을 실행하며 컴파일 단계가 필요하므로, 내보낸 후 정확도를 확인하세요. |
| 높은 FPS에서 더 큰 모델을 실행하거나, Pi가 지속적으로 처리할 수 있는 수보다 많은 스트림을 사용하거나, 다른 소프트웨어를 위한 CPU 시간이 필요합니다. | TensorRT를 사용하는 Jetson Orin Nano Super를 선택하고, 측정한 처리량이 부족하면 Orin NX 또는 AGX Orin으로 업그레이드하세요. |
프레임 레이트는 벤치마크 수치이기 전에 비즈니스 요구 사항입니다. 컴퓨터 비전에서 FPS에 관한 가이드에서는 관찰 대상의 속도를 기준으로 목표를 설정하는 방법을 설명하고, 적합한 엣지 디바이스 선택하기에서는 이 두 제품 외의 보드도 다룹니다.
자체 카메라로 두 보드를 측정하세요.#
위 수치는 통제된 조건에서 측정한 결과이며, 냉각, 전력 모드, OS 이미지, 소프트웨어 버전, 자체 모델에 따라 실제 결과가 달라집니다. Ultralytics 패키지는 두 보드에서 동일한 API를 사용하므로 양쪽에서 같은 측정을 수행할 수 있습니다. 아래 명령은 Ultralytics 8.4.215에서 확인했습니다.
1단계: 각 보드에서 내보내기 형식 벤치마크하기#
보드에서 yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640을 실행하세요. Benchmark 모드는 보드가 지원하는 각 내보내기 형식에 대해 모델 크기, mAP50-95, 추론 시간을 출력합니다. 형식에서 지원하는 경우 quantize=16 또는 quantize=8을 추가하여 FP16 또는 INT8을 측정하세요. Super 지원 구성이 플래시된 Orin Nano Super Developer Kit에서는 먼저 MAXN SUPER 전력 모드를 선택하세요. Orin Nano용 JetPack 6.2에 관한 NVIDIA의 Super Mode 게시물에 따르면 해당 설정은 sudo nvpmodel -m 2입니다. 그런 다음 sudo jetson_clocks을 실행하세요. 장시간 실행 중에는 온도를 확인하세요.
2단계: 각 보드에서 가장 빠른 형식으로 내보내기#
Raspberry Pi 5에서는 Raspberry Pi 5 안내에 나온 대로 NCNN으로 내보내세요. Jetson에서는 엔진을 해당 장치에서 빌드하세요. TensorRT 엔진은 엔진을 빌드한 GPU와 TensorRT 버전에 종속되기 때문입니다. dynamic 없이 내보낸 엔진은 입력 형태가 고정됩니다. 한 가지 방법은 batch를 카메라 수로 설정하고, 속도를 높여야 한다면 더 작은 imgsz으로 다시 내보내는 것입니다.
from ultralytics import YOLO

# Jetson 전용: NVIDIA GPU가 필요합니다. FP16 TensorRT 엔진, 640픽셀, 카메라 4대 배치
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # yolo26n.engine을 씁니다.
3단계: 카메라별 처리 FPS 측정하기#
cams.streams에 RTSP URL을 한 줄에 하나씩 넣고, 해당 보드에서 모델을 약 1분간 실행한 다음 각 카메라의 처리 FPS를 송신 속도와 비교하세요. 스트림이 연결되고 모델이 워밍업된 후 첫 번째 전체 배치가 처리되면 타이머를 시작하고, 전체 배치 처리가 완료되면 타이머를 중지합니다.
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
이 측정은 해당 파이프라인의 처리 결과 처리량을 보여줍니다. 스트림을 추가할수록 카메라의 처리 FPS가 프레임 레이트보다 크게 낮아진다면 보드가 처리를 따라가지 못하는 것입니다. Academy의 다중 스트림 강의에 있는 생산자-소비자 예제의 명시적인 스트림별 드롭 카운터를 사용해 확인하고, 애플리케이션에 필요한 트래킹 또는 화면 표시를 추가하세요. 그런 다음 더 작은 imgsz으로 다시 내보내거나, 더 작은 모델 또는 더 빠른 내보내기 형식을 사용하거나, 하드웨어를 업그레이드한 뒤 다시 측정하세요.
빌드 환경을 설정하고 싶지 않다면 Ultralytics Platform의 Export 탭에서 Orin Nano 8GB Super를 포함한 Jetson 대상 TensorRT 엔진을 빌드할 수 있습니다. Orin 설정은 AGX Orin에서 빌드되며 Orin Nano 자체에서의 검증은 아직 진행 중입니다. 따라서 장치의 TensorRT 및 CUDA 런타임이 엔진과 호환되는지 확인하고, 배포할 장치에서 각 엔진을 검증하세요. NVIDIA GPU에서 ONNX Runtime과 TensorRT를 비교하려면 ONNX와 TensorRT 비교를 참조하세요.
선택할 보드#
YOLO26n이 정확도 목표를 충족하고 보드에서 측정한 처리 FPS가 필요한 모든 카메라를 지원한다면 Raspberry Pi 5를 선택하세요. 추론 FPS 약 15로, 소매점 계산대, 컨베이어 계수, 야생 동물 및 가정용 카메라, 초기 로봇 프로토타입에 적합한 간단한 시스템을 구축할 수 있습니다. 더 많은 프레임이 필요하지만 Pi를 계속 사용하고 싶다면 가속기를 추가하세요.
nano보다 큰 모델을 실용적인 프레임 레이트로 실행해야 하거나, Pi가 지속적으로 처리할 수 있는 수보다 많은 스트림이 필요하거나, 트래킹, 내비게이션 및 나머지 애플리케이션을 위해 CPU 시간을 확보해야 한다면 Jetson Orin Nano Super를 선택하세요. 이 보드에서는 YOLO26s부터 YOLO26l까지 이미지당 추론 시간이 18 ms 미만이며, 카메라를 추가할 때 사용할 수 있는 여유 성능입니다. 전체 애플리케이션을 측정해 이를 확인하세요.
Ultralytics를 활용할 수 있는 영역#
Ultralytics는 두 보드 모두 제조하지 않습니다. 두 보드에서 실행되는 모델과 도구를 제작합니다. 동일한 YOLO26 가중치를 Pi 5용 NCNN, AI HAT+를 장착한 Pi용 Hailo, Jetson용 TensorRT로 내보낼 수 있으므로 재학습 없이 Pi에서 프로토타입을 만들고 워크로드가 증가하면 Jetson으로 옮길 수 있습니다. 각 내보내기 후 정확도를 검증하세요. Ultralytics Platform에서 배포 전 단계를 처리할 수 있습니다. 데이터셋에 주석을 달고, 로컬에서 사용할 수 있는 것보다 더 많은 학습 연산 자원이 필요한 프로젝트라면 클라우드에서 학습한 다음 두 보드 중 하나에 맞게 내보내세요.
한계도 있습니다. 공개된 벤치마크는 명시된 테스트 장치에서 추론만 측정했으며, 자체 카메라, 케이스 또는 생산용 모듈에서는 측정하지 않았습니다. 또한 Jetson 가이드에는 원래 Jetson Nano의 YOLO26 결과가 포함되어 있지 않습니다. Ultralytics YOLO는 AGPL-3.0 또는 Ultralytics Enterprise License에 따라 사용할 수 있습니다. 배포에 필요한 라이선스는 Ultralytics 라이선스를 참조하세요.
자주 묻는 질문
이미지당 처리 속도는 훨씬 빠릅니다. 서로 별도로 수행한 공개 벤치마크에서 YOLO26n은 Jetson Orin Nano Super Developer Kit의 TensorRT FP16 엔진으로 4.57 ms, Raspberry Pi 5 CPU의 NCNN으로 67.03 ms가 걸렸습니다(640픽셀 입력, 추론만 측정). Jetson에서 YOLO26m은 13.59 ms를 기록했습니다. 이런 성능이 필요한지는 모델, 카메라 수, FPS 목표에 따라 다릅니다. 자체 측정에서 Pi 5가 요구 사항을 충족한다면 Pi 5가 더 간단한 구성입니다.
아닙니다. 원래 Jetson Nano는 2019년에 128코어 Maxwell GPU와 4 GB 메모리를 탑재해 출시되었으며 JetPack 4만 지원합니다. Jetson Orin Nano는 1024코어 Ampere GPU를 탑재한 최신 모듈입니다. 벤치마크에 사용한 Orin Nano Super Developer Kit은 메모리 8 GB를 탑재하고 JetPack 5~7을 지원합니다. 이 문서의 성능 비교는 Orin Nano Super를 대상으로 하며 원래 Nano는 포함하지 않습니다.
예. 2019년형 Jetson Nano는 JetPack 4를 지원하고, Ultralytics는 JetPack 4 Docker 이미지를 제공합니다. TensorRT를 사용하는 YOLO26용 DeepStream 가이드는 JetPack 4.6.4가 설치된 Jetson Nano 4GB에서 테스트했습니다. Jetson 가이드에는 이 장치의 YOLO26 벤치마크가 없으며, 하드웨어 성능은 Orin Nano Super보다 훨씬 낮습니다.
모든 스트림이 보드의 연산 자원을 공유합니다. 카메라를 추가할 때마다 해당 카메라의 디코딩, 전처리, 추론, 후처리를 수행해야 합니다.
.streams파일을 사용하면 Ultralytics는 모든 카메라의 프레임을 배치로 묶고 모델이 처리 속도를 따라가지 못할 때 오래된 프레임을 건너뜁니다. 따라서 공유 파이프라인이 병목이 되면 카메라별 처리 FPS가 낮아질 수 있습니다. 더 빠른 내보내기 형식, 더 작은 모델,imgsz또는 더 강력한 하드웨어를 사용하면 FPS를 높일 수 있습니다.예. 한 번 학습한 다음 Pi 5용으로
format="ncnn", Jetson용으로format="engine"을 사용해 동일한 가중치를 내보내세요. TensorRT 엔진은 대상 장치에서 또는 대상 장치용으로 빌드해야 합니다. 각 내보내기 후 자체 데이터로 정확도를 검증하세요.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









