컴퓨터 비전 추론을 위한 ONNX와 TensorRT 비교: 벤치마크 및 선택 방법
컴퓨터 비전 추론을 위한 ONNX Runtime과 TensorRT 비교: NVIDIA GPU 19종에서 측정한 Ultralytics YOLO26의 속도와 정확도, 그리고 선택 방법
 Miles Deans11 분 읽기
ONNX와 TensorRT는 사실 경쟁 관계가 아닙니다. ONNX는 모델 형식이고 TensorRT는 NVIDIA의 추론 엔진이며, 일반적으로 ONNX 파일을 입력으로 사용합니다. 실제 선택 기준은 해당 파일을 실행하는 방법입니다. 하드웨어 전반에서 작동하고 TensorRT에 작업을 위임할 수도 있는 ONNX Runtime을 사용하거나, NVIDIA GPU에서만 실행되는 독립형 TensorRT 엔진으로 컴파일할 수 있습니다. NVIDIA GPU 19종에서 Ultralytics YOLO26을 대상으로 진행한 Ultralytics Platform 벤치마크에서 TensorRT FP16은 모든 GPU와 모델 크기에서 공개된 ONNX FP16 결과보다 빨랐으며, 정확도 차이는 0.001 mAP50-95 이내였습니다. 모델 크기별 중앙값 기준 속도 향상은 1.85배에서 2.55배였습니다. 벤치마크에는 ONNX 결과를 생성한 ONNX Runtime 실행 제공자가 명시되어 있지 않으므로, ONNX Runtime의 일반적인 성능이나 TensorRT 실행 제공자를 사용하는 경우와의 비교 결과를 확정할 수는 없습니다. NVIDIA GPU에서 Ultralytics YOLO26을 사용할 때 지연 시간이 중요하다면 TensorRT FP16으로 시작하고, 하나의 모델 파일을 여러 종류의 하드웨어에서 실행해야 한다면 ONNX Runtime을 사용하세요. Ultralytics YOLO는 하나의 인수로 두 형식 모두 내보낼 수 있습니다.
Ultralytics YOLO를 시작하는 방법:
| 배포 | 다음으로 시작하세요: | Ultralytics YOLO 내보내기 |
|---|---|---|
| NVIDIA GPU, 지연 시간이 중요함 | TensorRT FP16 | format="engine", quantize=16 |
| CPU, 비NVIDIA 하드웨어 또는 혼합 환경 | ONNX Runtime | format="onnx" |
| NVIDIA GPU에서 사용하는 ONNX Runtime API | TensorRT 실행 제공자를 사용하는 ONNX Runtime | format="onnx" |
ONNX와 TensorRT 비교: 형식, 런타임 및 엔진#
이 비교에는 서로 다른 세 가지가 포함됩니다:
- ONNX(개방형 신경망 교환)는 학습된 모델의 그래프와 가중치를 프레임워크에 종속되지 않는 방식으로 저장하는 파일 형식입니다. 다른 도구에서 모델을 읽을 수 있도록 PyTorch에서 ONNX로 내보냅니다.
- ONNX Runtime은 ONNX 모델을 실행합니다. CPU, CUDA, TensorRT와 같은 하드웨어 백엔드인 실행 제공자에 작업을 위임하므로, 동일한 파일을 노트북 CPU나 클라우드 GPU에서 실행할 수 있습니다.
- TensorRT는 ONNX 파서를 통해 일반적으로 ONNX 파일인 모델을 읽습니다. 레이어를 융합하고, 대상 GPU에서 각 연산에 가장 빠른 커널을 선택한 다음 최적화된 엔진을 작성합니다.
따라서 실제 비교 대상은 ONNX Runtime과 TensorRT입니다. ONNX Runtime은 TensorRT 실행 제공자를 통해서도 TensorRT를 호출할 수 있습니다. 이 방식을 사용하면 ONNX Runtime API를 유지하면서 TensorRT가 지원하는 서브그래프를 실행할 수 있습니다. ONNX Runtime은 TensorRT가 지원하지 않는 노드를 CUDA에서 실행할 수 있도록 CUDA 실행 제공자를 그 뒤에 등록하도록 권장합니다.
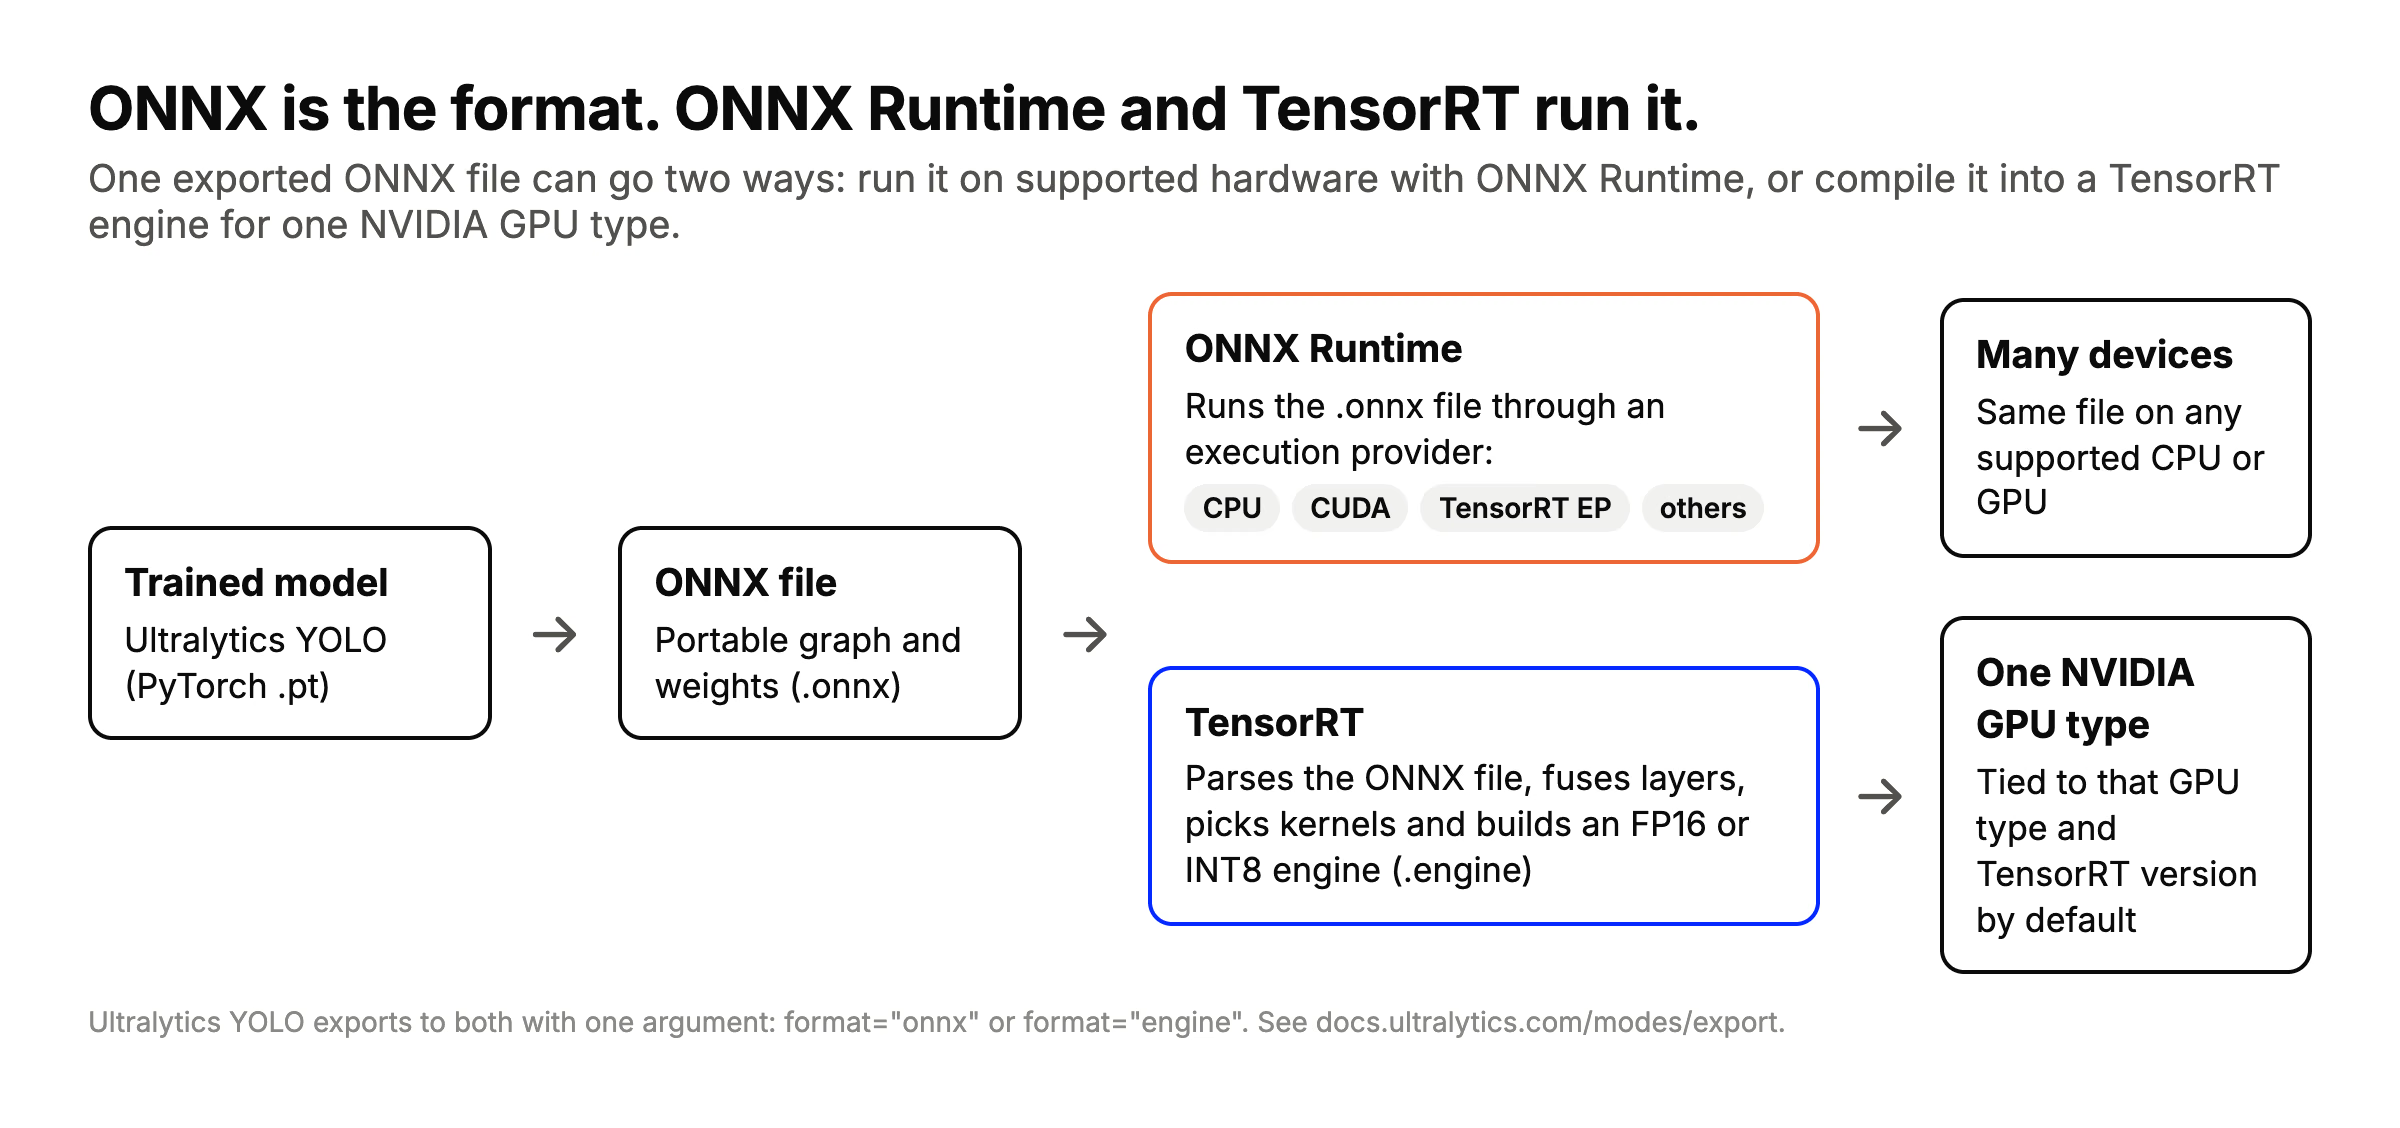
하나의 ONNX 파일, 두 가지 실행 경로: ONNX Runtime은 지원되는 하드웨어에서 파일을 실행하고, TensorRT는 특정 NVIDIA GPU 유형에 맞는 엔진으로 컴파일합니다. Ultralytics YOLO는 두 형식 모두로 내보낼 수 있습니다.
벤치마크: ONNX Runtime과 TensorRT에서 실행한 YOLO26#
아래 수치는 Ultralytics Platform 추론 벤치마크에서 가져왔습니다. 각 Ultralytics YOLO26 탐지 모델을 표시된 형식으로 내보낸 다음, COCO val2017에서 배치 크기 1, 입력 크기 640픽셀로 Ultralytics Platform GPU의 추론 지연 시간을 측정했습니다. 워밍업은 제외하고 실행별 시간에는 시그마 클리핑을 적용했습니다. 정확도는 COCO val2017에서 형식 및 정밀도별로 한 번씩 측정한 mAP50-95입니다. 비교에는 네 가지 형식 모두의 결과가 있는 NVIDIA GPU 19종(Ampere, Ada, Hopper)을 사용했습니다.
벤치마크 페이지에는 ONNX 결과를 생성한 ONNX Runtime 실행 제공자가 명시되어 있지 않으며, 모델에서 지원되는 부분을 TensorRT에 위임하는 ONNX Runtime의 TensorRT 실행 제공자를 사용한 결과라고 표시된 항목도 없습니다. 따라서 이 ONNX 결과는 벤치마크에서 사용한 설정을 나타내며, 성능은 ONNX Runtime 실행 제공자에 따라 달라질 수 있습니다. TensorRT를 기반으로 ONNX Runtime API를 사용하려면 자체 하드웨어에서 해당 조합을 벤치마크하세요.
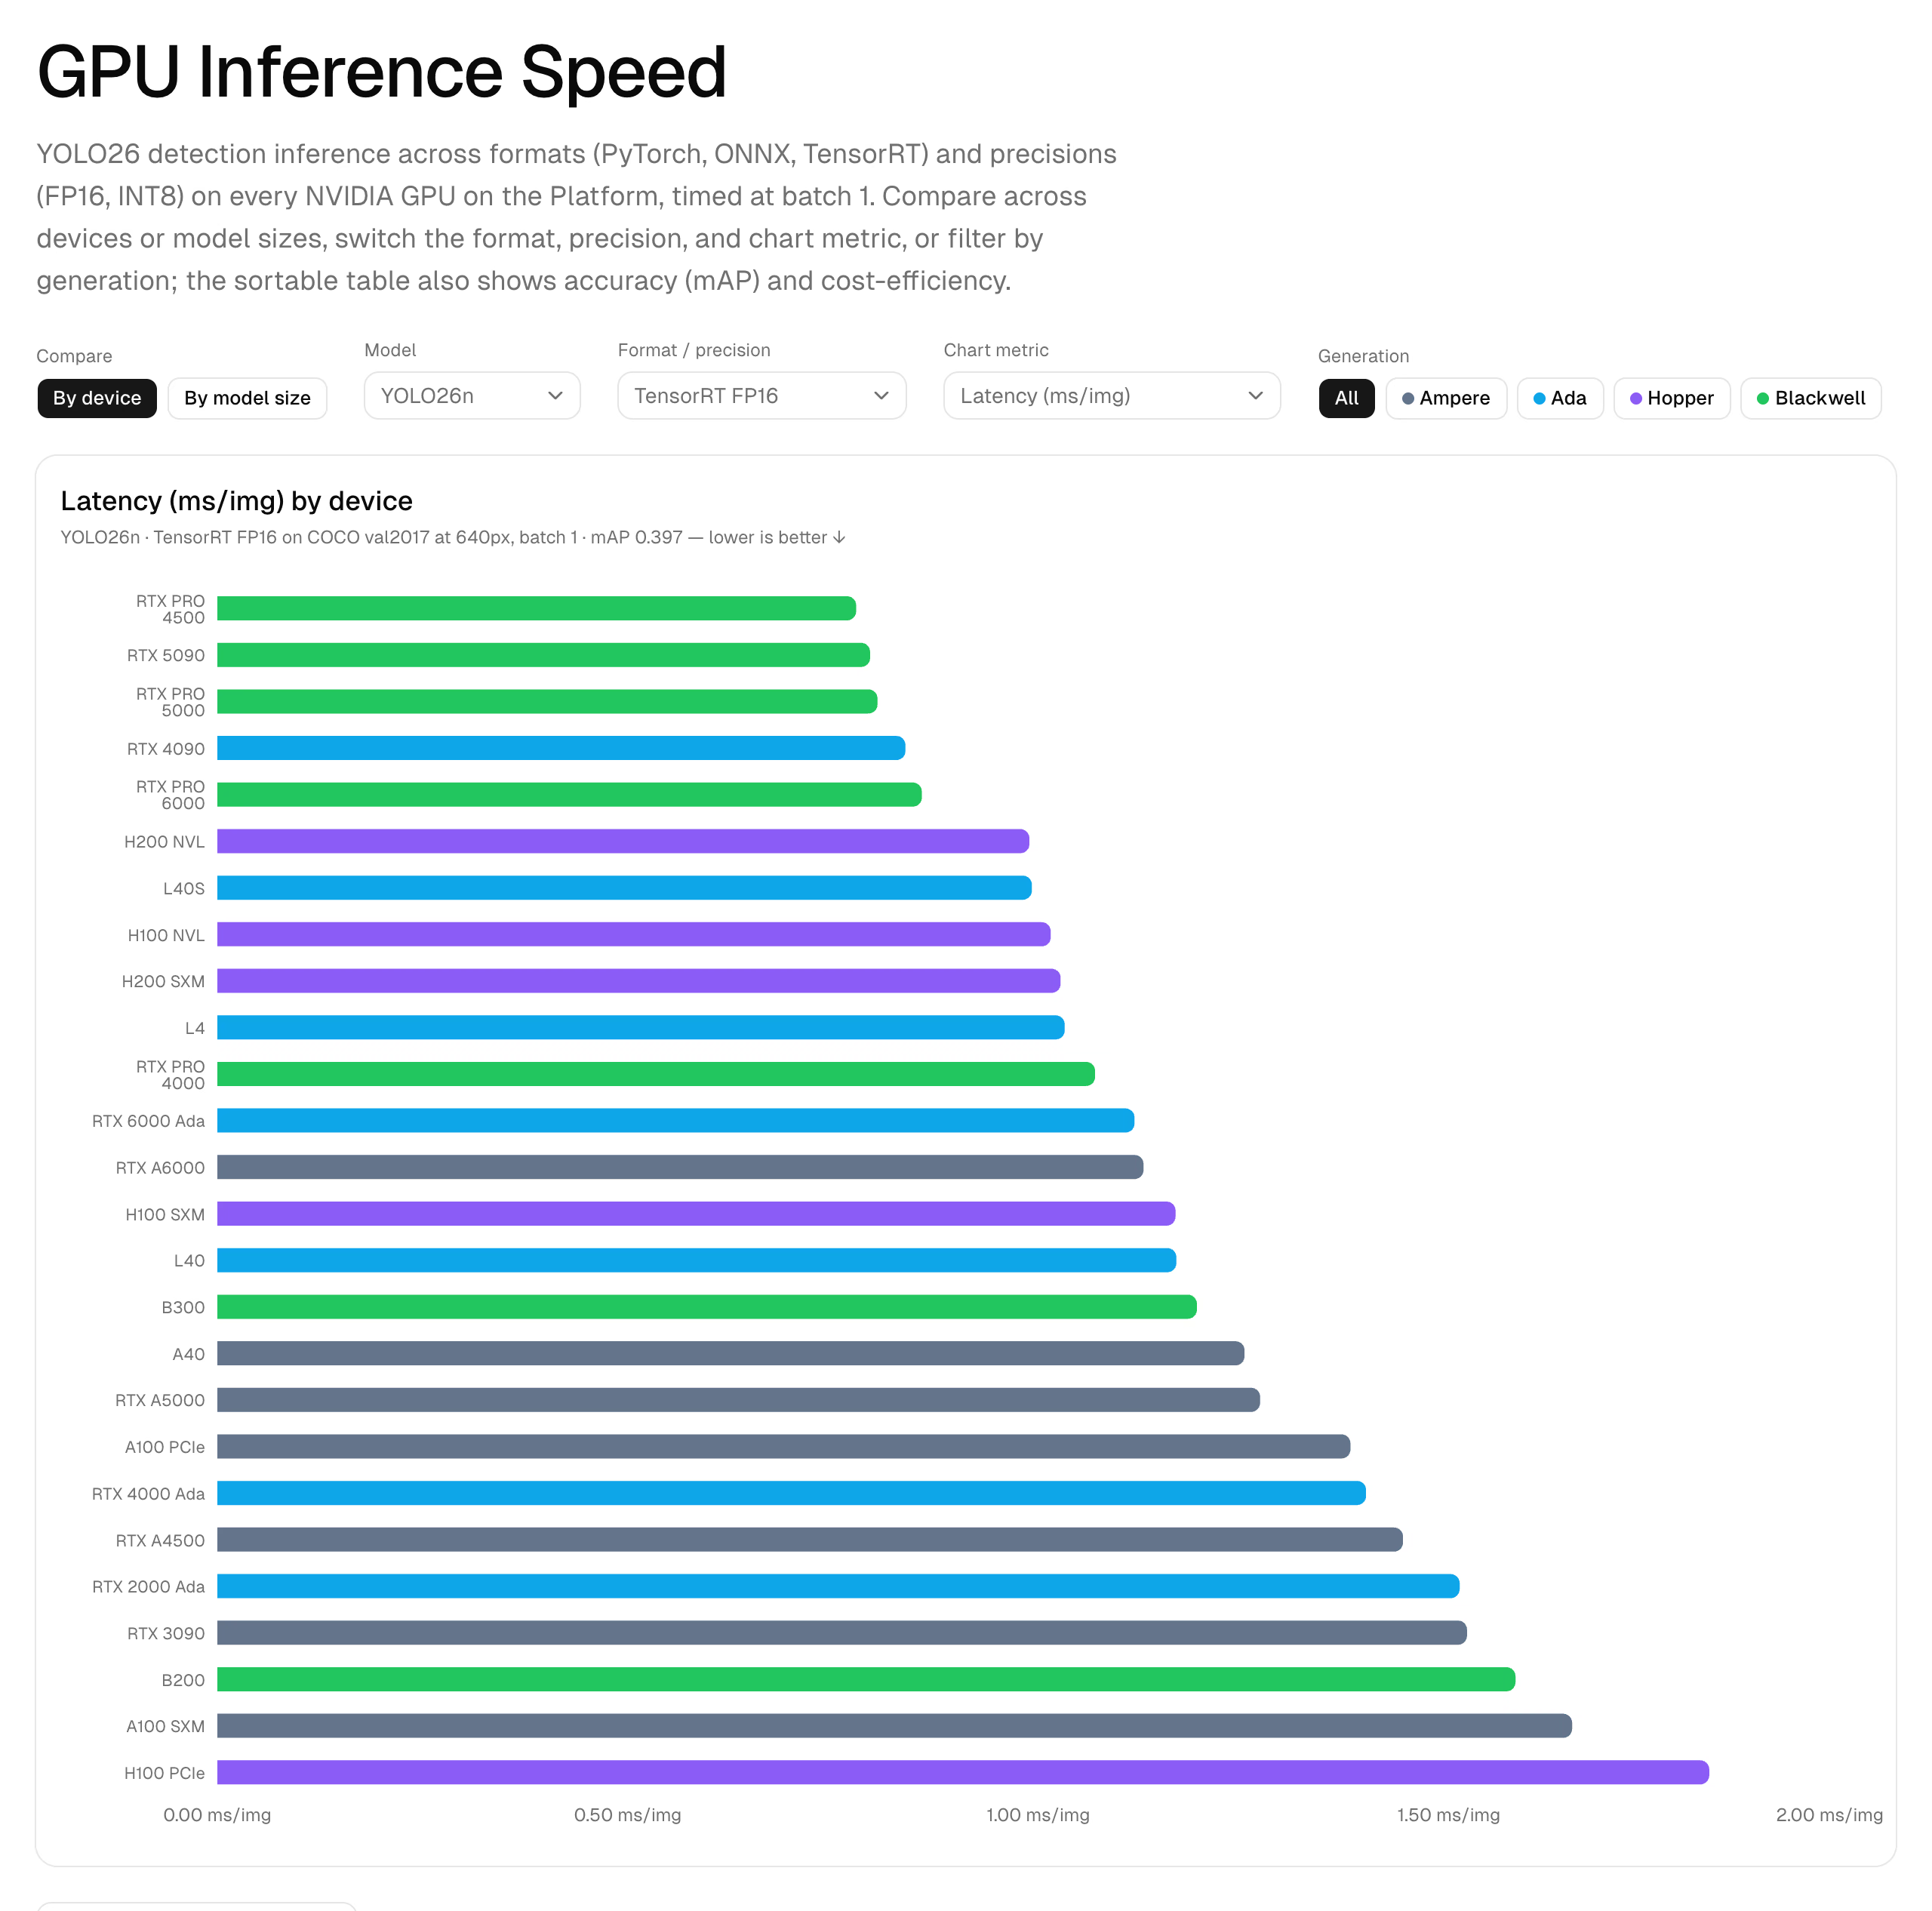
추론 탭에서 모델 크기, 형식, 정밀도를 바꾸고 지연 시간, 정확도 또는 비용을 기준으로 모든 GPU를 정렬할 수 있습니다.
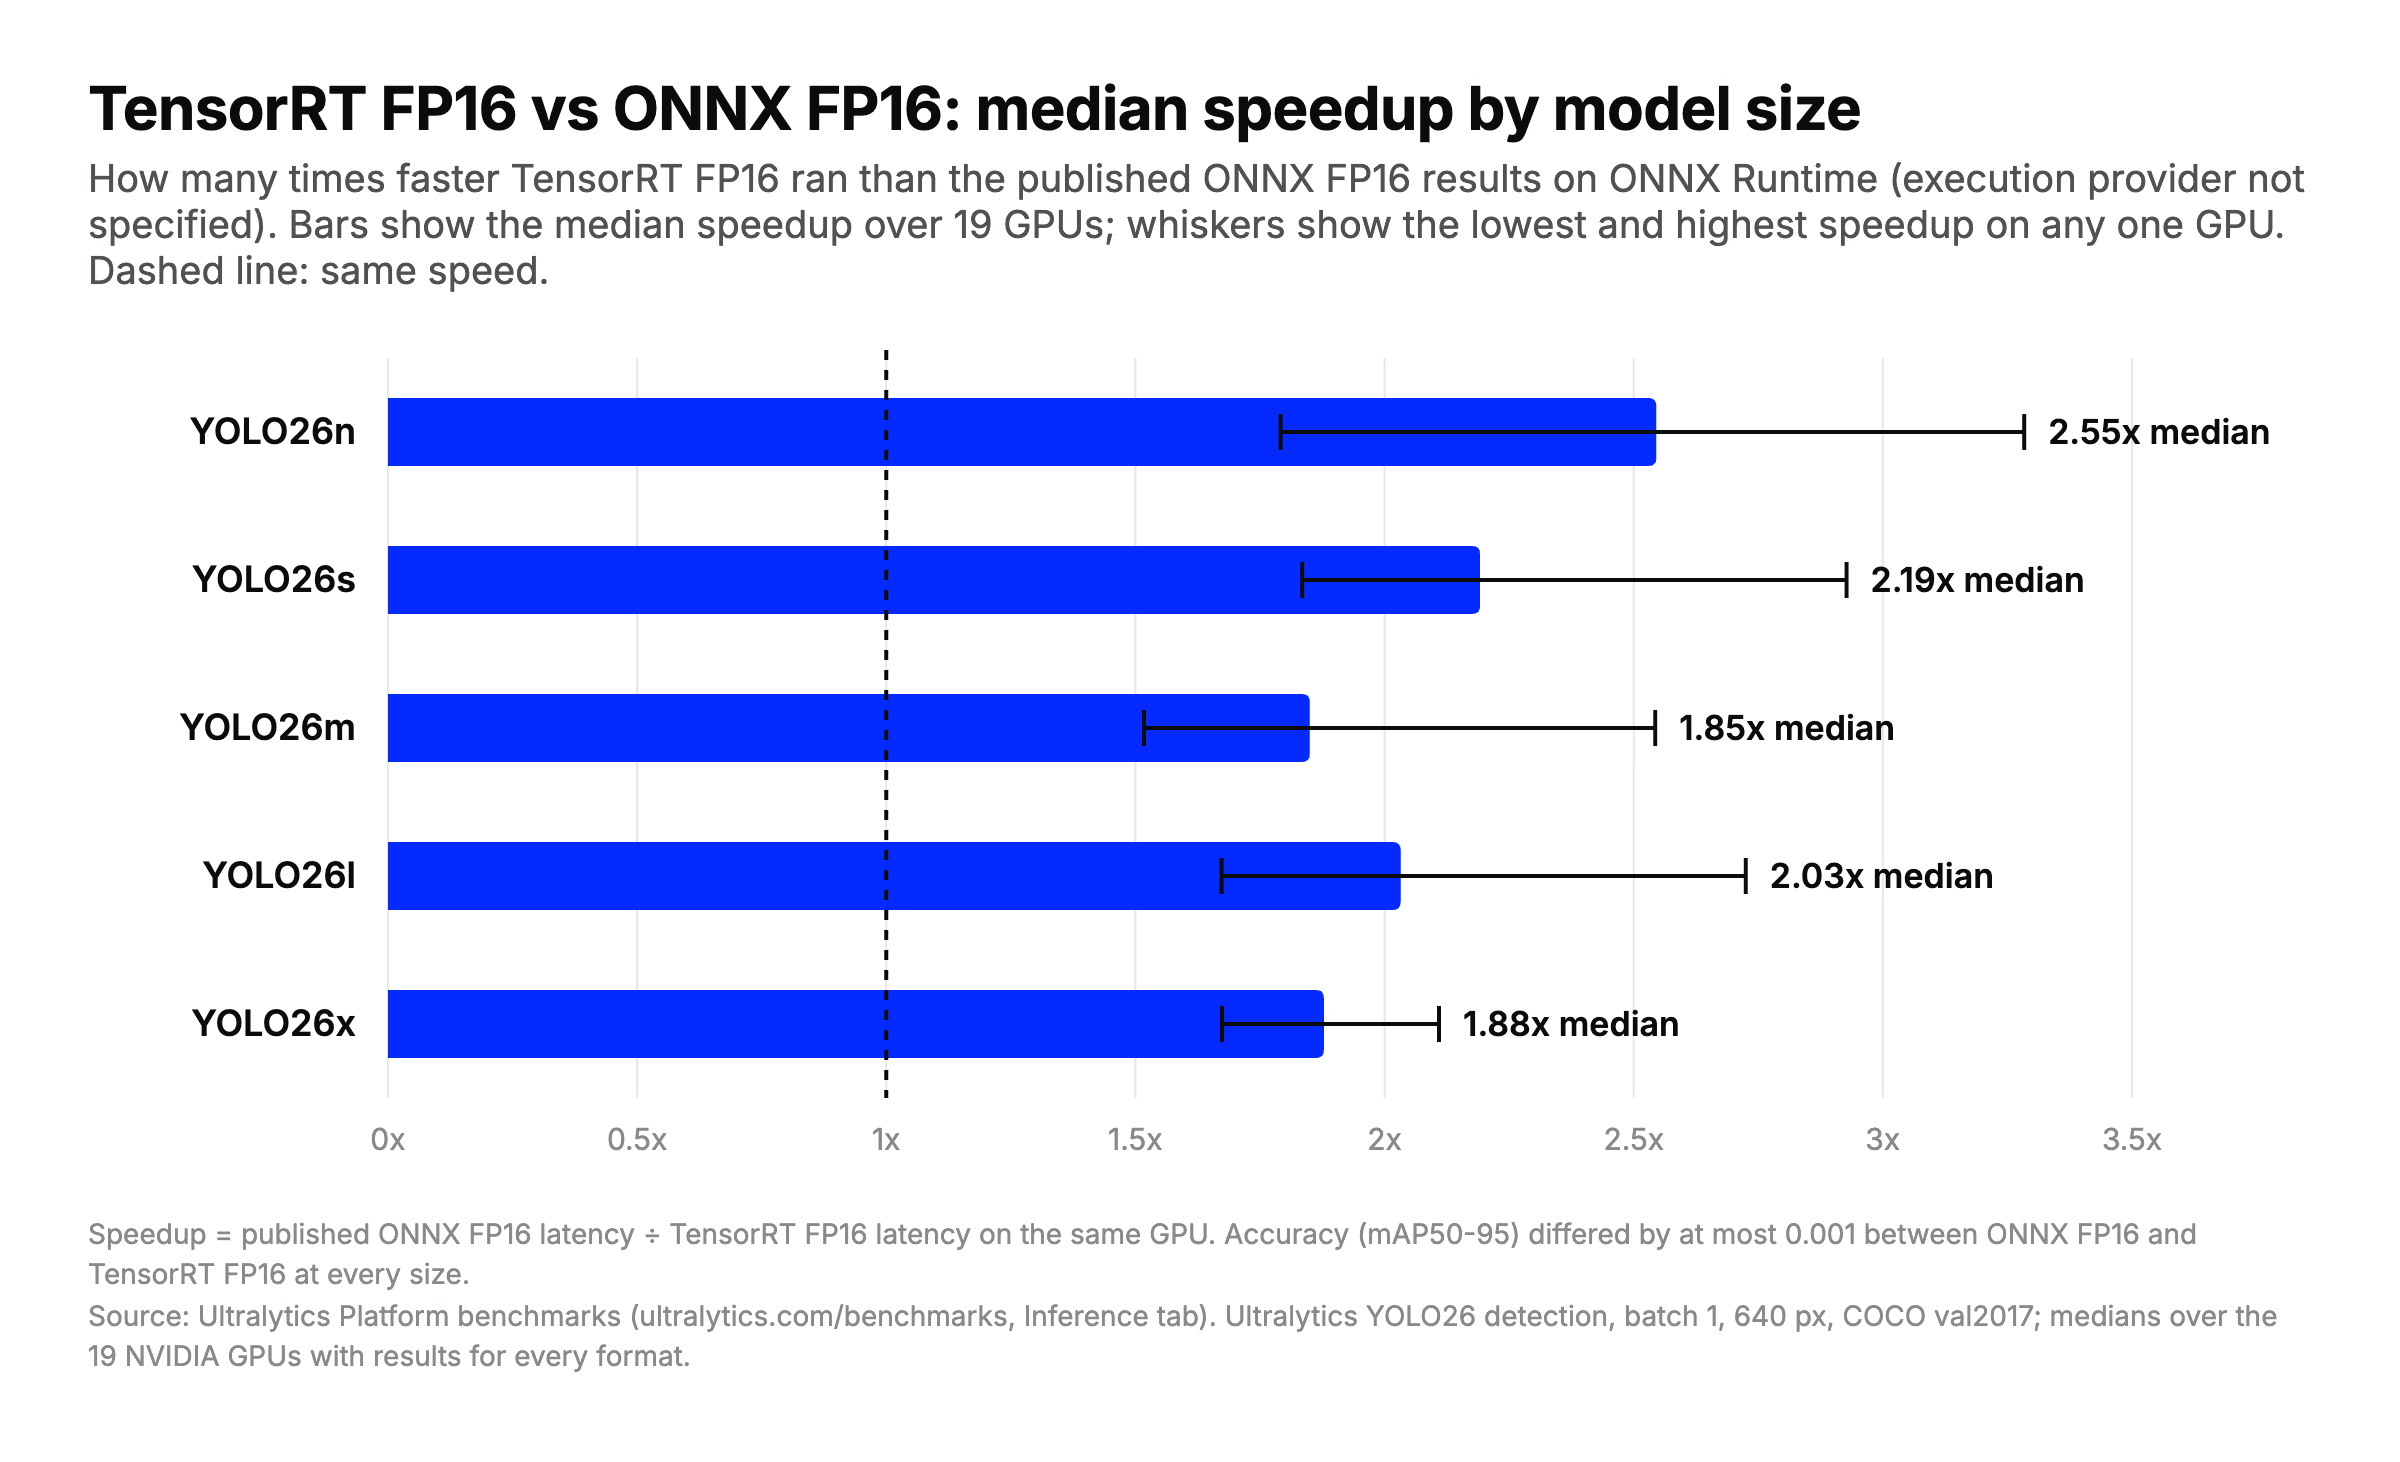
모든 GPU와 모델 크기에서 TensorRT FP16은 공개된 ONNX FP16 결과보다 빨랐습니다. 페이지에는 해당 결과를 생성한 ONNX Runtime 실행 제공자가 명시되어 있지 않습니다. 막대는 GPU 19종에서 측정한 중앙값 속도 향상을 나타내며, 오차 막대는 단일 GPU에서 가장 낮거나 높은 속도 향상을 나타냅니다. Ultralytics Platform 추론 벤치마크를 바탕으로 계산했습니다.
| 모델 | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | ONNX FP16 대비 TensorRT FP16 속도 향상(중앙값, 범위) | TensorRT FP16 대비 TensorRT INT8 속도 향상(중앙값, 범위) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55배 (1.79~3.28배) | 0.90배 (0.79~1.07배) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19배 (1.83~2.93배) | 1.04배 (0.89~1.19배) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85배 (1.52~2.54배) | 1.20배 (0.90~1.38배) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03배 (1.67~2.73배) | 1.08배 (0.92~1.33배) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88배 (1.67~2.11배) | 1.19배 (0.92~1.67배) |
Ultralytics Platform 추론 벤치마크를 바탕으로 계산했습니다. 속도 향상은 동일한 GPU에서 ONNX FP16 지연 시간을 TensorRT FP16 지연 시간으로 나눈 값 또는 TensorRT FP16 지연 시간을 TensorRT INT8 지연 시간으로 나눈 값입니다. 따라서 1배를 초과하는 값은 TensorRT FP16(또는 INT8)이 더 빨랐음을 의미합니다. 중앙값은 네 가지 형식의 결과가 모두 있는 NVIDIA GPU 19종을 사용했으며, 범위는 해당 GPU에서 계산한 비율의 최솟값과 최댓값입니다. 정확도는 각 형식 및 정밀도에서 보고된 mAP50-95입니다. ONNX FP16은 실행 제공자가 명시되지 않은 공개 ONNX Runtime 결과를 의미합니다.
벤치마크 페이지에 공개된 일반적인 GPU 네 종의 이미지당 지연 시간(밀리초):
| GPU | 모델 | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
두드러지는 점은 세 가지입니다:
- TensorRT FP16은 모든 GPU와 모델 크기에서 공개된 ONNX FP16 결과보다 빨랐으며, 정확도 차이는 0.001 mAP50-95 이내였습니다. 이 NVIDIA GPU에 배포하면서 낮은 지연 시간이 필요하다면 TensorRT FP16으로 시작하세요.
- INT8이 항상 더 빠른 것은 아닙니다. YOLO26n에서는 GPU 19종 중 17종에서 TensorRT FP16보다 느렸고, mAP50-95가 0.04 낮아졌습니다. 더 큰 모델에서는 더 자주 속도 향상을 보였으며, L4의 YOLO26x에서는 최대 1.67배 빨랐지만 mAP50-95는 0.034~0.076 낮아졌습니다.
- Blackwell GPU 7종의 ONNX 결과는 없습니다. 벤치마크 페이지에서는 테스트 환경의 ONNX Runtime에 Blackwell 커널이 없었기 때문이라고 설명합니다. TensorRT는 7종 모두에서 실행되었습니다.
이 결과는 벤치마크 페이지의 설정인 배치 크기 1, 입력 크기 640픽셀을 기준으로 합니다. 따라서 선택하기 전에 배포 장치와 자체 데이터를 사용해 모델을 벤치마크하세요.
TensorRT의 FP16과 INT8 비교#
정밀도를 낮추는 방법도 중요한 최적화 수단이며, 벤치마크는 이를 테스트해야 하는 이유를 보여 줍니다:
- FP16(반정밀도)는 FP32와 비교해 가중치와 활성화 값의 크기를 절반으로 줄입니다. Ultralytics Platform 벤치마크에서 TensorRT FP16의 정확도는 ONNX FP16 및 PyTorch FP16과 비교해 0.003 mAP50-95 이내로 일치했습니다.
- INT8은 가중치와 활성화 값을 8비트 정수로 저장하는 모델 양자화 방식입니다. 이 방식에는 보정이 필요합니다. 대표성 있는 이미지 세트를 모델에 입력해 활성화 값의 범위를 측정합니다. Ultralytics Platform 벤치마크에서는 COCO128을 보정 데이터로 사용하고 NVIDIA ModelOpt를 활용했습니다.
벤치마크 방법론에 설명된 바와 같이 INT8은 연산량이 많은 대형 모델에서 가장 효과적입니다. 가장 작은 모델에서는 추가 양자화 작업으로 인해 FP16과 성능이 비슷해지거나 오히려 느려질 수 있습니다. 자체 도메인의 이미지로 보정한 다음, INT8 엔진을 배포하기 전에 자체 데이터에서 정확도를 검증하세요.
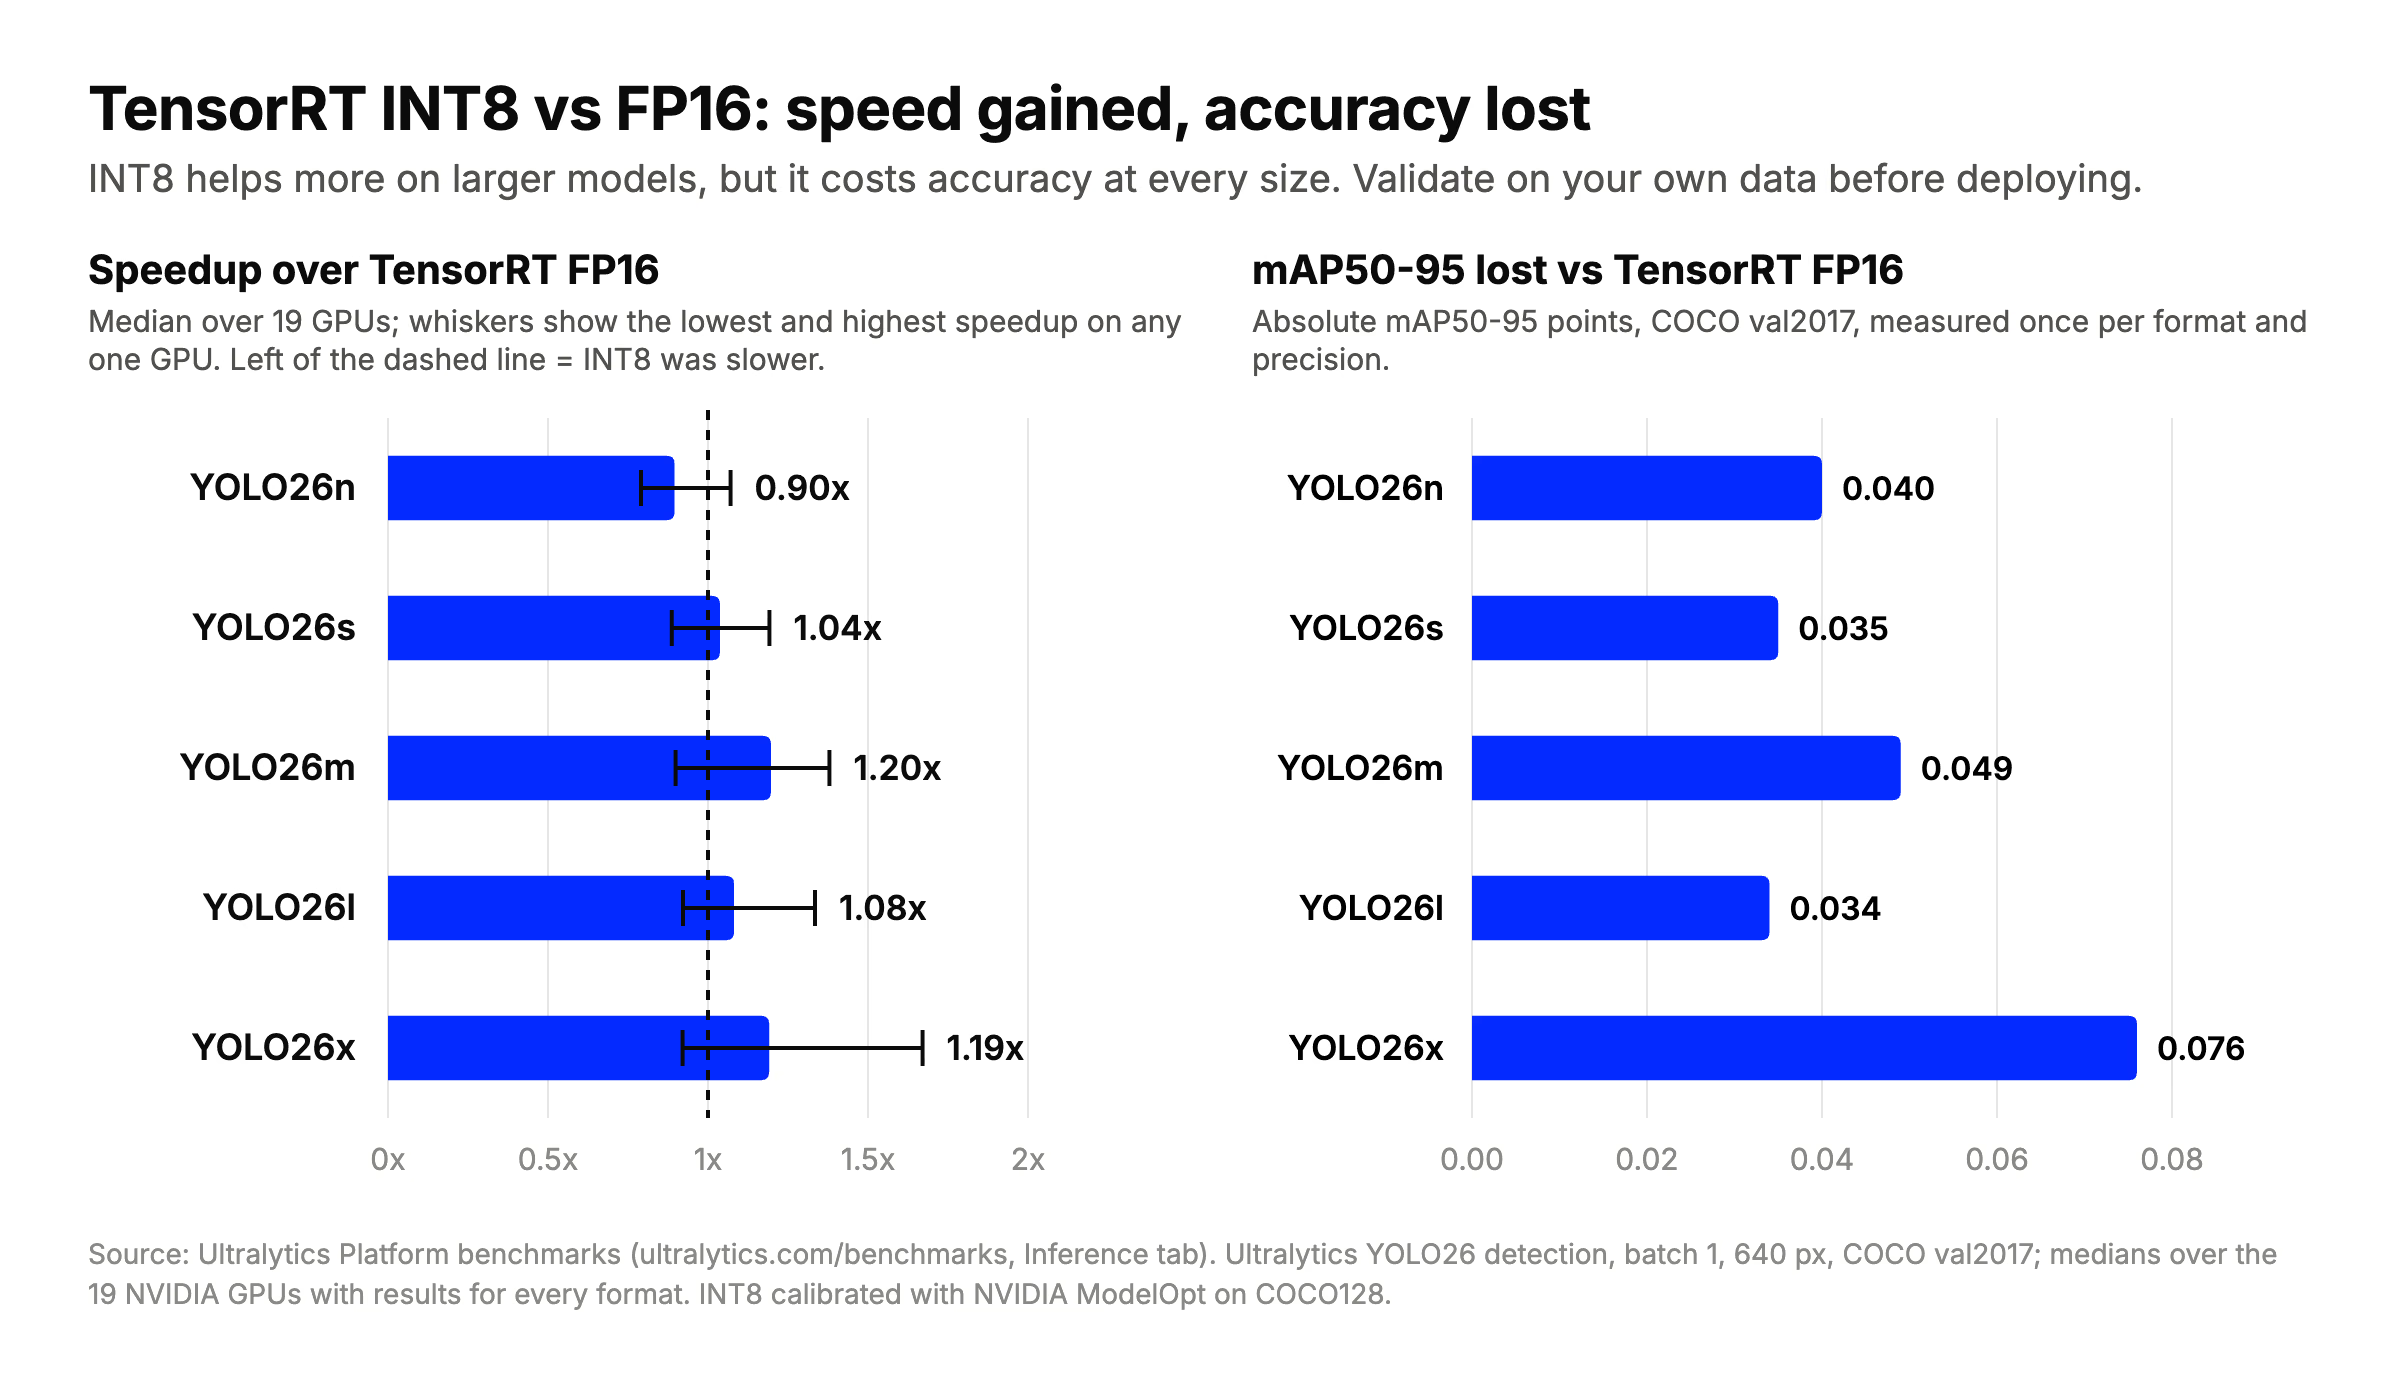
중앙값 기준으로 INT8은 YOLO26n에서 FP16보다 느렸으며, GPU 19종에서 대형 모델은 최대 약 1.2배 빨랐습니다. 모든 모델 크기에서 mAP50-95가 0.034~0.076 낮아졌습니다. Ultralytics Platform 추론 벤치마크를 바탕으로 계산했습니다.
엔진의 이식성과 동적 입력 크기#
기본적으로 TensorRT 엔진은 엔진을 빌드한 GPU와 TensorRT 버전에 종속되므로, RTX 4090에서 빌드한 엔진을 H100이나 Jetson에 복사해 사용하는 것은 적절하지 않습니다. TensorRT에는 이러한 제약을 완화하는 하드웨어 및 버전 호환성 옵션이 있지만, 기본적으로 배포 대상 장치에서 또는 해당 장치용으로 빌드하고 TensorRT를 업그레이드한 후에는 다시 빌드하는 것이 안전합니다. 이러한 이유로 Ultralytics Platform의 내보내기 탭에서는 TensorRT로 내보낼 때 GPU 유형을 선택하도록 합니다. ONNX 파일에는 이와 같은 제약이 없습니다. ONNX Runtime과 적절한 실행 제공자를 사용할 수 있는 환경이라면 동일한 파일을 실행할 수 있습니다.
두 형식 모두 다양한 입력 크기를 지원합니다. TensorRT에서 동적 형태를 사용하려면 입력의 최소, 최적, 최대 크기를 설정하는 최적화 프로파일이 필요하며, 런타임 입력은 해당 범위에 맞아야 합니다. Ultralytics YOLO 모델을 내보낼 때 dynamic=True을 사용하면 ONNX와 TensorRT에서 동적 입력 형태가 활성화됩니다. NVIDIA의 동적 형태 가이드에서 설명하듯이 고정 형태를 사용하면 TensorRT가 최적화할 여지가 더 커집니다. 따라서 입력 크기가 실제로 달라지는 경우 동적 형태를 사용하고 두 방식을 모두 벤치마크하세요.
ONNX Runtime과 TensorRT 중 선택하는 방법#
- 클라우드 또는 온프레미스의 NVIDIA GPU에서 지연 시간이 중요한 경우: FP16부터 TensorRT를 사용하세요. 더 큰 모델에서는 보정 및 검증 후 INT8을 테스트하세요.
- 엣지의 NVIDIA Jetson: TensorRT를 사용하세요. NVIDIA Jetson 가이드를 참조하세요.
- CPU, 비NVIDIA 하드웨어 또는 혼합 환경: ONNX와 ONNX Runtime을 사용하고 각 시스템에서 지원하는 실행 제공자를 선택하세요.
- 아직 배포 하드웨어를 모르는 경우: 먼저 ONNX로 내보내세요. 나중에 동일한 모델에서 TensorRT 엔진을 빌드할 수 있습니다.
- Intel CPU, GPU 또는 NPU: Intel의 추론 툴킷인 OpenVINO를 고려하세요.
지원되는 형식 전체 목록과 비교는 모델 배포 옵션 가이드를 참조하세요. 정밀도만 최적화 수단인 것은 아닙니다. 모델 크기와 입력 해상도도 중요하며, 가지치기 및 양자화 가이드에서는 모델 크기를 줄이는 두 가지 방법을 더 소개합니다.
Ultralytics YOLO를 ONNX와 TensorRT로 내보내기#
Ultralytics YOLO는 하나의 format 인수로 두 형식 모두에 내보낼 수 있으며, 내보낸 모델에서 바로 예측이나 검증을 실행할 수 있습니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX Runtime용 ONNX FP16
model.export(format="engine", quantize=16)  # 이 GPU에서 빌드한 TensorRT FP16 엔진
# 대신 INT8을 사용하려면 데이터셋 YAML로 보정하세요(coco8.yaml은 소규모 데모 세트이므로 자체 데이터를 사용하세요):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")quantize=16은 FP16을 선택하고 quantize=8은 INT8을 선택합니다. 두 엔진 내보내기 방식 모두 yolo26n.engine를 작성하므로 둘 중 하나만 실행하세요. INT8의 경우 data에 자체 데이터셋 YAML을 지정하여 배포 환경과 유사한 이미지로 보정하도록 하세요. 모든 옵션은 내보내기 인수와 ONNX 및 TensorRT 통합 가이드에서 확인하거나, ONNX로 내보내기 및 TensorRT로 최적화하기에 대한 단계별 게시물을 참조하세요. Ultralytics Platform에서 브라우저로 학습된 모델을 내보낼 수도 있습니다.
자주 묻는 질문
ONNX는 엔진이 아니라 모델 형식이므로 공정한 비교 대상은 ONNX Runtime과 TensorRT입니다. NVIDIA GPU 19종에서 Ultralytics YOLO26을 대상으로 진행한 Ultralytics Platform 벤치마크에서 TensorRT FP16은 모든 GPU에서 공개된 ONNX Runtime의 ONNX FP16 결과보다 빨랐습니다. 모델 크기별 계산된 중앙값 속도 향상은 1.85~2.55배였으며, mAP50-95 차이는 최대 0.001이었습니다. 벤치마크에는 ONNX 결과를 생성한 ONNX Runtime 실행 제공자가 명시되어 있지 않고, 해당 결과 중 TensorRT 실행 제공자를 사용한 것으로 표시된 항목도 없습니다. 따라서 ONNX Runtime API가 필요하다면 해당 조합을 직접 테스트하세요.
예. ONNX는 일반적으로 TensorRT의 입력으로 사용됩니다. ONNX 파서가 모델을 읽어 엔진을 빌드합니다. ONNX Runtime도 TensorRT 실행 제공자를 통해 TensorRT를 호출할 수 있습니다.
아니요. Ultralytics Platform 벤치마크에서 TensorRT INT8은 GPU 19종 중 17종에서 YOLO26n의 TensorRT FP16보다 느렸습니다. 더 큰 모델에서는 더 자주 빨랐으며, 모든 형식을 실행한 GPU 19종에서 YOLO26m과 YOLO26x는 중앙값 기준 약 1.2배 빨랐습니다. 그 대신 mAP50-95가 0.034~0.076 낮아졌으므로, INT8 모델은 먼저 자체 데이터에서 검증하세요.
복사해서 사용할 수 있다고 기대하지 마세요. 기본적으로 TensorRT 엔진은 엔진을 빌드한 GPU와 TensorRT 버전에 종속되므로 배포 대상 장치에서 또는 해당 장치용으로 빌드하세요. 이식 가능한 사본으로 ONNX 파일을 보관하고 대상별로 엔진을 다시 빌드하세요.
일반적으로 TensorRT를 선택합니다. NVIDIA JetPack에 TensorRT가 포함되어 있으며, Jetson 자체에서 엔진을 빌드하면 해당 장치에 맞게 최적화됩니다. 위 벤치마크에는 Jetson이 포함되지 않았으므로 결정하기 전에 사용 중인 모듈에서 성능을 측정하세요. NVIDIA Jetson 가이드에서 Ultralytics YOLO의 설정과 내보내기 과정을 안내합니다.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









