자동 주석용 Qwen4-Max: 두드러진 데이터셋 성능과 고르지 않은 개선
Qwen4-Max는 자동 주석 벤치마크에서 51개 모델 중 13위이며, 손목 X선에서는 1위, 소매 진열대에서는 2위입니다. 정확도, 비용 및 실행 방법을 살펴봅니다.
 Miles Deans12 분 읽기
Alibaba는 2026년 11월 16일 Qwen4-Max를 출시하면서, 네이티브 비전 기능과 100만 토큰 컨텍스트 윈도우를 갖춘 Qwen 제품군 중 역대 최고 성능의 모델이라고 소개했습니다. 같은 날 UL37, 즉 36개 데이터셋으로 구성된 객체 탐지 벤치마크에서 모델을 테스트했습니다.
전체적으로 Qwen4-Max는 VLM 리더보드에서 51개 모델 중 13위이며, mAP50 0.474에 이미지 1,000장당 비용은 $5.68입니다. 하지만 이 평균만으로는 더 두드러진 결과를 알기 어렵습니다. 소아 손목 X선에서는 테스트한 모든 모델 가운데 가장 높은 점수를 기록했으며, 수중 장면과 상품이 빽빽하게 진열된 소매 매대에서는 Gemini 4 Carbon에 이어 2위를 차지했습니다.
Qwen4-Max는 이제 Ultralytics Platform에서 자동 주석용 Alibaba 모델로 제공되며, Qwen3.8-Max를 대체합니다. 아래에서 Qwen4-Max가 강점을 보이는 영역과 부족한 영역, 비교 대상 모델과의 성능 및 라벨링 배치 비용을 살펴봅니다.
Qwen4-Max는 UL37에서 51개 모델 중 13위이며, 손목 X선에서는 1위입니다.#
UL37은 의료 영상과 항공 이미지부터 소매 매대, 스포츠, 회로 기판에 이르는 36개 실제 객체 탐지 데이터셋에서 각각 10장씩, 총 360장의 이미지에 대해 모델의 박스가 사람의 라벨과 얼마나 일치하는지 측정합니다. 평균을 계산할 때 모든 데이터셋은 동일한 비중으로 반영되며, 각 이미지는 Platform 사용자가 접하는 것과 동일한 프로덕션 파이프라인을 거칩니다. 여기에는 데이터셋 자체의 클래스 이름과 각 박스를 보정하는 SAM 3.1이 포함되므로, 점수는 원시 모델 출력이 아닌 보정된 파이프라인을 나타냅니다. 방법론은 공개되어 있습니다.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| 리더보드 순위 | #13 / 51 | #15 / 51 | #3 / 51 | #11 / 51 | #16 / 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| 정밀도 | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| 재현율 | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| 제공업체 비용(이미지 1,000장당) | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| 이미지당 중앙값 처리 시간 | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| 요청 실패 | 0% | 1.7% | 0% | 0% | 6.4% |
Ultralytics VLM 리더보드의 UL37 결과, 2026년 11월 19일 업데이트. Qwen3.8-Max는 더 이상 Platform에서 제공되지 않습니다.
Qwen4-Max는 모든 주요 메트릭에서 Qwen3.8-Max보다 개선되었고, 이미지당 비용이 더 낮으며, 모든 벤치마크 요청을 완료했습니다. 하지만 전체 평균으로 보면 여전히 선두 모델보다 크게 뒤처집니다. GPT-6.1 Terra는 비용이 더 낮고 응답 시간이 절반보다 훨씬 짧으면서 0.560점을 기록합니다.
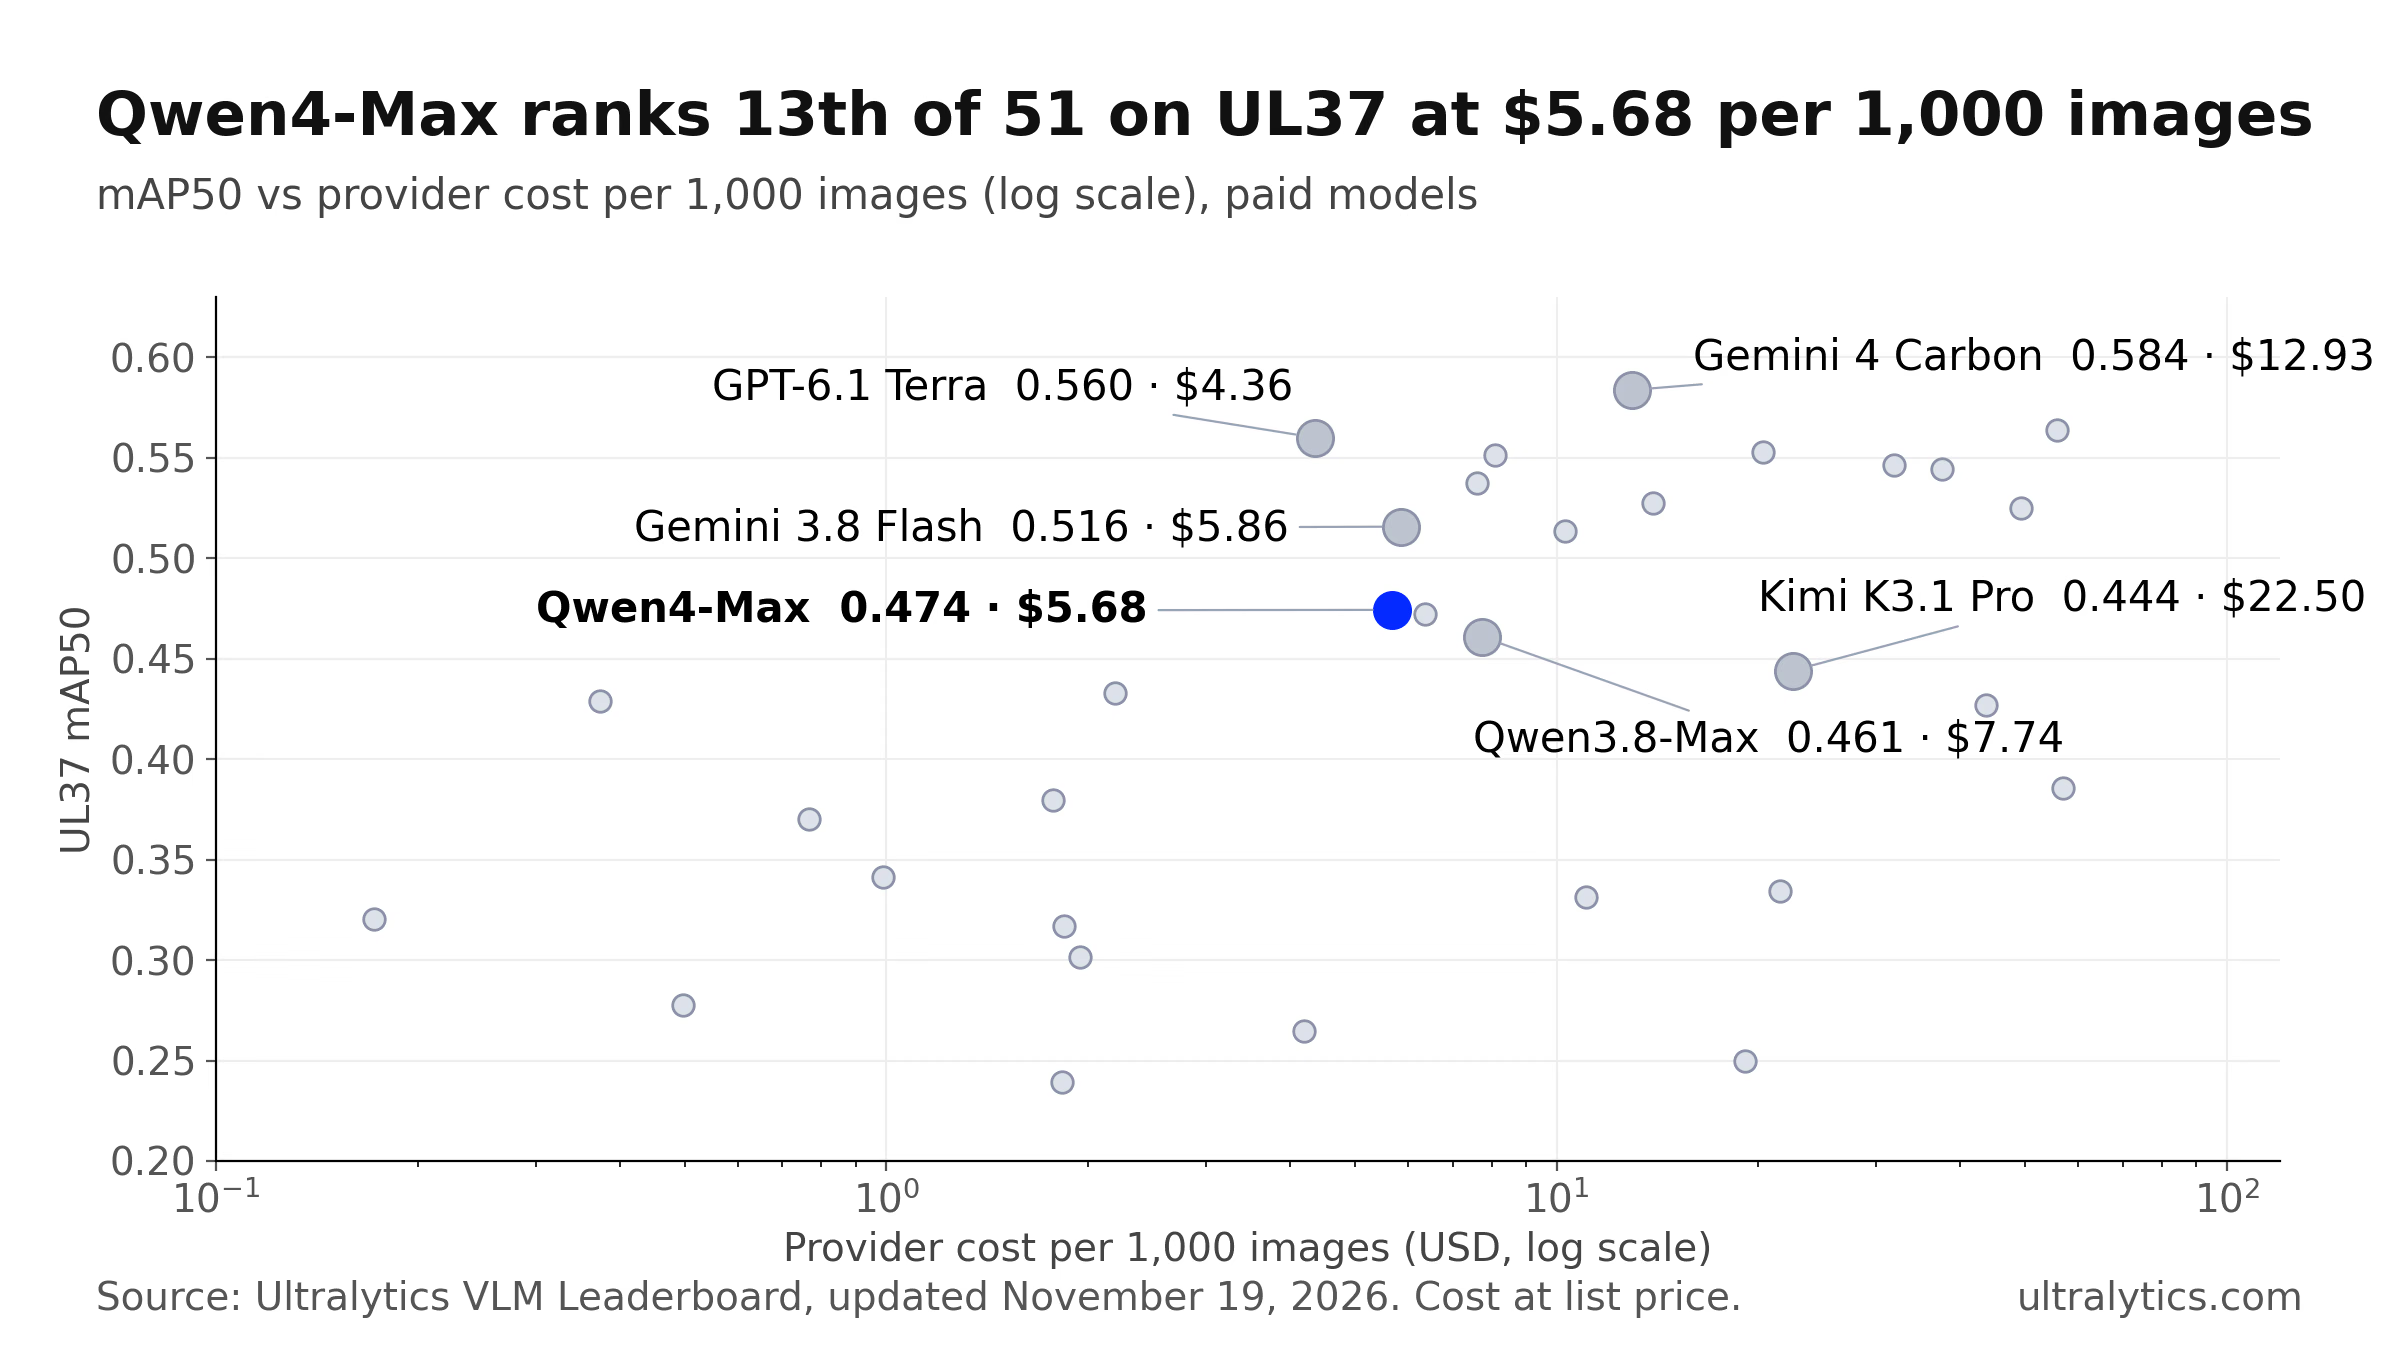
각 점은 Ultralytics VLM 리더보드에 등록된 유료 모델입니다.
Alibaba가 Qwen4-Max를 개발한 목적#
Alibaba는 출시 발표에서 Qwen4-Max를 총 2조 4천억 개의 파라미터 중 토큰마다 710억 개가 활성화되는 희소 Mixture-of-Experts 모델이며, 네이티브 비전 기능을 갖췄다고 설명합니다. 코딩, 에이전트 작업 및 시각적 추론을 강조하며, 자체 Work360 벤치마크에서 Qwen4-Max가 Qwen3.8-Max보다 뛰어난 성능을 보이고 작업당 평균 비용을 약 60% 절감한다고 보고합니다.
Alibaba Cloud의 Model Studio 릴리스 노트는 이 모델을 "텍스트 생성, 이미지 및 비디오 이해, 심층 추론을 결합한 Qwen 제품군 차세대 플래그십 멀티모달 모델"이라고 소개합니다. 국제 요금은 입력 토큰 100만 개당 $1.50, 출력 토큰 100만 개당 $4.50으로, Qwen3.8-Max의 $2 및 $6에서 인하되었습니다. 이 모델은 Alibaba의 API를 통해 사용할 수 있으며, Alibaba는 더 작은 오픈 웨이트 Qwen4 모델도 후속 출시할 예정이라고 밝혔습니다.
출시 발표와 릴리스 노트 어디에도 객체 탐지 결과가 공개되어 있지 않아, 해당 성능을 직접 측정했습니다.
Qwen4-Max와 Qwen3.8-Max 비교: 비용은 낮지만 개선 폭은 고르지 않음#
Qwen4-Max는 19개 데이터셋에서 이전 모델을 앞서고, 16개에서는 뒤처지며, 1개에서는 동률을 기록합니다. 평균 0.013 mAP50 향상은 일부 데이터셋에서 큰 폭으로 개선된 결과가 다른 데이터셋의 뚜렷한 하락을 상쇄하면서 나타났습니다.
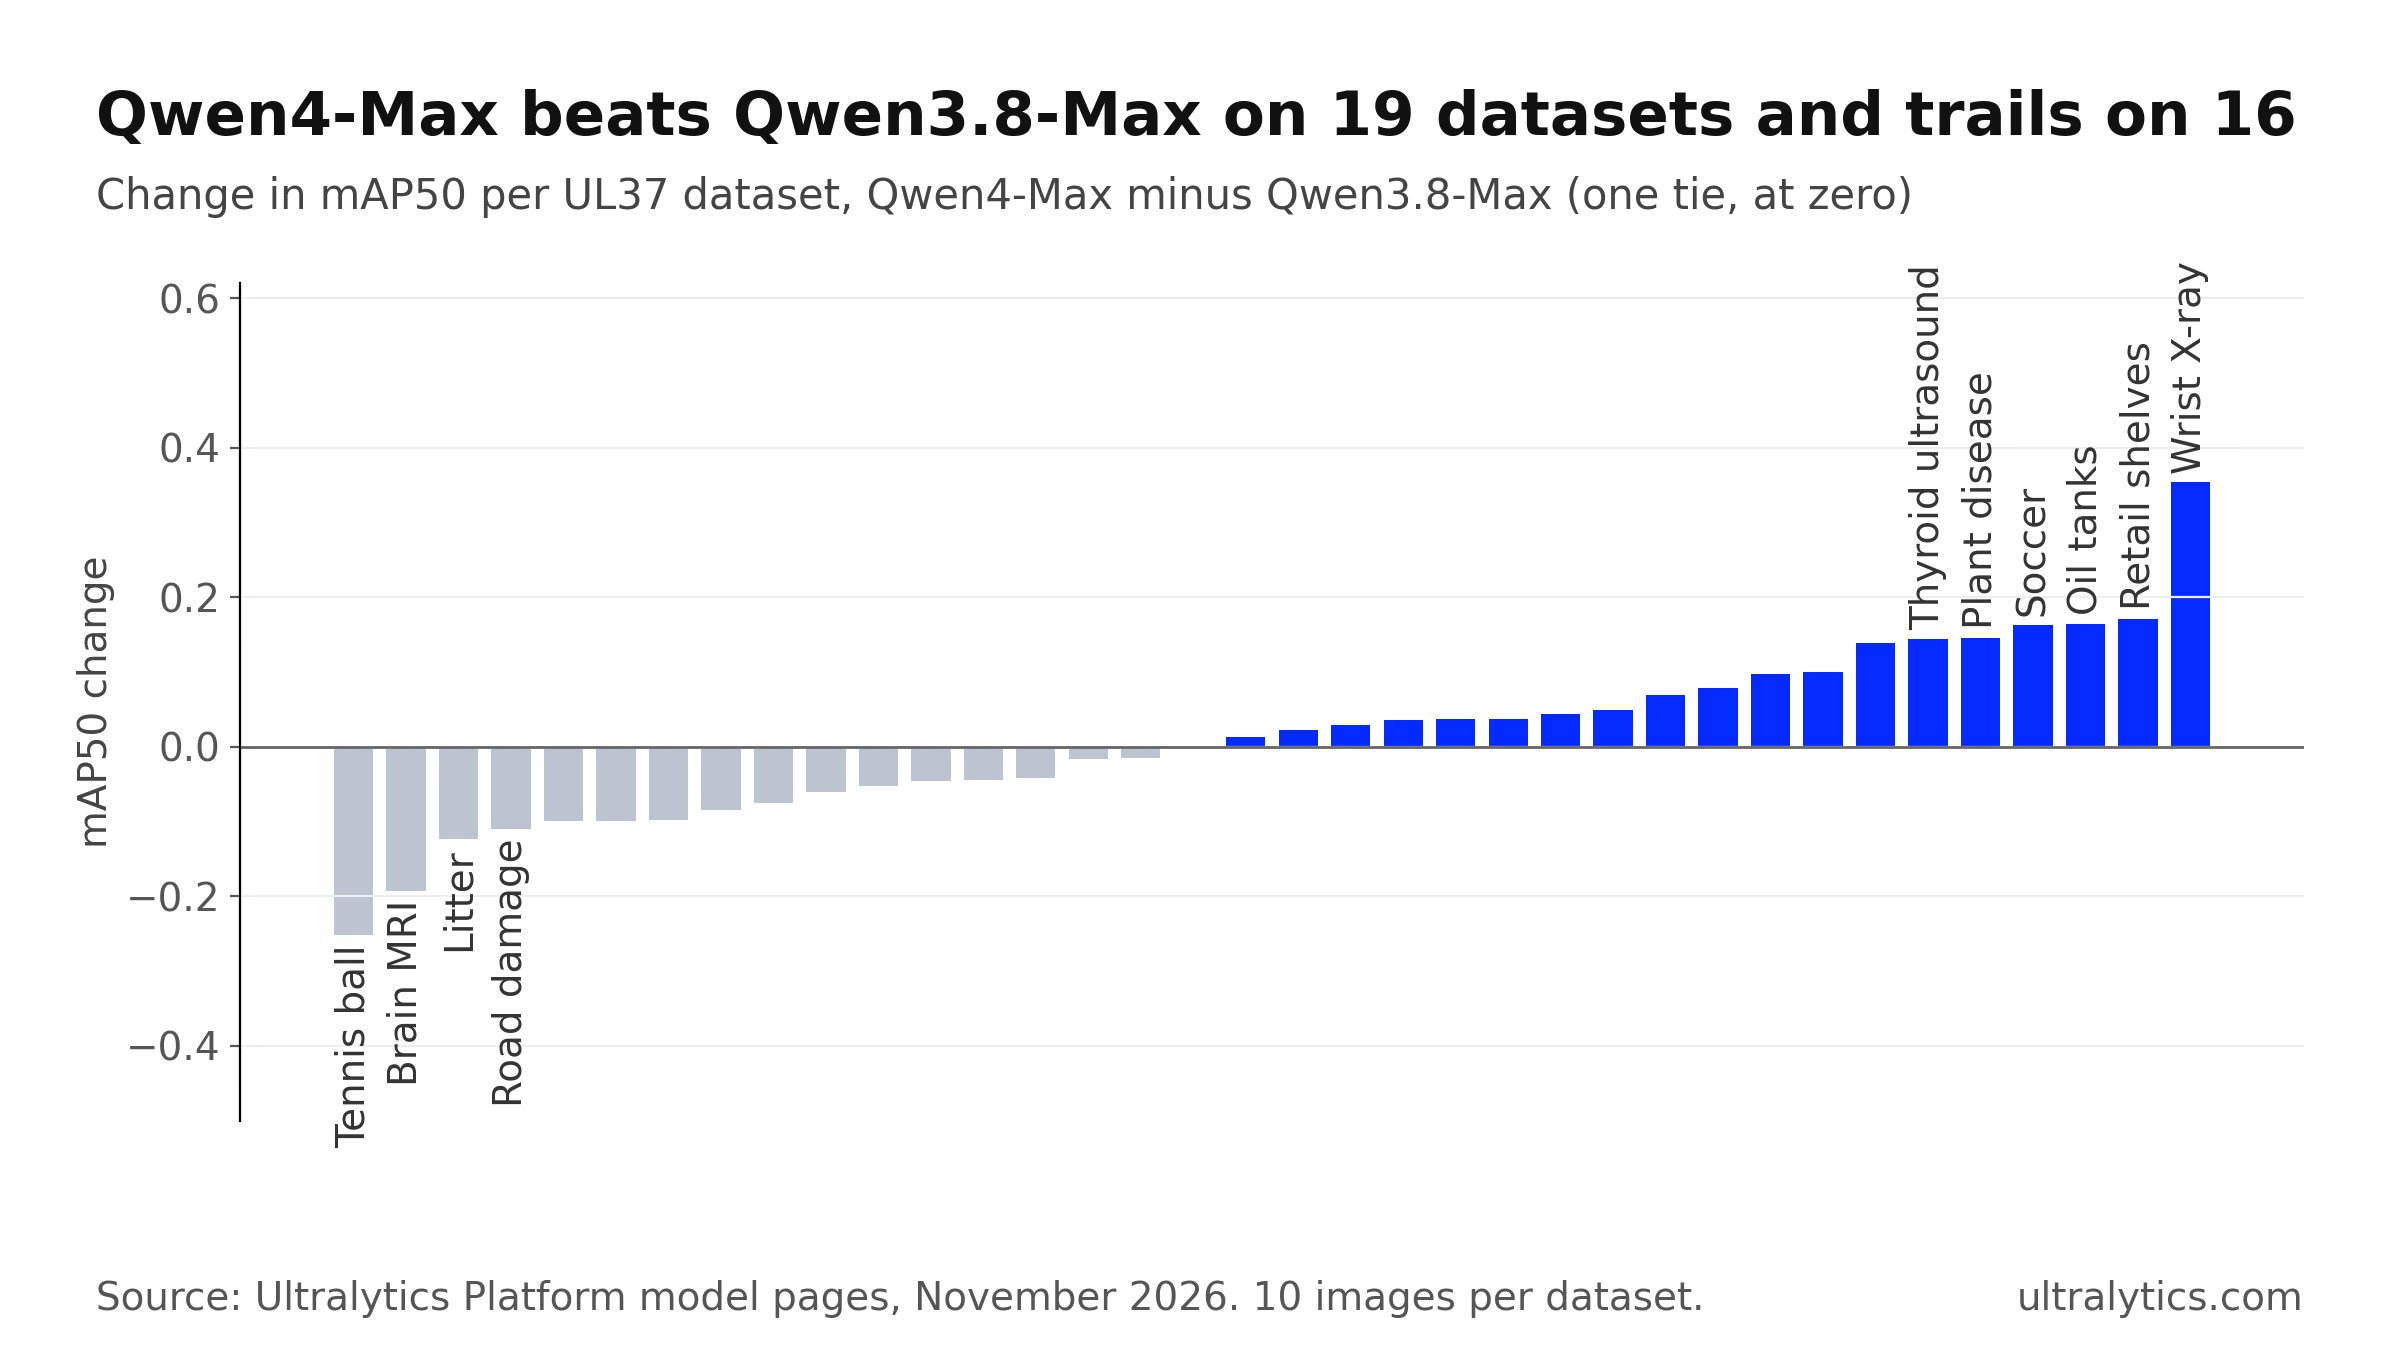
각 막대는 UL37 데이터셋 하나를 나타내며, 가장 큰 하락부터 가장 큰 개선 순으로 정렬되어 있습니다.
| 데이터셋 | Qwen4-Max | Qwen3.8-Max | 변화량 |
|---|---|---|---|
| GRAZPEDWRI-DX 소아 손목 X선 | 0.4975 | 0.1437 | +0.3538 |
| SKU110K 상품이 빽빽하게 진열된 소매 매대 | 0.6230 | 0.4516 | +0.1714 |
| Airbus 석유 저장 탱크 | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB 축구 | 0.8345 | 0.6715 | +0.1630 |
| RacketVision 테니스공 | 0.3775 | 0.6299 | −0.2524 |
| Cheng 뇌종양 MRI | 0.4421 | 0.6350 | −0.1929 |
데이터셋별 UL37 mAP50, 각 10개 이미지 기준. 각 변화량이 해당하는 두 점수와 일치하도록 소수점 넷째 자리까지 표시했습니다.
비용 절감은 더 분명합니다. 저희 테스트에서 Qwen4-Max의 이미지 1,000장당 비용은 $5.68로, Qwen3.8-Max의 $7.74보다 이미지당 약 27% 낮습니다. Alibaba가 제시한 약 60% 절감 수치는 다른 설정의 별도 벤치마크에서 나온 것이므로 두 수치를 직접 비교할 수는 없습니다.
Qwen4-Max가 강점을 보이는 영역#
세 가지 결과를 보면 Qwen4-Max는 Qwen 제품군뿐만 아니라 전체 리더보드에서도 최상위권에 가깝습니다.
| 데이터셋 | Qwen4-Max | 51개 모델 중 순위 | 최고 모델 |
|---|---|---|---|
| GRAZPEDWRI-DX 소아 손목 X선 | 0.4975 | 1st | Qwen4-Max(다음 순위: Muse Ember 1.0, 0.378) |
| RUOD 수중 물체 | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K 상품이 빽빽하게 진열된 소매 매대 | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
데이터셋별 UL37 mAP50. Ultralytics VLM 리더보드의 전체 51개 모델 중 순위입니다.
손목 X선. 소아 손목 외상 X선에서 Qwen4-Max는 0.4975점을 기록해 테스트한 모든 모델보다 높은 점수를 얻었으며, Qwen3.8-Max보다 3배 이상 높았습니다. 각 데이터셋은 이미지 10장으로 구성되므로, 이를 확정적인 결론이 아닌 테스트할 가치가 있는 강력한 신호로 보아야 합니다. 또한 이 결과는 진단이나 임상 검증을 의미하지 않습니다. 의료 영상 분석 연구용 주석을 위해 Qwen4-Max가 박스를 초안으로 생성하면 임상 전문가가 확인하고 수정할 수 있습니다.
소매 매대. UL37의 소매 데이터셋 두 개를 평균하면 Qwen4-Max는 0.752점으로, GPT-6.1 Terra의 0.724점보다 높습니다. 상품이 한 클래스에 속하고 매대 전체에 빽빽하게 들어찬 SKU110K에서는 Gemini 4 Carbon에 이어 2위입니다.
수중 장면. RUOD의 수중 물체 데이터셋에서 Qwen4-Max는 0.774점으로 51개 모델 중 2위이며, GPT-6.1 Terra의 0.658점보다 높습니다.
Qwen4-Max의 성능이 부족한 영역#
성공 사례만큼 격차도 뚜렷합니다. Qwen4-Max는 기판 결함 데이터셋인 DeepPCB에서 0.000점, 보안 검색 영상인 IEDXray에서 0.05점을 기록했으며, Gemini 4 모델들은 약 0.30점에 도달합니다. 결핵 흉부 X선 점수는 0.037이며, 뇌종양 MRI 데이터셋에서는 GPT-6.1 Terra에 0.442 대 0.904로 뒤처집니다.
도메인별 평균에서도 문서, UI 및 CAD 도면(0.357 대 0.494), 도로 및 교통(0.396 대 0.572), 전체 의료 영상(0.325 대 0.505)에서 GPT-6.1 Terra보다 낮은 점수를 기록합니다. 이러한 분야에서 대규모 데이터셋에 라벨을 지정하기 전에 Qwen4-Max 모델 페이지를 열어 모든 벤치마크 데이터셋에서 기록된 박스를 정답 라벨과 나란히 재생해 확인해 보세요.
Qwen4-Max와 GPT-6.1 Terra, Gemini 3.8 Flash, Kimi K3.1 Pro 비교#
| 36개 UL37 데이터셋 직접 비교 | Qwen4-Max 승리 | 패배 | 무승부 |
|---|---|---|---|
| GPT-6.1 Terra와 비교 | 11 | 23 | 2 |
| Gemini 3.8 Flash와 비교 | 17 | 18 | 1 |
| Kimi K3.1 Pro와 비교 | 21 | 14 | 1 |
| Qwen3.8-Max와 비교 | 19 | 16 | 1 |
GPT-6.1 Terra는 범용 모델로 더 적합합니다. Qwen4-Max의 11개보다 많은 23개 데이터셋에서 앞서고, 비용이 더 낮으며, 응답 시간 중앙값은 절반보다 짧습니다. Gemini 3.8 Flash는 비슷한 가격대에서 데이터셋별 성능이 거의 대등하고 평균 점수는 더 높습니다. Kimi K3.1 Pro와 비교하면 Qwen4-Max는 이미지당 약 4분의 1 비용으로 14개보다 많은 21개 데이터셋에서 앞섭니다.
Ultralytics Platform에서 Qwen4-Max를 실행하는 방법#
Platform에서 Qwen4-Max의 결과에는 두 가지 설정이 영향을 미칩니다. 첫째, Alibaba의 기본값인 "high" 대신 추론 수준을 "low"로 실행합니다. 벤치마크 이미지 370장(점수 산정 이미지 360장과 COCO 참조 이미지 10장)을 사용한 Ultralytics 테스트에서 기본 설정은 115초 요청 제한을 11회 초과했지만, "low" 설정은 3회 초과했으며 mAP50은 동일했습니다. 둘째, Platform은 Qwen 모델에 간결한 JSON 출력을 요청합니다. 이를 요청하지 않으면 mAP50이 약 0.02 낮아지기 때문입니다.
두 설정 모두 사용자가 별도로 조치할 필요는 없습니다. 모델 선택기에서 Qwen4-Max를 선택하면 Platform이 두 설정을 모두 적용합니다.
Qwen4-Max 주석 배치 비용#
공급업체 비용은 Alibaba가 보고한 토큰 사용량에 Platform의 해당 모델 요금을 적용한 금액이며, 주석 처리가 성공한 이미지 1,000장 기준입니다. 실제 이미지의 토큰 사용량은 이보다 많거나 적을 수 있습니다. Batch Annotation에는 이미지 1,000장당 $1.00의 Platform 처리 수수료가 추가되며, 실행 1회당 최소 수수료는 $0.01입니다.
| 이미지 1,000장당 | Qwen4-Max |
|---|---|
| Alibaba에 지불하는 비용 | $5.68 |
| Ultralytics Platform 처리 비용 | $1.00 |
| 합계 | $6.68 |
테스트용 예측 실행 비용을 포함해 자체 API 키를 통해 Alibaba에 직접 결제하며, Ultralytics는 토큰 요금에 마진을 붙이지 않습니다. 유료 키를 전혀 사용하지 않으려면 호스팅된 Qwen3.8 27B를 Platform에서 키 없이 실행할 수 있으며, UL37에서 mAP50 0.351을 기록합니다.
Ultralytics Platform에서 Qwen4-Max 자동 주석을 실행하는 방법#
Qwen4-Max는 클래스 프롬프트를 사용하는 모델로, 클래스가 1~200개인 탐지 데이터셋을 지원합니다. 데이터셋에 지정된 클래스 이름으로 바운딩 박스를 반환하며, 이후 결과를 검토하고 수정하면 됩니다.
- Platform에서 사용하는 엔드포인트인 국제(싱가포르) 리전에 대해 Alibaba Cloud Model Studio에서 API 키를 생성합니다.
- 워크스페이스 소유자에게 데이터셋이 있는 워크스페이스의 Settings > API Keys에서 Alibaba 항목에 키를 추가하도록 요청합니다. 자세한 내용은 공급업체 키 문서를 참조하세요.
- 주석 편집기에서 Smart 모드로 전환한 다음 모델 선택기에서 Alibaba 아래의 Qwen4-Max를 선택합니다.
- 데이터를 대표하는 이미지 몇 장에서 Predict를 누르거나
P을 실행합니다. - 결과가 만족스러우면 데이터셋 페이지를 열고 More actions > Batch Annotation을 선택해 레이블이 없는 모든 이미지에 주석을 지정합니다. Batch Annotation은 이미지 채널이 최대 3개인 Platform 호스팅 데이터셋에서 작동하며, Platform이 먼저 데이터셋 버전을 저장하므로 이전 상태로 되돌릴 수 있습니다.
- 경계 상자를 검토하고 저장한 다음, 동일한 워크스페이스에서 결과를 사용해 Ultralytics YOLO26 모델을 학습합니다.
주석 문서에서 Smart 모드와 Batch Annotation의 전체 설명을 확인할 수 있으며, 정밀도와 재현율을 기준으로 VLM을 선택하는 가이드를 참고하면 검토 워크플로에 적합한 모델을 찾을 수 있습니다.
Qwen4-Max를 사용해야 하는 경우#
| 다음이 필요하다면… | 다음으로 시작하세요: |
|---|---|
| 범용 유료 주석 모델 | GPT-6.1 Terra: Qwen4-Max보다 높은 UL37 점수, 낮은 비용, 빠른 속도 |
| 전문가 검토용 소아 손목 X선 초안 | Qwen4-Max: 이 데이터셋에서 51개 모델 중 UL37 최고 점수 |
| 상품이 빽빽한 소매 매대 또는 수중 장면 | Qwen4-Max를 사용하고 자체 이미지로 Gemini 4 Carbon과 비교 |
| Alibaba 모델을 찾거나 Qwen3.8-Max에서 전환하는 경우 | Qwen4-Max: 더 높은 점수, 더 낮은 이미지당 비용, 테스트에서 요청 실패 없음 |
| 유료 API 키를 사용하지 않는 경우 | Platform에서 호스팅되는 Qwen3.8 27B, Gemma 4 26B 또는 SAM 3.1 Text |
대부분의 라벨링 작업에서는 GPT-6.1 Terra가 여전히 더 나은 기본 선택입니다. 데이터가 Qwen4-Max의 강점을 보인 데이터셋과 유사한 경우 Qwen4-Max를 고려하고, 먼저 자체 이미지 샘플로 테스트해 보세요.
자주 묻는 질문
벤치마크에서 51개 모델 중 13위이며, 일부 영역에서 두드러진 결과를 보입니다. UL37 벤치마크에서는 요청 실패 없이 mAP50 0.474를 기록해 51개 모델 중 13위를 차지했습니다. 소아 손목 X선에서는 51개 모델 중 1위, 수중 물체와 상품이 빽빽한 소매 매대에서는 2위지만, 회로 기판 결함과 보안 X선에서는 점수가 낮습니다.
평균적으로는 그렇습니다. Qwen4-Max는 mAP50 0.474로 Qwen3.8-Max의 0.461보다 높고, 이미지 1,000장당 비용은 $5.68로 $7.74보다 낮으며, Qwen3.8-Max가 1.7%의 요청을 실패한 것과 달리 모든 요청을 완료했습니다. 다만 개선 폭은 고르지 않습니다. 19개 데이터셋에서는 Qwen3.8-Max를 앞서고 16개에서는 뒤처지며, 테니스공 및 뇌 MRI 탐지에서 큰 폭으로 하락했습니다.
일반적인 라벨링의 경우 GPT-6.1 Terra는 0.560 mAP50을 기록하고, 36개 데이터셋 중 23개에서 Qwen4-Max를 앞서며, 이미지 1,000장당 비용은 $4.36이고 응답 시간 중앙값은 5.1초입니다. 데이터가 손목 X선, 상품이 빽빽하게 진열된 소매점 선반 또는 수중 장면처럼 Qwen4-Max가 가장 강점을 보이는 데이터셋과 유사하다면 Qwen4-Max를 선택하고, 자체 이미지로 결과를 확인하세요.
전문가가 검토할 연구용 어노테이션의 박스를 초안으로 생성할 수는 있지만, 진단을 내리지는 않습니다. 소아 손목 X선에서 51개 모델 중 가장 높은 UL37 점수인 0.4975 mAP50을 기록하지만, 8개 의료 데이터셋 전체의 평균은 0.325로 GPT-6.1 Terra의 0.505보다 낮으며 흉부 X선에서는 성능이 좋지 않습니다.
Alibaba 요금은 약 $5.68입니다. 이는 성공적으로 어노테이션된 이미지 1,000장당 모델에 대해 Platform 요금을 적용한 Alibaba의 보고 토큰 사용량 기준입니다. Alibaba의 국제 정가는 입력 토큰 100만 개당 $1.50, 출력 토큰 100만 개당 $4.50입니다. Ultralytics Platform은 이미지 1,000장당 $1.00의 Batch Annotation 요금을 추가하므로 총액은 약 $6.68입니다.
국제 Alibaba Cloud Model Studio API 키를 생성한 다음, 워크스페이스 소유자가 Settings > API Keys의 Alibaba 항목에 해당 키를 추가하도록 하세요. 그런 다음 어노테이션 편집기의 Smart 모드에서 Qwen4-Max를 선택합니다. 이미지 몇 장으로 테스트하고 Batch Annotation을 실행한 뒤, 박스를 검토하고 같은 워크스페이스에서 Ultralytics YOLO26 모델을 학습하세요.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









