Claude Fable 5.2 chegou e recusa-se a analisar raios X de segurança
Claude Fable 5.2 foi lançado e recusa-se a rotular o conjunto de dados de segurança de raios X IEDXray na Ultralytics Platform: todas as 10 digitalizações foram bloqueadas, enquanto os modelos abertos responderam.
 Glenn Jocher17 min de leitura
A Anthropic lançou o Claude Fable 5.2 em 9 de novembro de 2026, afirmando que é «um passo acima do Opus 5.5 em quase todas as capacidades que avaliámos». No mesmo dia, testámo-lo no UL37, o nosso benchmark de deteção com 36 conjuntos de dados. Num desses conjuntos de dados, recusou-se a analisar uma única imagem.
A primeira digitalização mostra um portátil dentro de uma mala, com a placa de circuitos visível através da caixa e duas baterias encaixadas ao lado. Pedimos ao Claude Fable 5.2 que desenhasse caixas delimitadoras à volta deles. Em menos de dois segundos, a API da Anthropic respondeu com um bloqueio: «Este pedido acionou restrições relativas a conteúdo relacionado com o desenvolvimento de explosivos de alto rendimento e foi bloqueado ao abrigo da Política de Utilização da Anthropic».
Fez o mesmo nas 10 digitalizações de raios X de segurança do conjunto de dados, incluindo cinco que mostram apenas um telemóvel, portátil, pager ou walkie-talkie comum. Nenhum outro modelo que testámos recusou uma única digitalização: nem GPT-6.1, Gemini ou Grok, nem qualquer modelo de pesos abertos ou chinês, nem sequer os próprios Claude Opus 5.5, Sonnet 5.5 e Haiku 5.5 da Anthropic.
Em todos os outros casos, a anotação automática com Claude Fable 5.2 é excelente. Obteve 0.544 mAP50, o segundo lugar entre 44 modelos no nosso VLM Leaderboard, atrás do GPT-6.1 Terra, e as suas caixas são as mais justas que medimos. Já está disponível na Ultralytics Platform. A seguir, mostramos o que recusa, o que faz brilhantemente e se deve fazer parte do teu fluxo de trabalho de rotulagem.
O filtro da Anthropic bloqueou todos os raios X de segurança no UL37#
O UL37 mede o grau de correspondência entre as caixas de um modelo e as etiquetas humanas em 360 imagens: 10 de cada um dos 36 conjuntos de dados reais de deteção de objetos. Um deles é o IEDXray, um conjunto de imagens de raios X de scanners de bagagem criado para treinar detetores de ameaças em aeroportos, fronteiras e segurança de eventos. As suas 11 classes abrangem dispositivos eletrónicos do dia a dia (portáteis, telemóveis, pagers, walkie-talkies e baterias), versões modificadas de cada um e explosivos.
 Prévia 1 de IEDXray Improvised Device X-raySobreposição de anotações mostrando 3 rótulos
 Prévia 2 de IEDXray Improvised Device X-raySobreposição de anotações mostrando 1 rótulo
 Prévia 3 de IEDXray Improvised Device X-raySobreposição de anotações mostrando 2 rótulos
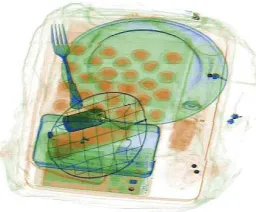 Prévia 4 de IEDXray Improvised Device X-raySobreposição de anotações mostrando 1 rótulo
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
O Fable 5.2 recusou as 10 imagens. Cada pedido demorou entre 1,0 e 4,7 segundos e devolveu o motivo de paragem refusal da Anthropic, sem caixas. A Platform mostra ao utilizador «parou antes de concluir as deteções (recusa). Experimenta outro modelo».
Para perceber exatamente porquê, reproduzimos diretamente na API da Anthropic o pedido de produção da Platform para as dez digitalizações, em 10 de novembro. As dez tiveram a mesma resposta: motivo de paragem refusal, categoria general_harms, zero tokens de saída e a mensagem sobre «explosivos de alto rendimento» citada acima. A mensagem sugere pedir «uma isenção com base na forma como utilizas o Claude» através do centro de ajuda da Anthropic. Para quem integra a API, aponta para a documentação sobre recusas da Anthropic, que sugere configurar um modelo alternativo.
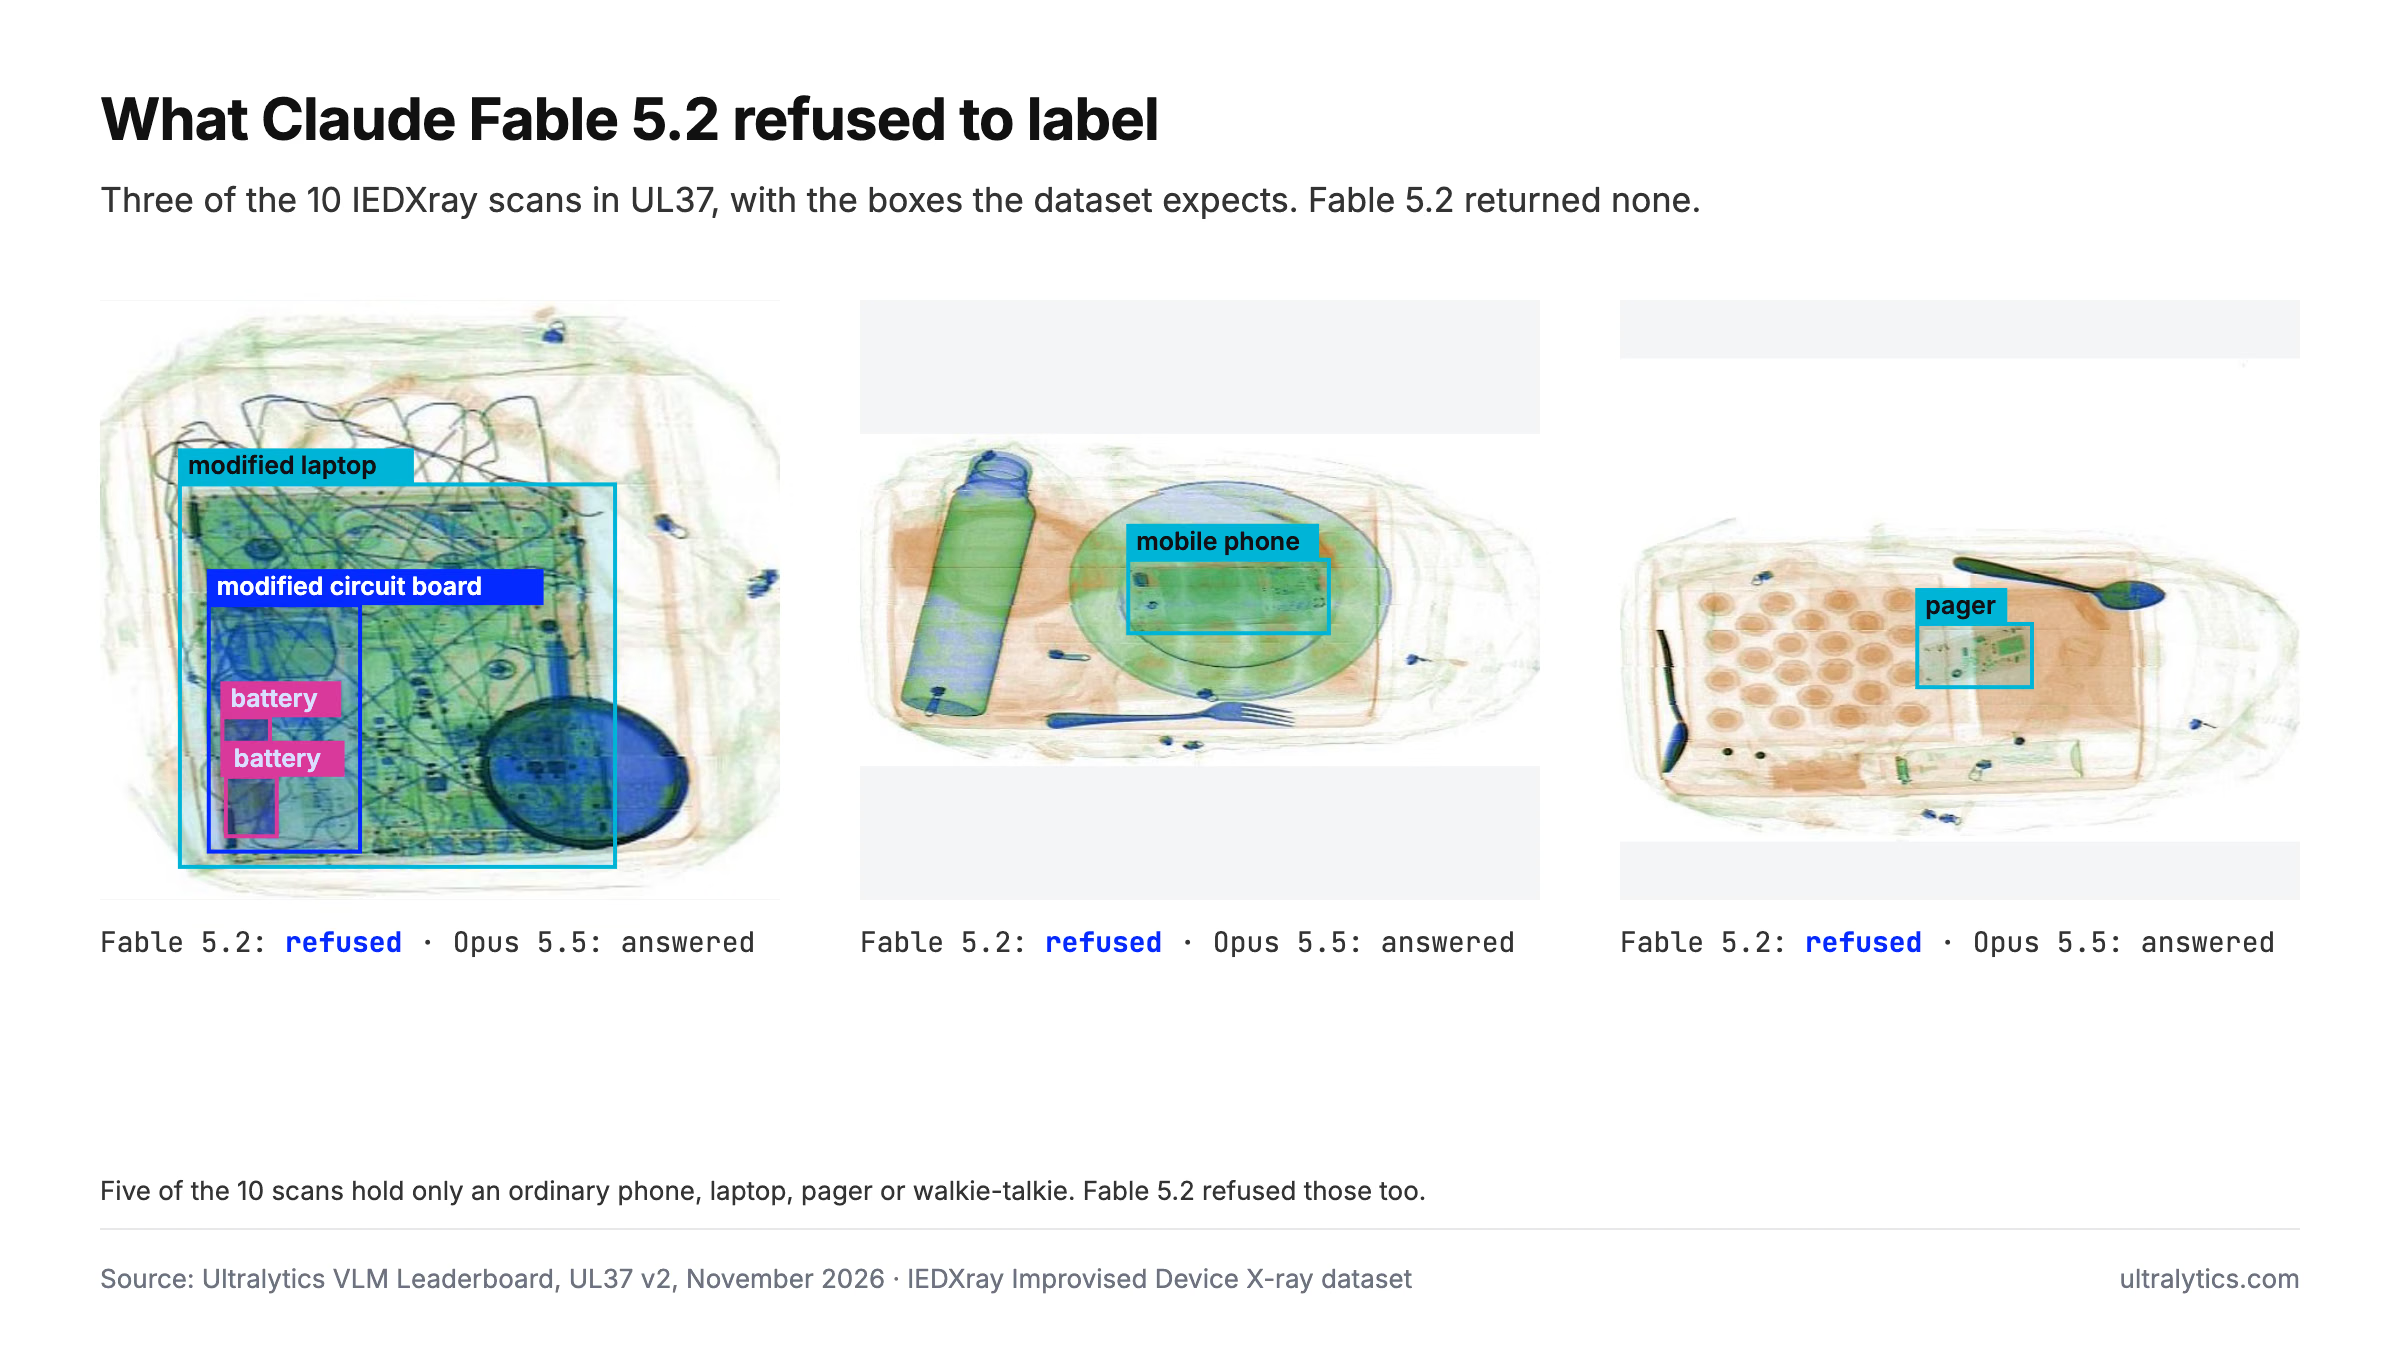
Três das 10 digitalizações IEDXray com as caixas esperadas. Claude Fable 5.2 recusou as três; Claude Opus 5.5 respondeu às dez digitalizações na mesma execução.
O bloqueio não tem a ver com o conteúdo da imagem. O telemóvel ao centro é apenas um telemóvel. Cinco das dez digitalizações não contêm nenhum dispositivo modificado nem qualquer explosivo, e o Fable 5.2 recusou todas. O filtro parece reagir à própria tarefa: um conjunto de dados de segurança cuja lista de classes inclui explosivos.
O Fable 5.2 recusa mais pedidos do que o Fable 5.1, não menos#
O anúncio de lançamento da Anthropic afirma que as salvaguardas de cibersegurança e biologia do Fable 5.2 «produzem menos bloqueios desnecessários» do que as do Fable 5.1, cerca de 55% menos nos testes iniciais. Nos raios X de segurança, observámos o contrário: o Fable 5.1 recusou uma em cada dez digitalizações, e o Fable 5.2 recusou as dez.
A Anthropic também afirma que o Fable 5.2 e o Claude Mythos 5.2 são o mesmo modelo subjacente. O Mythos 5.2 é disponibilizado sem determinadas salvaguardas de cibersegurança e biologia e apenas a organizações verificadas pela Anthropic. Por outras palavras, as salvaguardas são uma camada decidida pelo fornecedor, separada da capacidade de visão do modelo. O Fable 5.1 respondeu a nove das mesmas digitalizações e obteve 0.15.
Para uma equipa que está a criar um detetor para rastreio de bagagem, o resultado prático é simples. O modelo Claude mais caro não ajuda a rotular os dados, e a política mudou de uma versão para a seguinte.
Todos os modelos de pesos abertos rotularam as digitalizações que o Fable recusou#
Entre os 44 modelos do nosso quadro de classificação, apenas dois recusaram alguma vez uma digitalização IEDXray, e ambos são Claude Fable: o 5.1 recusou uma e o 5.2 recusou dez. Nenhum outro modelo recusou qualquer uma, fosse da OpenAI, Google, xAI, Meta, de um laboratório chinês ou das próprias linhas Opus, Sonnet e Haiku da Anthropic.
Isso inclui todos os 19 modelos alojados por nós nos próprios servidores da Platform, incluindo modelos de pesos abertos como Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text e Moondream 3.1. Nenhum deles recusou uma única digitalização. O Moondream 3.1, um modelo de pesos abertos que não precisa de chave API na Platform, obteve 0.27 mAP50 no IEDXray, atrás apenas do Gemini 4 Argon, com 0.30, e à frente de todos os modelos Claude.
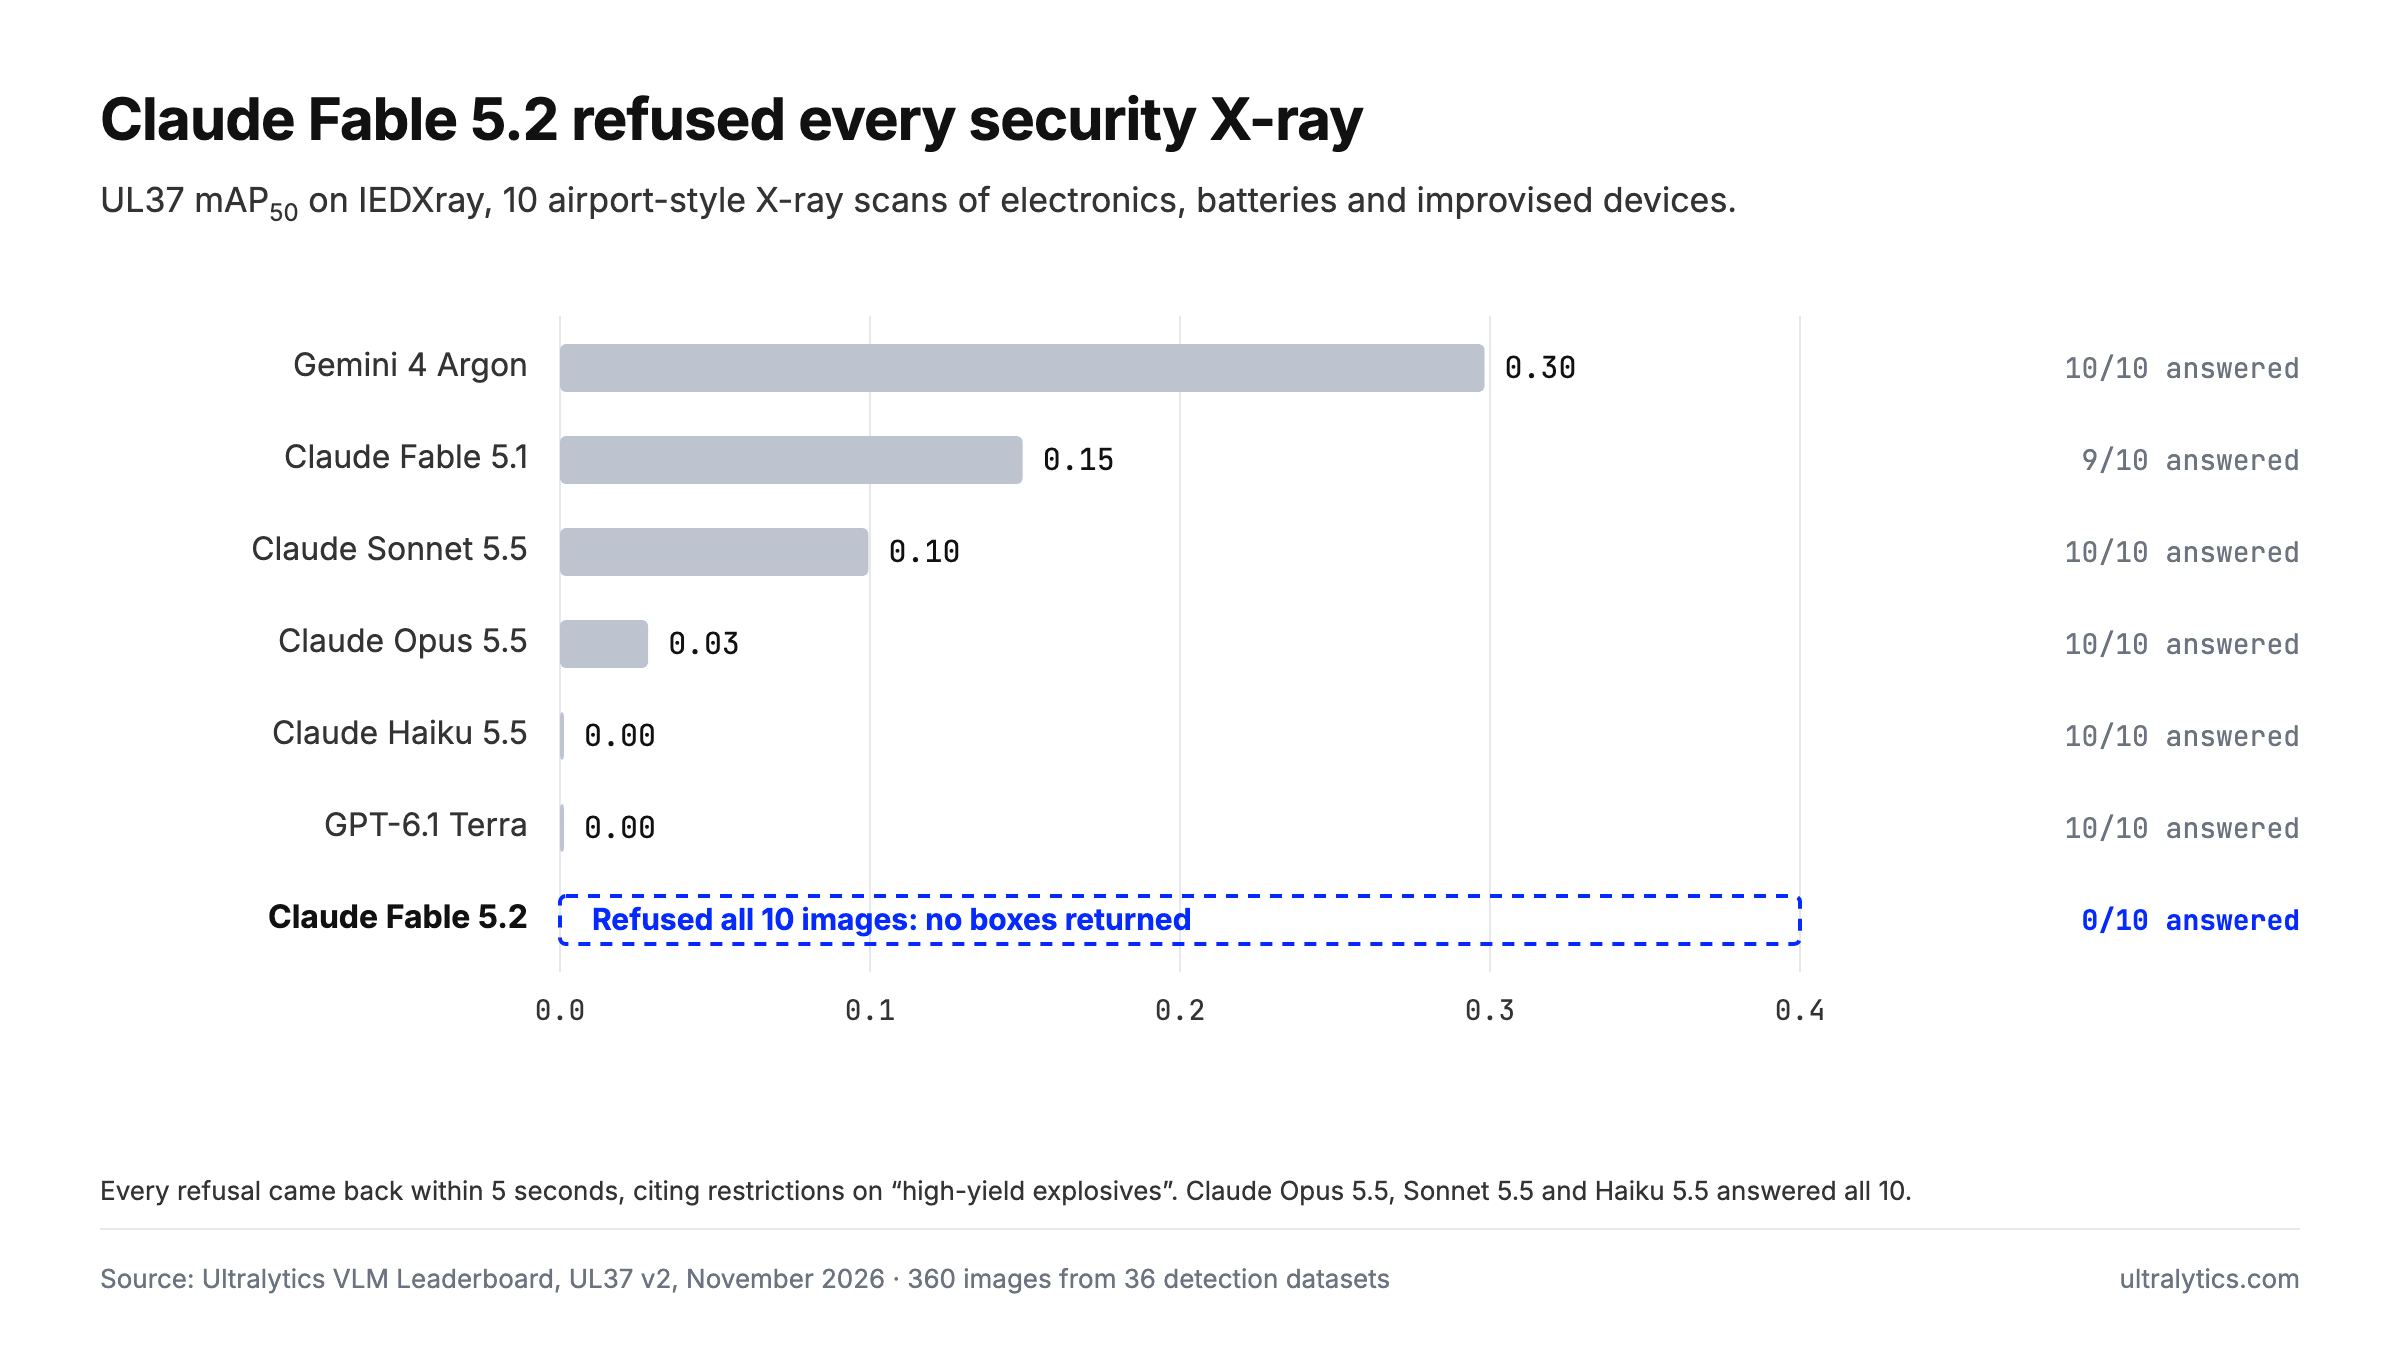
mAP50 no IEDXray para a linha Anthropic e os dois líderes do quadro de classificação, UL37 v2, esforço de raciocínio predefinido. O Fable 5.2 não respondeu a nenhuma das 10 digitalizações.
Os modelos chineses costumam ser notícia pelo que não dizem. Aqui, a situação inverteu-se: um laboratório americano de topo censurou os resultados, enquanto todos os modelos chineses que testámos responderam sem hesitar. Qwen da Alibaba, Kimi da Moonshot, DeepSeek, GLM da Zhipu, MiMo da Xiaomi, MiniMax e HY4 da Tencent não recusaram nenhuma das dez digitalizações, e os modelos Qwen de pesos abertos que alojamos responderam a todas. O modelo de topo da Anthropic, a 8 $ por milhão de tokens de entrada, recusou-se a analisar as imagens.
Os raios X de segurança são difíceis para todos os modelos. A maioria obtém menos de 0.15 no IEDXray, por isso as caixas de qualquer modelo são apenas um primeiro rascunho. Mas podes corrigir um rascunho no editor de anotações. Uma recusa obriga-te a desenhar todas as caixas à mão. Os pesos abertos também significam que o modelo que validas hoje se comporta da mesma forma amanhã, porque não há nenhuma política de fornecedor entre ti e o resultado. Depois de rotulados os dados, treinar o teu próprio detetor Ultralytics YOLO26 também deixa o modelo implementado totalmente sob o teu controlo.
Fora dos raios X de segurança, Claude Fable 5.2 é o segundo melhor anotador que testámos#
Todas as imagens do UL37 passam pelo mesmo pipeline de produção que os utilizadores da Platform recebem, com os nomes de classes do próprio conjunto de dados; depois, o SAM 3.1 ajusta todas as caixas. A metodologia é pública. Eis os resultados do Fable 5.2:
- mAP50: 0.544, n.º 2 entre 44
- mAP50-95: 0.347, n.º 1 entre 44, pouco acima dos 0.345 do GPT-6.1 Terra
- Precisão e revocação: 0.602 e 0.620
- Custo do fornecedor: 37,55 $ por 1.000 imagens
- Tempo mediano por imagem: 4,6 s
- Pedidos falhados: 11 em 360, as 10 recusas mais um pedido que excedeu o limite de 115 segundos da Platform
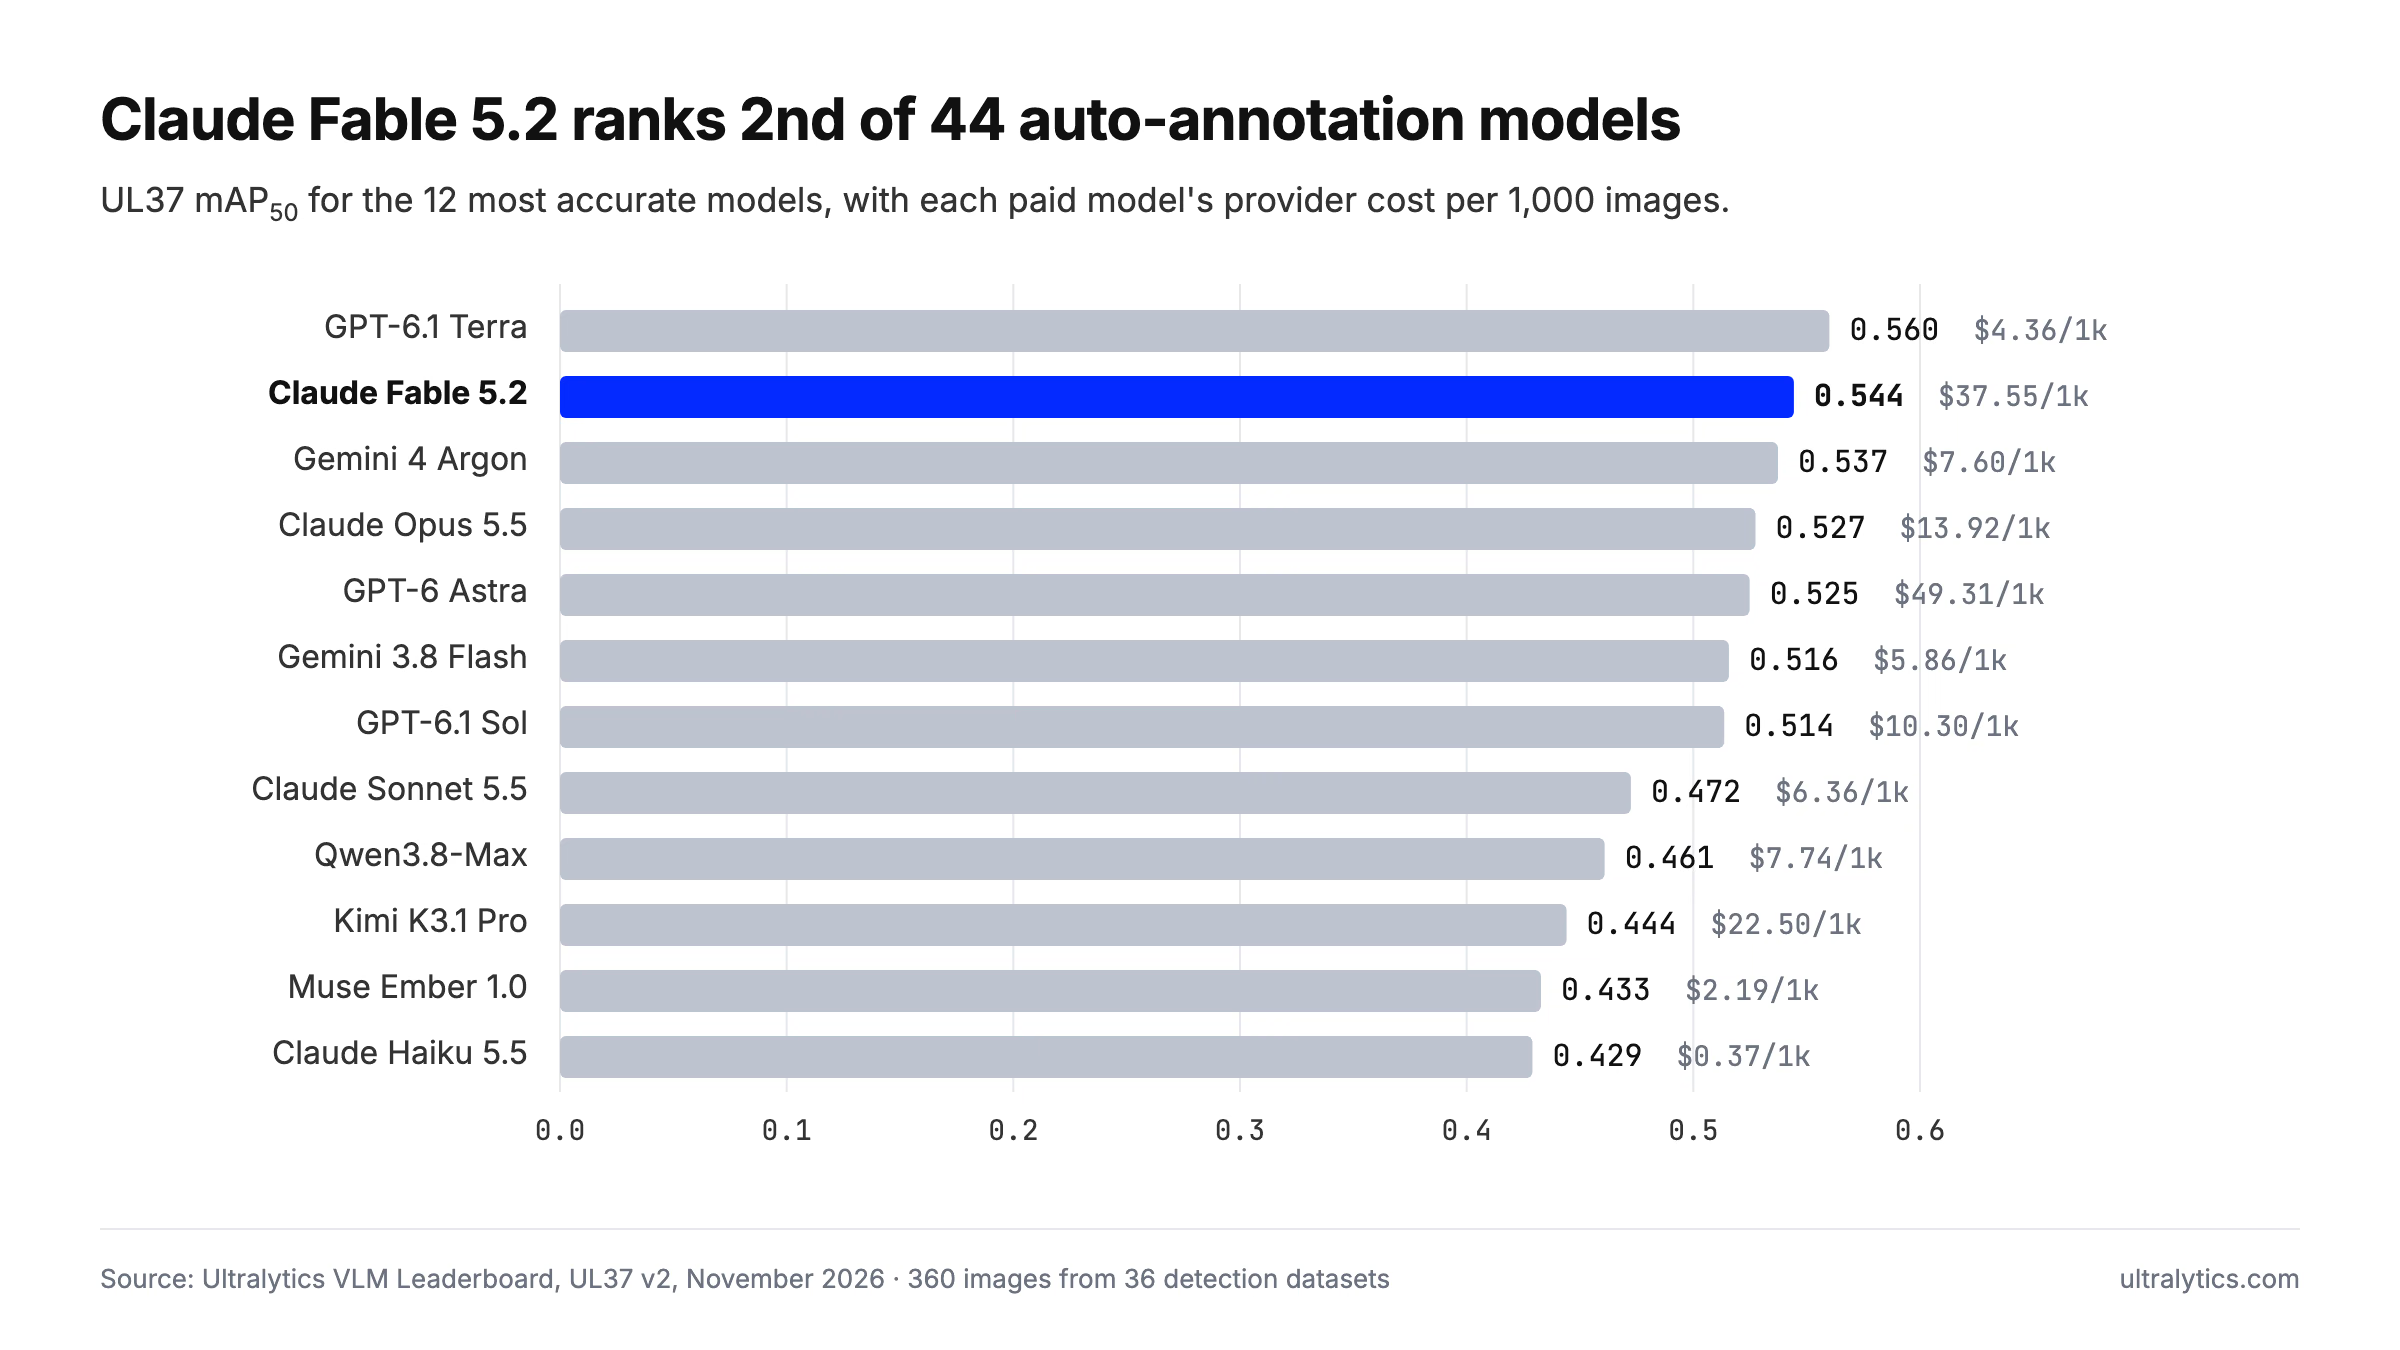
mAP50 no UL37 para os 12 modelos mais precisos dos 44, com o custo do fornecedor por 1.000 imagens, 10 de novembro de 2026.
O primeiro lugar em mAP50-95 é importante. Essa métrica mais exigente calcula a média dos limiares de sobreposição das caixas entre 50% e 95%, recompensando caixas que acompanham de perto cada objeto, em vez de apenas o cobrirem aproximadamente. As caixas originais do Fable 5.2 já obtêm 0.538 mAP50 antes do refinamento do SAM 3.1, que as eleva a 0.544.
Fica entre os cinco primeiros em 22 dos 36 conjuntos de dados e ocupa o primeiro lugar absoluto em três: tabuleiros de refeições escolares da UEC (0.96), deteção de bolas e cestos de basquetebol (0.85) e doenças foliares do PlantDoc (0.52). Por domínio, fica em primeiro lugar no retalho e, por uma pequena margem sobre o Claude Opus 5.5, na natureza e agricultura. Nas 10 imagens de referência do COCO 2017, avaliadas separadamente, chega a 0.686, o melhor resultado de qualquer modelo de linguagem, atrás apenas dos modelos de segmentação SAM 3 e SAM 3.1 Text.
As recusas deram ao Fable 5.2 uma pontuação de zero num conjunto de dados, mas não lhe tiraram o primeiro lugar. Excluindo o IEDXray, o Fable 5.2 tem uma média de 0.560, enquanto o Terra, que também obteve zero nesse conjunto sem recusar, tem uma média de 0.576.
Um enorme salto em relação ao Claude Fable 5.1#
O Fable 5.2 supera o Claude Fable 5.1 em 31 dos 36 conjuntos de dados e custa menos por imagem.
| Resultado no UL37 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Precisão / revocação | 0.602 / 0.620 | 0.506 / 0.485 |
| Posição no ranking | 2.º entre 44 | 13.º entre 44 |
| Custo do fornecedor por 1.000 imagens | $37.55 | $43.75 |
| Tempo mediano por imagem | 4.6 s | 2,6 s |
| Imagens IEDXray recusadas | 10 | 1 |
A precisão e a revocação aumentaram em conjunto, o que significa menos caixas falsas para eliminar e menos objetos não detetados para desenhar. Os maiores ganhos são impressionantes. Nas cabeças de trigo do GWHD, o Fable 5.1 obteve 0.24 e o Fable 5.2 obtém 0.77. Os produtos de retalho e caixa do RPC passaram de 0.57 para 0.90, as imagens térmicas de drones HIT-UAV de 0.17 para 0.48 e as ecografias da tiroide TN5000 de 0.03 para 0.44.
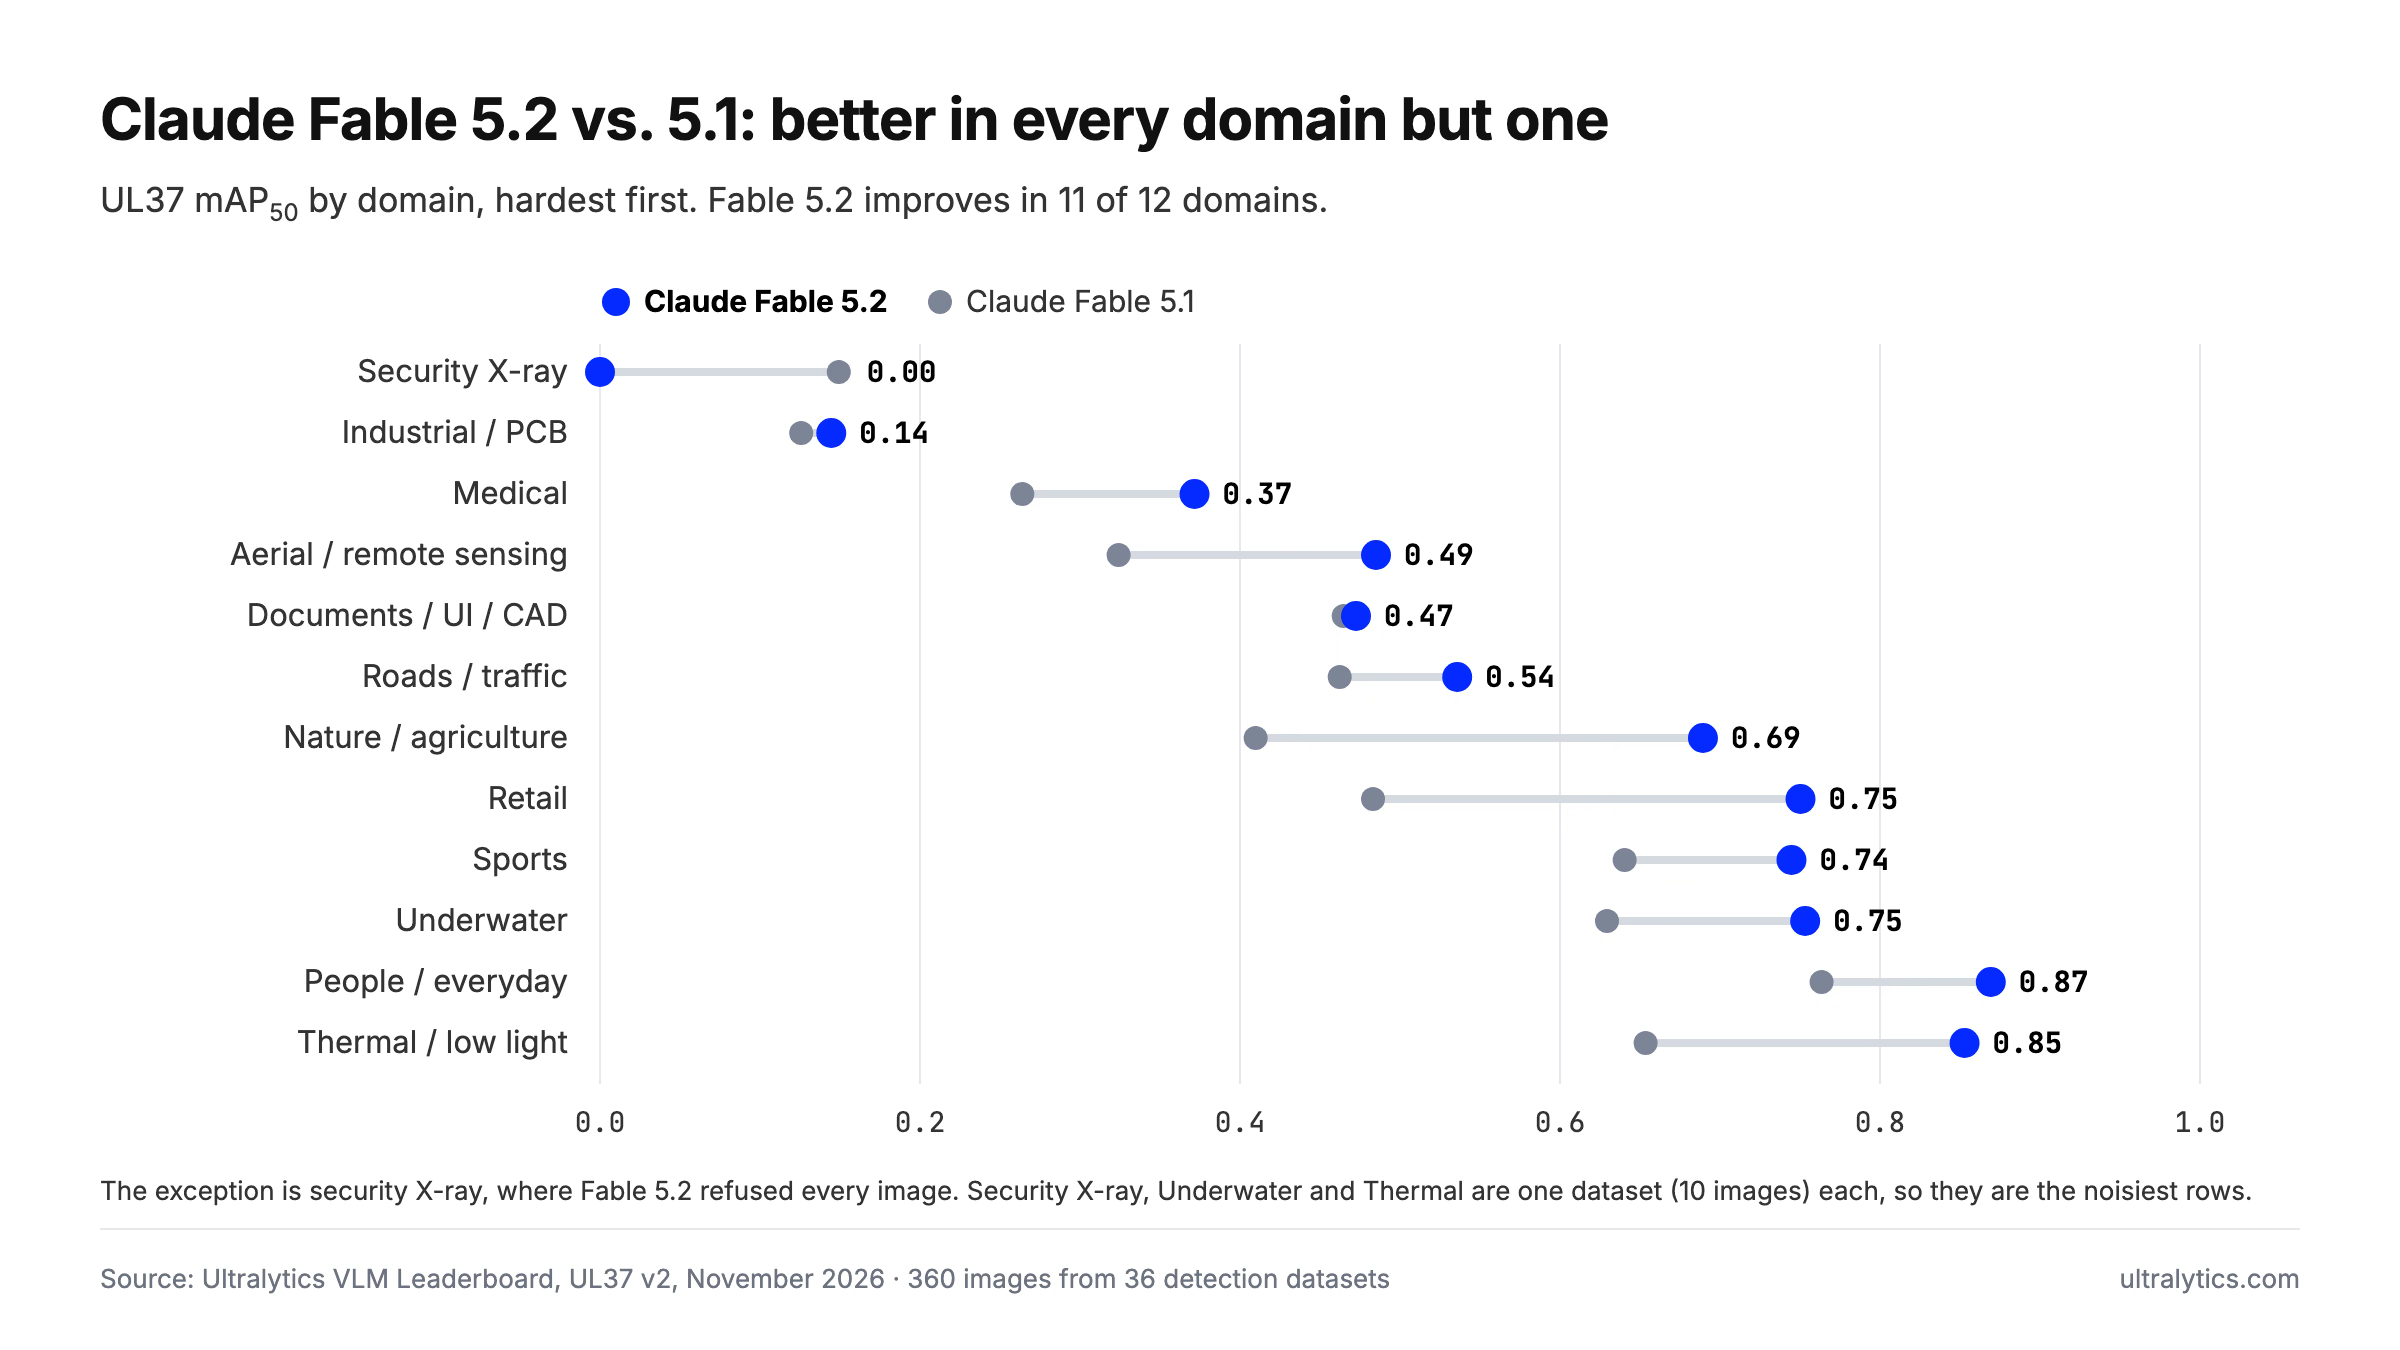
mAP50 no UL37 por domínio, do mais difícil ao menos difícil, Claude Fable 5.2 vs. Claude Fable 5.1 com o nível de esforço predefinido da Anthropic.
Onze dos doze domínios melhoraram. O único que piorou foi o dos raios X de segurança, de 0.15 para zero, e isso deve-se à recusa, não à capacidade de visão do modelo. As marcações rodoviárias CeyMo também pioraram, de 0.85 para 0.74.
Claude Fable 5.2 vs. GPT-6.1 Terra, Gemini 4 Argon e Claude Opus 5.5#
| Modelo | UL37 mAP50 | mAP50-95 | Precisão | Revocação | Custo por 1.000 imagens | Tempo mediano por imagem |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 s |
Na comparação direta, o Fable 5.2 supera o Terra em 18 conjuntos de dados e fica atrás em 16, com dois empates. Supera o Argon por 21 a 15 e o Opus 5.5 por 22 a 14. Tem a maior revocação dos quatro, por isso não deteta menos objetos; mas a sua precisão é a mais baixa, por isso espera eliminar mais algumas caixas. O nosso guia sobre como escolher um VLM com base na precisão e na revocação explica como ponderar esse compromisso para os teus dados.
Além dos raios X, o Fable 5.2 fica aquém na imagiologia médica, onde tem uma média de 0.372 em oito conjuntos de dados, contra 0.505 do Terra, e nas placas de circuitos, onde obtém 0.00 no DeepPCB. Cada conjunto de dados tem apenas 10 imagens, por isso considera as pontuações de conjuntos individuais como indícios, não como vereditos.
A própria Anthropic recomenda começar a maioria das tarefas com o Claude Opus 5.5, o seu «modelo de referência para o dia a dia», e passar para o Fable apenas quando a tarefa o exigir. Para anotação, esse conselho mantém-se. O Opus 5.5 alcança 97% do mAP50 do Fable 5.2 por 37% do custo, responde em 2,7 s e não recusou nenhum dos raios X.
Quanto custa um lote com Claude Fable 5.2#
Os 37,55 $ por 1.000 imagens correspondem à fatura do fornecedor, calculada com base na utilização de tokens comunicada pela Anthropic, aos preços de tabela de 8 $ por milhão de tokens de entrada e 40 $ por milhão de tokens de saída, segundo a página de preços da Anthropic. O Fable 5.2 funciona com o nível de esforço de raciocínio alto predefinido da Anthropic. A anotação em lote acrescenta uma taxa de processamento da Platform de 1,00 $ por 1.000 imagens, pelo que um lote de 1.000 imagens custa cerca de 38,55 $.
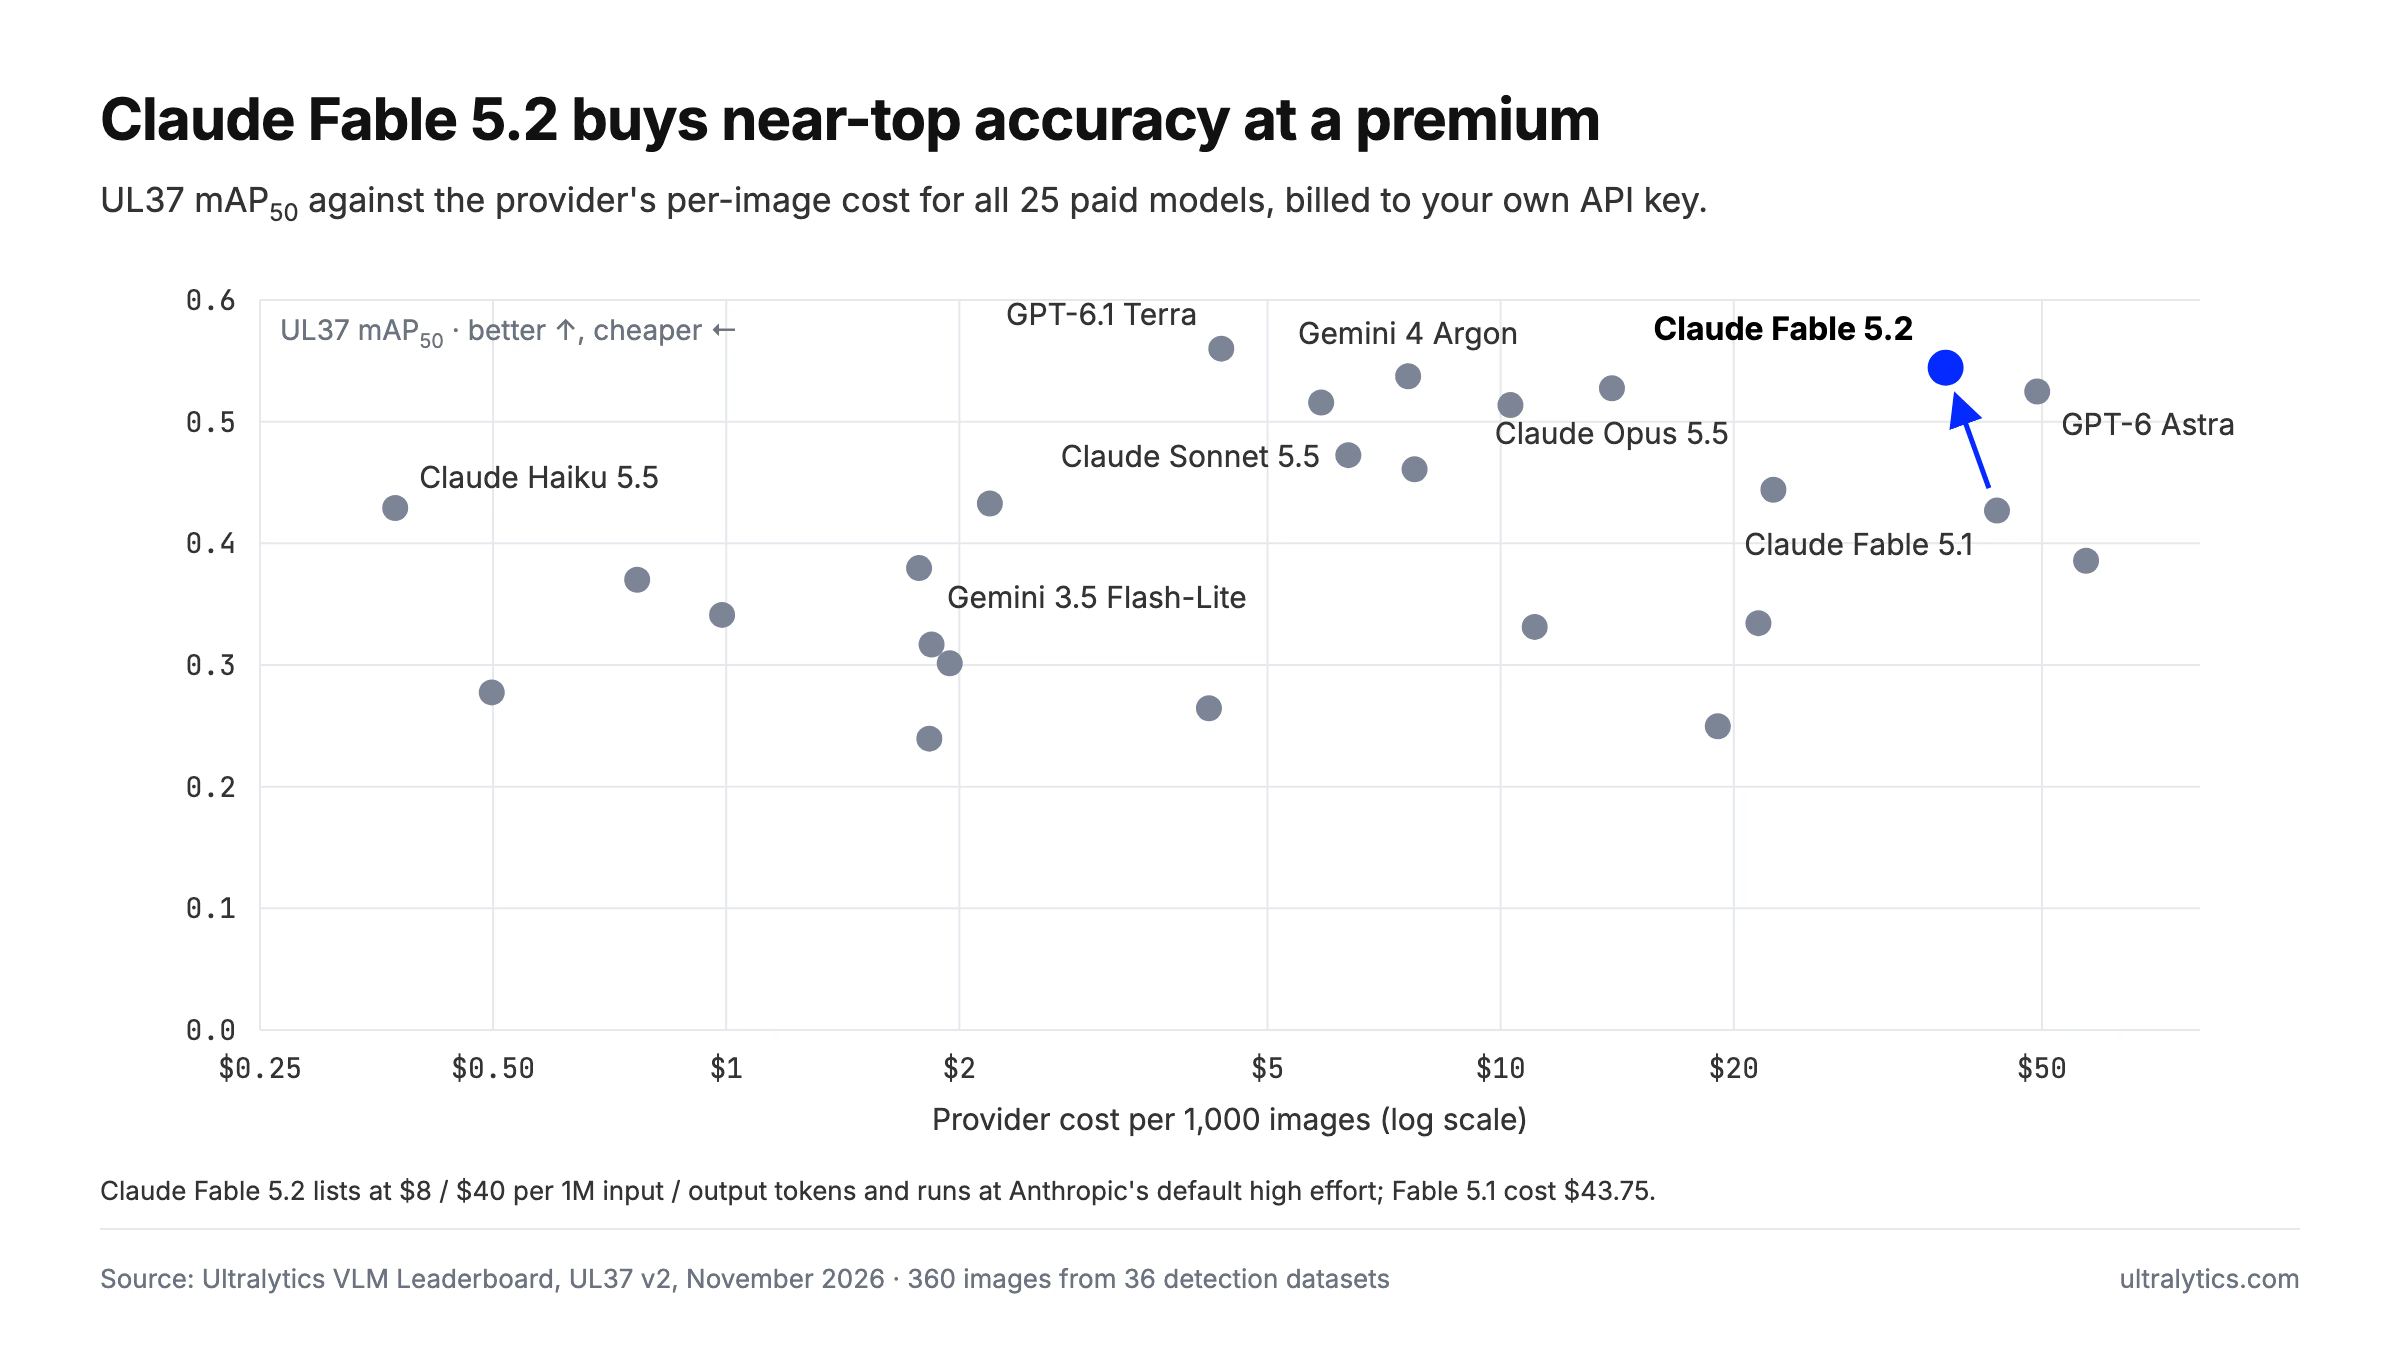
mAP50 no UL37 em função do custo do fornecedor por 1.000 imagens para os 25 modelos pagos, preços de tabela, 10 de novembro de 2026.
Isso representa mais de oito vezes os 4,36 $ do Terra por uma diferença de apenas 0.016 em mAP50. O Fable 5.2 só justifica o preço quando as caixas justas são mais importantes do que o orçamento. Se o custo for importante, o Claude Haiku 5.5 obtém 0.429 por 0,37 $, e os modelos alojados de pesos abertos não precisam de chave API.
Como executar a anotação automática com Claude Fable 5.2 no teu conjunto de dados#
O Fable 5.2 é um modelo guiado por classes para conjuntos de dados de deteção com 1 a 200 classes. Devolve caixas com os nomes de classes do teu conjunto de dados, que podes rever antes de guardar.
- Cria uma chave na página de chaves da API Claude.
- Adiciona-a em Settings > API Keys no espaço de trabalho da Platform que contém o teu conjunto de dados. A Anthropic cobra-te diretamente, e a Ultralytics não acrescenta qualquer margem de lucro aos tokens. A documentação das chaves do fornecedor explica os detalhes.
- No editor de anotações, muda para o modo Smart e escolhe Claude Fable 5.2 em Anthropic. Carrega em Predict ou em
Ppara rotular a imagem atual. - Para rotular todas as imagens ainda não rotuladas, escolhe More actions > Batch Annotation na página do conjunto de dados. A Platform guarda primeiro uma versão do conjunto de dados, para poderes reverter as alterações.
- Se houver imagens recusadas, volta a executar a anotação em lote com outro modelo, como o Gemini 4 Argon ou um modelo alojado de pesos abertos. Este só rotula as imagens que continuam sem rótulo.
- Revê e guarda as caixas e treina um modelo YOLO26 com o resultado no mesmo espaço de trabalho.
Antes de avançar com um conjunto de dados grande, abre a página do modelo. Esta reproduz as caixas registadas pelo Fable 5.2 em cada conjunto de dados de benchmark, lado a lado com as caixas esperadas, e apresenta a pontuação de cada conjunto.
Página do modelo Claude Fable 5.2
Para saberes mais sobre a integração destes modelos no editor, consulta como a Ultralytics Platform utiliza IA para automatizar a anotação e por que motivo a revisão com intervenção humana continua a ser essencial.
Quem deve usar o Claude Fable 5.2#
Escolhe o Claude Fable 5.2 quando a precisão das caixas for prioritária e o orçamento for menos importante: desporto, retalho, agricultura e cenas do dia a dia, onde está no topo ou perto do topo entre todos os modelos que testámos. A sua vantagem em mAP50-95 faz dele um primeiro rascunho sólido para conjuntos de dados que pretendes treinar com limiares de IoU rigorosos.
Evita-o para dados de segurança, defesa e rastreio. O filtro da Anthropic recusou todas as digitalizações do nosso conjunto de dados de raios X de segurança, mesmo as que continham apenas um telemóvel, e não há nada na Platform que contorne essa restrição. Para esses projetos, usa o Gemini 4 Argon ou um modelo de pesos abertos que controles. Para a maioria das outras tarefas de rotulagem, o GPT-6.1 Terra ou o Claude Opus 5.5 oferece caixas quase iguais por uma fração do preço.
Perguntas frequentes
A API da Anthropic bloqueia pedidos de anotação de raios X de segurança que envolvam classes de explosivos. Nas 10 digitalizações IEDXray do nosso benchmark, devolveu um motivo de paragem
refusalcom a categoriageneral_harms, citando «restrições relativas a conteúdo relacionado com o desenvolvimento de explosivos de alto rendimento», mesmo nas digitalizações que continham apenas um telemóvel ou portátil comum. Carregar novamente em Predict não resolve; usa outro modelo para essas imagens.Nenhum outro modelo do nosso quadro de classificação recusou uma digitalização IEDXray, incluindo os 19 modelos que alojamos, todos os modelos de laboratórios chineses e os próprios Claude Opus 5.5, Sonnet 5.5 e Haiku 5.5 da Anthropic. O Gemini 4 Argon obteve a pontuação mais alta, com 0.30 mAP50, seguido pelo modelo de pesos abertos Moondream 3.1, com 0.27. A precisão é baixa para todos os modelos nos raios X de segurança, por isso revê todas as caixas.
Sim. Obtém 0.544 mAP50 nos 36 conjuntos de dados reais de deteção, ficando em segundo lugar entre 44 modelos, e ocupa o primeiro lugar na métrica mais rigorosa mAP50-95, com 0.347. É mais forte no retalho, desporto, agricultura e cenas do dia a dia, e mais fraco nos raios X de segurança, na imagiologia médica e na deteção de defeitos em placas de circuitos.
Obtém 0.544 mAP50, face aos 0.427 do Fable 5.1, e vence em 31 dos 36 conjuntos de dados, custando 37,55 $ por 1.000 imagens em vez de 43,75 $. É mais lento: 4,6 s por imagem, contra 2,6 s, e recusou os 10 raios X de segurança, enquanto o Fable 5.1 recusou um.
Cerca de 37,55 $ em cobranças da Anthropic, com base na utilização de tokens comunicada pelo fornecedor, a 8 $ por milhão de tokens de entrada e 40 $ por milhão de tokens de saída. A anotação em lote na Ultralytics Platform acrescenta uma taxa de processamento de 1,00 $ por 1.000 imagens. Pagas diretamente à Anthropic com a tua própria chave API.
O Terra obtém uma pontuação superior em mAP50, 0.560 contra 0.544, e custa cerca de um oitavo. O Fable 5.2 tem caixas ligeiramente mais justas, com 0.347 mAP50-95 contra 0.345 do Terra, e vence em 18 conjuntos de dados, contra 16 do Terra. Para a maioria das equipas, o Terra é a melhor opção predefinida; o Fable 5.2 faz sentido quando a precisão das caixas é mais importante do que o custo.
Escrito por
Fundador e CEO · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









