GPT-6.1 Terra fica em 1º lugar na anotação automática, superando os principais modelos da própria OpenAI
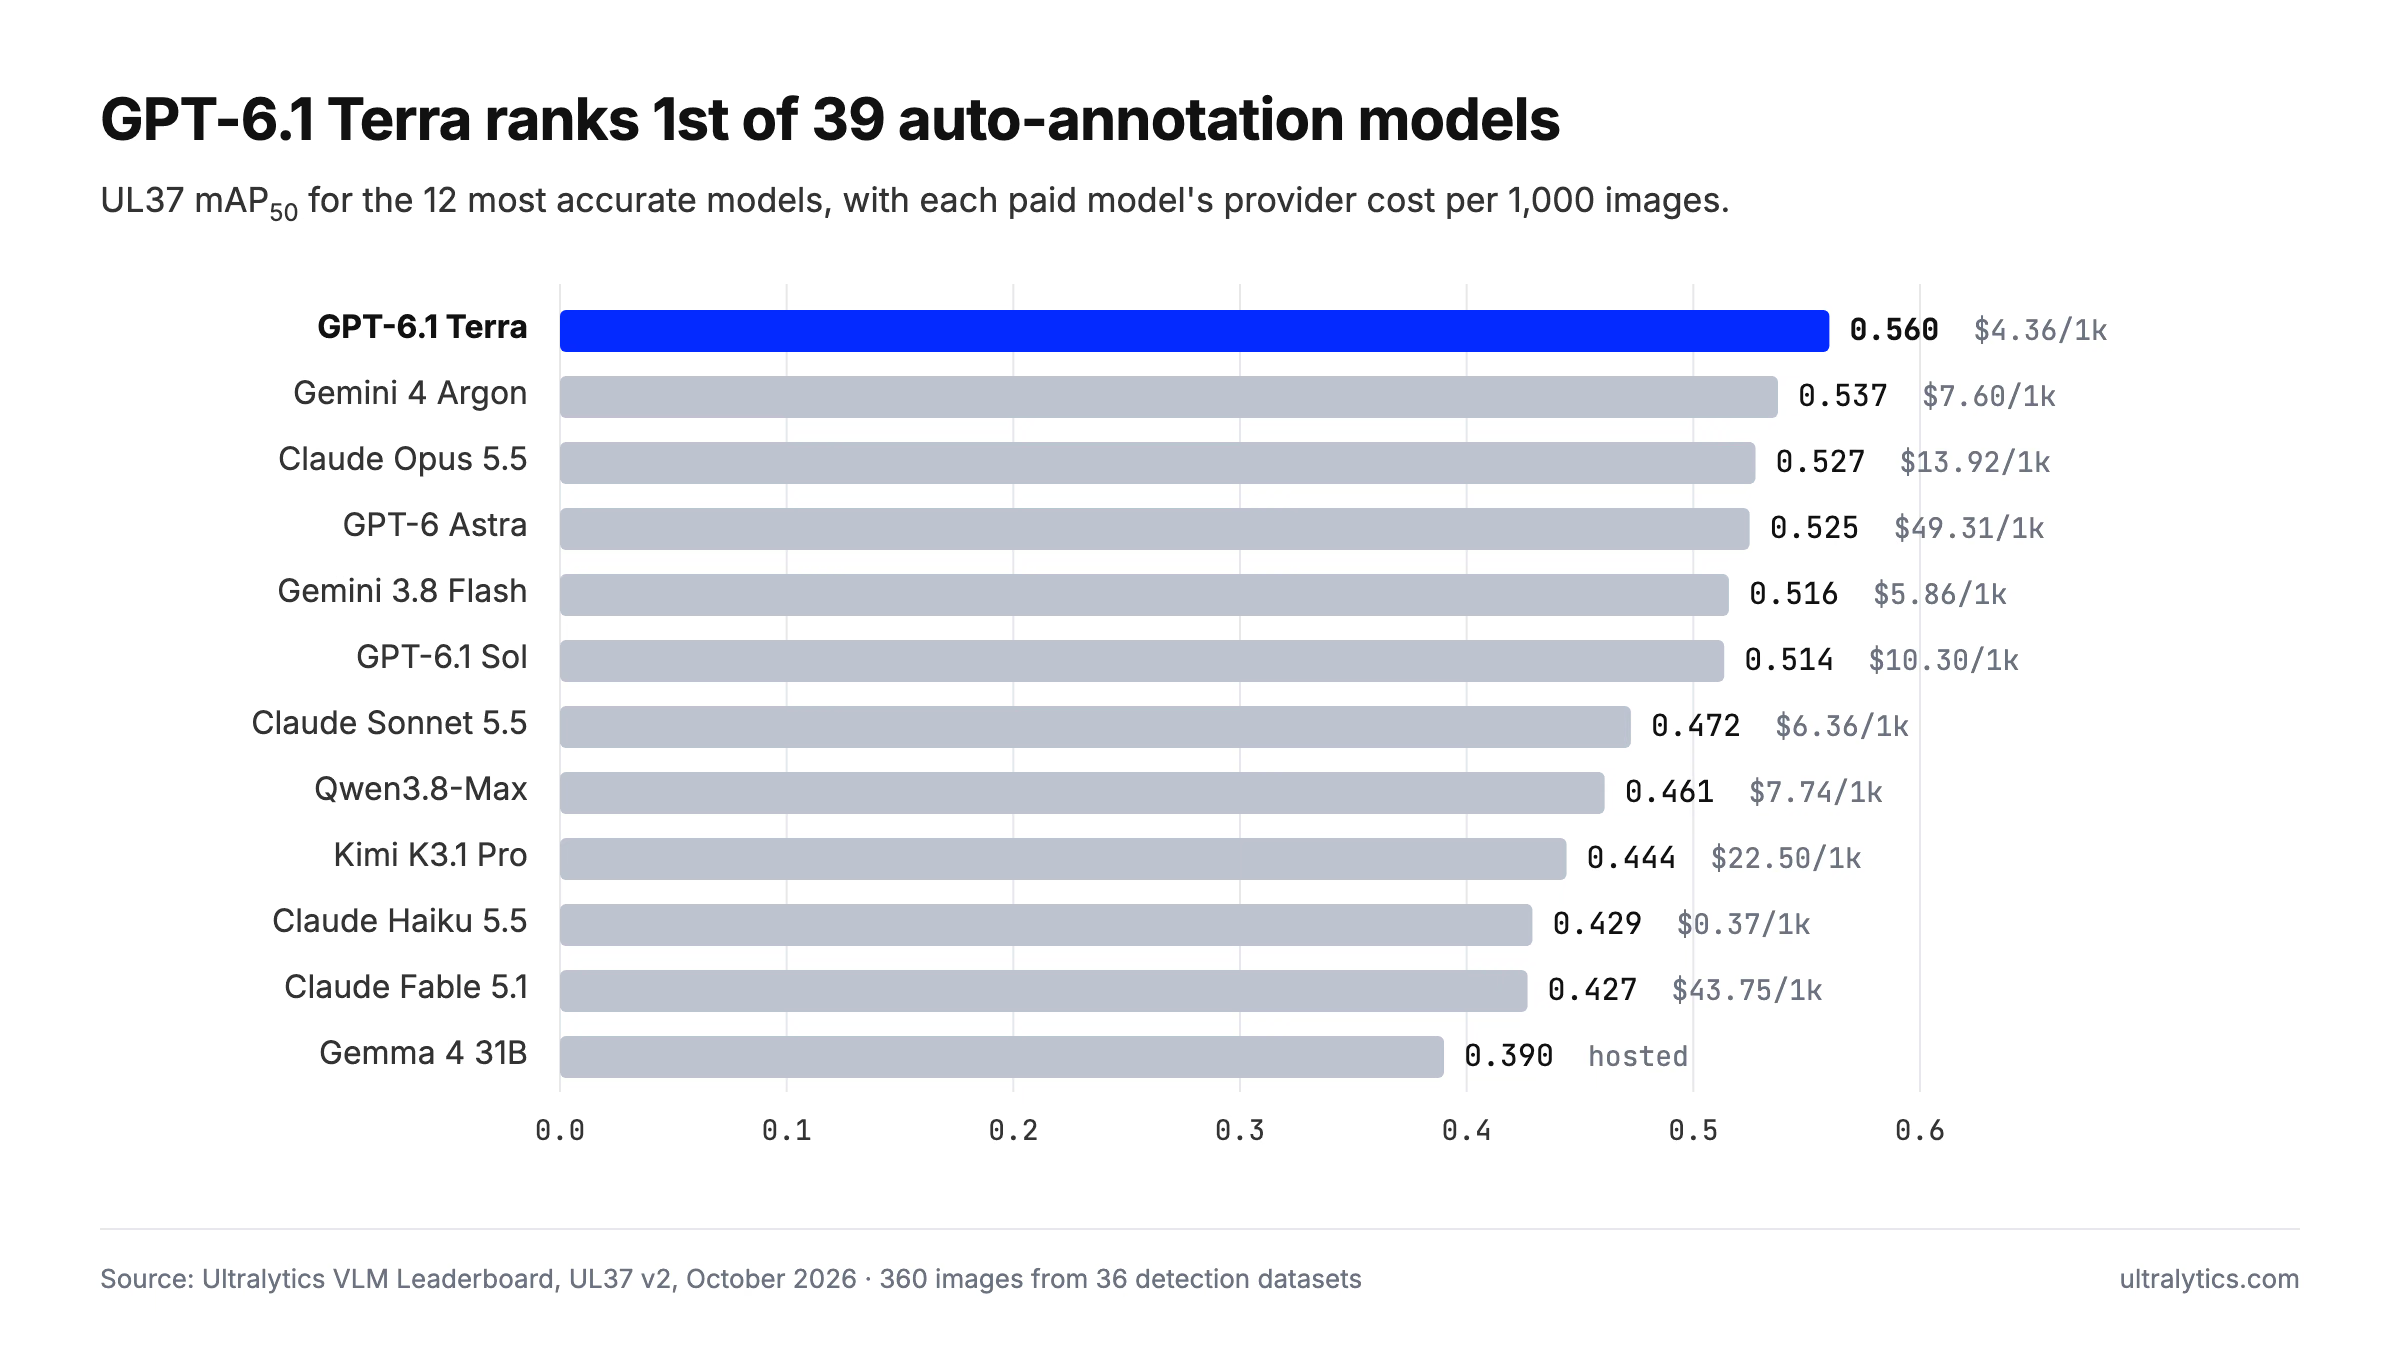
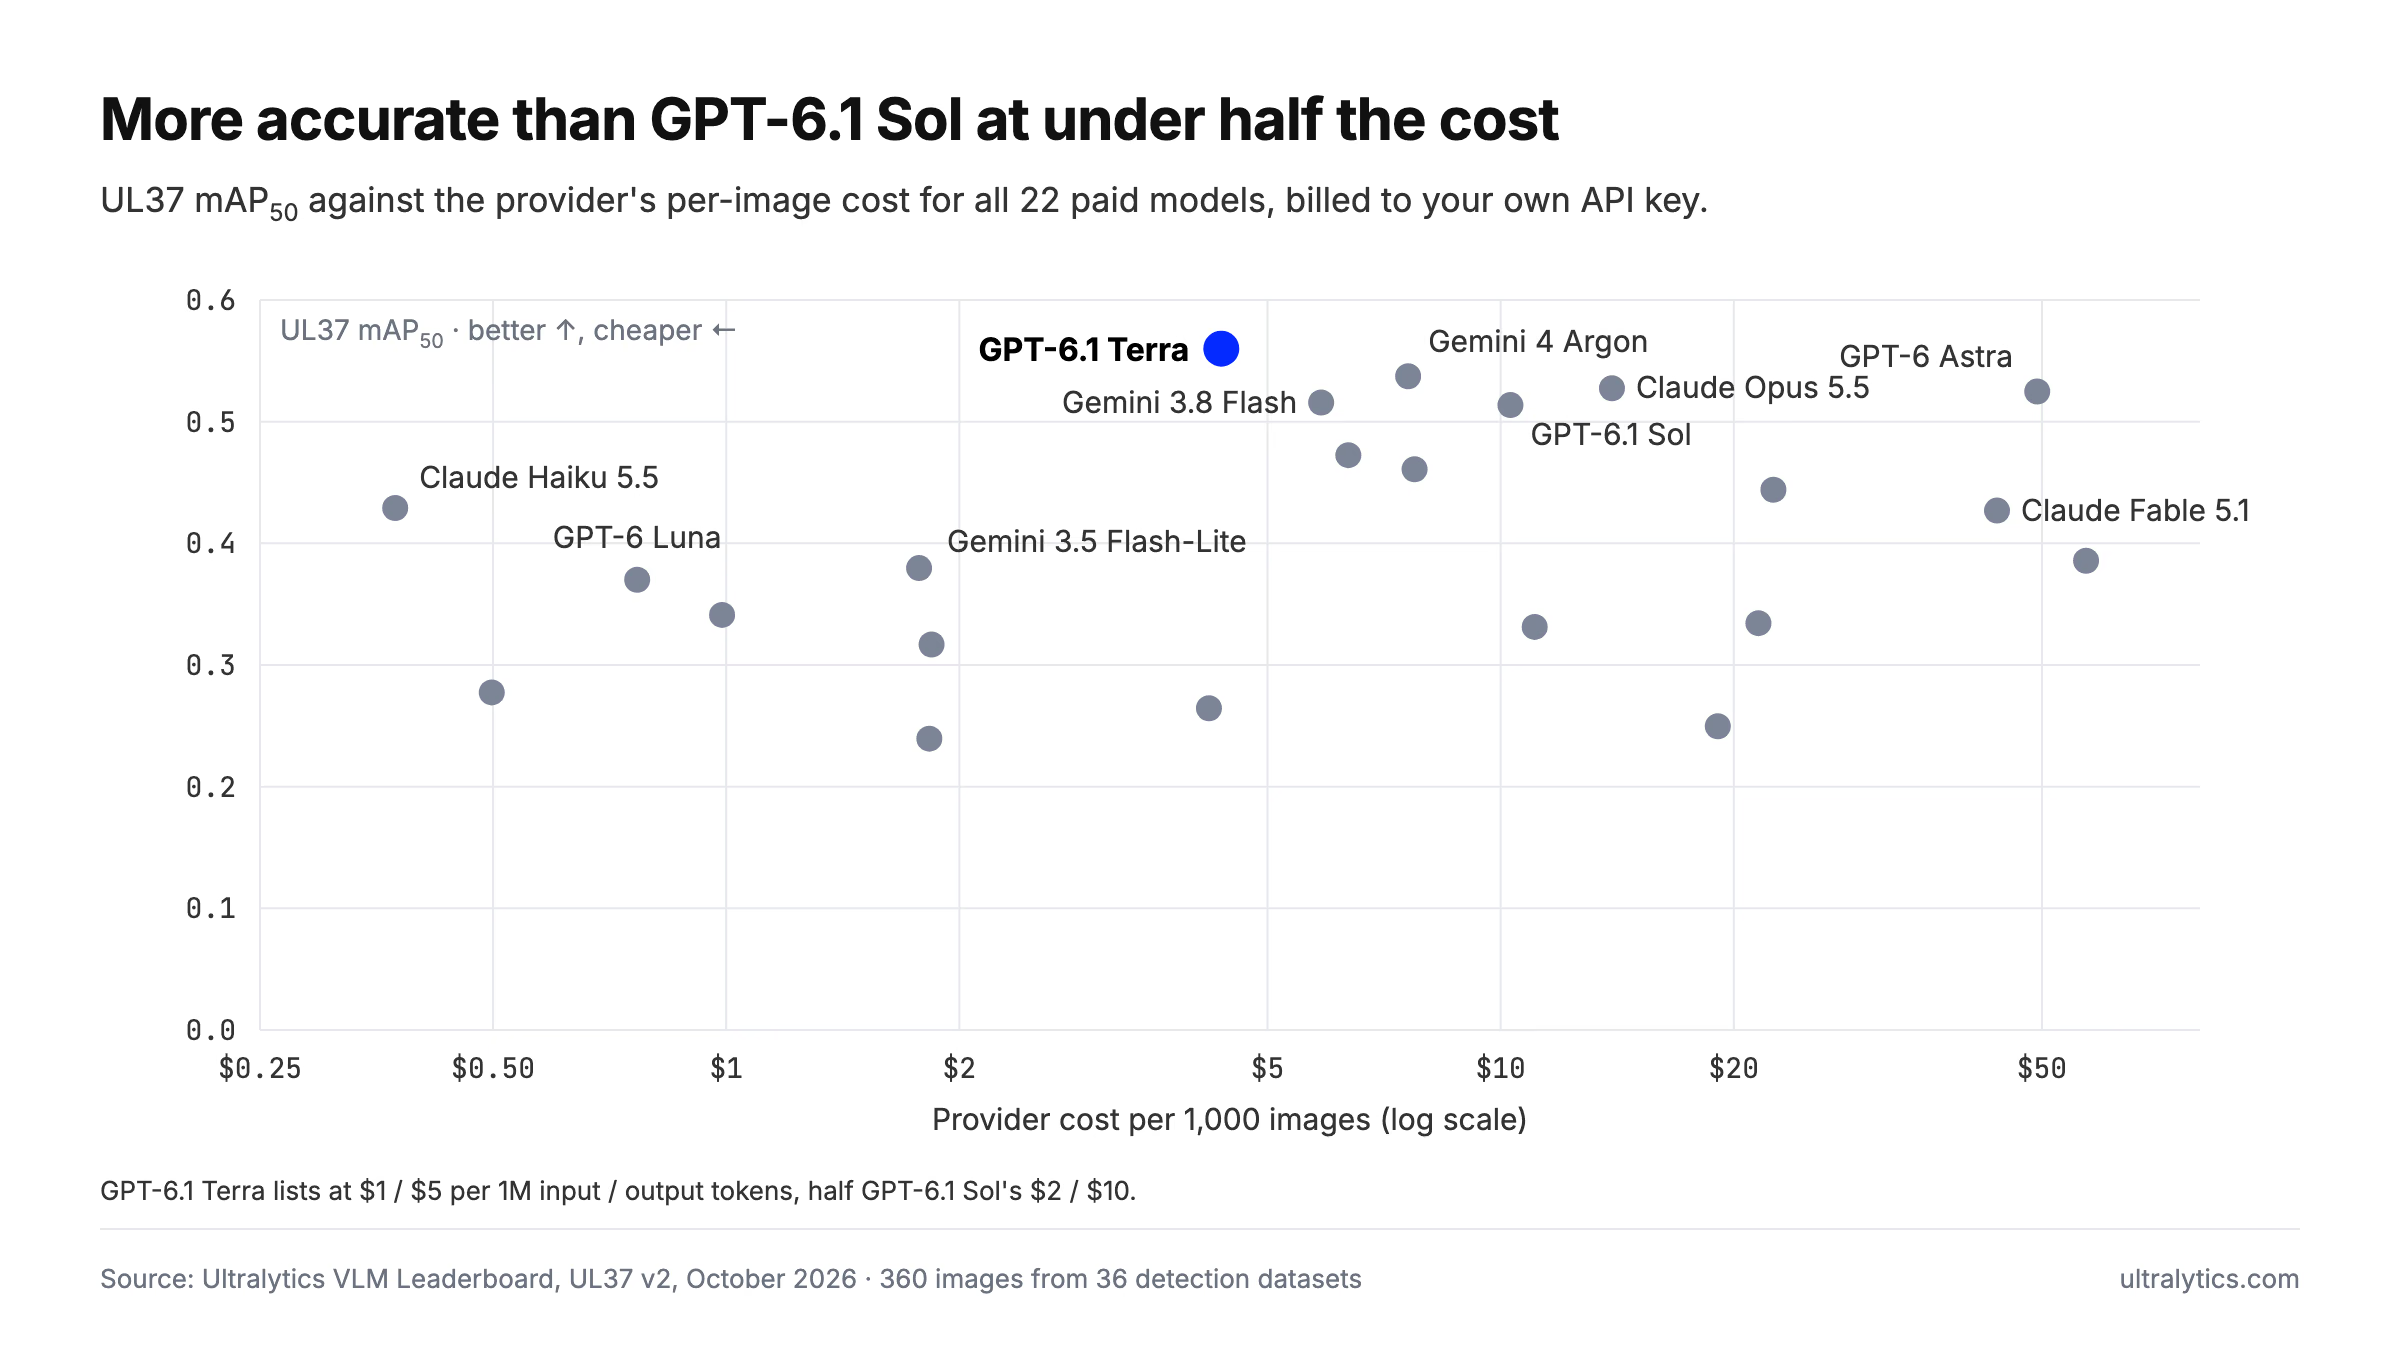
A anotação automática do GPT-6.1 Terra supera 39 modelos no nosso VLM Leaderboard: 0.560 mAP50 por US$ 4,36 a cada 1.000 imagens, à frente do GPT-6.1 Sol e do Gemini 4 Argon.
Os materiais de lançamento da OpenAI dizem que o GPT-6.1 Terra quase iguala seus irmãos maiores em raciocínio visual. Quando pedimos que desenhasse caixas delimitadoras, "quase" acabou sendo a palavra errada.
Executamos a anotação automática do GPT-6.1 Terra no UL37, nosso benchmark de detecção com 36 conjuntos de dados, em 26 de outubro de 2026, no dia em que a OpenAI o lançou. Ele obteve 0.560 mAP50, o melhor resultado entre os 39 modelos do nosso VLM Leaderboard. O modelo intermediário da OpenAI terminou à frente do GPT-6.1 Sol, do modelo principal GPT-6 Astra e do Gemini 4 Argon, que ocupava o primeiro lugar até esta semana.
Ele chegou lá por US$ 4,36 a cada 1.000 imagens, com 5,1 segundos por imagem e sem nenhuma solicitação com falha. Você já pode usá-lo na Ultralytics Platform. A seguir, mostramos onde ele se destaca, onde tropeça e como decidir se deve fazer parte do seu fluxo de trabalho de rotulagem.
GPT-6.1 Terra fica em primeiro lugar no UL37#
O UL37 mede o quanto as caixas de um modelo correspondem às anotações humanas em 360 imagens: 10 de cada um dos 36 conjuntos de dados reais de detecção de objetos, que abrangem exames médicos, imagens aéreas, prateleiras de lojas, esportes, documentos, placas de circuito e muito mais. Cada imagem passa pelo mesmo pipeline de produção usado pelos usuários da Platform, com os nomes de classe do próprio conjunto de dados e o SAM 3.1 ajustando cada caixa. A metodologia é pública.
Veja a pontuação do Terra:
- mAP50: 0.560, nº 1 de 39
- mAP50-95: 0.345, também nº 1, o que significa que as caixas se ajustam com precisão, não apenas de forma aproximada
- Precisão e revocação: 0.646 e 0.613
- Custo do provedor: US$ 4,36 a cada 1.000 imagens
- Tempo mediano por imagem: 5,1 s
- Solicitações com falha: nenhuma
Seis modelos pontuam acima de 0.51 no UL37, incluindo o Claude Opus 5.5, em terceiro lugar. Terra é o mais preciso dos seis e também o mais barato.
Não houve nenhum truque de ajuste por trás do resultado. O Terra usa o esforço de raciocínio padrão da OpenAI, que a documentação do modelo define como médio. Ele recebe a mesma solicitação que todos os outros modelos da OpenAI na Platform, com coordenadas das caixas em uma grade de 0–1000. Nós o conectamos, e ele foi direto para o topo.
Um modelo intermediário que supera os principais modelos da OpenAI#
A OpenAI posiciona o GPT-6.1 Terra como o modelo rápido e eficiente do meio da sua linha. Segundo a cobertura de lançamento do The Decoder e do BleepingComputer, ele sucede o GPT-5.6 Terra e é voltado ao uso de computadores, raciocínio visual, programação e tarefas cotidianas. Está disponível na API como gpt-6.1-terra e no ChatGPT Work e Codex para usuários Plus, Pro, Enterprise e Edu. A documentação da OpenAI o descreve como "um modelo rápido e eficiente para raciocínio visual, uso preciso de computadores e escrita clara e natural", com entrada de texto e imagem e uma janela de contexto de 1.050.000 tokens.
O preço é de US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de tokens de saída, com entrada em cache a US$ 0,05. Isso corresponde à metade dos US$ 2 e US$ 10 do GPT-6.1 Sol e a um décimo dos US$ 10 e US$ 50 do GPT-6 Astra, segundo as páginas da OpenAI sobre o GPT-6.1 Sol e o GPT-6 Astra.
Nos benchmarks de lançamento, a OpenAI apresenta o Terra como próximo dos seus modelos maiores, não como superior a eles. No MMMU-Pro, um teste de raciocínio visual, a OpenAI informa que o Terra quase iguala o Astra e o Sol. No Terminal-Bench 4.0, informa 50,3%, acima dos 21,5% do GPT-5.6 Terra. E ainda recomenda o Sol ou o Astra para as tarefas de programação mais difíceis.
No papel, Terra é a opção intermediária. No nosso benchmark, é o melhor detector da OpenAI.
| Modelo da OpenAI | UL37 mAP50 | Custo por 1.000 imagens | Tempo mediano por imagem |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5,1 s |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
O Terra custa menos da metade por imagem do que o GPT-6.1 Sol e menos de um décimo do GPT-6 Astra. Também responde cerca de duas vezes mais rápido que qualquer um dos dois. No confronto direto, supera o Sol em 22 dos 36 conjuntos de dados.
A OpenAI afirma que o Terra conclui tarefas mais de três vezes mais rápido que o Sol e o Astra, uma alegação referente a cargas de trabalho de agentes. A anotação é uma tarefa diferente e, nela, medimos uma vantagem de cerca de 2x sobre o Sol — o que ainda faz diferença quando você está rotulando milhares de imagens.
A vantagem do Terra sobre o Sol está na precisão#
Os dois modelos encontram uma proporção semelhante dos objetos anotados. A revocação do Terra é 0.613 e a do Sol é 0.618. A diferença aparece na precisão: 0.646 para o Terra contra 0.551 para o Sol. Uma proporção muito maior das caixas do Terra corresponde a um objeto real com o rótulo correto.
O SKU110K deixa essa diferença clara. Suas imagens mostram prateleiras de supermercado repletas de produtos, lado a lado, todos pertencentes a uma única classe. Os dois modelos alcançam uma revocação semelhante nesse conjunto: 0.73 para o Terra e 0.77 para o Sol. Mas a precisão do Sol nessas prateleiras é 0.49, enquanto a do Terra é 0.79. Cerca de metade das caixas do Sol são falsos positivos, contra aproximadamente uma em cada cinco para o Terra. O mAP50 de 0.62 do Terra no SKU110K é o mais alto já alcançado por qualquer modelo.
Isso importa para a rotulagem de dados, porque os erros não têm todos o mesmo custo. Deixar um produto passar significa desenhar uma caixa. Uma caixa falsa significa identificá-la entre dezenas de caixas corretas e apagá-la. Menos falsos positivos dão aos revisores uma primeira versão mais limpa.
Imagens médicas são o ponto forte mais notável do GPT-6.1 Terra#
O padrão mais distinto nos resultados do Terra está na área médica. O UL37 inclui oito conjuntos de dados médicos, e o Terra tem média de 0.505 mAP50 entre eles, ficando em 1º lugar entre 39 modelos. Os seguintes são Gemini 3.8 Flash, com 0.387, e Gemini 4 Argon, com 0.379. Nenhum modelo do leaderboard lidera outro domínio por uma margem maior.
Veja como ele pontua nos oito conjuntos, em comparação com o melhor dos outros 38 modelos em cada um:
| Conjunto de dados | GPT-6.1 Terra | Melhor outro modelo |
|---|---|---|
| Ultrassom da tireoide (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| Ressonância magnética de tumor cerebral (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Microscopia de células sanguíneas (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Endoscopia de pólipos do cólon (Kvasir-SEG) | 0.71 | Empate entre sete modelos, incluindo o Gemini 4 Argon, 0.81 |
| Radiografia pediátrica do punho (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Radiografia do tórax, tuberculose (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Lesões da retina (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Radiografia dentária (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Os três primeiros resultados sustentam o desempenho, e nenhum deles se resume a encontrar o local certo. No TN5000, cada caixa também recebe o rótulo de nódulo benigno ou maligno do conjunto de dados, exatamente o tipo de avaliação que um profissional clínico precisa confirmar. O Gemini 4 Argon pontua 0.29 nesse conjunto e o GPT-6.1 Sol, 0.53. As classes da ressonância magnética cerebral são meningioma, glioma e tumor hipofisário; o Sol pontua 0.52. O conjunto de células sanguíneas pede que o Terra classifique glóbulos brancos, glóbulos vermelhos e plaquetas.
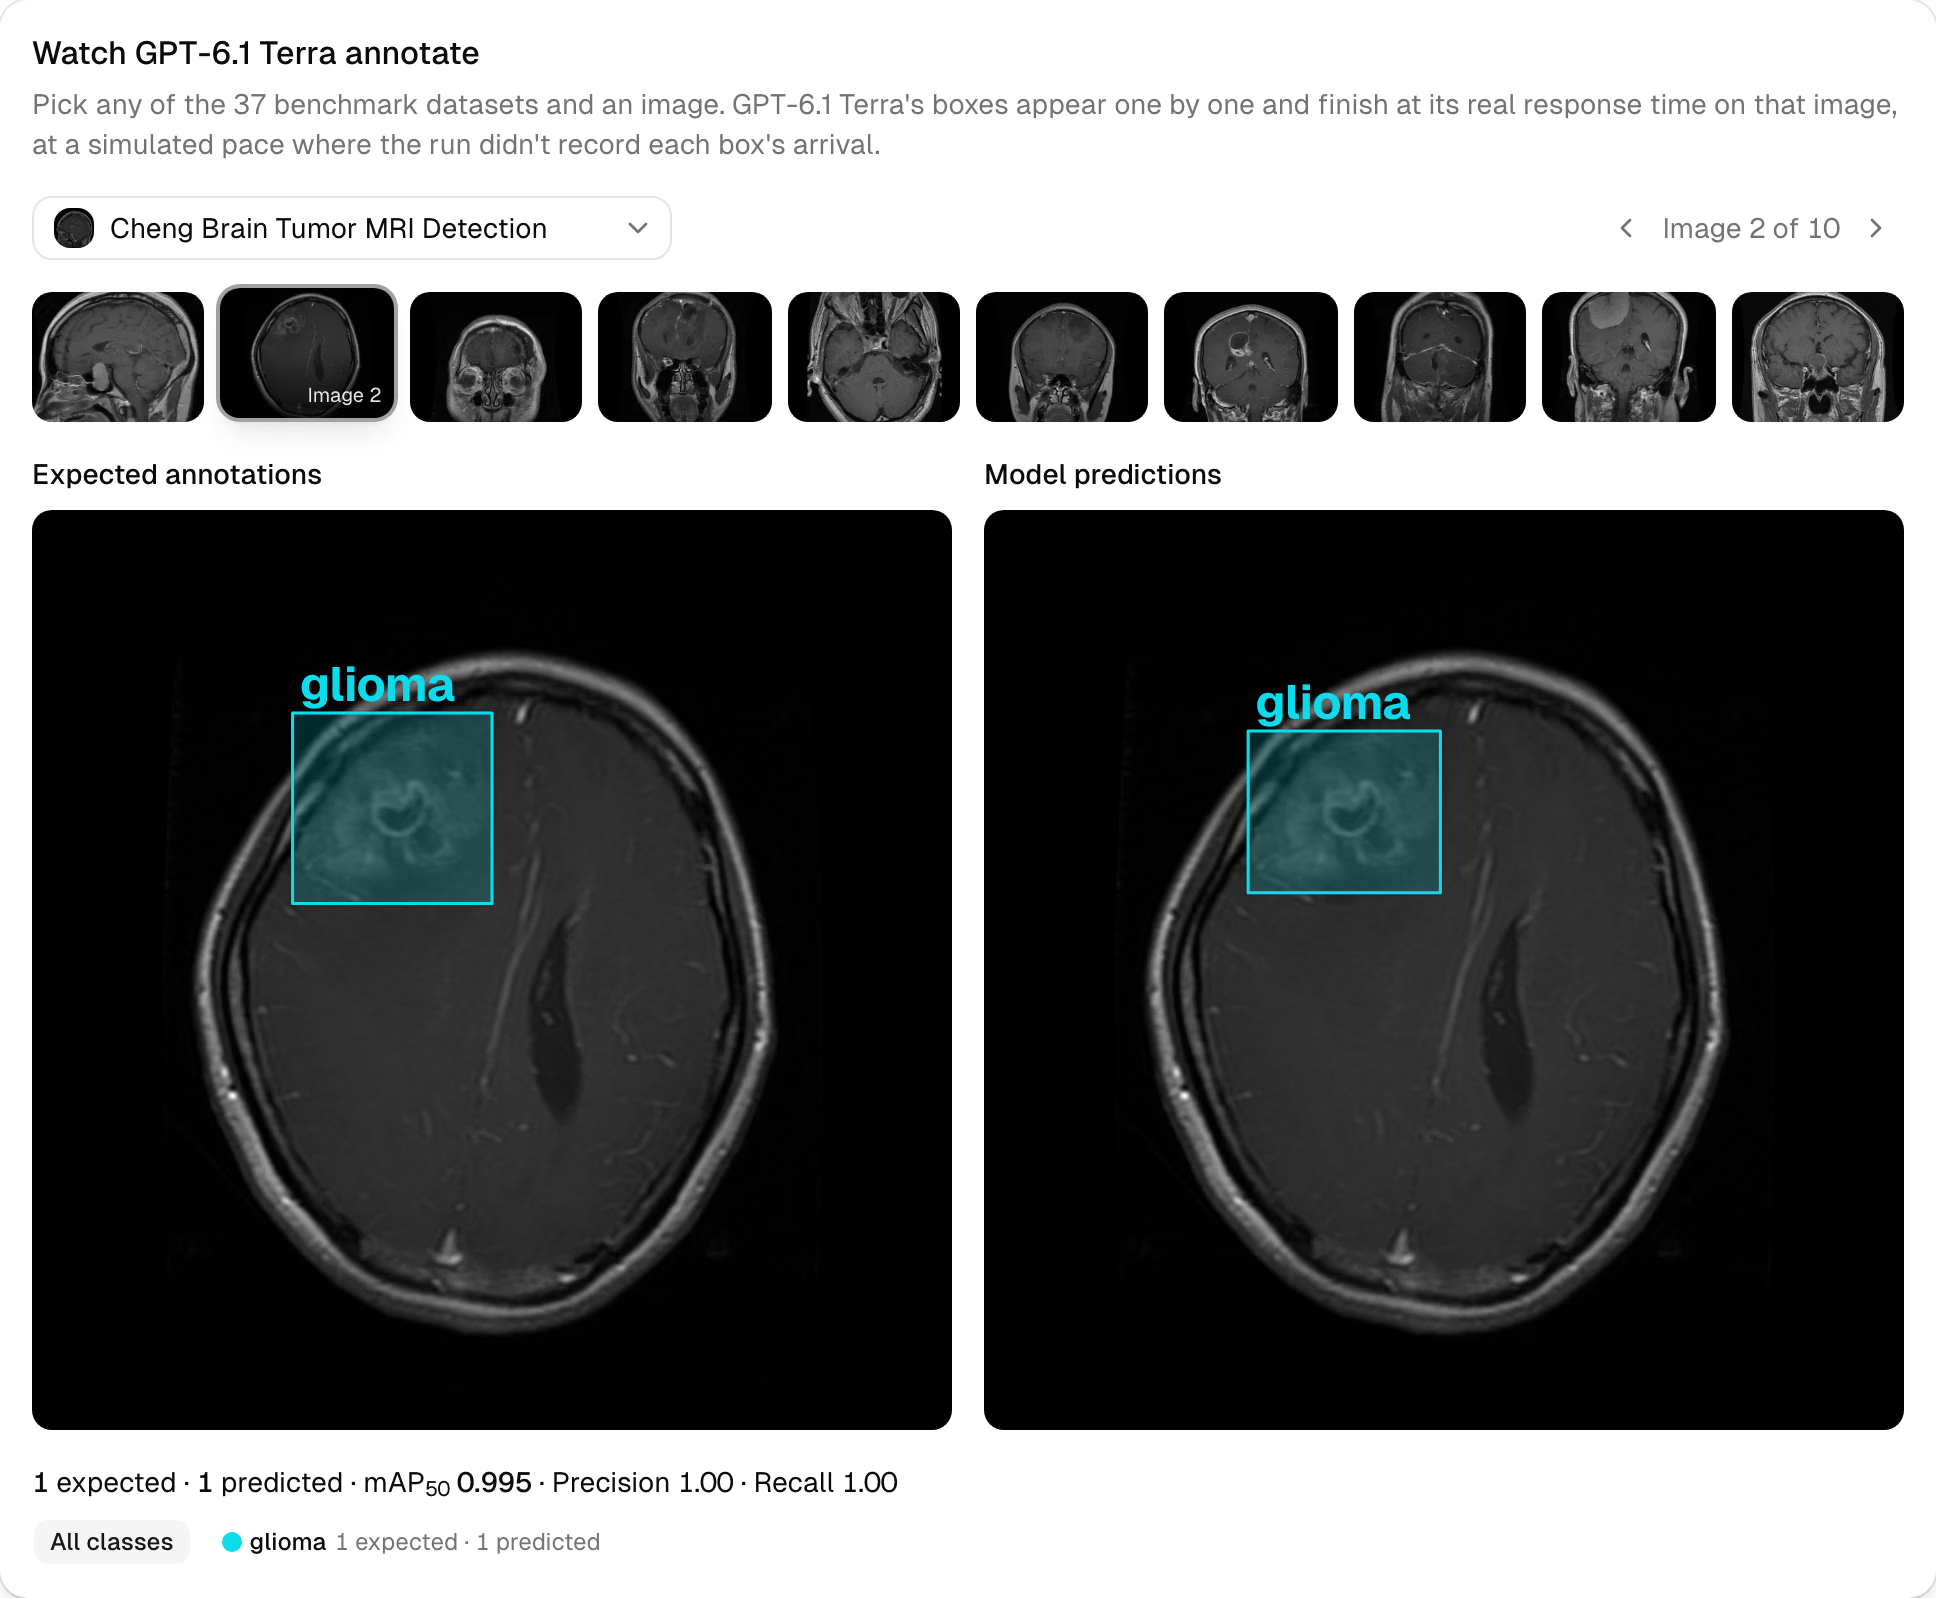
A reprodução acima, na página do modelo Terra, mostra um acerto típico: um glioma em uma ressonância magnética cerebral e uma caixa do Terra posicionada e rotulada para corresponder à anotação esperada.
Há duas ressalvas a considerar junto com esses números. Primeiro, cada conjunto de dados contribui com 10 imagens, então a pontuação de um único conjunto é um sinal para investigar, não um veredito. Segundo, nada disso é diagnóstico. Para uma equipe de análise de imagens médicas, o Terra é uma forma rápida de criar rascunhos de caixas em imagens de ultrassom, ressonância magnética e microscopia, que especialistas clínicos depois verificam, corrigem e aprovam. Essa revisão com participação humana é a essência do fluxo de trabalho, não um extra opcional.
Onde o GPT-6.1 Terra fica aquém: radiografias e placas de circuito#
A parte inferior dessa tabela revela um padrão claro. Em todos os conjuntos de radiografias do UL37, médicos ou não, outro modelo tem desempenho melhor. O Terra fica atrás do líder em radiografias pediátricas do punho, do tórax e dentárias; em radiografias de segurança, o resultado é ainda pior: 0.00 no IEDXray, enquanto o Gemini 4 Argon chega a 0.30.
O IEDXray é a falha mais marcante. Suas imagens mostram laptops, celulares, pagers, baterias e dispositivos improvisados, e o Terra não produziu nenhuma caixa correta em nenhuma delas.
As placas de circuito são outro ponto cego. O Terra tem média de 0.13 nos nossos conjuntos de dados de PCBs industriais, enquanto o GPT-6.1 Sol chega a 0.39. No DeepPCB, que abrange defeitos em placas nuas, como circuitos abertos, curtos-circuitos, mordidas de rato e saliências, o Terra pontua 0.03, contra 0.39 do Sol. Para dados de inspeção de PCBs, o Sol é a melhor opção da OpenAI.
Antes de rotular um conjunto de dados grande em qualquer um desses domínios, abra a página do modelo GPT-6.1 Terra. Ela reproduz as caixas registradas pelo Terra nos 36 conjuntos de dados do benchmark e no COCO, ao lado das caixas esperadas, e informa a pontuação em cada um.
GPT-6.1 Terra vs. Gemini 4 Argon: uma disputa mais acirrada do que o ranking indica#
O Gemini 4 Argon liderava o leaderboard até a chegada do Terra, e os dois estão próximos. O Terra pontua mais alto em 19 conjuntos de dados, o Argon em 16, e há um empate.
Boa parte da vantagem de 0.023 do Terra vem de um único conjunto de dados. No ultrassom da tireoide TN5000, o Terra pontua 0.94 e o Argon, 0.29. Se excluirmos esse conjunto, as médias são 0.549 para o Terra e 0.544 para o Argon, praticamente empatadas. O primeiro lugar do Terra é legítimo e se deve, em grande parte, às imagens médicas.
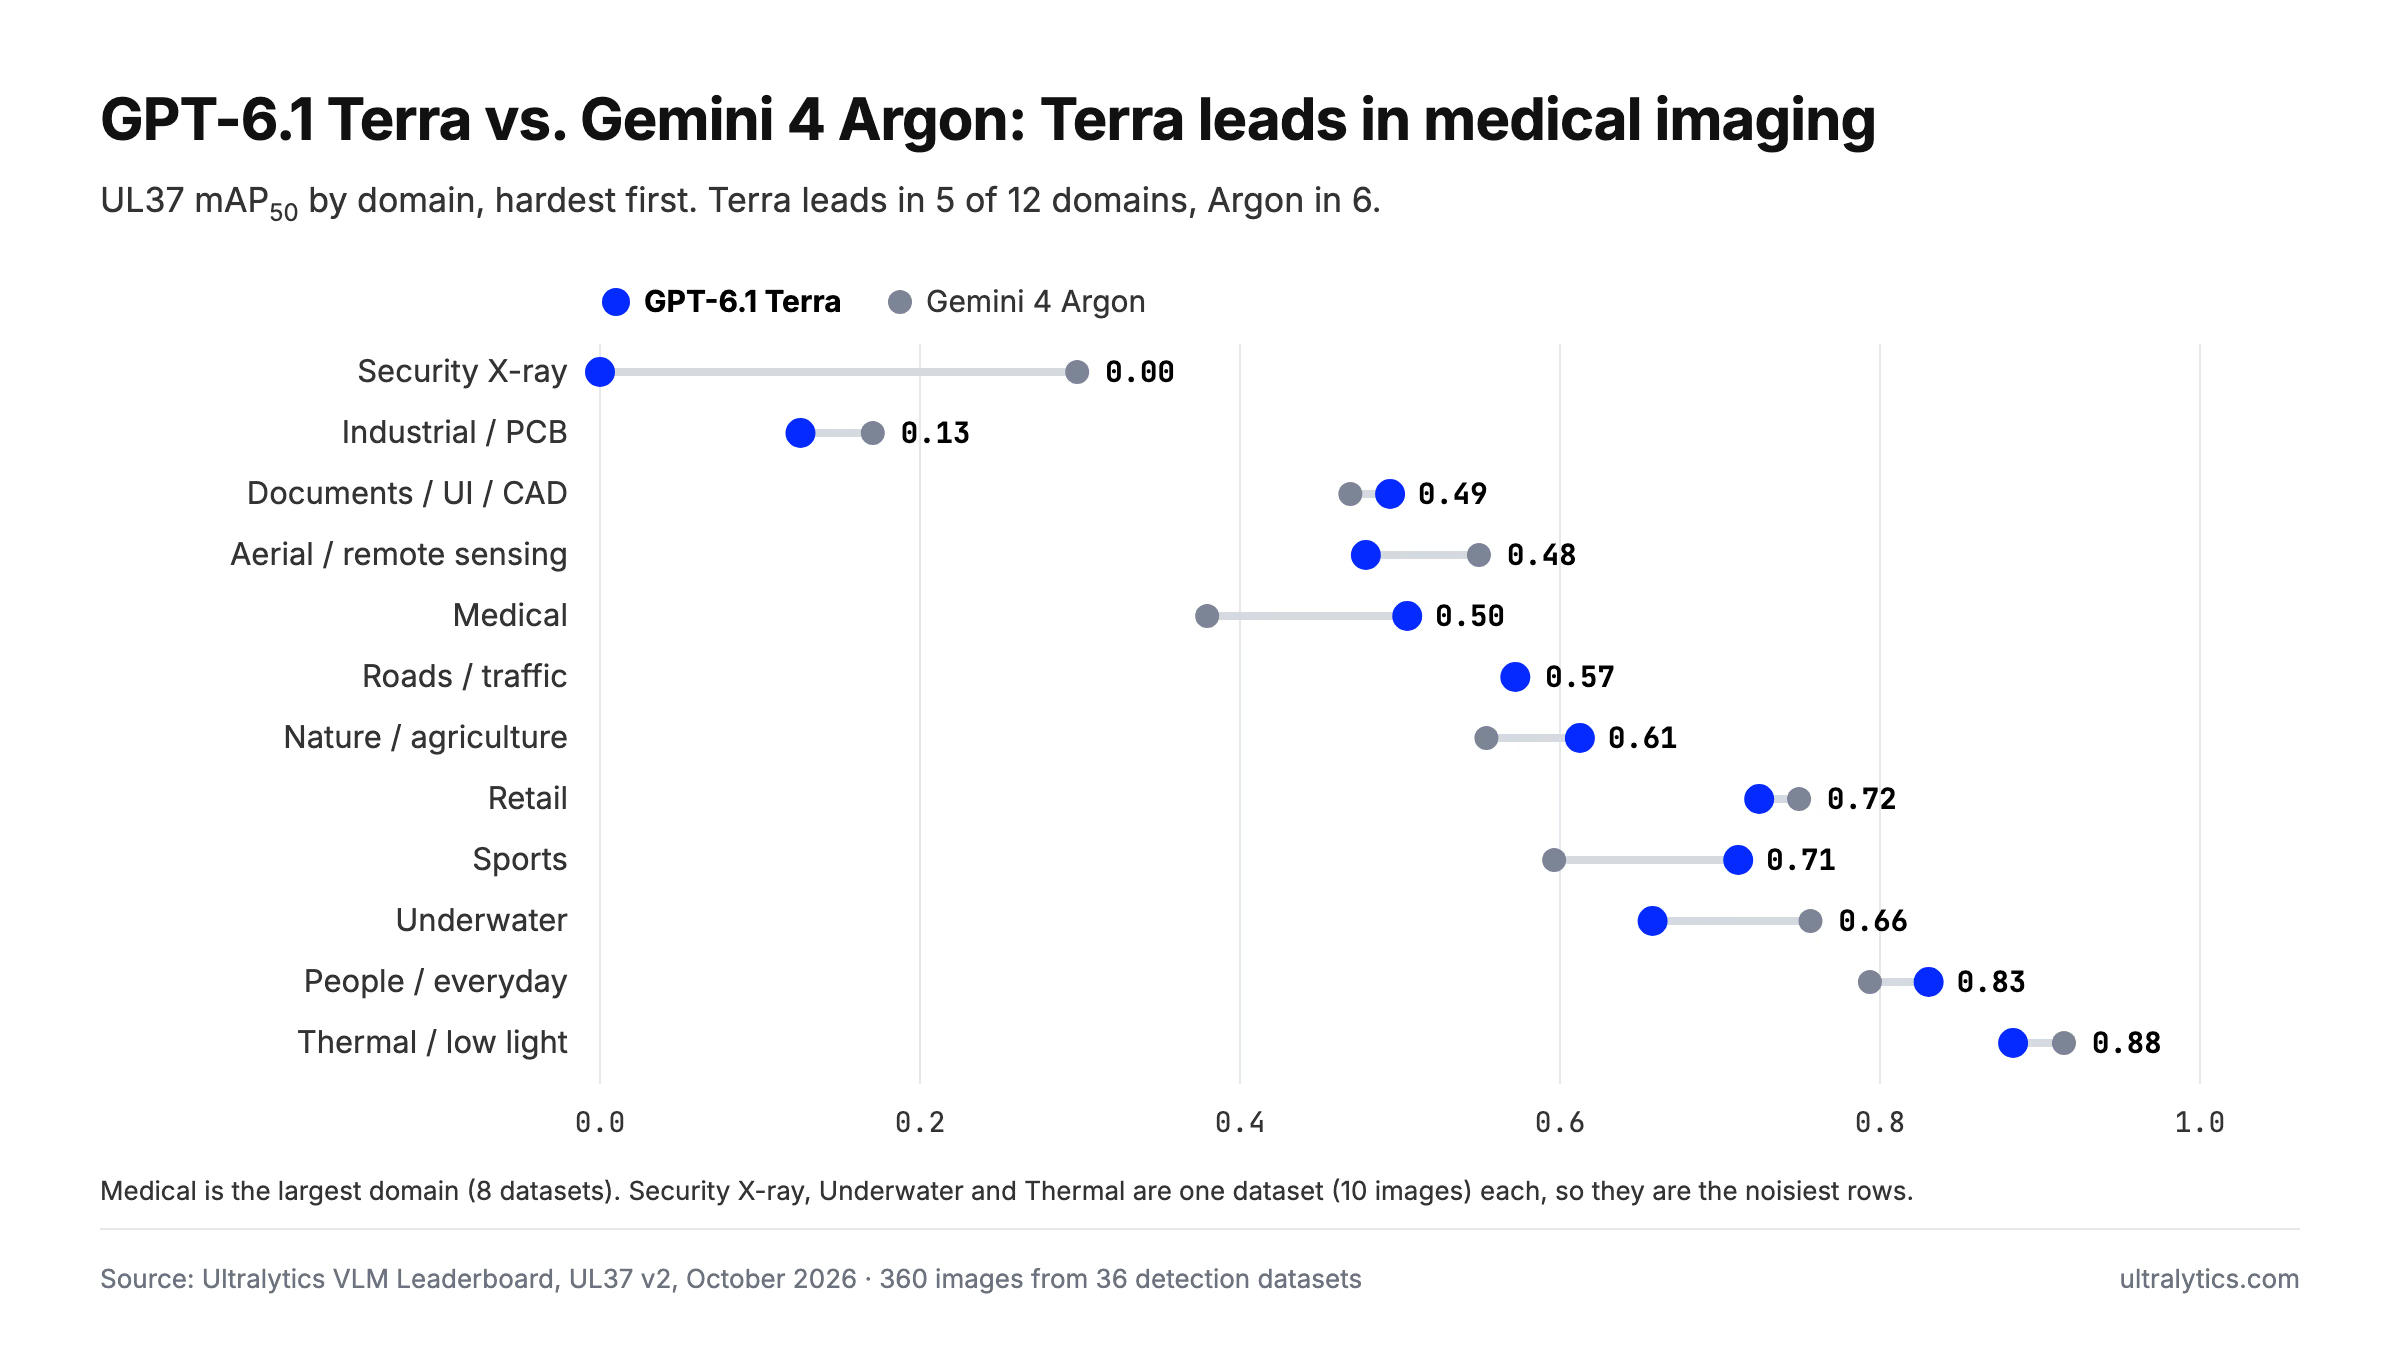
Por domínio, o Terra lidera em cinco e ocupa o primeiro lugar entre os 39 modelos em dois deles: medicina; e documentos, interface de usuário e CAD. O Argon lidera em seis e continua à frente nas categorias aérea, subaquática e térmica. Em estradas e trânsito, há empate.
Os dois também cometem tipos diferentes de erros. O Argon é um pouco mais preciso, 0.667 contra 0.646, enquanto o Terra encontra mais objetos, com revocação de 0.613 contra 0.585. O Terra custa US$ 4,36 a cada 1.000 imagens, contra US$ 7,60 do Argon nos preços de lançamento do Google. O Argon é um pouco mais rápido, com 4,6 s por imagem.
A divisão prática: escolha o Terra para imagens médicas, documentos e esportes. Escolha o Argon para imagens aéreas, subaquáticas, térmicas e de segurança. Nossos resultados de anotação automática do Gemini 4 Argon detalham o desempenho do Argon.
Quanto custa um lote processado pelo GPT-6.1 Terra#
Os US$ 4,36 a cada 1.000 imagens correspondem à cobrança do provedor, calculada com base no uso de tokens informado pela OpenAI e no preço de tabela. Uma imagem mediana usou cerca de 1.300 tokens de entrada e 370 tokens de saída. A Anotação em lote acrescenta uma taxa de processamento da Platform de US$ 1,00 a cada 1.000 imagens, então um lote de 1.000 imagens custa cerca de US$ 5,36 no total.
Mais três detalhes da execução:
- Nenhuma solicitação com falha. Todas as solicitações do benchmark do Terra foram concluídas dentro do limite de 115 segundos da Platform. O GPT-6.1 Sol falhou em 2 imagens e o GPT-6 Astra, em 4.
- As caixas brutas já são boas. Antes do refinamento com SAM 3.1, as caixas do Terra pontuam 0.559 mAP50. O refinamento eleva o resultado a 0.560, então o próprio modelo faz quase todo o trabalho.
- Nenhuma configuração necessária. Bastaram o esforço de raciocínio padrão e a solicitação padrão da OpenAI.
Se o orçamento importa mais do que os últimos pontos de precisão, há opções mais baratas. O Claude Haiku 5.5 pontua 0.429 por US$ 0,37 a cada 1.000 imagens, e o Gemini 3.5 Flash-Lite pontua 0.380 por US$ 1,77. Modelos hospedados como Qwen3.8 27B, Gemma 4 26B e SAM 3.1 Text não precisam de chave de API, assim como seus próprios modelos Ultralytics YOLO.
Da chave da OpenAI ao conjunto de dados rotulado#
O GPT-6.1 Terra é um modelo orientado por classes para conjuntos de dados de detecção com 1 a 200 classes. Ele retorna caixas delimitadoras com os nomes de classe do seu próprio conjunto de dados, e você as revisa antes de salvar. Para configurá-lo:
- Crie uma chave na página de chaves da API da OpenAI.
- Adicione-a em Settings > API Keys no espaço de trabalho da Platform que contém seu conjunto de dados. A OpenAI cobra diretamente de você, e a Ultralytics não aplica nenhuma margem sobre os tokens. A documentação sobre chaves de provedores explica os detalhes.
- No editor de anotações, mude para o modo Smart e selecione GPT-6.1 Terra em OpenAI, no seletor de modelos.
- Pressione Predict ou
Ppara rotular a imagem atual. Teste em algumas imagens representativas dos seus dados antes de ampliar a operação. - Quando estiver satisfeito com o resultado, acesse a página do conjunto de dados e escolha More actions > Batch Annotation para rotular todas as imagens sem rótulo de uma só vez. A Platform salva primeiro uma versão do conjunto de dados, para que você possa reverter as alterações.
- Revise as caixas, salve-as e treine um modelo Ultralytics YOLO26 com o resultado no mesmo espaço de trabalho. A documentação de treinamento explica o processo.
Para saber melhor como esses modelos se integram ao editor, veja como a Ultralytics Platform usa IA para automatizar a anotação e nosso guia introdutório sobre modelos de linguagem visual.
Quem deve migrar para o GPT-6.1 Terra#
Use o GPT-6.1 Terra como seu modelo pago padrão para rotulagem geral de detecção de objetos. É o modelo mais preciso que avaliamos, o mais barato entre os seis primeiros e não teve nenhuma solicitação com falha na nossa execução.
Ele é especialmente eficaz para criar rascunhos de anotações de imagens de ultrassom, ressonância magnética e microscopia que serão revisados por especialistas, além de prateleiras de lojas densamente abastecidas, onde caixas falsas se acumulam rapidamente. Para radiografias de qualquer tipo e defeitos em PCBs, escolha outro modelo: Gemini 4 Argon, GPT-6 Astra ou GPT-6.1 Sol têm resultados melhores.
Se você paga atualmente pelo Sol ou pelo Astra apenas para rotular imagens, a mudança é simples: o Terra oferece caixas melhores por menos da metade do custo do Sol.
Perguntas frequentes
Sim. No nosso benchmark UL37, o GPT-6.1 Terra alcança 0.560 mAP50 na média de 36 conjuntos de dados reais de detecção, a maior pontuação entre os 39 modelos do Ultralytics VLM Leaderboard. Também ocupa o primeiro lugar na métrica mais rigorosa mAP50-95, com 0.345. Seus pontos mais fracos são imagens de radiografias e defeitos em placas de circuito.
No nosso benchmark, sim. O Terra pontua 0.560 mAP50, contra 0.514 do Sol, vence em 22 dos 36 conjuntos de dados e custa US$ 4,36 a cada 1.000 imagens, contra US$ 10,30, além de ser cerca de duas vezes mais rápido. O Sol continua sendo a melhor opção da OpenAI para detectar defeitos em PCBs.
O Terra lidera por 0.560 a 0.537 mAP50 e custa menos por imagem, mas a disputa é acirrada: o Terra vence em 19 conjuntos de dados, o Argon em 16, e há um empate. Sem o conjunto de dados de ultrassom da tireoide TN5000, os dois ficam praticamente empatados. Escolha o Terra para imagens médicas e documentos, e o Argon para imagens aéreas, subaquáticas, térmicas e radiografias de segurança.
Cerca de US$ 4,36 em cobranças da OpenAI, com base no uso de tokens informado pelo provedor e nos preços de tabela de US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de tokens de saída. A anotação em lote na Ultralytics Platform adiciona uma taxa de processamento de US$ 1,00 por 1.000 imagens. Você paga diretamente à OpenAI usando sua própria chave de API.
É o modelo mais forte nos nossos oito conjuntos de dados médicos, com média de 0,505 mAP50 e as melhores pontuações em ultrassom da tireoide, ressonância magnética de tumores cerebrais e microscopia de células sanguíneas. É muito mais fraco em radiografias e tem resultados inferiores em endoscopias de pólipos do cólon. Use-o para criar caixas delimitadoras que serão revisadas por especialistas, nunca como ferramenta de diagnóstico.
Não. A plataforma o chama usando o nível médio de esforço de raciocínio padrão da OpenAI, com a mesma solicitação de caixa delimitadora que usa para todos os modelos da OpenAI, e o SAM 3.1 refina cada caixa delimitadora em seguida. A solicitação mediana no nosso benchmark levou 5,1 segundos, e nenhuma falhou.









