Jetson Orin Nano Super vs Raspberry Pi 5 para deteção de objetos com YOLO26
Inferência do YOLO26n: 4.57 ms num Jetson Orin Nano Super (TensorRT FP16) contra 67.03 ms numa CPU do Pi 5, em testes separados. Escolhe com base no modelo, nos FPS e nas câmaras.
 Onuralp Sezer18 min de leitura
Deves executar a deteção de objetos num Raspberry Pi 5 ou num NVIDIA Jetson Orin Nano? Para uma câmara, um objetivo de baixa taxa de fotogramas e um modelo pequeno, a CPU de um Pi 5 pode ser suficiente: no nosso benchmark publicado, o Ultralytics YOLO26n exportado para NCNN demora 67.03 ms de inferência por imagem nos seus quatro núcleos Arm, cerca de 15 fotogramas de inferência por segundo. Quando precisas de mais câmaras, de um modelo maior ou de mais margem na taxa de fotogramas do que o teu Pi oferece, um Jetson justifica-se: num Jetson Orin Nano Super Developer Kit, o mesmo modelo demora 4.57 ms como motor TensorRT FP16.
A Ultralytics publica esta comparação e desenvolve o YOLO26, que funciona em ambas as placas; não fabricamos nenhuma delas. Os nossos números do Jetson vêm do Orin Nano Super Developer Kit, o kit de desenvolvimento Orin de entrada da NVIDIA, e os números do Pi vêm de um Raspberry Pi 5, em testes separados. Muitas pessoas ainda pesquisam «Jetson Nano», a placa original de 2019. Executa YOLO26 através do JetPack 4, mas o nosso guia do Jetson não inclui benchmarks de YOLO26 para esse modelo, por isso aparece aqui apenas nas especificações.
A seguir: como as placas se comparam por tamanho do modelo, objetivo de taxa de fotogramas e número de transmissões de câmara, porque os FPS diminuem quando adicionas câmaras, como medir tu mesmo ambas as placas e qual delas se adequa ao teu projeto. Os passos de configuração estão no guia NVIDIA Jetson e no guia Raspberry Pi, e o nosso tutorial sobre deteção de objetos numa CPU Raspberry Pi 5 aborda em profundidade o lado do Pi.
O Pi 5 executa YOLO na CPU; o Orin Nano Super inclui uma GPU#
As placas resolvem o mesmo problema com silício diferente. O Raspberry Pi 5 é um computador de uso geral com quatro núcleos Arm Cortex-A76 e sem acelerador de IA dedicado, por isso os nossos benchmarks do Pi executam YOLO na CPU. O Jetson Orin Nano Super Developer Kit combina um módulo Orin Nano, baseado numa GPU Ampere, com uma placa portadora, e o runtime TensorRT da NVIDIA compila modelos para essa GPU. É uma plataforma de IA de ponta concebida para este tipo de carga de trabalho.
| Jetson Nano 4GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Computação para YOLO | GPU Maxwell com 128 núcleos | GPU Ampere com 1024 núcleos, 32 Tensor Cores | CPU Arm Cortex-A76 com 4 núcleos |
| CPU | Cortex-A57 com 4 núcleos, 1.43 GHz | Cortex-A78AE com 6 núcleos, até 1.7 GHz | Cortex-A76 com 4 núcleos, até 2.4 GHz |
| Memória | 4 GB LPDDR4, 25.6 GB/s | 8 GB LPDDR5, 102 GB/s | Varia consoante o modelo |
| Desempenho de IA (valor máximo indicado pela NVIDIA) | 472 GFLOPS | 67 TOPS INT8 dispersos | — |
| JetPack / SO | Apenas JetPack 4 | JetPack 5 a 7 | Raspberry Pi OS |
| Caminho de implementação da Ultralytics | TensorRT, incluindo DeepStream | TensorRT (o mais rápido no nosso benchmark) | NCNN (o mais rápido no nosso benchmark) |
Especificações, não medições, verificadas a 19 de novembro de 2026. Os valores máximos da NVIDIA usam formatos numéricos diferentes, por isso não são diretamente comparáveis. Os 67 TOPS do Orin Nano Super são um valor INT8 disperso; a NVIDIA indica 33 TOPS em modo denso. As linhas do Jetson baseiam-se nas tabelas de comparação e JetPack do guia NVIDIA Jetson e no guia DeepStream; as linhas do Pi 5 baseiam-se na documentação do Raspberry Pi.
O consumo de energia também faz parte da escolha. A NVIDIA indica 7 W a 25 W para o Orin Nano Super Developer Kit. Quando a placa é preparada com uma configuração com Super ativado, o Orin Nano 8GB oferece modos de energia de 15 W, 25 W e MAXN SUPER; com a configuração predefinida, mantém os modos originais de 7 W e 15 W. Seja qual for a placa que escolheres, mede o consumo de todo o sistema com as câmaras ligadas, porque é esse o consumo que a fonte de alimentação e a caixa têm de suportar.
Calcula o custo de todo o sistema, não apenas da placa: o armazenamento, a alimentação, a refrigeração e as câmaras somam-se em ambos os casos. A Raspberry Pi aumentou mais do que uma vez os preços do Pi 5 em 2026, à medida que os custos da memória subiram. Em novembro de 2026, o Pi 5 de 2GB custa $77.50 e a placa de 16GB custa $385. Para consultar os preços e a disponibilidade atuais do Jetson, verifica a página de kits de desenvolvimento da NVIDIA e adiciona o custo de qualquer acelerador de que o Pi precise, como o Raspberry Pi AI HAT+. Para produção, a NVIDIA vende módulos Jetson para a tua própria placa portadora; o kit de desenvolvimento que comparámos destina-se ao desenvolvimento e à prototipagem.
A CPU do Pi 5 é adequada para cargas de trabalho YOLO26n com FPS baixos#
O Pi 5 consegue fazer deteção com uma câmara sem hardware adicional quando a taxa de fotogramas necessária é moderada. No benchmark da Ultralytics (exportação FP32, entrada de 640 píxeis, COCO128, Ultralytics 8.4.108, apenas tempo de inferência), NCNN foi o formato de exportação mais rápido: 67.03 ms por imagem para YOLO26n, com 0.4784 mAP50-95. São cerca de 15 FPS de inferência, o que pode ser adequado para um posto de contagem, uma câmara de prateleira ou um protótipo de robótica que não precise de acompanhar movimentos rápidos. Valida todo o pipeline da câmara, não apenas a inferência. A Arm também publica um runtime de código aberto para YOLO26n no Pi 5 que, segundo as suas medições, é mais rápido do que NCNN no seu próprio teste; o nosso tutorial do Raspberry Pi 5 compara os dois.
O tamanho do modelo é o ponto fraco do Pi. O YOLO26s, maior, demora 172.88 ms com NCNN no Pi 5, menos de 6 FPS de inferência. A comparação multiformato do guia Raspberry Pi (Ultralytics 8.4.108) abrange apenas os modelos n e s. A comparação ONNX mais antiga (Ultralytics 8.4.14) também apresenta m, l e x; nesse teste, YOLO26m demora 993.78 ms. Se objetos pequenos ou classes difíceis de distinguir te levarem a optar por um modelo maior ou por uma resolução de entrada mais alta, testa esse modelo na placa antes de te comprometeres.
Adicionar um AI HAT+ ao Pi 5#
Há uma terceira configuração a considerar: um Pi 5 com o AI HAT+ da Raspberry Pi, que acrescenta um acelerador Hailo numa versão de 13 TOPS ou de 26 TOPS. No benchmark de integração Hailo da Ultralytics (Ultralytics 8.4.174, COCO128), YOLO26n exportado para a versão Hailo-8 de 26 TOPS demora 21.7 ms por imagem, com 0.455 mAP50-95, contra 364.6 ms para o modelo PyTorch não exportado no mesmo Pi. Esse teste não indica o tamanho da entrada e utiliza INT8, por isso considera-o um benchmark independente e não uma linha da comparação abaixo. Os modelos Hailo precisam de uma etapa de compilação, por isso verifica a precisão nas tuas próprias imagens após a exportação.
No Orin Nano Super, YOLO26n a YOLO26l demoram menos de 18 ms#
Num Jetson, os modelos maiores tornam-se práticos. Os benchmarks da Ultralytics no Orin Nano Super Developer Kit (entrada de 640 píxeis, COCO128, Ultralytics 8.4.33, apenas inferência) mostram que todos os tamanhos de n a l demoram menos de 18 ms de inferência por imagem como motor TensorRT FP16:
| Modelo YOLO26 | CPU do Raspberry Pi 5 (ms/imagem) | Orin Nano Super, TensorRT FP16 (ms/imagem) | Orin Nano Super mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67.03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78 (teste ONNX antigo, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46 (teste ONNX antigo, 8.4.14) | 17.42 | 0.6225 |
Resultados publicados de testes separados. Orin Nano Super: Ultralytics 8.4.33. Todas as linhas usam entrada de 640 píxeis e indicam apenas o tempo de inferência, sem pré-processamento nem pós-processamento.
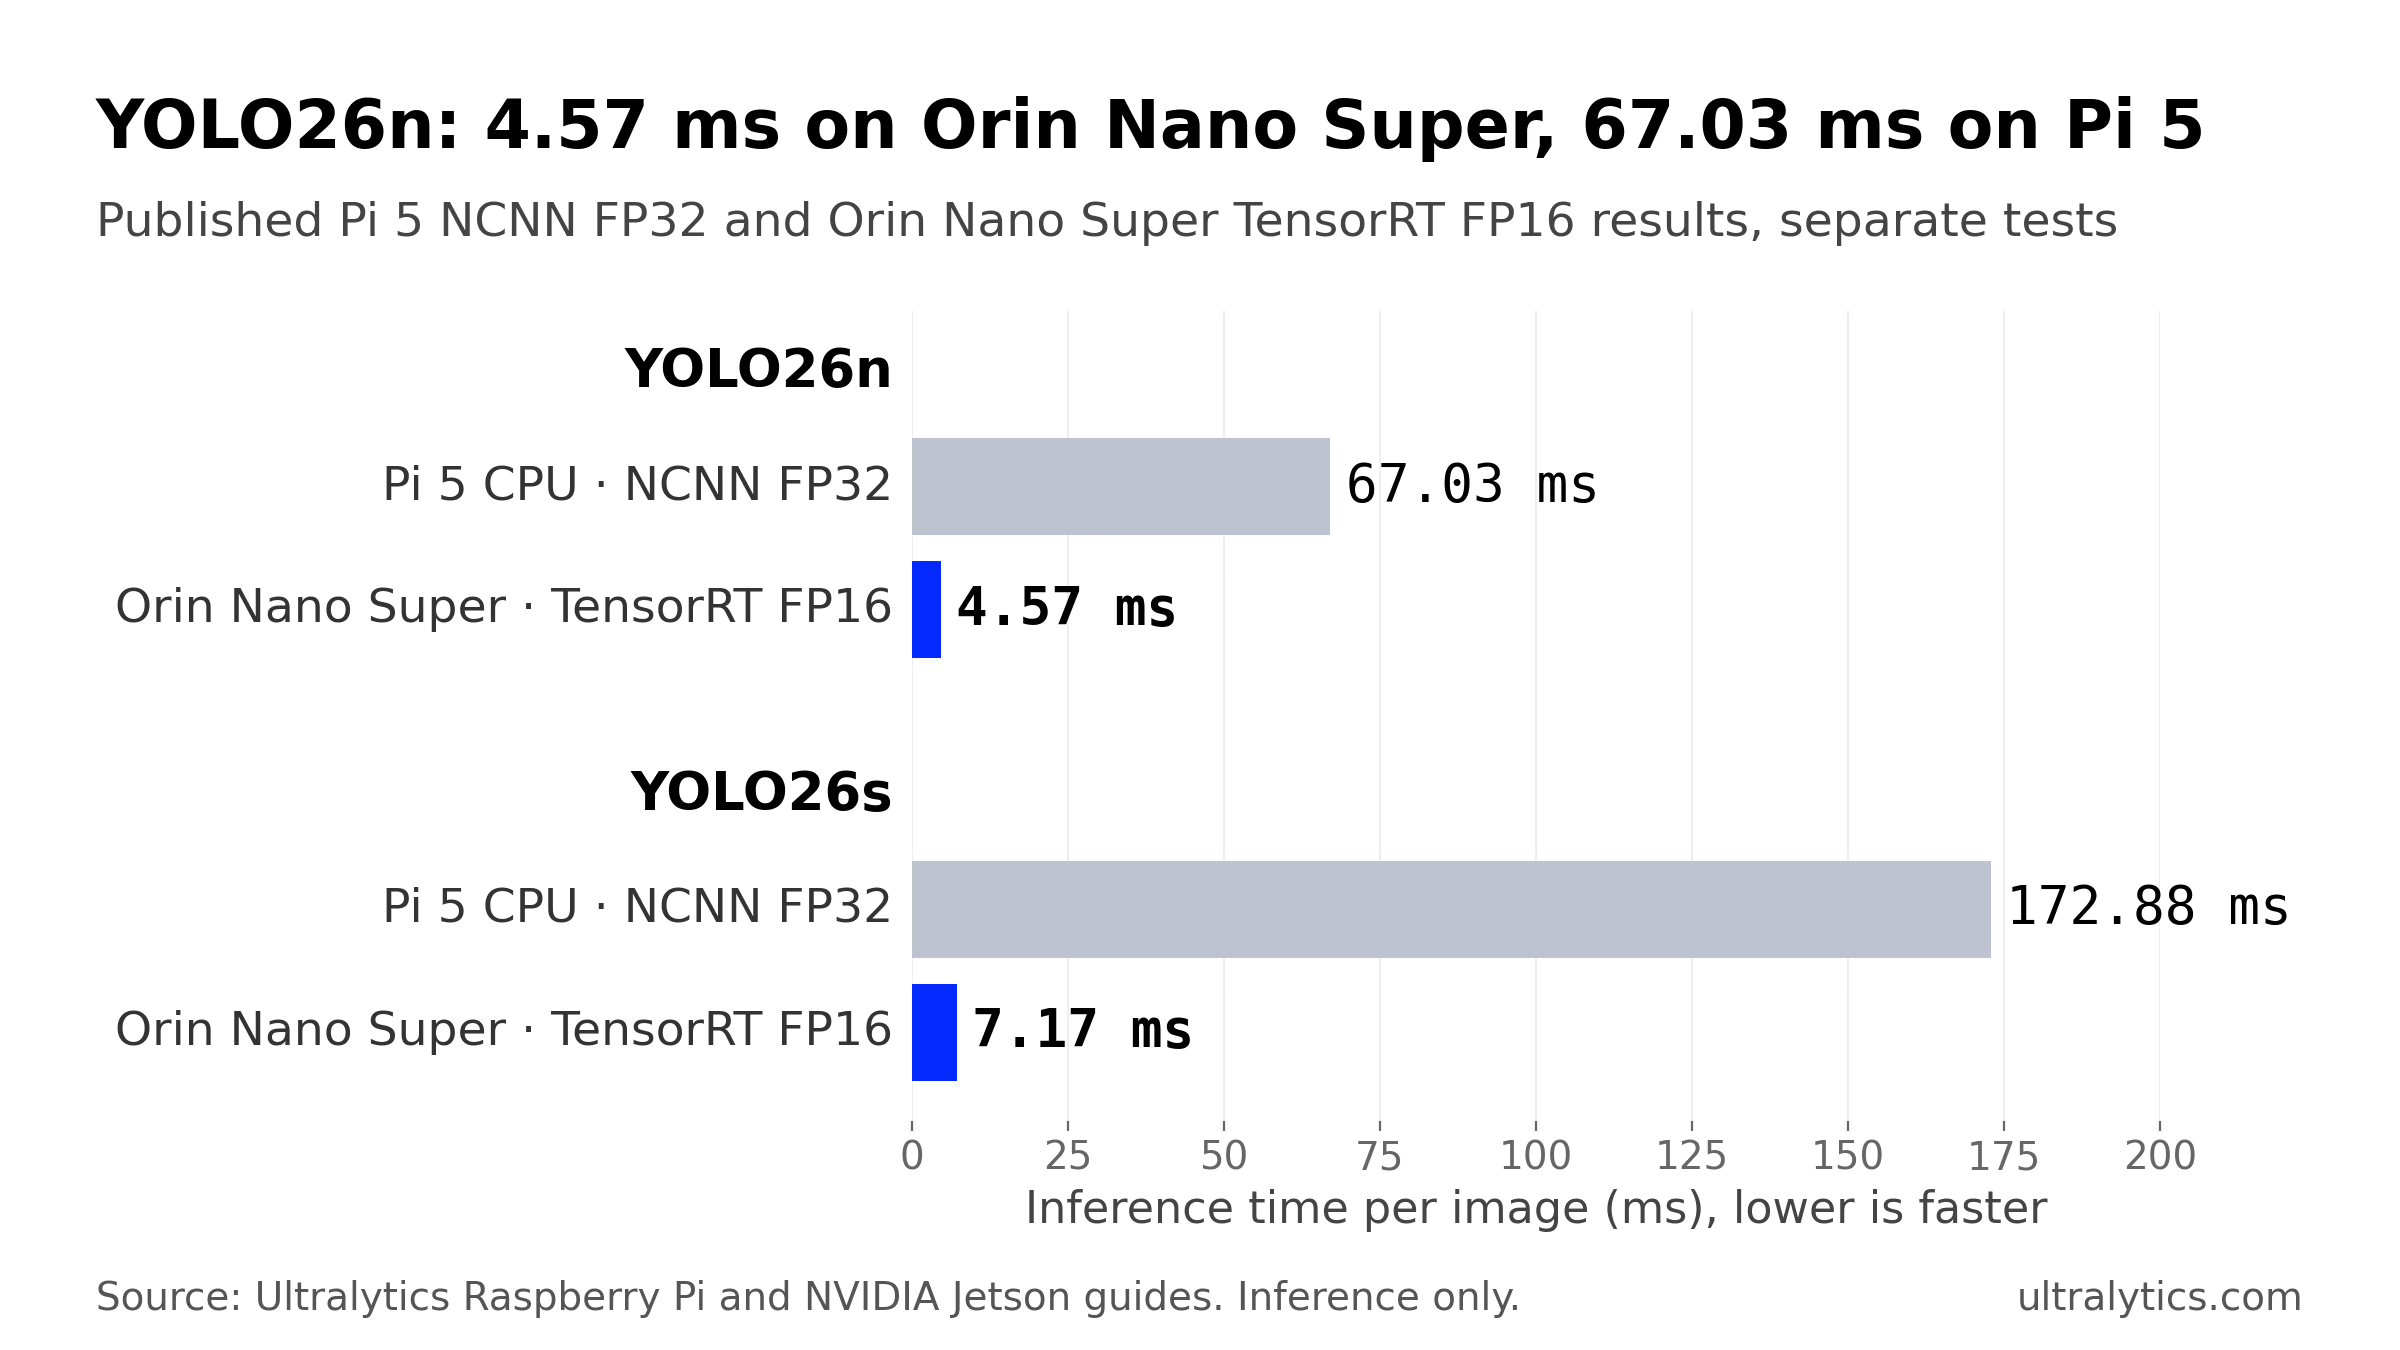
Resultados publicados de NCNN FP32 e TensorRT FP16 obtidos em testes separados: Raspberry Pi 5 com Ultralytics 8.4.108 e Orin Nano Super Developer Kit com Ultralytics 8.4.33. Apenas inferência, sem pré-processamento nem pós-processamento. Fonte: os guias Raspberry Pi e NVIDIA Jetson da Ultralytics.
Para YOLO26n, isso representa cerca de 93% menos tempo de inferência do que na CPU do Pi 5. A precisão explica parte da diferença, por isso compara também as exportações FP32: o motor TensorRT FP32 do Orin Nano Super demora 7.53 ms, quase nove vezes mais rápido do que a exportação NCNN FP32 do Pi, embora os runtimes e as versões dos testes sejam diferentes. O maior destaque é o YOLO26m: 0.6225 mAP50-95 em 13.59 ms, um modelo que a CPU do Pi 5 executou a cerca de um fotograma por segundo no teste ONNX mais antigo.
INT8 reduz mais um pouco o tempo. YOLO26n desce para 3.80 ms como motor INT8, mas o seu mAP50-95 cai de 0.4800 para 0.4490 em COCO128, por isso começa com FP16 e passa à quantização INT8 apenas se FP16 não cumprir o teu orçamento e conseguires calibrar com imagens das tuas próprias câmaras. A nossa aula da Academy sobre otimização com TensorRT explica esse processo de decisão.
Os FPS diminuem quando adicionas câmaras porque todas as transmissões partilham os mesmos recursos#
Um padrão comum ao aumentar a escala: uma câmara funciona sem problemas, mas a taxa de fotogramas processados diminui quando adicionas uma terceira ou quarta. Cada fotograma exige descodificação, pré-processamento, inferência e pós-processamento, e todas as câmaras recorrem ao mesmo conjunto de recursos computacionais. Num Pi 5, os mesmos quatro núcleos da CPU descodificam o vídeo e executam o modelo, por isso cada transmissão adicional consome tempo de ambos.
A Ultralytics trata da integração. Inclui uma fonte por linha num ficheiro .streams e passa-o ao modo Predict: cada transmissão tem o seu próprio thread de leitura, e o carregador agrupa num único lote o fotograma mais recente de cada câmara, pelo que uma fonte lenta ou interrompida pode atrasar o lote. Os backends que aceitam lotes processam-no numa única passagem forward; NCNN processa os fotogramas um de cada vez, e num motor TensorRT de forma fixa o lote é dividido ou preenchido para corresponder ao tamanho de exportação. Por predefinição (stream_buffer=False), um modelo lento ignora os fotogramas desatualizados em vez de os colocar numa fila, o que mantém curta a acumulação de tarefas na aplicação, embora o armazenamento em buffer na câmara, no descodificador ou na rede ainda possa acrescentar latência.
A latência de uma única imagem é um ponto de partida, não um limite para o número de câmaras. O processamento em lotes altera o débito, e a descodificação, o seguimento e o desenho acrescentam custos próprios. A aula sobre inferência multitransmissão da Ultralytics Academy apresenta a regra de dimensionamento: o número de transmissões por dispositivo é aproximadamente o débito sustentado ao tamanho de lote real, dividido pelos FPS necessários a cada transmissão, com uma margem de 20 a 30% para picos. Mede esse débito na placa com as câmaras ligadas, como explicado na secção prática abaixo. Para pipelines com várias câmaras no Jetson, o DeepStream processa várias fontes através de um único motor TensorRT numa aplicação com mosaico.
Escolhe com base nos FPS medidos por câmara, no tamanho do modelo e na precisão#
Começa pela placa mais barata que possa funcionar, mede o desempenho com as tuas próprias câmaras e passa a uma opção superior apenas se ficar aquém:
| Se as tuas medições mostrarem que… | Comece com |
|---|---|
| YOLO26n cumpre o teu objetivo de precisão e de FPS por câmara | Uma CPU do Pi 5 com NCNN. Uma tarefa com FPS baixos pode suportar mais do que uma câmara. |
| O Pi não consegue atingir a taxa de fotogramas necessária, mas queres continuar a usá-lo | Um Pi 5 com um acelerador como o Hailo-8 AI HAT+ ou o DEEPX DX-M1. Ambos executam modelos quantizados e acrescentam uma etapa de compilação, por isso verifica a precisão após a exportação. |
| Precisas de um modelo maior a FPS mais elevados, de mais transmissões do que o Pi consegue suportar ou de tempo de CPU para outro software | Um Jetson Orin Nano Super com TensorRT, passando ao Orin NX ou ao AGX Orin se o débito medido ficar aquém do necessário. |
A taxa de fotogramas é um requisito de negócio antes de ser um valor de benchmark. O nosso guia sobre FPS em visão computacional explica como defini-la com base na velocidade do que estás a observar, e o guia para escolher o dispositivo de ponta certo aborda placas além destas duas.
Mede ambas as placas com as tuas próprias câmaras#
Os valores acima foram medidos em condições fixas e os teus serão diferentes consoante a refrigeração, o modo de energia, a imagem do SO, a versão do software e o teu modelo. O pacote Ultralytics usa a mesma API em ambas as placas, por isso podes fazer a mesma medição em cada uma. Os comandos abaixo foram verificados com Ultralytics 8.4.215.
Passo 1: Compara os formatos de exportação em cada placa#
Executa yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 na placa. O modo Benchmark indica o tamanho, o mAP50-95 e o tempo de inferência de cada formato de exportação suportado pela placa; adiciona quantize=16 ou quantize=8 para medir FP16 ou INT8 quando o formato o suportar. Num Orin Nano Super Developer Kit preparado com uma configuração com Super ativado, seleciona primeiro o modo de energia MAXN SUPER; no artigo da NVIDIA sobre o Super Mode para JetPack 6.2 no Orin Nano, o comando é sudo nvpmodel -m 2. Depois executa sudo jetson_clocks. Acompanha as temperaturas durante execuções prolongadas.
Passo 2: Exporta para o formato mais rápido em cada placa#
No Raspberry Pi 5, exporta para NCNN conforme apresentado no nosso tutorial do Raspberry Pi 5. No Jetson, cria o motor no próprio dispositivo, porque os motores TensorRT dependem da GPU e da versão TensorRT utilizadas para os criar. Um motor exportado sem dynamic tem uma forma de entrada fixa. Uma opção é definir batch para o número de câmaras e voltar a exportar com um imgsz menor se precisares de mais velocidade:
from ultralytics import YOLO

# Apenas Jetson: requer uma GPU NVIDIA. Motor TensorRT FP16, 640 píxeis, lote de quatro câmaras
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # escreve yolo26n.engine
Passo 3: Mede os FPS processados por câmara#
Coloca um URL RTSP por linha em cams.streams, executa o modelo da placa durante cerca de um minuto e compara os FPS processados de cada câmara com a taxa a que envia os fotogramas. O cronómetro começa após o primeiro lote completo, quando as transmissões estão ligadas e o modelo já está aquecido, e para após um lote completo:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Isto mede o débito de resultados processados deste pipeline. Se os FPS processados de uma câmara ficarem bastante abaixo da sua taxa de fotogramas quando adicionas transmissões, a placa não está a acompanhar. Confirma-o com contadores explícitos de fotogramas perdidos por transmissão, usando o exemplo produtor-consumidor da aula sobre transmissões múltiplas da Academy, adiciona o seguimento ou o desenho de que a tua aplicação precisa e, em seguida, volta a exportar com um imgsz menor, passa a um modelo mais pequeno ou a uma exportação mais rápida, ou atualiza o hardware e repete o teste.
Se preferires não configurar um ambiente de compilação, o separador Export da Ultralytics Platform cria motores TensorRT para dispositivos Jetson, incluindo o Orin Nano 8GB Super. As configurações Orin são criadas num AGX Orin e a validação no próprio Orin Nano ainda está pendente, por isso confirma que o runtime TensorRT e CUDA do teu dispositivo é compatível com o motor e valida cada motor no dispositivo onde o vais implementar. Para comparar ONNX Runtime com TensorRT em GPUs NVIDIA, consulta ONNX vs TensorRT.
Que placa escolher#
Escolhe um Raspberry Pi 5 quando YOLO26n cumprir o teu objetivo de precisão e os FPS processados que medires na placa forem suficientes para todas as câmaras necessárias. Com cerca de 15 FPS de inferência, é uma solução simples para caixas de retalho, contagem em tapetes transportadores, câmaras de observação da vida selvagem e domésticas, e protótipos iniciais de robôs. Adiciona um acelerador quando precisares de mais fotogramas, mas quiseres continuar a usar o Pi.
Escolhe um Jetson Orin Nano Super quando precisares de um modelo maior do que nano a uma taxa de fotogramas útil, de mais transmissões do que um Pi consegue suportar ou de tempo de CPU disponível para seguimento, navegação e outras partes da aplicação. YOLO26s a YOLO26l demoram menos de 18 ms de inferência por imagem nesse dispositivo, e essa margem é o que vais consumindo à medida que adicionas câmaras. Mede a aplicação completa para confirmar.
Onde a Ultralytics se encaixa#
A Ultralytics não fabrica nenhuma das placas; desenvolvemos os modelos e as ferramentas que funcionam em ambas. Os mesmos pesos YOLO26 podem ser exportados para NCNN para o Pi 5, para Hailo para um Pi com o AI HAT+ e para TensorRT para um Jetson, para que possas criar um protótipo num Pi e passar para um Jetson quando a carga de trabalho aumentar, sem voltar a treinar; valida a precisão após cada exportação. A Ultralytics Platform trata dos passos anteriores à implementação: anota um conjunto de dados, treina na nuvem quando o projeto precisa de mais recursos de treino do que tens localmente e exporta para qualquer uma das placas.
Limitações: os nossos benchmarks publicados medem apenas a inferência e foram realizados nos dispositivos de teste indicados, não nas tuas câmaras, caixa ou módulo de produção, e o nosso guia Jetson não inclui resultados de YOLO26 para o Jetson Nano original. O Ultralytics YOLO está disponível ao abrigo da AGPL-3.0 ou de uma Licença Empresarial Ultralytics; consulta as licenças da Ultralytics para saberes o que a tua implementação exige.
Perguntas frequentes
É muito mais rápido por imagem. Nos nossos benchmarks publicados, realizados em testes separados, YOLO26n demora 4.57 ms como motor TensorRT FP16 num Jetson Orin Nano Super Developer Kit, contra 67.03 ms com NCNN na CPU de um Raspberry Pi 5 (entrada de 640 píxeis, apenas inferência), e YOLO26m demora 13.59 ms no Jetson. Depende do teu modelo, do número de câmaras e do objetivo de FPS se precisas dessa velocidade: se as tuas próprias medições mostrarem que um Pi 5 é suficiente, é a solução mais simples.
Não. O Jetson Nano original foi lançado em 2019 com uma GPU Maxwell de 128 núcleos e 4 GB de memória, e só suporta JetPack 4. O Jetson Orin Nano é um módulo mais recente com uma GPU Ampere de 1024 núcleos; o Orin Nano Super Developer Kit que comparámos tem 8 GB de memória e suporta JetPack 5 a 7. A comparação de desempenho deste artigo abrange o Orin Nano Super, não o Nano original.
Sim. O Jetson Nano de 2019 suporta JetPack 4, a Ultralytics disponibiliza uma imagem Docker JetPack 4 e o nosso guia DeepStream para YOLO26 com TensorRT foi testado num Jetson Nano 4GB com JetPack 4.6.4. O nosso guia Jetson não inclui um benchmark de YOLO26 para esse dispositivo, e o seu hardware fica muito aquém do Orin Nano Super.
Todas as transmissões partilham os recursos computacionais da placa: cada câmara adicional precisa da sua própria descodificação, pré-processamento, inferência e pós-processamento. Com um ficheiro
.streams, a Ultralytics agrupa em lotes os fotogramas de todas as câmaras e ignora os fotogramas desatualizados quando o modelo não consegue acompanhar, pelo que os FPS processados de cada câmara podem diminuir quando o pipeline partilhado se torna um estrangulamento. Uma exportação mais rápida, um modelo mais pequeno ouimgsz, ou hardware mais potente, aumenta os FPS.Sim. Treina uma vez e, em seguida, exporta os mesmos pesos com
format="ncnn"para o Pi 5 eformat="engine"para o Jetson, criando o motor TensorRT no dispositivo de destino ou para esse dispositivo. Valida a precisão com os teus próprios dados após cada exportação.
Escrito por
Engenheiro sênior de machine learning · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









