Comparação entre plataformas de treino gerido e GPUs autoalojadas para visão computacional
Compara plataformas geridas de treino com GPU, serviços de ML na nuvem, GPUs alugadas e o teu próprio hardware para visão computacional: custos, configuração, ponto de equilíbrio e quando cada opção é adequada.
 Miles Deans12 min de leitura
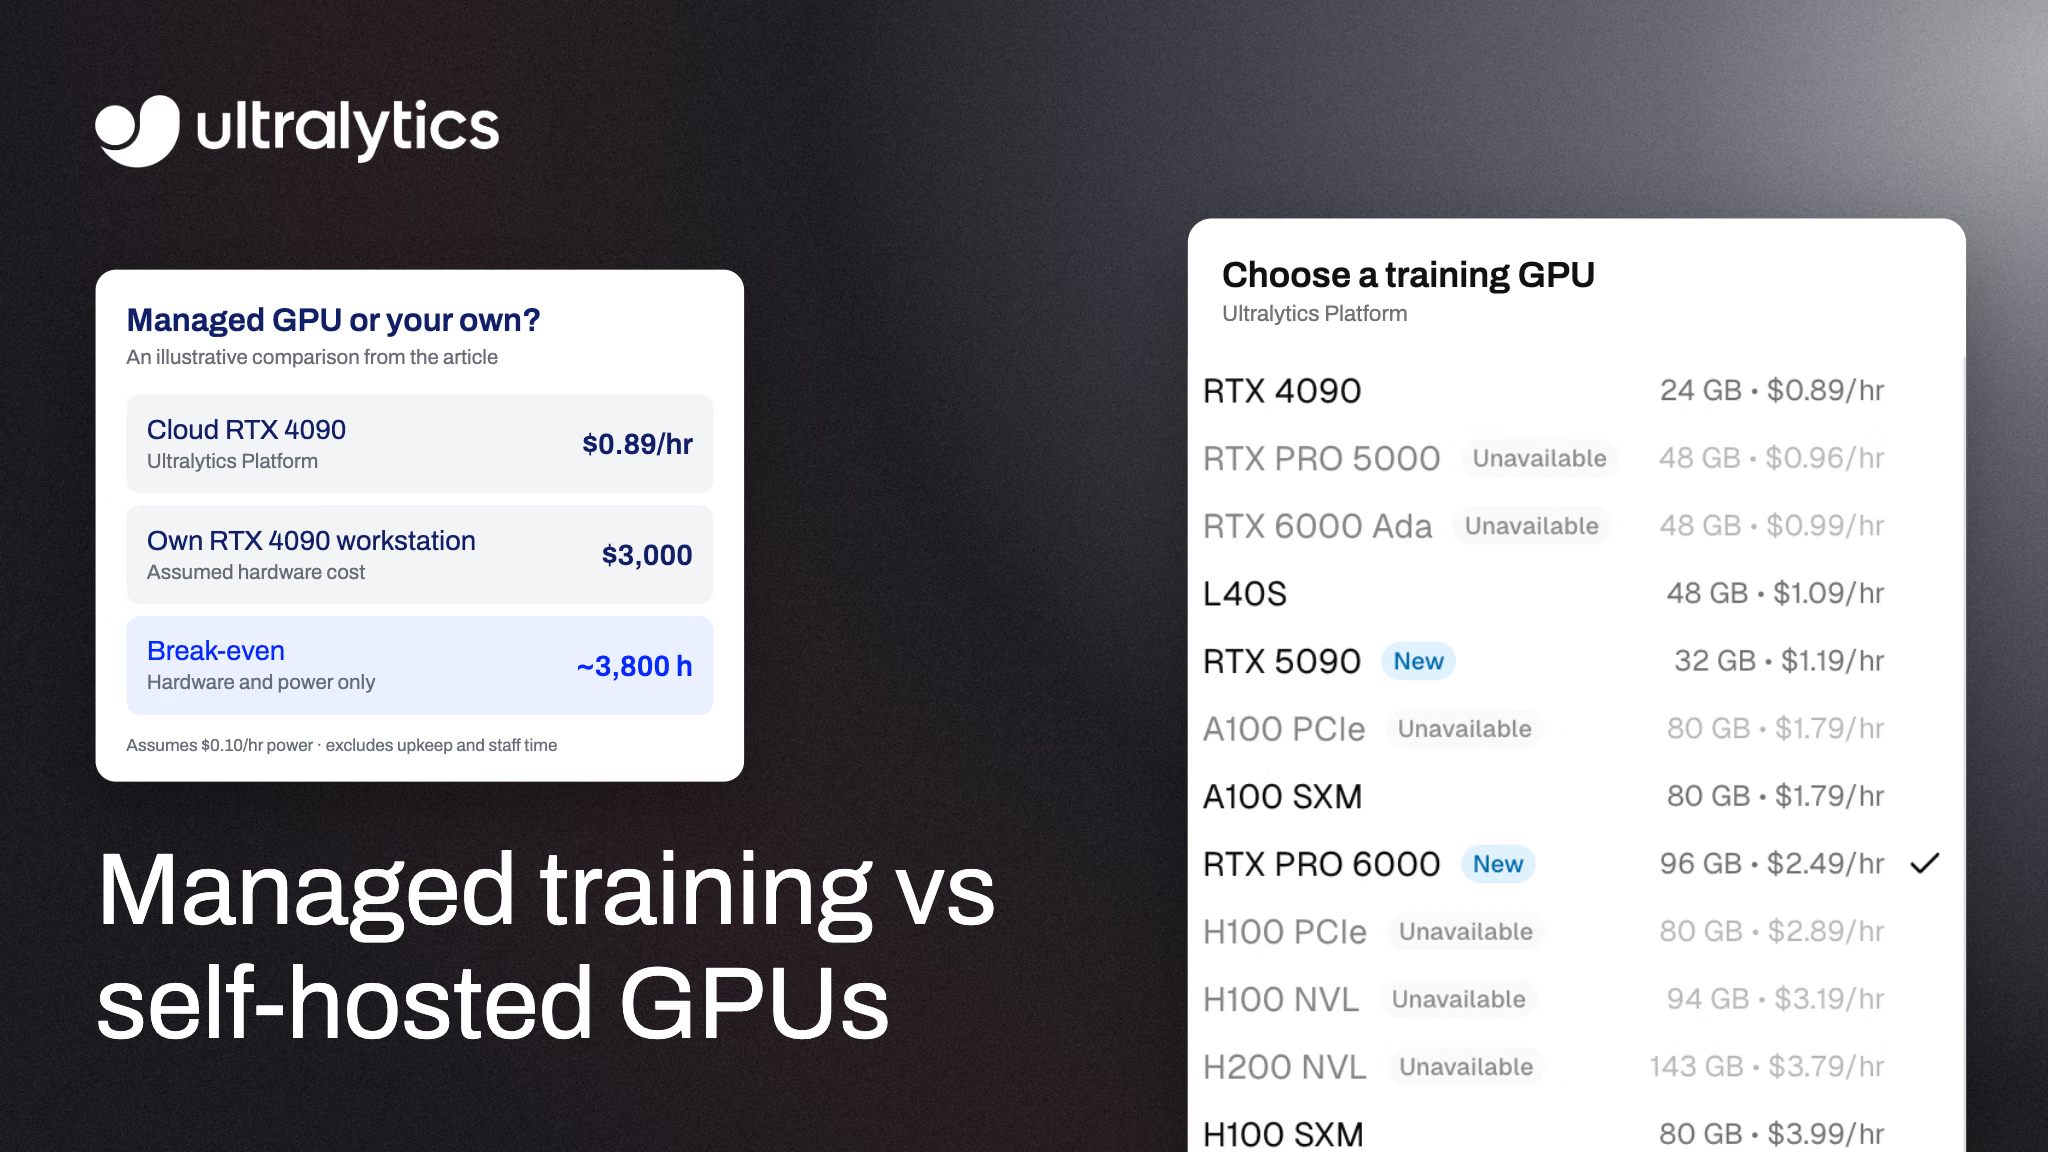
As plataformas de treino gerido executam a infraestrutura de treino por ti e cobram pelo tempo de utilização da GPU; com GPUs autoalojadas, a tua equipa fica responsável pelo hardware e pelo ambiente, quer alugue máquinas, quer as possua. O treino gerido costuma ser adequado para cargas de trabalho intermitentes e equipas que querem reduzir o trabalho de infraestrutura. Possuir GPUs pode custar menos com uma utilização sustentada, mas o resultado depende do nível de utilização do hardware, da sua vida útil, da eletricidade e do tempo de engenharia.
Este guia compara quatro opções comuns para treinar modelos de visão em 2026, mostra como calcular o ponto de equilíbrio para a tua própria carga de trabalho e explica onde se enquadra a Ultralytics Platform.
As quatro opções para treinar um modelo de visão#
A expressão «gerido vs. autoalojado» costuma ocultar quatro configurações diferentes:
- Uma plataforma gerida de treino de visão. Carregas ou ligas um conjunto de dados, escolhes um modelo e uma GPU, e a plataforma executa o treino. A Ultralytics Platform funciona desta forma para modelos YOLO.
- Uma plataforma de ML de uso geral. Serviços como Amazon SageMaker, Google Vertex AI e Azure Machine Learning executam tarefas de treino em instâncias na nuvem para muitas frameworks. Configuras a tarefa de treino, o ambiente, as permissões e o armazenamento; a computação e os serviços relacionados são cobrados à parte. Por isso, compara a página oficial de preços de cada fornecedor, em vez de considerares apenas as tarifas das GPUs.
- Uma GPU alugada na nuvem. Serviços de GPU na nuvem, como RunPod e Lambda, alugam-te uma máquina com base no tempo de utilização. A menos que a imagem do fornecedor já inclua o que precisas, configuras os controladores, CUDA, os pacotes Python e o código de treino, e paras a instância quando terminares.
- A tua própria GPU. Uma estação de trabalho ou um servidor no teu escritório ou centro de dados. Compras o hardware uma vez e pagas a eletricidade, a refrigeração, a manutenção e o tempo necessário para o manter em funcionamento.
Treino gerido vs. GPUs autoalojadas, numa síntese#
| Fator de decisão | Plataforma gerida de visão | Plataforma geral de ML | GPU alugada na nuvem | GPU própria |
|---|---|---|---|---|
| É necessário comprar hardware | Não | Não | Não | Sim |
| Pagas por | Tempo de utilização da GPU | Tempo de utilização da instância e serviços relacionados | Tempo de utilização da instância enquanto está em funcionamento | Hardware, eletricidade, manutenção |
| Configuração antes da primeira execução | Escolher o conjunto de dados, o modelo e a GPU | Configurar a tarefa, o ambiente, as permissões e o armazenamento | Configurar ou verificar o ambiente, o código e as dependências | Hardware, sistema operativo, controladores, pacotes |
| Ambiente de treino | Executado pela plataforma; tu escolhes as definições | Partilhado entre o serviço e a tua equipa | Principalmente a tua equipa | A tua equipa |
| Obter uma GPU mais potente | Selecionar outra GPU disponível | Selecionar outro tipo de instância | Alugar outra máquina | Comprar outra GPU |
| Localização dos dados | Armazenamento da plataforma, um contentor na nuvem ligado (Pro e Enterprise) ou dados no local (Enterprise) | A tua conta na nuvem | Onde quer que os copies | Nas tuas instalações |
| Considera quando | Queres um treino de visão rápido e repetível | As equipas já estão padronizadas nas ferramentas de ML de uma determinada nuvem | Os engenheiros estão à vontade para gerir máquinas | O treino é contínuo ou quase contínuo, ou há regras rigorosas para execução no local |
Como são cobrados os treinos geridos com GPU#
Na Ultralytics Platform, é fácil estimar o custo da GPU de uma execução de treino:
GPU cost = selected GPU hourly rate × billable GPU hoursAo comparar fornecedores, usa a mesma carga de trabalho e a mesma precisão pretendida, e acrescenta os custos de subscrição, armazenamento, transferência de dados e tempo de engenharia.
A Ultralytics Platform disponibiliza 26 tipos de GPU NVIDIA a partir de 0,24 $/h, sem mínimos nem compromisso; o plano Free permite usar 24 delas, e os planos Pro e Enterprise permitem usar as 26. Algumas opções comuns:
| GPU | VRAM | Preço por hora |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (recomendação predefinida) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (planos Pro e Enterprise) | 180 GB | $7.99 |
A faturação baseia-se no tempo real de utilização da GPU. As execuções concluídas, canceladas e as que falham depois de a GPU arrancar são cobradas pelo tempo de utilização decorrido; uma falha antes de a GPU arrancar não tem custos. A caixa de diálogo de treino estima a duração e o custo antes de começares, e cada estimativa reserva pelo menos 15 minutos de utilização da GPU do teu saldo. Essa reserva determina o saldo necessário para começar, enquanto a faturação se baseia no tempo real de utilização da GPU.
Para contextualizar, os tempos de treino típicos da Ultralytics para 1.000 imagens e 100 épocas numa RTX PRO 6000 são cerca de 15 minutos para YOLO26m e cerca de 30 minutos para YOLO26x. A 2,49 $ por hora, isso corresponde aproximadamente a 0,62 $ e 1,25 $ de utilização da GPU. As execuções reais variam consoante o tamanho da imagem, o aumento de dados e o tamanho do lote, por isso considera estes valores como referências iniciais, não como orçamentos.
O custo real das GPUs autoalojadas#
Uma GPU que possuis não tem uma tarifa horária, mas isso não significa que cada execução seja gratuita. O custo total inclui:
- O hardware, além do resto da estação de trabalho ou do servidor que o acompanha.
- Eletricidade e refrigeração durante cada hora de treino.
- Tempo de engenharia para tratar de controladores, versões de CUDA, conflitos entre pacotes e ambientes avariados.
- Tempo de inatividade. Uma GPU que treina duas horas por dia fica inativa durante o resto do tempo, o que aumenta proporcionalmente o custo por hora de treino.
- Limites de capacidade. Quando um modelo precisa de mais VRAM do que tens, ou quando várias experiências têm de ser executadas ao mesmo tempo, tens de esperar ou comprar mais hardware.
Uma comparação simplificada entre hardware e eletricidade, partindo do pressuposto de que a GPU própria treina tão depressa como a GPU na nuvem, é:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)A título de exemplo, suponhamos que uma estação de trabalho com RTX 4090 custa 3.000 $ e que a eletricidade custa cerca de 0,10 $ por hora de treino. Comparada com uma RTX 4090 a 0,89 $ por hora, atinge o ponto de equilíbrio após cerca de 3.800 horas de treino: aproximadamente 5,3 meses de utilização ininterrupta ou 15,8 meses a oito horas por dia. Este cálculo não inclui refrigeração, eletricidade em inatividade, reparações, financiamento, valor de revenda nem o teu próprio tempo; possuir o equipamento só compensa se esse volume de treino ocorrer durante a vida útil do hardware. Usa o preço real do teu hardware, o custo da eletricidade e as horas de treino previstas; o resultado varia bastante com o nível de utilização.
Quando faz sentido usar GPUs autoalojadas#
Possuir hardware é a melhor opção quando:
- As tuas GPUs estão sempre ocupadas. O retreino contínuo, as pesquisas extensas de hiperparâmetros ou uma equipa a partilhar uma máquina durante todo o dia aumentam a utilização e aproximam-na do ponto de equilíbrio.
- Os dados não podem sair das tuas instalações. Alguns ambientes regulamentados ou isolados da rede excluem totalmente o treino na nuvem.
- Já tens o hardware. Se tens uma GPU adequada sem utilização, compara os custos de funcionamento e o tempo de treino com as opções na nuvem antes de pagares por mais equipamento.
- Precisas de controlo total sobre controladores, kernels ou código de treino personalizado que uma plataforma gerida não suporta.
Quando faz sentido o treino gerido#
Uma plataforma gerida é a melhor opção quando:
- O treino é intermitente. Treinas quando os dados mudam e depois não treinas durante vários dias.
- Queres começar hoje. Não precisas de instalar controladores, resolver incompatibilidades de CUDA nem depurar o ambiente antes da primeira execução.
- Os tamanhos dos modelos variam. Podes treinar um modelo nano numa GPU pequena e um modelo grande numa GPU de 80 GB ou mais, sem teres de comprar nenhum dos dois.
- Várias pessoas treinam. As execuções, as métricas e os pontos de verificação ficam num só lugar, em vez de estarem em máquinas individuais.
A opção híbrida: GPUs próprias e um painel gerido#
Não tens de escolher uma opção ou a outra. A Ultralytics Platform permite o treino remoto: treinas na tua própria GPU com o pacote ultralytics, transmites métricas em direto para o mesmo painel da Platform usado nas execuções na nuvem e carregas os pesos finais quando o treino termina. As execuções remotas usam a tua própria GPU, não as GPUs na nuvem da Ultralytics, por isso não consomem tempo de utilização de GPUs na nuvem.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # o teu projeto na Platform
    name="local-gpu-run",
)
Define primeiro a tua chave API com export ULTRALYTICS_API_KEY="YOUR_API_KEY". A integração com Platform requer Python 3.11 ou posterior e ultralytics 8.4.120 ou posterior. Uma abordagem comum é executar experiências rápidas numa GPU local e, depois, enviar execuções maiores ou urgentes para uma GPU na nuvem quando a máquina local estiver ocupada.
Como treinar YOLO26 numa GPU gerida com a Ultralytics Platform#
- Cria uma conta em platform.ultralytics.com. As contas novas recebem um crédito de inscrição de 5 $, ou de 25 $ após a verificação de um endereço de e-mail profissional.
- Adiciona um conjunto de dados carregando imagens e etiquetas ou liga um contentor Amazon S3 num plano Pro ou Enterprise.
- Abre a caixa de diálogo de treino, escolhe um modelo YOLO26 e define as épocas e o tamanho da imagem.
- Escolhe uma GPU. A RTX PRO 6000 é a recomendação predefinida; consulta como escolher uma GPU na nuvem para conhecer os compromissos envolvidos.
- Verifica a estimativa de custos, começa o treino e acompanha as métricas em direto até a execução terminar.
O plano Free permite executar até 3 tarefas de treino na nuvem em simultâneo. O plano Pro, por 29 $ por lugar por mês, aumenta esse limite para 10 e inclui 30 $ em créditos mensais por lugar.
Quando o treino terminar, podes exportar o modelo ou implementá-lo como uma API. Se também estás a decidir onde executar a inferência, o nosso guia sobre IA de visão na nuvem vs. autoalojada compara os custos, a latência e o controlo dos dados na implementação.
Perguntas frequentes
Pode ser, sobretudo quando o treino é intermitente, porque só pagas pelas horas de GPU que utilizas. Compara o custo total e o tempo de conclusão da mesma carga de trabalho; o cálculo do ponto de equilíbrio acima (custo do hardware dividido pela tarifa horária da nuvem menos o custo da eletricidade por hora) é uma referência inicial, não uma garantia.
Uma GPU alugada na nuvem dá-te uma máquina, e a tua equipa configura a carga de trabalho de treino e verifica ou configura o ambiente. Uma plataforma de treino gerido trata de mais etapas do fluxo de trabalho: na Ultralytics Platform, escolhes um conjunto de dados, um modelo e uma GPU, e a plataforma disponibiliza a GPU, executa o treino, transmite métricas e guarda pontos de verificação.
Na Ultralytics Platform, uma execução que falha depois de a GPU na nuvem arrancar é cobrada pelo tempo de utilização decorrido, enquanto uma falha antes de a GPU arrancar não tem custos. As execuções canceladas são cobradas pelo tempo de utilização da GPU até ao cancelamento.
Sim. O treino remoto é executado no teu próprio hardware, transmite métricas em direto para a Platform e carrega os pesos finais, sem utilizar tempo de GPU na nuvem.
A RTX PRO 6000 (96 GB) é a recomendação predefinida para a maioria das tarefas. A Ultralytics indica a RTX 4090 para treino geral, a A100 SXM para lotes maiores ou modelos maiores, e GPUs H100, H200, B200 e B300 para tarefas urgentes, com muita memória ou de maior dimensão.
Novas contas da Ultralytics Platform recebem US$ 5 em créditos ao se cadastrarem, valor que aumenta para US$ 25 após a verificação de um e-mail profissional. Os planos Pro incluem US$ 30 em créditos mensais por usuário.
Não. O Kubernetes pode agendar cargas de trabalho de GPU, mas a documentação de agendamento de GPU exige drivers de GPU e um plug-in de dispositivo do fornecedor nos nós. Um cluster de treinamento autogerenciado ainda precisa de alguém responsável pelos ambientes, pelas permissões, pelo monitoramento dos trabalhos e pelos pontos de verificação; por isso, reserve orçamento para esse trabalho além dos custos de computação.
Escrito por
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









