ONNX vs TensorRT para inferência em visão computacional: benchmarks e como escolher
ONNX Runtime vs TensorRT para inferência em visão computacional: velocidade e precisão medidas do Ultralytics YOLO26 em 19 GPUs NVIDIA e como escolher.
 Miles Deans13 min de leitura
ONNX e TensorRT não são exatamente concorrentes. ONNX é um formato de modelo, e TensorRT é o mecanismo de inferência da NVIDIA, que normalmente recebe um arquivo ONNX como entrada. A escolha real é como executar esse arquivo: com ONNX Runtime, que funciona em diferentes hardwares e pode até delegar tarefas ao TensorRT, ou compilado em um mecanismo TensorRT independente, que só funciona em GPUs NVIDIA. Nos benchmarks da Ultralytics Platform do Ultralytics YOLO26 em 19 GPUs NVIDIA, o TensorRT FP16 foi mais rápido do que os resultados ONNX FP16 publicados em todas as GPUs e tamanhos de modelo, com precisão dentro de 0.001 mAP50-95. Os ganhos de velocidade medianos variaram de 1.85x a 2.55x entre os tamanhos de modelo. O benchmark não informa qual provedor de execução do ONNX Runtime gerou os resultados ONNX; por isso, não permite concluir como o ONNX Runtime se compara de modo geral nem com seu provedor de execução TensorRT. Para o Ultralytics YOLO26 em GPUs NVIDIA, comece com TensorRT FP16 quando a latência for importante e use ONNX Runtime quando um mesmo arquivo de modelo precisar funcionar em mais de um tipo de hardware. O Ultralytics YOLO exporta para os dois formatos com um único argumento.
Por onde começar com o Ultralytics YOLO:
| Implantação | Comece com | Exportação do Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, latência é importante | TensorRT FP16 | format="engine", quantize=16 |
| CPU, hardware que não seja NVIDIA ou infraestrutura mista | ONNX Runtime | format="onnx" |
| API do ONNX Runtime em uma GPU NVIDIA | ONNX Runtime com o provedor de execução TensorRT | format="onnx" |
ONNX vs TensorRT: formato, ambiente de execução e mecanismo#
Há três coisas diferentes por trás dessa comparação:
- ONNX (Intercâmbio Aberto de Redes Neurais) é um formato de arquivo que armazena o grafo e os pesos de um modelo treinado de forma independente de framework. Você exporta do PyTorch para ONNX para que outras ferramentas possam ler o modelo.
- ONNX Runtime executa modelos ONNX. Ele delega tarefas a back-ends de hardware chamados provedores de execução, como CPU, CUDA e TensorRT, para que o mesmo arquivo possa ser executado em uma CPU de laptop ou em uma GPU na nuvem.
- TensorRT lê um modelo, normalmente um arquivo ONNX, por meio do seu analisador ONNX. Ele combina camadas, escolhe o kernel mais rápido para cada operação na GPU em que será executado e grava um mecanismo otimizado.
Portanto, a questão é realmente ONNX Runtime vs TensorRT. O ONNX Runtime também pode chamar o TensorRT por meio do seu provedor de execução TensorRT, o que permite manter a API do ONNX Runtime enquanto o TensorRT executa os subgrafos compatíveis. O ONNX Runtime recomenda registrar o provedor de execução CUDA depois dele, para que quaisquer nós não compatíveis com o TensorRT possam ser executados no CUDA.
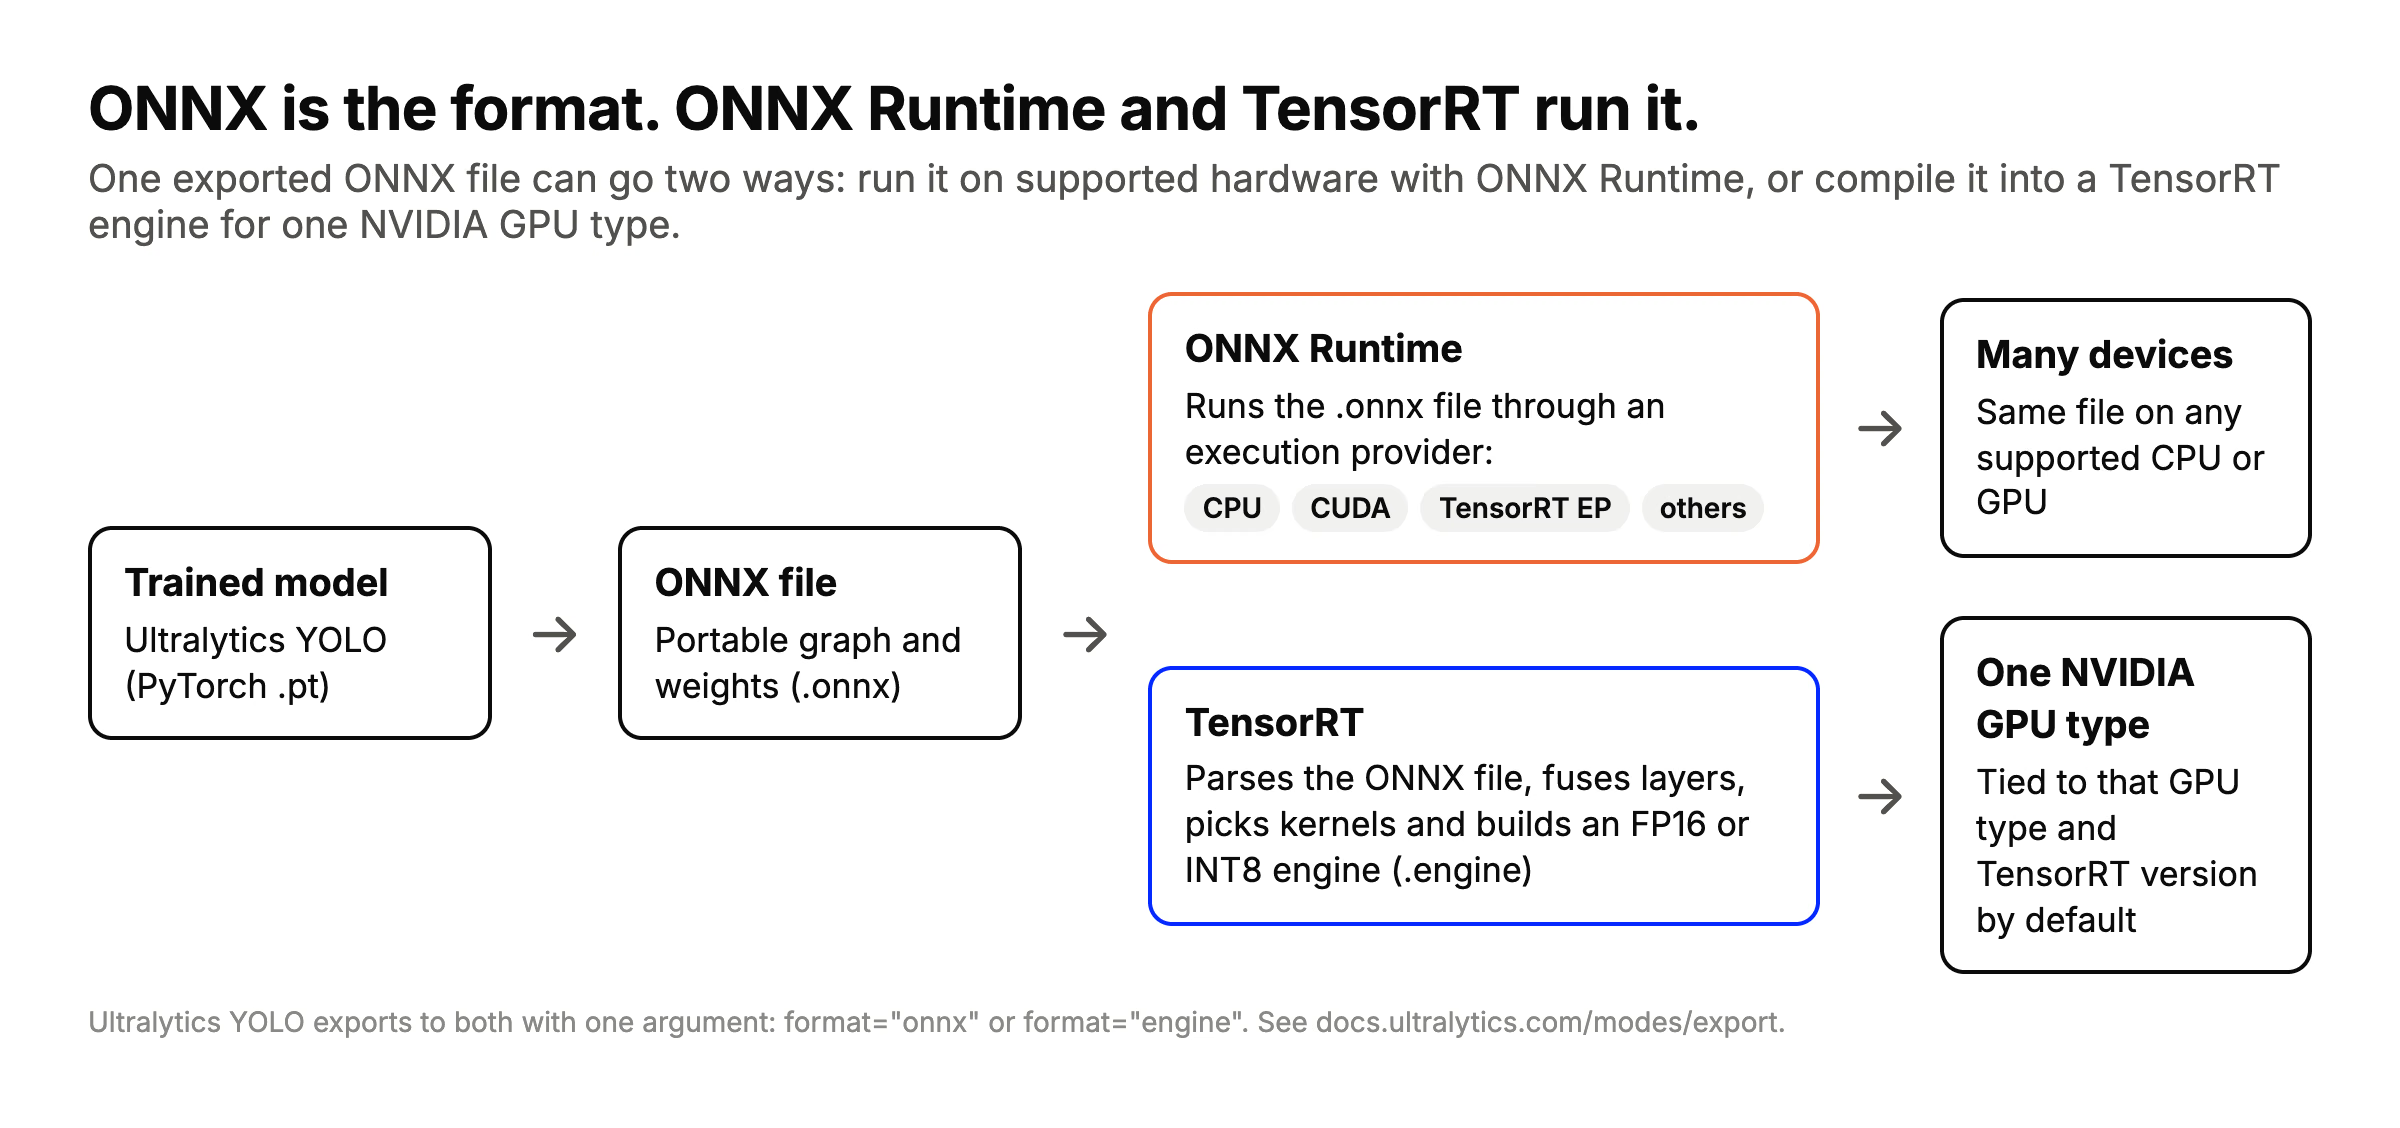
Um arquivo ONNX, dois caminhos: o ONNX Runtime executa o arquivo em hardwares compatíveis, enquanto o TensorRT o compila em um mecanismo para um tipo específico de GPU NVIDIA. O Ultralytics YOLO exporta para os dois.
Benchmarks: YOLO26 com ONNX Runtime vs TensorRT#
Os números abaixo vêm dos benchmarks de inferência da Ultralytics Platform. Cada modelo de detecção Ultralytics YOLO26 foi exportado para o formato indicado; em seguida, a latência de inferência foi medida em GPUs da Ultralytics Platform, com lote 1 e 640 pixels, no COCO val2017, sem incluir o aquecimento e com os tempos de cada execução filtrados por sigma. A precisão é o mAP50-95 no COCO val2017, medido uma vez para cada formato e precisão. A comparação usa as 19 GPUs NVIDIA (Ampere, Ada e Hopper) que têm resultados para os quatro formatos.
A página do benchmark não identifica qual provedor de execução do ONNX Runtime gerou os resultados ONNX, nem indica resultados que usem o provedor de execução TensorRT do ONNX Runtime, que delega ao TensorRT as partes compatíveis do modelo. Esses resultados ONNX descrevem a configuração testada; o desempenho pode variar conforme o provedor de execução do ONNX Runtime. Se você quiser usar a API do ONNX Runtime com o TensorRT por baixo, faça o benchmark dessa combinação no seu próprio hardware.
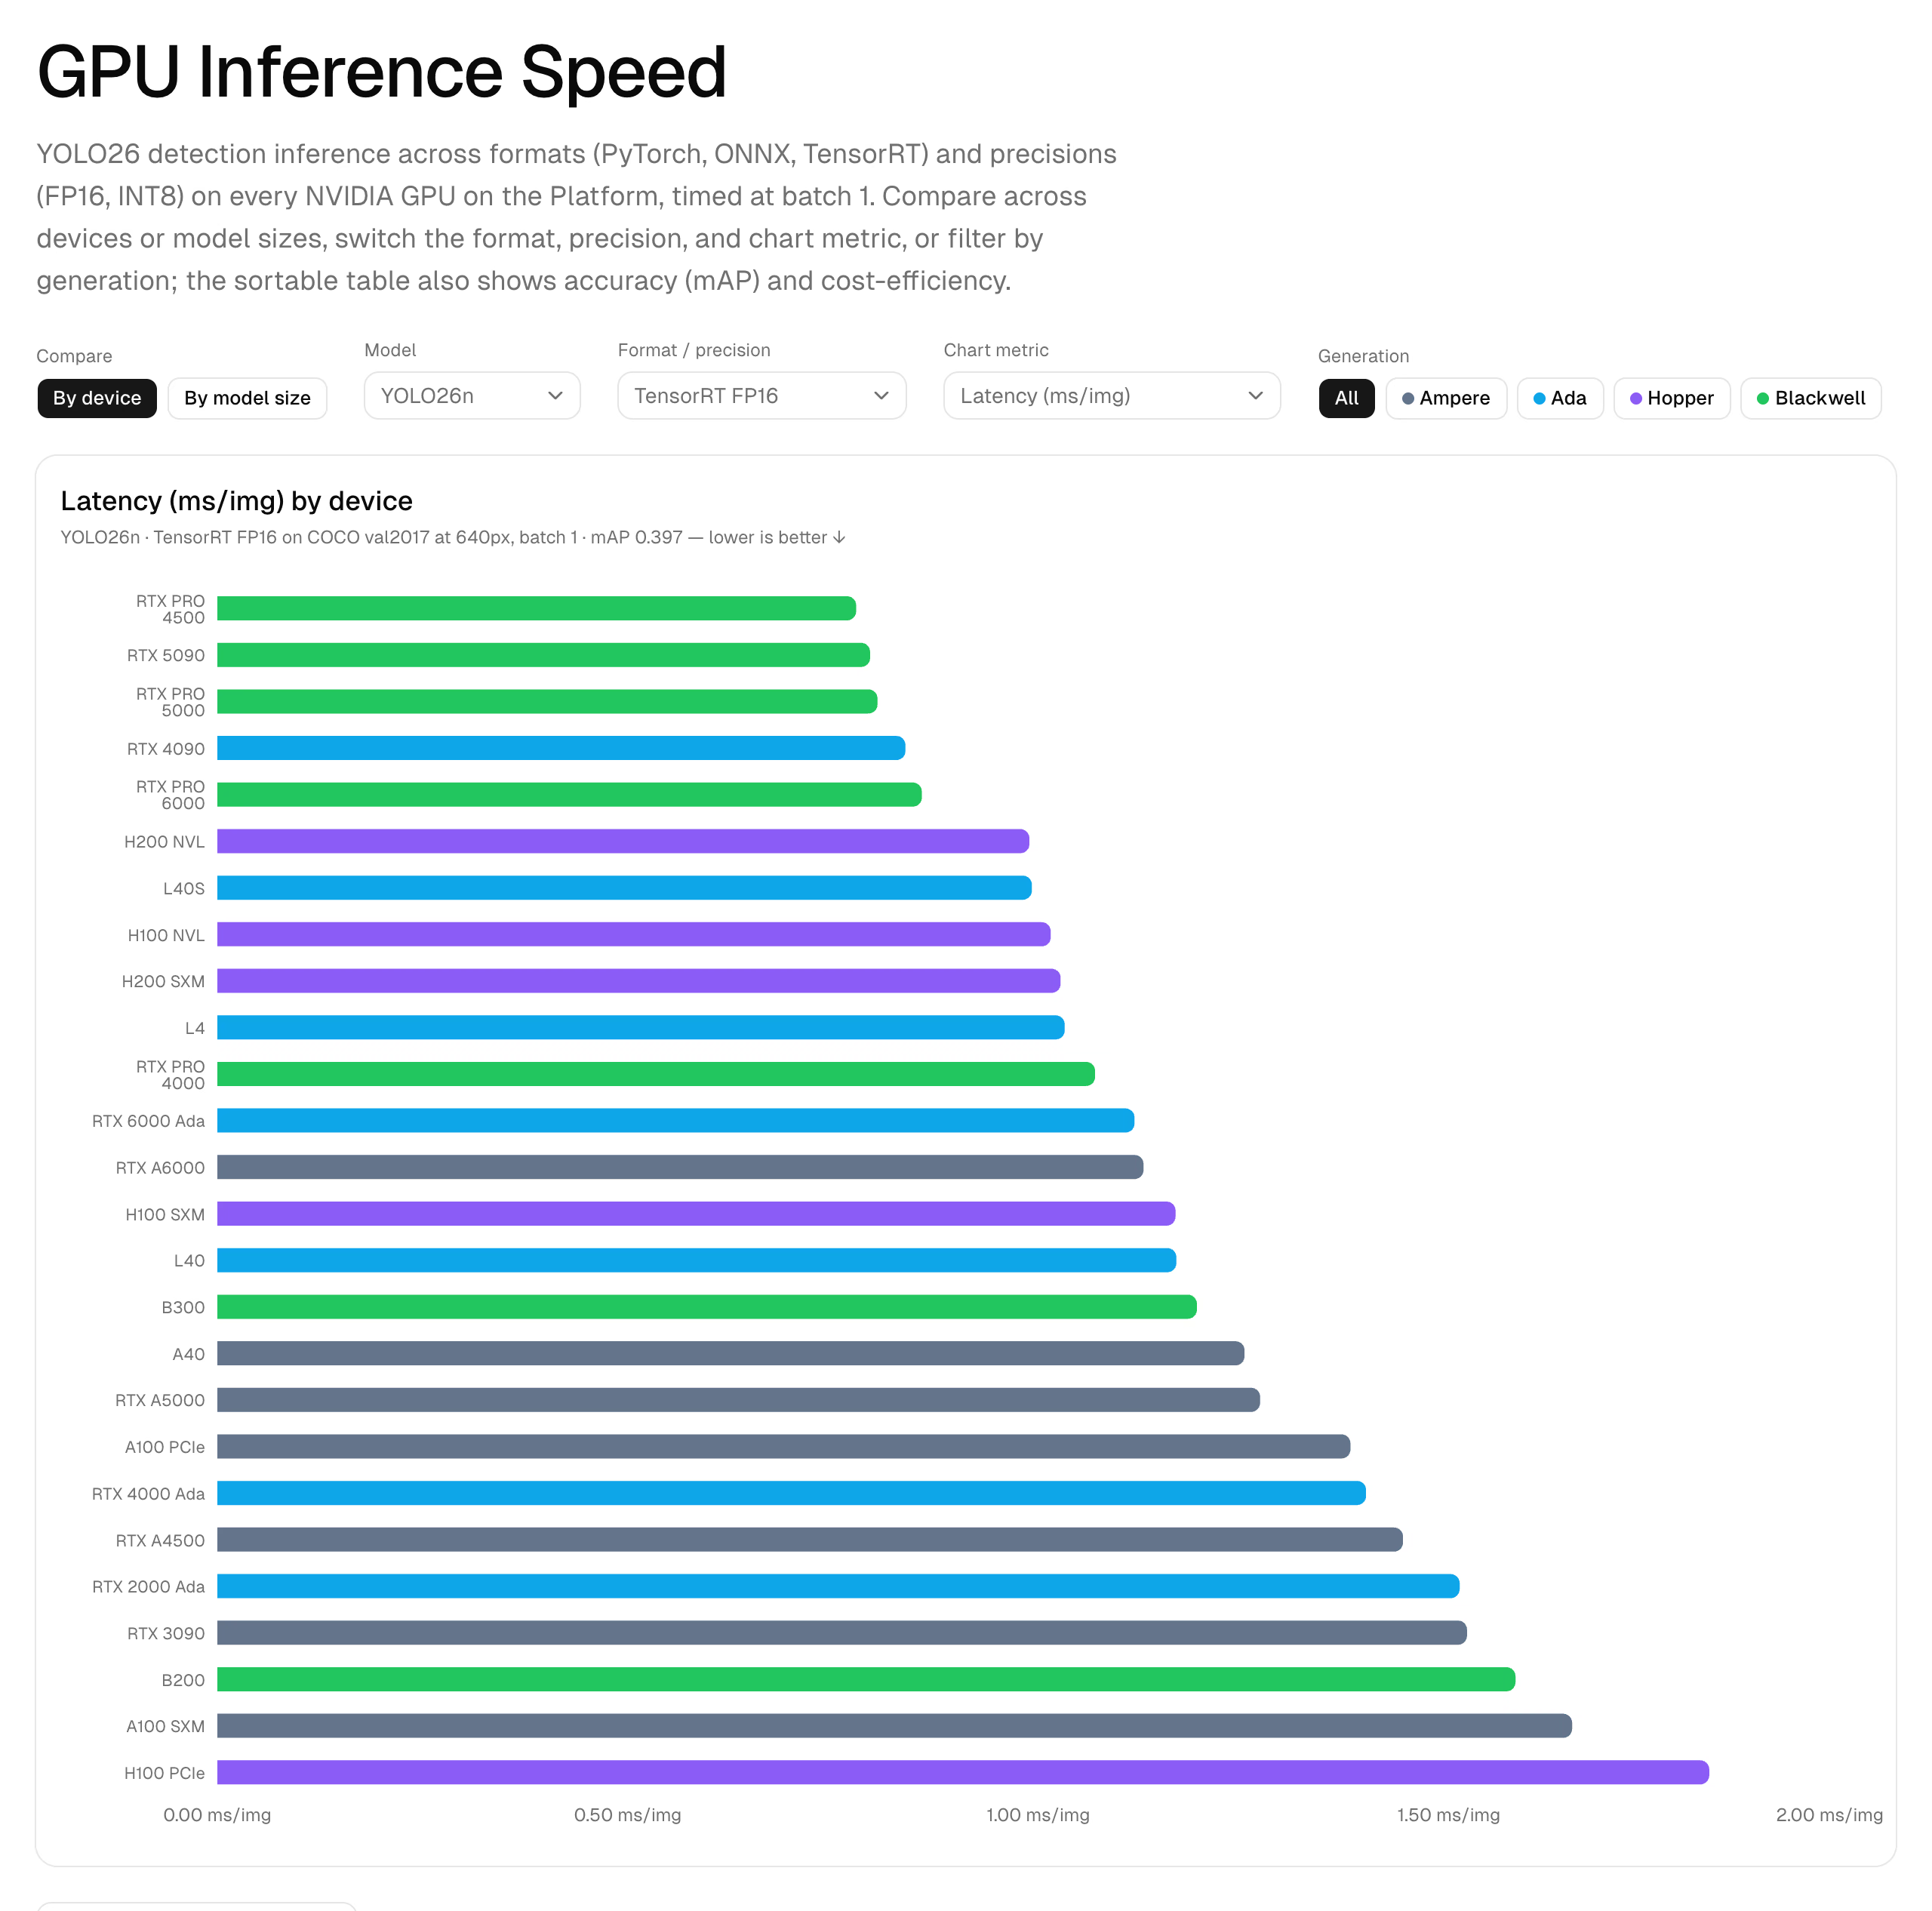
A aba Inferência permite alternar o tamanho do modelo, o formato e a precisão e, em seguida, ordenar todas as GPUs por latência, precisão ou custo.
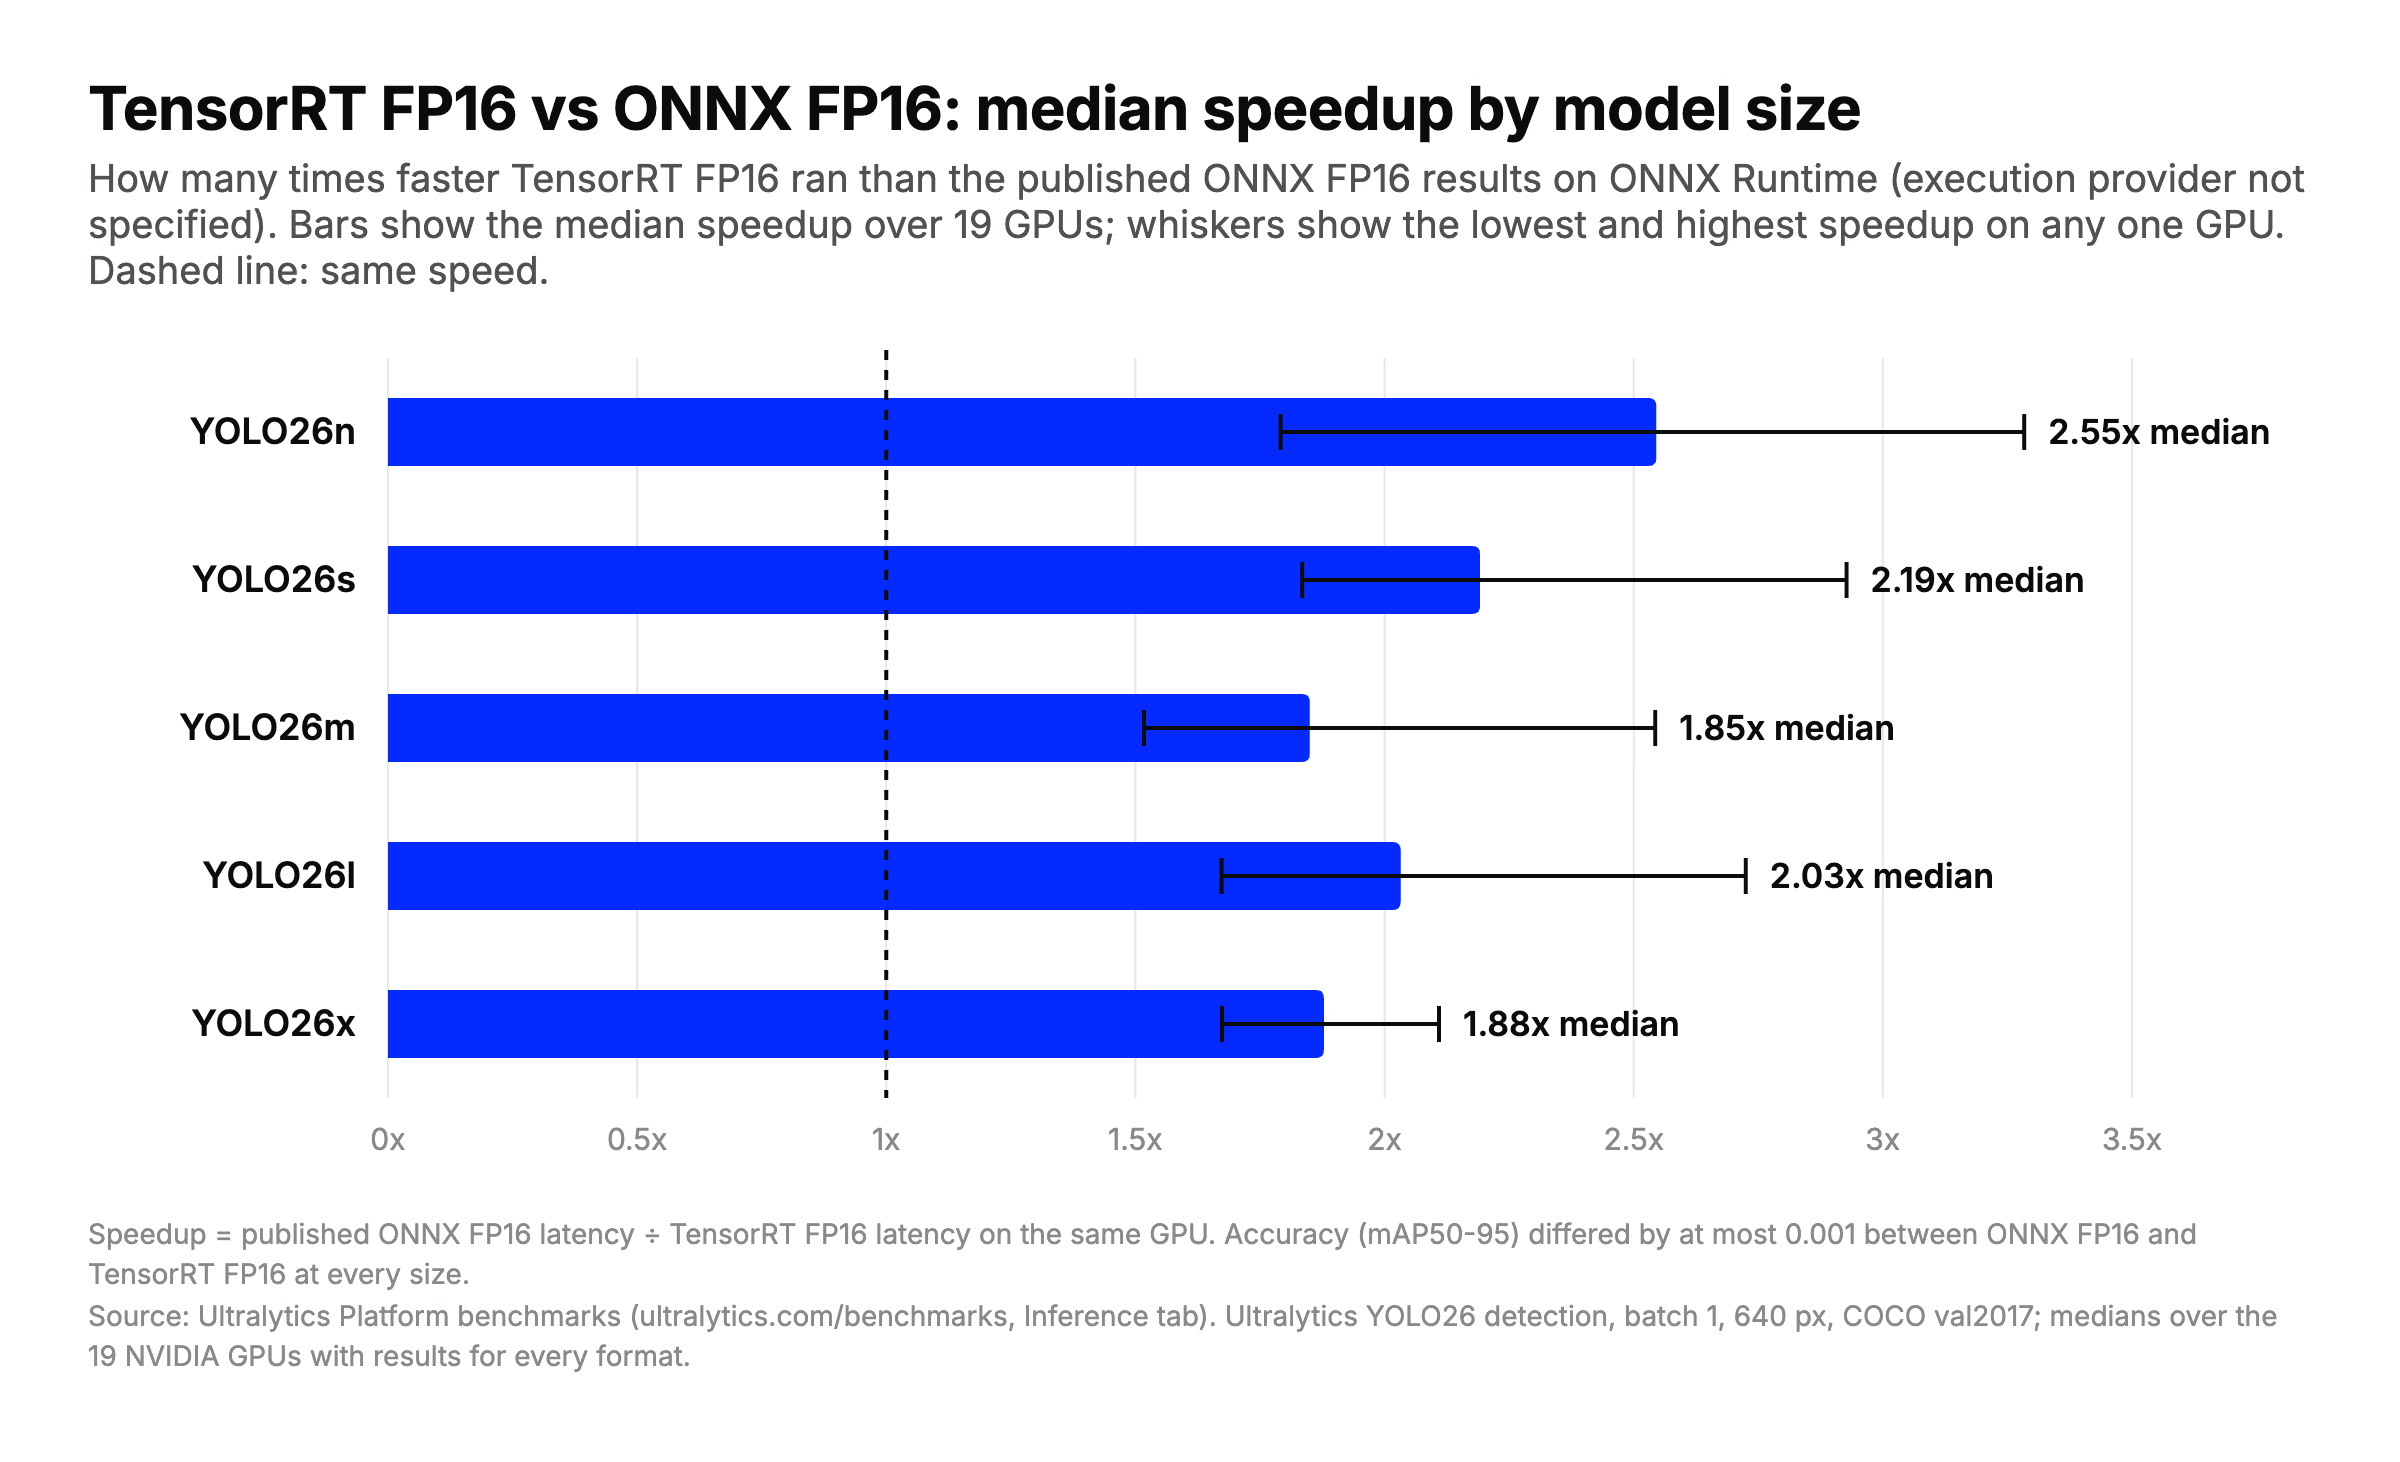
O TensorRT FP16 foi mais rápido do que os resultados ONNX FP16 publicados em todas as GPUs e para todos os tamanhos de modelo; a página não especifica qual provedor de execução do ONNX Runtime os gerou. As barras mostram o ganho de velocidade mediano nas 19 GPUs; as hastes mostram o ganho mínimo e máximo em qualquer GPU. Calculado a partir dos benchmarks de inferência da Ultralytics Platform.
| Modelo | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Ganho de velocidade do TensorRT FP16 sobre ONNX FP16 (mediana, intervalo) | Ganho de velocidade do TensorRT INT8 sobre TensorRT FP16 (mediana, intervalo) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Calculado a partir dos benchmarks de inferência da Ultralytics Platform. O ganho de velocidade é a latência do ONNX FP16 ÷ a latência do TensorRT FP16, ou a latência do TensorRT FP16 ÷ a latência do TensorRT INT8, na mesma GPU; assim, valores acima de 1x significam que o TensorRT FP16 (ou INT8) foi mais rápido. As medianas usam as 19 GPUs NVIDIA com resultados nos quatro formatos; os intervalos são as razões mínima e máxima nessas GPUs. A precisão é o mAP50-95 informado para cada formato e precisão. ONNX FP16 refere-se aos resultados publicados do ONNX Runtime, cujo provedor de execução não foi especificado.
Latência em quatro GPUs comuns, em milissegundos por imagem, conforme publicado na página de benchmarks:
| GPU | Modelo | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Três pontos se destacam:
- O TensorRT FP16 superou os resultados ONNX FP16 publicados em todas as GPUs e para todos os tamanhos de modelo, com precisão dentro de 0.001 mAP50-95. Se você implantar nesses GPUs NVIDIA e precisar de baixa latência, comece com TensorRT FP16.
- INT8 não é uma vitória garantida. No YOLO26n, foi mais lento do que TensorRT FP16 em 17 das 19 GPUs e teve uma perda de 0.04 mAP50-95. Em modelos maiores, foi mais vantajoso com maior frequência, chegando a 1.67x no YOLO26x em uma L4, mas com uma perda de 0.034 a 0.076 mAP50-95.
- Não há resultados ONNX para as sete GPUs Blackwell. A página do benchmark atribui isso à ausência de kernels Blackwell no ambiente de teste do ONNX Runtime. O TensorRT foi executado nas sete GPUs.
Esses resultados abrangem a configuração da página de benchmarks, com lote 1 e 640 pixels; portanto, faça o benchmark do seu próprio modelo no dispositivo de implantação e com seus próprios dados antes de escolher.
FP16 vs INT8 com TensorRT#
A precisão reduzida é outra alavanca importante, e o benchmark mostra por que é preciso testá-la:
- FP16 (precisão de 16 bits) reduz pela metade o tamanho dos pesos e das ativações em comparação com FP32. Nos benchmarks da Ultralytics Platform, o TensorRT FP16 teve precisão equivalente à do ONNX FP16 e do PyTorch FP16, com diferença de até 0.003 mAP50-95.
- INT8 armazena pesos e ativações como inteiros de 8 bits, uma forma de quantização de modelos. É necessário fazer a calibração: um conjunto representativo de imagens é processado pelo modelo para medir os intervalos das ativações. O benchmark da Ultralytics Platform usou o NVIDIA ModelOpt com COCO128 como dados de calibração.
Como explica a metodologia do benchmark, INT8 traz mais benefícios em modelos maiores e limitados pela capacidade de processamento. Nos menores modelos, o trabalho adicional de quantização pode igualar ou até reduzir a velocidade do FP16. Calibre com imagens do seu próprio domínio e, em seguida, valide a precisão com seus próprios dados antes de implantar um mecanismo INT8.
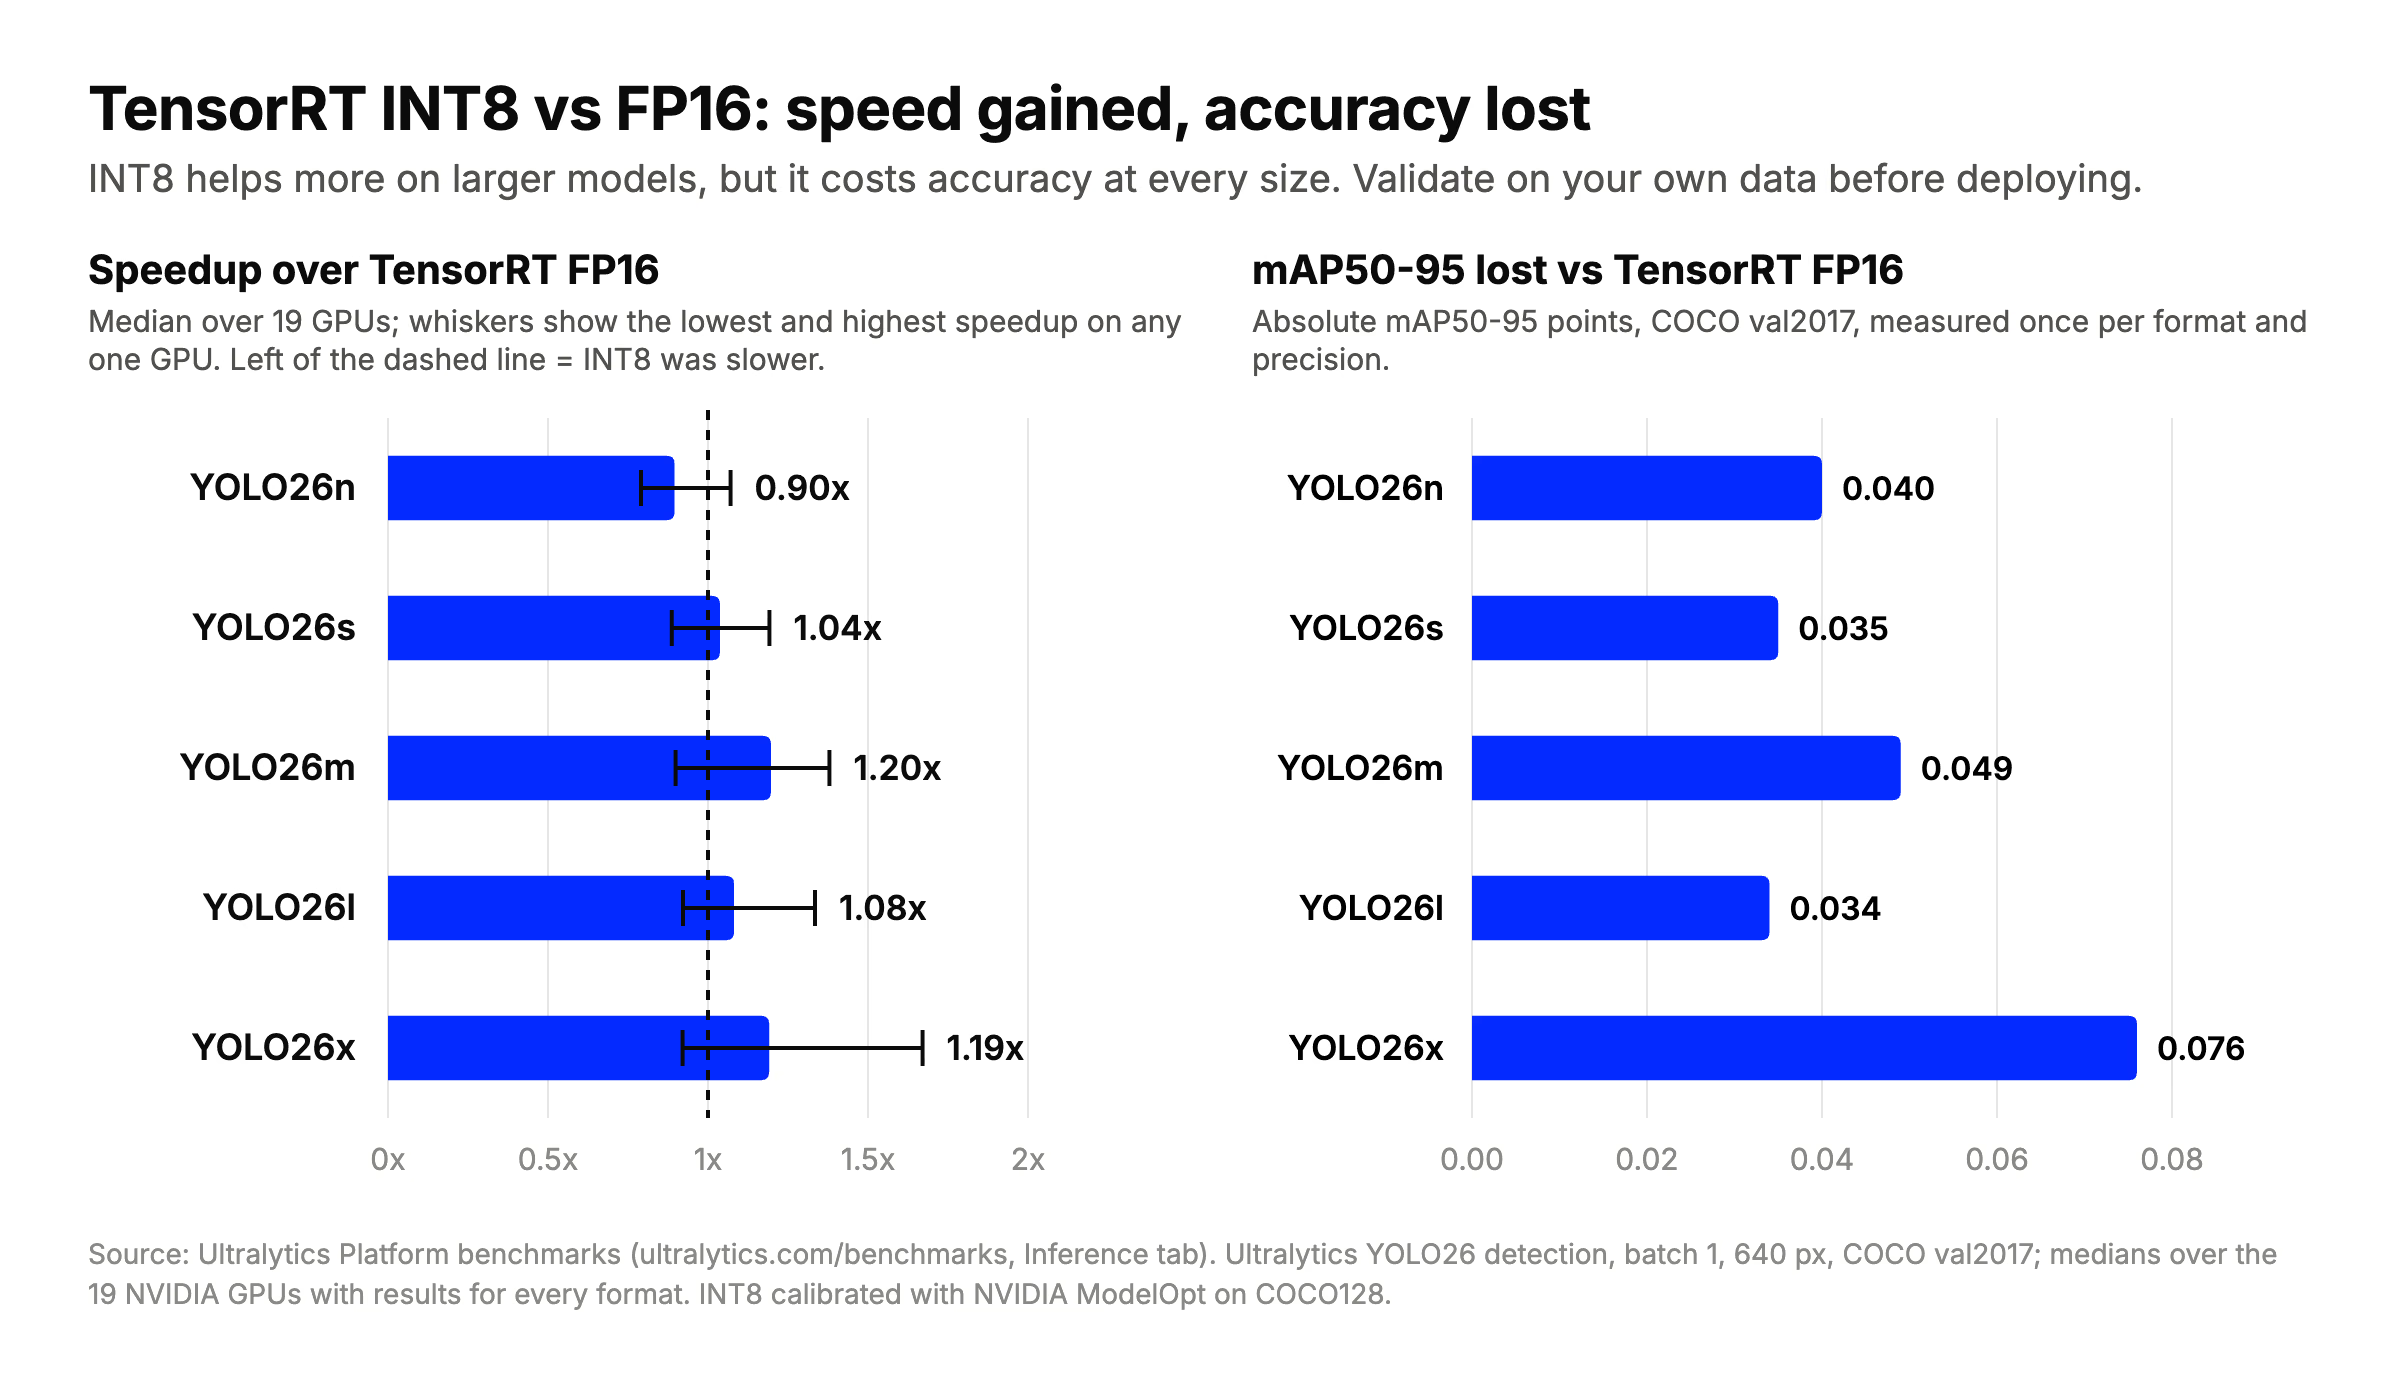
Na mediana, INT8 foi mais lento do que FP16 no YOLO26n e até cerca de 1.2x mais rápido nos modelos maiores nas 19 GPUs, com uma perda de 0.034 a 0.076 mAP50-95 em todos os tamanhos. Calculado a partir dos benchmarks de inferência da Ultralytics Platform.
Portabilidade do mecanismo e tamanhos dinâmicos de entrada#
Por padrão, um mecanismo TensorRT depende da GPU em que foi compilado e da versão do TensorRT usada; portanto, um mecanismo compilado em uma RTX 4090 não foi feito para ser copiado para uma H100 ou um Jetson. O TensorRT tem opções de compatibilidade de hardware e versão que flexibilizam essa regra, mas a opção segura é compilar no dispositivo de implantação ou para ele e recompilar após uma atualização do TensorRT. Por esse motivo, na Ultralytics Platform, a aba Exportação pede que você escolha um tipo de GPU para exportações TensorRT. Um arquivo ONNX não tem essa dependência: o mesmo arquivo funciona onde houver ONNX Runtime e um provedor de execução adequado.
Os dois formatos aceitam tamanhos de entrada variáveis. Para TensorRT, formas dinâmicas precisam de um perfil de otimização que defina as dimensões mínimas, ideais e máximas de entrada, e as entradas em tempo de execução precisam estar dentro desses limites. Ao exportar modelos Ultralytics YOLO, dynamic=True habilita formas dinâmicas de entrada para ONNX e TensorRT. Formas fixas dão ao TensorRT mais margem para otimizar, como explica o guia de formas dinâmicas da NVIDIA; portanto, use formas dinâmicas quando suas entradas realmente variarem e compare o desempenho dos dois casos.
Quando escolher ONNX Runtime e quando escolher TensorRT#
- GPU NVIDIA na nuvem ou local, latência é importante: TensorRT, começando com FP16. Experimente INT8 em modelos maiores após calibrá-lo e validar os resultados.
- NVIDIA Jetson na borda: TensorRT. Consulte o guia da NVIDIA Jetson.
- CPU, hardware que não seja NVIDIA ou infraestrutura mista: ONNX com ONNX Runtime, usando o provedor de execução compatível com cada máquina.
- Você ainda não sabe qual será o hardware de implantação: exporte primeiro para ONNX. Depois, você pode compilar um mecanismo TensorRT a partir do mesmo modelo.
- CPUs, GPUs ou NPUs Intel: considere o OpenVINO, o kit de ferramentas de inferência da Intel.
Para ver a lista completa de formatos e como eles se comparam, consulte o guia de opções de implantação de modelos. A precisão não é a única alavanca: o tamanho do modelo e a resolução de entrada também importam, e nosso guia de poda e quantização aborda mais duas formas de reduzir um modelo.
Exportando Ultralytics YOLO para ONNX e TensorRT#
O Ultralytics YOLO exporta para os dois formatos com um argumento format, e você pode executar a predição ou a validação diretamente no modelo exportado:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16, para ONNX Runtime
model.export(format="engine", quantize=16)  # Mecanismo TensorRT FP16, compilado nesta GPU
# Para usar INT8, calibre com um YAML de conjunto de dados (coco8.yaml é um pequeno conjunto demonstrativo; use o seu):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 seleciona FP16 e quantize=8 seleciona INT8. As duas exportações de mecanismo gravam yolo26n.engine; portanto, execute uma ou outra. Para INT8, indique em data o YAML do seu próprio conjunto de dados, para que a calibração use imagens semelhantes às que você usará na implantação. Consulte os argumentos de exportação e os guias de integração de ONNX e TensorRT para ver todas as opções, ou siga nossas publicações passo a passo sobre exportar para ONNX e otimizar com TensorRT. Você também pode exportar modelos treinados no navegador na Ultralytics Platform.
Perguntas frequentes
ONNX é um formato de modelo, não um mecanismo; portanto, a comparação justa é ONNX Runtime vs TensorRT. Nos benchmarks da Ultralytics Platform do Ultralytics YOLO26 em 19 GPUs NVIDIA, o TensorRT FP16 foi mais rápido do que os resultados ONNX FP16 publicados com ONNX Runtime em todas as GPUs, com ganhos de velocidade medianos calculados entre 1.85x e 2.55x nos vários tamanhos de modelo e diferenças de mAP50-95 de, no máximo, 0.001. O benchmark não informa qual provedor de execução do ONNX Runtime gerou os resultados ONNX, e nenhum resultado está identificado como usando o provedor de execução TensorRT do ONNX Runtime; por isso, teste essa combinação por conta própria se precisar da API do ONNX Runtime.
Sim. Normalmente, ONNX é a entrada do TensorRT: seu analisador ONNX lê o modelo e compila um mecanismo a partir dele. O ONNX Runtime também pode chamar o TensorRT por meio do provedor de execução TensorRT.
Não. Nos benchmarks da Ultralytics Platform, TensorRT INT8 foi mais lento do que TensorRT FP16 para YOLO26n em 17 das 19 GPUs. Foi mais rápido com maior frequência nos modelos maiores, com uma mediana de cerca de 1.2x para YOLO26m e YOLO26x nas 19 GPUs que executaram todos os formatos. Em todos os casos, houve uma perda de 0.034 a 0.076 mAP50-95; portanto, valide primeiro um modelo INT8 com seus próprios dados.
Não conte com isso. Por padrão, um mecanismo TensorRT depende da GPU e da versão do TensorRT usadas para compilá-lo; portanto, compile-o no dispositivo de implantação ou para ele. Mantenha o arquivo ONNX como cópia portátil e recompile o mecanismo para cada destino.
TensorRT costuma ser a escolha certa: o JetPack da NVIDIA inclui TensorRT, e compilar o mecanismo no próprio Jetson o otimiza para esse dispositivo. Os benchmarks acima não incluem o Jetson; portanto, faça medições no seu módulo antes de decidir. O guia da NVIDIA Jetson explica a configuração e a exportação para o Ultralytics YOLO.
Escrito por
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









