Qwen4-Max para anotação automática: conjuntos de dados com resultados de destaque e ganhos desiguais
Qwen4-Max ocupa o 13.º lugar entre 51 no nosso benchmark de anotação automática, fica em primeiro lugar em radiografias de punho e em segundo em prateleiras de lojas. Precisão, custo e como executá-lo.
 Miles Deans14 min de leitura
A Alibaba lançou o Qwen4-Max em 16 de novembro de 2026, chamando-o de modelo mais capaz da família Qwen até hoje, com visão nativa e uma janela de contexto de um milhão de tokens. No mesmo dia, testamos o modelo no UL37, nosso benchmark de detecção com 36 conjuntos de dados.
No geral, o Qwen4-Max ocupa o 13.º lugar entre 51 modelos em nosso VLM Leaderboard, com 0.474 mAP50 a US$ 5.68 por 1.000 imagens. Essa média esconde um resultado ainda melhor. Em radiografias pediátricas de punho, alcança a maior pontuação de qualquer modelo que testamos e fica atrás apenas do Gemini 4 Carbon em cenas subaquáticas e prateleiras de lojas com produtos muito próximos.
O Qwen4-Max agora é a opção da Alibaba para anotação automática na Ultralytics Platform, substituindo o Qwen3.8-Max. A seguir, veja onde ele se destaca, onde fica aquém, como se compara aos modelos que você consideraria e quanto custa um lote de anotações.
Qwen4-Max ocupa o 13.º lugar entre 51 no UL37 e o primeiro em radiografias de punho#
O UL37 mede o quanto as caixas de um modelo correspondem às anotações humanas em 360 imagens: 10 de cada um dos 36 conjuntos de dados reais de detecção de objetos, que abrangem desde exames médicos e imagens aéreas até prateleiras de lojas, esportes e placas de circuito. Cada conjunto de dados tem o mesmo peso na média, e todas as imagens passam pelo mesmo fluxo de produção que os usuários da Platform recebem, com os nomes de classe próprios do conjunto de dados e o SAM 3.1 refinando cada caixa. Assim, as pontuações descrevem esse fluxo refinado, não a saída bruta do modelo. A metodologia é pública.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Posição no ranking | #13 de 51 | #15 de 51 | #3 de 51 | #11 de 51 | #16 de 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Precisão | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Revocação | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Custo do fornecedor por 1.000 imagens | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Tempo mediano por imagem | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Solicitações com falha | 0% | 1.7% | 0% | 0% | 6.4% |
Resultados do UL37 no Ultralytics VLM Leaderboard, atualizados em 19 de novembro de 2026. O Qwen3.8-Max não está mais disponível na Platform.
O Qwen4-Max supera o Qwen3.8-Max em todas as métricas principais, custa menos por imagem e concluiu todas as solicitações do benchmark. Mesmo assim, fica bem atrás dos líderes na média: o GPT-6.1 Terra alcança 0.560 por um preço menor e em menos da metade do tempo.
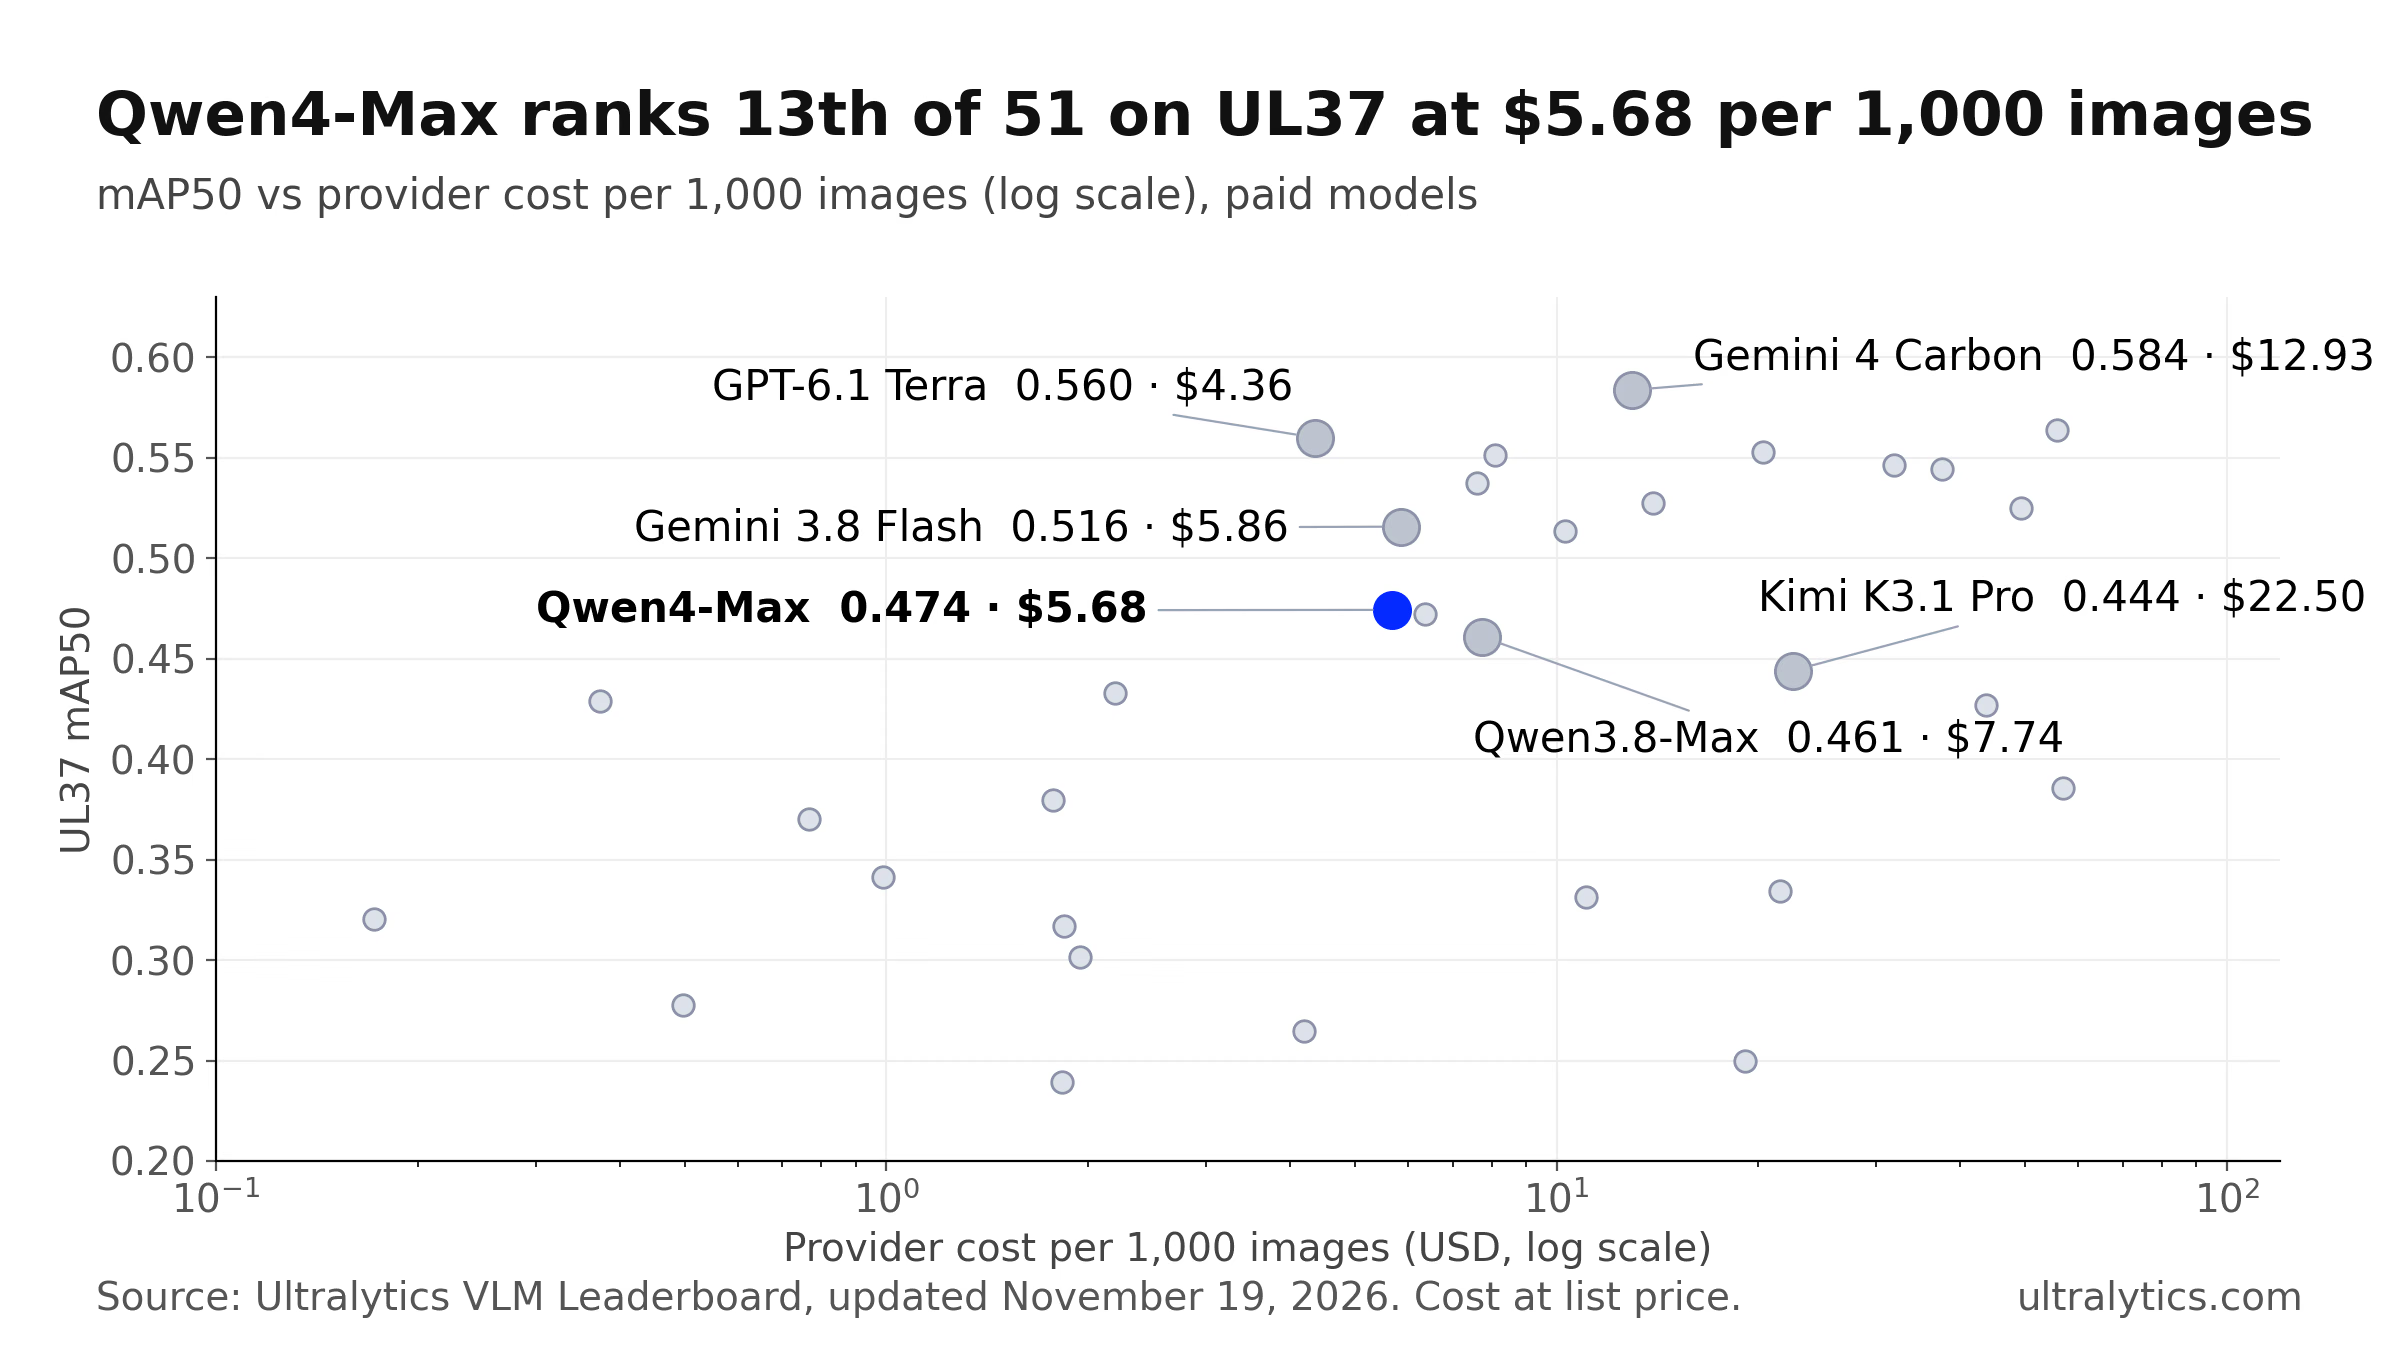
Cada ponto representa um modelo pago no Ultralytics VLM Leaderboard.
Para que a Alibaba desenvolveu o Qwen4-Max#
No anúncio de lançamento, a Alibaba descreve o Qwen4-Max como um modelo esparso de Mistura de Especialistas, com 2,4 trilhões de parâmetros no total, dos quais 71 bilhões são ativados por token, e visão nativa. A empresa destaca programação, tarefas agênticas e raciocínio visual, e informa que, no benchmark próprio Work360, o Qwen4-Max supera o Qwen3.8-Max e reduz em cerca de 60% o custo médio por tarefa.
As notas de lançamento do Model Studio da Alibaba Cloud o descrevem como “o modelo multimodal emblemático de próxima geração da família Qwen, que combina geração de texto, compreensão de imagens e vídeos e raciocínio profundo”. Seu preço internacional é de US$ 1.50 por milhão de tokens de entrada e US$ 4.50 por milhão de tokens de saída, abaixo dos US$ 2 e US$ 6 do Qwen3.8-Max. O modelo está disponível pela API da Alibaba; a empresa informa que modelos Qwen4 menores e com pesos abertos serão lançados em seguida.
Nem o anúncio nem as notas de lançamento apresentam resultados de detecção de objetos, então foi isso que medimos.
Qwen4-Max vs. Qwen3.8-Max: mais barato, com ganhos desiguais#
O Qwen4-Max supera seu antecessor em 19 conjuntos de dados, fica atrás em 16 e empata em um. Seu ganho médio de 0.013 mAP50 vem de grandes melhorias em alguns conjuntos de dados, que compensam quedas nítidas em outros.
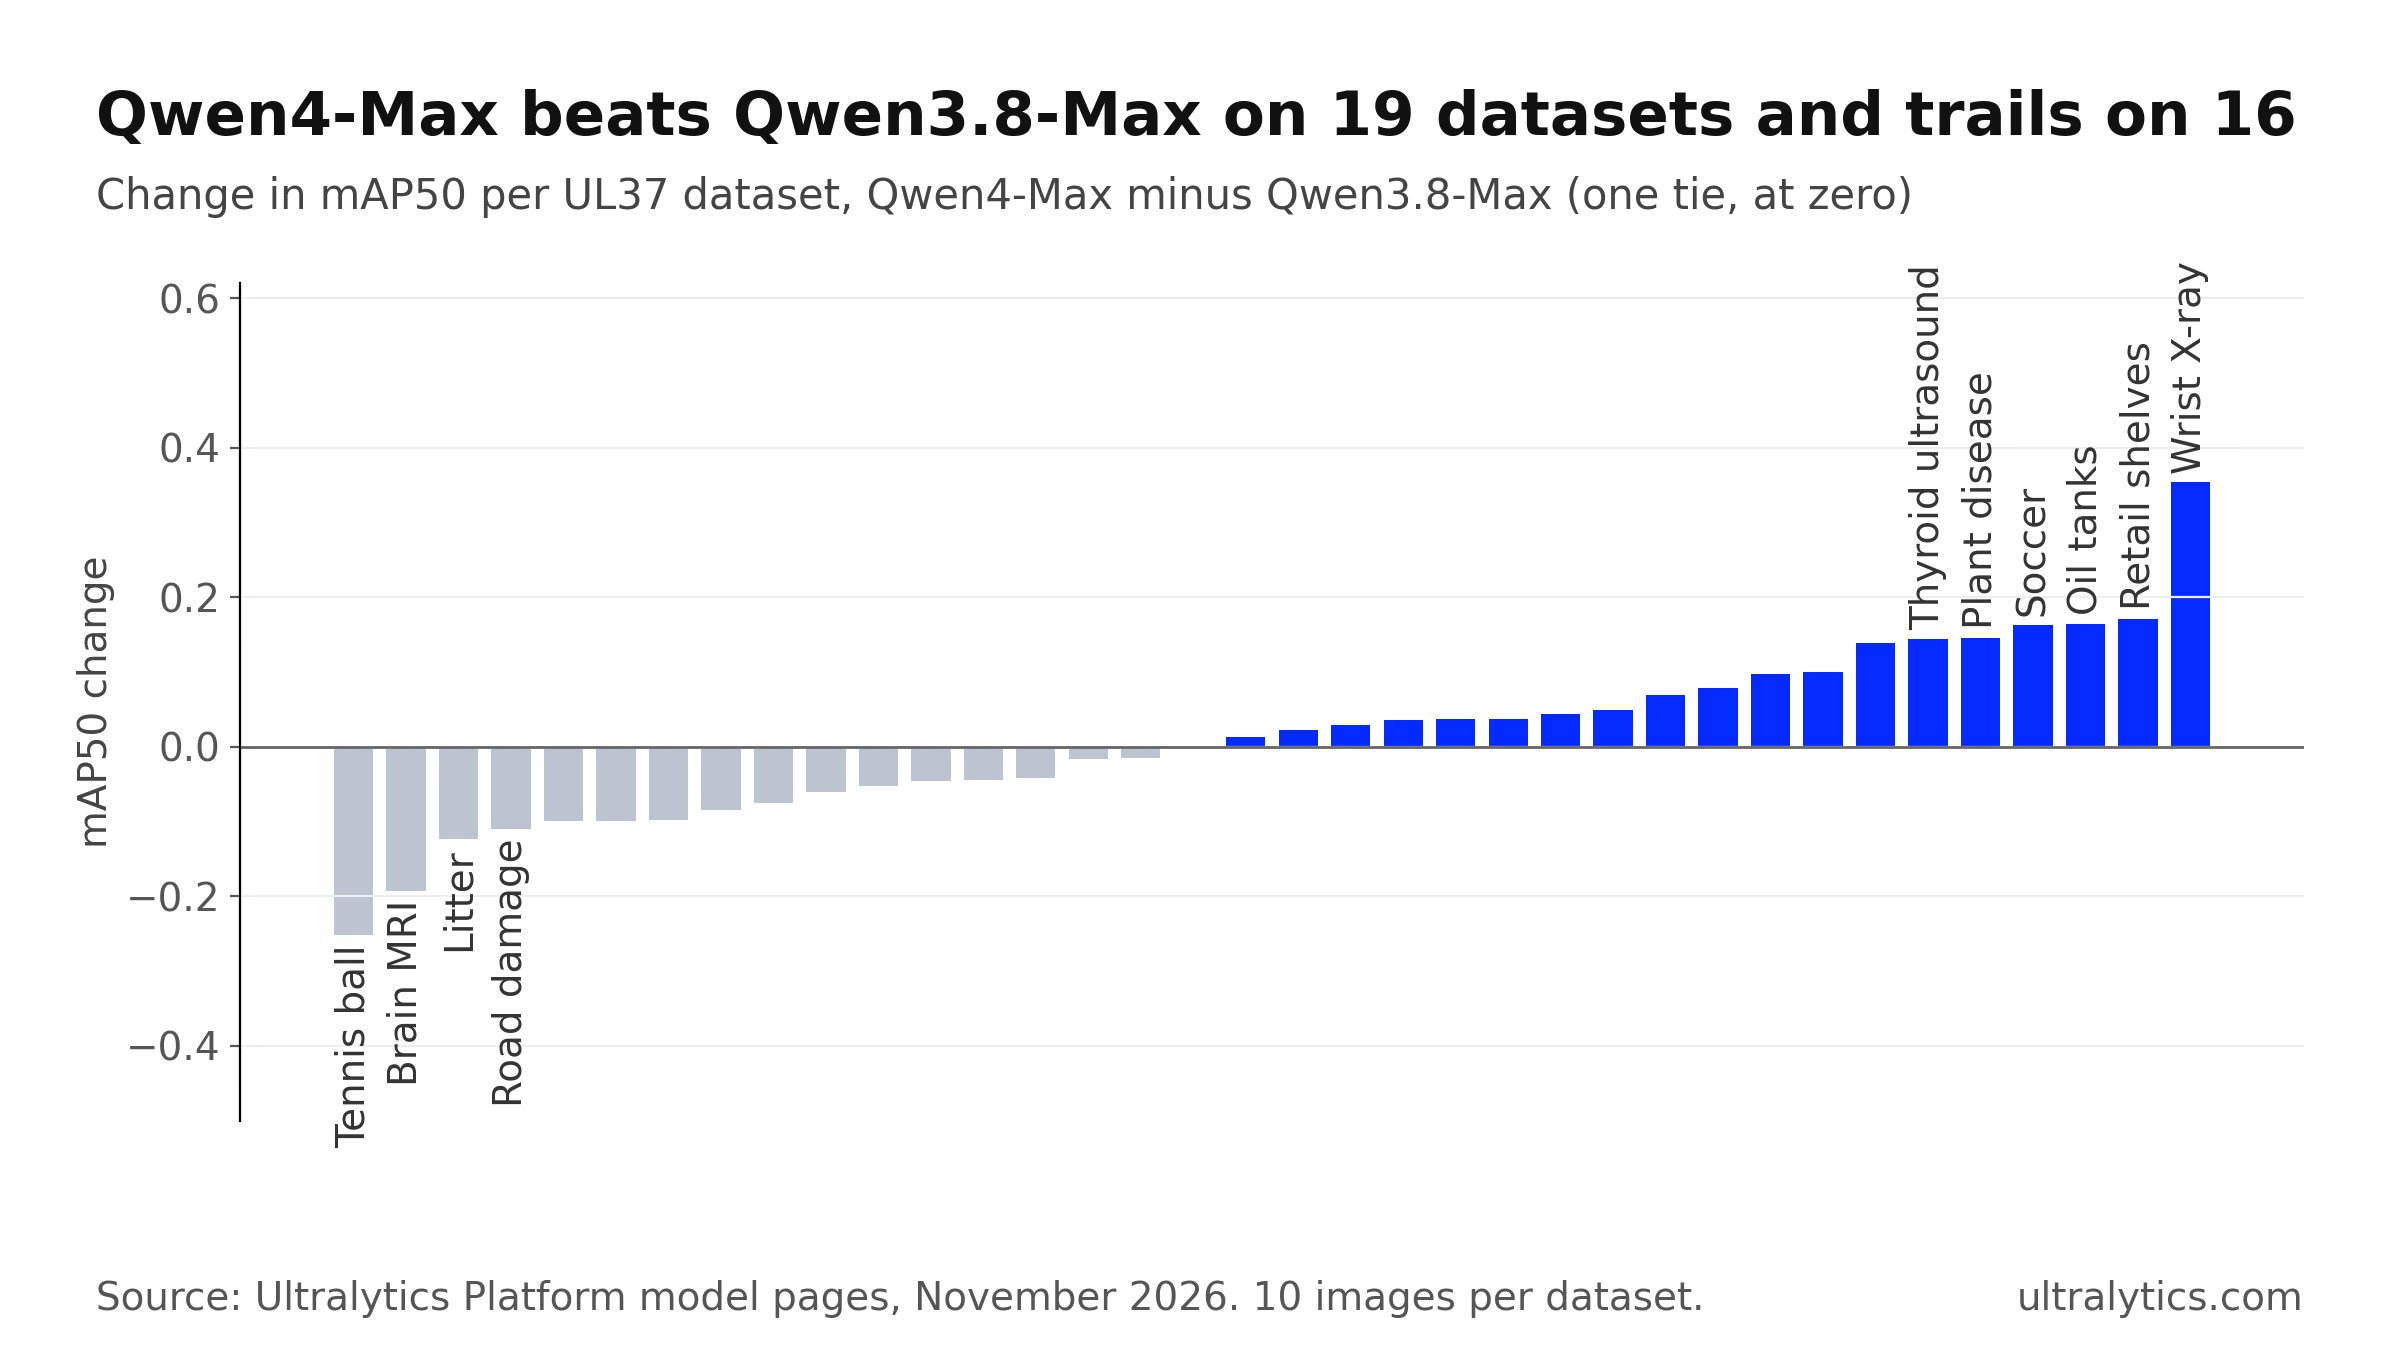
Cada barra representa um conjunto de dados do UL37, ordenado da maior queda ao maior ganho.
| Conjunto de dados | Qwen4-Max | Qwen3.8-Max | Variação |
|---|---|---|---|
| GRAZPEDWRI-DX radiografias pediátricas de punho | 0.4975 | 0.1437 | +0.3538 |
| SKU110K prateleiras de lojas com muitos produtos | 0.6230 | 0.4516 | +0.1714 |
| Airbus tanques de armazenamento de petróleo | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB futebol | 0.8345 | 0.6715 | +0.1630 |
| RacketVision bola de tênis | 0.3775 | 0.6299 | −0.2524 |
| Cheng ressonância magnética de tumor cerebral | 0.4421 | 0.6350 | −0.1929 |
mAP50 no UL37 por conjunto de dados, 10 imagens cada, exibido com quatro casas decimais para que cada variação corresponda às duas pontuações.
A redução de custo é mais evidente. A US$ 5.68 por 1.000 imagens, contra US$ 7.74, o Qwen4-Max custa cerca de 27% menos por imagem em nosso teste. O valor de cerca de 60% informado pela própria Alibaba vem de outro benchmark, com configurações diferentes, então os dois números não são diretamente comparáveis.
Onde o Qwen4-Max se destaca#
Três resultados colocam o Qwen4-Max entre os primeiros do ranking geral, não apenas entre os modelos da família Qwen.
| Conjunto de dados | Qwen4-Max | Posição entre 51 | Líder |
|---|---|---|---|
| GRAZPEDWRI-DX: radiografias pediátricas de punho | 0.4975 | 1st | Qwen4-Max (seguido por: Muse Ember 1.0, 0.378) |
| RUOD objetos subaquáticos | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K: prateleiras de lojas com muitos produtos | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
mAP50 no UL37 por conjunto de dados. Posição entre todos os 51 modelos no Ultralytics VLM Leaderboard.
Radiografias de punho. Em radiografias de trauma pediátrico do punho, o Qwen4-Max alcança 0.4975, à frente de todos os outros modelos que testamos e mais de três vezes acima do Qwen3.8-Max. Cada conjunto de dados contribui com 10 imagens, então considere isso um forte indício para testar, não uma conclusão definitiva. Também não é diagnóstico nem validação clínica: para anotações de pesquisa em análise de imagens médicas, o Qwen4-Max pode gerar caixas preliminares para especialistas clínicos verificarem e corrigirem.
Prateleiras de lojas. Na média dos dois conjuntos de dados de varejo do UL37, o Qwen4-Max alcança 0.752, acima dos 0.724 do GPT-6.1 Terra. No SKU110K, onde as prateleiras estão abarrotadas de produtos de uma única classe, fica atrás apenas do Gemini 4 Carbon.
Cenas subaquáticas. Em objetos subaquáticos do RUOD, sua pontuação de 0.774 ocupa o segundo lugar entre 51, acima dos 0.658 do GPT-6.1 Terra.
Onde o Qwen4-Max fica aquém#
As lacunas são tão evidentes quanto os bons resultados. O Qwen4-Max alcança 0.000 no DeepPCB, que avalia defeitos em placas sem componentes, e 0.05 no IEDXray, que avalia exames de segurança, enquanto os modelos Gemini 4 chegam a cerca de 0.30. Em radiografias de tórax para tuberculose, a pontuação é 0.037; no conjunto de dados de ressonância magnética de tumor cerebral, fica atrás do GPT-6.1 Terra por 0.442 a 0.904.
Na média por domínio, também fica atrás do GPT-6.1 Terra em documentos, interfaces de usuário e desenhos CAD (0.357 contra 0.494), estradas e trânsito (0.396 contra 0.572) e imagens médicas no geral (0.325 contra 0.505). Antes de anotar um conjunto de dados grande em qualquer uma dessas áreas, abra a página do modelo Qwen4-Max, que reproduz as caixas registradas em cada conjunto de dados do benchmark, ao lado das anotações esperadas.
Qwen4-Max vs. GPT-6.1 Terra, Gemini 3.8 Flash e Kimi K3.1 Pro#
| Comparação direta em 36 conjuntos de dados do UL37 | Vitórias do Qwen4-Max | Derrotas | Empates |
|---|---|---|---|
| vs. GPT-6.1 Terra | 11 | 23 | 2 |
| vs. Gemini 3.8 Flash | 17 | 18 | 1 |
| vs. Kimi K3.1 Pro | 21 | 14 | 1 |
| vs. Qwen3.8-Max | 19 | 16 | 1 |
O GPT-6.1 Terra é a melhor opção geral: vence em 23 conjuntos de dados contra 11 do Qwen4-Max, custa menos e tem um tempo de resposta mediano inferior à metade. O Gemini 3.8 Flash tem desempenho quase igual nos conjuntos de dados e preço semelhante, mas uma pontuação média mais alta. Contra o Kimi K3.1 Pro, o Qwen4-Max vence em 21 conjuntos de dados contra 14, com um custo por imagem cerca de quatro vezes menor.
Como a Ultralytics Platform executa o Qwen4-Max#
Duas configurações influenciam os resultados do Qwen4-Max na Platform. Primeiro, ele é executado com o esforço de raciocínio “low” da Alibaba, em vez do padrão “high”. Nos testes da Ultralytics com as 370 imagens do benchmark (as 360 imagens pontuadas mais 10 imagens de referência COCO), a configuração padrão ultrapassou o limite de solicitação de 115 segundos da Platform em 11 imagens, e a configuração “low” em 3, com o mesmo mAP50. Segundo, a Platform solicita aos modelos Qwen uma saída JSON compacta, pois sem ela perdem cerca de 0.02 mAP50.
Você não precisa fazer nada para aplicar essas configurações: escolha Qwen4-Max no seletor de modelos, e a Platform aplica ambas.
Quanto custa um lote de anotações com Qwen4-Max#
O custo do provedor corresponde ao uso de tokens informado pela Alibaba, calculado com as tarifas da Platform para o modelo por 1.000 imagens anotadas com sucesso; suas imagens podem consumir mais ou menos tokens. A Anotação em Lote acrescenta uma taxa de processamento da Platform de US$ 1.00 por 1.000 imagens, com um mínimo de US$ 0.01 por execução.
| Por 1.000 imagens | Qwen4-Max |
|---|---|
| Cobrança da Alibaba | $5.68 |
| Processamento da Ultralytics Platform | $1.00 |
| Total | $6.68 |
Você paga diretamente à Alibaba usando sua própria chave de API, inclusive pelas previsões de teste que executar primeiro, e a Ultralytics não cobra nenhuma margem sobre os tokens. Se preferir não usar uma chave paga, o Qwen3.8 27B hospedado é executado na Platform sem uma chave, com 0.351 mAP50 no UL37.
Como executar a anotação automática com Qwen4-Max na Ultralytics Platform#
O Qwen4-Max é um modelo guiado por classes para conjuntos de dados de detecção com 1 a 200 classes. Ele retorna caixas delimitadoras com os nomes de classe próprios do seu conjunto de dados, que você revisa e corrige.
- Crie uma chave de API no Model Studio da Alibaba Cloud para a região internacional (Singapura), que é o endpoint usado pela Platform.
- Peça ao proprietário do espaço de trabalho para adicioná-la em Alibaba, em Configurações > Chaves de API, no espaço de trabalho que contém seu conjunto de dados. A documentação sobre chaves do provedor traz todos os detalhes.
- No editor de anotações, mude para o modo Smart e escolha Qwen4-Max em Alibaba no seletor de modelos.
- Clique em Predict ou use
Pem algumas imagens representativas dos seus dados. - Quando estiveres satisfeito, abre a página do conjunto de dados e escolhe Mais ações > Batch Annotation para anotar todas as imagens sem etiquetas. A Batch Annotation funciona com conjuntos de dados alojados na Platform que tenham até três canais de imagem, e a Platform guarda primeiro uma versão do conjunto de dados para que possas reverter as alterações.
- Revê as caixas, guarda-as e treina um modelo Ultralytics YOLO26 com os resultados no mesmo espaço de trabalho.
A documentação de anotação explica detalhadamente os modos Smart e Batch Annotation, e o nosso guia sobre como escolher um VLM com base na precisão e na revocação ajuda-te a encontrar um modelo adequado ao teu fluxo de revisão.
Quem deve usar o Qwen4-Max#
| Se precisas de… | Comece com |
|---|---|
| Um anotador pago para uso geral | GPT-6.1 Terra: pontuação mais alta no UL37, custo menor e mais rápido que o Qwen4-Max |
| Rascunhos de radiografias pediátricas de punho para revisão por especialistas | Qwen4-Max: maior pontuação no UL37 entre 51 modelos neste conjunto de dados |
| Prateleiras de lojas com muitos produtos ou cenas subaquáticas | Qwen4-Max, comparado com o Gemini 4 Carbon nas suas imagens |
| Um modelo da Alibaba ou uma migração do Qwen3.8-Max | Qwen4-Max: pontuações mais altas, custo menor por imagem e nenhuma solicitação com falha em nosso teste |
| Sem chave de API paga | Qwen3.8 27B hospedado, Gemma 4 26B ou SAM 3.1 Text na Platform |
Para a maioria dos trabalhos de anotação, o GPT-6.1 Terra continua sendo a melhor opção padrão. O Qwen4-Max vale a pena quando seus dados se parecem com os conjuntos de dados em que ele se destaca; por isso, teste-o primeiro com uma amostra das suas próprias imagens.
Perguntas frequentes
Ele ocupa o 13.º lugar entre 51 em nosso benchmark e tem alguns resultados de destaque. No benchmark UL37, alcança 0.474 mAP50, ocupa o 13.º lugar entre 51 modelos e não teve nenhuma solicitação com falha. Fica em primeiro lugar entre 51 em radiografias pediátricas de punho e em segundo em objetos subaquáticos e prateleiras de lojas com muitos produtos, mas tem resultados fracos em defeitos de placas de circuito e radiografias de segurança.
Na média, sim. O Qwen4-Max alcança 0.474 mAP50 contra 0.461, custa US$ 5.68 por 1.000 imagens contra US$ 7.74 e concluiu todas as solicitações, enquanto o Qwen3.8-Max falhou em 1.7%. Os ganhos são desiguais: supera o Qwen3.8-Max em 19 conjuntos de dados e fica atrás em 16, com quedas acentuadas na detecção de bolas de tênis e em ressonâncias magnéticas cerebrais.
Para rotulagem geral, o GPT-6.1 Terra: obtém 0.560 mAP50, supera o Qwen4-Max em 23 de 36 conjuntos de dados, custa $4.36 por 1.000 imagens e tem um tempo de resposta mediano de 5.1 segundos. Escolhe o Qwen4-Max quando os teus dados se assemelham aos conjuntos de dados em que se destaca, como radiografias de pulsos, prateleiras de lojas muito abastecidas ou cenas subaquáticas, e confirma o desempenho nas tuas próprias imagens.
Pode criar caixas preliminares para anotações de investigação, que serão revistas por especialistas; não faz diagnósticos. Obtém a pontuação UL37 mais alta entre 51 modelos em radiografias de pulsos pediátricos, com 0.4975 mAP50, mas tem uma média de 0.325 nos nossos oito conjuntos de dados médicos, abaixo dos 0.505 do GPT-6.1 Terra, e obtém resultados fracos em radiografias do tórax.
Cerca de $5.68 em cobranças da Alibaba: utilização de tokens reportada pela Alibaba, calculada segundo as tarifas da plataforma para o modelo, por cada 1.000 imagens anotadas com sucesso. O preço de tabela internacional da Alibaba é de $1.50 por milhão de tokens de entrada e $4.50 por milhão de tokens de saída. A Ultralytics Platform acrescenta uma taxa de $1.00 pela Anotação em Lote por cada 1.000 imagens, para um total de cerca de $6.68.
Cria uma chave de API internacional do Alibaba Cloud Model Studio, pede ao proprietário do teu espaço de trabalho que a adicione em Alibaba, em Settings > API Keys, e depois seleciona o Qwen4-Max no modo Smart do editor de anotações. Testa algumas imagens, executa a Anotação em Lote, revê as caixas e treina um modelo Ultralytics YOLO26 no mesmo espaço de trabalho.
Escrito por
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









