Tăng tốc Ultralytics YOLO26 với OpenVINO trên Intel Core Ultra Series 3 (Panther Lake)
Tìm hiểu cách xuất model Ultralytics YOLO26 sang định dạng OpenVINO và tăng tốc inference trên phần cứng Intel, bao gồm CPU, GPU và NPU.
Trong vài năm qua, AI và thị giác máy tính đã chuyển từ giai đoạn thử nghiệm thành một phần quan trọng trong hoạt động kinh doanh hằng ngày. Trên thực tế, các khảo sát cho thấy khoảng 88% tổ chức đã sử dụng AI trong ít nhất một mảng hoạt động kinh doanh.
Tuy nhiên, để biến việc ứng dụng này thành giá trị thực tế—dù trong hệ thống production hay dự án cá nhân—thường phụ thuộc vào khả năng vận hành thực tế của model sau khi triển khai. Trong nhiều tình huống thực tế, model thị giác máy tính như Ultralytics YOLO26 được triển khai trên thiết bị edge và nhiều loại phần cứng, thường là CPU, GPU tích hợp hoặc NPU, thay vì GPU cao cấp.
Đó là lúc hiệu năng có thể bắt đầu khác biệt và việc tối ưu hóa trở nên thiết yếu. Một model hoạt động tốt trong môi trường này có thể gặp khó khăn ở môi trường khác nếu không được tối ưu phù hợp với phần cứng bên dưới.
Để đơn giản hóa quy trình này, gói Python Ultralytics hỗ trợ export model YOLO26 sang các định dạng đã tối ưu như OpenVINO, giúp model chạy mượt mà trên phần cứng Intel mà không cần thay đổi workflow.
Ví dụ, khi export model Ultralytics YOLO26 sang định dạng OpenVINO, model có thể chạy hiệu quả hơn trên bộ xử lý Intel Core Ultra Series 3, với tốc độ inference GPU tăng tối đa gấp ba lần.
Trong bài viết này, chúng ta sẽ tìm hiểu cách tích hợp Ultralytics và OpenVINO được cập nhật giúp triển khai model YOLO26 dễ dàng hơn trên phần cứng Intel Core Ultra Series 3. Bắt đầu nhé!
Tổng quan về tích hợp Ultralytics x OpenVINO#
Gói Python Ultralytics cung cấp một giao diện duy nhất để huấn luyện, chạy inference và triển khai các model Ultralytics YOLO như YOLO26. Gói này hỗ trợ nhiều tích hợp cho các giai đoạn khác nhau trong workflow vision AI, từ huấn luyện và thử nghiệm đến triển khai và tối ưu hóa.
Một trong những tích hợp tập trung vào triển khai là OpenVINO toolkit, cho phép bạn export model Ultralytics YOLO26 sang định dạng tối ưu cho phần cứng Intel. Quy trình này chuyển đổi model YOLO sang định dạng chạy hiệu quả hơn trên CPU, GPU và NPU của Intel, bao gồm các hệ thống sử dụng bộ xử lý Intel® Core™ Ultra™ series.
Nhờ đó, việc chạy model trên nhiều thiết bị Intel trở nên đơn giản hơn mà không cần điều chỉnh thủ công cho từng cấu hình. Dù làm việc trên máy cục bộ, thiết bị edge hay hệ thống triển khai quy mô lớn, bạn đều có thể tái sử dụng cùng một model đã export.
Điểm khiến tích hợp này đặc biệt thiết thực là khả năng kết hợp liền mạch với workflow Ultralytics hiện có. Bạn có thể export model bằng chính giao diện dùng để huấn luyện và chạy inference mà không cần thêm công cụ hay thiết lập phức tạp.
Sau khi export, bạn có thể chạy inference với model thông qua gói Python Ultralytics hoặc OpenVINO Runtime, tùy theo mức độ kiểm soát và linh hoạt cần thiết.
Tìm hiểu kỹ hơn về OpenVINO và phần cứng Intel Panther Lake cho inference AI#
Trước khi tìm hiểu model Ultralytics YOLO26 đã export có thể chạy hiệu quả ra sao trên phần cứng Intel, hãy cùng tìm hiểu cách OpenVINO và phần cứng Intel phối hợp để hỗ trợ inference hiệu quả.
OpenVINO là toolkit mã nguồn mở được thiết kế để tối ưu hóa và chạy inference AI trên phần cứng Intel, bao gồm CPU, GPU tích hợp và NPU. Toolkit này cung cấp runtime thống nhất, cho phép chạy cùng một model trên các đơn vị tính toán khác nhau mà không cần viết lại model.
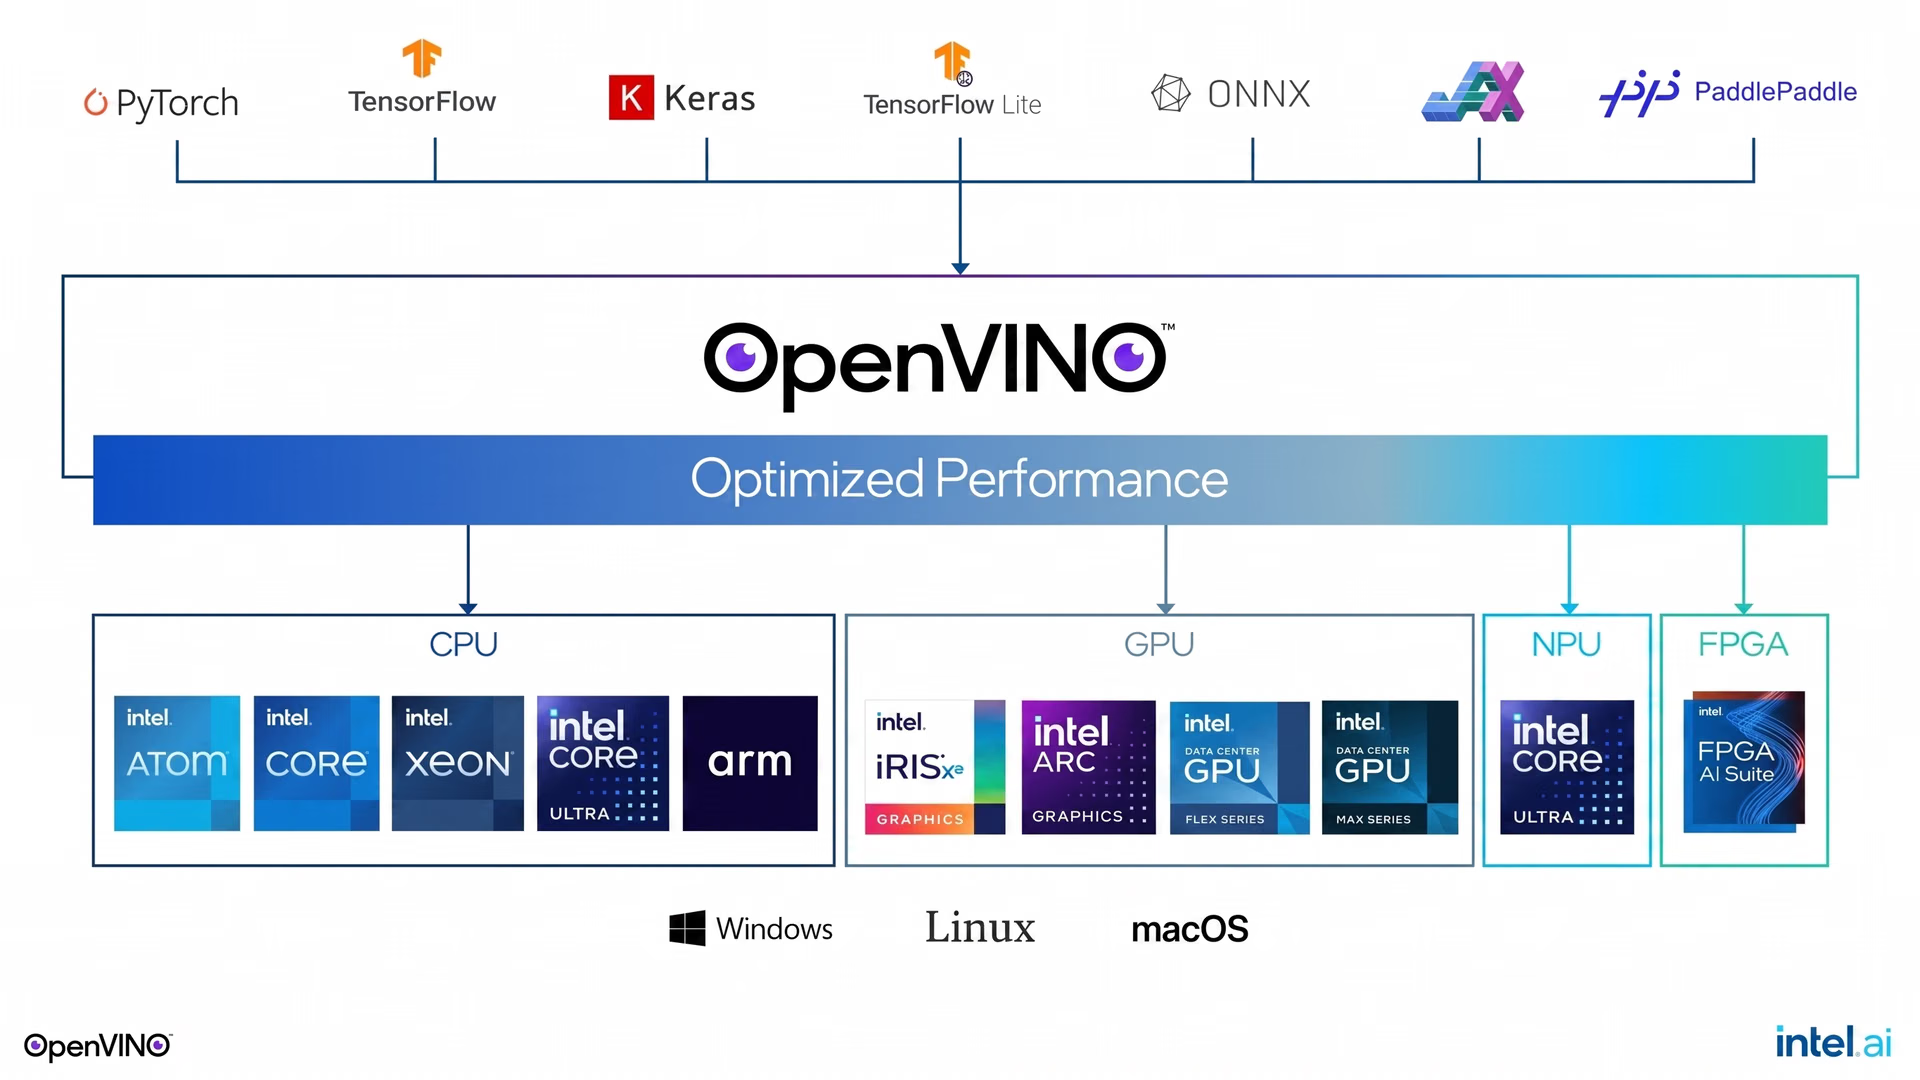
Hình 1. OpenVINO giúp dễ dàng triển khai model trên nhiều nền tảng phần cứng. (Nguồn)
Trên các bộ xử lý Intel® Core™ Ultra™ Series 3 mới (tên mã Panther Lake), workload AI chạy trên nhiều đơn vị tính toán bên trong cùng một bộ xử lý. Mỗi chip kết hợp các lõi CPU cho tác vụ đa dụng, GPU tích hợp để xử lý song song và NPU chuyên dụng được thiết kế riêng cho inference AI.
OpenVINO cung cấp API thống nhất cho phép bạn nhắm tới bất kỳ đơn vị tính toán nào trong số này—CPU, GPU hoặc NPU—mà không cần thay đổi code. Bạn chỉ cần chỉ định thiết bị chạy inference tại thời điểm chạy, nhờ đó dễ dàng chuyển đổi giữa cả ba tùy theo nhu cầu hiệu năng và hiệu quả.
Benchmark Ultralytics YOLO26 trên dòng Intel® Core™ Ultra™#
Khi tìm hiểu tích hợp Ultralytics và OpenVINO, có thể bạn sẽ thắc mắc: export YOLO26 sang định dạng OpenVINO giúp tăng hiệu năng model đến mức nào?
Chênh lệch về tốc độ inference trở nên rõ rệt khi benchmark model YOLO26 trên các định dạng và mức độ chính xác khác nhau. Chẳng hạn, khi chạy biến thể nano của YOLO26 (YOLO26n) trên Intel Core Ultra X7 358H, một bộ xử lý Panther Lake, thời gian inference giảm từ 25,18 ms mỗi ảnh với PyTorch ở độ chính xác FP32 xuống còn 2,64 ms với OpenVINO ở cùng độ chính xác, sử dụng NPU tích hợp.
Tốc độ này nhanh hơn mức cơ sở PyTorch FP32 ban đầu, tạo ra khác biệt đáng kể trong các ứng dụng thời gian thực và edge, nơi độ trễ là yếu tố then chốt. Mức tăng hiệu năng còn rõ rệt hơn khi chạy cùng model trên GPU Intel Arc tích hợp.
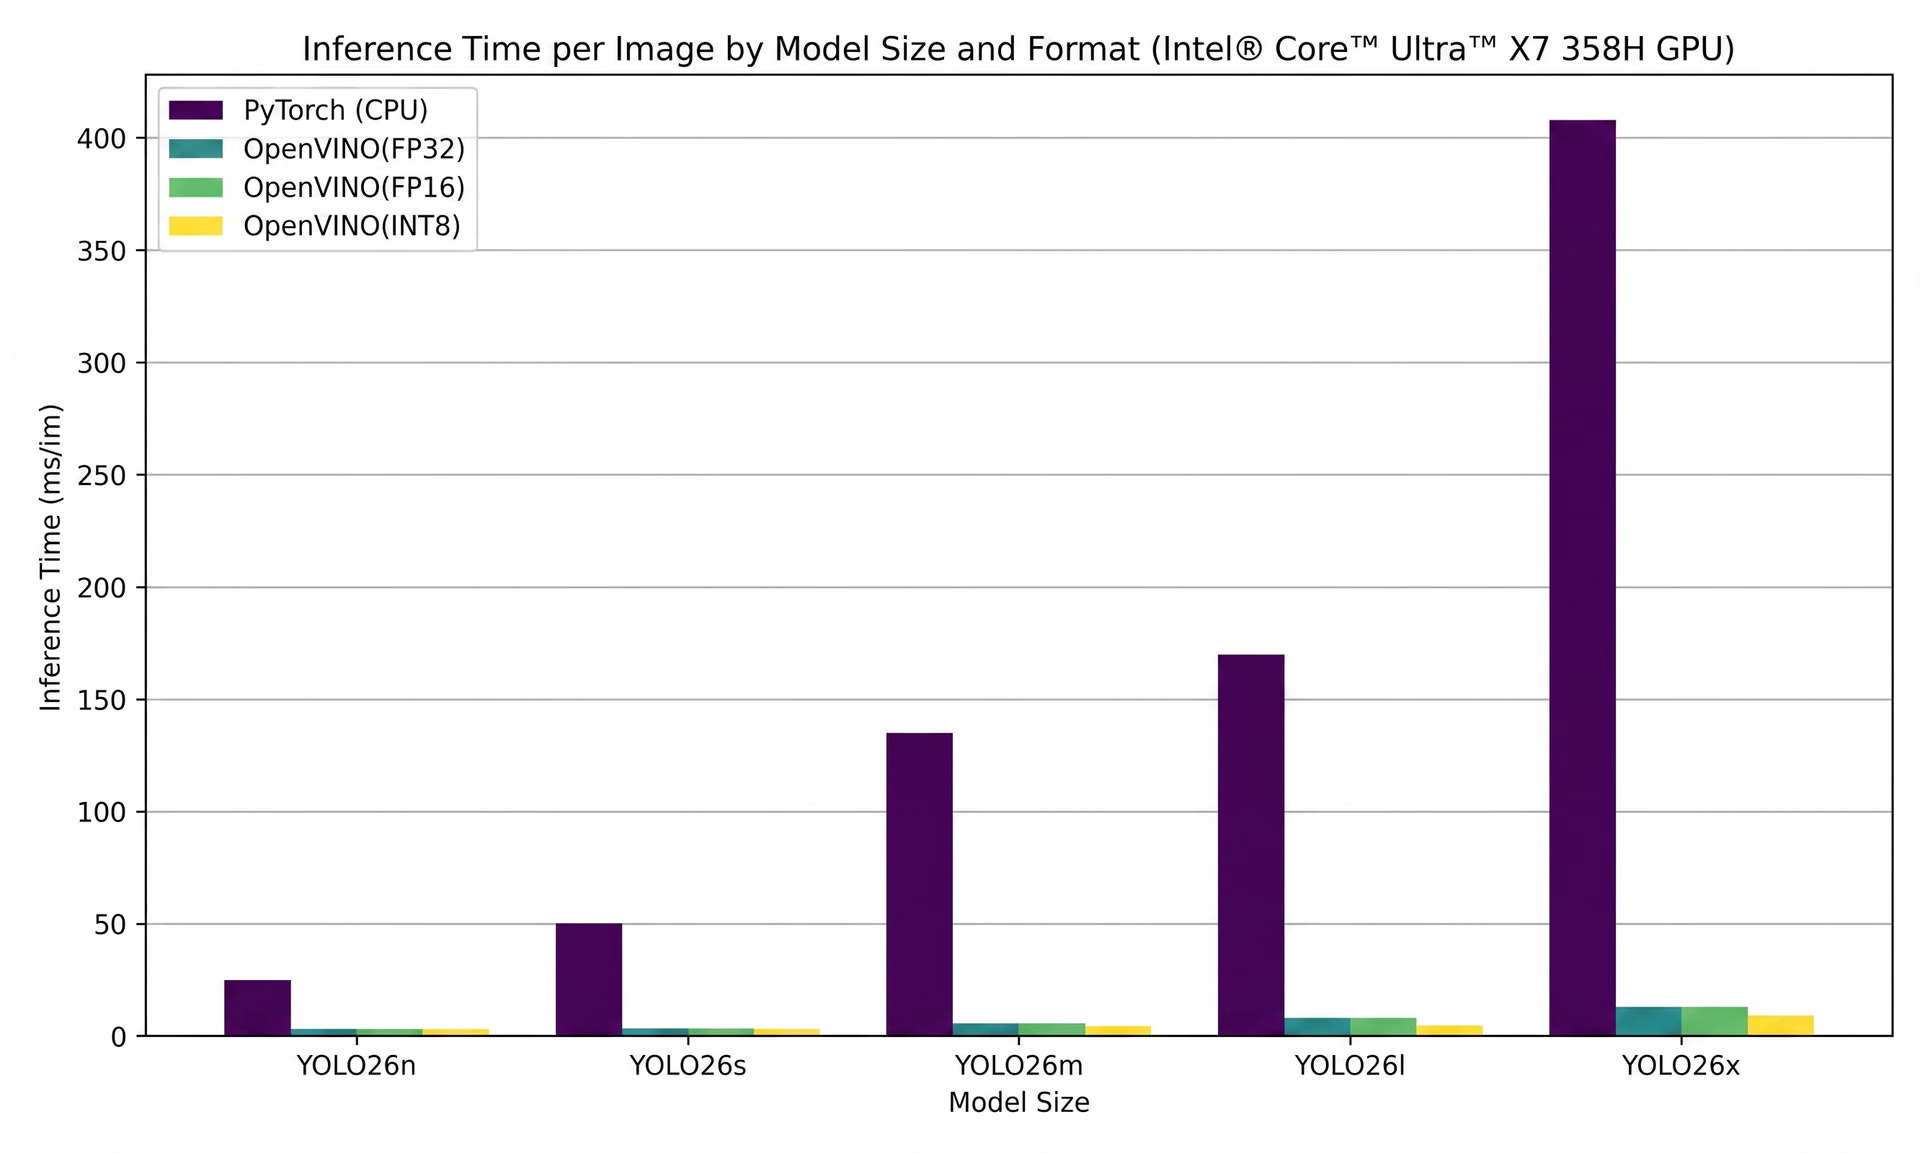
Hình 2. Benchmark inference Ultralytics YOLO26 trên GPU Intel Panther Lake bằng OpenVINO (Nguồn)
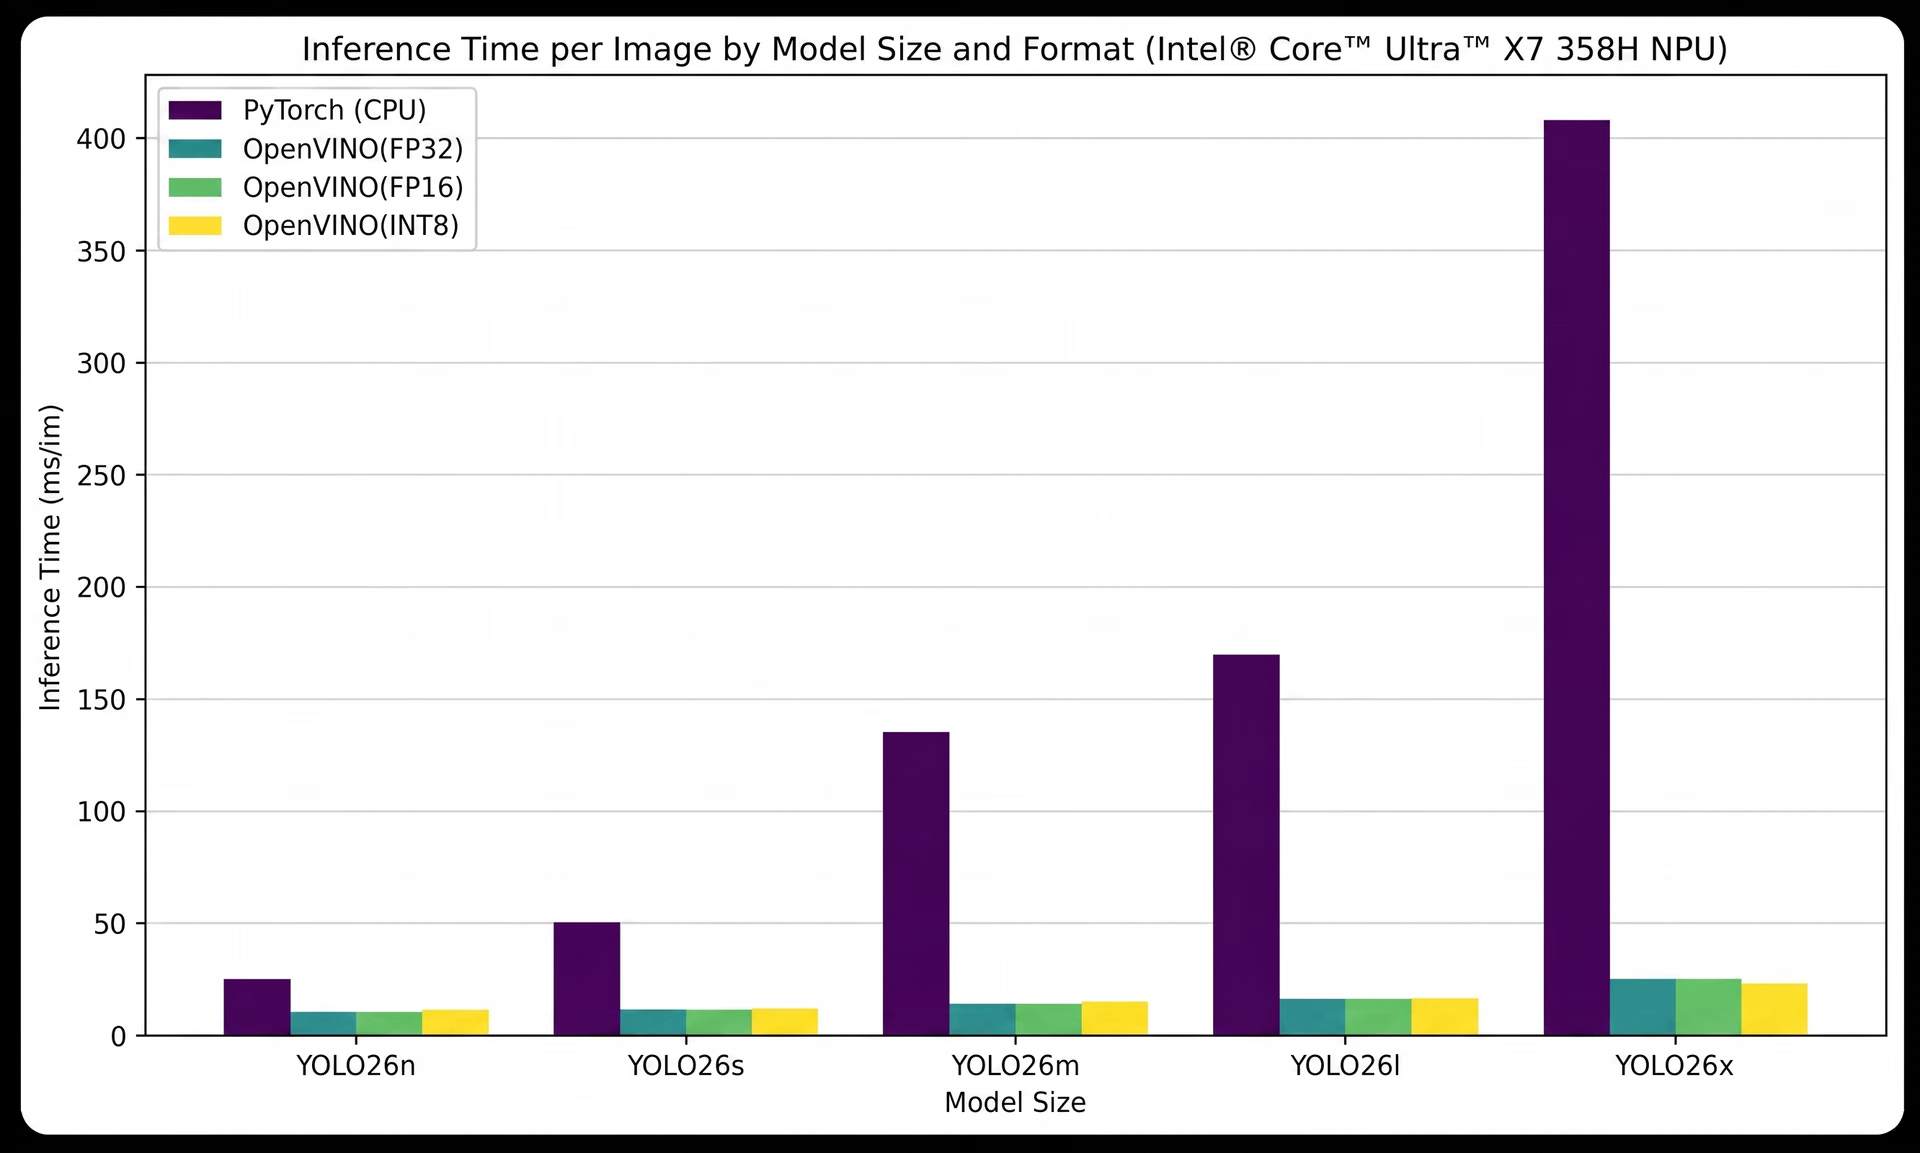
Hình 3. Benchmark inference Ultralytics YOLO26 trên NPU Intel Panther Lake bằng OpenVINO (Nguồn)
Tìm hiểu hai cách export Ultralytics YOLO26 sang định dạng OpenVINO#
Có hai cách chính để export model YOLO26 sang định dạng OpenVINO. Bạn có thể dùng gói Python Ultralytics hoặc export trực tiếp thông qua Ultralytics Platform, một workspace end-to-end để xây dựng và quản lý workflow thị giác máy tính tập trung tại một nơi. Tiếp theo, chúng ta sẽ hướng dẫn cả hai cách.
Dùng gói Python Ultralytics để export YOLO26#
Gói Python Ultralytics cung cấp cách đơn giản để export model YOLO26 sang định dạng OpenVINO trong workflow dựa trên code. Vì giao diện dùng cho cả huấn luyện và inference, việc export model dễ dàng tích hợp vào các pipeline hiện có mà không cần thêm công cụ.
Để bắt đầu, bạn có thể cài đặt gói Ultralytics bằng cách chạy lệnh “pip install ultralytics” trong terminal hoặc command prompt. Nếu đang làm việc trong môi trường tương tác như Jupyter Notebook hoặc Google Colab, bạn có thể chạy cùng lệnh đó bằng cách thêm dấu chấm than ở đầu.
Sau khi cài đặt, bạn có thể tải model YOLO26 đã huấn luyện và export trực tiếp sang định dạng OpenVINO. Như minh họa bên dưới, model YOLO26n tiền huấn luyện (yolo26n.pt) được tải lên rồi chuyển đổi sang định dạng OpenVINO bằng phương thức export.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
Sau khi chạy code, model đã chuyển đổi được lưu vào một thư mục mới để sử dụng khi triển khai.
Export YOLO26 trên Ultralytics Platform#
Nếu muốn có cách đơn giản hơn, không cần code, bạn có thể export model YOLO26 trực tiếp thông qua Ultralytics Platform. Nền tảng này tập hợp toàn bộ workflow thị giác máy tính vào một workspace duy nhất, giúp dễ dàng chuyển từ huấn luyện sang triển khai mà không cần thiết lập thêm.
Khi model đã sẵn sàng, bạn có thể mở model trên nền tảng và chuyển đến tab Export. Tại đây, bạn có thể chọn OpenVINO làm định dạng export và tùy chọn điều chỉnh các thiết lập như kích thước ảnh hoặc độ chính xác.
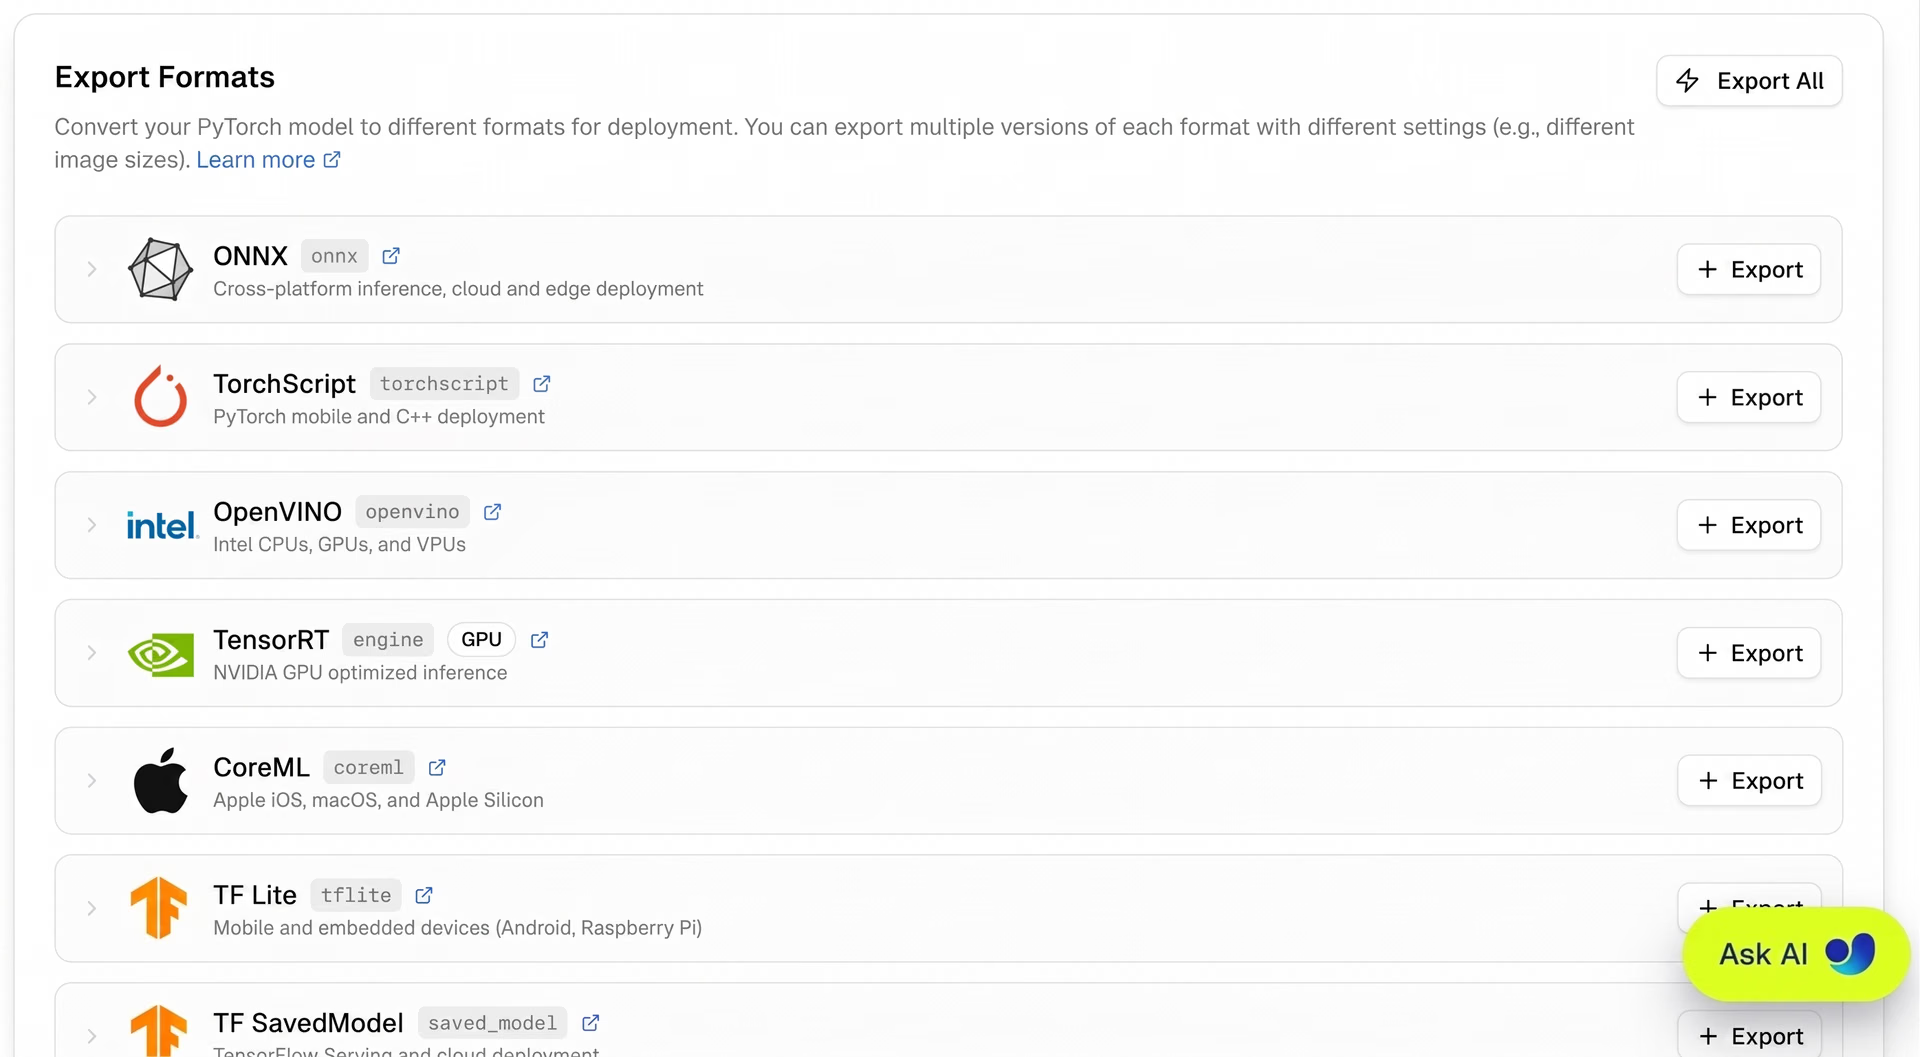
Hình 4. Minh họa thao tác export YOLO26 trên Ultralytics Platform
Nền tảng tự động xử lý việc chuyển đổi, vì vậy bạn không cần quản lý script, dependency hay cấu hình môi trường. Sau khi export hoàn tất, bạn có thể tải model đã tối ưu xuống và triển khai trên CPU, GPU và NPU của Intel.
Các tùy chọn triển khai nhờ tích hợp Ultralytics x OpenVINO#
Sau khi export model YOLO26 sang định dạng OpenVINO, có một vài cách chạy inference tùy theo workflow và mức độ kiểm soát cần thiết. Bạn có thể dùng gói Python Ultralytics để có cách tiếp cận đơn giản, tích hợp sẵn hoặc dùng OpenVINO runtime gốc để linh hoạt và kiểm soát tốt hơn.
Chạy inference bằng gói Python Ultralytics#
Sau khi export model sang định dạng OpenVINO, bạn có thể chạy inference bằng gói Python Ultralytics. Cách này phù hợp để kiểm thử nhanh và triển khai đơn giản, vì sử dụng cùng giao diện như khi huấn luyện và export.
Với cách này, bạn có thể tải model OpenVINO đã export từ thư mục chứa model và chạy inference trên đầu vào như ảnh hoặc video. Bạn cũng có thể chọn thiết bị chạy bằng cách chỉ định các tùy chọn như "intel:cpu", "intel:gpu" hoặc "intel:npu", tùy theo phần cứng có trên hệ thống.
Đoạn code bên dưới minh họa cách tải model đã export và chạy inference trên ảnh bằng GPU. Sau khi inference hoàn tất, ảnh đầu ra được lưu vào thư mục “runs/detect/predict”.
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
Tận dụng gói OpenVINO gốc để chạy inference#
Nếu cần kiểm soát nhiều hơn cách model vận hành trong production, bạn có thể dùng OpenVINO runtime gốc để chạy inference. Phương pháp này hữu ích khi tích hợp model vào ứng dụng lớn hơn hoặc khi muốn tinh chỉnh cách thực thi inference trên phần cứng cụ thể.
OpenVINO cung cấp phương thức thống nhất để chạy model trên CPU, GPU và NPU của Intel, cùng các tính năng như thực thi bất đồng bộ và sử dụng hiệu quả tài nguyên tính toán hiện có. Để thiết lập, bạn có thể làm việc trực tiếp với các file model đã export, bao gồm file .xml định nghĩa cấu trúc model và file .bin chứa trọng số đã huấn luyện.
Tùy trường hợp sử dụng, bạn cũng có thể điều chỉnh các thiết lập như kích thước đầu vào hoặc các bước tiền xử lý. Để thiết lập inference, cần khởi tạo OpenVINO runtime, tải và biên dịch model cho thiết bị mục tiêu, chuẩn bị dữ liệu đầu vào rồi chạy inference.
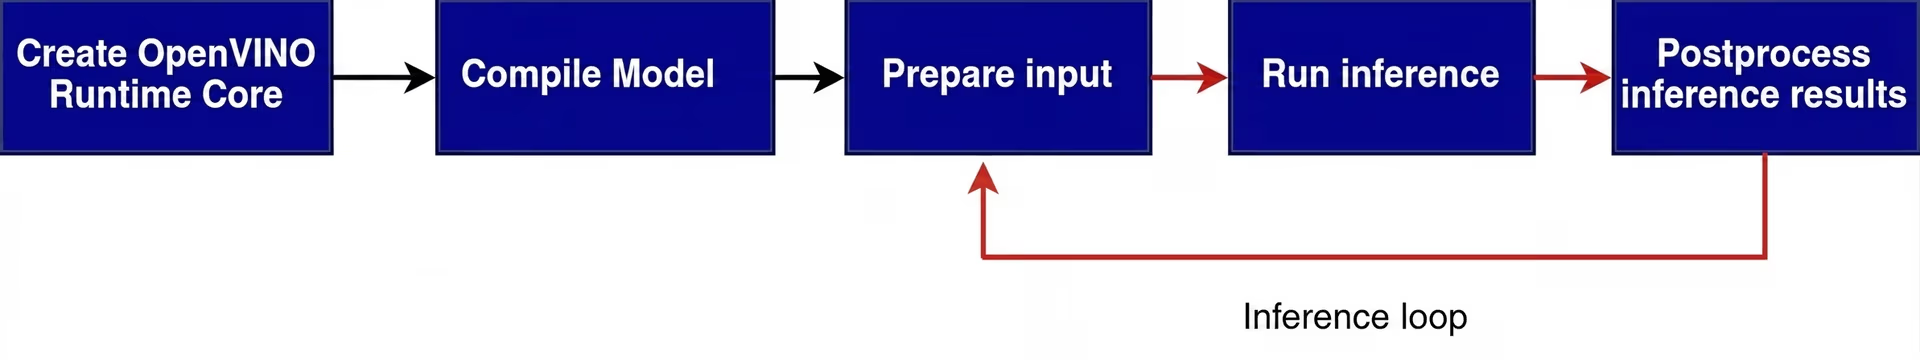
Hình 5. Ví dụ về pipeline inference điển hình với OpenVINO (Nguồn)
Nhờ vậy, bạn có thể kiểm soát cách thực thi model và cách model tích hợp vào quy trình triển khai tổng thể. Để tìm hiểu thêm cách thiết lập và chạy inference bằng OpenVINO runtime, hãy tham khảo Ultralytics tài liệu chính thức.
Ứng dụng thực tế của Ultralytics YOLO26 trên phần cứng Intel#
Giá trị thực sự của tích hợp Ultralytics và OpenVINO thể hiện rõ trong môi trường production, nơi inference ổn định với độ trễ thấp có thể tạo ra khác biệt thiết thực. Dưới đây là một số ngành tiêu biểu mà tích hợp này mang lại kết quả đáng kể:
- Sản xuất: Bằng cách export Ultralytics YOLO26 sang OpenVINO, các hệ thống trên dây chuyền sản xuất có thể tự động phát hiện lỗi trực quan như thiếu linh kiện, lệch vị trí hoặc hư hại bề mặt trên phần cứng Intel, góp phần nâng cao chất lượng sản phẩm và giảm lỗi gây tốn kém.
- Y tế: Các hệ thống chẩn đoán hình ảnh y tế và theo dõi bệnh nhân có thể chạy model Ultralytics YOLO26 đã export ngay trên phần cứng Intel, đáp ứng các yêu cầu nghiêm ngặt về quyền riêng tư dữ liệu mà vẫn duy trì hiệu năng inference ổn định.
- Thành phố thông minh: Có thể triển khai giám sát giao thông và phân tích đám đông bằng model Ultralytics YOLO26 đã export trên camera edge sử dụng Intel, tạo ra thông tin chuyên sâu theo thời gian thực như đếm phương tiện, theo dõi người đi bộ và phát hiện sự cố.
- Ô tô: Độ trễ thấp và hiệu quả năng lượng có ý nghĩa thiết yếu đối với hệ thống giám sát người lái và cảm biến trong cabin, khiến phần cứng Intel kết hợp với model Ultralytics YOLO26 đã export trở thành lựa chọn phù hợp cho các hệ thống ô tô nhúng.
Để tìm hiểu thêm về tích hợp này, hãy tham gia chuỗi workshop Intel OpenVINO DevCon với chủ đề “Từ gán nhãn đến triển khai: Xây dựng pipeline phát hiện đối tượng với Geti, Ultralytics YOLO26 và OpenVINO™”. Tại đây, Francesco Mattioli, Quản lý Đối tác và Hệ sinh thái của chúng tôi, sẽ cùng Adrian Boguszewski, Chuyên gia truyền bá phần mềm AI của Intel, trình diễn trực tiếp và hướng dẫn xây dựng pipeline thị giác máy tính sẵn sàng cho production trong các tình huống công nghiệp thực tế. Workshop sẽ giới thiệu workflow phát hiện đối tượng end-to-end hoàn chỉnh, từ tạo dataset và huấn luyện model đến tối ưu hóa và triển khai trên edge.
Lợi ích khi sử dụng định dạng export OpenVINO#
Dưới đây là một số ưu điểm chính của định dạng export OpenVINO:
- Dễ tiếp cận và tích hợp: Với API thống nhất và hơn 80 notebook hướng dẫn, OpenVINO giúp chuyển từ thử nghiệm sang triển khai dễ dàng hơn mà không làm tăng đáng kể độ phức tạp.
- Chạy cùng một model trên nhiều loại phần cứng: OpenVINO cho phép dùng một model đã export trên các phần cứng Intel được hỗ trợ, triển khai trên CPU, GPU hoặc NPU mà không cần viết lại hay điều chỉnh model cho từng thiết bị.
- Tối ưu hóa tích hợp sẵn trong quá trình export: Export sang OpenVINO chuyển đổi model từ các framework phổ biến như PyTorch và TensorFlow sang định dạng đã tối ưu, sẵn sàng chạy inference, loại bỏ nhu cầu thực hiện các bước chuyển đổi riêng.
- Tận dụng tài nguyên phần cứng tốt hơn: OpenVINO hỗ trợ inference bất đồng bộ và cân bằng tải trên phần cứng Intel, giúp cải thiện hiệu quả trong các ứng dụng thực tế.
Chạy Ultralytics YOLO26 với ExecuTorch và backend OpenVINO#
Nếu triển khai Ultralytics YOLO26 trong môi trường production đòi hỏi cao hơn, bạn có thể cân nhắc một lựa chọn khác kết hợp hiệu quả xử lý trên thiết bị với khả năng nén model nâng cao.
ExecuTorch, framework inference trên thiết bị của PyTorch, hỗ trợ backend OpenVINO, cho phép triển khai Ultralytics YOLO26 trên phần cứng Intel theo một quy trình export và runtime khác.
ExecuTorch xử lý việc export model và thực thi runtime, còn OpenVINO đóng vai trò lớp tăng tốc phần cứng bên dưới, đảm nhiệm tính toán thực tế trên CPU, GPU hoặc NPU của Intel. Hai công nghệ phối hợp để kết hợp tính di động và hiệu quả xử lý trên thiết bị của ExecuTorch với các tối ưu hóa đặc thù phần cứng mà OpenVINO cung cấp.
Để tìm hiểu thêm về cách thức hoạt động và bắt đầu sử dụng Ultralytics YOLO26 với ExecuTorch và backend OpenVINO, hãy xem bài viết trên blog Intel về các cập nhật mới nhất của ExecuTorch và OpenVINO.
Điểm chính cần ghi nhớ#
Export model YOLO26 thông qua tích hợp Ultralytics và OpenVINO giúp cải thiện hiệu năng trên phần cứng Intel mà không làm workflow phức tạp thêm. Bạn có thể chuyển từ huấn luyện sang triển khai mà không cần thiết kế lại pipeline. Nhìn chung, đây là cách đơn giản để chạy model hiệu quả trên CPU, GPU và NPU của Intel trong các ứng dụng thực tế.
Tham gia cộng đồng của chúng tôi và khám phá repository GitHub để tìm hiểu thêm về Vision AI. Xem các tùy chọn cấp phép để bắt đầu các dự án thị giác máy tính. Quan tâm đến những đổi mới như AI trong sản xuất hoặc thị giác máy tính trong ngành ô tô? Truy cập các trang giải pháp của chúng tôi để khám phá thêm.









