الربط بين معالجة اللغات الطبيعية والرؤية الحاسوبية
تعرّف على كيفية تكامل معالجة اللغات الطبيعية (NLP) والرؤية الحاسوبية (CV) لتحويل القطاعات من خلال أنظمة ذكاء اصطناعي أكثر ذكاءً ومتعددة الوسائط.
 Abirami Vina8 دقيقة قراءة

يُعد كل من معالجة اللغة الطبيعية (NLP) والرؤية الحاسوبية (CV) فرعين متميزين من فروع الذكاء الاصطناعي (AI)، وقد اكتسبا شعبية كبيرة في السنوات الأخيرة. وبفضل التقدم في الذكاء الاصطناعي، أصبح هذان الفرعان أكثر ترابطًا من أي وقت مضى.
من الأمثلة الرائعة على ذلك إنشاء أوصاف للصور تلقائيًا. إذ يمكن استخدام الرؤية الحاسوبية لتحليل محتوى الصورة وفهمه، بينما يمكن استخدام معالجة اللغة الطبيعية لإنشاء وصف لها. ويشيع استخدام إنشاء أوصاف الصور تلقائيًا على منصات التواصل الاجتماعي لتحسين إمكانية الوصول، وفي أنظمة إدارة المحتوى للمساعدة على تنظيم الصور ووسمها بكفاءة.
أفضت الابتكارات في معالجة اللغة الطبيعية والذكاء الاصطناعي للرؤية إلى العديد من التطبيقات في قطاعات متنوعة. وسنتناول في هذه المقالة معالجة اللغة الطبيعية والرؤية الحاسوبية بمزيد من التفصيل، ونناقش آلية عمل كل منهما. كما سنستكشف التطبيقات التي تستخدم هاتين التقنيتين معًا.
فهم معالجة اللغة الطبيعية والذكاء الاصطناعي البصري#
تركز معالجة اللغة الطبيعية على التفاعل بين الحواسيب واللغة البشرية. وهي تمكّن الآلات من فهم النصوص أو الكلام وتفسيرها وإنشائها بطريقة ذات معنى. ويمكن استخدامها لتنفيذ مهام مثل الترجمة أو تحليل المشاعر أو التلخيص.
في المقابل، تساعد الرؤية الحاسوبية الآلات على تحليل الصور ومقاطع الفيديو والتعامل معها. ويمكن استخدامها في مهام مثل اكتشاف الأجسام في صورة، والتعرف على الوجوه، وتعقب الأجسام، وتصنيف الصور. وتمكّن تقنية الذكاء الاصطناعي للرؤية الآلات من فهم العالم المرئي والتفاعل معه على نحو أفضل.
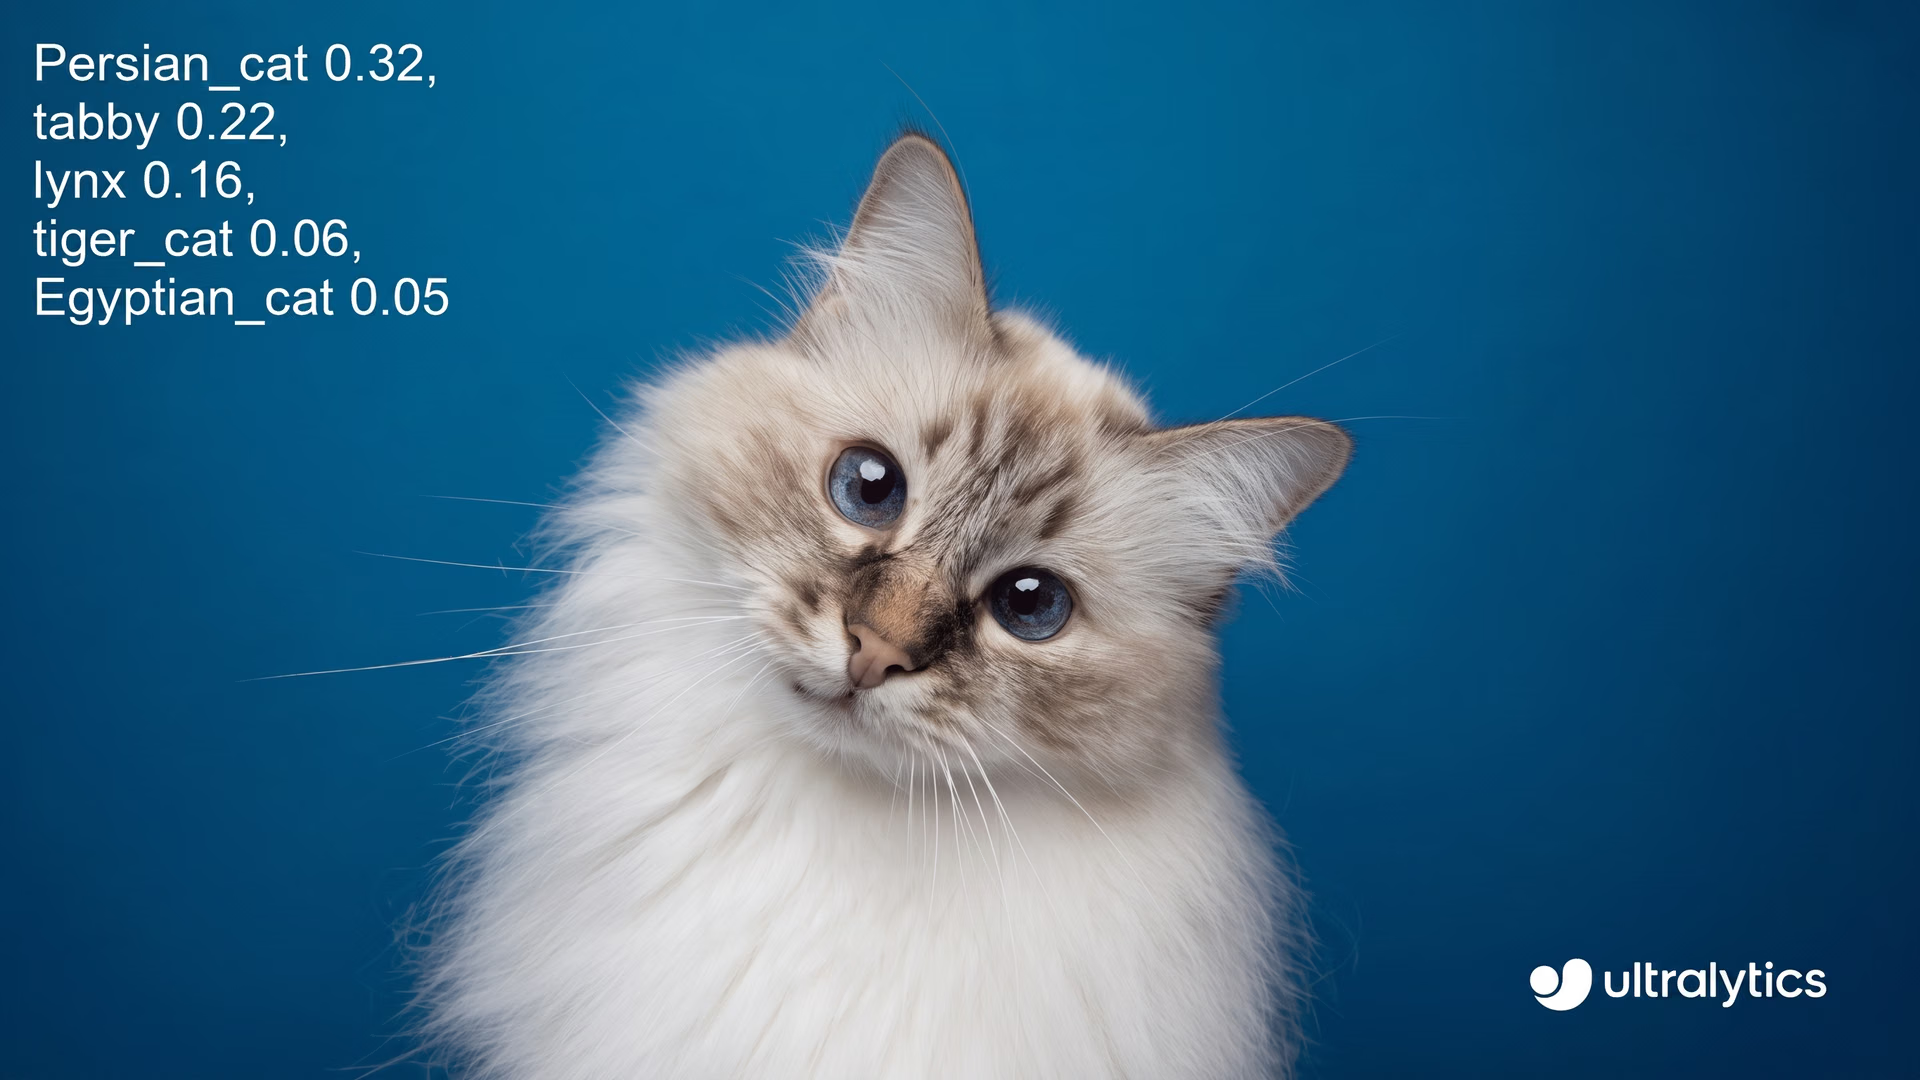
الشكل 1. مثال على تصنيف الصور.
عند دمج معالجة اللغة الطبيعية مع الرؤية الحاسوبية، يمكنها إضفاء معنى على البيانات المرئية من خلال الجمع بين النصوص والصور، ما يتيح فهمًا أعمق. وكما يقال: «الصورة تساوي ألف كلمة»، وعندما تقترن بالنص تصبح أكثر تأثيرًا، وتوفر رؤى أغنى.
أمثلة على عمل معالجة اللغة الطبيعية والرؤية الحاسوبية معًا#
ربما شاهدت معالجة اللغة الطبيعية والرؤية الحاسوبية تعملان معًا في أدوات يومية من دون أن تلاحظ ذلك، مثلما يحدث عندما يترجم هاتفك نصًا من صورة.
في الواقع، يستخدم Google Translate معالجة اللغة الطبيعية والرؤية الحاسوبية لترجمة النصوص من الصور. فعندما تلتقط صورة لإشارة شارع بلغة أخرى، تحدد الرؤية الحاسوبية النص وتستخرجه، بينما تترجمه معالجة اللغة الطبيعية إلى اللغة التي تفضلها.
تعمل معالجة اللغة الطبيعية والرؤية الحاسوبية معًا لتسهيل العملية وزيادة كفاءتها، ما يمكّن المستخدمين من فهم المعلومات والتفاعل معها عبر اللغات في الوقت الفعلي. ويساعد هذا التكامل على إزالة حواجز التواصل.

الشكل 2. ميزة الترجمة من Google.
فيما يلي تطبيقات أخرى تعمل فيها معالجة اللغة الطبيعية والرؤية الحاسوبية معًا:
- السيارات ذاتية القيادة: يمكن استخدام الرؤية الحاسوبية لاكتشاف إشارات الطريق والمسارات والعوائق، بينما يمكن لمعالجة اللغة الطبيعية تفسير الأوامر المنطوقة أو النصوص الموجودة على إشارات الطريق.
- قارئات المستندات: يستطيع الذكاء الاصطناعي للرؤية التعرف على النصوص في المستندات الممسوحة ضوئيًا أو الكتابة اليدوية، ويمكن لمعالجة اللغة الطبيعية تفسير المعلومات وتلخيصها.
- البحث المرئي في تطبيقات التسوق: تستطيع الرؤية الحاسوبية تحديد المنتجات في الصور، بينما تعالج معالجة اللغة الطبيعية مصطلحات البحث لتحسين التوصيات.
- الأدوات التعليمية: تستطيع الرؤية الحاسوبية التعرف على الملاحظات المكتوبة بخط اليد أو المدخلات المرئية، ويمكن لمعالجة اللغة الطبيعية تقديم الشروح أو الملاحظات استنادًا إلى المحتوى.
مفاهيم أساسية تربط الرؤية الحاسوبية بمعالجة اللغة الطبيعية#
بعد أن تعرفنا على استخدامات الرؤية الحاسوبية ومعالجة اللغة الطبيعية، دعونا نستكشف كيفية اجتماعهما لتمكين الذكاء الاصطناعي متعدد الوسائط.
يجمع الذكاء الاصطناعي متعدد الأنماط بين الفهم المرئي الذي توفره الرؤية الحاسوبية وفهم اللغة الذي توفره معالجة اللغة الطبيعية، لمعالجة المعلومات وربطها عبر النصوص والصور. فعلى سبيل المثال، يمكن للذكاء الاصطناعي متعدد الأنماط في مجال الرعاية الصحية المساعدة على تحليل صورة الأشعة السينية وإنشاء ملخص مكتوب وواضح للمشكلات المحتملة، ما يساعد الأطباء على اتخاذ قرارات أسرع وأكثر دقة.
فهم اللغة الطبيعية (NLU)#
فهم اللغة الطبيعية فرع من معالجة اللغة الطبيعية يركز على تفسير النص واستخلاص معناه عبر تحليل القصد والسياق والدلالات والنبرة والبنية. وبينما تعالج معالجة اللغة الطبيعية النصوص الخام، تمكّن تقنيات فهم اللغة الطبيعية الآلات من استيعاب اللغة البشرية بفاعلية أكبر. فعلى سبيل المثال، التحليل النحوي تقنية من تقنيات فهم اللغة الطبيعية تحوّل النص المكتوب إلى تنسيق منظم تستطيع الآلات فهمه.

الشكل 3. العلاقة بين معالجة اللغة الطبيعية وفهم اللغة الطبيعية.
يعمل فهم اللغة الطبيعية مع الرؤية الحاسوبية عندما تحتوي البيانات المرئية على نص يحتاج إلى الفهم. وتستخرج الرؤية الحاسوبية النصوص من الصور أو المستندات أو مقاطع الفيديو باستخدام تقنيات مثل التعرّف الضوئي على الحروف (OCR). وقد تشمل المهام مسح إيصال ضوئيًا، أو قراءة نص على لافتة، أو رقمنة ملاحظات مكتوبة بخط اليد.
ثم يعالج فهم اللغة الطبيعية النص المستخرج لفهم معناه وسياقه وقصده. ويتيح هذا الجمع للأنظمة القيام بما يتجاوز مجرد التعرّف على النصوص؛ إذ يمكنها تصنيف النفقات الواردة في الإيصالات أو تحليل النبرة والمشاعر. وتحول الرؤية الحاسوبية وفهم اللغة الطبيعية معًا النصوص المرئية إلى معلومات مفيدة قابلة للتنفيذ.
هندسة الأوامر#
هندسة المطالبات هي عملية تصميم مطالبات إدخال واضحة ودقيقة ومفصلة لتوجيه أنظمة الذكاء الاصطناعي التوليدي، مثل نماذج اللغة الكبيرة (LLMs) ونماذج الرؤية واللغة (VLMs)، نحو إنتاج المخرجات المطلوبة. وتعمل هذه المطالبات بمثابة تعليمات تساعد نموذج الذكاء الاصطناعي على فهم قصد المستخدم.
تتطلب هندسة المطالبات الفعالة فهم قدرات النموذج وصياغة مدخلات تعزز إلى أقصى حد قدرته على توليد إجابات دقيقة أو إبداعية أو ثاقبة. ويكتسب ذلك أهمية خاصة عند التعامل مع النماذج متعددة الوسائط التي تعمل مع النصوص والصور معًا.
خذ نموذج تحويل النص إلى صورة DALL·E من OpenAI مثالًا. فإذا طلبت منه إنشاء «صورة واقعية لرائد فضاء يمتطي حصانًا»، فسيكون قادرًا على إنشاء الصورة المطلوبة استنادًا إلى وصفك. وهذا مفيد في مجالات مثل التصميم الجرافيكي، حيث يستطيع المتخصصون تحويل الأفكار النصية إلى نماذج مرئية بسرعة، ما يوفر الوقت ويعزز الإنتاجية.

الشكل 4. صورة أُنشئت باستخدام DALL-E من OpenAI.
قد تتساءل عن صلة ذلك بالرؤية الحاسوبية - أليست هذه مجرد ذكاء اصطناعي توليدي؟ في الواقع، يرتبط المجالان ارتباطًا وثيقًا. فالذكاء الاصطناعي التوليدي يستند إلى أسس الرؤية الحاسوبية لإنشاء مخرجات مرئية جديدة بالكامل.
تُدرَّب نماذج الذكاء الاصطناعي التوليدي التي تنشئ الصور من المطالبات النصية على مجموعات بيانات كبيرة من الصور المقترنة بأوصاف نصية. وهذا يمكّنها من تعلم العلاقات بين اللغة والمفاهيم المرئية، مثل الكائنات والأنسجة والعلاقات المكانية.
لا تفسر هذه النماذج البيانات المرئية بالطريقة نفسها التي تتبعها أنظمة الرؤية الحاسوبية التقليدية، مثل التعرف على الأجسام في الصور الواقعية. بل تستخدم فهمها المكتسب لهذه المفاهيم لإنشاء صور جديدة استنادًا إلى المطالبات. ومن خلال الجمع بين هذه المعرفة والمطالبات المصاغة بعناية، يستطيع الذكاء الاصطناعي التوليدي إنتاج صور واقعية ومفصلة تتوافق مع مدخلات المستخدم.
الإجابة عن الأسئلة (QA)#
صُممت أنظمة الإجابة عن الأسئلة لفهم الأسئلة المكتوبة باللغة الطبيعية وتقديم إجابات دقيقة وذات صلة. وتستخدم تقنيات مثل استرجاع المعلومات والفهم الدلالي والتعلم العميق لتفسير الاستفسارات والرد عليها.
يمكن للنماذج المتقدمة مثل GPT-4o من OpenAI التعامل مع الإجابة عن الأسئلة البصرية (VQA)، أي يمكنها تحليل الصور والإجابة عن الأسئلة المتعلقة بها. لكن GPT-4o لا ينفذ مهام الرؤية الحاسوبية مباشرةً. بل يستخدم مشفّرًا متخصصًا للصور لمعالجة الصور واستخراج السمات منها ودمجها مع فهمه للغة لتقديم الإجابات.

الشكل 5. قدرة ChatGPT على الإجابة المرئية عن الأسئلة. الصورة من إعداد المؤلف.
يمكن لبعض الأنظمة الأخرى أن تتقدم خطوة إضافية من خلال الدمج الكامل لقدرات الرؤية الحاسوبية. إذ تستطيع هذه الأنظمة تحليل الصور أو مقاطع الفيديو مباشرةً لتحديد الأجسام أو المشاهد أو النصوص. وعند دمجها مع معالجة اللغة الطبيعية، يمكنها التعامل مع أسئلة أكثر تعقيدًا حول المحتوى المرئي. فعلى سبيل المثال، يمكنها الإجابة عن أسئلة مثل «ما الأجسام الموجودة في هذه الصورة؟» أو «من يظهر في هذا التسجيل؟» من خلال اكتشاف العناصر المرئية وتفسيرها. ولمعرفة مدى قدرة نماذج الرؤية واللغة الحالية على تحديد مواقع الأجسام في الصور، تفضل بزيارة لوحة ترتيب نماذج الرؤية واللغة.
التعلّم دون أمثلة سابقة (ZSL)#
التعلم من دون أمثلة مسبقة (ZSL) أسلوب من أساليب التعلم الآلي يتيح لنماذج الذكاء الاصطناعي التعامل مع مهام جديدة لم ترها من قبل من دون تدريب مخصص عليها. ويحقق ذلك باستخدام معلومات إضافية، مثل الأوصاف أو العلاقات الدلالية، لربط ما يعرفه النموذج بالفعل (الفئات التي شاهدها) بفئات جديدة لم يرها من قبل.
في معالجة اللغة الطبيعية، يساعد التعلم من دون أمثلة مسبقة النماذج على فهم موضوعات لم تتدرب عليها والتعامل معها، بالاستناد إلى العلاقات بين الكلمات والمفاهيم. وبالمثل، يتيح التعلم من دون أمثلة مسبقة في الرؤية الحاسوبية للنماذج التعرف على الأجسام أو المشاهد التي لم تصادفها من قبل، من خلال ربط السمات المرئية، مثل الأجنحة أو الريش، بمفاهيم معروفة مثل الطيور.
يربط ZSL بين معالجة اللغة الطبيعية والرؤية الحاسوبية، إذ يجمع بين فهم اللغة والتعرّف المرئي، مما يجعله مفيدًا بوجه خاص للمهام التي تتضمن كليهما. فعلى سبيل المثال، يستطيع النموذج في الإجابة المرئية عن الأسئلة تحليل صورة وفهم سؤال مرتبط بها لتقديم إجابة دقيقة. ويفيد أيضًا في مهام مثل التعليق على الصور.
أبرز النقاط#
أدى الجمع بين معالجة اللغة الطبيعية والرؤية الحاسوبية إلى ظهور أنظمة ذكاء اصطناعي قادرة على فهم النصوص والصور معًا. ويُستخدم هذا المزيج في قطاعات عديدة، بدءًا من مساعدة السيارات ذاتية القيادة على قراءة إشارات الطريق، وصولًا إلى تحسين التشخيص الطبي وتعزيز أمان وسائل التواصل الاجتماعي. ومع تطور هذه التقنيات، ستواصل تيسير الحياة وفتح فرص جديدة في مجموعة واسعة من المجالات. لمعرفة المزيد، تفضل بزيارة مستودع GitHub وتفاعل مع مجتمعنا. واستكشف تطبيقات الذكاء الاصطناعي في السيارات ذاتية القيادة والزراعة في صفحات حلولنا.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









