كيفية تدريب YOLO على بيانات Amazon S3 ونشر واجهة API مستضافة باستخدام Ultralytics Platform
درّب Ultralytics YOLO26 على الصور الموجودة في حاوية Amazon S3 لديك، وانشره كواجهة API مستضافة باستخدام Ultralytics Platform، خطوة بخطوة، مع مقارنته بـ SageMaker.
 Miles Deans11 دقيقة قراءة
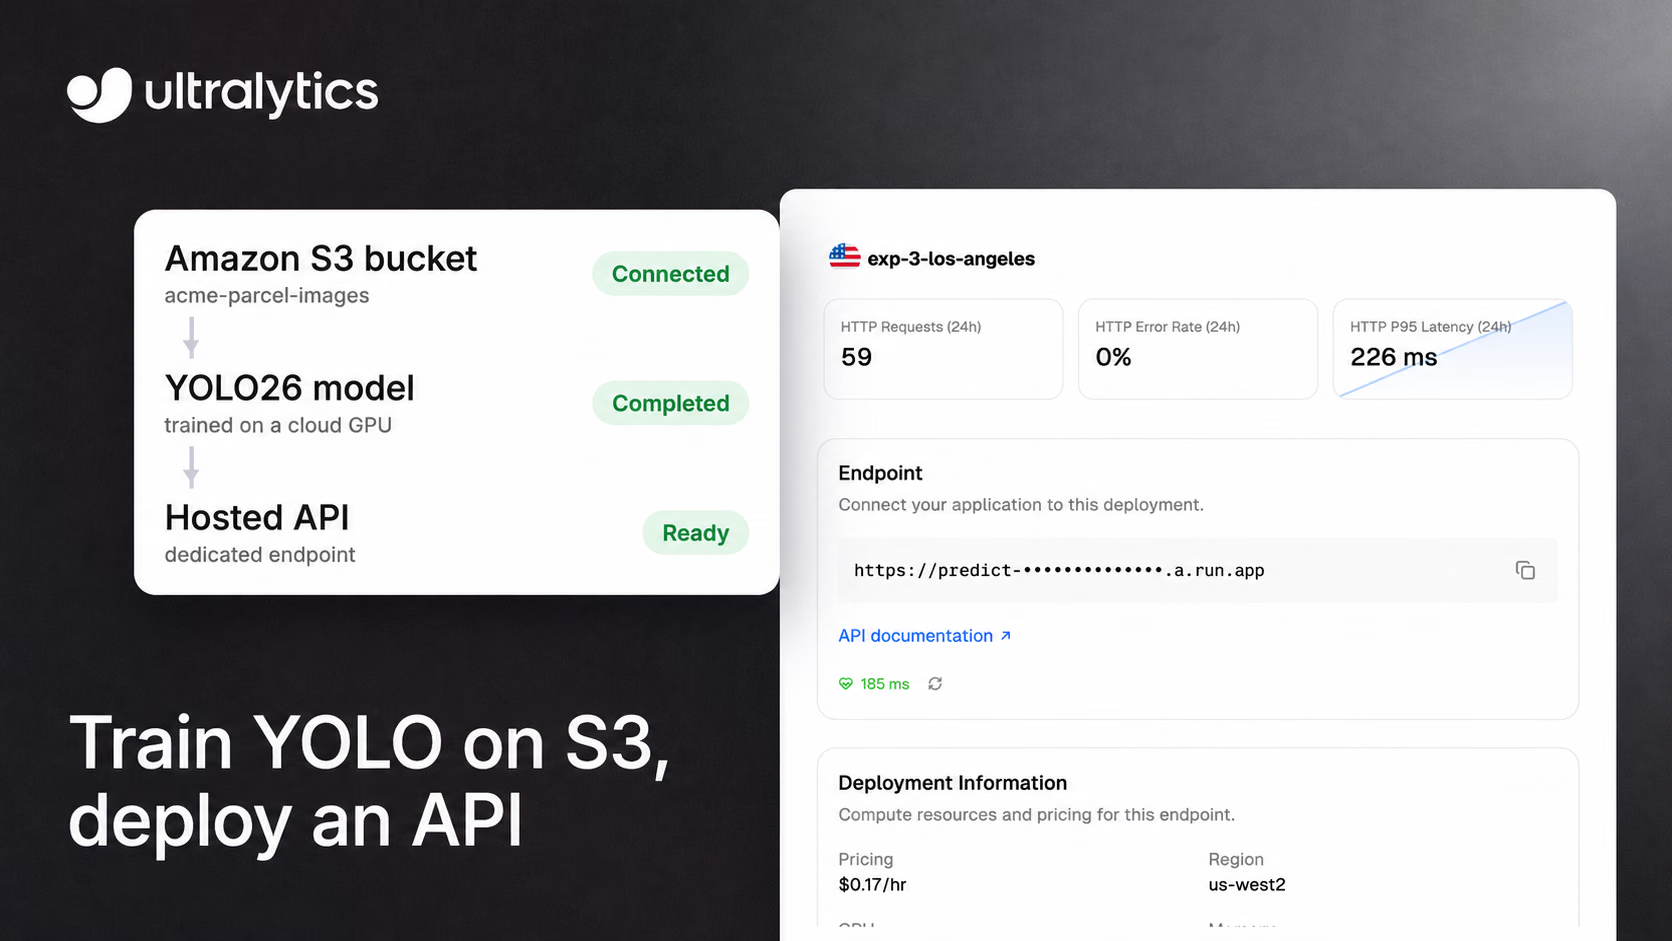
إذا كانت صورك موجودة بالفعل في حاوية Amazon S3، فيمكنك تدريب نموذج Ultralytics YOLO عليها ونشره كواجهة API مستضافة من دون تحميل نسخة ثانية من مجموعة البيانات. تفهرس Ultralytics Platform الحاوية في موقعها، وتتيح لك إضافة تسميات وتدريب YOLO26 على GPU سحابي، وتنشر النموذج المدرّب إلى نقطة نهاية مخصصة تستدعيها عبر HTTPS. يشرح هذا الدليل كل خطوة، من سياسة IAM إلى أول تنبؤ لك، ويقارن سير العمل بـ Amazon SageMaker وGoogle Vertex AI وAzure Machine Learning.
يسري سير العمل نفسه على Google Cloud Storage وAzure Blob Storage، مع استخدام مفتاح JSON لحساب خدمة أو سلسلة اتصال بمفتاح وصول الحساب بدلاً من مفتاح وصول AWS.
كيفية ترابط خطوات سير العمل#
يتألف خط الأنابيب من خمس مراحل. تبقى صورك الأصلية في حاويتك، ويستخدم التدريب السحابي نسخًا مؤقتة طوال مدة التشغيل:
- الاتصال بحاوية S3 باستخدام مستخدم IAM للقراءة فقط.
- الفهرسة: فهرس مجلدًا على أنه مجموعة بيانات في Platform. تقرأ Platform أبعاد الصور وأي تسميات YOLO تعثر عليها، ولا تخزّن نسخة ثانية من الصور.
- إضافة التسميات إلى الصور في المتصفح، أو الإبقاء على تسميات YOLO الموجودة بالفعل في الحاوية.
- التدريب: درّب نموذج YOLO26 على GPU سحابي. يستخدم التدريب نسخًا مؤقتة من الصور طوال مدة التشغيل.
- النشر: انشر النموذج إلى نقطة نهاية مخصصة في واحدة من 42 منطقة، وأرسل إليها الصور باستخدام مفتاح API.
تُحدَّد مجموعات بيانات الكشف والتجزئة وتقدير الوضع ومربع الإحاطة الموجّه (OBB) من بنية تسمياتها، لذا تنطبق الخطوات نفسها على كل مهمة رؤية حاسوبية.
قبل البدء: الخطط والأذونات وحدود البيانات#
تحتاج إلى ثلاثة أمور:
- مساحة عمل Pro أو Enterprise. تتطلب مجموعات بيانات Amazon S3 وGoogle Cloud Storage وAzure Blob Storage خطة Pro أو Enterprise. تبلغ تكلفة Pro 29 دولارًا لكل مقعد شهريًا، وتشمل رصيدًا بقيمة 30 دولارًا لكل مقعد شهريًا للحوسبة المحسوبة بالاستهلاك، مثل التدريب السحابي.
- دور مسؤول مساحة العمل أو مالكها، وهو مطلوب لربط التخزين السحابي.
- مستخدم AWS IAM لديه صلاحية عرض الحاوية وقراءة محتواها.
من المفيد معرفة ما الذي يغادر الحاوية قبل ربطها. تبث Platform الصور الأصلية عند الطلب للتصفح وإضافة التسميات، ولا تُحتسب الصور المفهرسة ضمن حصة التخزين في Platform. يتضمن كل اتصال مفتاح تبديل ميزات AI، وهو مفعّل افتراضيًا. عند تفعيله، يمكن لوحدات GPU التابعة لـ Ultralytics قراءة الصور لإضافة التسميات والبحث عن الصور المتشابهة والتدريب السحابي. وقد تعالج مزوّدات AI الخارجية الصور أيضًا عند استخدام نماذج إضافة التسميات المدفوعة بمفتاح المزوّد الخاص بمساحة العمل، وعند توليد الصور إذا كان الوصول للكتابة مفعّلًا. يستخدم التدريب السحابي نسخًا مؤقتة أثناء التشغيل؛ ويحتفظ البحث عن الصور المتشابهة بالتضمينات إلى أن تُزال الصور من Platform. أوقف الميزة، فلن يبدأ أي عمل جديد متعلق بـ AI (لكن العمل الجاري سيكتمل)، بينما يستمر العمل على إضافة التسميات يدويًا والتدريب المحلي. لا تعدّل Platform كائناتك أو تحذفها مطلقًا.
الخطوة 1: إنشاء مستخدم IAM للقراءة فقط#
في وحدة تحكم AWS، انتقل إلى IAM > Users، وأنشئ مستخدمًا بلا صلاحية للوصول إلى وحدة التحكم، وأرفق به سياسة تمنح صلاحية عرض الحاوية وقراءة محتواها:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
إن s3:ListAllMyBuckets اختياري. فهو يتيح لـ Platform اكتشاف حاوياتك، فلا تضطر إلى كتابة أسمائها.
بعد ذلك، افتح علامة التبويب Security credentials الخاصة بالمستخدم وأنشئ مفتاح وصول. تحتاج Platform إلى مفتاح مستخدم IAM طويل الأمد؛ فهي ترفض بيانات اعتماد AWS STS المؤقتة، بما فيها بيانات اعتماد جلسة الدور ومفاتيح IAM Identity Center، لأنها ستنتهي صلاحيتها بينما تظل مجموعة البيانات متصلة. استخدم لهذا الغرض مستخدمًا مخصصًا، ولا تستخدم بيانات اعتماد المستخدم الجذر مطلقًا. تشفّر Platform المفتاح أثناء التخزين باستخدام AES-256-GCM، ولا تكشفه مطلقًا لأحمال عمل التدريب، ويمكنك إلغاء الوصول في أي وقت بإلغاء تنشيط المفتاح في IAM.
الخطوة 2: ربط الحاوية بـ Ultralytics Platform#
- في Platform، انتقل إلى Settings > Integrations واختر Amazon S3.
- أدخل معرّف مفتاح الوصول ومفتاح الوصول السري ومنطقة الحاوية، مثل
us-east-1. - انقر Find available buckets واختر الحاويات المطلوب ربطها، أو اكتب اسم حاوية إذا كانت السياسة لا تسمح باكتشاف الحاويات.
- انقر Connect. تتحقق Platform من إمكانية عرض كل حاوية وقراءة محتواها قبل حفظ أي شيء.
يقرأ الاتصال الحاويات في منطقة واحدة، لذا أنشئ اتصالًا لكل منطقة إذا كانت بياناتك موزعة على عدة مناطق. يتناول دليل تكامل Amazon S3 صلاحية الكتابة الاختيارية المستخدمة لتوليد الصور.
الخطوة 3: إنشاء مجموعة بيانات من الحاوية#
انقر New Dataset، وافتح علامة التبويب Cloud، واختر الحاوية، وانتقل إلى المجلد الذي يحتوي على بياناتك، ثم أنشئ مجموعة البيانات. تعرض Platform محتويات المجلد مرة واحدة وتفهرس ما تعثر عليه:
- الصور: كائنات
.jpgو.jpegو.pngو.webpو.avif. - التسميات: ملفات YOLO
.txt، المطابقة لتخطيطimages/إلىlabels/القياسي أو الموجودة بجوار كل صورة. - الفئات: يوفّر الملف
data.yamlأسماء الفئات، كما هو الحال في مجموعة بيانات YOLO عادية. - التقسيمات: تعيّن أسماء المجلدات
trainوvalوtestالتقسيمات تلقائيًا.
تفهرس عملية استيراد واحدة ما يصل إلى 500,000 كائن، لذا قسّم الحاويات الأكبر حجمًا على عدة مجموعات بيانات. تعامل مع الكائنات المفهرسة على أنها غير قابلة للتغيير: إذ تُثبَّت كل صورة على علامة ETag الخاصة بكائن S3، وتتوقف Platform عن عرض أي صورة جرى استبدالها. لإضافة بيانات لاحقًا، حمّل كائنات جديدة وأنشئ مجموعة بيانات جديدة، إذ يُنشأ الفهرس مرة واحدة عند إنشاء مجموعة البيانات.
الخطوة 4: إضافة تسميات إلى الصور أو التحقق منها#
افتح مجموعة البيانات لمراجعة التسميات المستوردة في محرر إضافة التسميات. إذا لم تكن الحاوية تحتوي على تسميات بعد، فيمكنك رسم الصناديق والأقنعة يدويًا، أو استخدام إضافة التسميات الذكية (SAM للكشف والتجزئة وOBB، وYOLO لتقدير الوضع) وإضافة التسميات تلقائيًا لتسريع العمل، عند تفعيل ميزات AI. تُخزَّن التسميات في Platform، وتبقى كائنات الحاوية دون تغيير.
الخطوة 5: تدريب YOLO26 على GPU سحابي#
انقر New Model في مجموعة البيانات أو المشروع، واختر نموذجًا أساسيًا، وابدأ تشغيلًا سحابيًا:
- النموذج الأساسي: اختر نموذجًا رسميًا من Ultralytics (يوصى بـ YOLO26) أو أحد نماذجك لضبطه الدقيق. لا تُعرض إلا النماذج المتوافقة مع مهمة مجموعة البيانات.
- المعلمات: حدّد عدد العصور وحجم الصورة وحجم الدفعة، أو أبقِ على القيم الافتراضية.
- GPU: اختر GPU من Ultralytics Cloud. يعرض مربع الحوار السعر بالساعة ويقدّر مدة التشغيل وتكلفته الإجمالية قبل البدء. يساعدك دليلنا حول اختيار GPU سحابي على الموازنة بين الخيارات.
تُبث المقاييس ومخرجات وحدة التحكم ومخططات النظام إلى المتصفح أثناء التشغيل، وتُحفَظ نقاط التحقق تلقائيًا. عند انتهاء التدريب، تعرض صفحة النموذج مقاييسه، وعند توفر نتائج التحقق، تعرض تحليلًا مفصلًا مثل مصفوفة الالتباس.
الخطوة 6: نشر النموذج كواجهة API مستضافة#
افتح علامة التبويب Deploy الخاصة بالنموذج. تعرض خريطة وجدول 42 منطقة مرتبة حسب زمن الاستجابة المقاس من موقعك. انقر Deploy في المنطقة التي تريدها، وراجع CPU والذاكرة والسعر، ثم انقر Create Deployment.
يحدد الحجم الذي تختاره طريقة احتساب الرسوم:
- الحجم الافتراضي (1 vCPU، 2 GiB): مجاني، ويتوسع إلى الصفر عند الخمول.
- الأحجام المخصصة (حتى 8 vCPU و32 GiB): تُبقي مثيلًا واحدًا جاهزًا، وتُحتسب الرسوم وفق السعر الإقليمي المعروض بالساعة، بدءًا من الجاهزية وحتى إيقاف نقطة النهاية، بما في ذلك وقت الخمول.
كل نقطة نهاية مخصصة خدمة لمستأجر واحد لها عنوان URL ومراقبة خاصان بها، وترتبط بمفتاح API واحد من مساحة العمل. يمكن لمساحات العمل المجانية تشغيل 3 عمليات نشر، وPro تشغيل 10، بينما لا يفرض Enterprise حدًا. لمعرفة الحالات التي تكون فيها نقطة النهاية المخصصة خيارًا أفضل من الاستدلال المشترك، راجع دليلنا حول الاستدلال المخصص مقابل المشترك.
الخطوة 7: استدعاء نقطة النهاية#
ثبّت Requests باستخدام python -m pip install requests واحفظ صورة باسم image.jpg. استبدل عنوان URL النموذجي بعنوان URL المنسوخ من عملية النشر، متبوعًا بـ /predict، واستبدل YOUR_API_KEY بالمفتاح المرتبط بعملية النشر:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
الطلب نفسه باستخدام cURL:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
يوفّر كل endpoint أيضًا مرجع API تفاعليًا على /docs وفحصًا لـ /health. تتجاوز الطلبات المباشرة حد معدل API في Platform، لكن هناك مثيل واحد يخدم كل endpoint: تحصل الطلبات التي يتعذر خدمتها بسرعة على 429 مع ترويسة Retry-After، ويقتصر حجم أجسام الطلبات على 32 MB. بعد تشغيل endpoint، يمكنك مراقبة طلباته وأخطائه وزمن استجابته من صفحة النشر.
التكاليف والحدود والأمان في لمحة#
| العنصر | ما المتوقع |
|---|---|
| الباقة | Pro (29 دولارًا لكل مقعد شهريًا) أو Enterprise لمجموعات بيانات S3 وGoogle Cloud Storage وAzure Blob |
| التخزين | تبقى الصور المفهرسة في حاويتك ولا تستهلك حصة التخزين في Platform |
| التدريب | تُحتسب التكلفة حسب وقت استخدام GPU من الرصيد؛ ويقدّر مربع الحوار التكلفة قبل البدء |
| نقطة النهاية | الحجم الافتراضي مجاني ويتوسع إلى الصفر؛ وتُحتسب رسوم الأحجام المخصصة بالساعة أثناء التشغيل |
| حجم الاستيراد | حتى 500,000 كائن لكل عملية استيراد |
| بيانات الاعتماد | مفتاح مستخدم IAM طويل الأمد، مشفّر أثناء التخزين، ولا يُكشف مطلقًا لأحمال عمل التدريب |
| غير متاحة لمجموعات بيانات S3 | استنساخ مجموعات البيانات، ولقطات الإصدارات، وتمويه الوجوه، ولصق الصور من مجموعات بيانات أخرى |
Ultralytics Platform مقارنةً بـ SageMaker وVertex AI وAzure ML#
يمكن لمنصات ML السحابية متعددة الأغراض أيضًا تدريب النماذج على البيانات الموجودة في تخزينها الخاص وتقديم النماذج. تستند أعمدة التخزين والتقديم أدناه إلى وثائق كل منصة؛ أما العمود الأخير فيعرض تقييمنا.
| المنصة | مكان وجود بيانات التدريب | خيارات تقديم النماذج | الاستخدام الأنسب المقترح (تقييمنا) |
|---|---|---|---|
| Ultralytics Platform مع Ultralytics YOLO | تُفهرس البيانات في موقعها من S3 أو Google Cloud Storage أو Azure Blob | نقاط نهاية مخصصة بمثيل واحد في 42 منطقة؛ وتتوسع إلى الصفر عند استخدام الحجم الافتراضي | الفرق التي تريد استخدام YOLO للكشف أو التجزئة أو تقدير الوضع أو OBB، بدءًا من الحاوية وصولًا إلى API، دون كتابة شيفرة للتدريب أو التقديم |
| Amazon SageMaker AI | تقرأ مهام التدريب من Amazon S3 أو Amazon EFS أو Amazon FSx for Lustre | نقاط نهاية آنية مع التوسع التلقائي، وخدمات بلا خوادم، واستدلال غير متزامن | الفرق التي تشغّل بالفعل خطوط أنابيب ML على AWS وتريد اختيار الحاويات وخيارات التقديم الخاصة بها |
| Google Vertex AI | تربط مهام التدريب بلا خوادم حاويات Cloud Storage التي يمكن الوصول إليها ضمن /gcs/ | نقاط نهاية مُدارة للاستدلال عبر الإنترنت | الفرق التي تعتمد على بيانات Google Cloud وأدواتها |
| Azure Machine Learning | تشير مخازن البيانات إلى تخزين Azure موجود، مثل Blob Storage | نقاط نهاية مُدارة عبر الإنترنت للاستدلال الآني | الفرق التي تعتمد على Azure |
تسرد وثائق بيانات التدريب في SageMaker خدمات S3 وEFS وFSx for Lustre كمصادر مع نمطي إدخال البث والتنزيل. تدير خدمة الاستدلال بلا خوادم التوسع نيابةً عنك، وتناسب حركة المرور التي تتخللها فترات خمول ويمكنها تحمّل بدء التشغيل البارد؛ ويمكنك استخدام حاوية توفرها SageMaker أو إحضار حاويتك الخاصة. تشغّل Vertex AI التدريب المخصص من تطبيق Python على حاوية معدّة مسبقًا أو حاوية مخصصة، وتتصل Azure Machine Learning بتخزين Azure الموجود عبر مخازن البيانات، وتقدّم النماذج من نقاط نهاية مُدارة عبر الإنترنت. وهذا الاتساع هو مكمن قوة المنصة متعددة الأغراض. وفقًا لتقييمنا، يتطلب سير عمل YOLO المخصص مزيدًا من الإعداد؛ وتعتمد متطلبات الحاوية على خيارات التدريب والتقديم المحددة. إذا أردت البقاء ضمن AWS، يوضح دليل النشر على SageMaker كيفية تقديم نموذج YOLO هناك.
صُممت Ultralytics Platform لتكون أكثر تخصصًا. وهي مبنية حول نماذج Ultralytics YOLO، لذا تحل الخطوات أعلاه محل برنامج التدريب النصي وحاوية التقديم. وتكون أقل ملاءمة إذا كانت مؤسستك تشترط استخدام بيانات اعتماد STS المؤقتة لكل عملية تكامل، أو إذا كان لا بد لنقطة نهاية واحدة من التوسع عبر مثيلات عديدة تحت حمل متزامن كثيف. إذا كنت لا تزال تقرر أين ينبغي تشغيل الاستدلال، يقارن دليلنا حول السحابة مقابل الاستضافة الذاتية التكلفة وزمن الاستجابة والتحكم في البيانات.
الأسئلة الشائعة
تربط Ultralytics Platform حاوية S3، وتفهرس الصور في موقعها، وتدرّب YOLO26 على GPU سحابي، وتنشر النموذج إلى نقطة نهاية HTTPS مخصصة. كما تدرّب Amazon SageMaker AI انطلاقًا من S3، وتوفّر استدلالًا آنيًا وبلا خوادم وغير متزامن، باستخدام حاويات توفرها SageMaker أو حاويات مخصصة وفقًا لخيار التقديم. وتوفّر Google Vertex AI وAzure Machine Learning مسارات عمل مماثلة مبنية حول خدمات التخزين الخاصة بهما، أي Cloud Storage وتخزين Azure، بدلًا من حاوية S3 موجودة.
لا تحتفظ Platform بنسخة ثانية من مجموعة بياناتك: فهي تفهرس الصور وتبث النسخ الأصلية عند الطلب. عند تفعيل ميزات AI، يستخدم التدريب السحابي نسخًا مؤقتة خارج حاويتك طوال مدة التشغيل، ويحتفظ البحث عن الصور المتشابهة بتضمين لكل صورة. لا تعدّل Platform كائناتك أو تحذفها مطلقًا.
ليس في الوقت الحالي. تتطلب Platform مفتاح وصول طويل الأمد من مستخدم IAM مخصص، وترفض بيانات اعتماد STS لأنها تنتهي صلاحيتها أثناء اتصال مجموعة البيانات. امنح المستخدم صلاحية العرض والقراءة فقط، وألغِ تنشيط المفتاح في IAM لإلغاء الوصول.
تتطلب مجموعات بيانات S3 خطة Pro (29 دولارًا لكل مقعد شهريًا، مع رصيد شهري بقيمة 30 دولارًا لكل مقعد) أو خطة Enterprise. تُحتسب تكلفة التدريب حسب وقت استخدام GPU، ويقدّر مربع حوار التدريب التكلفة قبل البدء. حجم نقطة النهاية الافتراضي مجاني ويتوسع إلى الصفر؛ أما الأحجام المخصصة فتُحتسب بالساعة أثناء التشغيل.
نعم. يتصل Google Cloud Storage باستخدام مفتاح JSON لحساب خدمة ودور Storage Object Viewer، بينما يتصل Azure Blob Storage بسلسلة اتصال لمفتاح الوصول إلى الحساب عبر HTTPS (لا تُقبل سلاسل رموز SAS). تظل خطوات مجموعة البيانات والتدريب والنشر كما هي.
تُفهرس مجموعة البيانات مرة واحدة عند إنشائها، لذا لا تُلتقط العناصر الجديدة تلقائيًا. أضف عناصر جديدة بدلًا من استبدال العناصر الموجودة، ثم أنشئ مجموعة بيانات جديدة تتضمنها، وأعِد التدريب أو الضبط الدقيق.
نعم. نزّل الأوزان أو صدّر النموذج إلى تنسيقات مثل ONNX وTensorRT وCoreML من صفحة النموذج، ثم شغّله على خوادمك أو أجهزتك الطرفية باستخدام حزمة Ultralytics Python.
بقلم
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









