OCR باستخدام Python وUltralytics YOLO26: اقرأ المستندات والصور وملفات PDF بأي زاوية
اقرأ النصوص في الصور وصفحات PDF بأي زاوية باستخدام Ultralytics YOLO26-Text وPP-OCRv6، عبر بضعة أسطر من Python، على CPU أو GPU، مع إمكانية استخدام TensorRT.
 Jing Qiu12 دقيقة قراءة
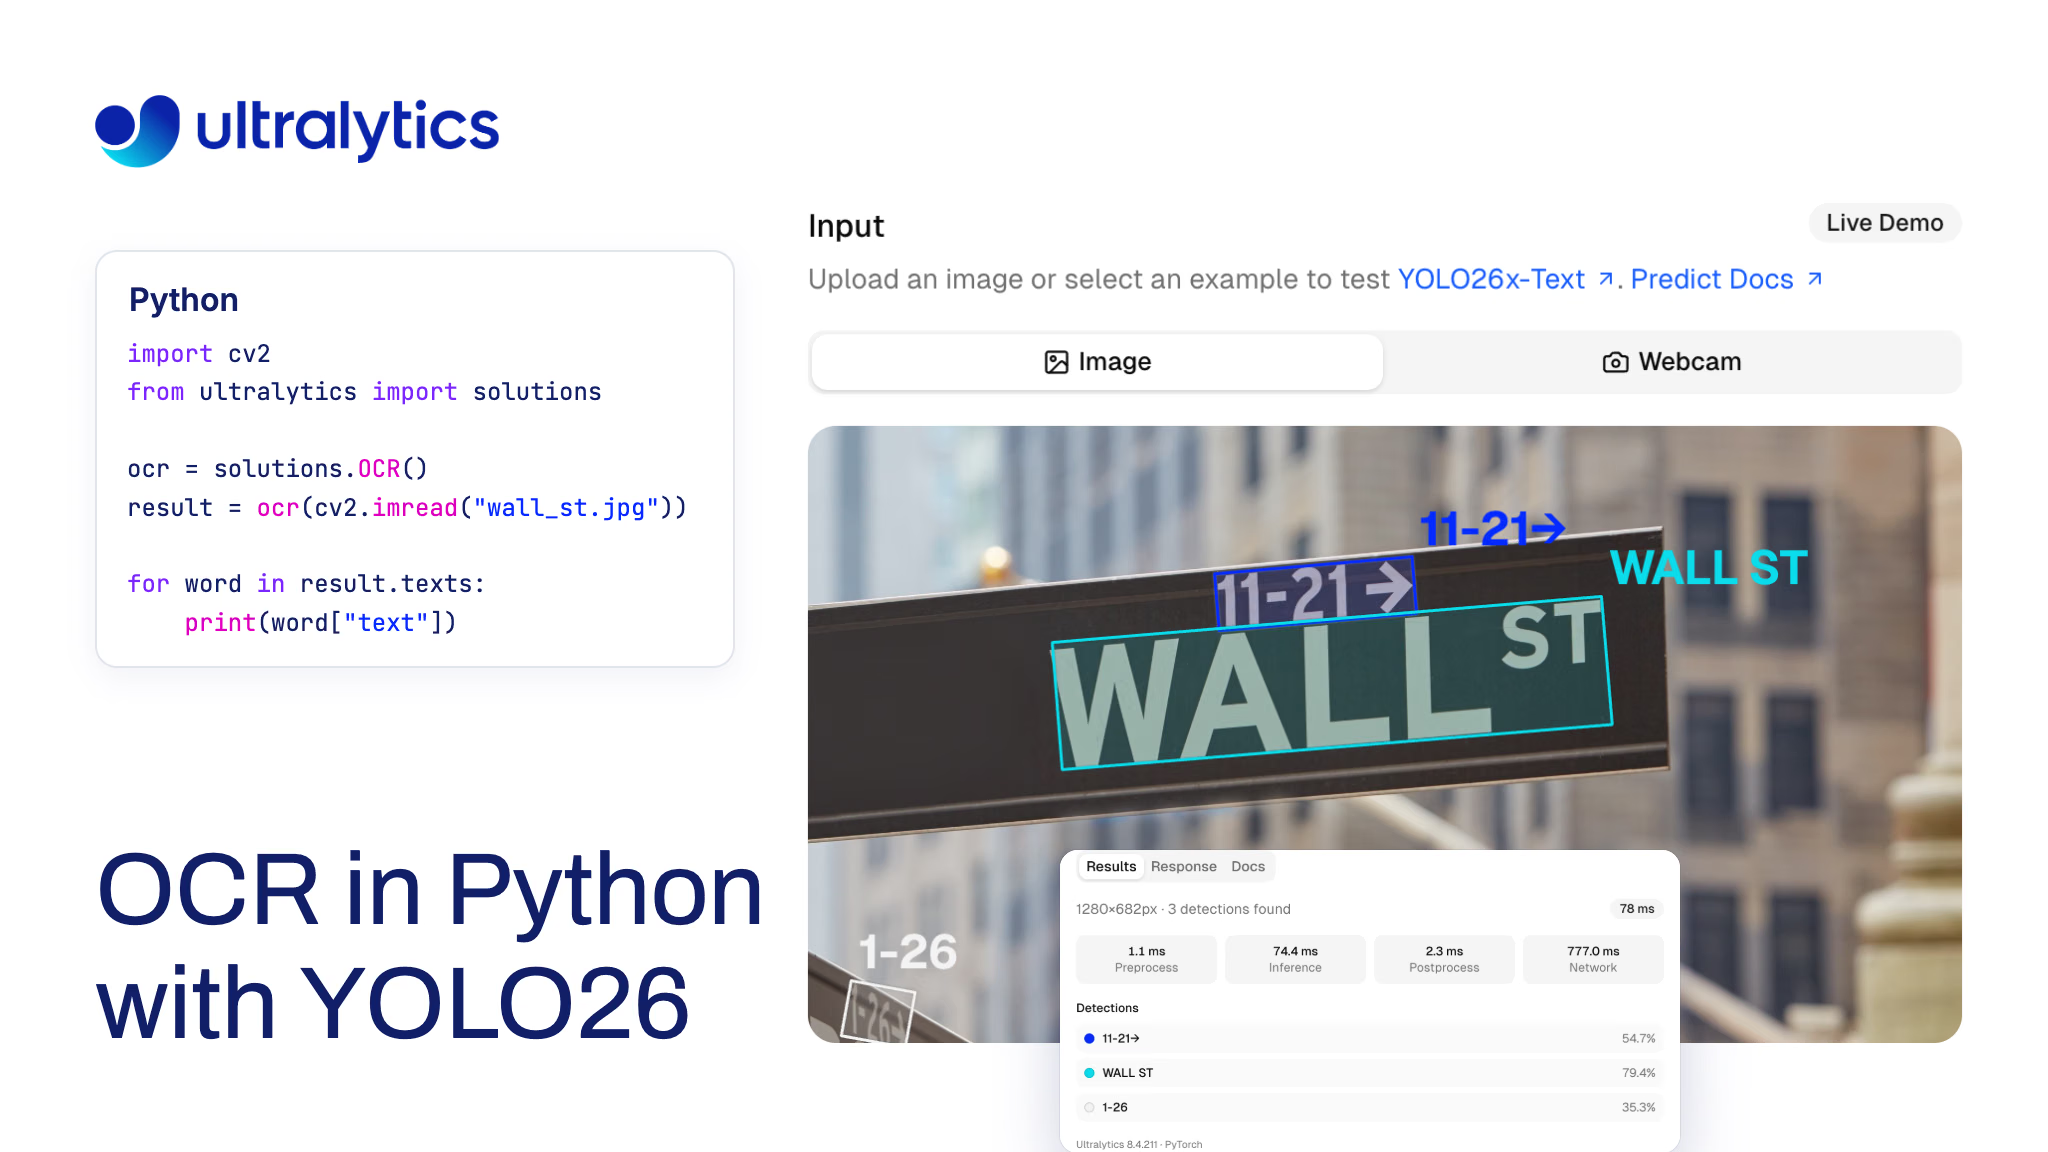
كيف تشغّل OCR باستخدام Python على مسح ضوئي مائل أو صورة لافتة بهاتف أو صفحة من ملف PDF، ثم تستخرج الكلمات مرتبةً كما يقرأها الشخص؟ باستخدام حزمة Ultralytics، لا يتطلب الأمر سوى فئة واحدة: يكتشف solutions.OCR() النص باستخدام نموذج YOLO26-Text من Ultralytics، ويقرأ كل كلمة باستخدام أداة التعرّف PP-OCRv6 من PaddleOCR، ثم يعيد الكلمات التي تعرّف عليها سطرًا بسطر، بأي تدوير للصفحة، على CPU أو GPU.
هذا المسار جديد. أعادت Ultralytics 8.4.210 بناء حل OCR حول PP-OCRv6 على ONNX Runtime، مع معالجة التدوير وترتيب القراءة، وأضاف الإصدار 8.4.211 أداة تعرّف اختيارية باستخدام TensorRT. في اختبار الأداء الذي أجريناه بحجم صورة 1280، حقق الإعداد الافتراضي درجة F1 للكلمات بلغت 0.931 في ست صفحات PDF و0.722 في 80 صورة من HierText. وعلى RTX PRO 6000، قرأ محرّك TensorRT مخبأ بصيغة FP16 الكلمات الـ251 المكتشفة في صورة واحدة خلال 82 ms، مقابل 249 ms باستخدام ONNX Runtime على CUDA.
يشرح هذا الدليل آلية عمل المسار، وكيفية تشغيله على الصور وملفات PDF، وسرعته واللغات التي يقرأها حاليًا. توفّر Ultralytics أحد خيارات OCR التي تجري مقارنتها أدناه، لذا تقتصر المقارنة على الإمكانات الموثقة لكل مشروع.
يقرأ YOLO26 OCR الصفحة على خطوتين، ثم يرتّب الكلمات#
تتولى تقنية التعرّف الضوئي على الحروف (OCR) مهمتين: العثور على النص ثم قراءته. ويفصل حل OCR من Ultralytics بينهما بوضوح:
- الكشف: يرسم نموذج YOLO26-Text، وهو كاشف صناديق الإحاطة الموجّهة، صناديق مائلة حول النص. يتوفر بأحجام n وs وm وl وx، ويكون نموذج x هو الافتراضي.
- التعرّف: يقرأ نموذج PP-OCRv6 المتوسط كل قصاصة. ويعمل باستخدام ONNX Runtime من إصدار أصول Ultralytics، لذا لا تحتاج إلى تثبيت PaddlePaddle. تُستبعد القصاصات التي لا يُقرأ منها شيء.
- الترتيب: تُجمع الكلمات في أسطر وتُعاد من الأعلى إلى الأسفل ومن اليسار إلى اليمين، مع إرفاق رقم السطر بكل كلمة.
تُعاد كل كلمة كسجل يتضمن نصها، ودرجة الثقة في التعرّف عليها، ودرجة ثقة الكاشف، ورقم السطر، ومضلعًا بإحداثيات الصورة الأصلية. ولأن درجتي الثقة منفصلتان، يمكنك إرسال كلمة اكتُشفت بثقة لكن قُرئت بدرجة شك إلى المراجعة البشرية بدلًا من الوثوق بها.
تظل المرحلتان مستقلتين. يمكنك استبدال الكاشف بآخر أصغر، أو بنموذج كشف أو تقسيم خاص بك، أو بأداة تعرّف مختلفة، مع استمرار عمل معالجة التدوير وترتيب القراءة. ويمكنك تجربة المسار البرمجي نفسه في المتصفح على صفحة معالجة المستندات قبل تثبيت أي شيء.
قراءة الصفحات المدوّرة والمقلوبة رأسًا على عقب بالترتيب الصحيح#
يستنتج الحل تدوير الصفحة من النص الذي يكتشفه، لذا لا تحتاج إلى تصحيح ميل الصفحات أو تدويرها مسبقًا:
- تحديد اتجاه النص. يحسب متوسط زاوية الضلع الطويل للصناديق المكتشفة، مع ترجيحها بحسب مدى استطالة كل صندوق. ولا تُحتسب الصناديق التي تقل استطالتها عن 2:1، مثل صناديق الأرقام المفردة.
- تدوير الصفحة. يدوّر الصفحة بحيث يمتد النص من اليسار إلى اليمين، ويقص كل كلمة لتصبح مستقيمة، ثم يجمع الكلمات في أسطر.
- حسم 0° أو 180°. لا يحدد الصندوق اتجاه النص، لذا يقرأ الحل الكلمات الثماني الأعرض في كلا الاتجاهين، ويختار التدوير الذي يحقق ثقة أعلى في القراءة. يظهر النص المقلوب رأسًا على عقب كضجيج منخفض الثقة، ما يجعل الإجابة الصحيحة أوضح.
عندما دوّرنا 8 مستندات ولقطات شاشة، بالإضافة إلى 12 صورة، إلى زوايا 90° و180° و270°، بلغت درجة F1 للكلمات 0.925 في المستندات و0.654 في الصور. وفي نموذج IRS 8802 فارغ، قرأ الحل 404 و401 و399 كلمة عند الزوايا 0° و180° و90°، مع تطابق الأسطر الأولى. أما الإصدار السابق فكان يفترض أن كل صفحة بوضعية مستقيمة.
الإعدادات الافتراضية مبنية على اختبار أداء، لا على التخمين#
حددنا الإعدادات الافتراضية الرئيسية بالقياس. أُجري اختبار الأداء على RTX PRO 6000 باستخدام صورة Platform الإنتاجية، مع إرسال الملفات بصيغة JPEG وبحد أقصى 1280 بكسل على الضلع الطويل. واستخدم 80 صورة تحقق من مجموعة بيانات HierText من Google مع تفريغ الكلمات المقروءة فيها، و6 صفحات PDF جرى تقييمها بمقارنة النتائج بطبقات النص فيها (4 من ورقة بحثية على arXiv، بالإضافة إلى نموذجي IRS 1040 و8802 فارغين)، ولقطة شاشة اصطناعية وصورة اصطناعية. المقياس هو درجة F1 على مستوى الكلمات، وهي مقياس للتوازن بين الإحكام والاستدعاء، مع احتساب الكلمات المكتوبة بأحرف صغيرة والمكوّنة من حرفين أبجديين رقميين على الأقل.
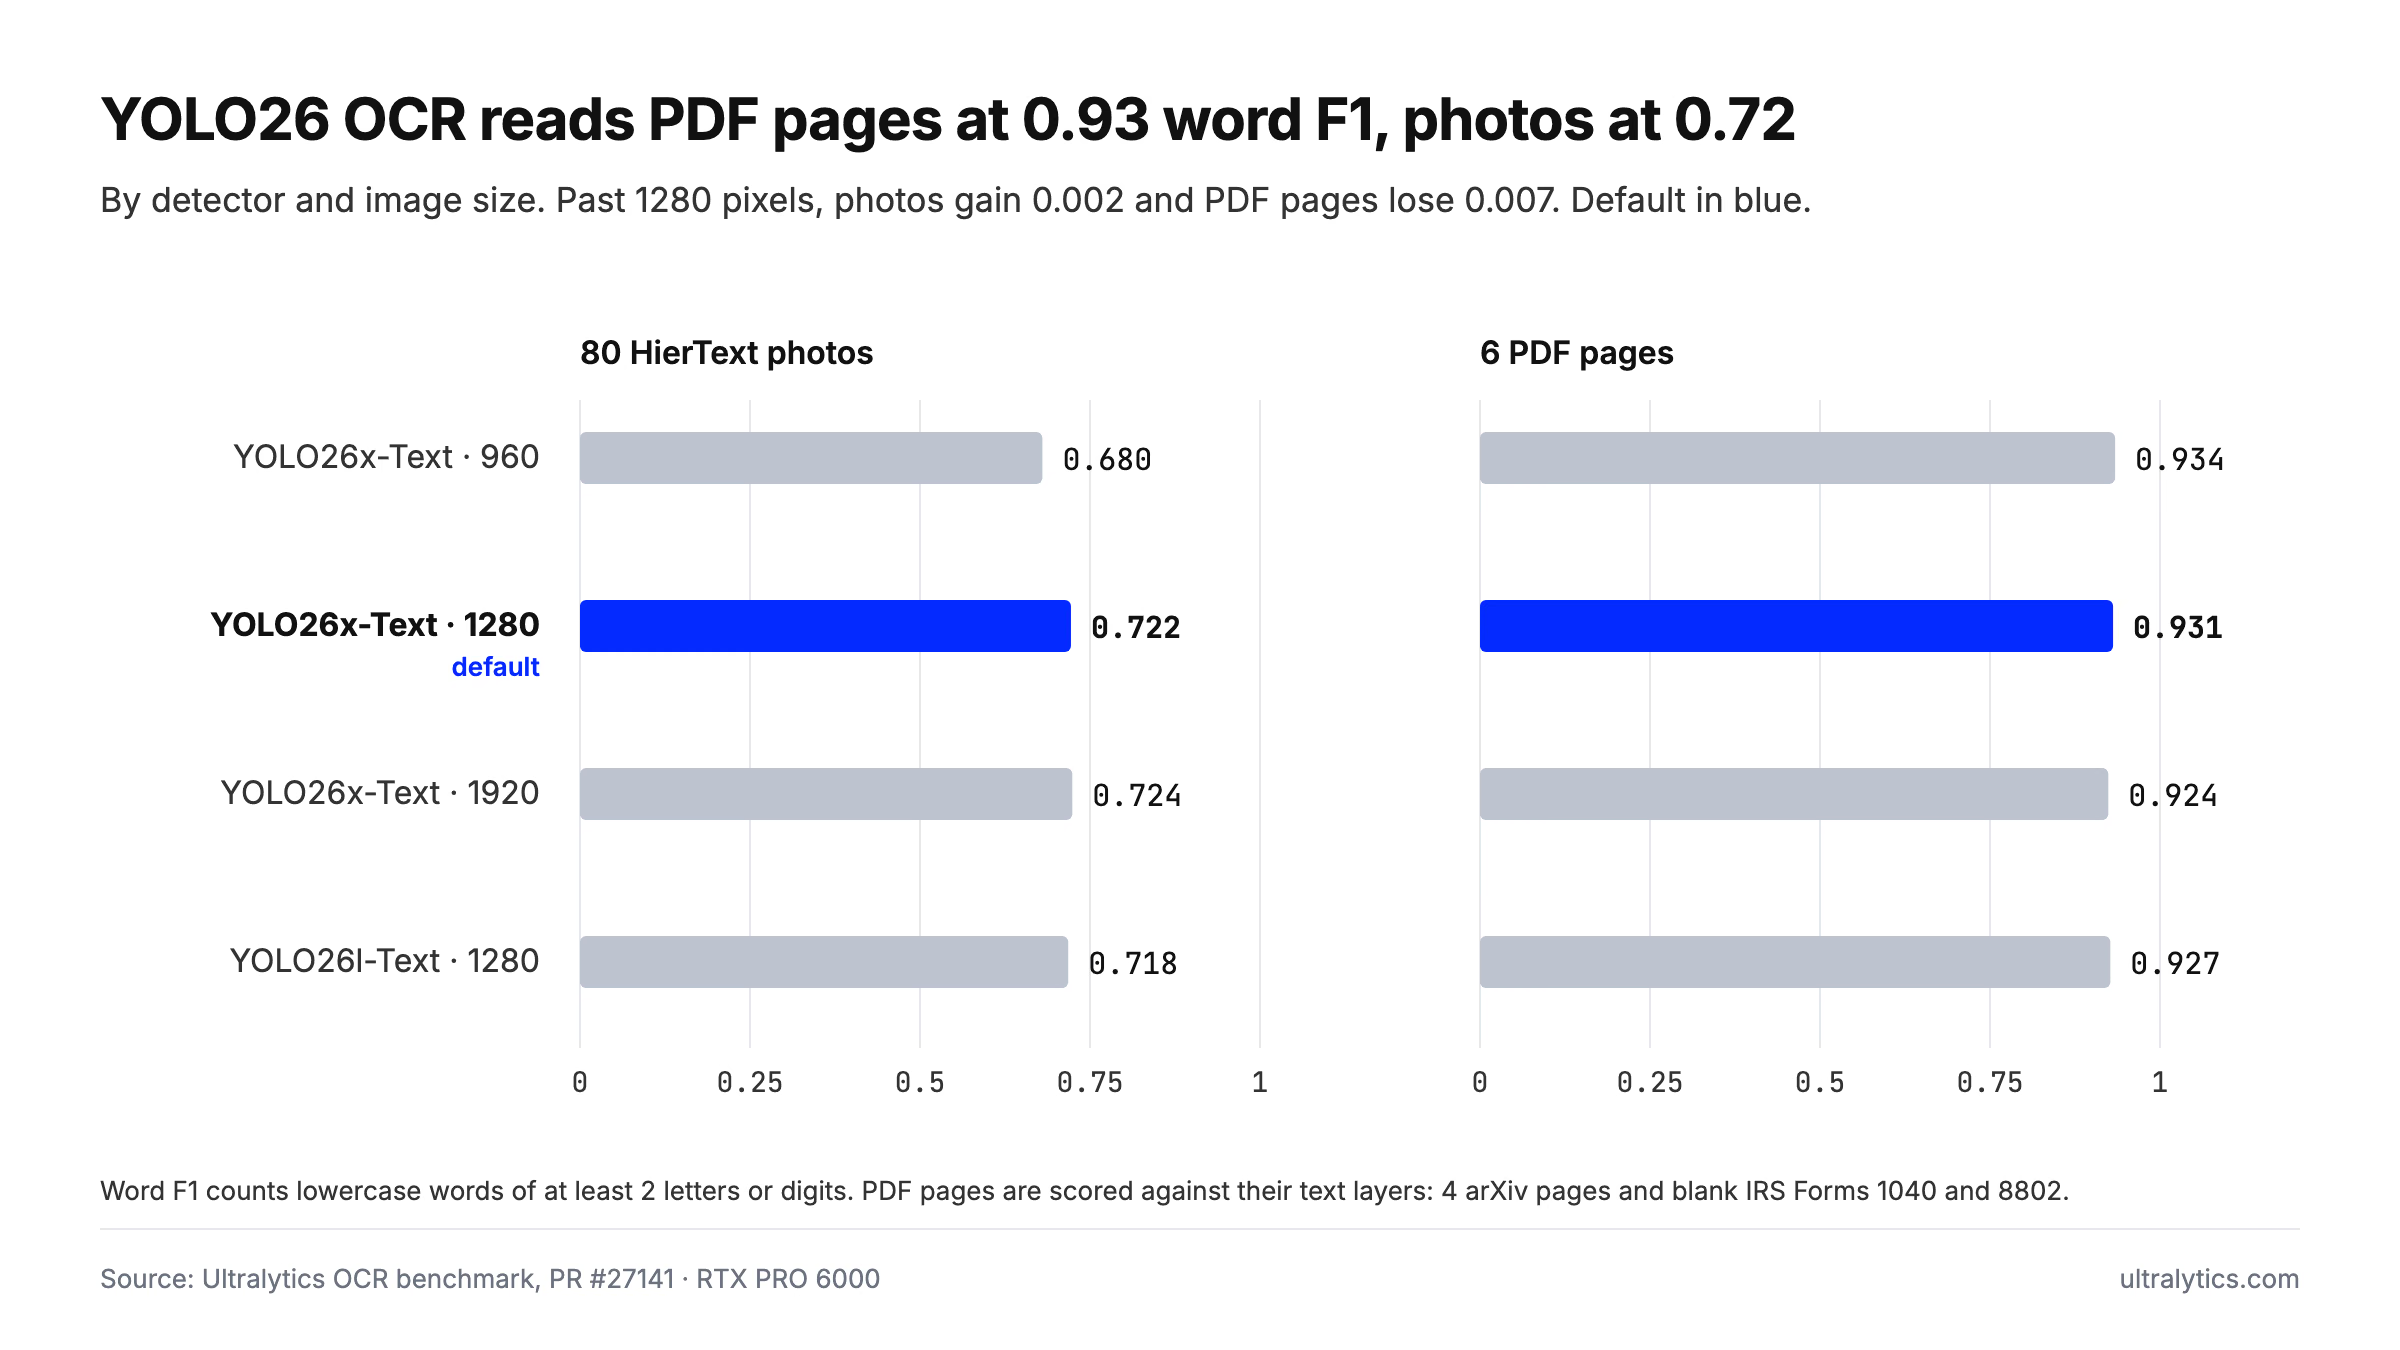
درجة F1 للكلمات في YOLO26-Text مع PP-OCRv6 على 80 صورة من HierText و6 صفحات PDF، بحسب الكاشف وحجم الصورة، على RTX PRO 6000.
تُقرأ صفحات PDF النظيفة أفضل بكثير من صور النصوص ضمن المشاهد في جميع الإعدادات، وتنبثق ثلاثة إعدادات افتراضية من هذه الأرقام:
yolo26x-textعندimgsz=1280. أدى خفض الحجم إلى 960 إلى خسارة 0.042 من F1 في الصور، بينما أضاف الحجم 1920 مقدار 0.002 في الصور وخسر 0.007 في صفحات PDF. لا تُكبّر الصور الأصغر إلى 1280؛ بل تُعالج بحجمها الأصلي، بعد تقريبه للأعلى إلى أقرب مضاعف لخطوة النموذج البالغة 32 بكسل.- اقرأ كلمةً كلمةً. تفوّقت قراءة الكلمات المفردة على قراءة الأسطر كاملةً بمقدار 4 نقاط F1 في الصور.
max_det=1000. تحتوي صفحة المستند الكثيفة على أكثر من 300 عملية كشف، وهو العدد المعتاد.
إذا كنت بحاجة إلى كاشف أخف، فقد بقي YOLO26l-Text ضمن نصف نقطة من نموذج x في كلتا المجموعتين.
كيفية تشغيل OCR باستخدام Python وYOLO26#
ثبّت الحزمة أو حدّثها باستخدام pip install -U "ultralytics>=8.4.211". عند استدعاء OCR للمرة الأولى، تُنزّل الحزمة YOLO26x-Text وPP-OCRv6 وتثبّت ONNX Runtime، مستخدمةً onnxruntime-gpu عند توفر CUDA. يتطلب أداة التعرّف الافتراضية ONNX Runtime الإصدار 3.11 أو أحدث من Python، والإصدار 1.26 أو أحدث من ONNX Runtime.
قراءة صورة#
import cv2
from ultralytics import solutions
ocr = solutions.OCR() # YOLO26x-Text عند imgsz=1280 مع PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im) # صورة مشروحة
for word in result.texts:
print(word["line"], word["text"], round(word["confidence"], 2))من سطر الأوامر، ينفّذ yolo solutions ocr source="path/to/video.mp4" العملية نفسها على كل إطار. وتُقرأ الإطارات كلٌّ على حدة، من دون تتبّع.
قراءة ملف PDF#
يتعامل الحل مع الصور، لذا حوّل كل صفحة من صفحات PDF إلى صورة أولًا. وتُعد PyMuPDF إحدى الطرق لتنفيذ ذلك:
import cv2
import numpy as np
import pymupdf # pip install pymupdf
from ultralytics import solutions
ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
pix = page.get_pixmap(dpi=200)
rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))
lines = {}
for word in result.texts: # مرتّبة بالفعل حسب تسلسل القراءة
lines.setdefault(word["line"], []).append(word["text"])
print("\n".join(" ".join(words) for words in lines.values()))بما أن result.texts مرتّب بالفعل، فإن إعادة بناء النص العادي لا تتطلب سوى قاموس ودمج. وتتيح لك المضلعات إجراء المزيد، مثل التحقق من وجود مبلغ بجوار كلمة "Total".
اختيار النموذج والجهاز وأداة التعرّف#
- كاشف أصغر: يحمّل
solutions.OCR(model="yolo26s-text.pt")كاشفًا أصغر وأسرع؛ تحقّق من دقته على صفحاتك. وتُنزّل الأحجام الخمسة تلقائيًا. - CPU أو GPU: تعمل أداة التعرّف على CUDA عند اختيار GPU يدعم CUDA وتوفر موفّر التنفيذ CUDA في ONNX Runtime، وتعمل على CPU خلاف ذلك، لذا يمكن تشغيل البرنامج النصي نفسه على حاسوب محمول أو خادم.
- أداة التعرّف الخاصة بك: مرّر دالةً بوصفها
recognizer. تستقبل الدالة قصاصة كلمة بصيغة BGR وتعيد(text, confidence)، ويواصل الحل تنفيذ الكشف والتدوير والترتيب حولها.
def recognize(crop):
# شغّل أي نموذج تعرّف على قصاصة الكلمة بصيغة BGR
return "example", 0.95
ocr = solutions.OCR(recognizer=recognize)يقرأ TensorRT الكلمات بسرعة أكبر بمقدار 2.5x إلى 3x في الصور الكثيفة#
في اختباراتنا على GPU للصفحات الكثيفة، استغرق التعرّف معظم الوقت، لا الكشف. قاس تحسين سابق زمن الكشف بنحو 11 ms من طلب استغرق 250 ms، وتتبع طلب سحب TensorRT جزءًا كبيرًا من زمن التعرّف المتبقي إلى 33 دفعة صغيرة هيمن عليها العبء الزائد لبدء التنفيذ بدلًا من الحساب. يضيف Ultralytics 8.4.211 وسيطًا واحدًا لهذا الغرض:
ocr = solutions.OCR(recognizer="tensorrt") # محرّك TensorRT بصيغة FP16 على وحدات GPU من NVIDIAينشئ التشغيل الأول محرّك TensorRT بصيغة FP16 في نحو 30 ثانية، ويخزّنه مؤقتًا بجوار نموذج PP-OCRv6، مرة واحدة لكل إصدار من TensorRT وبنية GPU. وتستغرق عمليات التحميل اللاحقة من 0.05 إلى 0.2 ثانية. ويذكر الإصدار أنه أسرع بنحو 2.5x من ONNX Runtime على الصفحات الكثيفة.
قِسنا read_words، وهي الخطوة التي تلي الكشف وتقص الكلمات وتدوّرها وتتعرف عليها وترتبها، على أربع صور لنصوص ضمن مشاهد. في الصور الثلاث التي احتوت على 195 إلى 263 كلمة، كان محرّك FP16 أسرع بمقدار 2.5x إلى 3x من ONNX Runtime على CUDA؛ أما في صورة احتوت على 48 كلمة، فكان أسرع بمقدار 1.4x:
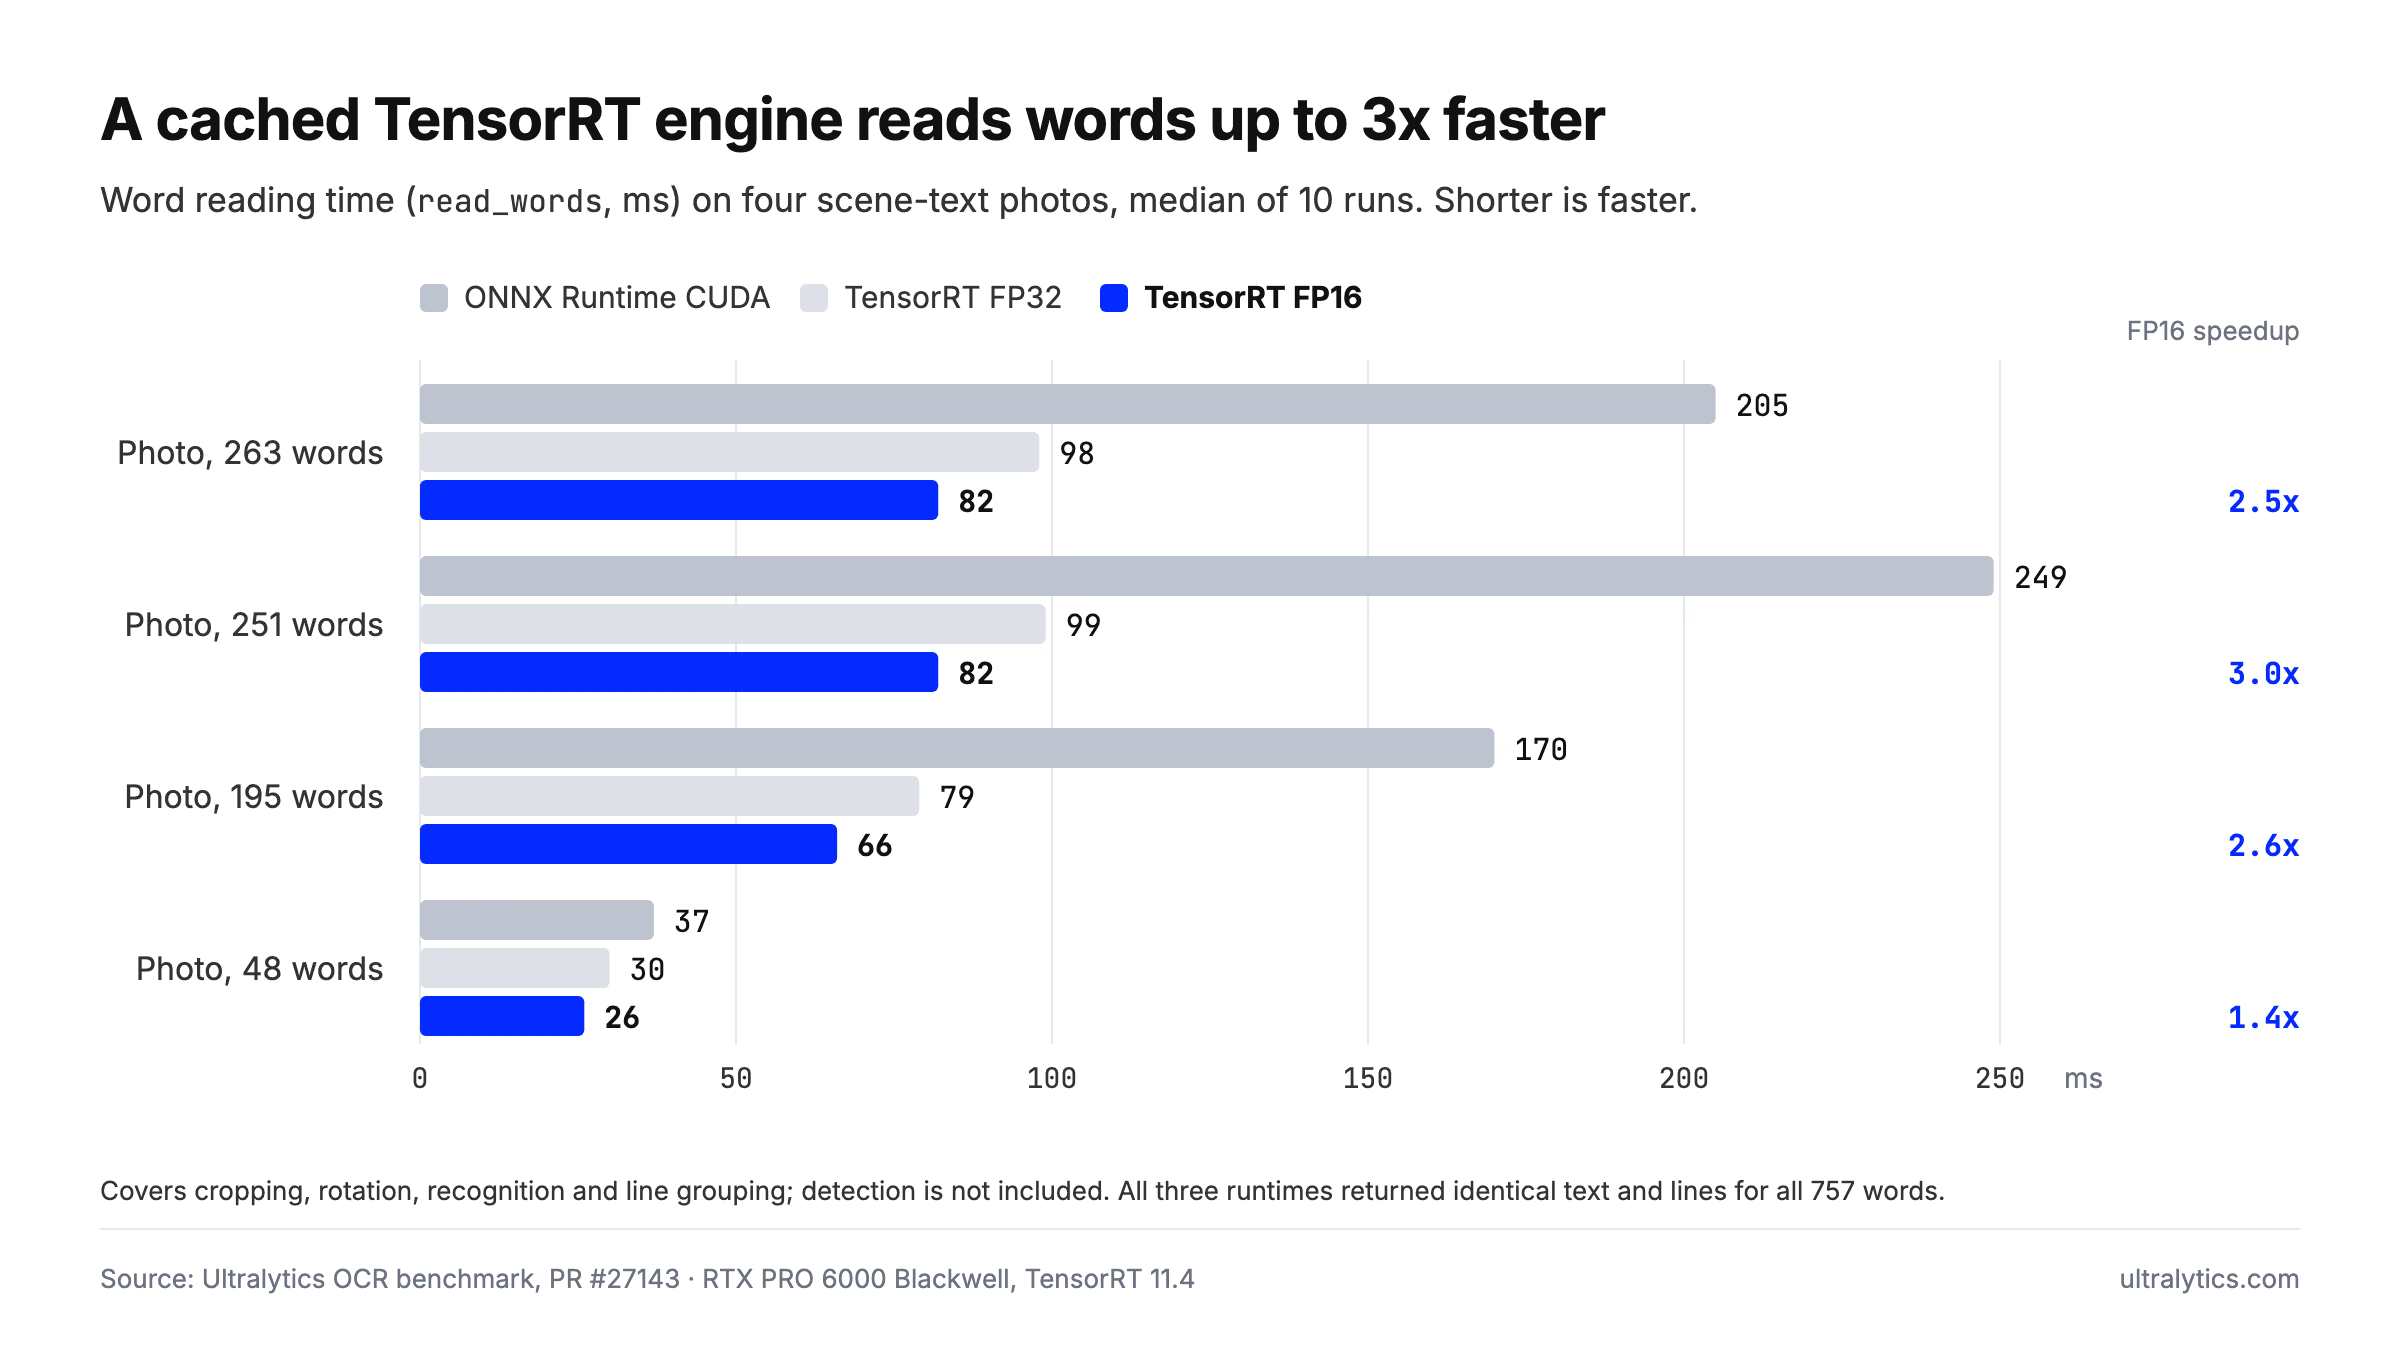
زمن قراءة الكلمات في أربع صور لنصوص ضمن مشاهد باستخدام ONNX Runtime CUDA ومحركي TensorRT بصيغتي FP32 وFP16، وهو متوسط 10 مرات تشغيل على RTX PRO 6000 Blackwell مع TensorRT 11.4.
انخفض زمن استدعاء OCR كامل على صفحة كثيفة من 182 ms إلى 94 ms. وفي هذه الصور الأربع، لم يغيّر التسريع الناتج: فقد أعاد ONNX Runtime وكلا المحركين النص نفسه وتجميع الأسطر نفسه للكلمات الـ757 كلها.
استخدم recognizer="paddleocr" الافتراضي عندما لا يمكنك انتظار الإنشاء الأول أو عندما لا تستخدم أجهزة NVIDIA. فهو لا ينشئ شيئًا ويبدأ العمل في نحو ثانية. وتتناول مقارنتنا بين ONNX وTensorRT المفاضلة نفسها لنماذج الكشف، كما يشرح دليل تكامل TensorRT الإعداد.
دعم النصوص الصينية واليابانية واللاتينية متاح حاليًا#
لا يستطيع PP-OCRv6 إخراج سوى المحارف الموجودة ضمن مجموعته المدمجة البالغ عددها 18,708. ولا يعتمد كاشف YOLO26-Text على مجموعة المحارف هذه، ويظل قادرًا على العثور على الكلمات المكتوبة بنصوص أخرى، لكن الكلمة التي لا تنتمي إلى المجموعة تُعاد بمحارف شبيهة بها. فعلى سبيل المثال، تُقرأ الكلمة الروسية ТЕКСТ على أنها "TEKCT"، وغالبًا بدرجة ثقة عالية.
- مدعوم: الصينية المبسطة والتقليدية (نحو 15,600 محرف صيني وياباني وكوري)، واليابانية (هيراغانا وكاتاكانا وكانجي)، واللغات المكتوبة بالأحرف اللاتينية، ومنها الإنجليزية والفرنسية والألمانية والإسبانية والبرتغالية والإيطالية والهولندية والسويدية والفنلندية والدنماركية والنرويجية والبولندية والتشيكية والمجرية والرومانية والتركية والكرواتية والإندونيسية والملايوية. ويغطي النظام جميع الأحرف والأحرف المشكولة، باستثناء الحرف الألماني الكبير ẞ وعلامة ¡ الإسبانية.
- مدعوم جزئيًا: الفيتنامية، حيث تغيب معظم الحروف الصوتية ذات النغمات، واليونانية، حيث لا تُغطى سوى الأحرف الأساسية.
- غير مدعوم بعد: السيريلية، والكورية (هانغول)، والعربية، والعبرية، والديفاناغارية، والتايلاندية.
للتعامل مع نص غير مدعوم، أبقِ على كاشف YOLO26-Text ومرّر أداة تعرّف مدرّبة لذلك النص على هيئة recognizer. يتضمن قسم اللغات المدعومة في دليل OCR جدول التغطية الكامل.
مقارنة مكتبات OCR لـPython بحسب الإمكانات الموثقة#
لا يوجد نموذج OCR واحد هو الأفضل دائمًا؛ فالخيار المناسب يتوقف على صفحاتك ولغاتك وبيئة تشغيل الشفرة. يقارن الجدول الإمكانات الموثقة، لا النتائج المقاسة، استنادًا إلى الصفحات العامة لكل مشروع كما كانت في 12 نوفمبر 2026. وعُرضت الخيارات بترتيب أبجدي.
| الخيار | بيئة التشغيل | النص المدوّر | اللغات بحسب التوثيق | الناتج |
|---|---|---|---|---|
| EasyOCR | PyTorch | تجرّب rotation_info زوايا 90° و180° و270° لكل صندوق نص | أكثر من 80 لغة، منها السيريلية والعربية والديفاناغارية والكورية والتايلاندية | الصناديق والنص والثقة |
| PaddleOCR | PaddlePaddle | تصنيف اتجاه اختياري | أكثر من 100 لغة (يغطي PP-OCRv6 50 لغة في نموذج واحد) | الصناديق والنص والثقة |
| Tesseract (pytesseract) | ملف تنفيذي أصلي، يعمل على CPU | اكتشاف الاتجاه والنص (image_to_osd)؛ دوّر الصورة قبل قراءتها | 100+ | النص، مع بيانات الكلمات الاختيارية |
| Ultralytics YOLO26 OCR | كاشف PyTorch؛ أداة التعرّف على ONNX Runtime أو TensorRT على وحدات GPU من NVIDIA | تقدير تدوير الصفحة من النص المكتشف، مع حسم 0° مقابل 180° تلقائيًا | الصينية واليابانية والنصوص اللاتينية؛ ويمكن دعم غيرها باستخدام أداة تعرّف مخصصة | كلمات بترتيب القراءة مع أرقام الأسطر والمضلعات ودرجات ثقة منفصلة للكشف والتعرّف |
يمكنك الرجوع إلى توثيق EasyOCR ومستودع PaddleOCR وتوثيق Tesseract وpytesseract للتحقق من الخيارات المتاحة حاليًا. ولمعرفة المزيد عن آلية عمل هذه المحركات، راجع عرضنا العام عن نماذج OCR الشائعة مفتوحة المصدر.
موضع Ultralytics في المنظومة#
صُمم Ultralytics YOLO26 OCR لمطوري Python الذين يحتاجون إلى استخراج النص من مدخلات متنوعة، مثل النماذج الممسوحة ضوئيًا وصفحات PDF ولقطات الشاشة وصور الملصقات واللافتات، مع ترتيب الكلمات حسب القراءة وإتاحة إحداثيات يمكن التحقق منها. وهو مناسب عندما تصل الصفحات بزوايا غير متوقعة، أو عندما تريد تشغيل OCR على أجهزتك، أو عندما تستخدم بالفعل نماذج Ultralytics YOLO26 وتريد إضافة OCR ضمن الحزمة نفسها. أضف recognizer="tensorrt" لمعالجة أحجام كبيرة على وحدات GPU من NVIDIA.
الكاشف نموذج عادي من Ultralytics، لذا يمكن تدريبه والتحقق منه وتصديره مثل أي نموذج آخر. يضم مشروع YOLO26-Text على Ultralytics Platform الأحجام الخمسة، من n إلى x، حيث يمكنك مقارنة منحنيات التدريب واستنساخ المشروع للبدء منها.
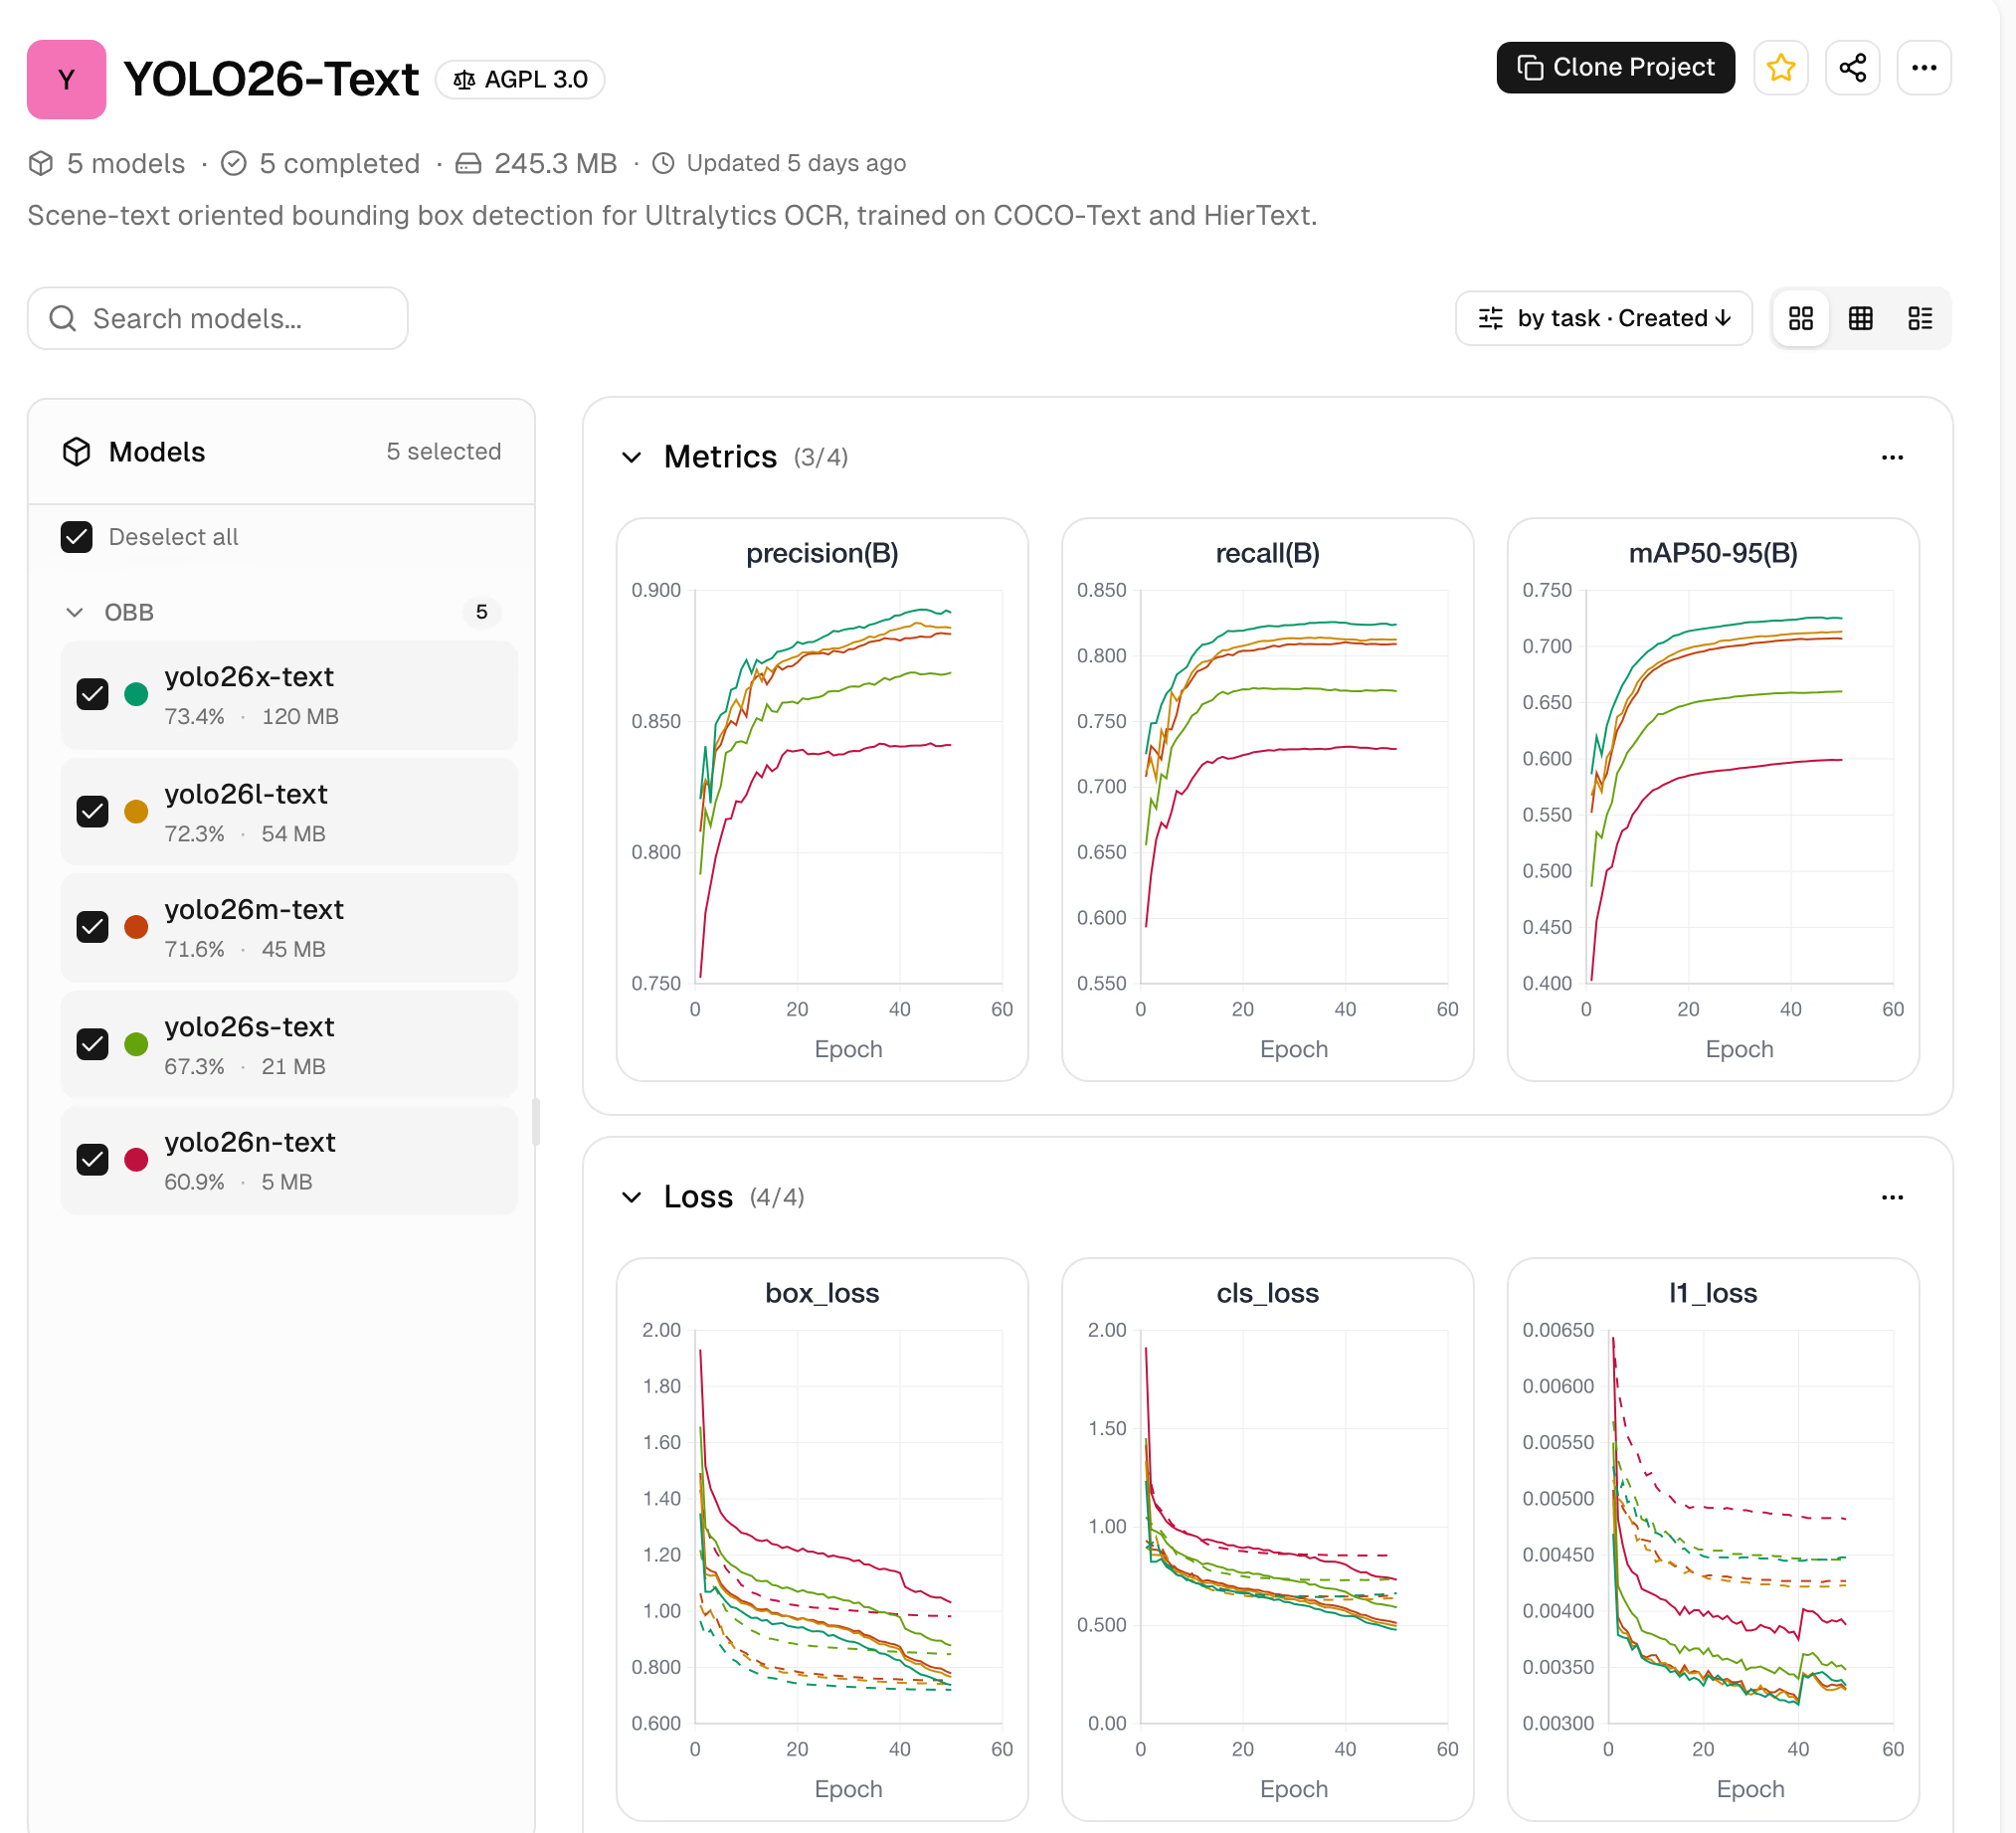
مشروع YOLO26-Text على Ultralytics Platform: أحجام الكاشف الخمسة مع منحنيات الإحكام والاستدعاء وmAP50-95 والخسارة أثناء التدريب.
لتكييف النموذج مع مستنداتك، ابدأ من مجموعة بيانات Scene Text OBB، التي تجمع بين COCO-Text وHierText في 65,325 صورة تضم نحو 1.29 مليون مضلع للكلمات.
لهذا الحل قيود محددة:
- النصوص. لا تقرأ أداة التعرّف الافتراضية السيريلية أو الكورية أو العربية أو العبرية أو الديفاناغارية أو التايلاندية بعد. استخدم الكاشف مع أداة تعرّف خاصة بك، أو اختر محركًا يدعم هذه النصوص.
- الاتجاهات المختلطة. يدوّر الحل الصفحة بأكملها وفق اتجاه النص السائد، لذا قد تكون القراءة أقل دقة للنصوص متعددة الاتجاهات في الصفحة نفسها، مثل ملاحظة هامشية عمودية.
- التصدير. لا تُضمّن أداة التعرّف في ملف الكاشف المُصدّر، لذا انشر الكاشف وبيئة تشغيل التعرّف جنبًا إلى جنب، أو أبقِ حل Python طبقةً وسيطةً للتنسيق بينهما.
- Rust. تقرأ Ultralytics Inference نصوص المشاهد باستخدام Rust وأداة التعرّف PP-OCRv6 نفسها عبر
ultralytics-inference predict --ocr، لكنها تتعامل مع الاتجاه باستخدام مصنّف بدلًا من خطوة تدوير الصفحة في حل Python. - الخصوصية. يعمل حل Python على أجهزتك، لذا لا يلزم أن تغادر الصفحات أجهزتك؛ أما العرض التوضيحي في المتصفح فيرفع الصفحات لإجراء الاستدلال. وبالنسبة إلى الحقول التي يجب عدم قراءتها، غطِّ المناطق المعروفة بقناع معتم قبل تشغيل OCR.
في النماذج والعقود، يمكن لنموذج YOLO مخصص العثور أولًا على الحقول والجداول والتوقيعات والأختام، بحيث لا تقرأ إلا المناطق التي تحتاج إليها. تُعد مجموعة بيانات التوقيعات على Ultralytics Platform ودليلنا حول تحليل المستندات الذكي نقطتي بداية مناسبتين، كما تتيح لك Ultralytics Platform وسم الصفحات وتدريب ذلك النموذج في مكان واحد. ولمعاينة OCR على صفحتك، ألقِ صورة أو ملف PDF في عرض OCR المباشر.
الأسئلة الشائعة
ثبّت حزمة Ultralytics باستخدام
pip install -U "ultralytics>=8.4.211"، ثم استدعِsolutions.OCR()على صورة محمّلة باستخدام OpenCV. ويعيد الكلمات التي تعرّف عليها مع نصها ودرجة الثقة ورقم السطر والمضلع، مرتبةً حسب القراءة. عند التشغيل الأول، يُنزّل كاشف YOLO26-Text وأداة التعرّف PP-OCRv6 تلقائيًا.يعتمد ذلك على مستنداتك ولغاتك وأجهزتك؛ وتُقارن مراجعتنا العامة لـنماذج OCR الشائعة مفتوحة المصدر الخيارات الرئيسية. في اختبار الأداء الذي أجريناه بحجم صورة 1280 على RTX PRO 6000، حقق YOLO26x-Text مع PP-OCRv6 درجة F1 للكلمات بلغت 0.931 في ست صفحات PDF و0.722 في 80 صورة من HierText، كما يقرأ الصفحات بأي زاوية. وبالنسبة إلى النصوص التي لا يدعمها بعد، مثل السيريلية أو الكورية، استخدم أداة تعرّف مدرّبة على ذلك النص.
يكتشف نموذج YOLO النص لكنه لا يقرأه. يكتشف Ultralytics YOLO26-Text النص في هيئة صناديق موجّهة، ويمرّر حل OCR كل قصاصة إلى أداة التعرّف PP-OCRv6، وبذلك ينجزان معًا OCR كاملًا باستدعاء واحد.
نعم. حوّل كل صفحة من ملف PDF إلى صورة، مثلًا باستخدام
get_pixmapفي PyMuPDF، ثم حوّلها إلى BGR ومرّرها إلىsolutions.OCR(). في المتصفح، يقبل العرض التوضيحي وعلامة التبويب Platform Predict ملف PDF ويقرآن صفحته الأولى.نعم. يعمل PP-OCRv6 على ONNX Runtime باستخدام CPU أو وحدات GPU مع CUDA، ويعمل النص البرمجي نفسه على كليهما. ويتطلب مُعرِّف TensorRT الاختياري وحدة GPU من NVIDIA.
ليس بعد باستخدام أداة التعرّف الافتراضية. يدعم PP-OCRv6 الصينية واليابانية واللغات المكتوبة بالأبجدية اللاتينية، لكنه لا يدعم السيريلية أو الهانغول أو العربية أو العبرية أو الديفاناغارية أو التايلاندية. يمكنك الإبقاء على كاشف YOLO26-Text وتمرير أداة تعرّف مدرَّبة على ذلك الخط.
بقلم
مهندس تعلم آلي أول · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









