Verarbeitung natürlicher Sprache und Computer Vision verbinden
Erfahre, wie die Verarbeitung natürlicher Sprache (NLP) und Computer Vision (CV) gemeinsam Branchen mit intelligenteren, multimodalen KI-Systemen verändern können.
 Abirami Vina8 Min. Lesezeit

Die Verarbeitung natürlicher Sprache (NLP) und Computer Vision (CV) sind zwei eigenständige Teilgebiete der künstlichen Intelligenz (AI), die in den vergangenen Jahren stark an Bedeutung gewonnen haben. Dank der Fortschritte im Bereich der AI sind diese beiden Gebiete heute stärker miteinander verbunden als je zuvor.
Ein gutes Beispiel dafür ist die automatische Bildbeschreibung. Computer Vision kann den Inhalt eines Bildes analysieren und verstehen, während die Verarbeitung natürlicher Sprache eine passende Bildbeschreibung erzeugt. Automatische Bildbeschreibungen werden häufig auf Social-Media-Plattformen eingesetzt, um die Barrierefreiheit zu verbessern, und in Content-Management-Systemen, um Bilder effizient zu organisieren und mit Schlagwörtern zu versehen.
Innovationen in der Verarbeitung natürlicher Sprache und bei Vision-KI haben zu zahlreichen Anwendungen in verschiedensten Branchen geführt. In diesem Artikel befassen wir uns näher mit der Verarbeitung natürlicher Sprache und Computer Vision und erklären, wie beide funktionieren. Außerdem stellen wir Anwendungen vor, die diese beiden Technologien gemeinsam nutzen.
NLP und Vision AI verstehen#
Die Verarbeitung natürlicher Sprache befasst sich mit der Interaktion zwischen Computern und menschlicher Sprache. Sie ermöglicht es Maschinen, Texte oder Sprache sinnvoll zu verstehen, zu interpretieren und zu erzeugen. Sie kann für Aufgaben wie Übersetzung, Sentimentanalyse oder Zusammenfassung eingesetzt werden.
Computer Vision hilft Maschinen, Bilder und Videos zu analysieren und zu verarbeiten. Sie kann für Aufgaben wie das Erkennen von Objekten in einem Foto, Gesichtserkennung, Objektverfolgung oder Bildklassifizierung eingesetzt werden. Vision-KI ermöglicht es Maschinen, die visuelle Welt besser zu verstehen und mit ihr zu interagieren.
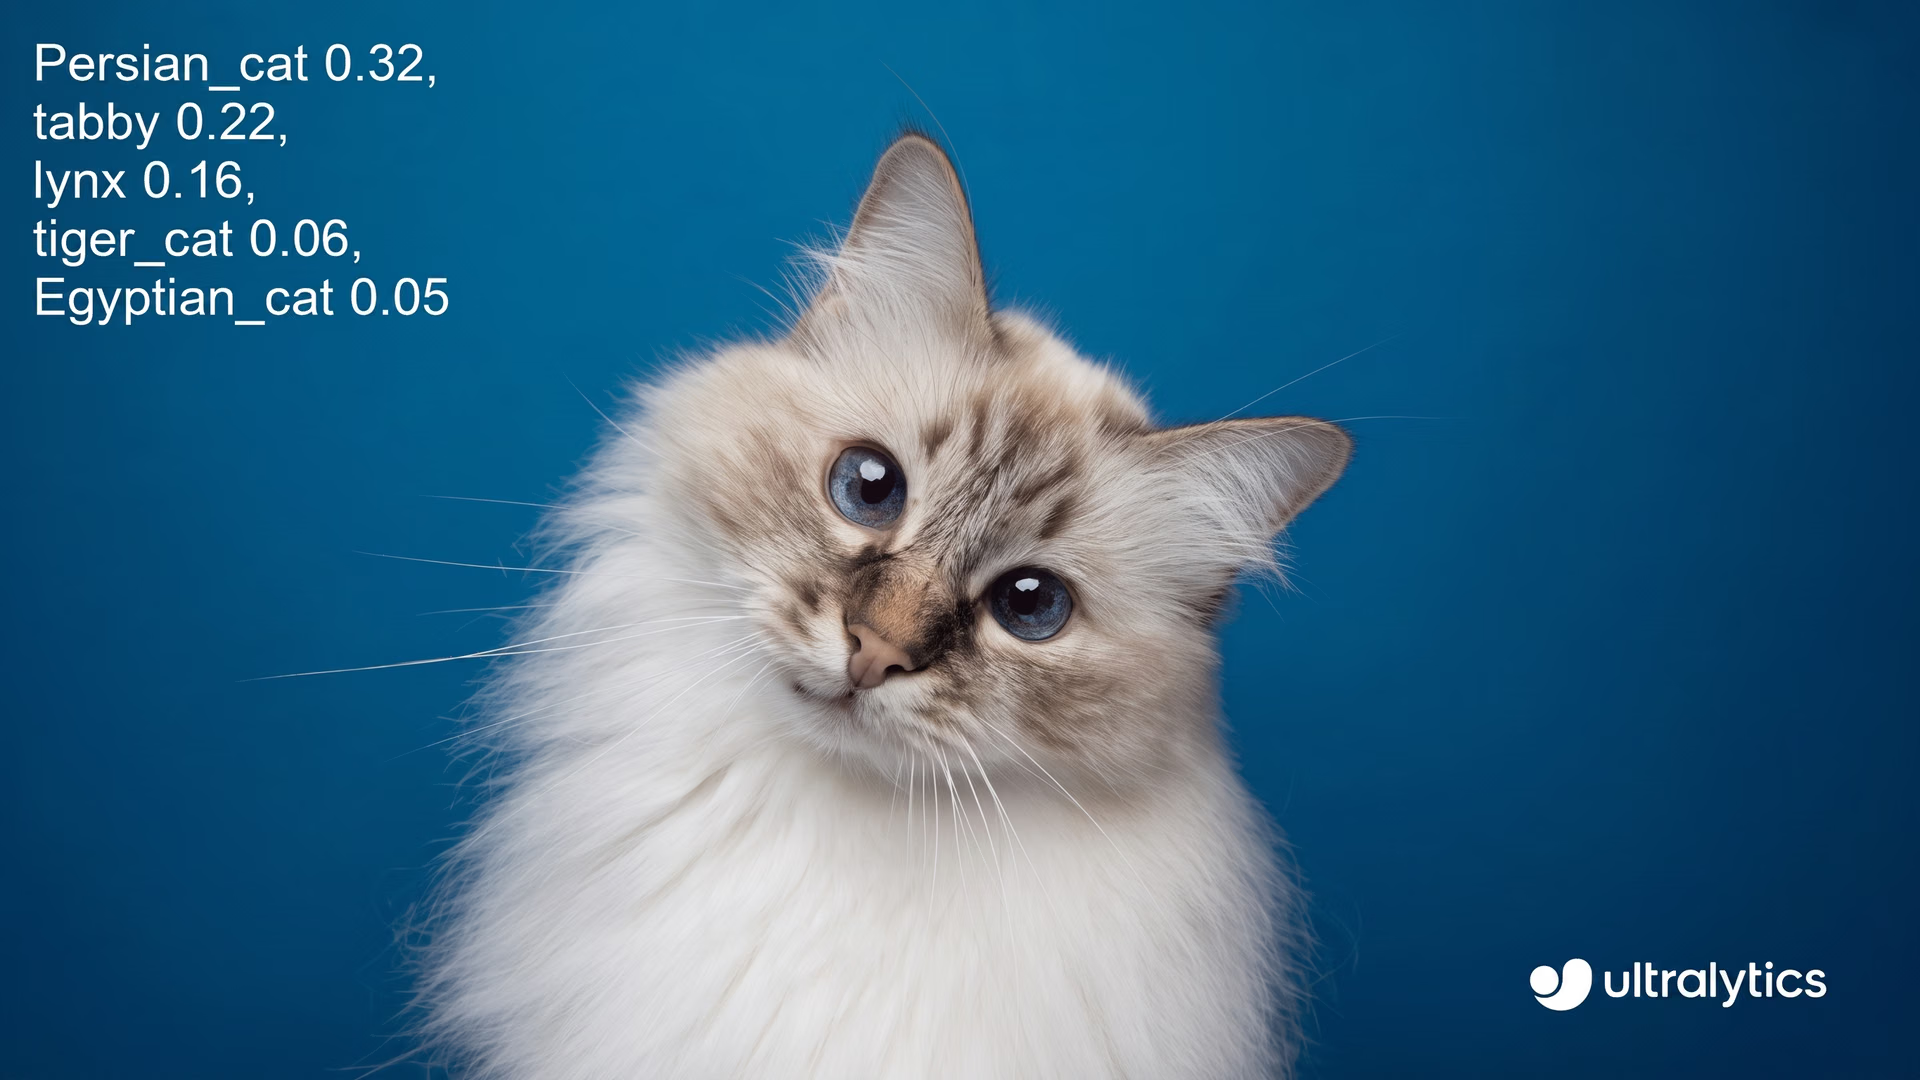
Abb. 1: Beispiel für Bildklassifizierung.
In Kombination mit Computer Vision kann die Verarbeitung natürlicher Sprache visuellen Daten Bedeutung verleihen, indem sie Text und Bilder zusammenführt und so ein tieferes Verständnis ermöglicht. Wie das Sprichwort sagt: „Ein Bild sagt mehr als tausend Worte.“ In Verbindung mit Text wird es noch aussagekräftiger und liefert umfassendere Erkenntnisse.
Beispiele für das Zusammenspiel von NLP und Computer Vision#
Wahrscheinlich hast du schon erlebt, wie die Verarbeitung natürlicher Sprache und Computer Vision in alltäglichen Tools zusammenarbeiten, ohne es zu bemerken – etwa wenn dein Smartphone den Text auf einem Bild übersetzt.
Google Translate nutzt sowohl die Verarbeitung natürlicher Sprache als auch Computer Vision, um Text in Bildern zu übersetzen. Wenn du ein Foto von einem Verkehrsschild in einer anderen Sprache aufnimmst, erkennt und extrahiert Computer Vision den Text, während die Verarbeitung natürlicher Sprache ihn in deine bevorzugte Sprache übersetzt.
Die Verarbeitung natürlicher Sprache und Computer Vision arbeiten zusammen, um den Ablauf reibungslos und effizient zu gestalten. So können Nutzer Informationen in verschiedenen Sprachen in Echtzeit verstehen und verarbeiten. Diese Integration hilft, Kommunikationsbarrieren abzubauen.

Abb. 2. Die Übersetzungsfunktion von Google.
Hier sind einige weitere Anwendungsbereiche, in denen NLP und Computer Vision zusammenarbeiten:
- Selbstfahrende Autos: CV kann Verkehrszeichen, Fahrspuren und Hindernisse erkennen, während die Verarbeitung natürlicher Sprache gesprochene Befehle oder den Text auf Verkehrszeichen verarbeiten kann.
- Dokumentenleser: Vision-KI kann Text in gescannten Dokumenten oder Handschrift erkennen, während die Verarbeitung natürlicher Sprache die Informationen interpretieren und zusammenfassen kann.
- Visuelle Suche in Shopping-Apps: Computer Vision kann Produkte auf Fotos erkennen, während die Verarbeitung natürlicher Sprache Suchbegriffe verarbeitet, um Empfehlungen zu verbessern.
- Lernwerkzeuge: CV kann handschriftliche Notizen oder visuelle Eingaben erkennen, während die Verarbeitung natürlicher Sprache auf Grundlage des Inhalts Erklärungen oder Feedback geben kann.
Wichtige Konzepte an der Schnittstelle von Computer Vision und NLP#
Nachdem wir gesehen haben, wie Computer Vision und die Verarbeitung natürlicher Sprache eingesetzt werden, sehen wir uns nun an, wie beide zusammenarbeiten und multimodale KI ermöglichen.
Multimodale KI verbindet das visuelle Verständnis von Computer Vision mit dem Sprachverständnis der Verarbeitung natürlicher Sprache, um Informationen aus Texten und Bildern zu verarbeiten und miteinander zu verknüpfen. Im Gesundheitswesen kann multimodale KI beispielsweise eine Röntgenaufnahme analysieren und eine verständliche schriftliche Zusammenfassung möglicher Probleme erstellen. So können Ärzte schneller und präziser entscheiden.
Verstehen natürlicher Sprache (NLU)#
Das Sprachverständnis ist ein Teilgebiet der Verarbeitung natürlicher Sprache. Es konzentriert sich darauf, die Bedeutung von Text zu interpretieren und zu erschließen, indem Absicht, Kontext, Semantik, Ton und Struktur analysiert werden. Während die Verarbeitung natürlicher Sprache Rohtext verarbeitet, ermöglicht das Sprachverständnis Maschinen, menschliche Sprache effektiver zu begreifen. Parsing ist beispielsweise eine Technik des Sprachverständnisses, die geschriebenen Text in ein strukturiertes, maschinenverständliches Format umwandelt.

Abb. 3. Das Verhältnis zwischen NLP und NLU.
NLU arbeitet mit Computer Vision zusammen, wenn visuelle Daten Text enthalten, der verstanden werden muss. Computer Vision extrahiert mithilfe von Technologien wie der optischen Zeichenerkennung (OCR) Text aus Bildern, Dokumenten oder Videos. Dazu gehören Aufgaben wie das Scannen eines Kassenbons, das Lesen von Text auf einem Schild oder das Digitalisieren handschriftlicher Notizen.
Anschließend verarbeitet NLU den extrahierten Text, um dessen Bedeutung, Kontext und Absicht zu verstehen. Durch diese Kombination können Systeme mehr tun, als nur Text zu erkennen: Sie können Ausgaben auf Kassenbons kategorisieren oder Tonfall und Stimmung analysieren. Zusammen machen Computer Vision und NLU visuellen Text zu aussagekräftigen, umsetzbaren Informationen.
Prompt Engineering#
Prompt Engineering bezeichnet die Entwicklung klarer, präziser und detaillierter Eingabeaufforderungen, mit denen generative KI-Systeme wie große Sprachmodelle (LLMs) und Vision-Language-Modelle (VLMs) zu gewünschten Ausgaben angeleitet werden. Diese Prompts dienen als Anweisungen, die dem KI-Modell helfen, die Absicht des Nutzers zu verstehen.
Für effektives Prompt Engineering musst du die Fähigkeiten des Modells verstehen und Eingaben so formulieren, dass das Modell möglichst präzise, kreative oder aufschlussreiche Antworten erzeugt. Das ist besonders wichtig bei multimodalen Modellen, die sowohl mit Text als auch mit Bildern arbeiten.
Nehmen wir als Beispiel das Text-zu-Bild-Modell DALL·E von OpenAI. Wenn du es bittest, „ein fotorealistisches Bild eines Astronauten auf einem Pferd“ zu erstellen, kann es genau das anhand deiner Beschreibung erzeugen. Das ist in Bereichen wie Grafikdesign nützlich, wo Fachleute Textideen schnell in visuelle Entwürfe umsetzen, Zeit sparen und ihre Produktivität steigern können.

Abb. 4. Ein mit OpenAI DALL-E erstelltes Bild.
Vielleicht fragst du dich, wie das mit Computer Vision zusammenhängt – ist das nicht einfach generative KI? Tatsächlich sind beide eng miteinander verwandt. Generative KI baut auf den Grundlagen von Computer Vision auf, um völlig neue visuelle Inhalte zu erstellen.
Generative KI-Modelle, die Bilder anhand von Text-Prompts erstellen, werden mit umfangreichen Datensätzen aus Bildern und den dazugehörigen Textbeschreibungen trainiert. Dadurch lernen sie die Beziehungen zwischen Sprache und visuellen Konzepten wie Objekten, Texturen und räumlichen Beziehungen.
Diese Modelle interpretieren visuelle Daten nicht auf dieselbe Weise wie herkömmliche Computer-Vision-Systeme, die beispielsweise Objekte in realen Bildern erkennen. Stattdessen nutzen sie ihr erlerntes Verständnis dieser Konzepte, um auf Grundlage von Prompts neue Bilder zu erzeugen. Durch die Verbindung dieses Wissens mit sorgfältig formulierten Prompts kann generative KI realistische und detailreiche Bilder erstellen, die der Eingabe des Nutzers entsprechen.
Fragebeantwortung (QA)#
Fragebeantwortungssysteme sind darauf ausgelegt, Fragen in natürlicher Sprache zu verstehen und genaue, relevante Antworten zu geben. Sie nutzen Verfahren wie Informationssuche, semantisches Verständnis und Deep Learning, um Anfragen zu interpretieren und zu beantworten.
Fortschrittliche Modelle wie GPT-4o von OpenAI können visuelle Fragen beantworten (VQA), also Bilder analysieren und Fragen dazu beantworten. GPT-4o führt jedoch nicht direkt Computer-Vision-Aufgaben aus. Stattdessen verarbeitet ein spezialisierter Bildencoder die Bilder, extrahiert Merkmale und verknüpft sie mit dem Sprachverständnis des Modells, um Antworten zu geben.

Abb. 5: ChatGPTs Fähigkeit zur visuellen Fragebeantwortung. Bild vom Autor.
Andere Systeme gehen noch einen Schritt weiter und integrieren Computer-Vision-Funktionen vollständig. Sie können Bilder oder Videos direkt analysieren, um Objekte, Szenen oder Text zu erkennen. In Verbindung mit der Verarbeitung natürlicher Sprache können sie komplexere Fragen zu visuellen Inhalten beantworten. Sie können zum Beispiel Fragen wie „Welche Objekte sind auf diesem Bild zu sehen?“ oder „Wer ist in dieser Aufnahme zu sehen?“ beantworten, indem sie visuelle Elemente erkennen und interpretieren. Wie gut aktuelle Vision-Language-Modelle Objekte in Bildern lokalisieren, erfährst du auf der VLM-Bestenliste.
Lernen ohne Beispiele (ZSL)#
Zero-Shot-Lernen (ZSL) ist ein Verfahren des maschinellen Lernens, mit dem KI-Modelle neue, zuvor unbekannte Aufgaben bewältigen können, ohne speziell dafür trainiert worden zu sein. Dazu nutzt es zusätzliche Informationen wie Beschreibungen oder semantische Beziehungen, um bereits Bekanntes (bekannte Klassen) mit neuen, unbekannten Kategorien zu verknüpfen.
Bei der Verarbeitung natürlicher Sprache hilft ZSL Modellen, Themen zu verstehen und zu bearbeiten, für die sie nicht trainiert wurden. Dafür nutzen die Modelle Beziehungen zwischen Wörtern und Konzepten. Ähnlich ermöglicht ZSL in der Computer Vision, zuvor unbekannte Objekte oder Szenen zu erkennen, indem visuelle Merkmale wie Flügel oder Federn mit bekannten Konzepten wie Vögeln verknüpft werden.
ZSL verbindet NLP und CV, indem es Sprachverständnis mit visueller Erkennung kombiniert. Dadurch eignet es sich besonders für Aufgaben, bei denen beides gefragt ist. Bei der visuellen Fragebeantwortung kann ein Modell beispielsweise ein Bild analysieren und gleichzeitig eine dazugehörige Frage verstehen, um eine genaue Antwort zu geben. Auch für Aufgaben wie die Bildbeschreibung ist ZSL nützlich.
Die wichtigsten Erkenntnisse#
Die Verbindung von Verarbeitung natürlicher Sprache und Computer Vision hat zu KI-Systemen geführt, die sowohl Texte als auch Bilder verstehen können. Diese Kombination kommt in vielen Branchen zum Einsatz: Sie hilft selbstfahrenden Autos beim Lesen von Verkehrszeichen, verbessert medizinische Diagnosen und macht soziale Medien sicherer. Mit den Fortschritten dieser Technologien wird der Alltag weiter erleichtert und es werden neue Möglichkeiten in vielen Bereichen eröffnet. Weitere Informationen findest du in unserem GitHub-Repository; tausche dich auch mit unserer Community aus. Entdecke auf unseren Lösungsseiten KI-Anwendungen in selbstfahrenden Autos und der Landwirtschaft.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









