Faire le lien entre le traitement du langage naturel et la vision par ordinateur
Découvre comment le traitement du langage naturel (NLP) et la vision par ordinateur (CV) peuvent se combiner pour transformer les secteurs d’activité grâce à des systèmes d’IA intermodaux plus intelligents.
 Abirami Vina10 min de lecture

Le traitement automatique du langage naturel (NLP) et la vision par ordinateur (CV) sont deux branches distinctes de l’intelligence artificielle (IA) qui ont gagné en popularité ces dernières années. Grâce aux progrès de l’IA, ces deux branches sont aujourd’hui plus étroitement liées que jamais.
La génération automatique de légendes d’images en est un excellent exemple. La vision par ordinateur peut servir à analyser et à comprendre le contenu d’une image, tandis que le traitement automatique du langage naturel peut générer une légende pour la décrire. La génération automatique de légendes d’images est couramment utilisée sur les réseaux sociaux pour améliorer l’accessibilité, ainsi que dans les systèmes de gestion de contenu pour organiser et étiqueter efficacement les images.
Les innovations en matière de NLP et de vision par IA ont donné naissance à de nombreux cas d’usage de ce type dans différents secteurs. Dans cet article, nous allons examiner de plus près le NLP et la vision par ordinateur et expliquer leur fonctionnement. Nous explorerons également les applications qui combinent ces deux technologies.
Comprendre le NLP et l’IA visuelle#
Le NLP porte sur les interactions entre les ordinateurs et le langage humain. Il permet aux machines de comprendre, d’interpréter et de générer du texte ou de la parole de manière pertinente. Il peut servir à effectuer des tâches comme la traduction, l’analyse des sentiments ou le résumé.
La vision par ordinateur permet quant à elle aux machines d’analyser et de traiter des images et des vidéos. Elle peut servir à des tâches comme la détection d’objets dans une photo, la reconnaissance faciale, le suivi d’objets ou la classification d’images. Les technologies de vision par IA permettent aux machines de mieux comprendre le monde visuel et d’interagir avec lui.
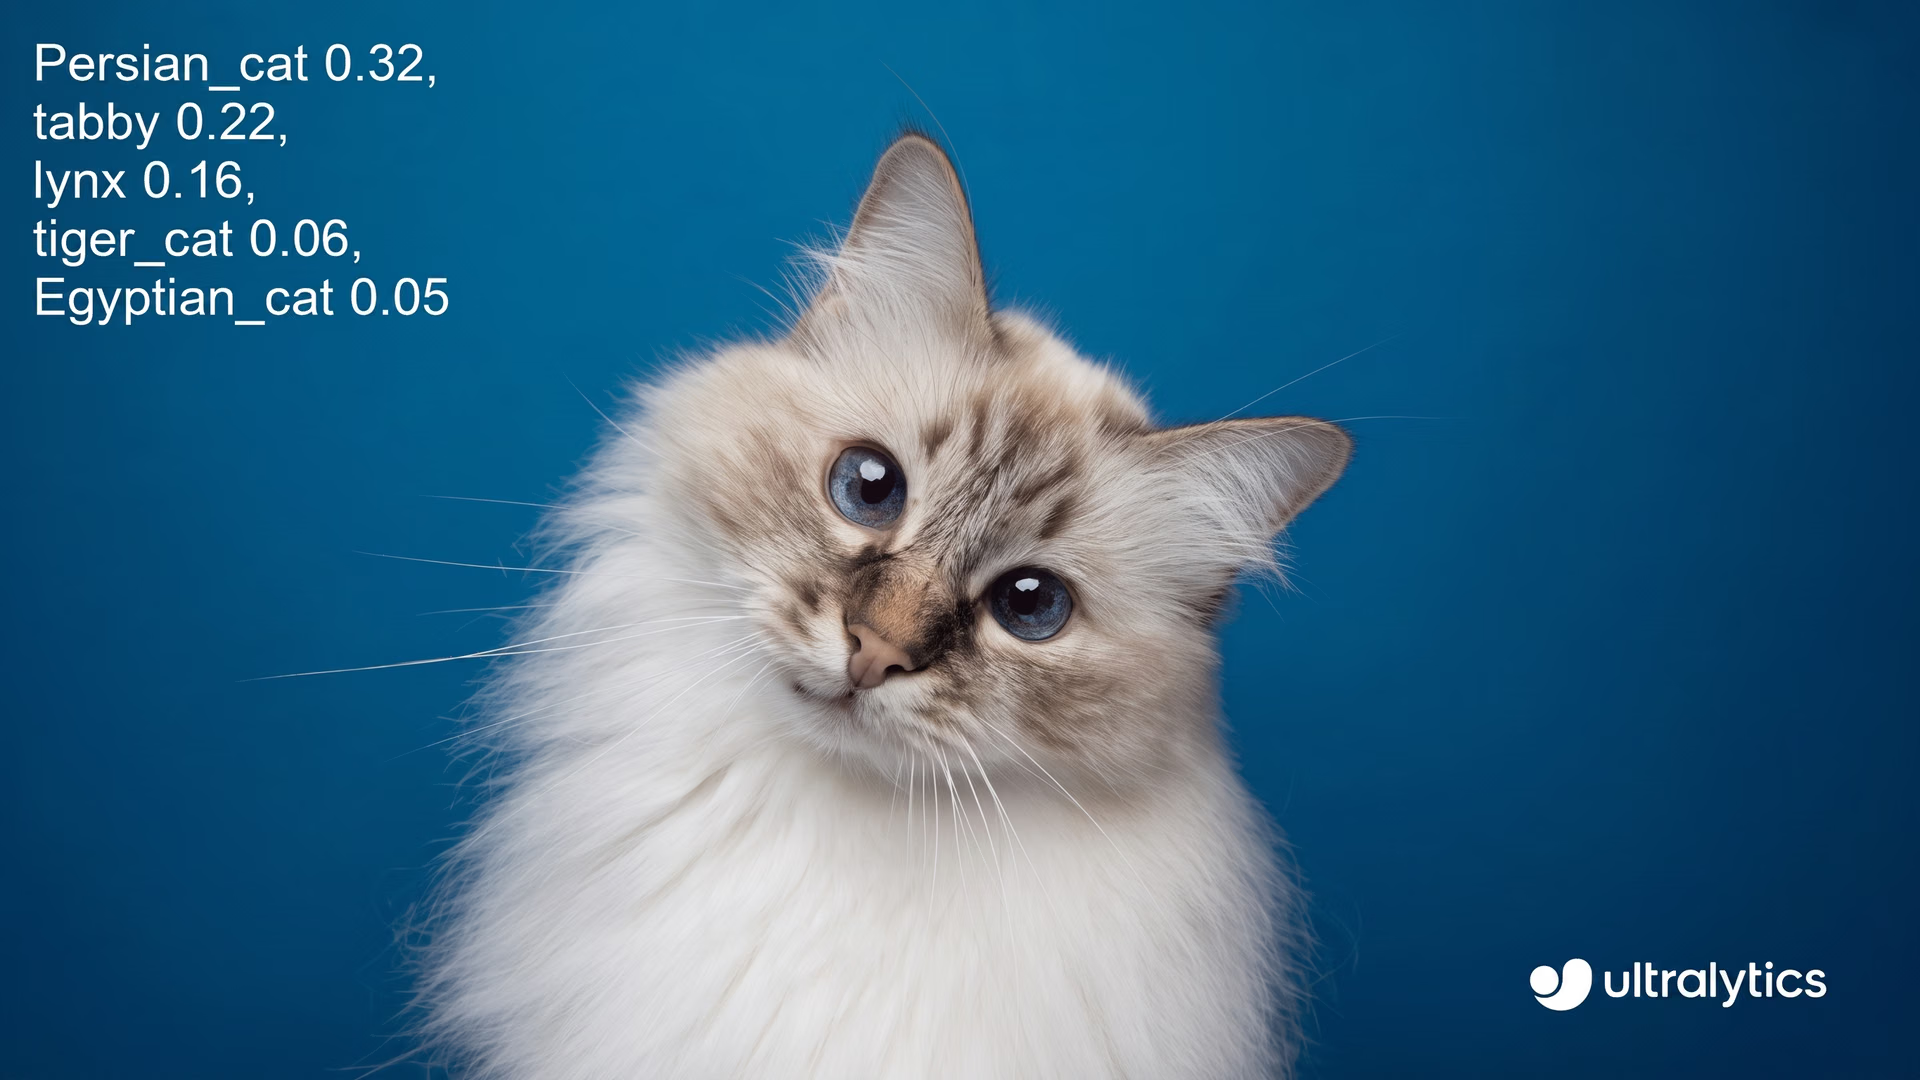
Fig. 1. Exemple de classification d’images.
Associé à la vision par ordinateur, le NLP peut donner du sens aux données visuelles en combinant texte et images, ce qui permet une compréhension plus approfondie. Comme le dit le proverbe, « une image vaut mille mots » ; lorsqu’on l’associe à du texte, elle devient encore plus puissante et livre des informations plus riches.
Exemples de collaboration entre le NLP et la vision par ordinateur#
Tu as probablement déjà vu le NLP et la vision par ordinateur travailler ensemble dans des outils du quotidien sans même t’en rendre compte, par exemple lorsque ton téléphone traduit le texte d’une image.
En fait, Google Translate utilise à la fois le traitement automatique du langage naturel et la vision par ordinateur pour traduire le texte des images. Lorsque tu prends en photo un panneau de rue rédigé dans une autre langue, la vision par ordinateur détecte et extrait le texte, tandis que le NLP le traduit dans la langue de ton choix.
Le NLP et le CV fonctionnent ensemble pour rendre le processus simple et efficace, permettant aux utilisateurs de comprendre et d’exploiter des informations dans différentes langues en temps réel. Cette intégration contribue à faire tomber les barrières de communication.

Fig. 2. Fonctionnalité de traduction de Google.
Voici d’autres exemples d’applications qui associent le NLP et la vision par ordinateur :
- Voitures autonomes : le CV peut servir à détecter les panneaux routiers, les voies et les obstacles, tandis que le NLP peut traiter les commandes vocales ou le texte figurant sur les panneaux.
- Lecteurs de documents : la vision par IA peut reconnaître le texte de documents numérisés ou de documents manuscrits, et le traitement automatique du langage naturel peut interpréter et résumer les informations.
- Recherche visuelle dans les applications de shopping : la vision par ordinateur peut identifier des produits sur des photos, tandis que le NLP traite les termes de recherche pour améliorer les recommandations.
- Outils pédagogiques : le CV peut reconnaître des notes manuscrites ou des entrées visuelles, tandis que le NLP peut fournir des explications ou des commentaires en fonction du contenu.
Concepts clés reliant la vision par ordinateur et le NLP#
Maintenant que nous avons vu comment la vision par ordinateur et le traitement automatique du langage naturel sont utilisés, voyons comment ces technologies s’associent pour permettre l’IA multimodale.
L’IA intermodale associe la compréhension visuelle de la vision par ordinateur à la compréhension du langage du NLP afin de traiter et de relier des informations issues du texte et des images. Par exemple, dans le domaine des soins de santé, l’IA intermodale peut aider à analyser une radiographie et à générer un résumé écrit clair des problèmes potentiels, ce qui aide les médecins à prendre des décisions plus rapidement et avec plus de précision.
Compréhension du langage naturel (NLU)#
La compréhension du langage naturel est un sous-domaine du NLP qui porte sur l’interprétation du texte et l’extraction de son sens par l’analyse de l’intention, du contexte, de la sémantique, du ton et de la structure. Alors que le NLP traite le texte brut, la NLU permet aux machines de comprendre plus efficacement le langage humain. Par exemple, l’analyse syntaxique est une technique de NLU qui convertit le texte écrit en un format structuré compréhensible par les machines.

Fig. 3. La relation entre le NLP et la NLU.
La NLU fonctionne avec la vision par ordinateur lorsque les données visuelles contiennent du texte qu’il faut comprendre. La vision par ordinateur extrait le texte des images, des documents ou des vidéos grâce à des technologies comme la reconnaissance optique de caractères (OCR). Elle peut servir à numériser un reçu, à lire le texte d’un panneau ou à convertir des notes manuscrites en format numérique.
La NLU traite ensuite le texte extrait pour en comprendre le sens, le contexte et l’intention. Cette combinaison permet aux systèmes de faire bien plus que reconnaître du texte. Ils peuvent classer les dépenses figurant sur des reçus ou analyser le ton et les sentiments. Ensemble, la vision par ordinateur et la NLU transforment le texte visuel en informations utiles et exploitables.
Ingénierie des prompts#
L’ingénierie des prompts consiste à concevoir des prompts clairs, précis et détaillés pour guider les systèmes d’IA générative, comme les grands modèles de langage (LLM) et les modèles vision-langage (VLM), afin qu’ils produisent les résultats souhaités. Ces prompts servent d’instructions pour aider le modèle d’IA à comprendre l’intention de l’utilisateur.
Pour bien concevoir des prompts, il faut comprendre les capacités du modèle et élaborer des entrées qui maximisent sa capacité à générer des réponses précises, créatives ou pertinentes. C’est particulièrement important pour les modèles multimodaux qui traitent à la fois du texte et des images.
Prenons par exemple le modèle texte-image DALL·E d’OpenAI. Si tu lui demandes de créer « une image photoréaliste d’un astronaute à cheval », il peut générer exactement cela à partir de ta description. C’est utile dans des domaines comme la conception graphique, où les professionnels peuvent rapidement transformer des idées écrites en maquettes visuelles, gagner du temps et améliorer leur productivité.

Fig. 4. Image créée avec DALL-E d’OpenAI.
Tu te demandes peut-être quel est le lien avec la vision par ordinateur : n’est-ce pas simplement de l’IA générative ? En réalité, les deux sont étroitement liées. L’IA générative s’appuie sur les fondements de la vision par ordinateur pour créer des contenus visuels entièrement nouveaux.
Les modèles d’IA générative qui créent des images à partir de prompts textuels sont entraînés sur de grands ensembles de données d’images associées à des descriptions textuelles. Cela leur permet d’apprendre les relations entre le langage et les concepts visuels, comme les objets, les textures et les relations spatiales.
Ces modèles n’interprètent pas les données visuelles de la même façon que les systèmes traditionnels de vision par ordinateur, qui reconnaissent par exemple des objets dans des images du monde réel. Ils s’appuient plutôt sur leur compréhension acquise de ces concepts pour générer de nouveaux visuels à partir de prompts. En combinant ces connaissances à des prompts bien conçus, l’IA générative peut produire des images réalistes et détaillées qui correspondent aux demandes de l’utilisateur.
Réponse aux questions (QA)#
Les systèmes de réponse aux questions sont conçus pour comprendre les questions en langage naturel et fournir des réponses précises et pertinentes. Ils utilisent des techniques comme la recherche d’informations, la compréhension sémantique et l’apprentissage profond pour interpréter les requêtes et y répondre.
Des modèles avancés comme GPT-4o d’OpenAI peuvent répondre à des questions sur des images (VQA), c’est-à-dire les analyser et répondre à des questions les concernant. Cependant, GPT-4o n’effectue pas directement de tâches de vision par ordinateur. Il utilise plutôt un encodeur d’images spécialisé pour traiter les images, en extraire des caractéristiques et les combiner à sa compréhension du langage afin de fournir des réponses.

Fig. 5. Capacité de ChatGPT à répondre à des questions visuelles. Image de l’auteur.
D’autres systèmes vont plus loin en intégrant pleinement des capacités de vision par ordinateur. Ils peuvent analyser directement des images ou des vidéos pour identifier des objets, des scènes ou du texte. Associés au traitement automatique du langage naturel, ils peuvent répondre à des questions plus complexes sur le contenu visuel. Par exemple, ils peuvent répondre à « Quels objets se trouvent dans cette image ? » ou « Qui apparaît dans cette séquence ? » en détectant et en interprétant les éléments visuels. Pour voir à quel point les modèles vision-langage actuels localisent bien les objets dans les images, consulte le classement des VLM.
Apprentissage à zéro exemple (ZSL)#
L’apprentissage à zéro exemple (ZSL) est une méthode d’apprentissage automatique qui permet aux modèles d’IA de traiter de nouvelles tâches inédites sans avoir été entraînés spécifiquement sur celles-ci. Pour ce faire, elle utilise des informations supplémentaires, comme des descriptions ou des relations sémantiques, afin de relier ce que le modèle connaît déjà (les classes vues) à de nouvelles catégories inédites.
En traitement automatique du langage naturel, le ZSL aide les modèles à comprendre des sujets sur lesquels ils n’ont pas été entraînés et à les traiter, en s’appuyant sur les relations entre les mots et les concepts. De même, en vision par ordinateur, le ZSL permet aux modèles de reconnaître des objets ou des scènes qu’ils n’ont jamais rencontrés, en reliant des caractéristiques visuelles, comme des ailes ou des plumes, à des concepts connus, comme les oiseaux.
Le ZSL relie le NLP et la CV en combinant compréhension du langage et reconnaissance visuelle, ce qui le rend particulièrement utile pour les tâches qui mobilisent les deux. Par exemple, pour répondre à une question visuelle, un modèle peut analyser une image tout en comprenant une question associée afin de fournir une réponse précise. Cette méthode est également utile pour des tâches comme le sous-titrage d’images.
Points clés à retenir#
La combinaison du traitement automatique du langage naturel et de la vision par ordinateur a donné naissance à des systèmes d’IA capables de comprendre à la fois le texte et les images. Cette combinaison est utilisée dans de nombreux secteurs, qu’il s’agisse d’aider les voitures autonomes à lire les panneaux routiers, d’améliorer les diagnostics médicaux ou de renforcer la sécurité sur les réseaux sociaux. À mesure que ces technologies progressent, elles continueront de nous faciliter la vie et d’ouvrir de nouvelles possibilités dans de nombreux domaines. Pour en savoir plus, consulte notre dépôt GitHub et participe à notre communauté. Découvre les applications de l’IA dans les voitures autonomes et l’agriculture sur nos pages de solutions.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









