Computer Vision (CV)
La vision par ordinateur (CV) est le domaine de l’IA qui permet aux machines d’interpréter des images et des vidéos. Découvre son fonctionnement, ses tâches principales, ses applications et ses défis.
La vision par ordinateur (CV) est le domaine de l’intelligence artificielle (IA) qui permet aux ordinateurs d’extraire du sens d’images, de vidéos et d’autres données visuelles : quels objets sont présents, où ils se trouvent, comment ils se déplacent et ce qui se passe dans une scène. Les systèmes modernes apprennent ces capacités à partir d’exemples. Un modèle entraîné sur des milliers d’images annotées apprend les motifs visuels qui définissent une voiture, une fissure ou une tumeur, puis les applique à des images inédites. C’est pourquoi le domaine repose aujourd’hui sur l’apprentissage automatique (ML) et, surtout, sur l’apprentissage profond (DL).
Fonctionnement de la vision par ordinateur#
Pour un ordinateur, une image en couleur est une grille de nombres. Une photo de 640×480 pixels contient 921 600 valeurs, une par pixel pour chacun des trois canaux de couleur, chaque valeur représentant une intensité de 0 à 255. Un pipeline de vision par ordinateur transforme cette grille en décision en cinq étapes.
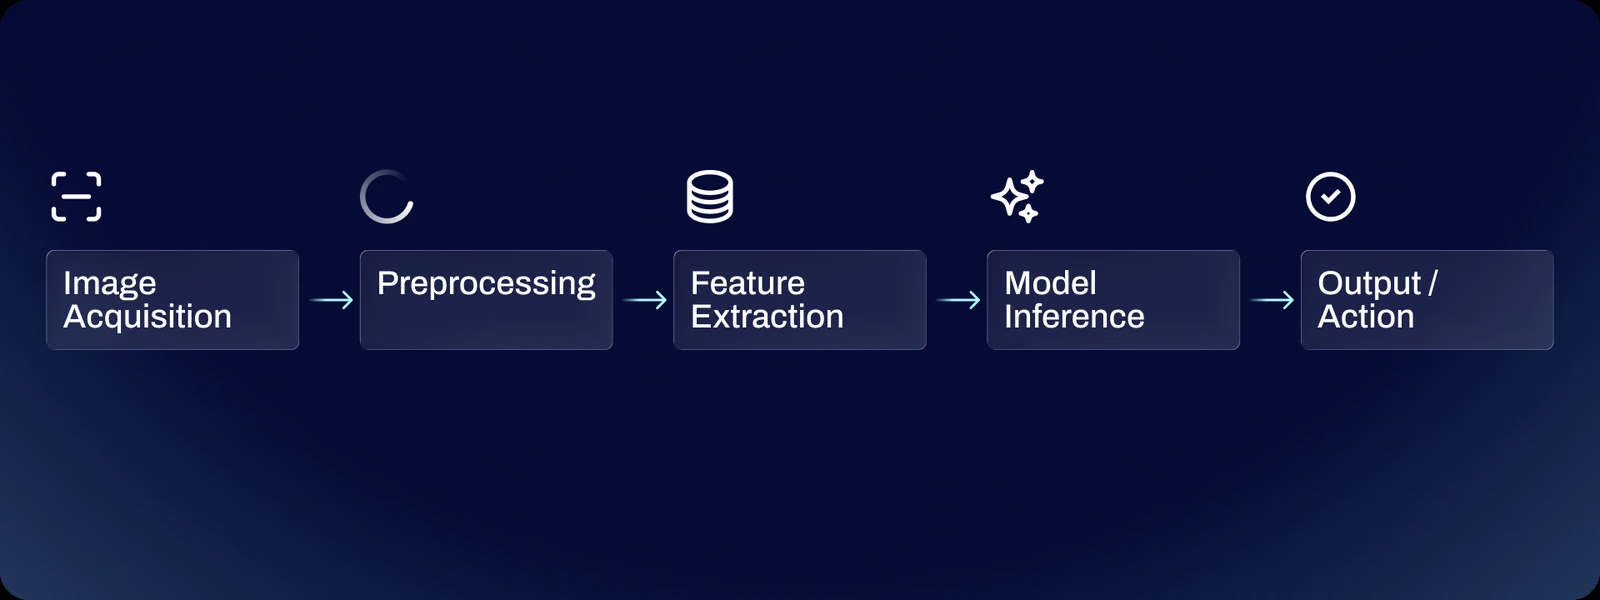
Une caméra ou un capteur capture l’image ; le prétraitement, souvent réalisé avec OpenCV, la redimensionne et la normalise afin que le modèle reçoive toujours des entrées au même format. Le modèle procède ensuite à l’extraction de caractéristiques : les premières couches d’un réseau neuronal convolutif (CNN) réagissent aux contours et aux gradients de couleur, les couches intermédiaires les combinent en textures et en parties, et les couches profondes réagissent aux objets entiers. Les Vision Transformers (ViT) produisent des représentations similaires en découpant l’image en patches et en reliant chaque patch à tous les autres par l’auto-attention. Une tête adaptée à la tâche convertit les caractéristiques en sortie — par exemple une étiquette de classe, un ensemble de boîtes englobantes ou un masque de pixels — puis le système environnant agit en rejetant une pièce défectueuse, en freinant un véhicule ou en déclenchant une alerte.
Les modèles apprennent ces caractéristiques par l’apprentissage supervisé. Pendant l’entraînement, le modèle effectue des prédictions sur des images annotées, une fonction de perte mesure l’écart entre chaque prédiction et la vérité terrain, puis la rétropropagation ajuste les poids pour réduire cette erreur. De grands jeux de données publics, comme ImageNet, qui contient plus de 14 millions d’images annotées, et COCO, qui couvre 80 catégories d’objets courants, fournissent le préentraînement dont partent la plupart des modèles personnalisés grâce à l’apprentissage par transfert.
Des caractéristiques conçues à la main à l’apprentissage profond#
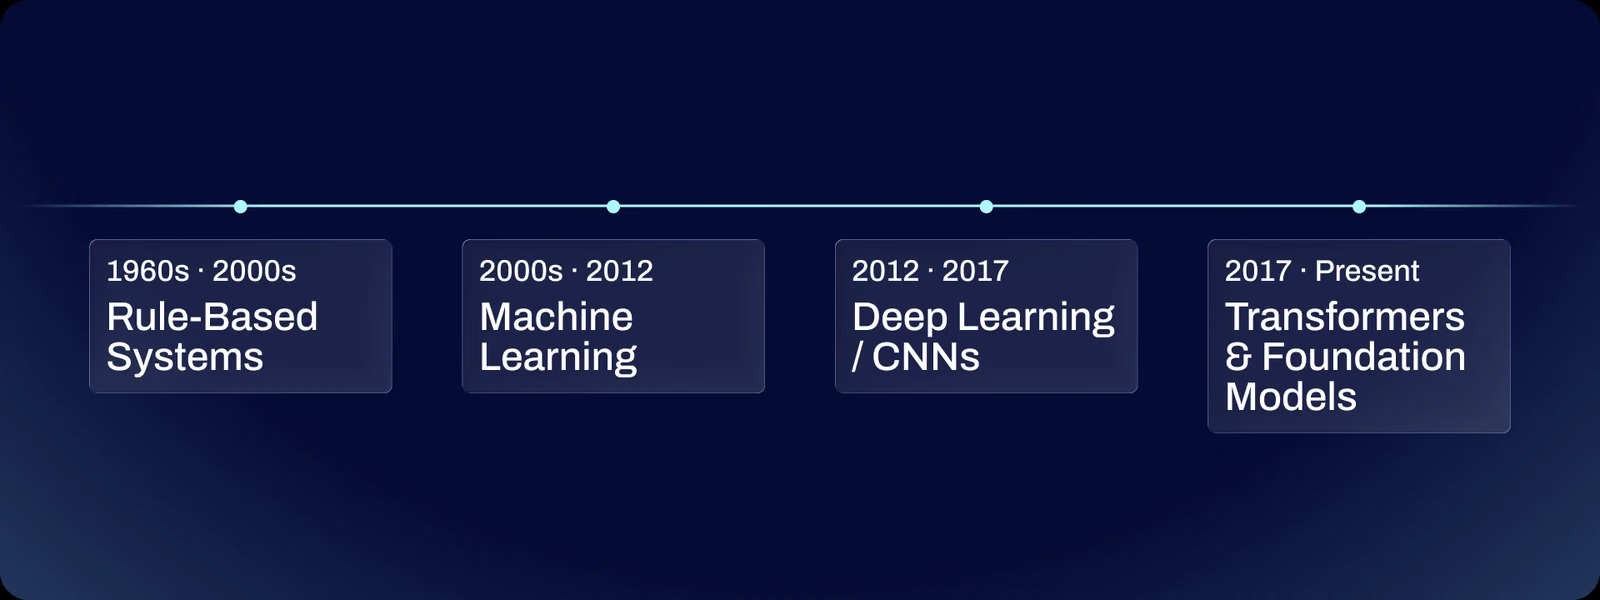
Les débuts de la vision par ordinateur reposaient sur des caractéristiques conçues à la main. Les ingénieurs écrivaient des détecteurs de contours, de coins et de motifs de gradient comme SIFT et HOG, puis transmettaient ces caractéristiques à un classificateur. Ces systèmes échouaient dès que l’éclairage, le point de vue ou l’arrière-plan changeait. Le tournant a eu lieu en 2012, quand AlexNet a remporté le défi ImageNet avec un taux d’erreur top-5 de 15,3 %, contre 26,2 % pour le participant suivant. Depuis, les CNN et, à partir de 2020, les transformeurs de vision apprennent leurs caractéristiques directement à partir des données. Les modèles de langage et de vision (VLM) associent désormais des images à du texte, ce qui permet à un même modèle de répondre à des questions ouvertes sur une photo ou de repérer des objets décrits en langage courant. Le classement VLM mesure la précision avec laquelle ces modèles détectent des objets dans des jeux de données du monde réel.
Principales tâches de vision par ordinateur#
Chaque tâche répond à une question différente sur une image :
- Détection d’objets : repère chaque objet et trace une boîte autour de lui, avec une classe et un score de confiance, ce qui permet de les compter et de les localiser.
- Segmentation d’instance : attribue à chaque objet son propre masque de pixels, afin que deux personnes côte à côte restent distinctes.
- Segmentation sémantique : attribue une classe à chaque pixel, comme route, trottoir ou ciel.
- Estimation de profondeur : prédit, à partir d’une seule image, la distance entre chaque pixel et la caméra.
- Classification d’images : attribue une seule étiquette à l’ensemble de l’image, comme « défectueux » ou « OK ».
- Estimation de pose : localise des points clés, comme les articulations du corps, pour mesurer la posture et les mouvements.
- Boîtes englobantes orientées (OBB) : ajuste des boîtes pivotées à des objets inclinés selon n’importe quel angle, comme des navires ou des avions dans des images satellites.
- Suivi d’objets : associe les détections d’une image vidéo à l’autre pour que chaque objet conserve un identifiant cohérent.
Choisir une tâche commence par déterminer la sortie dont l’application a besoin :
Ultralytics YOLO26 prend en charge sept de ces tâches avec une seule API Python : le même appel YOLO() charge un modèle de détection, de segmentation d’instances, de segmentation sémantique, de profondeur, de classification, de pose ou OBB, et model.track() ajoute le suivi vidéo. Cet exemple effectue une détection d’objets sur une image d’exemple :
from ultralytics import YOLO

# Charger un modèle de détection YOLO26 nano préentraîné
model = YOLO("yolo26n.pt")

# Lancer l’inférence sur une image de rue d’exemple
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# Afficher le nombre d’objets détectés par classe et enregistrer l’image annotée
print(result.verbose())
result.save(filename="bus_detections.jpg")
La ligne affichée indique le nombre de détections par classe, et l’image enregistrée représente chacune d’elles avec sa boîte, son étiquette et son score de confiance.
La vision par ordinateur et les domaines apparentés#
- Traitement d’images : transforme une image en une autre en accentuant la netteté, en réduisant le bruit, en redimensionnant ou en ajustant le contraste. Les pipelines de vision par ordinateur utilisent ces opérations en prétraitement avant d’interpréter la scène.
- Vision industrielle : application de la vision par ordinateur à l’inspection et au guidage de robots dans l’industrie, généralement au moyen de caméras fixes, d’un éclairage contrôlé et de matériel dédié sur une chaîne de production.
- Reconnaissance d’images : synonyme courant de classification d’images, parfois employé au sens large pour toute tâche qui identifie le contenu d’une image.
Applications concrètes#
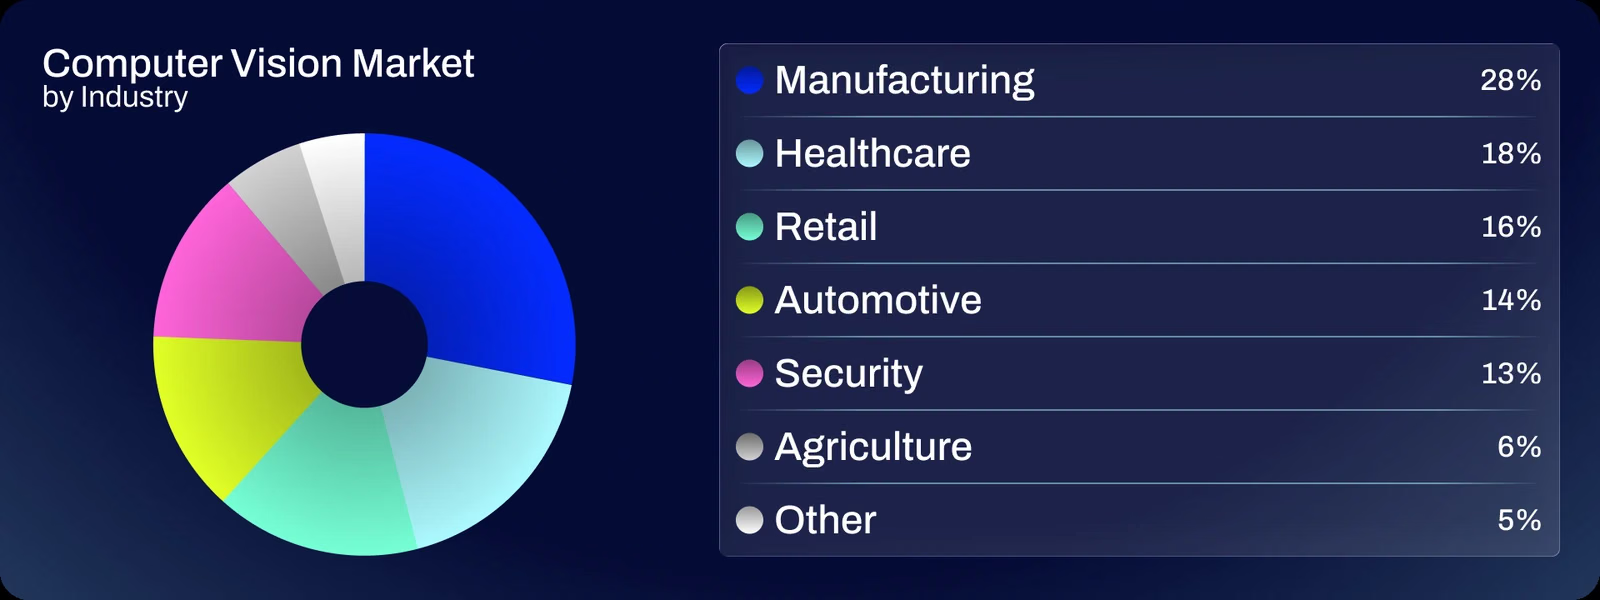
- Industrie manufacturière : des caméras inspectent chaque pièce à la cadence de la chaîne pour détecter fissures, rayures et composants mal alignés, et surveillent l’usure des machines avant qu’elles ne tombent en panne.
- Imagerie médicale : des modèles signalent les tumeurs, les fractures et les maladies de la rétine dans les radiographies, les tomodensitogrammes et les photos de la rétine, afin que les radiologues les examinent.
- Véhicules autonomes : les voitures détectent en temps réel les voies, les panneaux, les piétons et les autres véhicules, puis combinent les résultats des caméras avec ceux du radar et du LiDAR pour construire un modèle 3D de leur environnement.
- Commerce de détail : des caméras en rayon détectent les emplacements vides et les produits mal placés, tandis que les magasins sans caisse suivent les articles emportés par chaque client.
- Agriculture : des drones et des pulvérisateurs distinguent les cultures des mauvaises herbes, plante par plante, afin que les herbicides et les engrais ne soient appliqués qu’aux endroits nécessaires.
- Sécurité et villes intelligentes : les systèmes comptent les personnes et les véhicules, surveillent la circulation et utilisent la détection d’anomalies pour signaler les événements inhabituels dans les zones réglementées.
Défis et limites#
Un modèle ne vaut que par son jeu de données d’entraînement, et l’annotation des données — le dessin de boîtes ou de masques sur des milliers d’images — demande souvent plus d’efforts que l’entraînement du modèle lui-même. Les conditions changent aussi après le déploiement : pluie, éblouissement, éclairage nocturne, occultation ou déplacement de la caméra modifient les entrées par rapport à celles vues par le modèle pendant l’entraînement. L’augmentation de données simule ces conditions pendant l’entraînement, et la validation sur des images mises de côté permet de détecter le surapprentissage avant la mise en production.
La puissance de calcul est la contrainte suivante. Les caméras, les drones et les téléphones exécutent des modèles avec des budgets d’énergie et de mémoire limités ; les déploiements d’IA en périphérie privilégient donc les petits modèles et la quantification des modèles pour atteindre une vitesse en temps réel sans envoyer les vidéos dans le cloud.
Les systèmes qui analysent des personnes soulèvent des questions de biais et de confidentialité. Un jeu de données qui sous-représente certains groupes produit un modèle dont les performances varient selon les groupes, et les données sur le visage et le corps sont considérées comme des données personnelles sensibles par la plupart des lois sur la confidentialité. Depuis février 2025, l’EU AI Act interdit aux autorités répressives l’identification biométrique à distance en temps réel dans les espaces accessibles au public, sauf exceptions limitées, comme la recherche de victimes d’enlèvement ou la prévention d’une menace terroriste imminente.









