Computer Vision (CV)
La visión artificial (CV) es el campo de la IA que permite a las máquinas interpretar imágenes y vídeos. Explica cómo funciona, sus tareas principales, aplicaciones y retos.
La visión artificial (CV) es el campo de la inteligencia artificial (AI) que permite a los ordenadores extraer significado de imágenes, vídeos y otros datos visuales: qué objetos hay, dónde están, cómo se mueven y qué ocurre en una escena. Los sistemas modernos aprenden estas capacidades a partir de ejemplos. Un modelo entrenado con miles de imágenes etiquetadas aprende los patrones visuales que definen un coche, una grieta o un tumor y los aplica a imágenes que nunca ha visto; por eso, hoy el campo se basa en el aprendizaje automático (ML) y, sobre todo, en el aprendizaje profundo (DL).
Cómo funciona la visión artificial#
Para un ordenador, una imagen en color es una cuadrícula de números. Una foto de 640×480 contiene 921 600 valores, uno por píxel para cada uno de los tres canales de color, y cada valor es una intensidad de 0 a 255. Una canalización de visión artificial convierte esa cuadrícula en una decisión mediante cinco etapas.
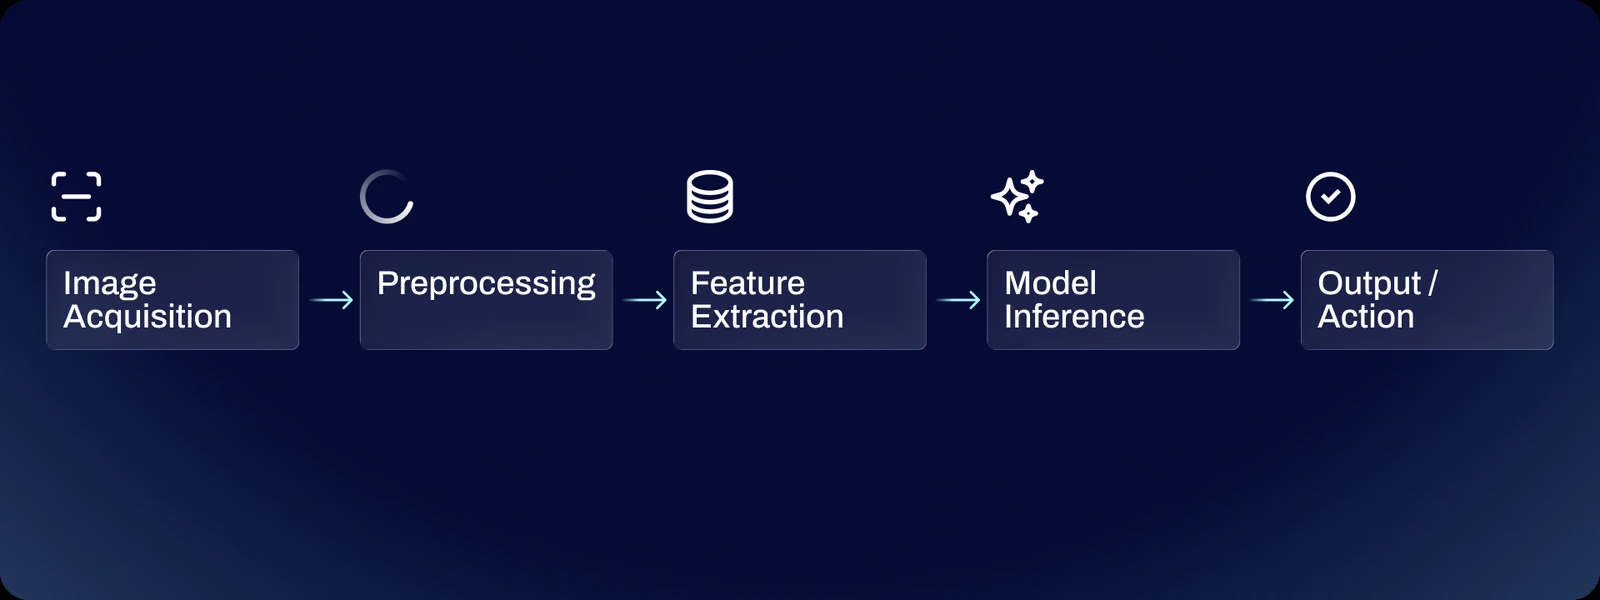
Una cámara o un sensor captura la imagen, y el preprocesamiento, a menudo con OpenCV, cambia su tamaño y la normaliza para que el modelo siempre reciba una entrada con el mismo formato. Después, el modelo realiza la extracción de características: las primeras capas de una red neuronal convolucional (CNN) responden a los bordes y los gradientes de color; las capas intermedias los combinan para formar texturas y partes, y las capas profundas responden a objetos completos. Los Transformers de visión (ViT) obtienen representaciones similares dividiendo la imagen en parches y relacionando cada parche con los demás mediante autoatención. Una cabeza específica para la tarea convierte las características en la salida —por ejemplo, una etiqueta de clase, un conjunto de cuadros delimitadores o una máscara de píxeles—, y el sistema que la rodea actúa en consecuencia: puede rechazar una pieza defectuosa, frenar un vehículo o activar una alerta.
Los modelos aprenden estas características mediante aprendizaje supervisado. Durante el entrenamiento, el modelo hace predicciones sobre imágenes etiquetadas, una función de pérdida mide la diferencia entre cada predicción y el valor de referencia, y la retropropagación ajusta los pesos para reducir ese error. Grandes conjuntos de datos públicos, como ImageNet, con más de 14 millones de imágenes etiquetadas, y COCO, con 80 categorías de objetos cotidianos, proporcionan el preentrenamiento del que parten la mayoría de los modelos personalizados mediante aprendizaje por transferencia.
De las características diseñadas a mano al aprendizaje profundo#
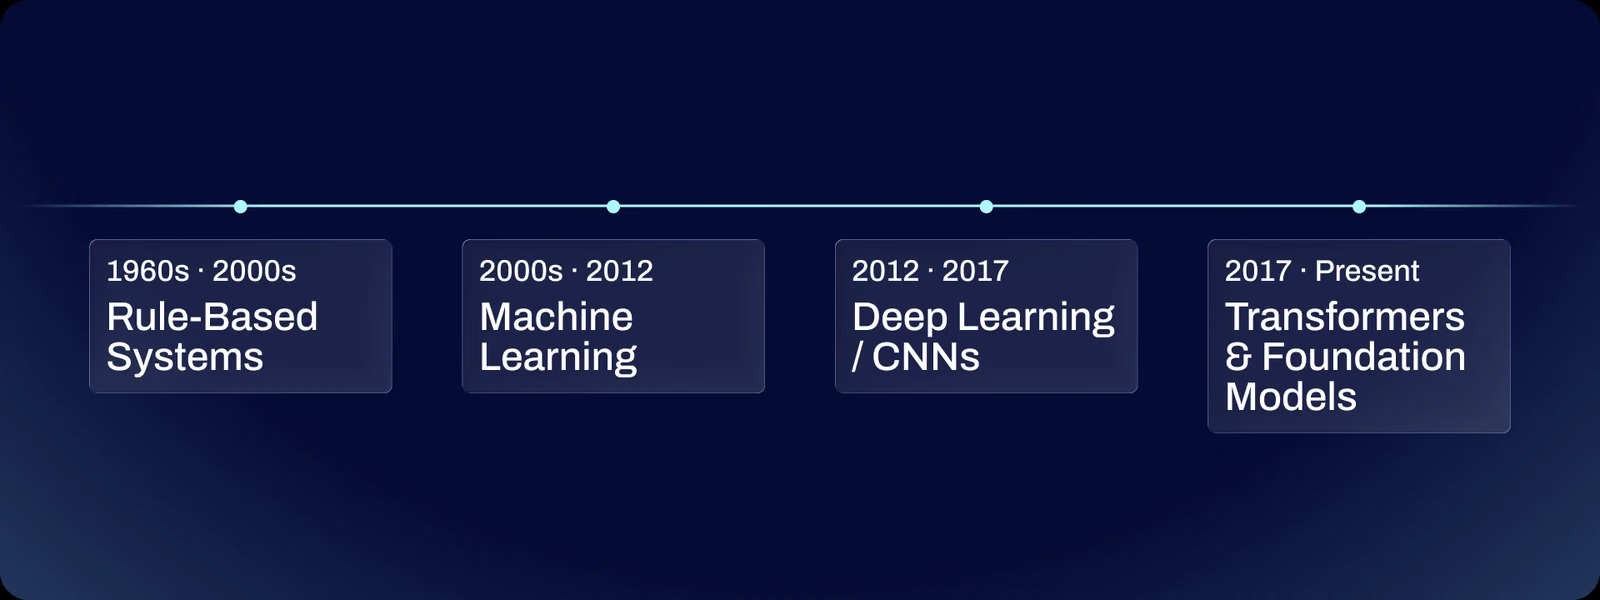
Los primeros sistemas de visión artificial se basaban en características diseñadas a mano. Los ingenieros escribían detectores de bordes, esquinas y patrones de gradiente, como SIFT y HOG, y después pasaban esas características a un clasificador. Los sistemas resultantes fallaban cuando cambiaban la iluminación, el punto de vista o el fondo. El punto de inflexión llegó en 2012, cuando AlexNet ganó el desafío ImageNet con una tasa de error top-5 del 15,3 %, frente al 26,2 % de la siguiente propuesta. Desde entonces, las CNN y, a partir de 2020, los Vision Transformers han aprendido las características directamente de los datos. Los modelos de lenguaje y visión (VLM) ahora combinan imágenes con texto, de modo que un mismo modelo puede responder preguntas abiertas sobre una foto o encontrar objetos descritos en lenguaje cotidiano. La clasificación de VLM mide la precisión con la que estos modelos detectan objetos en conjuntos de datos del mundo real.
Tareas principales de la visión artificial#
Cada tarea responde a una pregunta distinta sobre una imagen:
- Detección de objetos: encuentra cada objeto y lo encuadra, indicando la clase y una puntuación de confianza, lo que permite contar y localizar objetos.
- Segmentación de instancias: asigna a cada objeto su propia máscara de píxeles, de modo que dos personas que están una al lado de la otra siguen siendo instancias distintas.
- Segmentación semántica: asigna una clase a cada píxel, como carretera, acera o cielo.
- Estimación de profundidad: predice a qué distancia de la cámara está cada píxel a partir de una sola imagen.
- Clasificación de imágenes: asigna una etiqueta a toda la imagen, como «defectuoso» o «correcto».
- Estimación de la pose: localiza puntos clave, como las articulaciones del cuerpo, para medir la postura y el movimiento.
- Cuadros delimitadores orientados (OBB): ajusta cuadros girados a objetos con cualquier orientación, como barcos y aviones en imágenes de satélite.
- Seguimiento de objetos: relaciona las detecciones entre fotogramas de vídeo para que cada objeto conserve un ID estable.
Elegir una tarea empieza por determinar qué resultado necesita la aplicación:
Ultralytics YOLO26 cubre siete de estas tareas con una API de Python: la misma llamada YOLO() carga un modelo de detección, segmentación de instancias, segmentación semántica, profundidad, clasificación, pose u OBB; model.track() añade el seguimiento en vídeo. Este ejemplo ejecuta la detección de objetos en una imagen de muestra:
from ultralytics import YOLO

# Carga un modelo de detección nano YOLO26 preentrenado
model = YOLO("yolo26n.pt")

# Ejecuta la inferencia en una imagen de muestra de una calle
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# Imprime el recuento de objetos detectados por clase y guarda la imagen anotada
print(result.verbose())
result.save(filename="bus_detections.jpg")
La línea impresa cuenta las detecciones por clase, y la imagen guardada dibuja cada una con su cuadro, etiqueta y puntuación de confianza.
La visión artificial y los campos relacionados#
- Procesamiento de imágenes: transforma una imagen en otra mediante el aumento de nitidez, la reducción del ruido, el cambio de tamaño o el ajuste del contraste. Las canalizaciones de visión artificial utilizan estas operaciones como preprocesamiento antes de interpretar la escena.
- Visión artificial industrial: aplicación de la visión artificial a la inspección y al guiado de robots en entornos industriales, normalmente con cámaras fijas, iluminación controlada y hardware específico en una línea de producción.
- Reconocimiento de imágenes: sinónimo habitual de clasificación de imágenes, que a veces se usa de forma imprecisa para cualquier tarea que identifique qué contiene una imagen.
Aplicaciones en el mundo real#
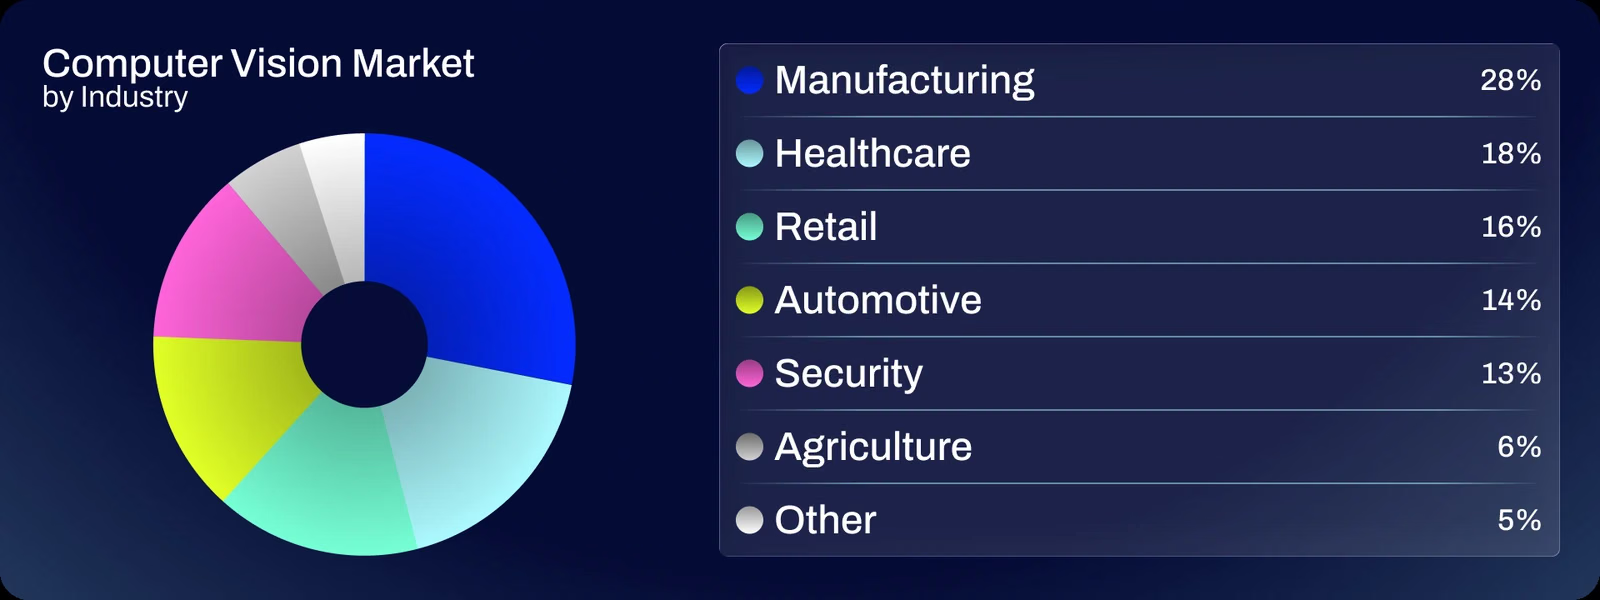
- Fabricación: las cámaras inspeccionan todas las piezas a la velocidad de la línea para detectar grietas, arañazos y componentes desalineados, y controlan el desgaste de la maquinaria antes de que falle.
- Diagnóstico por imagen: los modelos señalan tumores, fracturas y enfermedades de la retina en radiografías, tomografías computarizadas y fotografías de la retina para que los radiólogos las revisen.
- Vehículos autónomos: los coches detectan carriles, señales, peatones y otros vehículos en tiempo real, y combinan la salida de las cámaras con el radar y LiDAR para crear un modelo 3D de su entorno.
- Comercio minorista: las cámaras de las estanterías detectan huecos y productos mal colocados, y las tiendas sin cajas registradoras hacen un seguimiento de los artículos que coge cada cliente.
- Agricultura: los drones y los pulverizadores distinguen los cultivos de las malas hierbas planta por planta, para aplicar herbicidas y fertilizantes solo donde hacen falta.
- Seguridad y ciudades inteligentes: los sistemas cuentan personas y vehículos, supervisan el flujo del tráfico y usan la detección de anomalías para señalar sucesos inusuales en zonas restringidas.
Retos y limitaciones#
Un modelo solo es tan bueno como su conjunto de entrenamiento, y el etiquetado de datos —dibujar cuadros o máscaras en miles de imágenes— suele requerir más esfuerzo que entrenar el propio modelo. Además, las condiciones cambian tras el despliegue: la lluvia, los reflejos, la iluminación nocturna, las oclusiones o el movimiento de una cámara alejan los datos de entrada de lo que el modelo vio durante el entrenamiento. El aumento de datos simula estas condiciones durante el entrenamiento, y la validación con imágenes reservadas detecta el sobreajuste antes del lanzamiento.
La capacidad de cálculo es la siguiente limitación. Las cámaras, los drones y los teléfonos ejecutan modelos con presupuestos de energía y memoria muy ajustados, por lo que los despliegues de IA en el borde favorecen los modelos pequeños y la cuantización de modelos para alcanzar la velocidad en tiempo real sin enviar vídeo a la nube.
Los sistemas que analizan a las personas plantean problemas de sesgo y privacidad. Un conjunto de datos que represente poco a ciertos grupos produce un modelo cuyo rendimiento varía entre ellos, y la mayoría de las leyes de privacidad consideran que los datos faciales y corporales son datos personales sensibles. Desde febrero de 2025, la Ley de IA de la UE prohíbe a las fuerzas del orden la identificación biométrica remota en tiempo real en espacios de acceso público, salvo excepciones limitadas, como buscar a víctimas de secuestro o prevenir una amenaza terrorista inminente.









