Collegare l'elaborazione del linguaggio naturale e la visione artificiale
Scopri come l'elaborazione del linguaggio naturale (NLP) e la visione artificiale (CV) possono collaborare per trasformare i settori industriali con sistemi di IA multimodali più intelligenti.
 Abirami Vina9 min di lettura

L'elaborazione del linguaggio naturale (NLP) e la visione artificiale (CV) sono due branche distinte dell'intelligenza artificiale (AI) che hanno acquisito grande popolarità negli ultimi anni. Grazie ai progressi dell'AI, oggi queste due branche sono più interconnesse che mai.
Un ottimo esempio è la generazione automatica di didascalie per immagini. La visione artificiale può essere usata per analizzare e comprendere il contenuto di un'immagine, mentre l'elaborazione del linguaggio naturale può generare una didascalia che la descriva. La generazione automatica di didascalie per immagini è comunemente usata sui social media per migliorare l'accessibilità e nei sistemi di gestione dei contenuti per organizzare e taggare le immagini in modo efficiente.
Le innovazioni nell'NLP e nella Vision AI hanno portato a molti casi d'uso di questo tipo in diversi settori. In questo articolo approfondiremo l'NLP e la visione artificiale e vedremo come funzionano entrambe. Esamineremo anche le applicazioni che combinano queste due tecnologie.
Comprendere la NLP e la Vision AI#
L'NLP si concentra sull'interazione tra computer e linguaggio umano. Consente alle macchine di comprendere, interpretare e generare testo o parlato in modo significativo. Può essere usata per attività come la traduzione, l'analisi del sentiment o la sintesi.
La visione artificiale, invece, aiuta le macchine ad analizzare ed elaborare immagini e video. Può essere usata per attività come il rilevamento di oggetti in una foto, il riconoscimento facciale, il tracciamento degli oggetti o la classificazione delle immagini. La tecnologia Vision AI consente alle macchine di comprendere e interpretare meglio il mondo visivo.
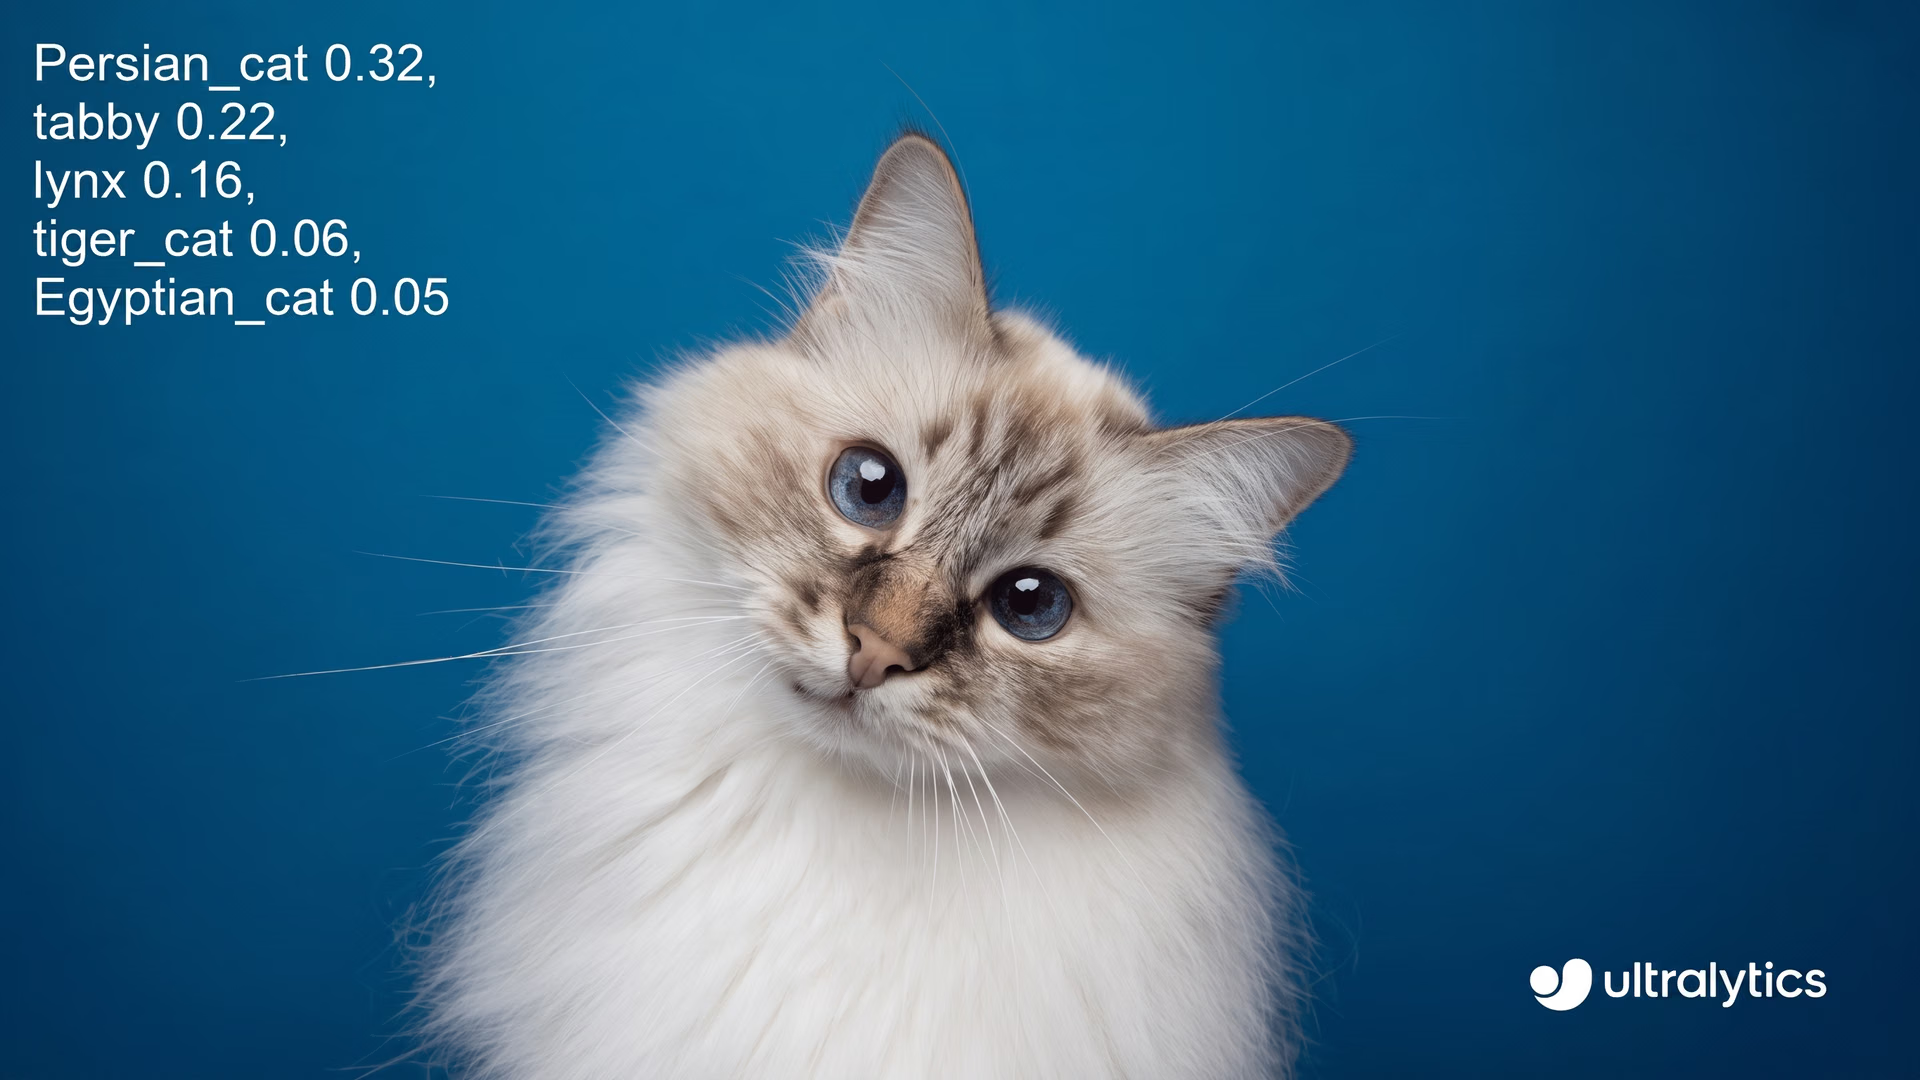
Fig. 1. Un esempio di classificazione delle immagini.
Integrata con la visione artificiale, l'NLP può dare significato ai dati visivi combinando testo e immagini e consentendo una comprensione più approfondita. Come si suol dire, «un'immagine vale più di mille parole» e, se abbinata al testo, diventa ancora più potente e offre informazioni più ricche.
Esempi di collaborazione tra NLP e visione artificiale#
Probabilmente hai già visto l'NLP e la visione artificiale lavorare insieme negli strumenti di uso quotidiano senza accorgertene, per esempio quando il telefono traduce il testo di un'immagine.
In effetti, Google Translate usa sia l'elaborazione del linguaggio naturale sia la visione artificiale per tradurre il testo nelle immagini. Quando scatti una foto a un cartello stradale in un'altra lingua, la visione artificiale identifica ed estrae il testo, mentre l'NLP lo traduce nella lingua che preferisci.
NLP e CV lavorano insieme per rendere il processo fluido ed efficiente, consentendo agli utenti di comprendere e consultare informazioni in diverse lingue in tempo reale. Questa integrazione aiuta ad abbattere le barriere comunicative.

Fig. 2. La funzione Translate di Google.
Ecco altre applicazioni in cui NLP e visione artificiale collaborano:
- Auto a guida autonoma: la CV può essere usata per rilevare segnali stradali, corsie e ostacoli, mentre l'NLP può elaborare i comandi vocali o il testo sui segnali stradali.
- Lettori di documenti: la Vision AI può riconoscere il testo nei documenti acquisiti tramite scansione o nella scrittura a mano, mentre l'elaborazione del linguaggio naturale può interpretare e riassumere le informazioni.
- Ricerca visiva nelle app di shopping: la visione artificiale può identificare i prodotti nelle foto, mentre l'NLP elabora i termini di ricerca per migliorare i suggerimenti.
- Strumenti didattici: la CV può riconoscere appunti scritti a mano o input visivi, mentre l'NLP può fornire spiegazioni o feedback in base al contenuto.
Concetti chiave che collegano visione artificiale e NLP#
Ora che abbiamo visto come si usano la visione artificiale e l'elaborazione del linguaggio naturale, scopriamo come si combinano per consentire l'AI multimodale.
L'AI multimodale combina la comprensione visiva della visione artificiale con la comprensione del linguaggio dell'NLP per elaborare e collegare informazioni contenute in testi e immagini. Per esempio, in ambito sanitario, l'AI multimodale può aiutare ad analizzare una radiografia e generare un riepilogo scritto e chiaro dei possibili problemi, aiutando i medici a prendere decisioni più rapide e accurate.
Comprensione del linguaggio naturale (NLU)#
La comprensione del linguaggio naturale è una branca dell'NLP che si concentra sull'interpretazione e sull'estrazione di significato dal testo, analizzandone intenzione, contesto, semantica, tono e struttura. Mentre l'NLP elabora il testo grezzo, la NLU consente alle macchine di comprendere il linguaggio umano in modo più efficace. Per esempio, l'analisi sintattica è una tecnica NLU che converte il testo scritto in un formato strutturato comprensibile alle macchine.

Fig. 3. La relazione tra NLP e NLU.
La NLU si integra con la visione artificiale quando i dati visivi contengono testo da comprendere. La visione artificiale, con tecnologie come il riconoscimento ottico dei caratteri (OCR), estrae il testo da immagini, documenti o video. Le attività possono includere la scansione di una ricevuta, la lettura del testo su un cartello o la digitalizzazione di appunti scritti a mano.
La NLU elabora quindi il testo estratto per comprenderne il significato, il contesto e l'intento. Questa combinazione permette ai sistemi di fare più che riconoscere il testo: possono classificare le spese riportate sulle ricevute o analizzare tono e sentiment. Insieme, la visione artificiale e la NLU trasformano il testo visivo in informazioni significative e utilizzabili.
Prompt engineering#
Il prompt engineering è il processo di progettazione di prompt chiari, precisi e dettagliati per guidare i sistemi di AI generativa, come i modelli linguistici di grandi dimensioni (LLMs) e i modelli visione-linguaggio (VLMs), nella produzione dei risultati desiderati. Questi prompt fungono da istruzioni che aiutano il modello AI a comprendere l'intento dell'utente.
Per un prompt engineering efficace, è necessario comprendere le capacità del modello e formulare input che ne massimizzino la capacità di generare risposte accurate, creative o ricche di spunti. Questo è particolarmente importante per i modelli multimodali che elaborano sia testo sia immagini.
Prendi, per esempio, DALL·E di OpenAI, un modello che genera immagini a partire dal testo. Se gli chiedi di creare «un'immagine fotorealistica di un astronauta a cavallo», può generarla esattamente in base alla tua descrizione. È utile in settori come il graphic design, dove i professionisti possono trasformare rapidamente idee testuali in bozze visive, risparmiando tempo e aumentando la produttività.

Fig. 4. Immagine creata con DALL-E di OpenAI.
Ti starai chiedendo che legame ci sia con la visione artificiale: non si tratta semplicemente di AI generativa? In realtà, le due tecnologie sono strettamente correlate. L'AI generativa si basa sui fondamenti della visione artificiale per creare contenuti visivi del tutto nuovi.
I modelli di AI generativa che creano immagini a partire da prompt testuali vengono addestrati su grandi dataset di immagini abbinate a descrizioni testuali. Questo permette loro di apprendere le relazioni tra il linguaggio e i concetti visivi, come oggetti, texture e relazioni spaziali.
Questi modelli non interpretano i dati visivi come fanno i sistemi tradizionali di visione artificiale, per esempio quando riconoscono oggetti in immagini del mondo reale. Usano invece la comprensione che hanno appreso di questi concetti per generare nuove immagini in base ai prompt. Combinando questa conoscenza con prompt ben formulati, l'AI generativa può produrre immagini realistiche e dettagliate che corrispondono all'input dell'utente.
Risposta alle domande (QA)#
I sistemi di risposta alle domande sono progettati per comprendere domande in linguaggio naturale e fornire risposte accurate e pertinenti. Usano tecniche come il recupero delle informazioni, la comprensione semantica e il deep learning per interpretare e rispondere alle domande.
I modelli avanzati come GPT-4o di OpenAI possono gestire la risposta a domande visive (VQA), ovvero analizzare le immagini e rispondere a domande su di esse. Tuttavia, GPT-4o non esegue direttamente attività di visione artificiale. Utilizza invece un codificatore di immagini specializzato per elaborare le immagini, estrarne le caratteristiche e combinarle con la propria comprensione del linguaggio per fornire risposte.

Fig. 5. La capacità di ChatGPT di rispondere a domande visive. Immagine dell'autore.
Altri sistemi possono spingersi oltre, integrando pienamente le capacità di visione artificiale. Possono analizzare direttamente immagini o video per identificare oggetti, scene o testo. Se combinati con l'elaborazione del linguaggio naturale, possono gestire domande più complesse sui contenuti visivi. Per esempio, possono rispondere a domande come «Quali oggetti ci sono in questa immagine?» o «Chi compare in questo filmato?» rilevando e interpretando gli elementi visivi. Per scoprire quanto sono efficaci gli attuali modelli visione-linguaggio nell'individuare oggetti nelle immagini, consulta la classifica dei VLM.
Apprendimento zero-shot (ZSL)#
L'apprendimento zero-shot (ZSL) è un metodo di machine learning che consente ai modelli AI di gestire attività nuove e mai viste senza essere addestrati appositamente per svolgerle. Lo fa usando informazioni aggiuntive, come descrizioni o relazioni semantiche, per collegare ciò che il modello già conosce (classi viste) a nuove categorie mai viste.
Nell'elaborazione del linguaggio naturale, la ZSL aiuta i modelli a comprendere e trattare argomenti su cui non sono stati addestrati, basandosi sulle relazioni tra parole e concetti. Allo stesso modo, nella visione artificiale, la ZSL consente ai modelli di riconoscere oggetti o scene mai incontrati prima, collegando caratteristiche visive, come ali o piume, a concetti noti, come gli uccelli.
La ZSL collega NLP e CV combinando la comprensione linguistica con il riconoscimento visivo, risultando particolarmente utile per le attività che coinvolgono entrambi. Per esempio, nella risposta a domande visive, un modello può analizzare un'immagine e comprendere una domanda correlata per fornire una risposta accurata. È utile anche per attività come la generazione di didascalie per immagini.
Punti chiave#
La combinazione di elaborazione del linguaggio naturale e visione artificiale ha portato alla creazione di sistemi AI capaci di comprendere sia testi sia immagini. Questa combinazione viene usata in molti settori: aiuta le auto a guida autonoma a leggere i segnali stradali, migliora le diagnosi mediche e rende più sicuri i social media. Man mano che queste tecnologie migliorano, continueranno a semplificare la vita e a creare nuove opportunità in molti ambiti. Per saperne di più, visita il nostro repository GitHub e partecipa alla nostra community. Scopri le applicazioni dell'AI nelle auto a guida autonoma e nell'agricoltura nelle nostre pagine dedicate alle soluzioni.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









