Claude Fable 5.2 ist da und weigert sich, Sicherheitsröntgenaufnahmen anzusehen
Claude Fable 5.2 ist erschienen und weigert sich, den Sicherheitsröntgen-Datensatz IEDXray auf der Ultralytics Platform zu beschriften: Alle 10 Aufnahmen wurden blockiert, während Open-Source-Modelle antworteten.
 Glenn Jocher15 Min. Lesezeit
Anthropic hat Claude Fable 5.2 am 9. November 2026 veröffentlicht und erklärt, es sei „in fast allen von uns bewerteten Fähigkeiten einen Schritt besser als Opus 5.5“. Noch am selben Tag haben wir das Modell mit UL37 getestet, unserem Benchmark zur Detektion auf 36 Datensätzen. Bei einem dieser Datensätze weigerte es sich, auch nur ein einziges Bild anzusehen.
Die erste Aufnahme zeigt einen in einer Tasche verstauten Laptop. Durch das Gehäuse ist die Platine zu sehen, daneben sind zwei Akkus eingeklemmt. Wir baten Claude Fable 5.2, Begrenzungsrahmen darum zu zeichnen. In weniger als zwei Sekunden antwortete die Anthropic-API stattdessen mit einer Blockierung: „Diese Anfrage löste Einschränkungen für Inhalte im Zusammenhang mit der Entwicklung von hocheffektiven Sprengstoffen aus und wurde gemäß der Nutzungsrichtlinie von Anthropic blockiert.“
Bei allen 10 Sicherheitsröntgenaufnahmen des Datensatzes reagierte das Modell genauso. Dazu gehörten fünf Aufnahmen, auf denen nichts weiter als ein gewöhnliches Telefon, ein Laptop, ein Pager oder ein Walkie-Talkie zu sehen war. Kein anderes von uns getestetes Modell verweigerte auch nur eine Aufnahme: weder GPT-6.1, Gemini oder Grok noch ein Open-Weights- oder chinesisches Modell – und nicht einmal Anthropics eigene Modelle Claude Opus 5.5, Sonnet 5.5 und Haiku 5.5.
In allen anderen Bereichen ist die automatische Annotation mit Claude Fable 5.2 hervorragend. Das Modell erreichte 0.544 mAP50 und belegte auf unserer VLM-Bestenliste Platz 2 von 44, hinter GPT-6.1 Terra. Seine Begrenzungsrahmen sind die engsten, die wir bisher gemessen haben. Das Modell ist ab heute auf der Ultralytics Platform verfügbar. Im Folgenden erfährst du, was es verweigert, worin es glänzt und ob es in deinen Beschriftungsablauf passt.
Anthropics Filter blockierte jede Sicherheitsröntgenaufnahme in UL37#
UL37 misst, wie genau die Begrenzungsrahmen eines Modells mit menschlichen Beschriftungen auf 360 Bildern übereinstimmen: 10 Bilder aus jedem von 36 realen Datensätzen zur Objektdetektion. Einer davon ist IEDXray, eine Sammlung von Röntgenaufnahmen aus Gepäckscannern, die zum Training von Bedrohungsdetektoren für Flughäfen, Grenzen und Veranstaltungssicherheit erstellt wurde. Die 11 Klassen umfassen alltägliche Elektronikgeräte (Laptops, Telefone, Pager, Walkie-Talkies und Akkus), veränderte Versionen dieser Geräte und Sprengstoffe.
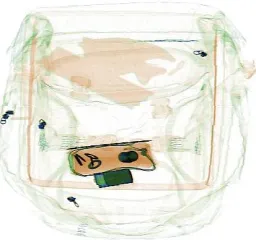 Vorschau 1 von IEDXray Improvised Device X-rayAnnotationen-Overlay mit 2 Beschriftungen
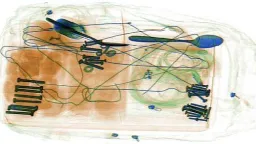 Vorschau 2 von IEDXray Improvised Device X-rayAnnotationen-Overlay mit 1 Beschriftung
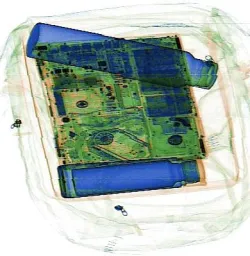 Vorschau 3 von IEDXray Improvised Device X-rayAnnotationen-Overlay mit 1 Beschriftung
 Vorschau 4 von IEDXray Improvised Device X-rayAnnotationen-Overlay mit 1 Beschriftung
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 verweigerte alle 10 Bilder. Jede Anfrage wurde nach 1,0 bis 4,7 Sekunden mit dem Stoppgrund refusal von Anthropic und ohne Begrenzungsrahmen beantwortet. Die Platform zeigt die Meldung „vor Abschluss der Detektionen angehalten (Verweigerung)“. Versuche es mit einem anderen Modell.“
Um genau herauszufinden, warum das geschah, haben wir am 10. November die Produktionsanfrage der Platform für alle zehn Aufnahmen direkt an die Anthropic-API gesendet. Alle zehn Antworten waren gleich: Stoppgrund refusal, Kategorie general_harms, null Ausgabetokens und die oben zitierte Meldung zu „hocheffektiven Sprengstoffen“. Die Meldung empfiehlt, über das Hilfezentrum von Anthropic eine „Ausnahmegenehmigung auf Grundlage deiner Verwendung von Claude“ zu beantragen. Für API-Integratoren verweist sie auf Anthropics Dokumentation zu Verweigerungen, in der die Konfiguration eines Ausweichmodells empfohlen wird.
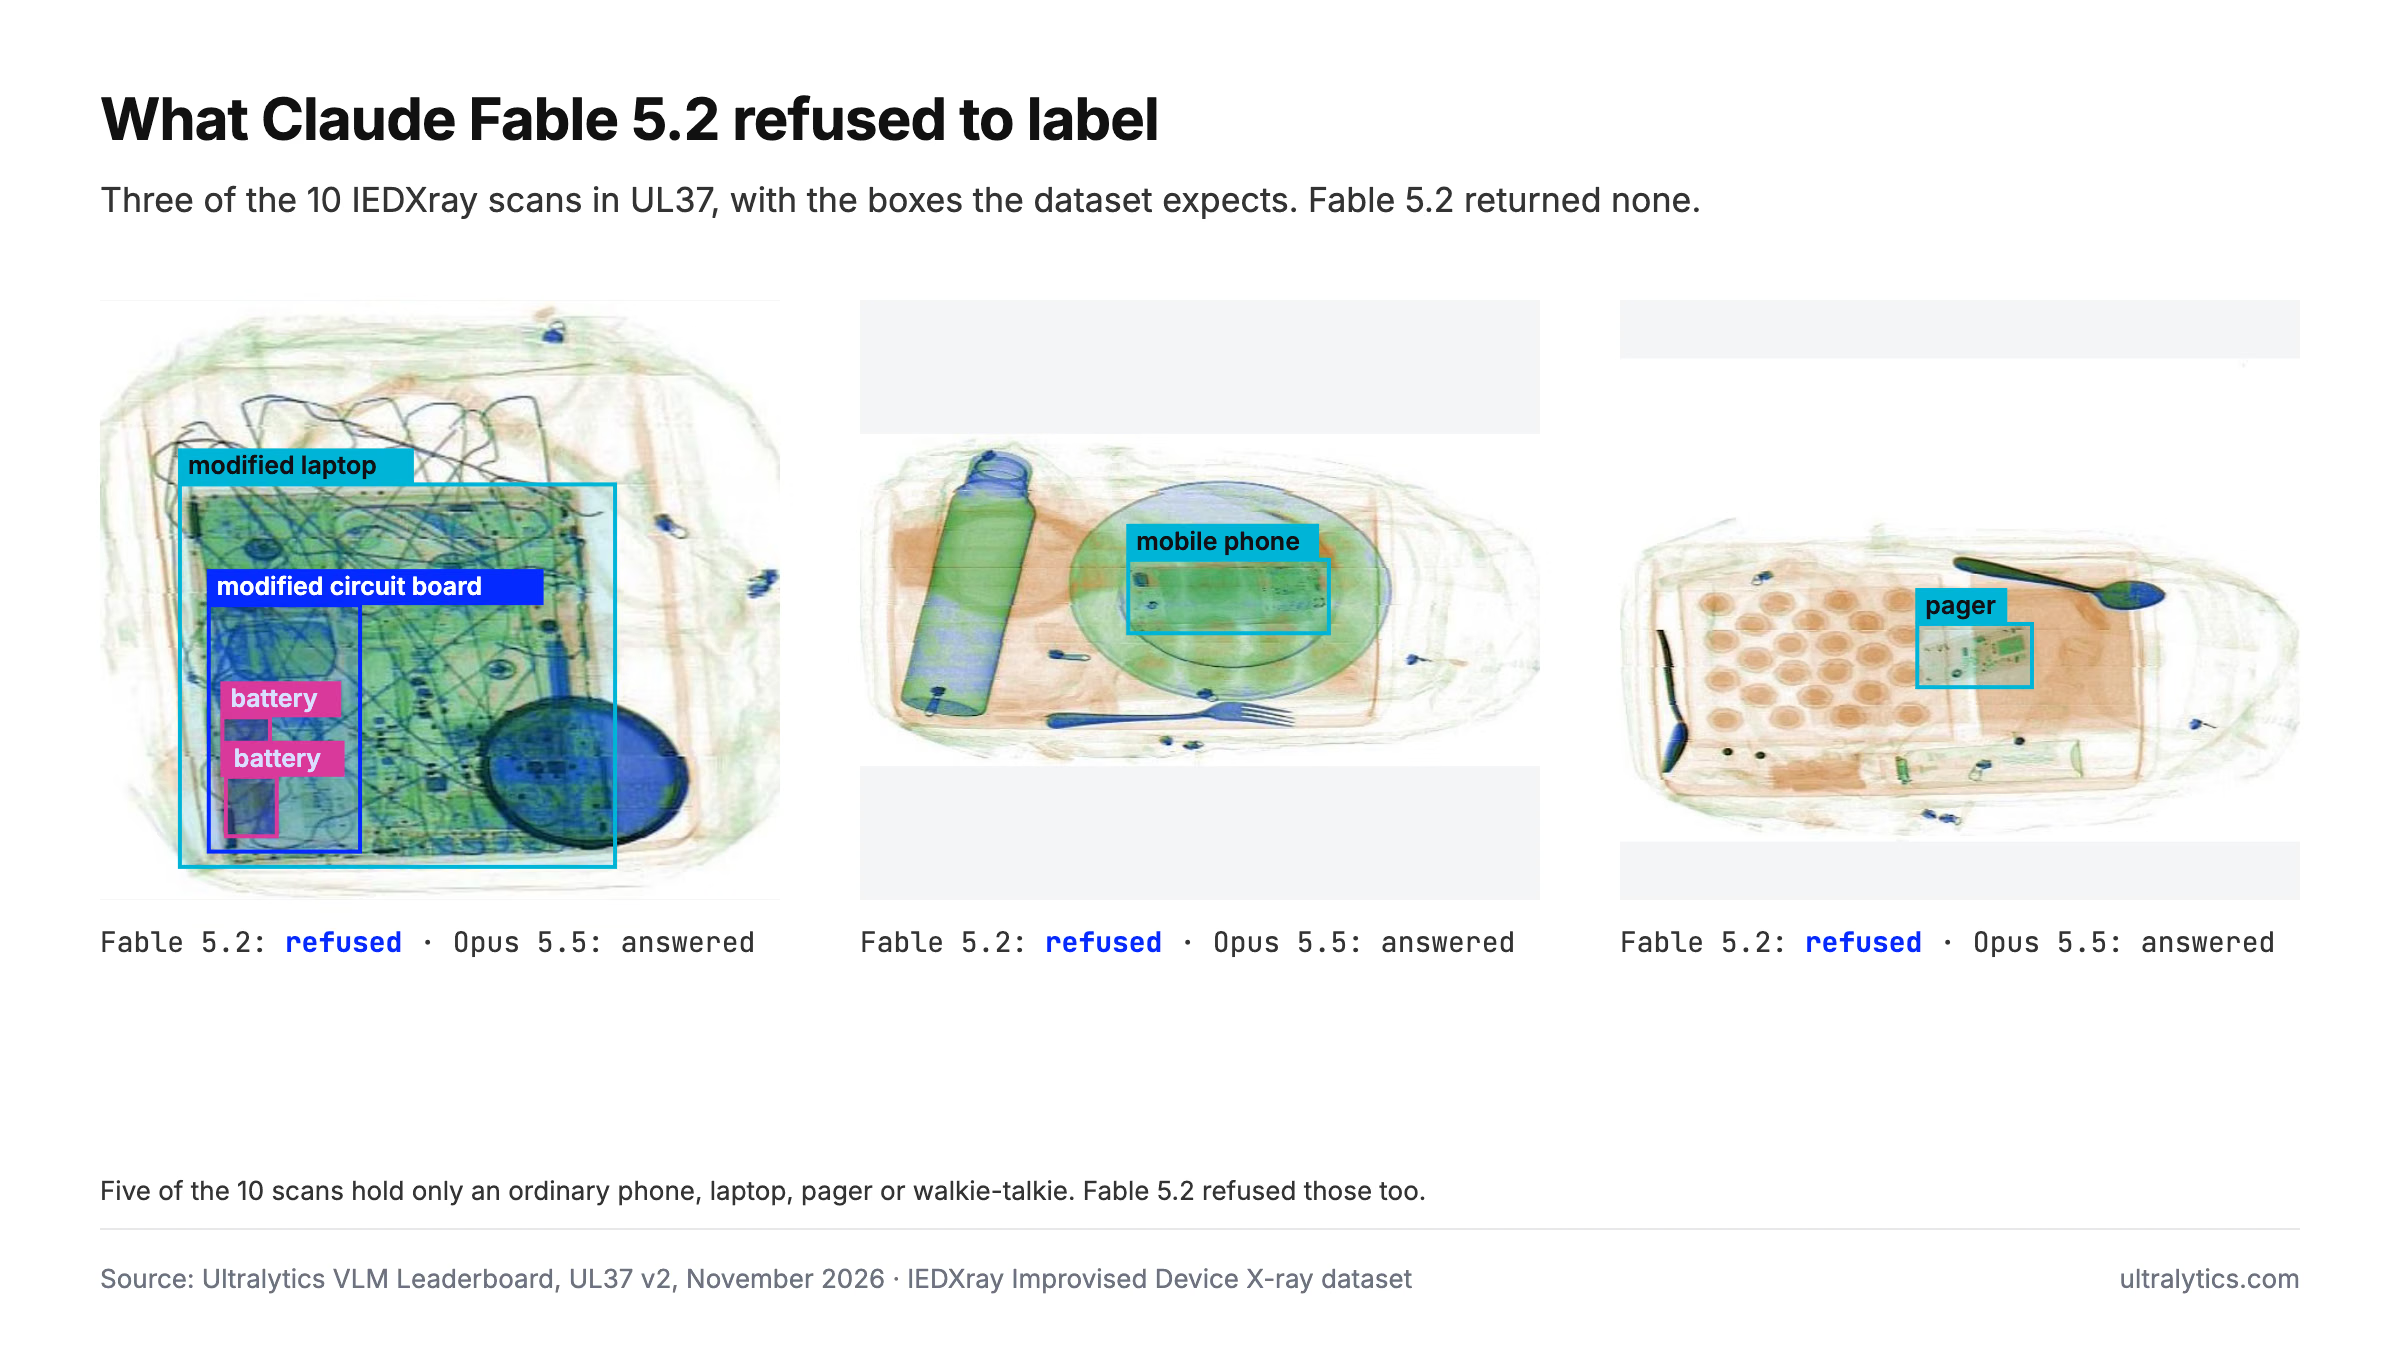
Drei der 10 IEDXray-Aufnahmen mit den erwarteten Begrenzungsrahmen. Claude Fable 5.2 verweigerte alle drei; Claude Opus 5.5 beantwortete in demselben Durchlauf alle zehn Aufnahmen.
Die Blockierung hat nichts mit dem Bildinhalt zu tun. Das Mobiltelefon in der Mitte ist einfach ein Mobiltelefon. Fünf der zehn Aufnahmen zeigen weder ein verändertes Gerät noch Sprengstoff, trotzdem verweigerte Fable 5.2 jede einzelne. Offenbar reagiert der Filter auf die Aufgabe selbst: einen Sicherheitsdatensatz, dessen Klassenliste Sprengstoffe aufführt.
Fable 5.2 verweigert mehr als Fable 5.1, nicht weniger#
Anthropics Ankündigung zur Veröffentlichung zufolge führen die Schutzmaßnahmen von Fable 5.2 für Cybersicherheit und Biologie zu „weniger unnötigen Blockierungen“ als bei Fable 5.1 – in frühen Tests etwa 55 % weniger. Bei Sicherheitsröntgenaufnahmen beobachteten wir das Gegenteil: Fable 5.1 verweigerte eine von zehn Aufnahmen, Fable 5.2 alle zehn.
Anthropic erklärt außerdem, Fable 5.2 und Claude Mythos 5.2 seien dasselbe zugrunde liegende Modell. Mythos 5.2 wird ohne bestimmte Schutzmaßnahmen für Cybersicherheit und Biologie ausgeliefert und ist nur für Organisationen verfügbar, die Anthropic überprüft hat. Anders gesagt: Die Schutzmaßnahmen sind eine vom Anbieter festgelegte Ebene, die unabhängig von der Sehfähigkeit des Modells ist. Fable 5.1 beantwortete neun derselben Aufnahmen und erreichte 0.15.
Für ein Team, das einen Detektor für die Gepäckkontrolle entwickelt, ist das Ergebnis klar: Das teuerste Claude-Modell hilft nicht bei der Beschriftung der Daten, und die Richtlinie hat sich von einer Version zur nächsten geändert.
Alle Open-Weights-Modelle beschrifteten die Aufnahmen, die Fable verweigerte#
Unter allen 44 Modellen auf unserer Bestenliste verweigerten nur zwei jemals eine IEDXray-Aufnahme, und beide waren Claude Fable: Version 5.1 verweigerte eine, Version 5.2 zehn. Kein anderes Modell verweigerte eine Aufnahme – ganz gleich, ob es von OpenAI, Google, xAI, Meta, einem chinesischen Labor oder aus Anthropics eigenen Produktreihen Opus, Sonnet und Haiku stammte.
Dazu gehören alle 19 von uns gehosteten Modelle auf den eigenen Servern der Platform sowie Open-Weights-Modelle wie Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text und Moondream 3.1. Keines dieser Modelle verweigerte auch nur eine Aufnahme. Moondream 3.1, ein Open-Weights-Modell, das auf der Platform keinen API-Schlüssel benötigt, erreichte auf IEDXray 0.27 mAP50. Damit lag es hinter Gemini 4 Argon mit 0.30 auf Platz zwei und vor allen Claude-Modellen.
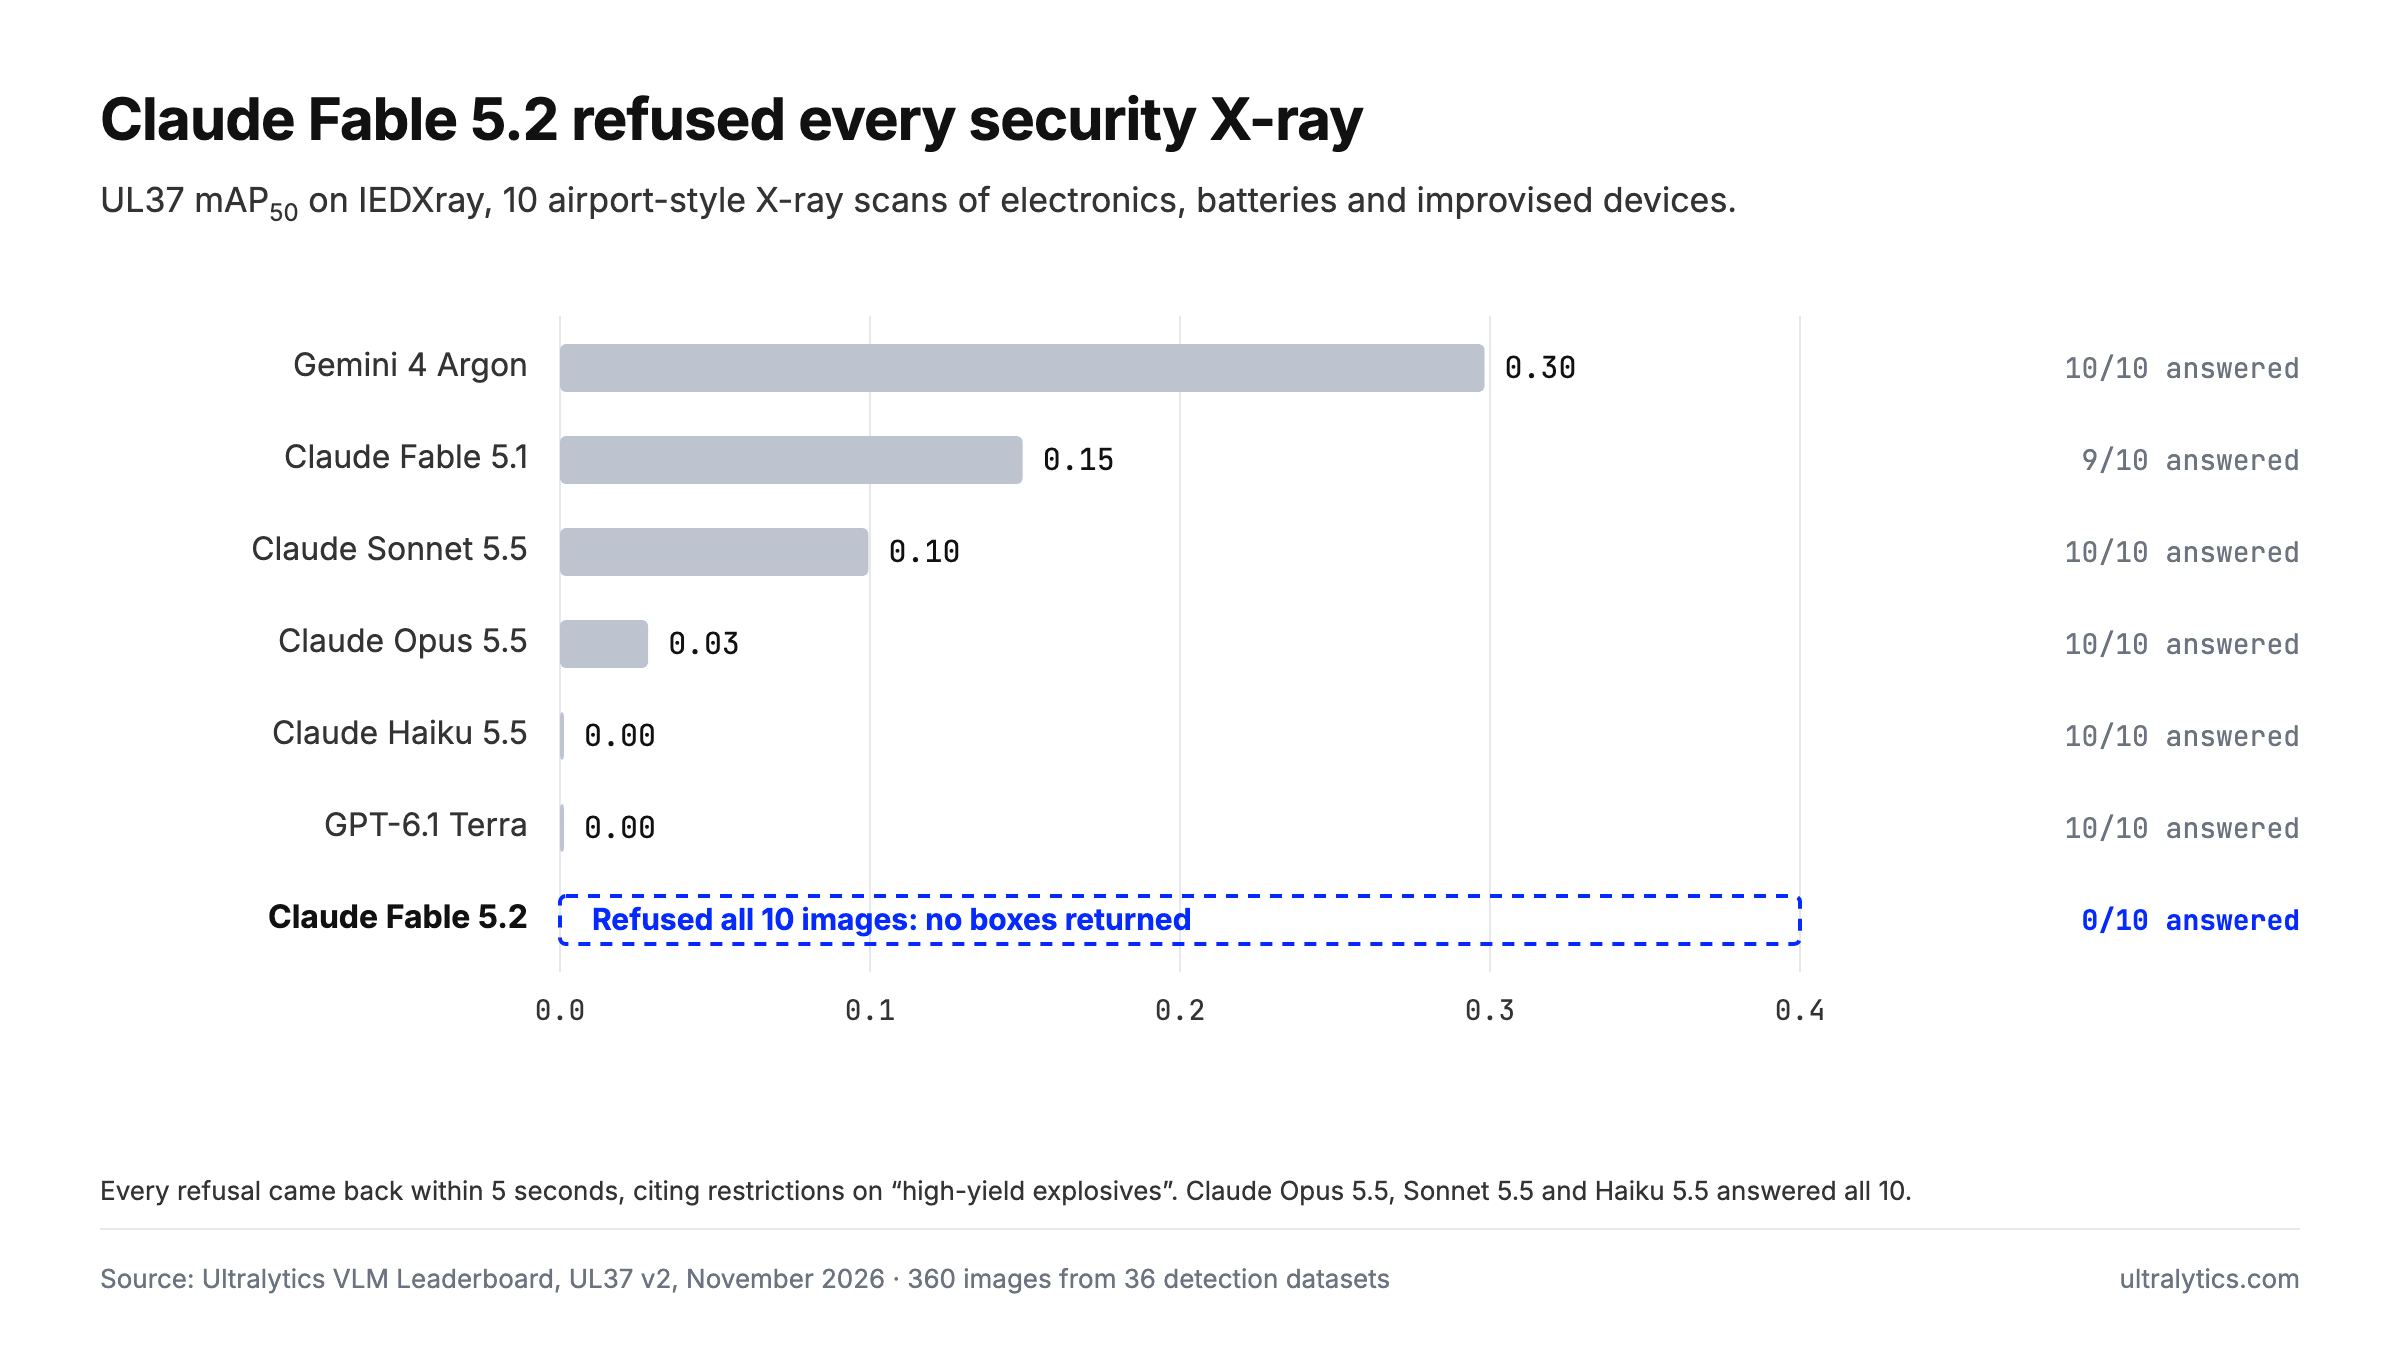
mAP50 auf IEDXray für Anthropics Modellreihe und die beiden Spitzenreiter der Bestenliste, UL37 v2, Standardeinstellung für den Reasoning-Aufwand. Fable 5.2 beantwortete keine der 10 Aufnahmen.
Chinesische Modelle sorgen häufig mit dem für Schlagzeilen, was sie nicht sagen wollen. Hier lief es umgekehrt: Ein führendes amerikanisches Labor zensierte die Ergebnisse, während alle von uns getesteten chinesischen Modelle bereitwillig antworteten. Alibabas Qwen, Moonshots Kimi, DeepSeek, Zhipus GLM, Xiaomis MiMo, MiniMax und Tencents HY4 verweigerten keine der zehn Aufnahmen. Auch die von uns gehosteten Open-Weights-Modelle von Qwen beantworteten jede einzelne. Anthropics Spitzenmodell für 8 $ pro Million Eingabetokens lehnte es ab, hinzusehen.
Sicherheitsröntgenaufnahmen sind für jedes Modell schwierig. Die meisten erreichen auf IEDXray weniger als 0.15, daher sind die Begrenzungsrahmen jedes Modells dort nur ein erster Entwurf. Einen Entwurf kannst du jedoch im Annotationseditor korrigieren. Bei einer Verweigerung musst du jeden Rahmen von Hand zeichnen. Open Weights bedeuten außerdem, dass sich das von dir heute geprüfte Modell morgen genauso verhält, weil keine Anbieterrichtlinie zwischen dir und seiner Ausgabe steht. Sobald die Daten beschriftet sind, hast du mit dem Training deines eigenen Ultralytics-YOLO26-Detektors auch das eingesetzte Modell vollständig unter Kontrolle.
Abseits von Sicherheitsröntgenaufnahmen ist Claude Fable 5.2 der zweitbeste von uns getestete Annotationsassistent#
Jedes UL37-Bild durchläuft dieselbe Produktionspipeline wie für Platform-Nutzer, mit den Klassenbezeichnungen des jeweiligen Datensatzes. Anschließend verfeinert SAM 3.1 jeden Begrenzungsrahmen. Die Methodik ist öffentlich. Hier ist die Ergebnisübersicht von Fable 5.2:
- mAP50: 0.544, Platz 2 von 44
- mAP50-95: 0.347, Platz 1 von 44, knapp vor den 0.345 von GPT-6.1 Terra
- Präzision und Trefferquote: 0.602 und 0.620
- Anbieterkosten: 37,55 $ pro 1.000 Bilder
- Medianzeit pro Bild: 4,6 s
- Fehlgeschlagene Anfragen: 11 von 360, die 10 Verweigerungen plus eine Anfrage, die das 115-Sekunden-Limit der Platform überschritt
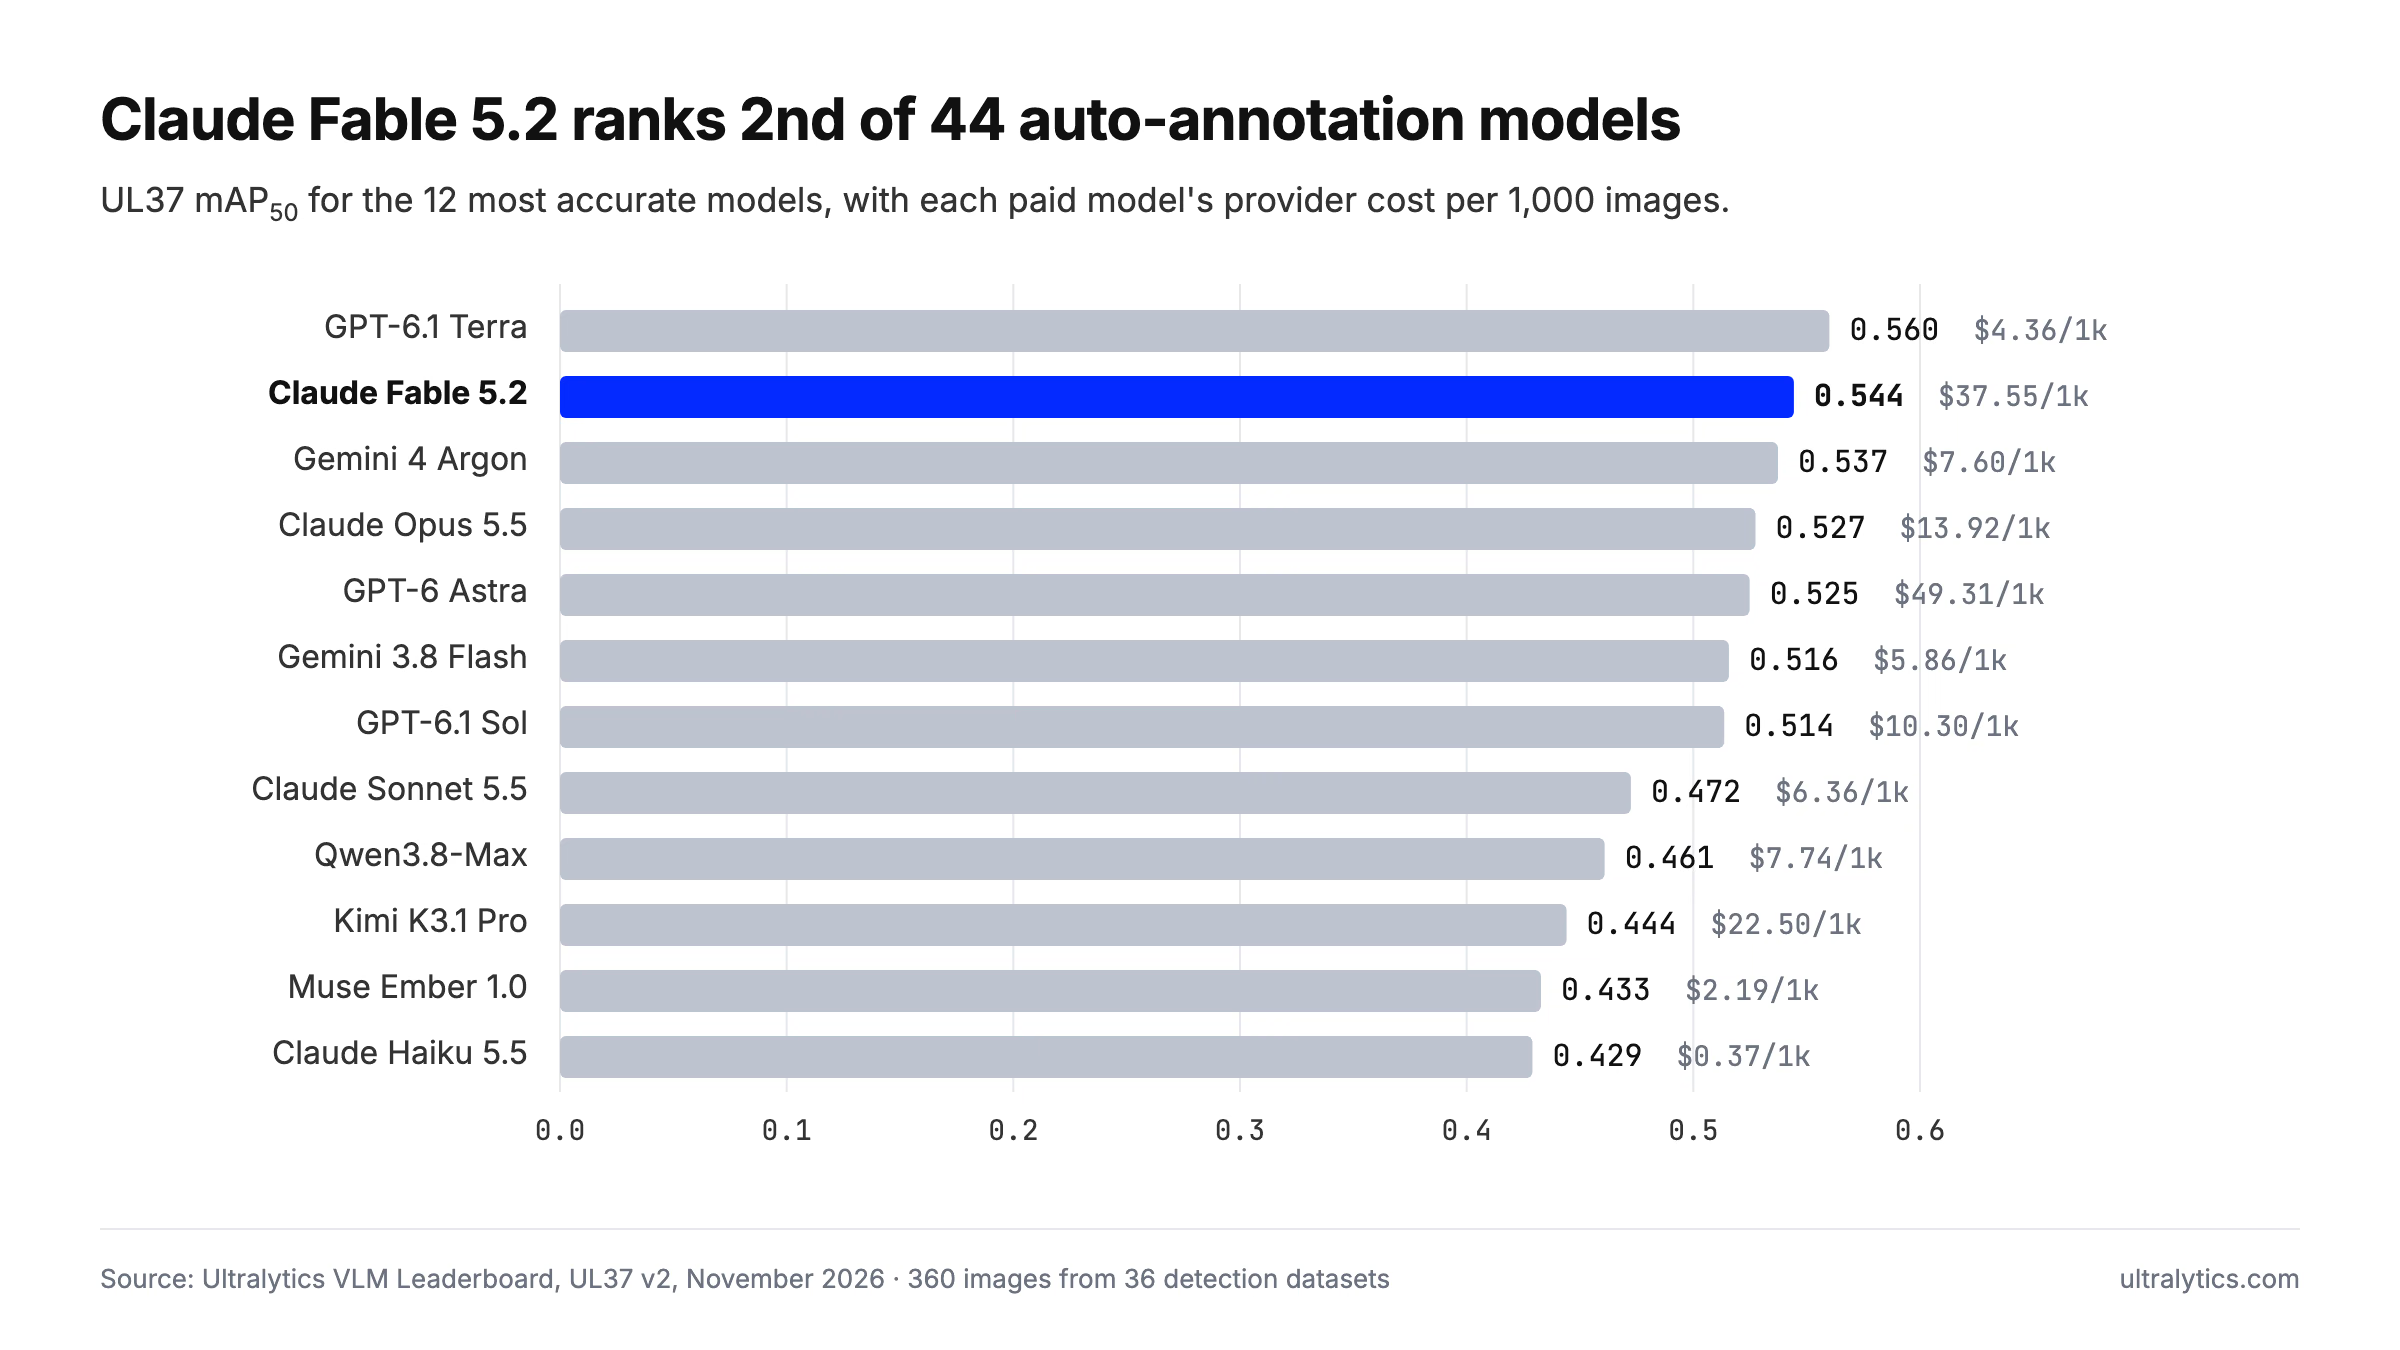
mAP50 auf UL37 für die 12 genauesten von 44 Modellen, einschließlich der Anbieterkosten pro 1.000 Bilder, Stand 10. November 2026.
Der erste Platz beim Wert mAP50-95 ist bedeutsam. Dieser strengere Wert bildet den Durchschnitt der Überlappungsschwellen für Begrenzungsrahmen von 50 % bis 95 % und belohnt daher Rahmen, die eng an den jeweiligen Objekten anliegen, statt sie nur ungefähr zu umschließen. Die ursprünglichen Begrenzungsrahmen von Fable 5.2 erreichen schon vor der Verfeinerung durch SAM 3.1 einen Wert von 0.538 mAP50; durch die Verfeinerung steigt dieser auf 0.544.
Bei 22 der 36 Datensätze landet das Modell unter den ersten fünf, bei drei belegt es den ersten Platz: Tabletts mit Schulmittagessen aus UEC (0.96), die Detektion von Basketballkörben und -würfen (0.85) sowie PlantDoc zur Erkennung von Pflanzenkrankheiten auf Blättern (0.52). Nach Anwendungsgebiet liegt es im Einzelhandel auf Platz eins und in Natur und Landwirtschaft knapp vor Claude Opus 5.5. Auf den 10 separat ausgewerteten COCO-2017-Referenzbildern erreicht es 0.686. Das ist der beste Wert unter allen Sprachmodellen, übertroffen nur von den Segmentierungsmodellen SAM 3 und SAM 3.1 Text.
Durch die Verweigerungen erhielt Fable 5.2 bei einem Datensatz eine glatte Null, aber das kostete das Modell nicht den ersten Platz. Ohne IEDXray erreicht Fable 5.2 im Durchschnitt 0.560, während Terra, das dort ebenfalls eine Null erzielte, ohne die Aufnahme zu verweigern, auf durchschnittlich 0.576 kommt.
Ein gewaltiger Sprung gegenüber Claude Fable 5.1#
Fable 5.2 übertrifft Claude Fable 5.1 bei 31 von 36 Datensätzen und kostet pro Bild weniger.
| UL37-Ergebnis | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Präzision / Trefferquote | 0.602 / 0.620 | 0.506 / 0.485 |
| Platzierung in der Rangliste | Platz 2 von 44 | Platz 13 von 44 |
| Anbieterkosten pro 1.000 Bilder | $37.55 | $43.75 |
| Mediane Zeit pro Bild | 4.6 s | 2,6 s |
| Verweigerte IEDXray-Bilder | 10 | 1 |
Präzision und Trefferquote stiegen gemeinsam an. Das bedeutet weniger falsche Begrenzungsrahmen, die gelöscht werden müssen, und weniger übersehene Objekte, die eingezeichnet werden müssen. Die größten Verbesserungen sind beeindruckend: Bei den Weizenköpfen in GWHD stieg der Wert von Fable 5.1 von 0.24 auf 0.77 bei Fable 5.2. Bei RPC im Einzelhandel ging es für Produkte von 0.57 auf 0.90, bei Wärmebildern von Drohnen aus HIT-UAV von 0.17 auf 0.48 und bei Schilddrüsenultraschall aus TN5000 von 0.03 auf 0.44.
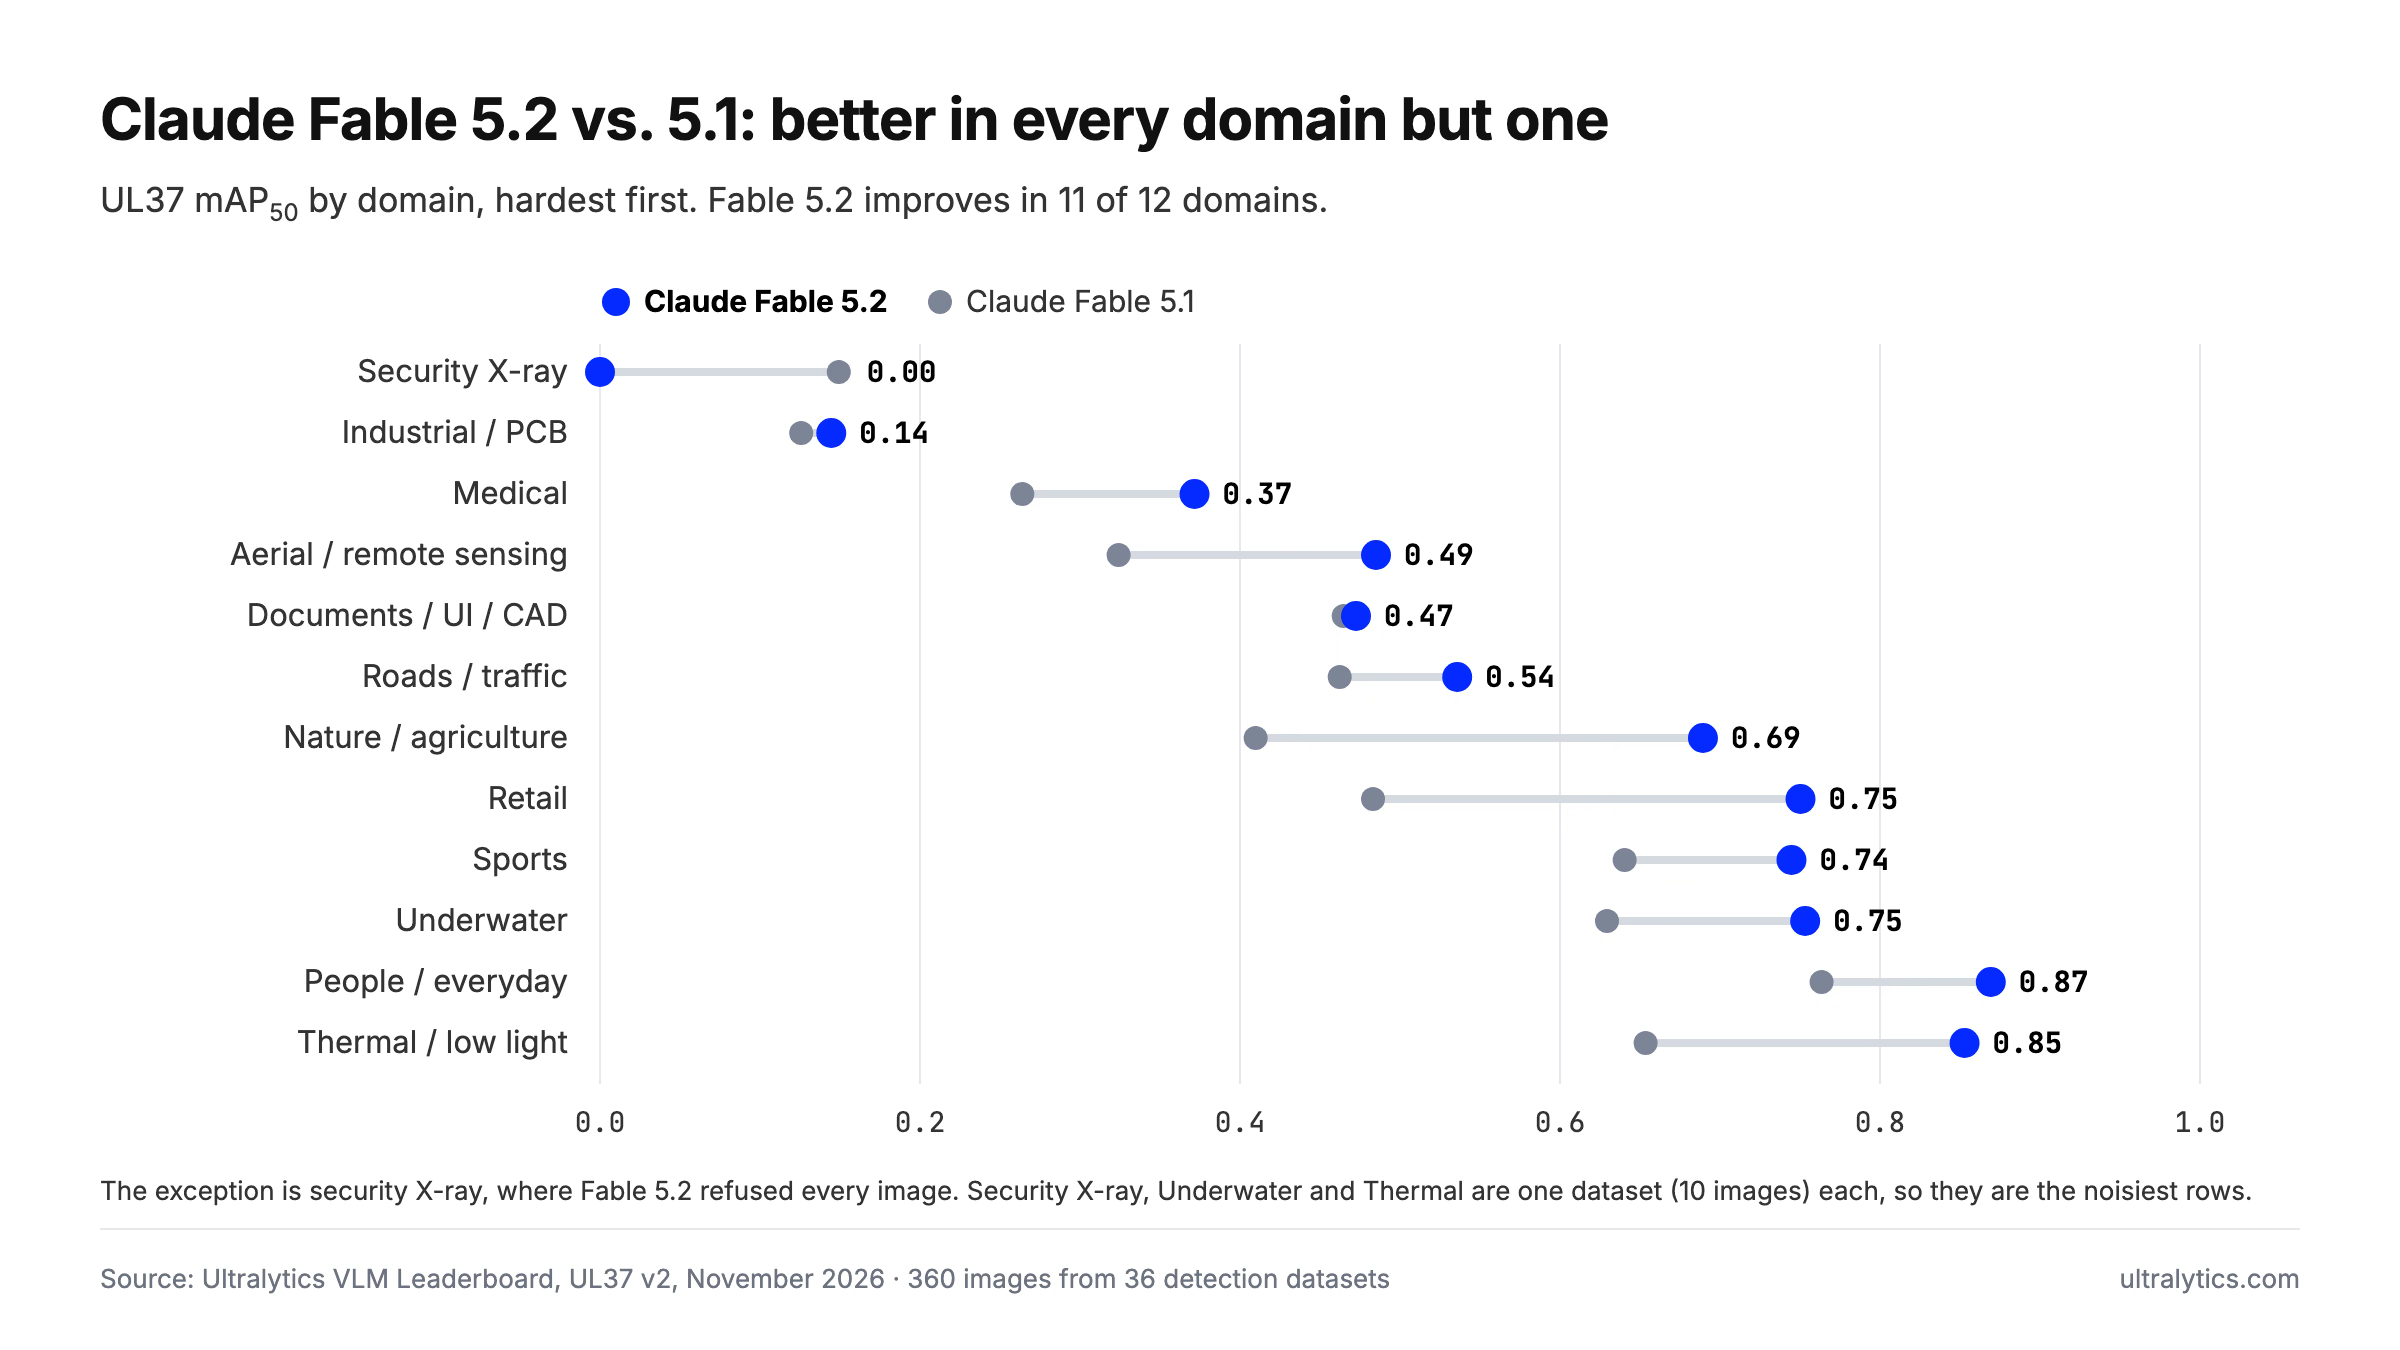
mAP50 nach Anwendungsgebiet auf UL37, sortiert vom schwierigsten zum einfachsten: Claude Fable 5.2 im Vergleich zu Claude Fable 5.1 bei Anthropics Standardeinstellung für den Reasoning-Aufwand.
In elf von zwölf Bereichen gab es Verbesserungen. Der einzige Rückgang betrifft Sicherheitsröntgenaufnahmen: Der Wert sank von 0.15 auf null, und das liegt an der Verweigerung, nicht an der Sehfähigkeit des Modells. Auch bei Straßenmarkierungen in CeyMo ging der Wert von 0.85 auf 0.74 zurück.
Claude Fable 5.2 im Vergleich zu GPT-6.1 Terra, Gemini 4 Argon und Claude Opus 5.5#
| Modell | UL37 mAP50 | mAP50-95 | Präzision | Trefferquote | Kosten pro 1.000 Bilder | Mediane Zeit pro Bild |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 s |
Im direkten Vergleich schlägt Fable 5.2 Terra bei 18 Datensätzen und unterliegt bei 16; zwei Ergebnisse sind gleich. Gegen Argon liegt das Verhältnis bei 21 zu 15 und gegen Opus 5.5 bei 22 zu 14. Von den vier Modellen hat es die höchste Trefferquote, übersieht also die wenigsten Objekte. Seine Präzision ist jedoch am niedrigsten, sodass du mit einigen zusätzlichen Begrenzungsrahmen rechnen musst, die gelöscht werden müssen. Unser Leitfaden zur Auswahl eines VLM anhand von Präzision und Trefferquote erklärt, wie du diesen Kompromiss für deine Daten abwägst.
Abgesehen von Röntgenaufnahmen schneidet Fable 5.2 bei medizinischen Bildern schlechter ab: Über acht Datensätze liegt der Durchschnitt bei 0.372 gegenüber 0.505 für Terra. Bei Platinen erreicht das Modell auf DeepPCB 0.00. Jeder Datensatz enthält nur 10 Bilder; betrachte die Werte einzelner Datensätze daher als Hinweise, nicht als endgültiges Urteil.
Anthropic selbst empfiehlt, die meisten Aufgaben mit Claude Opus 5.5 zu beginnen – dem „stärksten Alltagsmodell“ – und nur dann zu Fable zu wechseln, wenn die Aufgabe es erfordert. Für die Annotation gilt dieser Rat ebenfalls. Opus 5.5 erreicht 97 % des mAP50-Werts von Fable 5.2 bei 37 % der Kosten, antwortet in 2,7 s und verweigerte keine der Röntgenaufnahmen.
Was ein Durchlauf mit Claude Fable 5.2 kostet#
Die 37,55 $ pro 1.000 Bilder sind die Kosten des Anbieters. Sie wurden anhand der von Anthropic gemeldeten Token-Nutzung und der Listenpreise von 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens gemäß Anthropics Preisseite berechnet. Fable 5.2 läuft mit Anthropics standardmäßig hoher Reasoning-Intensität. Für die Stapelannotation fällt zusätzlich eine Bearbeitungsgebühr der Platform von 1,00 $ pro 1.000 Bilder an; ein Durchlauf mit 1.000 Bildern kostet somit etwa 38,55 $.
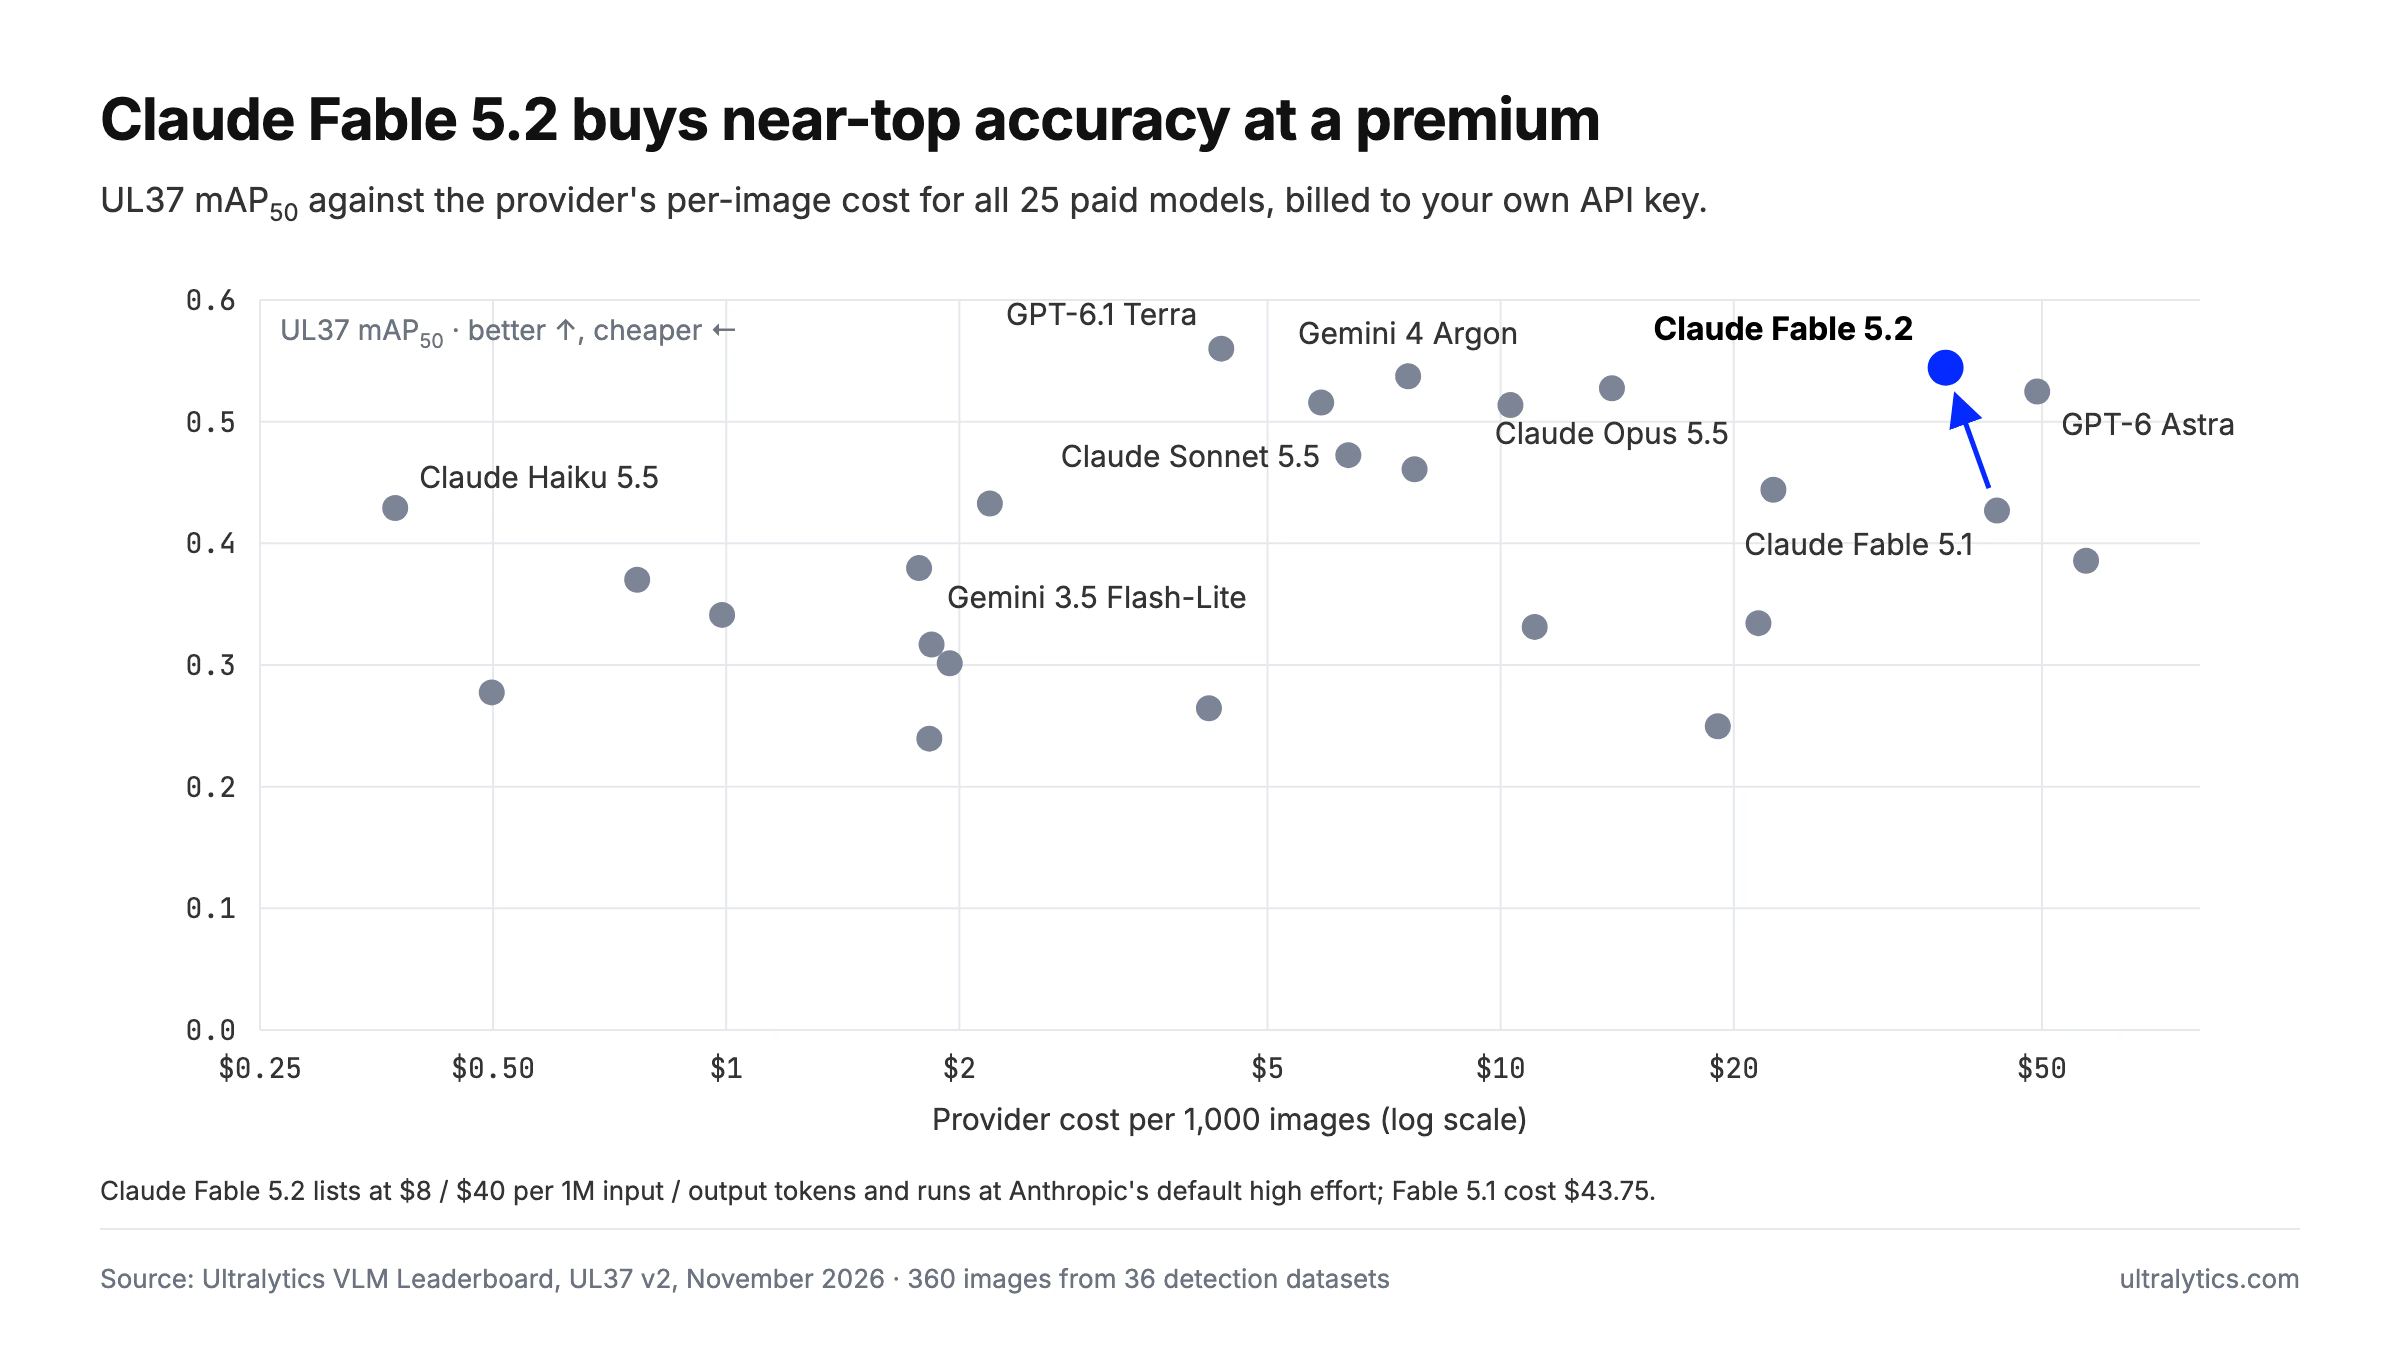
mAP50 auf UL37 im Verhältnis zu den Anbieterkosten pro 1.000 Bilder für alle 25 kostenpflichtigen Modelle, Listenpreise, Stand 10. November 2026.
Das ist mehr als das Achtfache von Terras 4,36 $, bei einem um 0.016 niedrigeren mAP50-Wert. Fable 5.2 ist seinen Preis nur dann wert, wenn eng anliegende Begrenzungsrahmen wichtiger sind als das Budget. Wenn die Kosten eine Rolle spielen, erreicht Claude Haiku 5.5 für 0,37 $ einen Wert von 0.429, und gehostete Open-Weights-Modelle benötigen überhaupt keinen API-Schlüssel.
So nutzt du Claude Fable 5.2 zur automatischen Annotation deines Datensatzes#
Fable 5.2 ist ein Modell für Detektionsdatensätze mit 1 bis 200 Klassen, die über Klassen-Prompts angegeben werden. Es gibt Begrenzungsrahmen für die Klassenbezeichnungen deines Datensatzes zurück, die du vor dem Speichern überprüfst.
- Erstelle einen Schlüssel auf der Seite Claude-API-Schlüssel.
- Füge ihn unter Einstellungen > API-Schlüssel im Platform-Arbeitsbereich hinzu, dem dein Datensatz gehört. Anthropic rechnet direkt mit dir ab, und Ultralytics erhebt keinen Aufschlag auf Tokens. Alle Einzelheiten findest du in der Dokumentation zu Anbieterschlüsseln.
- Wechsle im Annotationseditor zum Modus Smart und wähle unter Anthropic Claude Fable 5.2 aus. Klicke auf Vorhersagen, oder drücke
P, um das aktuelle Bild zu beschriften. - Um alle noch nicht beschrifteten Bilder zu beschriften, wähle auf der Datensatzseite Weitere Aktionen > Stapelannotation. Die Platform speichert zuerst eine Datensatzversion, sodass du Änderungen rückgängig machen kannst.
- Wenn die Beschriftung einiger Bilder verweigert wird, starte die Stapelannotation mit einem anderen Modell erneut, etwa Gemini 4 Argon oder einem gehosteten Open-Weights-Modell. Beschriftet werden nur die Bilder, die noch keine Beschriftung haben.
- Überprüfe die Begrenzungsrahmen, speichere sie und trainiere ein YOLO26-Modell mit dem Ergebnis im selben Arbeitsbereich.
Öffne vor dem Übernehmen eines großen Datensatzes die Modellseite. Dort werden die aufgezeichneten Begrenzungsrahmen von Fable 5.2 auf jedem Benchmark-Datensatz neben den erwarteten Rahmen angezeigt, außerdem wird der jeweilige Wert aufgelistet.
Modellseite von Claude Fable 5.2
Wenn du mehr darüber erfahren möchtest, wie diese Modelle in den Editor passen, lies, wie die Ultralytics Platform KI zur Automatisierung der Annotation nutzt und warum die Überprüfung durch Menschen weiterhin unverzichtbar ist.
Für wen eignet sich Claude Fable 5.2?#
Wähle Claude Fable 5.2, wenn eng anliegende Begrenzungsrahmen am wichtigsten sind und das Budget eine untergeordnete Rolle spielt: etwa bei Sport, Einzelhandel, Landwirtschaft und Alltagsszenen, wo das Modell zu den besten gehört oder ganz vorne liegt. Dank seiner Spitzenleistung bei mAP50-95 eignet es sich als erster Entwurf für Datensätze, mit denen du bei strengen IoU-Schwellenwerten trainieren möchtest.
Verzichte bei Daten aus den Bereichen Sicherheit, Verteidigung und Kontrolle darauf. Anthropics Filter verweigerte jede Aufnahme in unserem Sicherheitsröntgen-Datensatz, selbst solche, auf denen nur ein Telefon zu sehen war. Die Platform kann diese Blockierung nicht umgehen. Nutze für solche Projekte Gemini 4 Argon oder ein Open-Weights-Modell, das du kontrollierst. Für die meisten anderen Beschriftungsaufgaben liefern GPT-6.1 Terra oder Claude Opus 5.5 fast dieselben Begrenzungsrahmen für einen Bruchteil des Preises.
Häufig gestellte Fragen
Die Anthropic-API blockiert Anfragen zur Annotation von Sicherheitsröntgenaufnahmen, wenn sie Sprengstoffklassen betreffen. Bei allen 10 IEDXray-Aufnahmen in unserem Benchmark gab sie den Stoppgrund
refusalund die Kategoriegeneral_harmszurück. Als Begründung nannte sie „Einschränkungen für Inhalte im Zusammenhang mit der Entwicklung von hocheffektiven Sprengstoffen“ – sogar bei Aufnahmen, auf denen nur ein gewöhnliches Telefon oder ein Laptop zu sehen war. Ein erneuter Klick auf „Vorhersagen“ hilft nicht; verwende für diese Bilder ein anderes Modell.Kein anderes Modell auf unserer Bestenliste verweigerte eine IEDXray-Aufnahme. Dazu gehören alle 19 von uns gehosteten Modelle, sämtliche Modelle aus chinesischen Laboren und Anthropics eigene Modelle Claude Opus 5.5, Sonnet 5.5 und Haiku 5.5. Gemini 4 Argon erzielte mit 0.30 mAP50 den höchsten Wert, gefolgt vom Open-Weights-Modell Moondream 3.1 mit 0.27. Die Genauigkeit bei Sicherheitsröntgenaufnahmen ist bei allen Modellen gering; überprüfe daher jeden Begrenzungsrahmen.
Ja. Über 36 reale Datensätze zur Objektdetektion erreicht es 0.544 mAP50 und belegt Platz 2 von 44 Modellen. Beim strengeren Wert mAP50-95 liegt es mit 0.347 auf Platz eins. Besonders gut ist es bei Einzelhandel, Sport, Landwirtschaft und Alltagsszenen, am schwächsten dagegen bei Sicherheitsröntgenaufnahmen, medizinischen Bildern und Fehlern auf Platinen.
Das Modell erreicht 0.544 mAP50 gegenüber 0.427 bei Fable 5.1 und gewinnt bei 31 von 36 Datensätzen. Gleichzeitig kostet es 37,55 $ statt 43,75 $ pro 1.000 Bilder. Es ist mit 4,6 s pro Bild langsamer als Fable 5.1 mit 2,6 s und verweigerte alle 10 Sicherheitsröntgenaufnahmen, während Fable 5.1 eine verweigerte.
Etwa 37,55 $ an Anthropic-Gebühren, berechnet anhand der vom Anbieter gemeldeten Token-Nutzung zu 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens. Für die Stapelannotation auf der Ultralytics Platform fällt eine Bearbeitungsgebühr von 1,00 $ pro 1.000 Bilder an. Du bezahlst Anthropic direkt über deinen eigenen API-Schlüssel.
Terra erzielt mit 0.560 gegenüber 0.544 einen höheren mAP50-Wert und kostet etwa ein Achtel. Die Begrenzungsrahmen von Fable 5.2 sind etwas enger: Das Modell erreicht 0.347 mAP50-95 gegenüber Terras 0.345 und gewinnt bei 18 Datensätzen gegenüber 16 für Terra. Für die meisten Teams ist Terra die bessere Standardwahl. Fable 5.2 lohnt sich, wenn die Genauigkeit der Begrenzungsrahmen wichtiger ist als die Kosten.
Verfasst von
Gründer und CEO · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









