GPT-6.1 Terra erreicht Platz 1 bei der automatischen Annotation und übertrifft OpenAIs eigene Spitzenmodelle
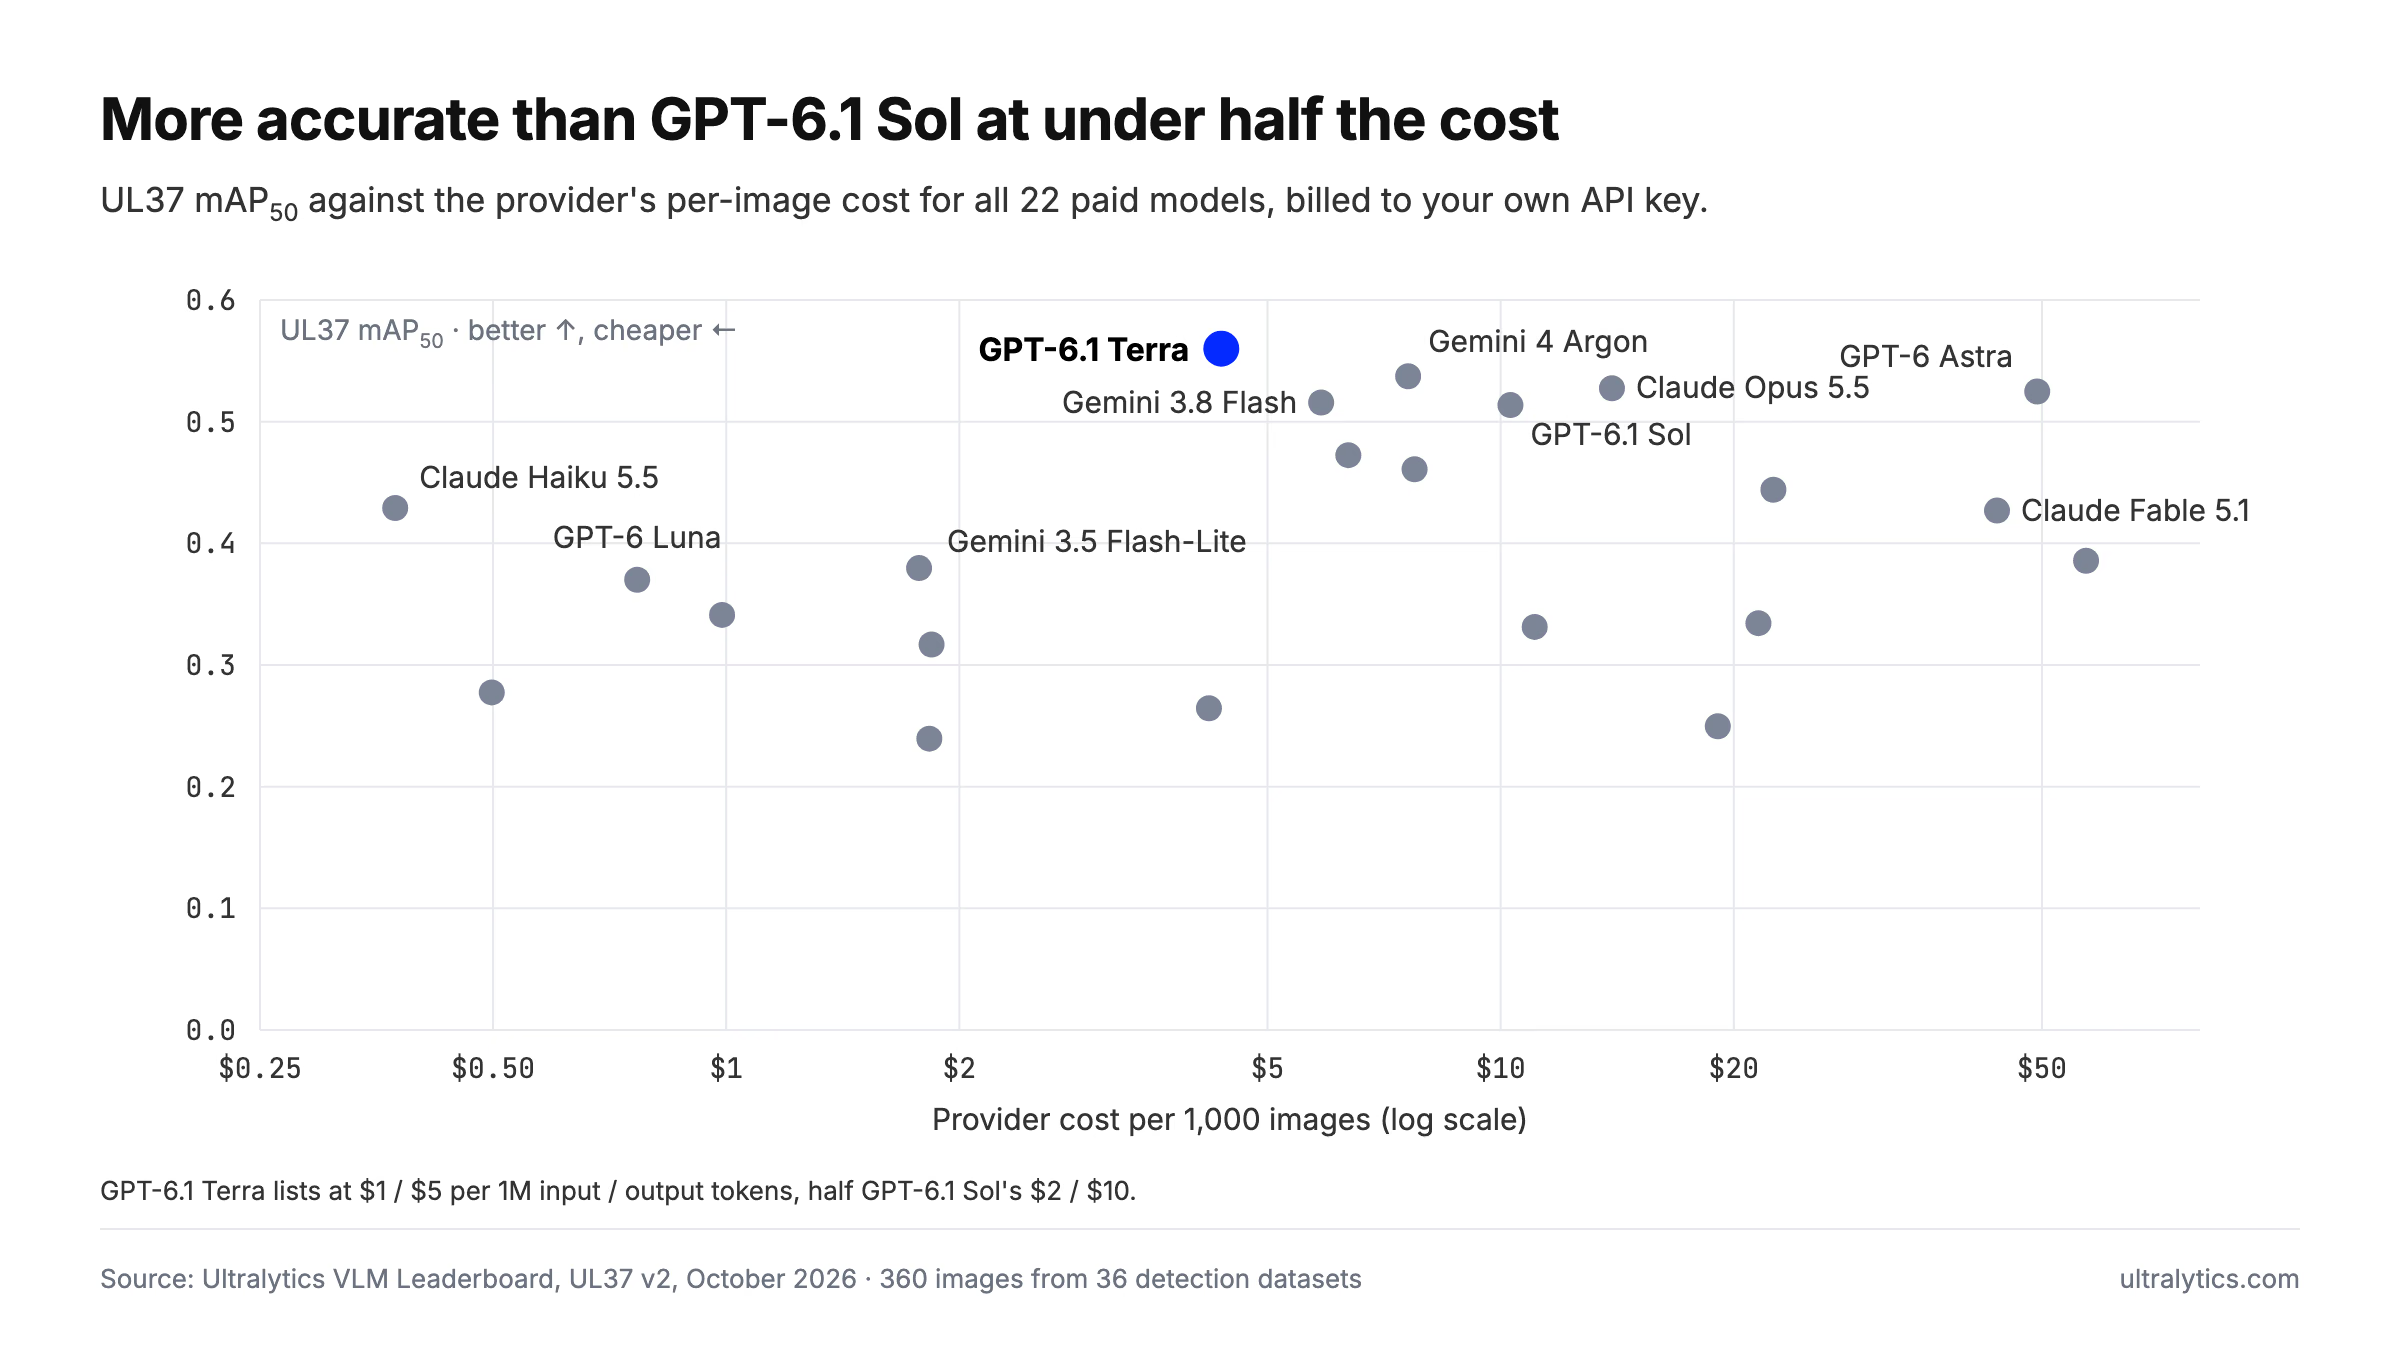
GPT-6.1 Terra für automatische Annotation übertrifft 39 Modelle auf unserer VLM-Bestenliste: 0.560 mAP50 für 4,36 $ pro 1.000 Bilder, vor GPT-6.1 Sol und Gemini 4 Argon.
OpenAIs Einführungsmaterialien sagen, dass GPT-6.1 Terra bei visuellen Schlussfolgerungen seinen größeren Geschwistermodellen fast ebenbürtig ist. Als wir das Modell aufforderten, Begrenzungsrahmen zu zeichnen, stellte sich „fast“ als das falsche Wort heraus.
Am 26. Oktober 2026, dem Tag der Veröffentlichung, haben wir GPT-6.1 Terra für die automatische Annotation mit UL37 getestet, unserem Detektions-Benchmark mit 36 Datensätzen. Das Modell erzielte 0.560 mAP50 – das beste Ergebnis aller 39 Modelle auf unserer VLM-Bestenliste. OpenAIs mittelpreisiges Modell lag vor GPT-6.1 Sol, dem Spitzenmodell GPT-6 Astra und Gemini 4 Argon, das bis zu dieser Woche den ersten Platz belegt hatte.
Das Ergebnis erreichte es für 4,36 $ pro 1.000 Bilder bei 5,1 Sekunden pro Bild und ohne einen einzigen fehlgeschlagenen Aufruf. Du kannst es ab sofort auf der Ultralytics Platform verwenden. Im Folgenden erfährst du, worin es glänzt, wo es Schwächen zeigt und wie du entscheidest, ob es zu deinem Beschriftungsablauf passt.
GPT-6.1 Terra belegt den ersten Platz auf UL37#
UL37 misst anhand von 360 Bildern, wie genau die Begrenzungsrahmen eines Modells mit menschlichen Beschriftungen übereinstimmen: 10 Bilder aus jedem von 36 realen Objekterkennungs-Datensätzen zu medizinischen Aufnahmen, Luftbildern, Verkaufsregalen, Sport, Dokumenten, Leiterplatten und mehr. Jedes Bild durchläuft dieselbe Produktionspipeline, die Platform-Nutzer verwenden, mit den jeweiligen Klassennamen des Datensatzes und SAM 3.1 zur präziseren Anpassung jedes Begrenzungsrahmens. Die Methodik ist öffentlich.
Hier ist die Ergebnisübersicht von Terra:
- mAP50: 0.560, Platz 1 von 39
- mAP50-95: 0.345, ebenfalls Platz 1; die Begrenzungsrahmen sitzen also präzise und nicht nur ungefähr
- Präzision und Trefferquote: 0.646 und 0.613
- Kosten beim Anbieter: 4,36 $ pro 1.000 Bilder
- Medianzeit pro Bild: 5,1 s
- Fehlgeschlagene Aufrufe: keine
Sechs Modelle erzielen auf UL37 mehr als 0.51, darunter Claude Opus 5.5 auf Platz drei. Terra ist das genaueste der sechs und zugleich das günstigste.
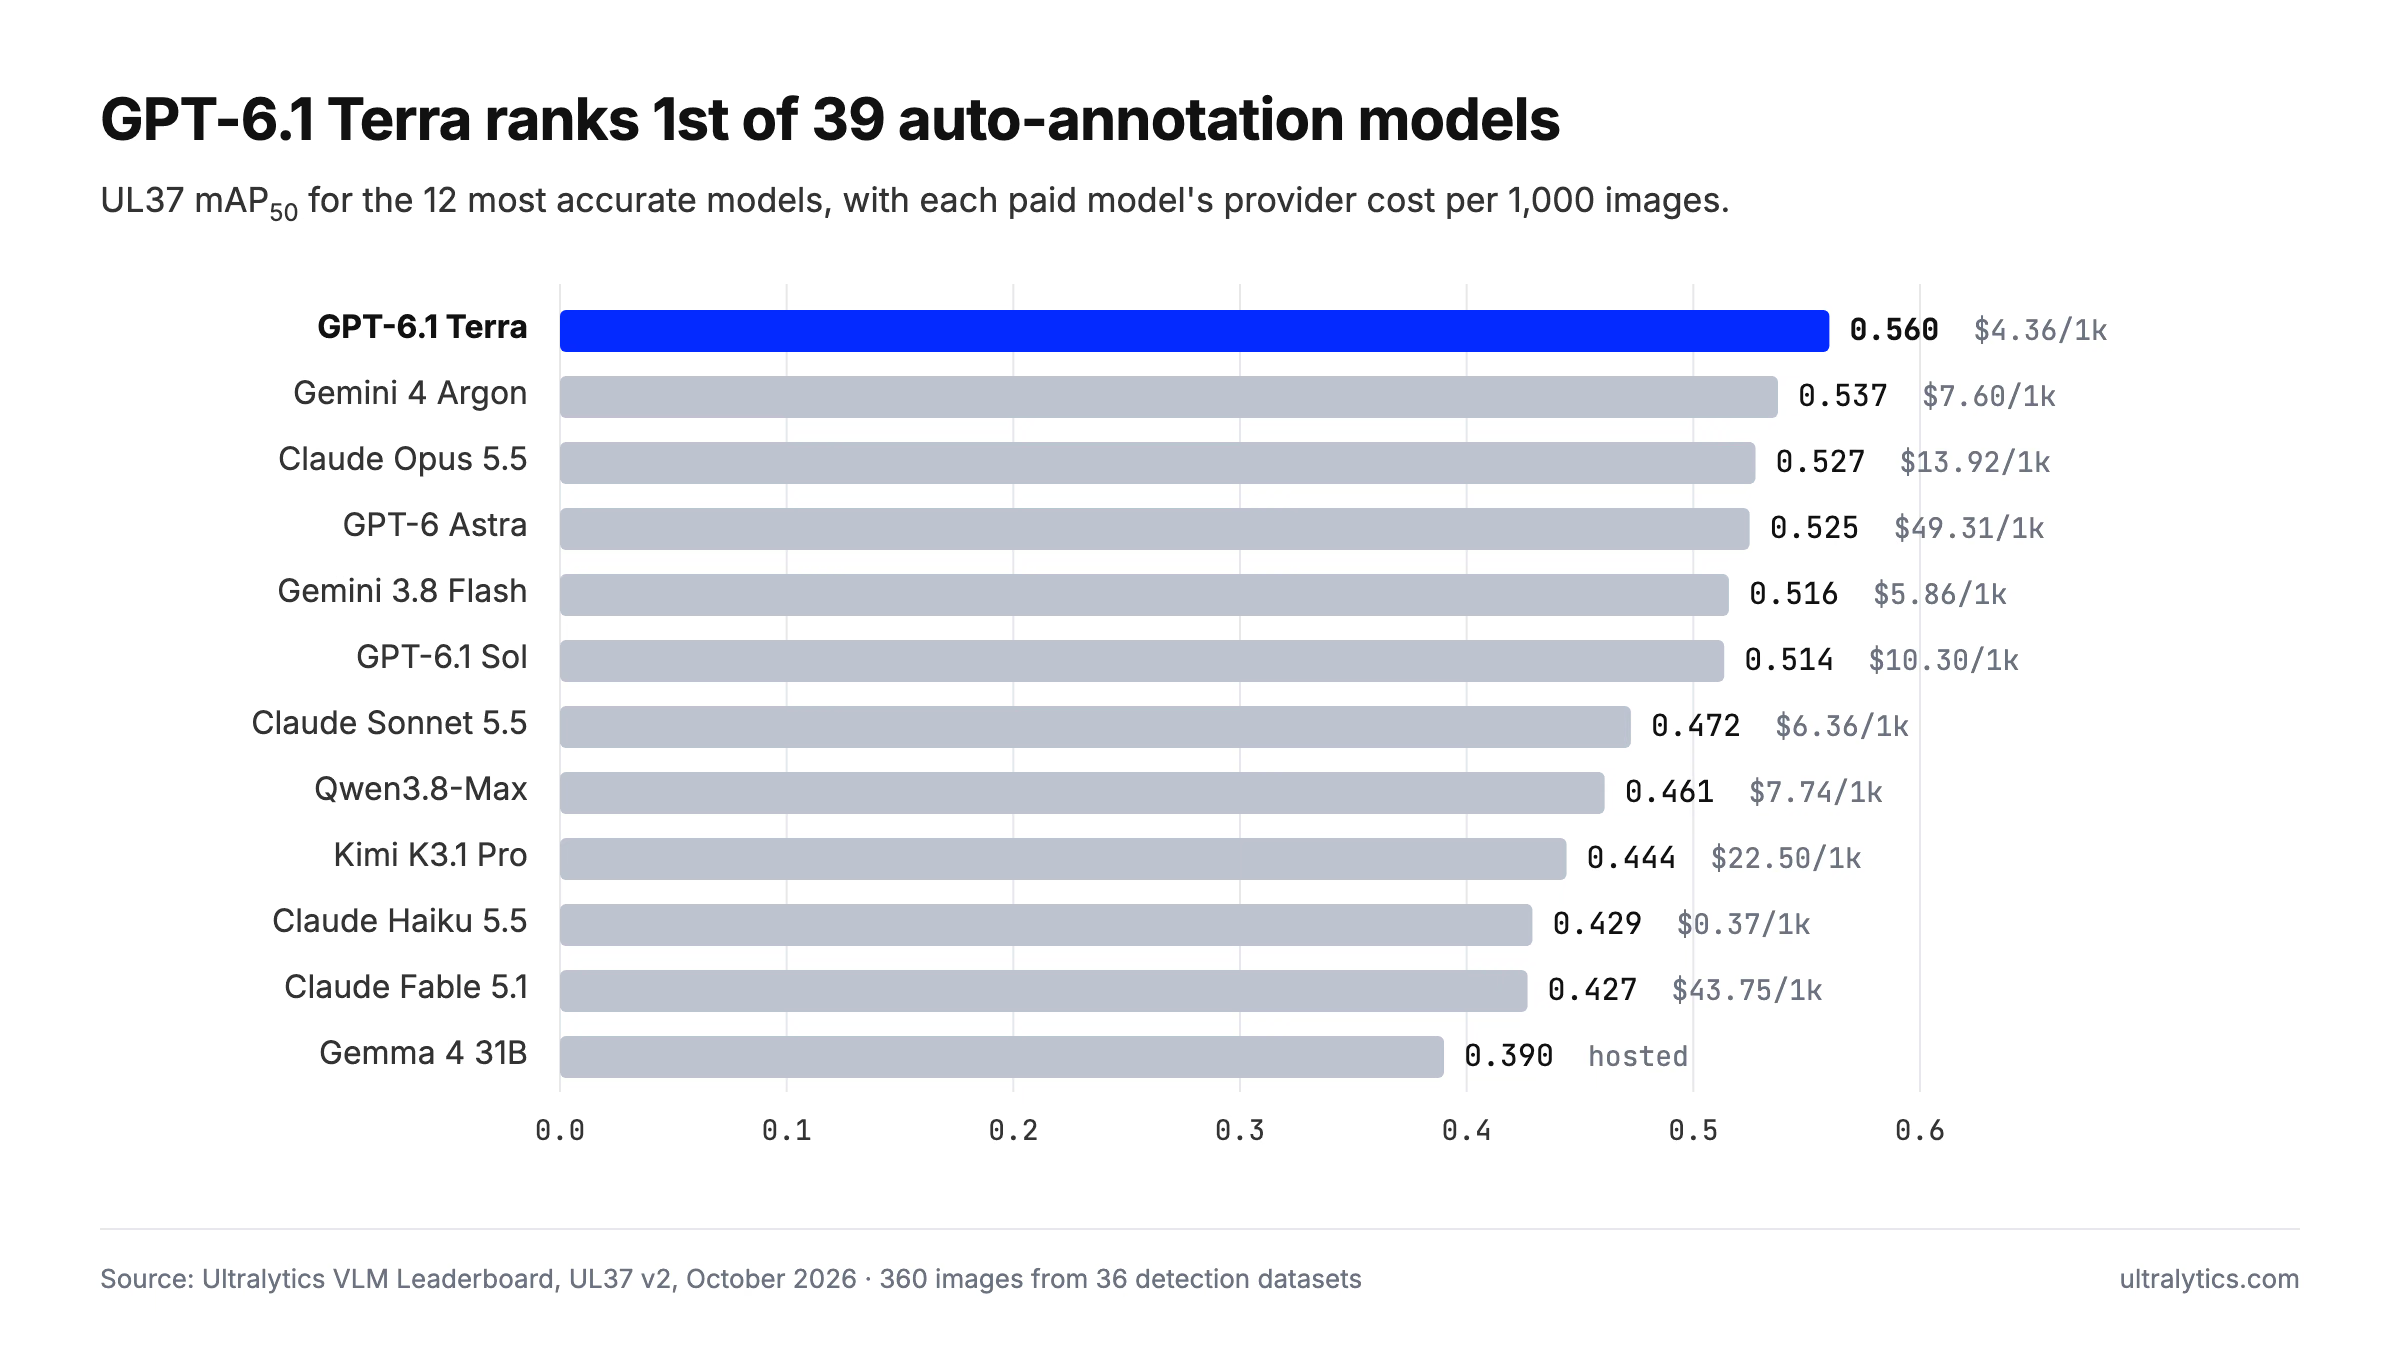
Hinter dem Ergebnis steckte kein Rätsel um die richtige Einstellung. Terra läuft mit OpenAIs standardmäßigem Reasoning-Aufwand, der in der Modelldokumentation als mittel angegeben ist. Das Modell erhält dieselbe Anfrage wie alle anderen OpenAI-Modelle auf der Platform, mit Koordinaten der Begrenzungsrahmen auf einem Raster von 0–1000. Wir haben es eingebunden, und es stand sofort an der Spitze.
Ein mittelpreisiges Modell, das OpenAIs Spitzenmodelle übertrifft#
OpenAI positioniert GPT-6.1 Terra als schnelles, effizientes Mittelklassemodell seines Angebots. Laut Berichten zur Einführung von The Decoder und BleepingComputer ist es der Nachfolger von GPT-5.6 Terra und auf die Computernutzung, visuelle Schlussfolgerungen, Programmierung und alltägliche Arbeit ausgelegt. Das Modell ist über die API unter gpt-6.1-terra sowie in ChatGPT Work und Codex für Plus-, Pro-, Enterprise- und Edu-Nutzer verfügbar. OpenAI beschreibt es in der Dokumentation als „ein schnelles, effizientes Modell für visuelle Schlussfolgerungen, präzise Computernutzung und klare, natürliche Texte“ mit Text- und Bildeingabe sowie einem Kontextfenster von 1.050.000 Tokens.
Der Preis beträgt 1 $ pro Million Eingabe-Tokens und 5 $ pro Million Ausgabe-Tokens; zwischengespeicherte Eingaben kosten 0,05 $. Das ist die Hälfte der 2 $ und 10 $ von GPT-6.1 Sol und ein Zehntel der 10 $ und 50 $ von GPT-6 Astra, laut den OpenAI-Seiten zu GPT-6.1 Sol und GPT-6 Astra.
OpenAIs Einführungsbenchmarks stellen Terra als seinen größeren Geschwistermodellen nahe, nicht als überlegen dar. Beim MMMU-Pro, einem Test visueller Schlussfolgerungen, berichtet OpenAI, dass Terra Astra und Sol fast ebenbürtig ist. Für Terminal-Bench 4.0 werden 50,3 % angegeben, gegenüber 21,5 % bei GPT-5.6 Terra. Für besonders anspruchsvolle Programmieraufgaben empfiehlt OpenAI weiterhin Sol oder Astra.
Auf dem Papier ist Terra der Kompromiss. Bei unserem Benchmark ist es OpenAIs bester Detektor.
| OpenAI-Modell | UL37 mAP50 | Kosten pro 1.000 Bilder | Mediane Zeit pro Bild |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1 s |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra kostet pro Bild weniger als halb so viel wie GPT-6.1 Sol und weniger als ein Zehntel so viel wie GPT-6 Astra. Außerdem antwortet es etwa doppelt so schnell wie beide. Im direkten Vergleich schlägt es Sol bei 22 der 36 Datensätze.
OpenAI zufolge erledigt Terra Aufgaben mehr als dreimal so schnell wie Sol und Astra – eine Aussage zu Arbeitslasten mit Agenten. Annotation ist eine andere Aufgabe. Dabei haben wir einen etwa zweifachen Geschwindigkeitsvorteil gegenüber Sol gemessen, der sich bemerkbar macht, wenn du Tausende Bilder beschriftest.
Terras Vorteil gegenüber Sol liegt bei der Präzision#
Die beiden Modelle finden einen ähnlichen Anteil der beschrifteten Objekte. Terras Trefferquote beträgt 0.613, die von Sol 0.618. Der Unterschied zeigt sich bei der Präzision: 0.646 für Terra gegenüber 0.551 für Sol. Ein deutlich größerer Anteil von Terras Begrenzungsrahmen liegt auf einem echten Objekt und hat die richtige Beschriftung.
SKU110K macht den Unterschied anschaulich. Die Bilder zeigen dicht an dicht mit Produkten gefüllte Supermarktregale, alle unter einer einzigen Klasse. Beide Modelle erreichen dort eine ähnliche Trefferquote: 0.73 für Terra und 0.77 für Sol. Doch Sols Präzision bei diesen Regalen beträgt 0.49, während Terra 0.79 erreicht. Etwa die Hälfte von Sols Begrenzungsrahmen sind Fehlalarme, verglichen mit ungefähr einem von fünf bei Terra. Terras 0.62 mAP50 bei SKU110K ist der höchste bisher von einem Modell erzielte Wert.
Das ist bei der Datenbeschriftung wichtig, weil Fehler unterschiedlich viel Aufwand verursachen. Bei einem übersehenen Produkt musst du einen Begrenzungsrahmen zeichnen. Einen falschen Begrenzungsrahmen musst du zwischen Dutzenden korrekter erkennen und löschen. Weniger Fehlalarme sorgen für einen saubereren ersten Entwurf, den Prüfer überarbeiten können.
Medizinische Bildgebung ist GPT-6.1 Terras herausragende Stärke#
Das auffälligste Muster in Terras Ergebnissen zeigt sich in der Medizin. UL37 umfasst acht medizinische Datensätze, und Terra erzielt über alle hinweg durchschnittlich 0.505 mAP50 – Platz 1 von 39. Die nächstbesten Ergebnisse erreichen Gemini 3.8 Flash mit 0.387 und Gemini 4 Argon mit 0.379. Kein anderes Modell auf der Bestenliste liegt in einem anderen Bereich mit einem größeren Abstand vorn.
Hier siehst du die Ergebnisse für alle acht Datensätze im Vergleich mit dem jeweils besten der anderen 38 Modelle:
| Datensatz | GPT-6.1 Terra | Bestes anderes Modell |
|---|---|---|
| Schilddrüsen-Ultraschall (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| MRT von Hirntumoren (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Mikroskopie von Blutzellen (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Darmspiegelung mit Polypen (Kvasir-SEG) | 0.71 | Sieben Modelle gleichauf, darunter Gemini 4 Argon, 0.81 |
| Röntgenaufnahme des Handgelenks bei Kindern (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Röntgenaufnahme des Brustkorbs, TB (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Netzhautläsionen (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Zahn-Röntgenaufnahme (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Die ersten drei Zeilen tragen das Ergebnis, und dabei geht es um mehr als nur darum, die richtige Stelle zu finden. Bei TN5000 ist jeder Begrenzungsrahmen auch mit der Einstufung des Knotens als gut- oder bösartig versehen – genau die Art von Beurteilung, die eine Ärztin oder ein Arzt bestätigen muss. Gemini 4 Argon erzielt dort 0.29 und GPT-6.1 Sol 0.53. Die Klassen der MRT-Aufnahmen des Gehirns sind Meningeom, Gliom und Hypophysentumor; bei ihnen erreicht Sol 0.52. Bei den Blutzellbildern soll Terra weiße Blutkörperchen, rote Blutkörperchen und Blutplättchen unterscheiden.
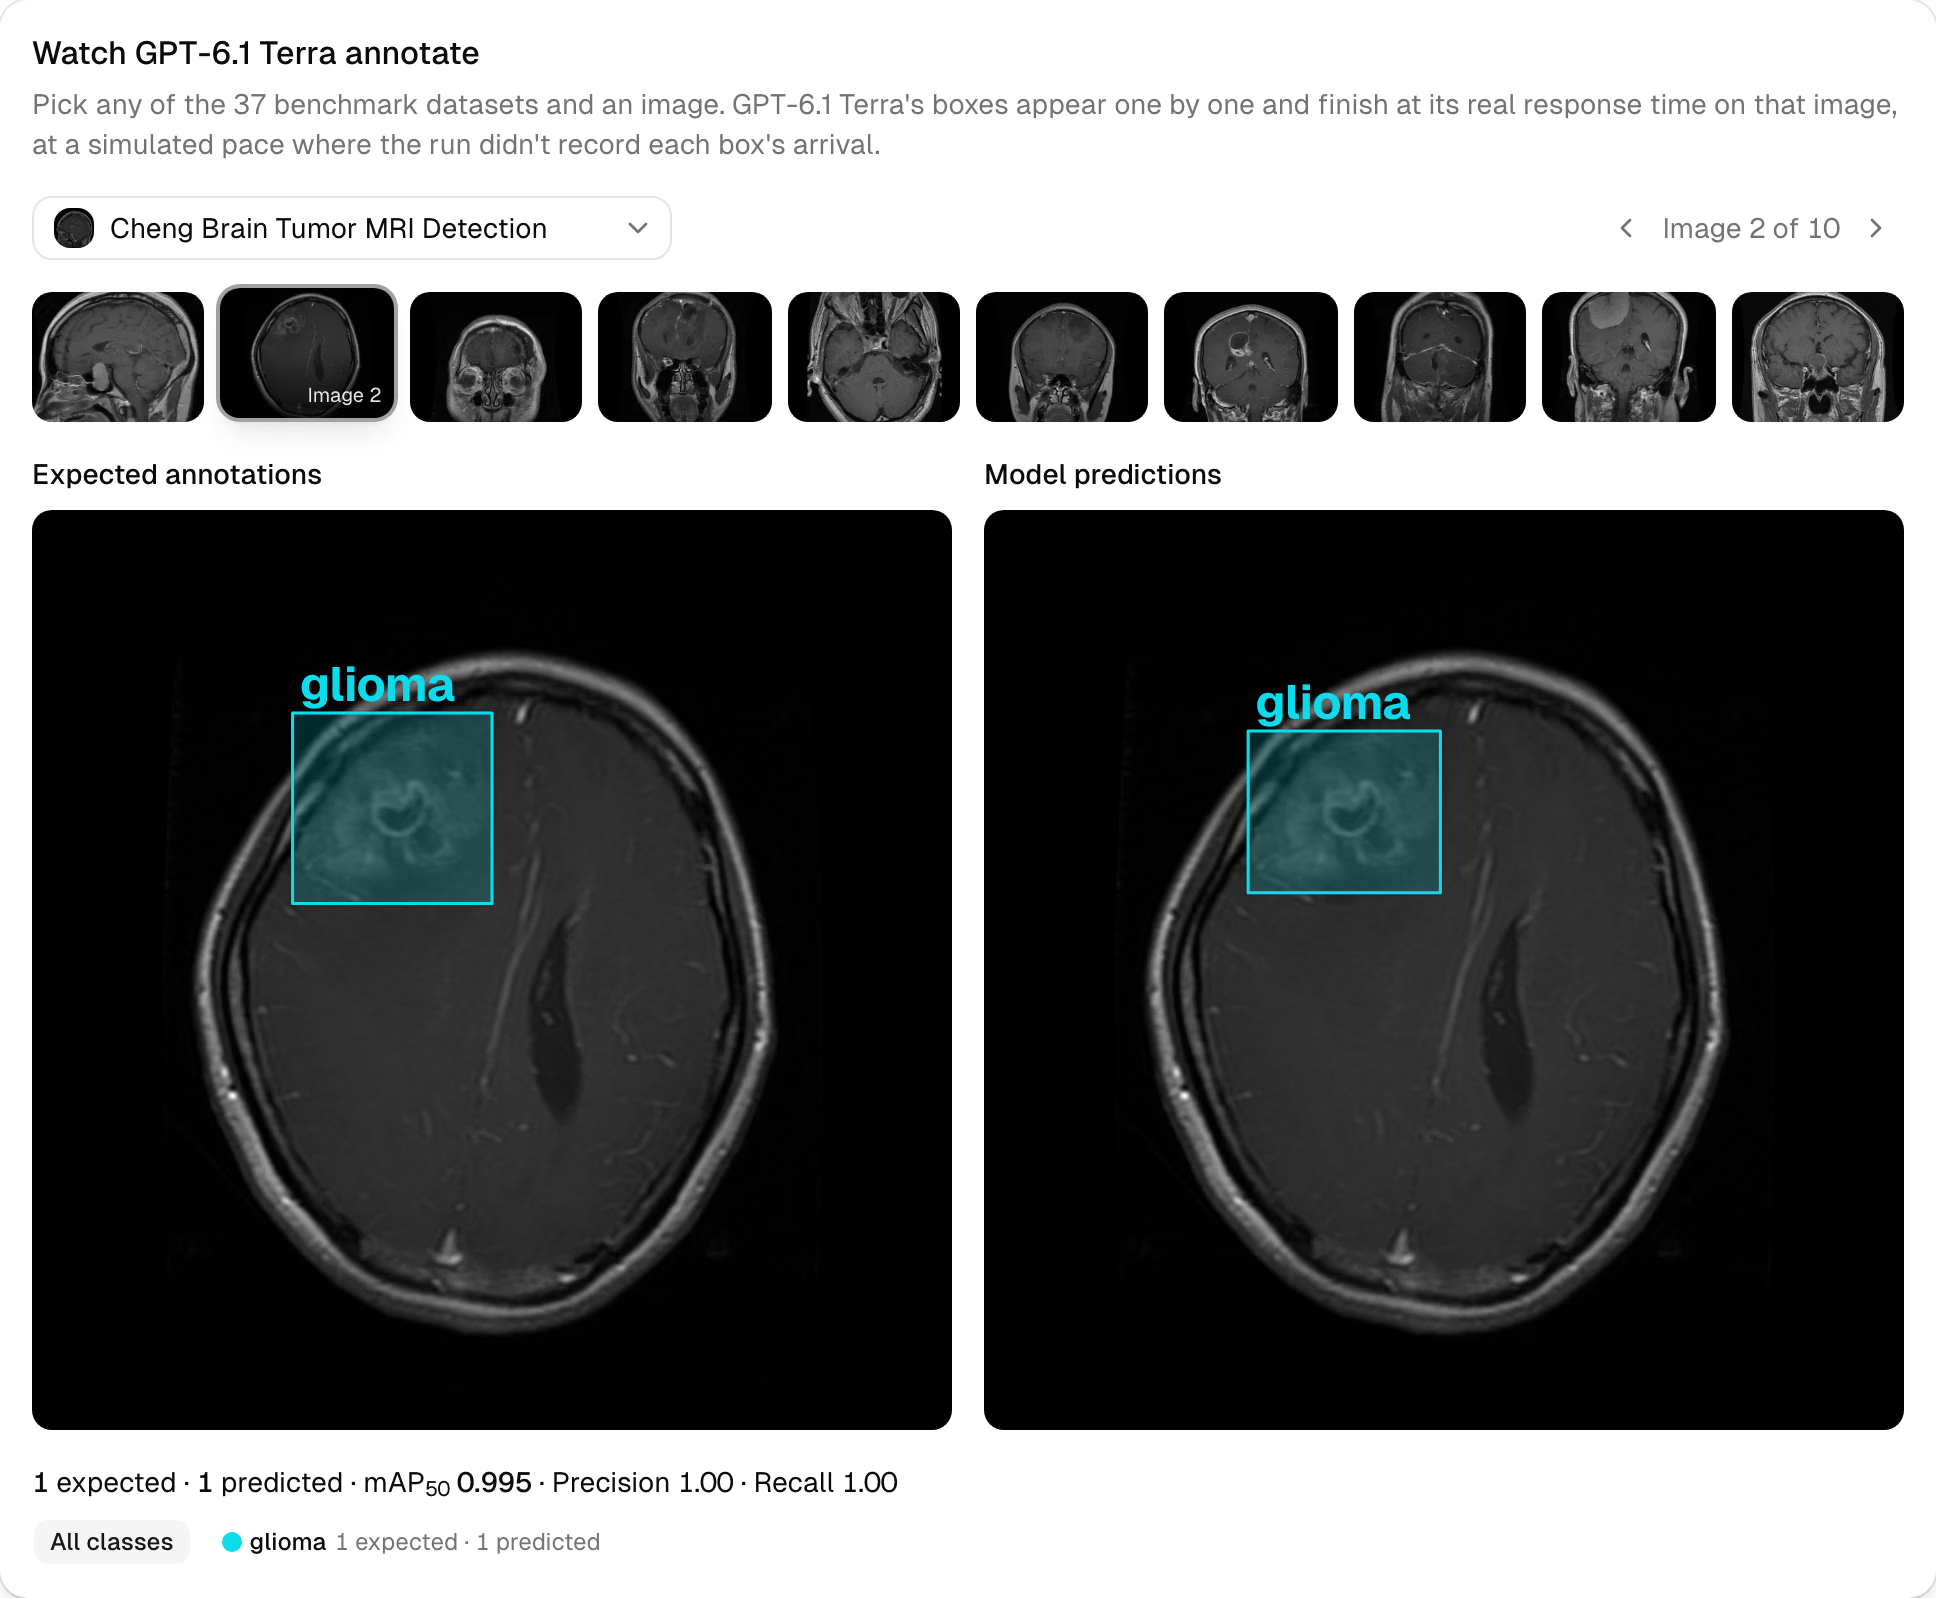
Die Wiedergabe oben von Terras Modellseite zeigt einen typischen Treffer: ein Gliom auf einer MRT-Aufnahme des Gehirns, ein Begrenzungsrahmen von Terra, der passend platziert und beschriftet ist.
Zu diesen Zahlen gehören zwei Vorbehalte. Erstens umfasst jeder Datensatz 10 Bilder. Das Ergebnis eines einzelnen Datensatzes ist also ein Anlass für weitere Untersuchungen, kein abschließendes Urteil. Zweitens handelt es sich hier nicht um Diagnosen. Für ein Team zur Analyse medizinischer Bilder ist Terra eine schnelle Möglichkeit, Begrenzungsrahmen auf Ultraschall-, MRT- und Mikroskopiebildern als Entwurf zu erstellen, die anschließend von klinischen Fachleuten geprüft, korrigiert und freigegeben werden. Diese Überprüfung mit menschlicher Beteiligung ist der Kern des Arbeitsablaufs und kein optionaler Zusatz.
Wo GPT-6.1 Terra Schwächen zeigt: Röntgenbilder und Leiterplatten#
Das Tabellenende zeigt ein klares Muster. Bei jedem Röntgendatensatz in UL37, ob medizinisch oder nicht, schneidet ein anderes Modell besser ab. Terra liegt bei Röntgenaufnahmen von Kinderhandgelenken, Brustkorb und Zähnen hinter dem Spitzenmodell. Bei Sicherheitskontrollen mit Röntgenbildern fällt das Ergebnis noch schlechter aus: 0.00 bei IEDXray, während Gemini 4 Argon 0.30 erreicht.
IEDXray ist der deutlichste Ausreißer. Die Aufnahmen zeigen Laptops, Telefone, Pager, Batterien und improvisierte Geräte. Terra hat bei keiner dieser Aufnahmen einen korrekten Begrenzungsrahmen erzeugt.
Leiterplatten sind der andere blinde Fleck. Bei unseren industriellen PCB-Datensätzen erzielt Terra durchschnittlich 0.13, während GPT-6.1 Sol 0.39 erreicht. Bei DeepPCB, das Defekte auf unbestückten Leiterplatten wie Unterbrechungen, Kurzschlüsse, Ausbrüche und Grate erfasst, erzielt Terra 0.03 gegenüber Sols 0.39. Für Daten zur Leiterplattenprüfung ist Sol die bessere Wahl von OpenAI.
Bevor du einen großen Datensatz aus einem dieser Bereiche beschriftest, öffne die Modellseite von GPT-6.1 Terra. Dort werden Terras aufgezeichnete Begrenzungsrahmen für alle 36 Benchmark-Datensätze und COCO neben den erwarteten Begrenzungsrahmen wiedergegeben. Außerdem wird das jeweilige Ergebnis aufgeführt.
GPT-6.1 Terra im Vergleich zu Gemini 4 Argon: ein engeres Rennen, als die Rangliste vermuten lässt#
Gemini 4 Argon führte die Bestenliste an, bis Terra erschien, und die beiden liegen nah beieinander. Terra erzielt bei 19 Datensätzen ein besseres Ergebnis, Argon bei 16, und bei einem sind sie gleichauf.
Ein großer Teil von Terras Vorsprung von 0.023 geht auf einen einzelnen Datensatz zurück. Beim Schilddrüsen-Ultraschall TN5000 erzielt Terra 0.94 und Argon 0.29. Lässt man diesen Datensatz weg, liegen die Durchschnittswerte mit 0.549 für Terra und 0.544 für Argon praktisch gleichauf. Terras erster Platz ist verdient, beruht aber größtenteils auf der medizinischen Bildgebung.
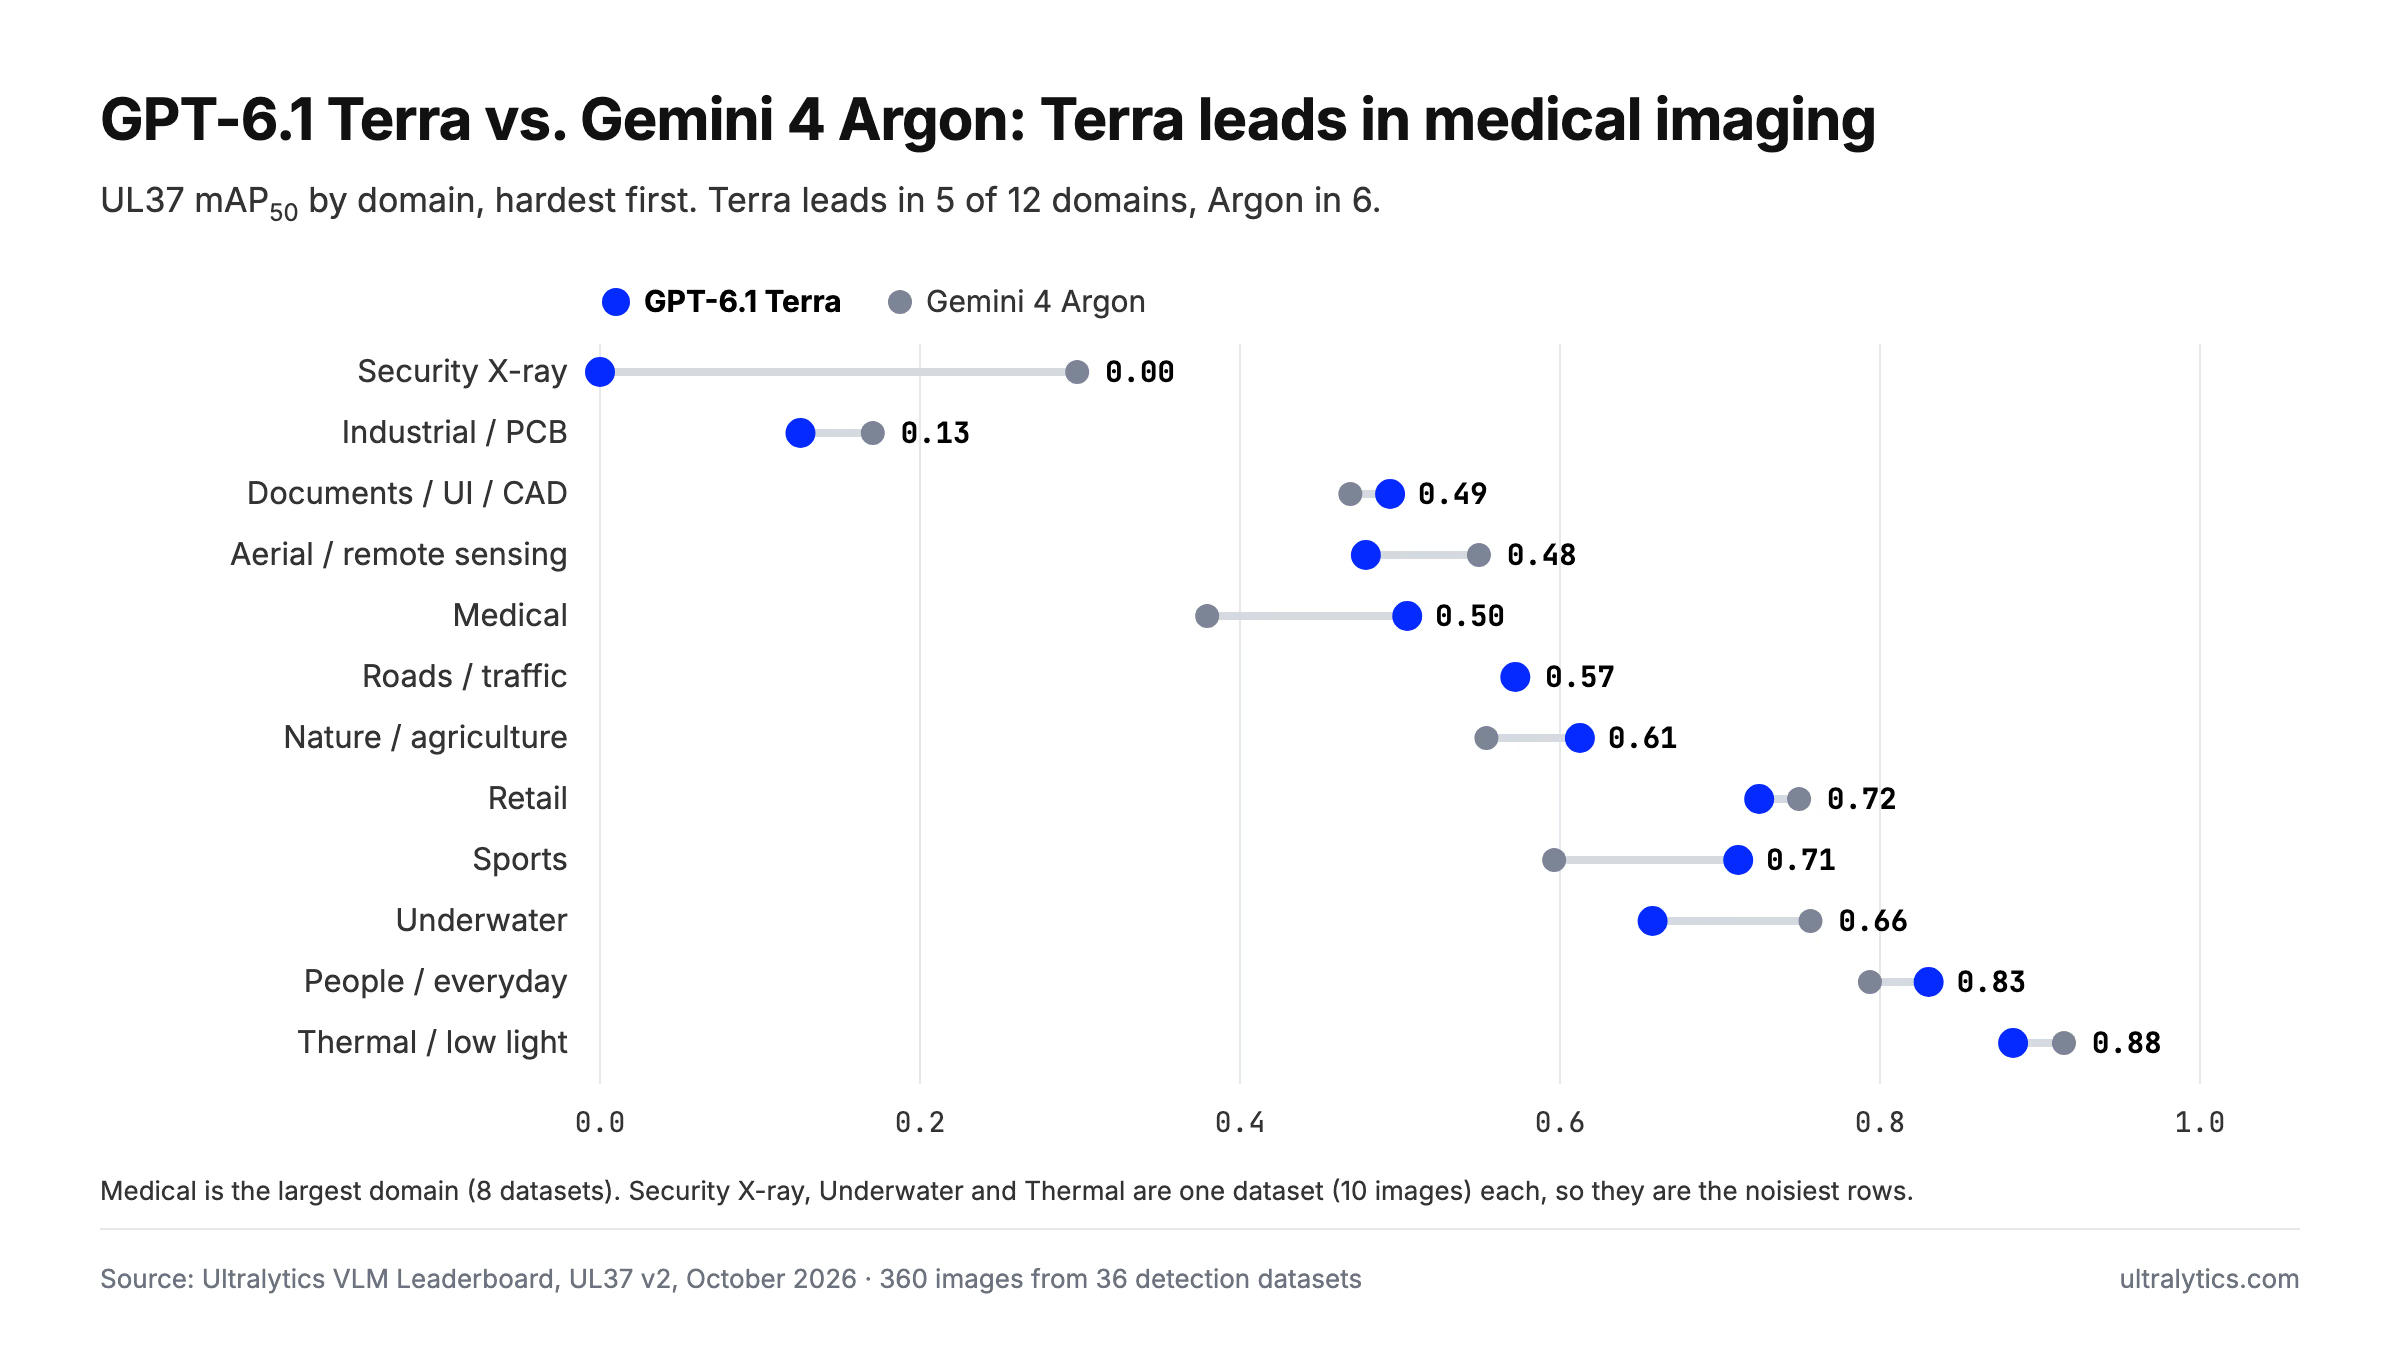
Nach Bereichen liegt Terra in fünf vorn und belegt in zwei davon Platz 1 unter allen 39 Modellen: Medizin sowie Dokumente, Benutzeroberflächen und CAD. Argon führt in sechs Bereichen und hält weiterhin die Spitzenposition bei Luftbildern, Unterwasser- und Wärmebildern. Bei Straßen und Verkehr sind beide gleichauf.
Auch die Fehlerarten unterscheiden sich. Argon ist mit 0.667 gegenüber 0.646 etwas präziser, während Terra mehr Objekte findet und eine Trefferquote von 0.613 gegenüber 0.585 erreicht. Terra kostet 4,36 $ pro 1.000 Bilder, gegenüber Argons 7,60 $ zum Einführungspreis von Google. Argon ist mit 4,6 s pro Bild etwas schneller.
Die praktische Aufteilung: Greif bei medizinischen Bildern, Dokumenten und Sportbildern zu Terra. Verwende Argon bei Luftbildern, Unterwasser- und Wärmebildern sowie Sicherheitsaufnahmen. Unsere Ergebnisse zur automatischen Annotation mit Gemini 4 Argon behandeln die andere Seite des Vergleichs.
Was ein Verarbeitungslauf mit GPT-6.1 Terra kostet#
Die 4,36 $ pro 1.000 Bilder sind die Kosten beim Anbieter, berechnet anhand des von OpenAI angegebenen Tokenverbrauchs zu Listenpreisen. Ein Bild benötigte im Median etwa 1.300 Eingabe-Tokens und 370 Ausgabe-Tokens. Für Batch Annotation kommt eine Platform-Verarbeitungsgebühr von 1,00 $ pro 1.000 Bilder hinzu. Ein Lauf mit 1.000 Bildern kostet somit insgesamt etwa 5,36 $.
Drei weitere Details aus dem Testlauf:
- Keine fehlgeschlagenen Aufrufe. Alle Benchmark-Aufrufe von Terra wurden innerhalb des 115-Sekunden-Limits der Platform abgeschlossen. Bei GPT-6.1 Sol schlugen 2 Aufrufe und bei GPT-6 Astra 4 fehl.
- Schon die unverarbeiteten Begrenzungsrahmen sind gut. Vor der Verfeinerung mit SAM 3.1 erzielen Terras Begrenzungsrahmen 0.559 mAP50. Durch die Verfeinerung steigt der Wert auf 0.560; das Modell erledigt also fast die gesamte Arbeit selbst.
- Keine Konfiguration nötig. Der standardmäßige Reasoning-Aufwand und die übliche OpenAI-Anfrage reichten aus.
Wenn das Budget wichtiger ist als die letzten Genauigkeitspunkte, gibt es günstigere Möglichkeiten. Claude Haiku 5.5 erzielt 0.429 für 0,37 $ pro 1.000 Bilder und Gemini 3.5 Flash-Lite erzielt 0.380 für 1,77 $. Gehostete Modelle wie Qwen3.8 27B, Gemma 4 26B und SAM 3.1 Text benötigen keinen API-Schlüssel. Das gilt auch für deine eigenen Ultralytics-YOLO-Modelle.
Vom OpenAI-Schlüssel zum beschrifteten Datensatz#
GPT-6.1 Terra ist ein Modell zur Objekterkennung mit Klassenangabe für Datensätze mit 1 bis 200 Klassen. Es liefert Begrenzungsrahmen für die Klassennamen deines Datensatzes, die du vor dem Speichern überprüfst. So richtest du es ein:
- Erstelle auf der Seite OpenAI API keys einen Schlüssel.
- Füge den Schlüssel unter Einstellungen > API-Schlüssel im Platform-Arbeitsbereich hinzu, in dem sich dein Datensatz befindet. OpenAI rechnet direkt mit dir ab; Ultralytics schlägt nichts auf die Tokenkosten auf. Die Dokumentation zu Anbieterschlüsseln enthält weitere Informationen.
- Wechsle im Annotationseditor zum Modus Smart und wähle im Modellauswahlmenü unter OpenAI GPT-6.1 Terra aus.
- Klicke auf Vorhersagen oder
P, um das aktuelle Bild zu beschriften. Probiere zunächst einige Bilder aus, die für deine Daten repräsentativ sind, bevor du den Umfang vergrößerst. - Wenn dir die Ergebnisse gefallen, öffne die Datensatzseite und wähle Weitere Aktionen > Batch Annotation, um alle noch nicht beschrifteten Bilder auf einmal zu bearbeiten. Die Platform speichert zuerst eine Datensatzversion, sodass du Änderungen rückgängig machen kannst.
- Überprüfe die Begrenzungsrahmen, speichere sie und trainiere im selben Arbeitsbereich anhand der Ergebnisse ein Ultralytics YOLO26-Modell. Die Trainingsdokumentation führt dich durch den Ablauf.
Wenn du einen umfassenderen Überblick darüber möchtest, wie diese Modelle in den Editor passen, lies wie die Ultralytics Platform KI zur Automatisierung von Annotationen einsetzt und unsere Einführung in Vision-Language-Modelle.
Für wen sich der Wechsel zu GPT-6.1 Terra lohnt#
Verwende GPT-6.1 Terra als dein standardmäßiges kostenpflichtiges Modell für die allgemeine Beschriftung bei der Objekterkennung. Es ist das genaueste von uns getestete Modell, das günstigste der sechs Spitzenmodelle und hat bei unserem Testlauf keinen einzigen Aufruf fehlschlagen lassen.
Als erste Beschriftung ist es besonders stark bei Ultraschall-, MRT- und Mikroskopiebildern, die anschließend von Fachleuten geprüft werden, sowie bei dicht bestückten Verkaufsregalen, in denen sich falsche Begrenzungsrahmen schnell häufen. Für Röntgenbilder aller Art und Leiterplattendefekte solltest du andere Modelle wählen: Gemini 4 Argon, GPT-6 Astra oder GPT-6.1 Sol schneiden dort besser ab.
Wenn du derzeit Sol oder Astra nur für die Bildbeschriftung bezahlst, ist der Wechsel einfach: Terra liefert bessere Begrenzungsrahmen und kostet weniger als halb so viel wie Sol.
Häufig gestellte Fragen
Ja. Bei unserem UL37-Benchmark erzielt GPT-6.1 Terra über 36 reale Detektionsdatensätze hinweg durchschnittlich 0.560 mAP50 und liegt damit unter den 39 Modellen auf der Ultralytics VLM-Bestenliste an erster Stelle. Auch bei der strengeren Kennzahl mAP50-95 belegt es mit 0.345 Platz 1. Am schwächsten ist das Modell bei Röntgenbildern und Leiterplattendefekten.
Bei unserem Benchmark: ja. Terra erzielt 0.560 mAP50 gegenüber Sols 0.514, gewinnt bei 22 von 36 Datensätzen und kostet 4,36 $ gegenüber 10,30 $ pro 1.000 Bilder. Zudem läuft es etwa doppelt so schnell. Für die Erkennung von Leiterplattendefekten bleibt Sol die bessere OpenAI-Option.
Terra liegt mit 0.560 gegenüber 0.537 mAP50 vorn und kostet weniger pro Bild, aber das Rennen ist knapp: Terra gewinnt bei 19 Datensätzen, Argon bei 16, und bei einem sind beide gleichauf. Ohne den Datensatz TN5000 zum Schilddrüsen-Ultraschall liegen die beiden fast gleichauf. Wähle Terra für medizinische Bilder und Dokumente, Argon für Luftbilder, Unterwasser- und Wärmebilder sowie Sicherheits-Röntgenbilder.
Etwa 4,36 $ an Gebühren für OpenAI, basierend auf dem vom Anbieter gemeldeten Tokenverbrauch und den Listenpreisen von 1 $ pro Million Eingabetoken und 5 $ pro Million Ausgabetoken. Die Stapelannotation in der Ultralytics Platform verursacht eine Bearbeitungsgebühr von 1,00 $ pro 1.000 Bilder. Du bezahlst OpenAI direkt mit deinem eigenen API-Schlüssel.
Es ist das leistungsstärkste Modell auf unseren acht medizinischen Datensätzen und erreicht durchschnittlich 0,505 mAP50. Die besten Ergebnisse erzielt es bei Schilddrüsenultraschall, Gehirntumor-MRT und der Mikroskopie von Blutzellen. Bei Röntgenaufnahmen ist es deutlich schwächer und bei der Darmspiegelung zur Erkennung von Darmpolypen weniger leistungsfähig. Nutze es, um Begrenzungsrahmen zur Prüfung durch Fachleute zu erstellen, niemals als Diagnosewerkzeug.
Nein. Die Platform ruft das Modell mit OpenAIs standardmäßigem Reasoning-Aufwand „mittel“ und derselben Aufforderung zur Erstellung von Begrenzungsrahmen auf, die sie für jedes OpenAI-Modell verwendet. Anschließend verfeinert SAM 3.1 jeden Begrenzungsrahmen. Die mediane Anfrage in unserem Benchmark dauerte 5,1 Sekunden, und keine Anfrage schlug fehl.









