Jetson Orin Nano Super oder Raspberry Pi 5 für die YOLO26-Objekterkennung
YOLO26n-Inferenz: 4,57 ms auf einem Jetson Orin Nano Super (TensorRT FP16) gegenüber 67,03 ms auf einer Pi-5-CPU, in separaten Tests. Entscheide anhand des Modells, der FPS und der Anzahl der Kameras.
 Onuralp Sezer15 Min. Lesezeit
Solltest du die Objekterkennung auf einem Raspberry Pi 5 oder einem NVIDIA Jetson Orin Nano ausführen? Für eine Kamera, eine niedrige angestrebte Bildrate und ein kleines Modell kann die CPU eines Pi 5 ausreichen: In unserem veröffentlichten Benchmark benötigt Ultralytics YOLO26n, exportiert nach NCNN, auf seinen vier Arm-Kernen 67,03 ms Inferenzzeit pro Bild, also etwa 15 Inferenz-FPS. Wenn du mehr Kameras, ein größeres Modell oder mehr Spielraum bei der Bildrate brauchst, als dein Pi bietet, lohnt sich ein Jetson: Auf einem Jetson Orin Nano Super Developer Kit benötigt dasselbe Modell als TensorRT-FP16-Engine 4,57 ms.
Ultralytics veröffentlicht diesen Vergleich und entwickelt YOLO26, das auf beiden Boards läuft; keines der Boards stammt von uns. Unsere Jetson-Werte stammen von einem Orin Nano Super Developer Kit, dem Einstiegs-Entwicklerkit der Orin-Reihe von NVIDIA, und unsere Pi-Werte von einem Raspberry Pi 5; die Tests wurden separat durchgeführt. Viele suchen weiterhin nach „Jetson Nano“, dem ursprünglichen Board von 2019. Darauf läuft YOLO26 über JetPack 4, aber unser Jetson-Leitfaden enthält keine YOLO26-Benchmarks für dieses Board, deshalb wird es hier nur mit technischen Daten aufgeführt.
Im Folgenden erfährst du, wie sich die Boards je nach Modellgröße, angestrebter Bildrate und Anzahl der Kamerastreams vergleichen, warum die FPS bei zusätzlichen Kameras sinken, wie du beide Boards selbst misst und welches zu deinem Projekt passt. Die Einrichtungsschritte findest du im NVIDIA-Jetson-Leitfaden und im Raspberry-Pi-Leitfaden. Unser ausführlicher Leitfaden zur Objekterkennung auf einer Raspberry-Pi-5-CPU behandelt die Pi-Seite.
Der Pi 5 führt YOLO auf seiner CPU aus; der Orin Nano Super bietet eine GPU.#
Die Boards lösen dasselbe Problem mit unterschiedlicher Hardware. Der Raspberry Pi 5 ist ein vielseitiger Computer mit vier Arm-Cortex-A76-Kernen und ohne speziellen KI-Beschleuniger. Deshalb führen unsere Pi-Benchmarks YOLO auf der CPU aus. Das Jetson Orin Nano Super Developer Kit kombiniert ein Orin-Nano-Modul mit Ampere-GPU und einer Trägerplatine. Die TensorRT-Laufzeitumgebung von NVIDIA kompiliert Modelle für diese GPU. Es ist eine Edge-KI-Plattform, die für solche Arbeitslasten ausgelegt ist.
| Jetson Nano 4GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Rechenleistung für YOLO | Maxwell-GPU mit 128 Kernen | Ampere-GPU mit 1024 Kernen und 32 Tensor Cores | Arm-Cortex-A76-CPU mit 4 Kernen |
| CPU | Cortex-A57 mit 4 Kernen, 1,43 GHz | Cortex-A78AE mit 6 Kernen, bis zu 1,7 GHz | Cortex-A76 mit 4 Kernen, bis zu 2,4 GHz |
| Arbeitsspeicher | 4 GB LPDDR4, 25,6 GB/s | 8 GB LPDDR5, 102 GB/s | Je nach Modell unterschiedlich |
| KI-Leistung (NVIDIA-Spitzenwert) | 472 GFLOPS | 67 sparse INT8 TOPS | — |
| JetPack / Betriebssystem | Nur JetPack 4 | JetPack 5 bis 7 | Raspberry Pi OS |
| Ultralytics-Bereitstellungspfad | TensorRT, einschließlich DeepStream | TensorRT (schnellstes Ergebnis in unserem Benchmark) | NCNN (schnellstes Ergebnis in unserem Benchmark) |
Technische Daten, keine Messwerte; geprüft am 19. November 2026. NVIDIA verwendet für die Spitzenwerte unterschiedliche Zahlenformate, daher sind sie nicht direkt vergleichbar. Die 67 TOPS des Orin Nano Super sind ein sparse-INT8-Wert; NVIDIA gibt für dense 33 TOPS an. Die Jetson-Werte stammen aus den Vergleichs- und JetPack-Tabellen im NVIDIA-Jetson-Leitfaden und im DeepStream-Leitfaden; die Pi-5-Werte stammen aus der Raspberry-Pi-Dokumentation.
Auch der Stromverbrauch spielt bei der Entscheidung eine Rolle. NVIDIA gibt für das Orin Nano Super Developer Kit 7 W bis 25 W an. Wird das Board mit einer Super-fähigen Konfiguration geflasht, bietet das Orin Nano 8GB die Leistungsmodi 15 W, 25 W und MAXN SUPER; mit der Standardkonfiguration bleiben die ursprünglichen Modi mit 7 W und 15 W erhalten. Miss unabhängig von deiner Boardwahl den Verbrauch des gesamten Systems mit angeschlossenen Kameras, denn diesen muss dein Netzteil samt Gehäuse bewältigen.
Kalkuliere die Kosten für den gesamten Aufbau, nicht nur für das Board: Speicher, Stromversorgung, Kühlung und Kameras schlagen bei beiden zu Buche. Raspberry Pi hat die Preise des Pi 5 2026 aufgrund gestiegener Speicherkosten mehrmals erhöht. Im November 2026 kostet der Pi 5 mit 2 GB laut Preisliste 77,50 $ und das Board mit 16 GB 385 $. Aktuelle Jetson-Preise und Verfügbarkeit findest du auf der NVIDIA-Seite für Entwicklerkits. Berücksichtige auch die Kosten für jeden Beschleuniger, den ein Pi benötigt, etwa den Raspberry Pi AI HAT+. Für die Produktion verkauft NVIDIA Jetson-Module für deine eigene Trägerplatine; das von uns getestete Entwicklerkit ist für Entwicklung und Prototyping vorgesehen.
Eine Pi-5-CPU eignet sich für YOLO26n-Arbeitslasten mit niedrigen FPS.#
Der Pi 5 bewältigt Erkennung mit einer einzelnen Kamera ohne zusätzliche Hardware, wenn du nur eine moderate Bildrate benötigst. Im Ultralytics-Benchmark (FP32-Export, Eingabe mit 640 Pixeln, COCO128, Ultralytics 8.4.108, nur Inferenz) war NCNN das schnellste Exportformat: 67,03 ms pro Bild für YOLO26n bei 0,4784 mAP50-95. Das entspricht etwa 15 Inferenz-FPS und kann für eine Zählstation, eine Regalkamera oder einen Robotik-Prototyp ausreichen, bei dem schnelle Bewegungen keine Rolle spielen. Überprüfe die gesamte Kamerapipeline, nicht nur die Inferenz. Arm veröffentlicht außerdem eine Open-Source-Laufzeitumgebung für YOLO26n auf dem Pi 5, die laut eigenen Messungen schneller als NCNN ist. In unserem Leitfaden zum Raspberry Pi 5 werden die beiden verglichen.
Bei größeren Modellen stößt der Pi an seine Grenzen. Das größere YOLO26s benötigt mit NCNN auf dem Pi 5 172,88 ms und bleibt damit unter 6 Inferenz-FPS. Der Multi-Format-Vergleich im Raspberry-Pi-Leitfaden (Ultralytics 8.4.108) umfasst nur n und s. Der ältere ONNX-Vergleich (Ultralytics 8.4.14) enthält außerdem m, l und x; dort benötigt YOLO26m 993,78 ms. Wenn kleine Objekte oder schwer unterscheidbare Klassen ein größeres Modell oder eine höhere Eingabegröße erfordern, teste dieses Modell auf dem Board, bevor du dich festlegst.
Einen AI HAT+ zum Pi 5 hinzufügen#
Eine dritte Möglichkeit ist ein Pi 5 mit dem AI HAT+ von Raspberry Pi, das einen Hailo-Beschleuniger mit 13 TOPS oder 26 TOPS hinzufügt. Im Ultralytics-Benchmark zur Hailo-Integration (Ultralytics 8.4.174, COCO128) benötigt YOLO26n, exportiert für die Hailo-8-Version mit 26 TOPS, 21,7 ms pro Bild bei 0,455 mAP50-95. Das nicht exportierte PyTorch-Modell benötigt auf demselben Pi 364,6 ms. Bei diesem Test wird die Eingabegröße nicht angegeben und INT8 verwendet. Betrachte ihn daher als separaten Benchmark und nicht als Zeile im folgenden Vergleich. Hailo-Modelle müssen kompiliert werden. Überprüfe nach dem Export also die Genauigkeit anhand deiner eigenen Bilder.
Auf dem Orin Nano Super benötigen YOLO26n bis YOLO26l weniger als 18 ms.#
Auf einem Jetson werden größere Modelle praxistauglich. Die Ultralytics-Benchmarks auf dem Orin Nano Super Developer Kit (Eingabe mit 640 Pixeln, COCO128, Ultralytics 8.4.33, nur Inferenz) zeigen, dass alle Modellgrößen von n bis l als TensorRT-FP16-Engine weniger als 18 ms Inferenzzeit pro Bild benötigen:
| YOLO26-Modell | Raspberry Pi 5 CPU (ms/Bild) | Orin Nano Super, TensorRT FP16 (ms/Bild) | Orin Nano Super mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67,03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172,88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993,78 (älterer ONNX-Test, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259,46 (älterer ONNX-Test, 8.4.14) | 17.42 | 0.6225 |
Veröffentlichte Ergebnisse aus separaten Tests. Orin Nano Super: Ultralytics 8.4.33. Alle Zeilen verwenden eine Eingabe mit 640 Pixeln und messen nur die Inferenzzeit, ohne Vor- und Nachverarbeitung.
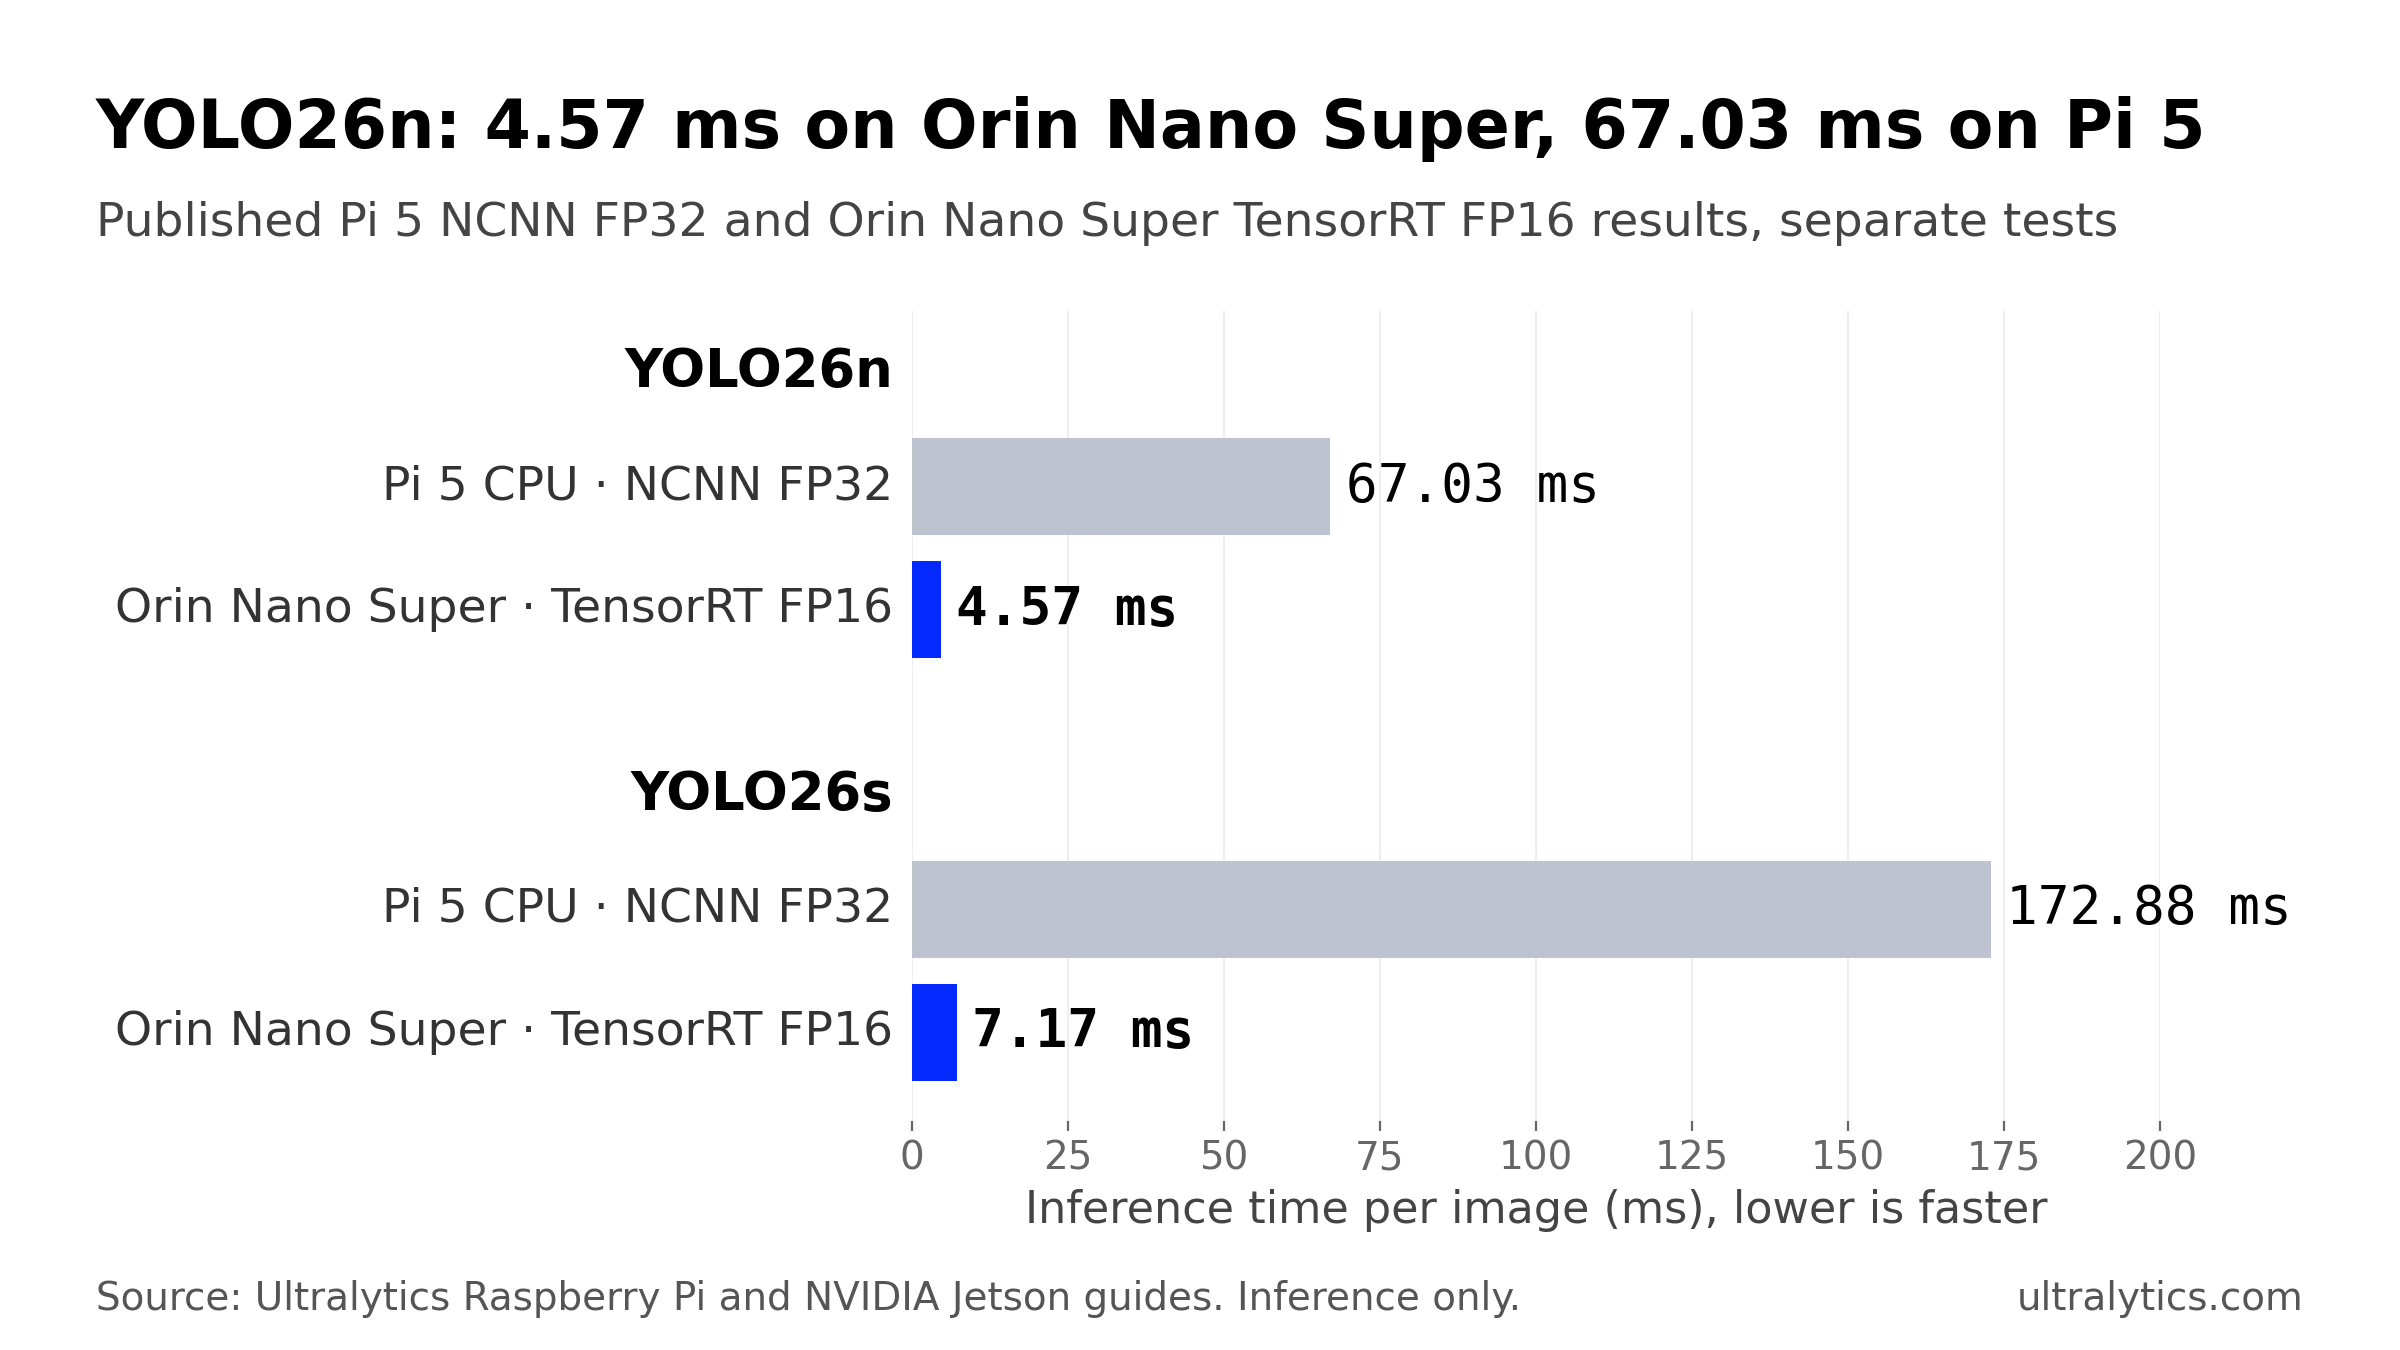
Veröffentlichte NCNN-FP32- und TensorRT-FP16-Ergebnisse aus separaten Tests: Raspberry Pi 5 mit Ultralytics 8.4.108, Orin Nano Super Developer Kit mit Ultralytics 8.4.33. Nur Inferenz, ohne Vor- und Nachverarbeitung. Quelle: die Ultralytics-Leitfäden zu Raspberry Pi und NVIDIA Jetson.
Für YOLO26n bedeutet das etwa 93 % weniger Inferenzzeit als auf der Pi-5-CPU. Ein Teil des Unterschieds geht auf die Genauigkeit zurück. Vergleiche daher auch die FP32-Exporte: Die FP32-TensorRT-Engine des Orin Nano Super benötigt 7,53 ms und ist damit immer noch fast neunmal schneller als der FP32-NCNN-Export des Pi, auch wenn sich Laufzeitumgebungen und Testversionen unterscheiden. Besonders deutlich ist der Unterschied bei YOLO26m: 0,6225 mAP50-95 bei 13,59 ms – ein Modell, das die Pi-5-CPU im älteren ONNX-Test mit etwa einem Bild pro Sekunde ausführte.
INT8 spart noch etwas Zeit. YOLO26n benötigt als INT8-Engine 3,80 ms, aber sein mAP50-95 fällt auf COCO128 von 0,4800 auf 0,4490. Starte daher mit FP16 und wechsle nur dann zur INT8-Quantisierung, wenn FP16 dein Zeitbudget überschreitet und du mit Bildern deiner eigenen Kameras kalibrieren kannst. Unsere Academy-Lektion zur Optimierung mit TensorRT führt dich durch diese Entscheidung.
Bei zusätzlichen Kameras sinken die FPS, weil sich alle Streams dasselbe Leistungsbudget teilen.#
Ein häufiges Muster beim Ausbau: Eine Kamera läuft reibungslos, doch mit einer dritten oder vierten sinkt die verarbeitete Bildrate. Für jedes Bild fallen Kosten für Dekodierung, Vorverarbeitung, Inferenz und Nachverarbeitung an; alle Kameras greifen auf dieselben Rechenressourcen zu. Auf einem Pi 5 dekodieren dieselben vier CPU-Kerne das Video und führen das Modell aus. Jeder zusätzliche Stream beansprucht daher Zeit für beides.
Ultralytics übernimmt die nötige Infrastruktur. Trage in eine .streams-Datei pro Zeile eine Quelle ein und übergib sie an den Predict-Modus: Jeder Stream erhält einen eigenen Lesethread, und der Lader fasst das jeweils neueste Bild jeder Kamera zu einem Batch zusammen. Eine langsame oder ausgefallene Quelle kann dadurch den gesamten Batch aufhalten. Backends, die Batches unterstützen, verarbeiten sie in einem einzigen Vorwärtsdurchlauf; NCNN verarbeitet die Bilder nacheinander, und bei einer TensorRT-Engine mit fester Form wird der Batch auf die exportierte Größe aufgeteilt oder aufgefüllt. Standardmäßig überspringt ein langsames Modell (stream_buffer=False) veraltete Bilder, statt sie in eine Warteschlange zu stellen. So bleibt der Rückstand in deiner Anwendung gering, auch wenn Pufferung in Kamera, Decoder oder Netzwerk weiterhin Latenz verursachen kann.
Die Latenz eines einzelnen Bildes ist ein Ausgangspunkt, aber keine Angabe zur möglichen Kamerazahl. Batching verändert den Durchsatz; auch Dekodierung, Tracking und Zeichnen verursachen zusätzliche Kosten. Die Lektion zur Inferenz mit mehreren Streams der Ultralytics Academy erläutert die Auslegungsregel: Die Anzahl der Streams pro Gerät entspricht ungefähr dem anhaltenden Durchsatz bei deiner tatsächlichen Batchgröße, geteilt durch die benötigten FPS pro Stream, mit 20 bis 30 % Reserve für Spitzenlasten. Miss diesen Durchsatz wie im Praxisteil weiter unten auf dem Board mit angeschlossenen Kameras. Für Pipelines mit mehreren Kameras verarbeitet DeepStream auf Jetson mehrere Quellen in einer einzigen Kachelansicht-Anwendung mit einer TensorRT-Engine.
Wähle anhand der gemessenen FPS pro Kamera, der Modellgröße und der Genauigkeit.#
Beginne mit dem günstigsten Board, das funktionieren könnte, miss die Leistung mit deinen eigenen Kameras und wechsle nur dann zu einem leistungsfähigeren Board, wenn das erste nicht ausreicht:
| Wenn deine Messungen Folgendes zeigen … | Beginne mit |
|---|---|
| YOLO26n erreicht dein Genauigkeitsziel und die erforderlichen FPS pro Kamera. | Eine Pi-5-CPU mit NCNN. Bei einer niedrigen FPS-Anforderung kann das für mehrere Kameras ausreichen. |
| Der Pi schafft die erforderliche Bildrate nicht, du möchtest aber bei ihm bleiben. | Ein Pi 5 mit einem Beschleuniger wie dem Hailo-8 AI HAT+ oder dem DEEPX DX-M1. Beide führen quantisierte Modelle aus und erfordern einen Kompilierungsschritt. Überprüfe daher die Genauigkeit nach dem Export. |
| Du benötigst ein größeres Modell mit höheren FPS, mehr Streams als der Pi dauerhaft bewältigt oder CPU-Zeit für andere Software. | Ein Jetson Orin Nano Super mit TensorRT; wenn der gemessene Durchsatz nicht ausreicht, kannst du auf den Orin NX oder AGX Orin wechseln. |
Die Bildrate ist zunächst eine betriebliche Anforderung und erst danach eine Benchmark-Zahl. Unser Leitfaden zu FPS in der Computer Vision erklärt, wie du sie anhand der Geschwindigkeit des beobachteten Objekts festlegst. Der Leitfaden zur Auswahl des richtigen Edge-Geräts behandelt auch andere Boards.
Miss beide Boards mit deinen eigenen Kameras.#
Die obigen Werte wurden unter festen Bedingungen gemessen. Deine Werte unterscheiden sich je nach Kühlung, Leistungsmodus, Betriebssystemabbild, Softwareversion und eigenem Modell. Das Ultralytics-Paket verwendet auf beiden Boards dieselbe API, sodass du dieselbe Messung auf jedem Board ausführen kannst. Die folgenden Befehle wurden mit Ultralytics 8.4.215 geprüft.
Schritt 1: Exportformate auf jedem Board vergleichen#
Führe yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 auf dem Board aus. Der Benchmark-Modus gibt Größe, mAP50-95 und Inferenzzeit für jedes vom Board unterstützte Exportformat an. Ergänze quantize=16 oder quantize=8, um FP16 oder INT8 zu messen, sofern das Format dies unterstützt. Wähle auf einem Orin Nano Super Developer Kit, das mit einer Super-fähigen Konfiguration geflasht wurde, zuerst den Leistungsmodus MAXN SUPER aus. Für JetPack 6.2 auf Orin Nano ist das laut NVIDIAs Beitrag zum Super-Modus sudo nvpmodel -m 2. Führe anschließend sudo jetson_clocks aus. Beobachte bei längeren Testläufen die Temperaturen.
Schritt 2: Auf jedem Board das schnellste Format exportieren#
Exportiere auf dem Raspberry Pi 5 nach NCNN, wie in unserem Leitfaden zum Raspberry Pi 5 gezeigt. Erstelle die Engine auf dem Jetson direkt auf dem Gerät, denn TensorRT-Engines sind an die GPU und die TensorRT-Version gebunden, mit der sie erstellt wurden. Eine Engine, die ohne dynamic exportiert wurde, hat eine feste Eingabeform. Du kannst beispielsweise batch auf die Anzahl deiner Kameras setzen und mit einem kleineren imgsz erneut exportieren, wenn du mehr Geschwindigkeit brauchst:
from ultralytics import YOLO

# Nur für Jetson: erfordert eine NVIDIA-GPU. TensorRT-FP16-Engine, 640 Pixel, Batch aus vier Kameras
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # schreibt yolo26n.engine
Schritt 3: Verarbeitete FPS pro Kamera messen#
Trage in cams.streams pro Zeile eine RTSP-URL ein, führe etwa eine Minute lang das Modell des Boards damit aus und vergleiche die verarbeiteten FPS jeder Kamera mit ihrer Bildrate. Der Timer startet nach dem ersten vollständigen Batch, sobald die Streams verbunden und das Modell aufgewärmt ist, und endet mit einem vollständigen Batch:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Damit misst du den Durchsatz der verarbeiteten Ergebnisse für diese Pipeline. Wenn die verarbeiteten FPS einer Kamera bei zusätzlichen Streams deutlich unter ihrer Bildrate liegen, kommt das Board nicht mit. Überprüfe dies anhand expliziter Zähler für verworfene Bilder pro Stream aus dem Producer-Consumer-Beispiel der Multi-Stream-Lektion in der Academy. Ergänze das für deine Anwendung erforderliche Tracking oder Zeichnen und exportiere das Modell anschließend mit einem kleineren imgsz erneut, wechsle zu einem kleineren Modell oder einem schnelleren Exportformat oder rüste die Hardware auf. Führe danach den Test erneut aus.
Wenn du keine Build-Umgebung einrichten möchtest, erstellt der Export-Tab der Ultralytics Platform TensorRT-Engines für Jetson-Zielgeräte, einschließlich des Orin Nano 8GB Super. Die Orin-Konfigurationen werden auf einem AGX Orin erstellt; die Validierung auf dem Orin Nano selbst steht noch aus. Prüfe deshalb, ob die TensorRT- und CUDA-Laufzeitumgebung deines Geräts mit der Engine kompatibel ist, und validiere jede Engine auf dem Zielgerät. Einen Vergleich von ONNX Runtime und TensorRT auf NVIDIA-GPUs findest du unter ONNX vs. TensorRT.
Welches Board solltest du wählen?#
Wähle einen Raspberry Pi 5, wenn YOLO26n dein Genauigkeitsziel erreicht und die auf dem Board gemessenen verarbeiteten FPS alle Kameras abdecken, die du benötigst. Mit etwa 15 Inferenz-FPS eignet sich der Pi für einfache Aufbauten an Ladenkassen, Förderbändern zur Zählung, Wildtier- und Heimkameras sowie frühe Robotik-Prototypen. Füge einen Beschleuniger hinzu, wenn du mehr Bilder benötigst, aber beim Pi bleiben möchtest.
Wähle einen Jetson Orin Nano Super, wenn du ein größeres als ein Nano-Modell mit brauchbarer Bildrate, mehr Streams als der Pi dauerhaft bewältigt oder CPU-Zeit für Tracking, Navigation und den Rest deiner Anwendung brauchst. YOLO26s bis YOLO26l benötigen dort weniger als 18 ms Inferenzzeit pro Bild. Mit diesem Spielraum kannst du zusätzliche Kameras betreiben. Miss die vollständige Anwendung, um das zu überprüfen.
Wo Ultralytics ins Spiel kommt#
Ultralytics stellt keines der beiden Boards her; wir entwickeln die Modelle und Tools, die auf beiden laufen. Dieselben YOLO26-Gewichte lassen sich für NCNN auf dem Pi 5, für Hailo auf einem Pi mit AI HAT+ und für TensorRT auf einem Jetson exportieren. So kannst du mit einem Pi Prototypen erstellen und bei steigender Arbeitslast auf einen Jetson wechseln, ohne das Modell neu zu trainieren. Überprüfe die Genauigkeit nach jedem Export. Die Ultralytics Platform übernimmt die Schritte vor der Bereitstellung: Beschrifte einen Datensatz, trainiere in der Cloud, wenn dein Projekt mehr Rechenleistung fürs Training benötigt, als lokal verfügbar ist, und exportiere das Modell für eines der beiden Boards.
Die Einschränkungen: Unsere veröffentlichten Benchmarks messen nur die Inferenz auf den genannten Testgeräten, nicht auf deinen Kameras, in deinem Gehäuse oder auf deinem Produktionsmodul. Außerdem enthält unser Jetson-Leitfaden keine YOLO26-Ergebnisse für den ursprünglichen Jetson Nano. Ultralytics YOLO ist unter AGPL-3.0 oder einer Ultralytics-Enterprise-Lizenz verfügbar. Informationen dazu, was deine Bereitstellung erfordert, findest du unter Ultralytics-Lizenzierung.
Häufig gestellte Fragen
Pro Bild ist er deutlich schneller. In unseren veröffentlichten Benchmarks aus separaten Tests benötigt YOLO26n als TensorRT-FP16-Engine auf einem Jetson Orin Nano Super Developer Kit 4,57 ms gegenüber 67,03 ms mit NCNN auf einer Raspberry-Pi-5-CPU (Eingabe mit 640 Pixeln, nur Inferenz). YOLO26m benötigt auf dem Jetson 13,59 ms. Ob du diese Leistung brauchst, hängt von deinem Modell, der Anzahl der Kameras und deinem FPS-Ziel ab: Wenn ein Pi 5 diese Anforderungen bei deinen eigenen Messungen erfüllt, ist er die einfachere Lösung.
Nein. Der ursprüngliche Jetson Nano kam 2019 mit einer Maxwell-GPU mit 128 Kernen und 4 GB Arbeitsspeicher auf den Markt und unterstützt nur JetPack 4. Der Jetson Orin Nano ist ein neueres Modul mit einer Ampere-GPU mit 1024 Kernen. Das von uns getestete Orin Nano Super Developer Kit verfügt über 8 GB Arbeitsspeicher und unterstützt JetPack 5 bis 7. Dieser Artikel vergleicht die Leistung des Orin Nano Super, nicht die des ursprünglichen Nano.
Ja. Der Jetson Nano von 2019 unterstützt JetPack 4, Ultralytics stellt ein JetPack-4-Docker-Image bereit, und unser DeepStream-Leitfaden zu YOLO26 mit TensorRT wurde auf einem Jetson Nano 4GB mit JetPack 4.6.4 getestet. Unser Jetson-Leitfaden enthält keinen YOLO26-Benchmark für dieses Gerät, dessen Hardware außerdem deutlich schwächer ist als die des Orin Nano Super.
Alle Streams teilen sich die Rechenleistung des Boards: Jede zusätzliche Kamera benötigt eigene Ressourcen für Dekodierung, Vorverarbeitung, Inferenz und Nachverarbeitung. Bei einer
.streams-Datei fasst Ultralytics die Bilder aller Kameras zu Batches zusammen und überspringt veraltete Bilder, wenn das Modell nicht hinterherkommt. Sobald die gemeinsame Pipeline zum Engpass wird, können daher die verarbeiteten FPS jeder Kamera sinken. Ein schnellerer Export, ein kleineres Modell oderimgszsowie leistungsfähigere Hardware können die FPS erhöhen.Ja. Trainiere das Modell einmal und exportiere anschließend dieselben Gewichte mit
format="ncnn"für den Pi 5 und mitformat="engine"für den Jetson. Erstelle die TensorRT-Engine auf dem Zielgerät oder für das Zielgerät. Überprüfe die Genauigkeit nach jedem Export anhand deiner eigenen Daten.
Verfasst von
Senior Machine-Learning-Engineer · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









