Verwaltete Trainingsplattformen und selbst gehostete GPUs für Computer Vision im Vergleich
Vergleiche verwaltete GPU-Trainingsplattformen, Cloud-ML-Dienste, gemietete GPUs und eigene Hardware für Computer Vision: Kosten, Einrichtung, Amortisationspunkt und passende Einsatzbereiche.
 Miles Deans10 Min. Lesezeit
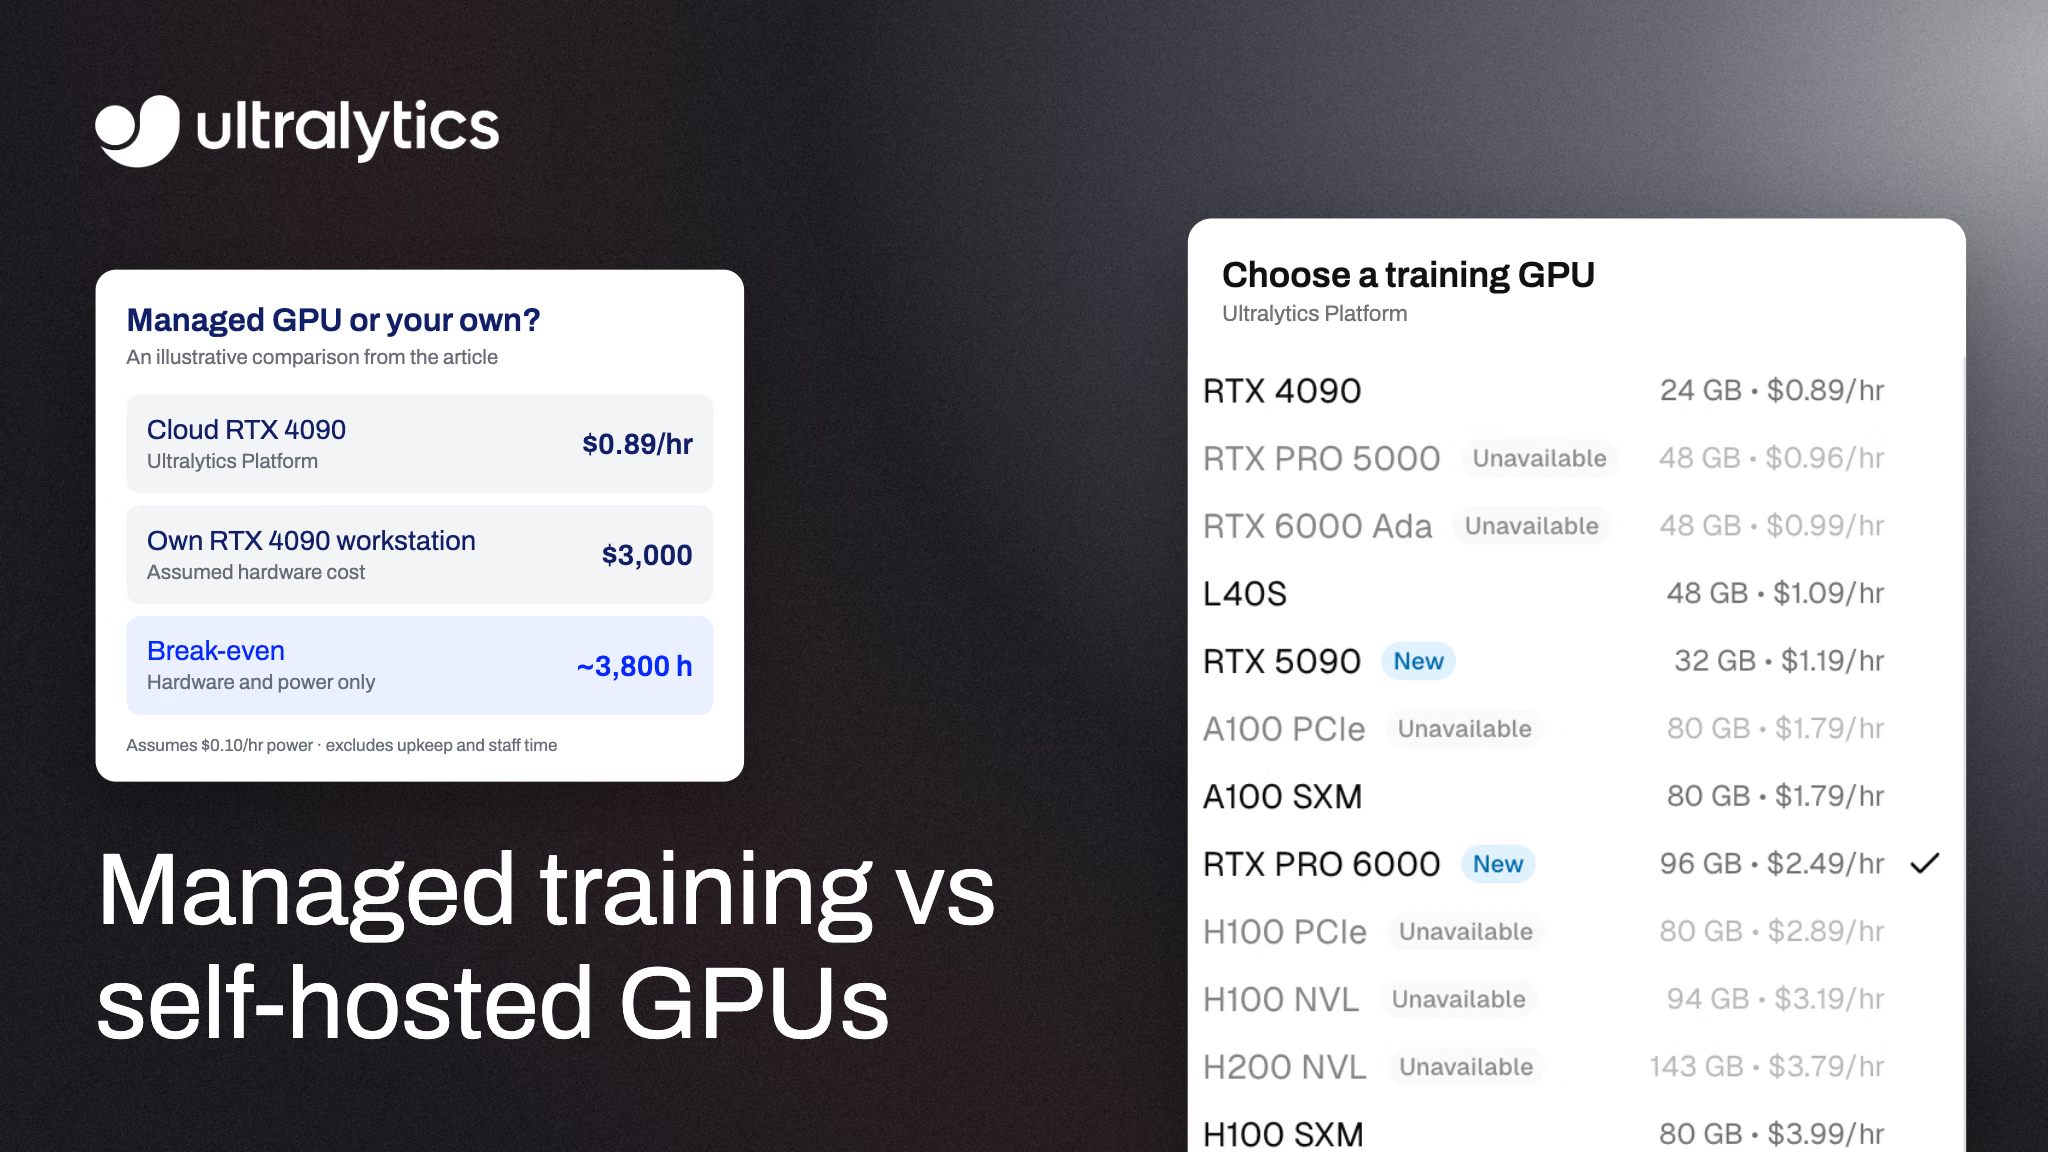
Verwaltete Trainingsplattformen übernehmen die Trainingsinfrastruktur für dich und berechnen die GPU-Nutzungszeit; bei selbst gehosteten GPUs ist dein Team für Hardware und Umgebung verantwortlich – unabhängig davon, ob ihr Rechner mietet oder selbst besitzt. Verwaltetes Training eignet sich meist für sporadische Arbeitslasten und Teams, die weniger Infrastrukturaufwand möchten. Eigene GPUs können bei dauerhafter Auslastung kostengünstiger sein. Das hängt jedoch davon ab, wie intensiv die Hardware genutzt wird, wie lange sie einsatzfähig bleibt und welche Kosten für Strom und Entwicklungszeit anfallen.
Dieser Leitfaden vergleicht vier gängige Optionen für das Training von Bildverarbeitungsmodellen im Jahr 2026, zeigt, wie du den Amortisationspunkt für deine eigene Arbeitslast berechnest, und erklärt, wo die Ultralytics Platform einzuordnen ist.
Die vier Optionen für das Training eines Bildverarbeitungsmodells#
Hinter „verwaltet oder selbst gehostet“ verbergen sich meist vier verschiedene Konfigurationen:
- Eine verwaltete Plattform für Bildverarbeitungstraining. Du lädst einen Datensatz hoch oder bindest ihn an, wählst ein Modell und eine GPU aus, und die Plattform führt das Training aus. Die Ultralytics Platform funktioniert für YOLO-Modelle auf diese Weise.
- Eine universell einsetzbare ML-Plattform. Dienste wie Amazon SageMaker, Google Vertex AI und Azure Machine Learning führen Trainingsaufträge für viele Frameworks auf Cloud-Instanzen aus. Du konfigurierst den Trainingsauftrag, die Umgebung, Berechtigungen und den Speicher. Rechenleistung und zugehörige Dienste werden separat abgerechnet. Vergleiche daher die offiziellen Preisseiten der Anbieter und nicht nur die GPU-Tarife.
- Eine gemietete Cloud-GPU. GPU-Cloud-Anbieter wie RunPod und Lambda vermieten dir einen Rechner nach Nutzungsdauer. Sofern das Abbild des Anbieters nicht bereits alles enthält, was du benötigst, richtest du Treiber, CUDA, Python-Pakete und den Trainingscode ein und beendest die Instanz nach Abschluss.
- Deine eigene GPU. Eine Workstation oder ein Server in deinem Büro oder Rechenzentrum. Du kaufst die Hardware einmalig und zahlst für Strom, Kühlung, Wartung und die Zeit, die für den Betrieb nötig ist.
Verwaltetes Training und selbst gehostete GPUs auf einen Blick#
| Entscheidungsfaktor | Verwaltete Plattform für Bildverarbeitung | Universell einsetzbare ML-Plattform | Gemietete Cloud-GPU | Eigene GPU |
|---|---|---|---|---|
| Hardwarekauf erforderlich | Nein | Nein | Nein | Ja |
| Abrechnung nach | Genutzter GPU-Zeit | Instanzlaufzeit und zugehörigen Diensten | Laufzeit der Instanz | Hardware, Strom, Wartung |
| Einrichtung vor dem ersten Durchlauf | Datensatz, Modell und GPU auswählen | Auftrag, Umgebung, Berechtigungen und Speicher konfigurieren | Umgebung, Code und Abhängigkeiten einrichten oder überprüfen | Hardware, Betriebssystem, Treiber, Pakete |
| Trainingsumgebung | Wird von der Plattform ausgeführt; du legst die Einstellungen fest | Wird gemeinsam vom Dienst und deinem Team verwaltet | Größtenteils dein Team | Dein Team |
| Eine leistungsstärkere GPU erhalten | Eine andere verfügbare GPU auswählen | Einen anderen Instanztyp auswählen | Einen weiteren Rechner mieten | Eine weitere GPU kaufen |
| Speicherort der Daten | Plattformspeicher, angebundener Cloud-Bucket (Pro und Enterprise) oder lokale Daten (Enterprise) | Dein Cloud-Konto | Dort, wohin du die Daten kopierst | Bei dir vor Ort |
| Geeignet, wenn | Schnelles, reproduzierbares Training für Bildverarbeitung | Teams bereits auf die ML-Werkzeuge eines Cloud-Anbieters standardisiert sind | Ingenieure mit der Verwaltung von Rechnern vertraut sind | Regelmäßiges, nahezu durchgängiges Training oder strenge Vorgaben für den Betrieb vor Ort erforderlich sind |
Abrechnung für verwaltetes GPU-Training#
Auf der Ultralytics Platform lassen sich die GPU-Kosten eines Trainingslaufs einfach abschätzen:
GPU cost = selected GPU hourly rate × billable GPU hoursVergleiche bei den Anbietern dieselbe Arbeitslast und Zielgenauigkeit und rechne eventuelle Abonnement-, Speicher-, Datenübertragungs- und Entwicklungskosten hinzu.
Die Ultralytics Platform bietet 26 NVIDIA-GPU-Typen ab 0,24 $/Std. an – ohne Mindestabnahme oder Vertragsbindung. Im Free-Tarif sind 24 davon verfügbar, in Pro und Enterprise alle 26. Einige gängige Optionen:
| GPU | VRAM | Preis pro Stunde |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (empfohlene Standardoption) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (Tarife Pro und Enterprise) | 180 GB | $7.99 |
Die Abrechnung richtet sich nach der tatsächlichen GPU-Nutzungszeit. Für abgeschlossene und abgebrochene Läufe sowie für Läufe, die nach dem Start der GPU fehlschlagen, wird die tatsächlich verstrichene GPU-Zeit berechnet. Ein Fehler vor dem Start der GPU verursacht keine Kosten. Im Trainingsdialog werden Dauer und Kosten vor dem Start geschätzt. Jede Schätzung reserviert mindestens 15 Minuten GPU-Zeit von deinem Guthaben. Diese Reservierung bestimmt das erforderliche Startguthaben; abgerechnet wird die tatsächliche GPU-Nutzungszeit.
Zur Einordnung: Die typischen Trainingszeiten von Ultralytics für 1.000 Bilder und 100 Epochen auf einer RTX PRO 6000 betragen etwa 15 Minuten für YOLO26m und etwa 30 Minuten für YOLO26x. Bei 2,49 $ pro Stunde entspricht das rund 0,62 $ beziehungsweise 1,25 $ GPU-Nutzungsgebühr. Die tatsächlichen Laufzeiten variieren je nach Bildgröße, Augmentierung und Batchgröße. Betrachte diese Angaben daher als Richtwerte, nicht als verbindliche Angebote.
Die tatsächlichen Kosten selbst gehosteter GPUs#
Für eine eigene GPU zahlst du keine stündliche Gebühr, aber sie ist pro Trainingslauf nicht kostenlos. Zu den Gesamtkosten gehören:
- Die Hardware sowie der restliche Aufbau der Workstation oder des Servers.
- Strom und Kühlung für jede Trainingsstunde.
- Entwicklungszeit für Treiber, CUDA-Versionen, Paketkonflikte und fehlerhafte Umgebungen.
- Leerlaufzeit. Wenn eine GPU täglich zwei Stunden trainiert, steht sie den Rest der Zeit still, wodurch ihre Kosten pro Trainingsstunde entsprechend steigen.
- Kapazitätsgrenzen. Wenn ein Modell mehr VRAM benötigt, als dir zur Verfügung steht, oder mehrere Experimente gleichzeitig laufen müssen, wartest du oder kaufst zusätzliche Hardware.
Ein vereinfachter Vergleich von Hardware- und Stromkosten, bei dem die eigene GPU genauso schnell trainiert wie die Cloud-GPU, sieht folgendermaßen aus:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)Zur Veranschaulichung mit angenommenen Zahlen: Angenommen, eine RTX-4090-Workstation kostet dich 3.000 $ und der Strom kostet etwa 0,10 $ pro Trainingsstunde. Bei einem Preis von 0,89 $ pro Stunde für eine RTX 4090 ist der Amortisationspunkt nach etwa 3.800 Trainingsstunden erreicht: nach rund 5,3 Monaten im Dauerbetrieb oder 15,8 Monaten bei acht Stunden täglicher Nutzung. Kühlung, Strom im Leerlauf, Reparaturen, Finanzierung, Wiederverkaufswert und deine eigene Zeit sind dabei nicht berücksichtigt. Die Anschaffung lohnt sich nur, wenn dieses Trainingsvolumen innerhalb der Nutzungsdauer der Hardware erreicht wird. Verwende dein tatsächliches Hardwareangebot, deinen Strompreis und die erwartete Zahl der Trainingsstunden. Je nach Auslastung kann das Ergebnis stark variieren.
Wann sich selbst gehostete GPUs eignen#
Eigene Hardware ist besser geeignet, wenn:
- Deine GPUs stark ausgelastet sind. Kontinuierliches erneutes Training, umfangreiche Hyperparametersuchen oder ein Team, das sich den ganzen Tag einen Rechner teilt, steigern die Auslastung in Richtung des Amortisationspunkts.
- Daten deinen Standort nicht verlassen dürfen. In manchen regulierten oder vom Netz getrennten Umgebungen ist Cloud-Training vollständig ausgeschlossen.
- Du die Hardware bereits besitzt. Wenn eine leistungsfähige GPU ungenutzt herumsteht, vergleiche ihre Betriebskosten und Trainingszeit mit Cloud-Optionen, bevor du weitere Hardware kaufst.
- Du volle Kontrolle über Treiber, Kernel oder eigenen Trainingscode brauchst, den eine verwaltete Plattform nicht unterstützt.
Wann sich verwaltetes Training eignet#
Eine verwaltete Plattform ist besser geeignet, wenn:
- Das Training nur gelegentlich stattfindet. Du trainierst, wenn sich die Daten ändern, und dann tagelang überhaupt nicht.
- Du sofort loslegen möchtest. Vor dem ersten Lauf sind weder Treiberinstallationen noch CUDA-Kompatibilitätsprobleme oder die Fehlersuche in der Umgebung nötig.
- Die Modellgrößen variieren. Du kannst ein Nano-Modell auf einer kleinen GPU und ein großes Modell auf einer GPU mit 80 GB oder mehr trainieren, ohne eine der GPUs kaufen zu müssen.
- Mehrere Personen trainieren. Trainingsläufe, Kennzahlen und Prüfpunkte befinden sich an einem zentralen Ort statt auf einzelnen Rechnern.
Die hybride Option: eigene GPUs und ein verwaltetes Dashboard#
Du musst dich nicht für nur eine Option entscheiden. Die Ultralytics Platform unterstützt Remote-Training: Du trainierst auf deiner eigenen GPU mit dem Paket ultralytics, überträgst Live-Kennzahlen an dasselbe Platform-Dashboard wie bei Cloud-Läufen und lädst nach Abschluss des Trainings die endgültigen Gewichte hoch. Remote-Läufe verwenden deine eigene GPU, nicht die Cloud-GPUs von Ultralytics, und verbrauchen daher keine Cloud-GPU-Zeit.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # dein Platform-Projekt
    name="local-gpu-run",
)
Richte zuerst mit export ULTRALYTICS_API_KEY="YOUR_API_KEY" deinen API-Schlüssel ein. Für die Integration mit Platform sind Python 3.11 oder höher und ultralytics in Version 8.4.120 oder höher erforderlich. Häufig werden schnelle Experimente auf einer lokalen GPU ausgeführt und größere oder zeitkritische Trainingsläufe an eine Cloud-GPU übergeben, wenn der lokale Rechner ausgelastet ist.
YOLO26 mit einer verwalteten GPU auf der Ultralytics Platform trainieren#
- Erstelle ein Konto unter platform.ultralytics.com. Neue Konten erhalten ein Anmeldeguthaben von 5 $ oder 25 $ nach Bestätigung einer geschäftlichen E-Mail-Adresse.
- Füge einen Datensatz hinzu, indem du Bilder und Labels hochlädst oder in einem Tarif Pro oder Enterprise einen Amazon-S3-Bucket verbindest.
- Öffne den Trainingsdialog, wähle ein YOLO26-Modell aus und lege die Anzahl der Epochen und die Bildgröße fest.
- Wähle eine GPU aus. RTX PRO 6000 ist die empfohlene Standardoption. Unter Auswahl einer Cloud-GPU findest du die jeweiligen Vor- und Nachteile.
- Prüfe die Kostenschätzung, starte das Training und verfolge die Live-Kennzahlen bis zum Abschluss des Laufs.
Im Free-Tarif können bis zu drei Cloud-Trainingsaufträge gleichzeitig ausgeführt werden. Pro kostet 29 $ pro Platz und Monat, erhöht die Obergrenze auf zehn Aufträge und umfasst ein monatliches Guthaben von 30 $ pro Platz.
Nach dem Training kannst du das Modell exportieren oder als API bereitstellen. Wenn du auch entscheidest, wo die Inferenz ausgeführt werden soll, vergleicht unser Leitfaden zu Cloud- und selbst gehosteter KI für Bildverarbeitung die Kosten, Latenz und Datenkontrolle bei der Bereitstellung.
Häufig gestellte Fragen
Das kann der Fall sein, besonders bei gelegentlichem Training, da du nur für die tatsächlich genutzten GPU-Stunden zahlst. Vergleiche die Gesamtkosten und die Dauer für dieselbe Arbeitslast. Die obige Amortisationsrechnung – Hardwarekosten geteilt durch den Cloud-Stundensatz abzüglich der Stromkosten pro Stunde – ist ein Ausgangspunkt, aber keine Garantie.
Bei einer gemieteten Cloud-GPU erhältst du einen Rechner, und dein Team konfiguriert die Trainingsarbeitslast und überprüft oder richtet die Umgebung ein. Eine verwaltete Trainingsplattform übernimmt mehr Schritte des Arbeitsablaufs: Auf der Ultralytics Platform wählst du einen Datensatz, ein Modell und eine GPU aus. Die Plattform stellt die GPU bereit, führt das Training aus, überträgt Kennzahlen und speichert Prüfpunkte.
Auf der Ultralytics Platform wird für einen Lauf, der nach dem Start der Cloud-GPU fehlschlägt, die tatsächlich verstrichene GPU-Zeit berechnet. Ein Fehler vor dem Start der GPU ist kostenlos. Für abgebrochene Läufe wird die GPU-Zeit bis zum Abbruch berechnet.
Ja. Remote-Training läuft auf deiner eigenen Hardware, überträgt Live-Kennzahlen an Platform und lädt die endgültigen Gewichte hoch. Es verbraucht daher keine Cloud-GPU-Zeit.
Die RTX PRO 6000 (96 GB) ist die empfohlene Standardoption für die meisten Trainingsaufträge. Ultralytics empfiehlt die RTX 4090 für allgemeines Training, die A100 SXM für große Batchgrößen oder größere Modelle sowie H100-, H200-, B200- und B300-GPUs für zeitkritische Arbeitslasten, hohe Speicheranforderungen und die größten Modelle.
Neue Konten auf der Ultralytics Platform erhalten ein Startguthaben von 5 $, das sich nach der Verifizierung einer geschäftlichen E-Mail-Adresse auf 25 $ erhöht. Pro-Tarife umfassen ein monatliches Guthaben von 30 $ pro Sitzplatz.
Nein. Kubernetes kann GPU-Workloads planen, aber die Dokumentation zur GPU-Planung setzt GPU-Treiber und ein Geräte-Plugin des Anbieters auf den Knoten voraus. Für einen selbst verwalteten Trainingscluster muss sich weiterhin jemand um Umgebungen, Berechtigungen, die Überwachung von Jobs und Prüfpunkte kümmern. Plane diesen Aufwand daher zusätzlich zu den Rechenressourcen ein.
Verfasst von
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









