ONNX oder TensorRT für die Inferenz in der Bildverarbeitung: Benchmarks und Entscheidungshilfe
ONNX Runtime oder TensorRT für die Inferenz in der Bildverarbeitung: gemessene Geschwindigkeit und Genauigkeit von Ultralytics YOLO26 auf 19 NVIDIA-GPUs und wie du dich entscheidest.
 Miles Deans11 Min. Lesezeit
ONNX und TensorRT sind keine echten Konkurrenten. ONNX ist ein Modellformat, TensorRT die Inferenz-Engine von NVIDIA, die üblicherweise eine ONNX-Datei als Eingabe verwendet. Die eigentliche Entscheidung ist, wie du diese Datei ausführst: mit ONNX Runtime, das auf verschiedenen Hardwaretypen funktioniert und Aufgaben sogar an TensorRT übergeben kann, oder als kompilierte, eigenständige TensorRT-Engine, die nur auf NVIDIA-GPUs läuft. In Benchmarks von Ultralytics Platform mit Ultralytics YOLO26 auf 19 NVIDIA-GPUs war TensorRT FP16 bei jeder GPU und Modellgröße schneller als die veröffentlichten ONNX-FP16-Ergebnisse; die Genauigkeit wich um höchstens 0.001 mAP50-95 ab. Die medianen Geschwindigkeitssteigerungen lagen je nach Modellgröße zwischen 1.85x und 2.55x. Aus dem Benchmark geht nicht hervor, welcher Ausführungsanbieter von ONNX Runtime die ONNX-Ergebnisse erzeugt hat. Daher lässt sich daraus nicht allgemein ableiten, wie ONNX Runtime abschneidet oder wie es sich mit seinem TensorRT-Ausführungsanbieter verhält. Für Ultralytics YOLO26 auf NVIDIA-GPUs solltest du mit TensorRT FP16 beginnen, wenn die Latenz wichtig ist. ONNX Runtime eignet sich, wenn eine Modelldatei auf mehreren Hardwaretypen laufen muss. Ultralytics YOLO exportiert mit einem einzigen Argument in beide Formate.
Einstieg mit Ultralytics YOLO:
| Bereitstellung | Beginne mit | Ultralytics-YOLO-Export |
|---|---|---|
| NVIDIA-GPU, Latenz ist wichtig | TensorRT FP16 | format="engine", quantize=16 |
| CPU, Hardware ohne NVIDIA oder gemischte Flotten | ONNX Runtime | format="onnx" |
| ONNX-Runtime-API auf einer NVIDIA-GPU | ONNX Runtime mit dem TensorRT-Ausführungsanbieter | format="onnx" |
ONNX oder TensorRT: Format, Laufzeitumgebung und Engine#
Hinter dem Vergleich verbergen sich drei verschiedene Dinge:
- ONNX (Austausch neuronaler Netze) ist ein Dateiformat, das den Graphen und die Gewichte eines trainierten Modells unabhängig von einem bestimmten Framework speichert. Du exportierst ein Modell aus PyTorch nach ONNX, damit andere Werkzeuge es lesen können.
- ONNX Runtime führt ONNX-Modelle aus. Sie übergibt Aufgaben an Hardware-Back-Ends, sogenannte Ausführungsanbieter, etwa CPU, CUDA und TensorRT. So kann dieselbe Datei auf der CPU eines Laptops oder einer Cloud-GPU laufen.
- TensorRT liest ein Modell, typischerweise eine ONNX-Datei, mit seinem ONNX-Parser ein. TensorRT führt Ebenen zusammen, wählt für jede Operation den schnellsten Kernel auf der GPU aus, für die es erstellt wurde, und schreibt eine optimierte Engine.
Die eigentliche Frage lautet also: ONNX Runtime oder TensorRT? ONNX Runtime kann TensorRT auch über den TensorRT-Ausführungsanbieter aufrufen. So kannst du die ONNX-Runtime-API beibehalten, während TensorRT die unterstützten Teilgraphen ausführt. ONNX Runtime empfiehlt, den CUDA-Ausführungsanbieter danach zu registrieren, damit nicht unterstützte TensorRT-Knoten stattdessen auf CUDA ausgeführt werden können.
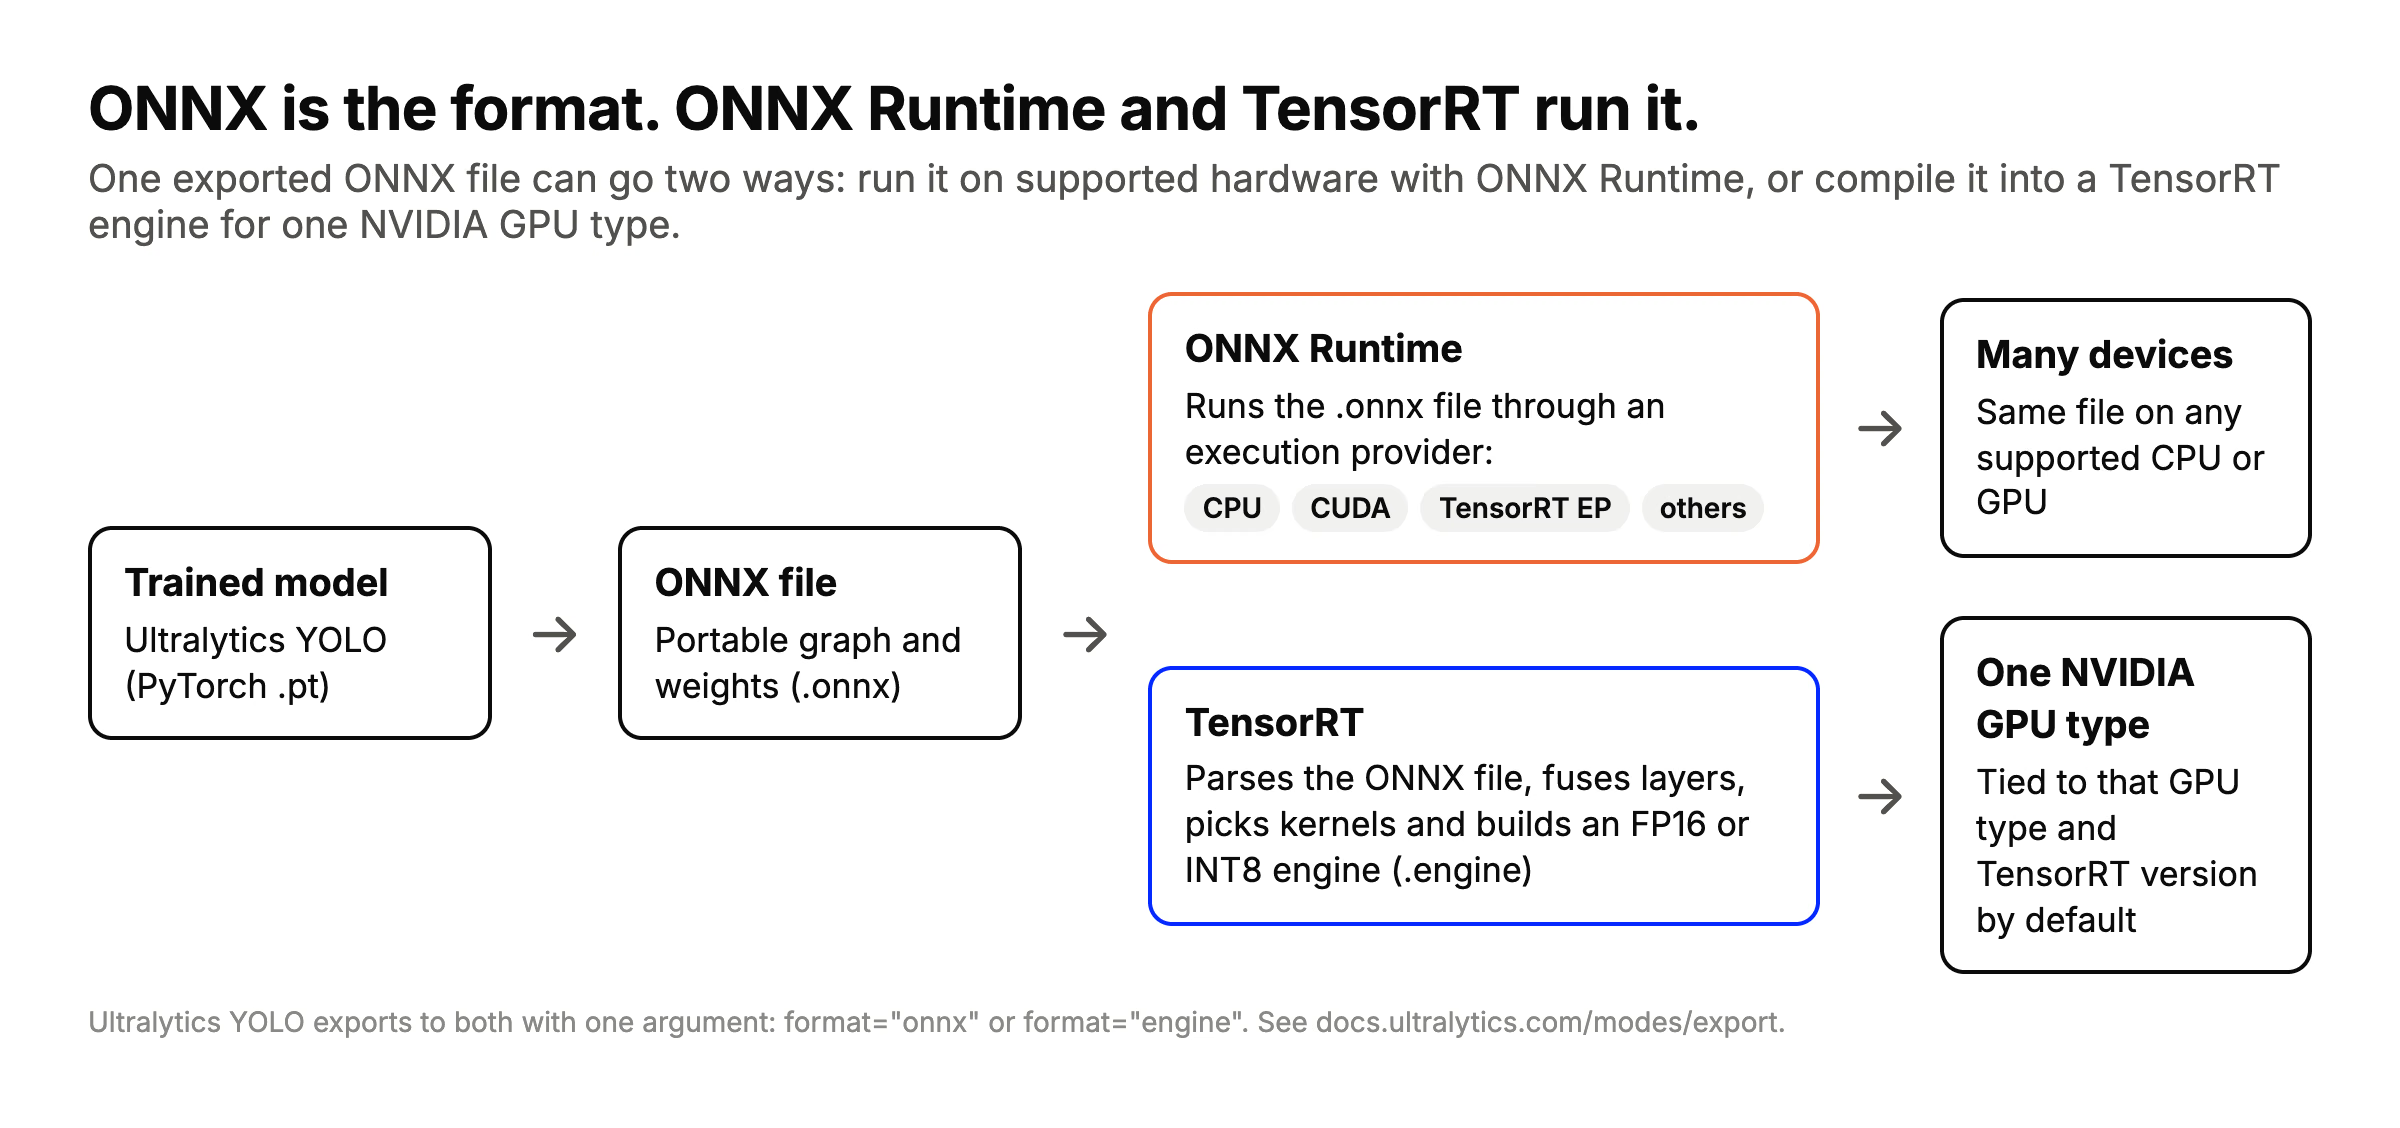
Eine ONNX-Datei, zwei Wege: ONNX Runtime führt sie auf unterstützter Hardware aus, während TensorRT sie für einen bestimmten NVIDIA-GPU-Typ zu einer Engine kompiliert. Ultralytics YOLO exportiert in beide Formate.
Benchmarks: YOLO26 mit ONNX Runtime oder TensorRT#
Die folgenden Zahlen stammen aus den Inferenz-Benchmarks von Ultralytics Platform. Jedes Ultralytics-YOLO26-Erkennungsmodell wurde in das angegebene Format exportiert. Anschließend wurde seine Inferenzlatenz auf den GPUs von Ultralytics Platform bei Batchgröße 1 und 640 Pixeln auf COCO val2017 gemessen. Die Aufwärmphase wurde nicht berücksichtigt, und die Laufzeiten wurden pro Durchlauf per Sigma-Clipping bereinigt. Die Genauigkeit ist der mAP50-95-Wert auf COCO val2017, gemessen einmal pro Format und Genauigkeitsstufe. Der Vergleich umfasst die 19 NVIDIA-GPUs (Ampere, Ada und Hopper), für die Ergebnisse in allen vier Formaten vorliegen.
Auf der Benchmark-Seite wird nicht angegeben, welcher Ausführungsanbieter von ONNX Runtime die ONNX-Ergebnisse erzeugt hat. Auch ist bei keinem Ergebnis vermerkt, dass der TensorRT-Ausführungsanbieter von ONNX Runtime verwendet wurde, der unterstützte Modellteile an TensorRT übergibt. Die ONNX-Ergebnisse gelten für die getestete Konfiguration; die Leistung kann je nach Ausführungsanbieter von ONNX Runtime variieren. Wenn du die ONNX-Runtime-API mit TensorRT im Hintergrund verwenden möchtest, teste diese Kombination auf deiner eigenen Hardware.
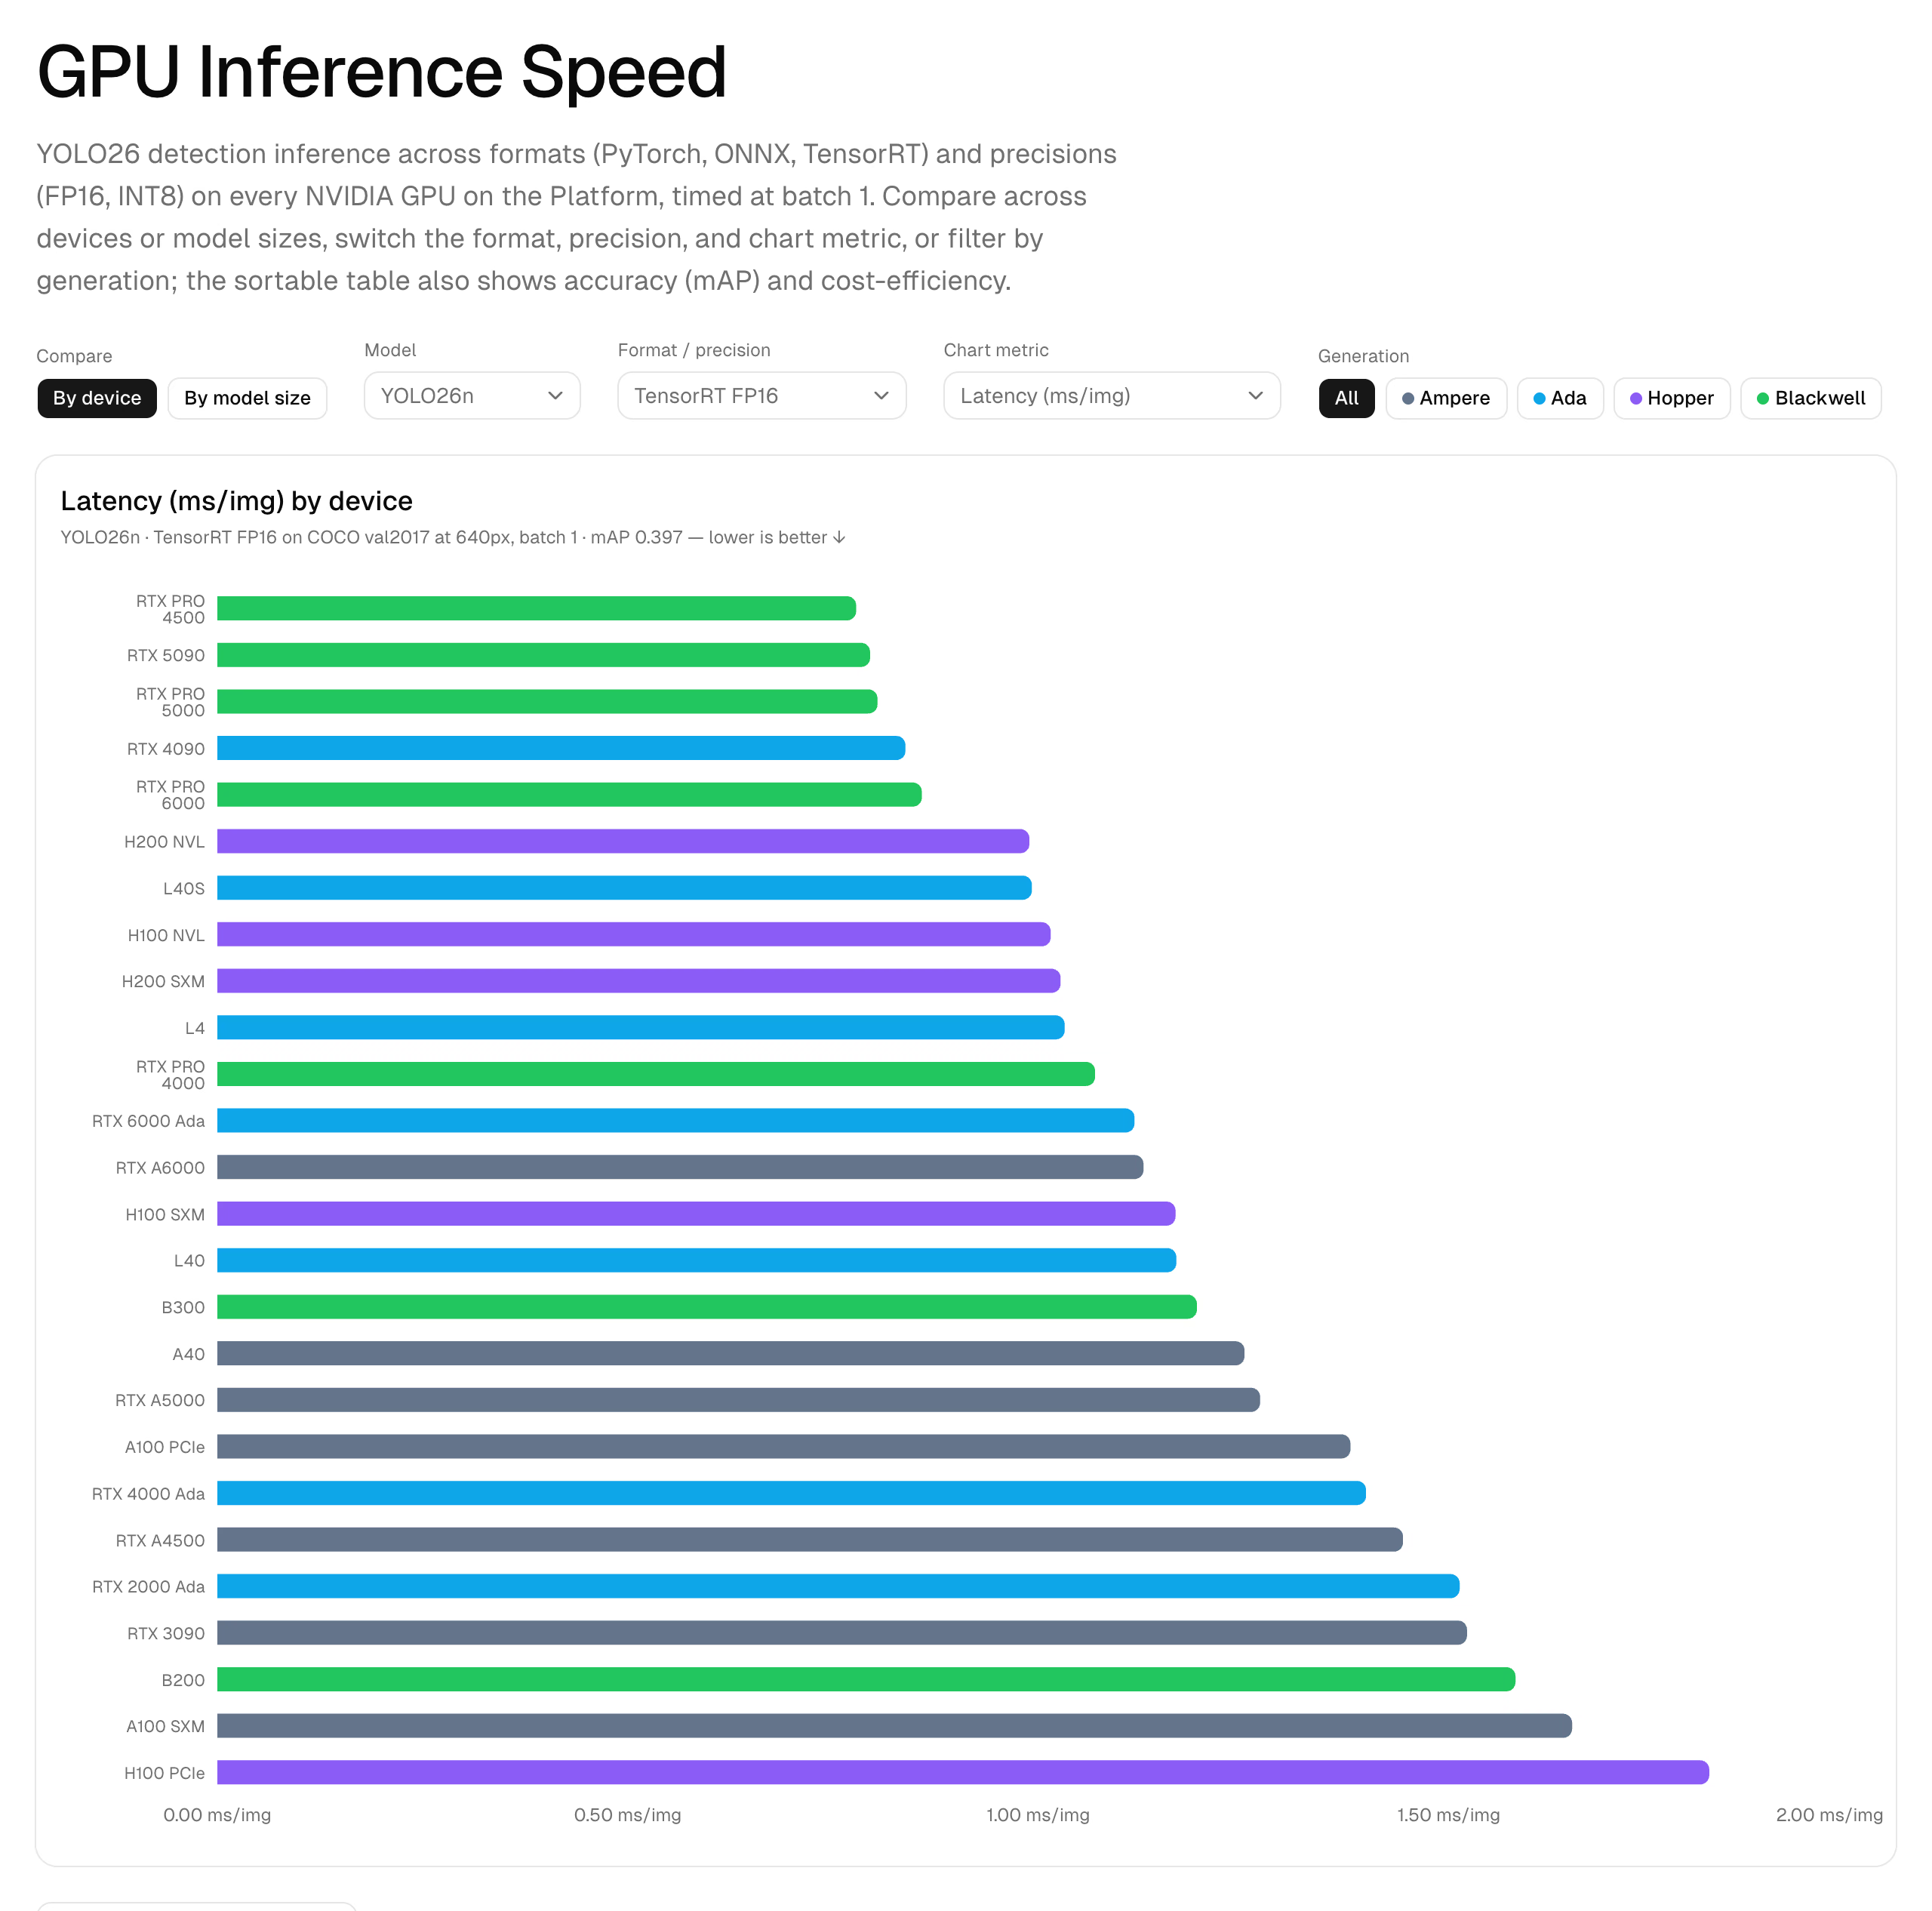
Im Tab „Inference“ kannst du Modellgröße, Format und Genauigkeitsstufe auswählen und anschließend alle GPUs nach Latenz, Genauigkeit oder Kosten sortieren.
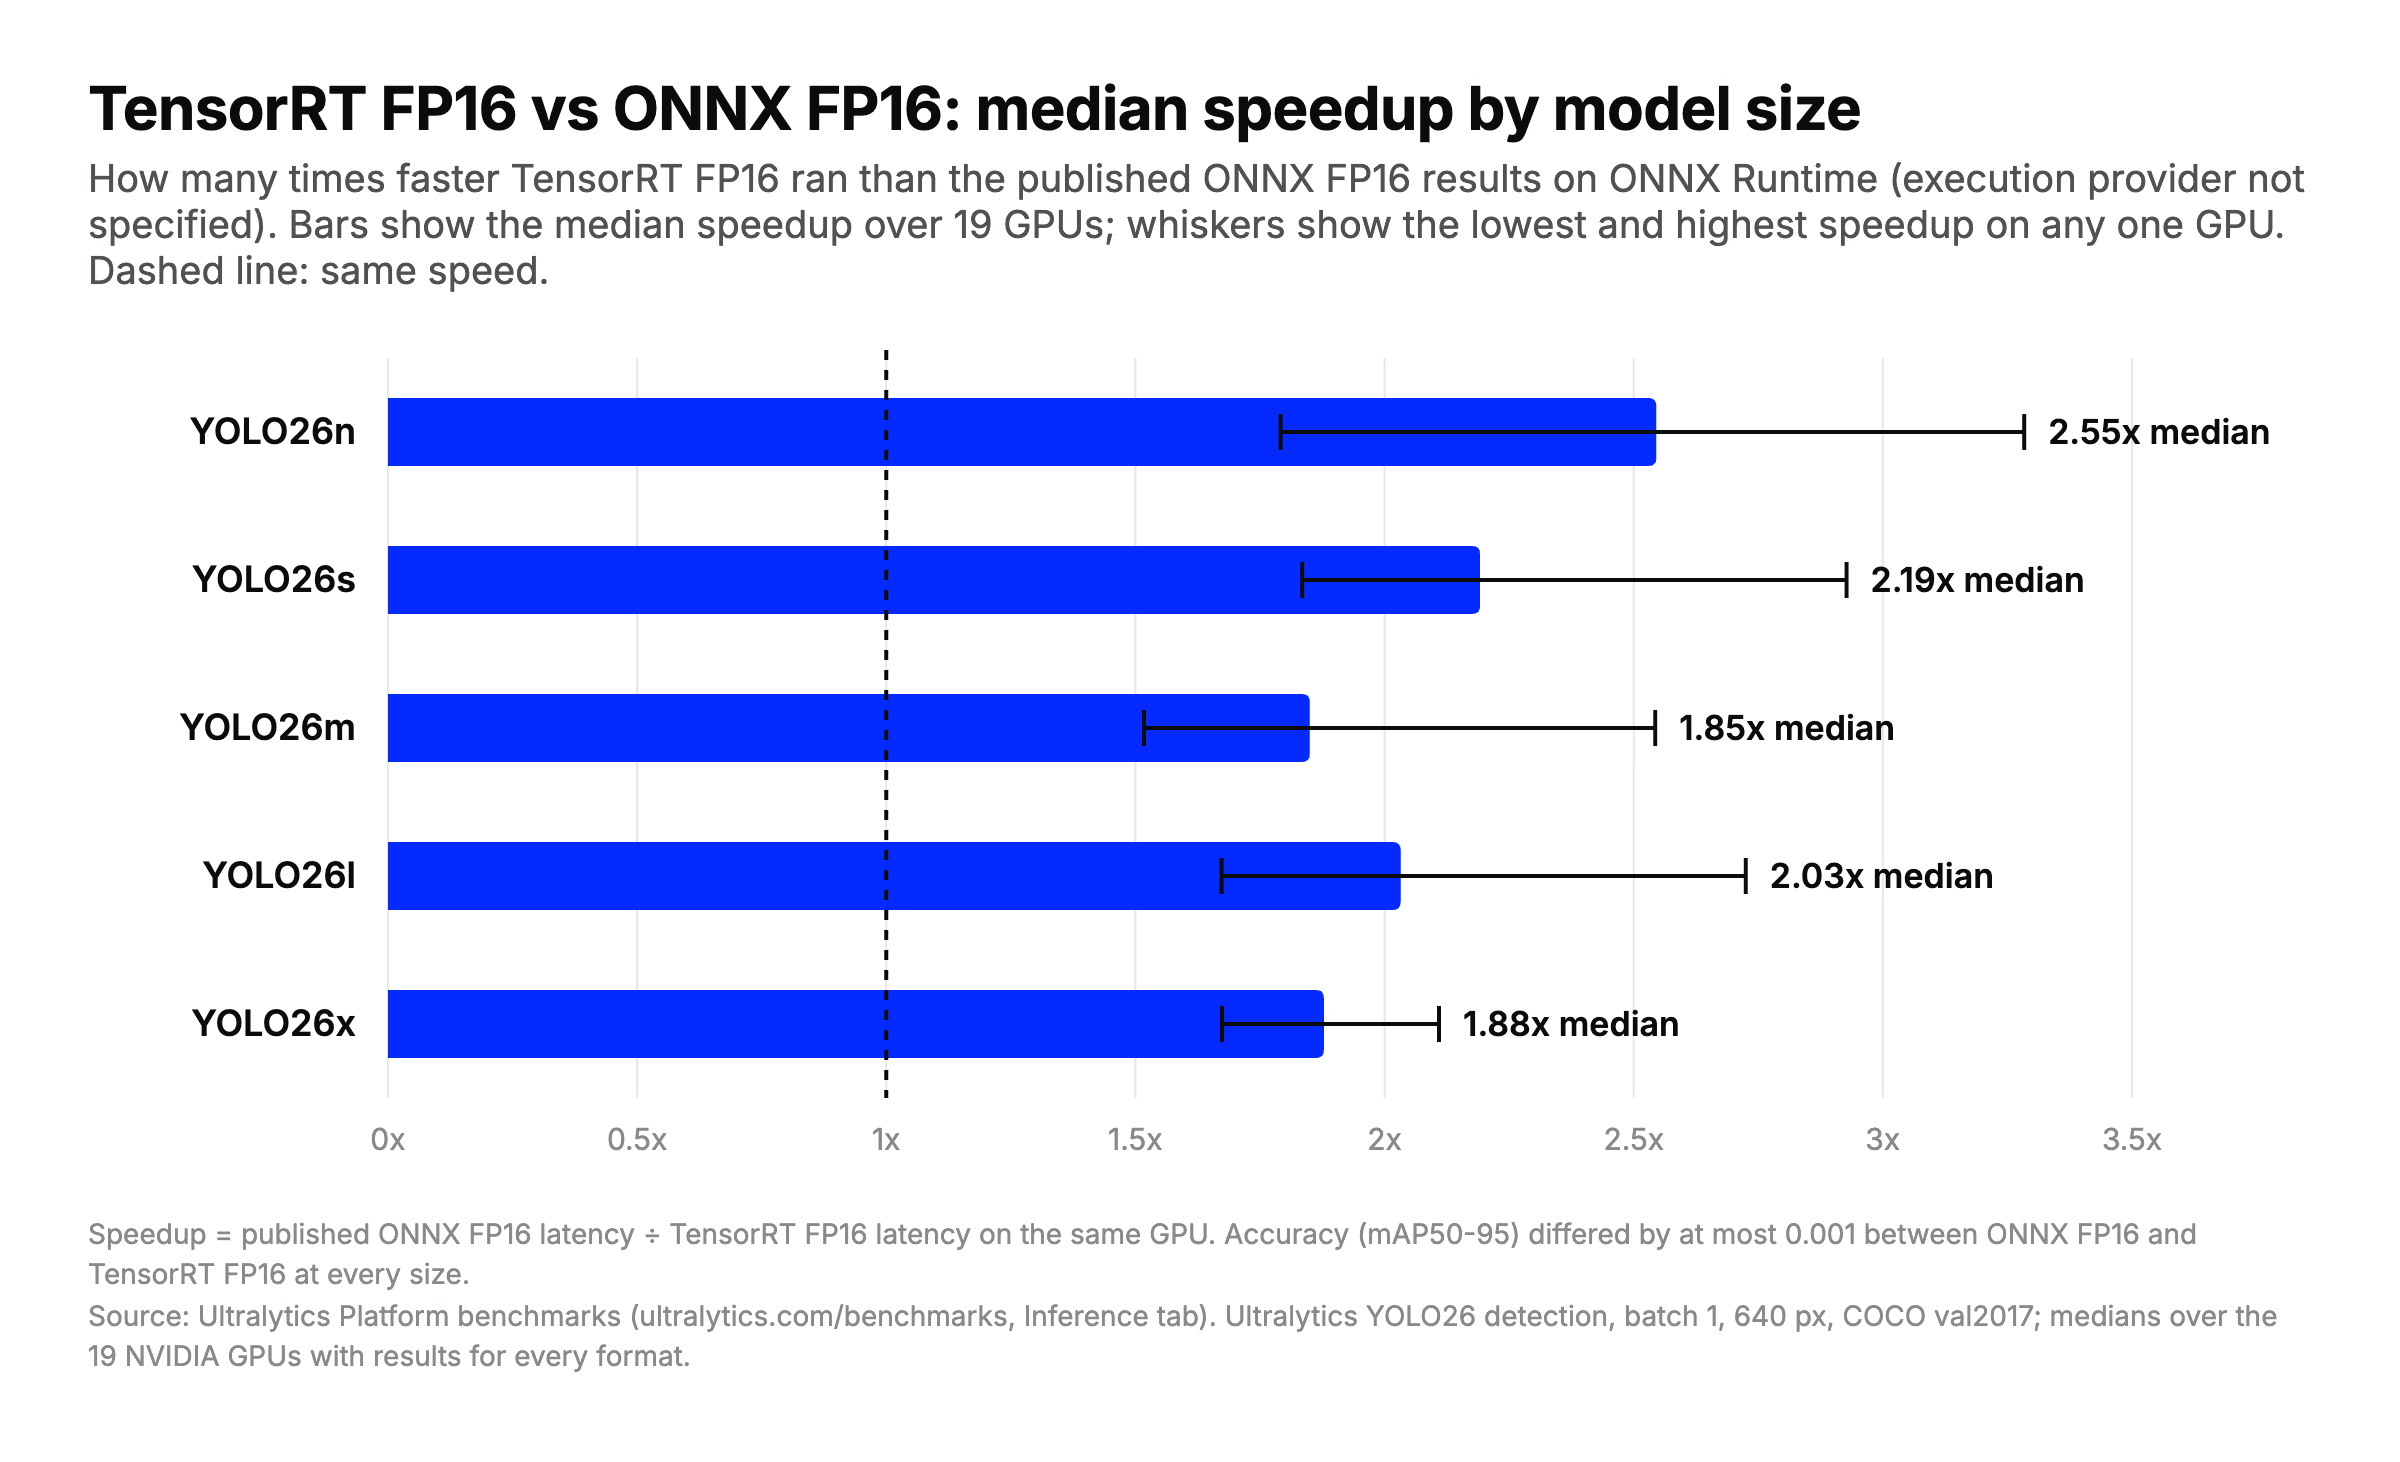
TensorRT FP16 war bei jeder GPU und jeder Modellgröße schneller als die veröffentlichten ONNX-FP16-Ergebnisse; auf der Seite wird nicht angegeben, welcher Ausführungsanbieter von ONNX Runtime diese erzeugt hat. Die Balken zeigen die mediane Geschwindigkeitssteigerung über 19 GPUs; die Fehlerbalken zeigen den niedrigsten und höchsten Wert auf einer einzelnen GPU. Berechnet anhand der Inferenz-Benchmarks von Ultralytics Platform.
| Modell | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Geschwindigkeitssteigerung von TensorRT FP16 gegenüber ONNX FP16 (Median, Spannweite) | Geschwindigkeitssteigerung von TensorRT INT8 gegenüber TensorRT FP16 (Median, Spannweite) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Berechnet anhand der Inferenz-Benchmarks von Ultralytics Platform. Die Geschwindigkeitssteigerung ergibt sich aus der ONNX-FP16-Latenz ÷ TensorRT-FP16-Latenz oder der TensorRT-FP16-Latenz ÷ TensorRT-INT8-Latenz auf derselben GPU. Werte über 1x bedeuten daher, dass TensorRT FP16 (oder INT8) schneller war. Die Mediane basieren auf den 19 NVIDIA-GPUs, für die Ergebnisse in allen vier Formaten vorliegen. Die Spannweiten zeigen das Minimum und Maximum der Verhältnisse auf diesen GPUs. Die Genauigkeit entspricht dem angegebenen mAP50-95 für jedes Format und jede Genauigkeitsstufe. ONNX FP16 bezeichnet die veröffentlichten ONNX-Runtime-Ergebnisse, bei denen der Ausführungsanbieter nicht angegeben ist.
Latenz auf vier gängigen GPUs in Millisekunden pro Bild, wie auf der Benchmark-Seite veröffentlicht:
| GPU | Modell | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Drei Dinge fallen auf:
- TensorRT FP16 war bei jeder GPU und jeder Modellgröße schneller als die veröffentlichten ONNX-FP16-Ergebnisse und wich bei der Genauigkeit um höchstens 0.001 mAP50-95 ab. Wenn du auf diesen NVIDIA-GPUs bereitstellst und eine geringe Latenz brauchst, solltest du mit TensorRT FP16 beginnen.
- INT8 ist nicht automatisch schneller. Bei YOLO26n war es auf 17 der 19 GPUs langsamer als TensorRT FP16 und kostete 0.04 mAP50-95. Bei größeren Modellen half es häufiger, bei YOLO26x auf einer L4 mit bis zu 1.67x, allerdings auf Kosten von 0.034 bis 0.076 mAP50-95.
- Für die sieben Blackwell-GPUs gibt es keine ONNX-Ergebnisse. Laut Benchmark-Seite liegt das daran, dass ONNX Runtime in der Testumgebung keine Blackwell-Kernels hatte. TensorRT lief auf allen sieben GPUs.
Diese Ergebnisse gelten für die auf der Benchmark-Seite beschriebene Konfiguration mit Batchgröße 1 und 640 Pixeln. Teste dein eigenes Modell daher vor der Entscheidung mit deinen eigenen Daten auf dem Gerät, auf dem du es bereitstellen willst.
FP16 oder INT8 mit TensorRT#
Eine weitere wichtige Stellschraube ist die geringere Genauigkeit. Der Benchmark zeigt, warum du sie testen solltest:
- FP16 (halbe Genauigkeit) halbiert im Vergleich zu FP32 die Größe der Gewichte und Aktivierungen. In den Benchmarks von Ultralytics Platform entsprach die Genauigkeit von TensorRT FP16 der von ONNX FP16 und PyTorch FP16 mit einer Abweichung von höchstens 0.003 mAP50-95.
- INT8 speichert Gewichte und Aktivierungen als 8-Bit-Ganzzahlen – eine Form der Modellquantisierung. Dafür ist eine Kalibrierung erforderlich: Eine repräsentative Bildauswahl wird durch das Modell geleitet, um die Wertebereiche der Aktivierungen zu messen. Im Benchmark von Ultralytics Platform wurde NVIDIA ModelOpt mit COCO128 als Kalibrierungsdaten verwendet.
Wie in der Benchmark-Methodik erläutert, lohnt sich INT8 vor allem bei größeren, rechengebundenen Modellen. Bei den kleinsten Modellen kann der zusätzliche Quantisierungsaufwand den Geschwindigkeitsvorteil von FP16 aufheben oder die Ausführung sogar verlangsamen. Kalibriere mit Bildern aus deinem eigenen Anwendungsbereich und prüfe die Genauigkeit anhand deiner eigenen Daten, bevor du eine INT8-Engine bereitstellst.
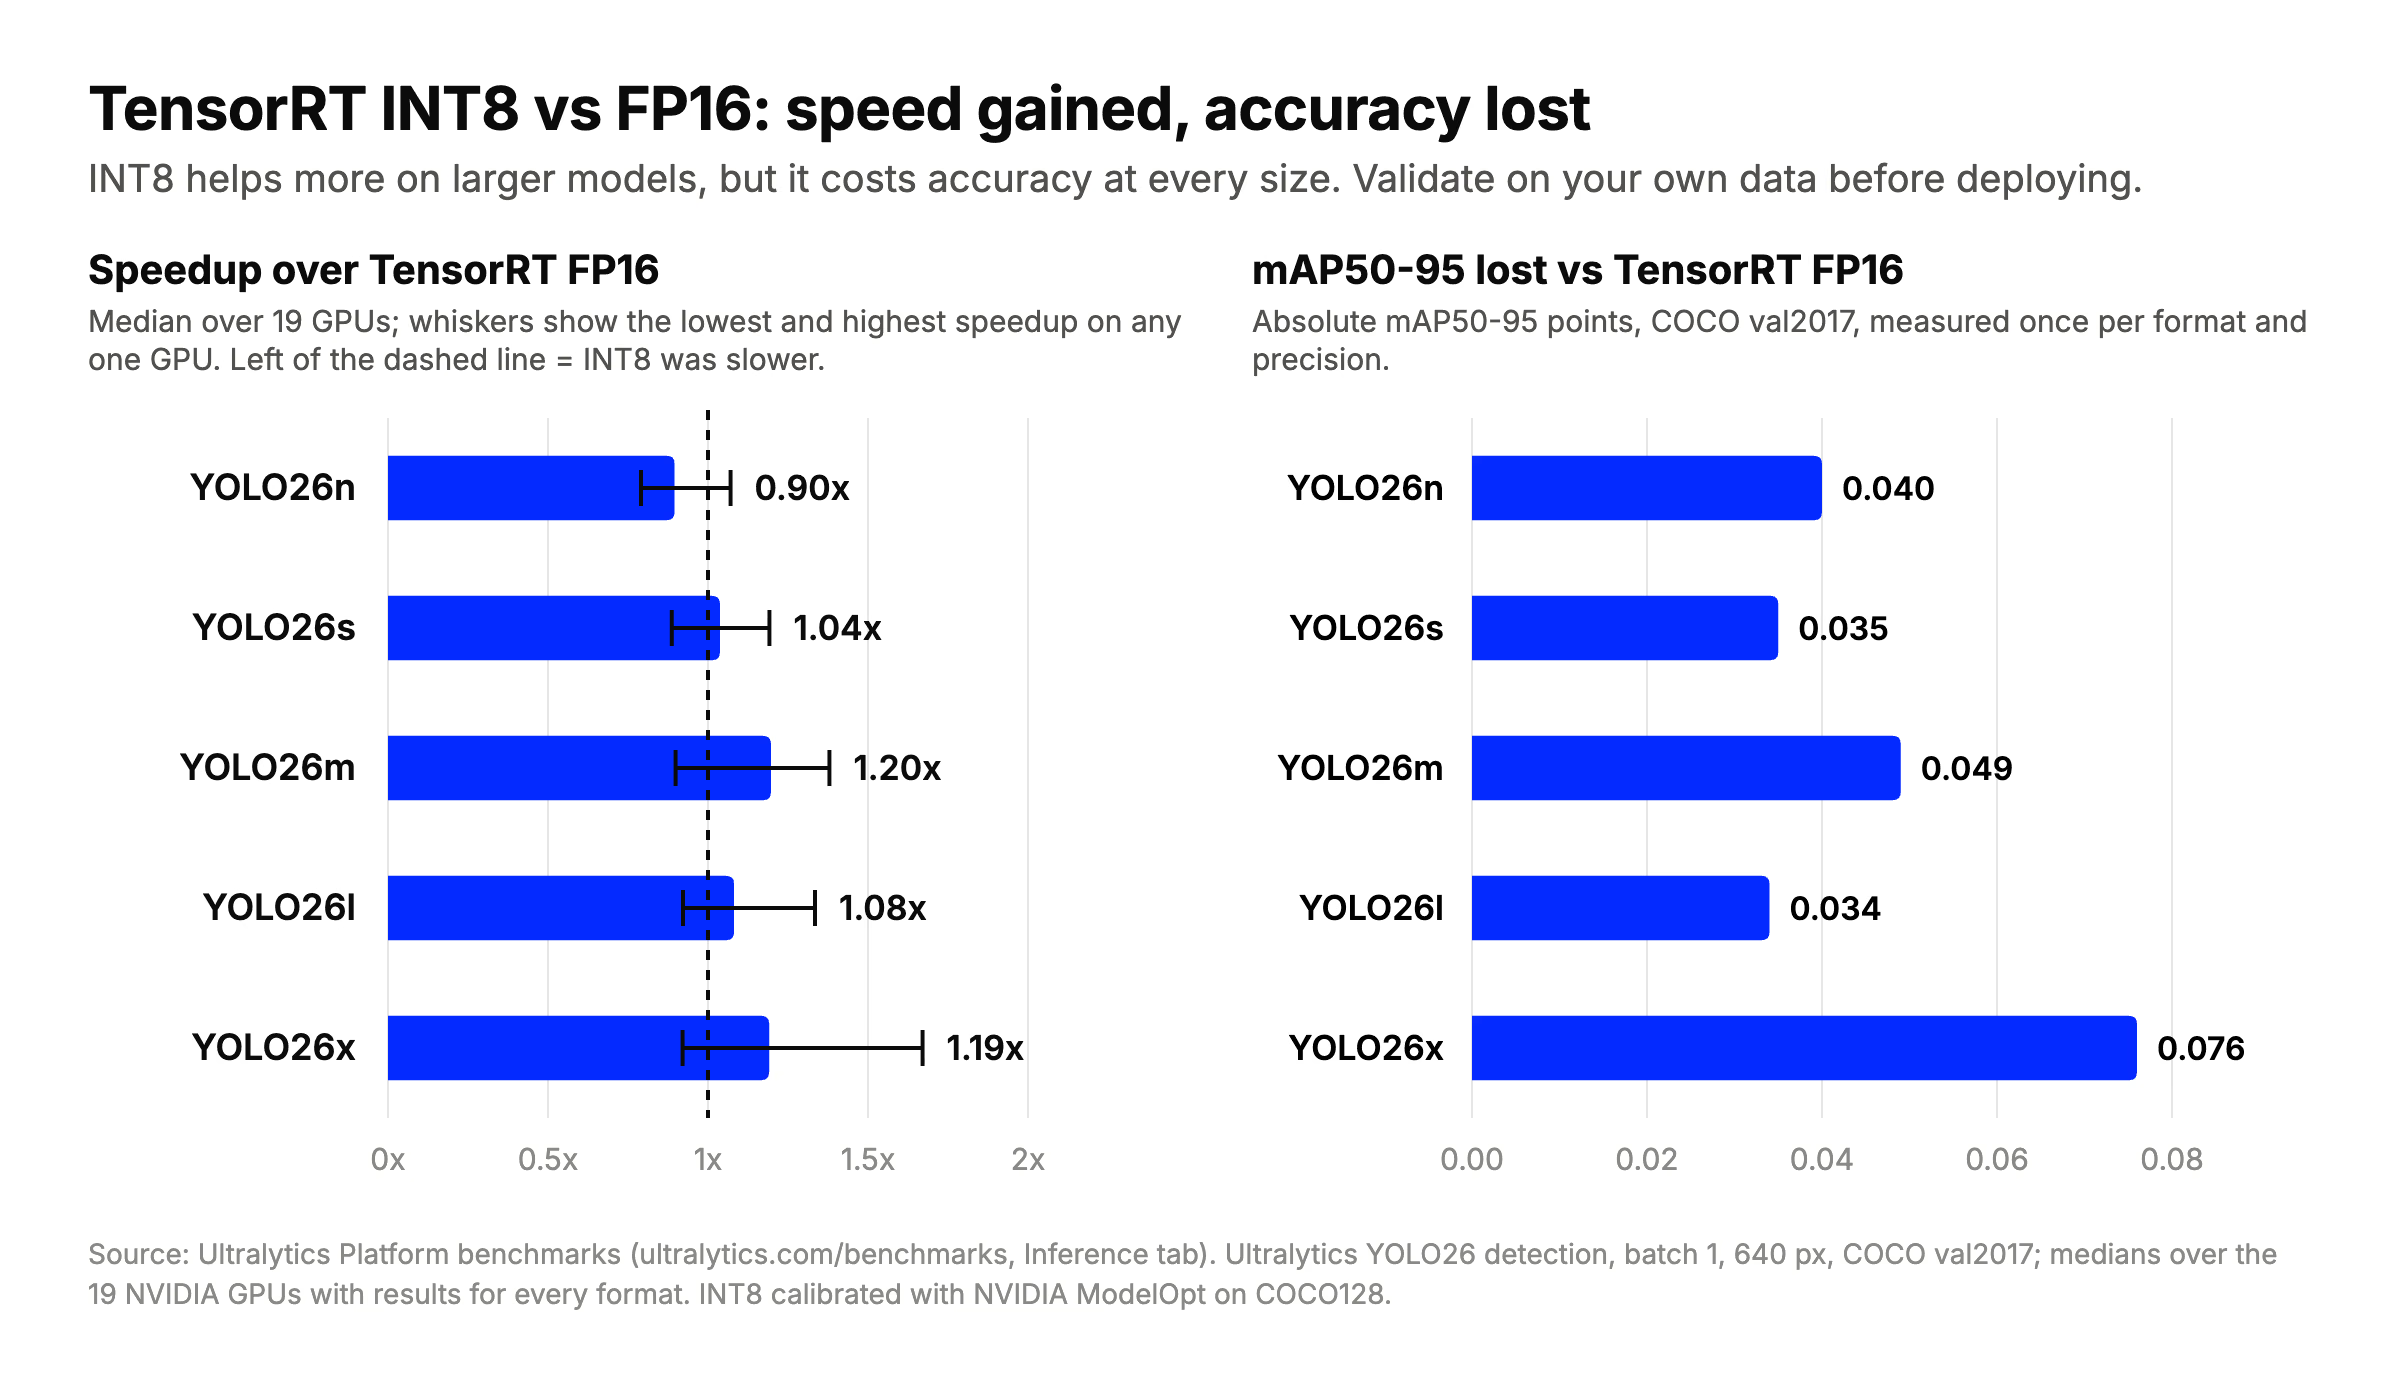
Im Median war INT8 bei YOLO26n langsamer als FP16 und bei größeren Modellen auf den 19 GPUs bis zu etwa 1.2x schneller. Bei allen Modellgrößen kostete es 0.034 bis 0.076 mAP50-95. Berechnet anhand der Inferenz-Benchmarks von Ultralytics Platform.
Übertragbarkeit der Engine und variable Eingabegrößen#
Standardmäßig ist eine TensorRT-Engine an die GPU gebunden, auf der sie erstellt wurde, sowie an die verwendete TensorRT-Version. Eine Engine für eine RTX 4090 ist also nicht dafür gedacht, auf eine H100 oder ein Jetson-Gerät kopiert zu werden. TensorRT bietet Optionen für Hardware- und Versionskompatibilität, die diese Einschränkungen lockern. Am sichersten ist es jedoch, die Engine auf dem Gerät zu erstellen, auf dem du sie bereitstellen willst, oder gezielt für dieses Gerät zu bauen, und sie nach einem TensorRT-Upgrade neu zu erstellen. Deshalb musst du im Tab „Export“ von Ultralytics Platform für TensorRT-Exporte einen GPU-Typ auswählen. Eine ONNX-Datei ist nicht an bestimmte Hardware gebunden: Dieselbe Datei läuft überall dort, wo ONNX Runtime und ein passender Ausführungsanbieter verfügbar sind.
Beide Formate unterstützen variable Eingabegrößen. Für dynamische Formen in TensorRT brauchst du ein Optimierungsprofil, das die minimalen, optimalen und maximalen Eingabedimensionen festlegt. Die Eingaben zur Laufzeit müssen innerhalb dieses Bereichs liegen. Beim Export von Ultralytics-YOLO-Modellen aktiviert dynamic=True dynamische Eingabeformen für ONNX und TensorRT. Mit festen Formen hat TensorRT mehr Spielraum für Optimierungen, wie NVIDIA in der Anleitung zu dynamischen Formen erklärt. Verwende dynamische Formen daher nur, wenn deine Eingaben tatsächlich variieren, und teste beide Varianten.
Wann du ONNX Runtime und wann TensorRT verwenden solltest#
- NVIDIA-GPU in der Cloud oder lokal, Latenz ist wichtig: TensorRT, zunächst mit FP16. Probiere INT8 bei größeren Modellen aus, nachdem du es kalibriert und validiert hast.
- NVIDIA Jetson am Netzwerkrand: TensorRT. Siehe die NVIDIA-Jetson-Anleitung.
- CPU, Hardware ohne NVIDIA oder gemischte Flotten: ONNX mit ONNX Runtime und dem Ausführungsanbieter, den der jeweilige Rechner unterstützt.
- Du kennst die Zielhardware noch nicht: Exportiere zunächst nach ONNX. Später kannst du aus demselben Modell eine TensorRT-Engine erstellen.
- Intel-CPUs, GPUs oder NPUs: Ziehe OpenVINO in Betracht, das Inferenz-Toolkit von Intel.
Eine vollständige Liste der Formate und ihren Vergleich findest du in der Anleitung zu Optionen für die Modellbereitstellung. Die Genauigkeitsstufe ist nicht der einzige Einflussfaktor: Auch Modellgröße und Eingabeauflösung spielen eine Rolle. Unsere Anleitung zu Pruning und Quantisierung beschreibt zwei weitere Möglichkeiten, ein Modell zu verkleinern.
Ultralytics YOLO nach ONNX und TensorRT exportieren#
Ultralytics YOLO exportiert mit einem einzigen Argument format in beide Formate. Anschließend kannst du Vorhersagen oder Validierungen direkt mit dem exportierten Modell ausführen:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16 für ONNX Runtime
model.export(format="engine", quantize=16)  # TensorRT-FP16-Engine, auf dieser GPU erstellt
# Für INT8 stattdessen mit einer Dataset-YAML-Datei kalibrieren (coco8.yaml ist ein kleiner Beispieldatensatz; verwende deinen eigenen):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 wählt FP16 aus, quantize=8 INT8. Beide Engine-Exporte schreiben yolo26n.engine; führe daher nur einen davon aus. Gib für INT8 unter data den Pfad zu deiner eigenen Dataset-YAML-Datei an, damit die Kalibrierung Bilder verwendet, die deinen Bereitstellungsdaten ähneln. Alle Optionen findest du unter Exportargumente sowie in den Integrationsanleitungen für ONNX und TensorRT. Schritt-für-Schritt-Anleitungen gibt es außerdem zum Export nach ONNX und zur Optimierung mit TensorRT. Auf Ultralytics Platform kannst du trainierte Modelle auch im Browser exportieren.
Häufig gestellte Fragen
ONNX ist ein Modellformat, keine Engine. Ein fairer Vergleich ist daher ONNX Runtime oder TensorRT. In Benchmarks von Ultralytics Platform mit Ultralytics YOLO26 auf 19 NVIDIA-GPUs war TensorRT FP16 auf jeder GPU schneller als die veröffentlichten ONNX-FP16-Ergebnisse mit ONNX Runtime. Die berechnete mediane Geschwindigkeitssteigerung lag je nach Modellgröße zwischen 1.85x und 2.55x; die Unterschiede beim mAP50-95 betrugen höchstens 0.001. Aus dem Benchmark geht nicht hervor, welcher Ausführungsanbieter von ONNX Runtime die ONNX-Ergebnisse erzeugt hat. Keines der Ergebnisse ist als Resultat des TensorRT-Ausführungsanbieters von ONNX Runtime gekennzeichnet. Teste diese Kombination daher selbst, wenn du die ONNX-Runtime-API benötigst.
Ja. Normalerweise verwendet TensorRT ONNX als Eingabe: Sein ONNX-Parser liest das Modell ein und erstellt daraus eine Engine. ONNX Runtime kann TensorRT auch über seinen TensorRT-Ausführungsanbieter aufrufen.
Nein. In den Benchmarks von Ultralytics Platform war TensorRT INT8 bei YOLO26n auf 17 von 19 GPUs langsamer als TensorRT FP16. Bei größeren Modellen war INT8 häufiger schneller. Über die 19 GPUs, auf denen alle Formate getestet wurden, lag der Median bei YOLO26m und YOLO26x bei etwa 1.2x. Jedes Mal kostete INT8 0.034 bis 0.076 mAP50-95. Prüfe ein INT8-Modell deshalb zuerst anhand deiner eigenen Daten.
Verlass dich nicht darauf. Standardmäßig ist eine TensorRT-Engine an die GPU und TensorRT-Version gebunden, mit der sie erstellt wurde. Erstelle sie daher auf dem Gerät, auf dem du sie bereitstellen willst, oder gezielt für dieses Gerät. Bewahre die ONNX-Datei als portable Kopie auf und erstelle für jedes Zielgerät eine neue Engine.
Üblicherweise ist TensorRT die passende Wahl: NVIDIA JetPack enthält TensorRT, und wenn du die Engine direkt auf dem Jetson erstellst, wird sie für dieses Gerät optimiert. Die obigen Benchmarks umfassen keine Jetson-Geräte. Miss daher die Leistung auf deinem Modul, bevor du dich entscheidest. Die NVIDIA-Jetson-Anleitung führt dich durch Einrichtung und Export für Ultralytics YOLO.
Verfasst von
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









