Qwen4-Max für automatische Annotation: herausragende Datensätze, uneinheitliche Verbesserungen
Qwen4-Max belegt in unserem Benchmark für automatische Annotation Platz 13 von 51, Platz 1 bei Röntgenaufnahmen von Handgelenken und Platz 2 bei Verkaufsregalen. Genauigkeit, Kosten und Ausführung.
 Miles Deans12 Min. Lesezeit
Alibaba hat Qwen4-Max am 16. November 2026 veröffentlicht und als bislang leistungsfähigstes Modell der Qwen-Familie bezeichnet. Das Modell bietet native Bildverarbeitung und ein Kontextfenster von einer Million Tokens. Noch am selben Tag haben wir es mit UL37 getestet, unserem Benchmark für Objekterkennung mit 36 Datensätzen benchmark.
Insgesamt belegt Qwen4-Max mit 0,474 mAP50 für 5,68 $ pro 1.000 Bilder Platz 13 von 51 Modellen auf unserer VLM-Bestenliste. Dieser Durchschnitt verbirgt ein deutlich besseres Einzelergebnis: Bei Röntgenaufnahmen von Kinderhandgelenken erzielt das Modell den höchsten Wert aller von uns getesteten Modelle. Bei Unterwasseraufnahmen und dicht bestückten Verkaufsregalen liegt es nur hinter Gemini 4 Carbon.
Qwen4-Max ist jetzt die Alibaba-Option für automatische Annotation in der Ultralytics Platform und ersetzt Qwen3.8-Max. Im Folgenden erfährst du, wo das Modell besonders gut abschneidet und wo es Schwächen zeigt, wie es sich im Vergleich zu den Alternativen schlägt und was ein Annotationslauf kostet.
Qwen4-Max belegt Platz 13 von 51 auf UL37 und Platz 1 bei Röntgenaufnahmen von Handgelenken#
UL37 misst auf 360 Bildern, wie genau die Boxen eines Modells mit menschlichen Labels übereinstimmen: 10 Bilder aus jedem von 36 realen Datensätzen zur Objekterkennung, darunter medizinische Aufnahmen, Luftbilder, Verkaufsregale, Sport und Leiterplatten. Jeder Datensatz zählt im Durchschnitt gleich viel. Jedes Bild durchläuft dieselbe Produktionspipeline wie für Platform-Nutzer, einschließlich der Klassennamen des jeweiligen Datensatzes und der Verfeinerung jeder Box durch SAM 3.1. Die Werte beziehen sich also auf diese verfeinerte Pipeline und nicht auf die unverarbeitete Modellausgabe. Die Methodik ist öffentlich.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Platzierung in der Rangliste | #13 von 51 | #15 von 51 | #3 von 51 | #11 von 51 | #16 von 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Präzision | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Trefferquote | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Anbieterkosten pro 1.000 Bilder | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Mediane Zeit pro Bild | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Fehlgeschlagene Anfragen | 0% | 1.7% | 0% | 0% | 6.4% |
Ergebnisse von UL37 aus der Ultralytics VLM-Bestenliste, aktualisiert am 19. November 2026. Qwen3.8-Max wird in Platform nicht mehr angeboten.
Qwen4-Max übertrifft Qwen3.8-Max bei allen zentralen Metriken, ist pro Bild günstiger und hat alle Benchmark-Anfragen abgeschlossen. Im Durchschnitt liegt das Modell jedoch weiterhin deutlich hinter den Spitzenreitern: GPT-6.1 Terra erzielt 0,560 zu geringeren Kosten und in weniger als der halben Zeit.
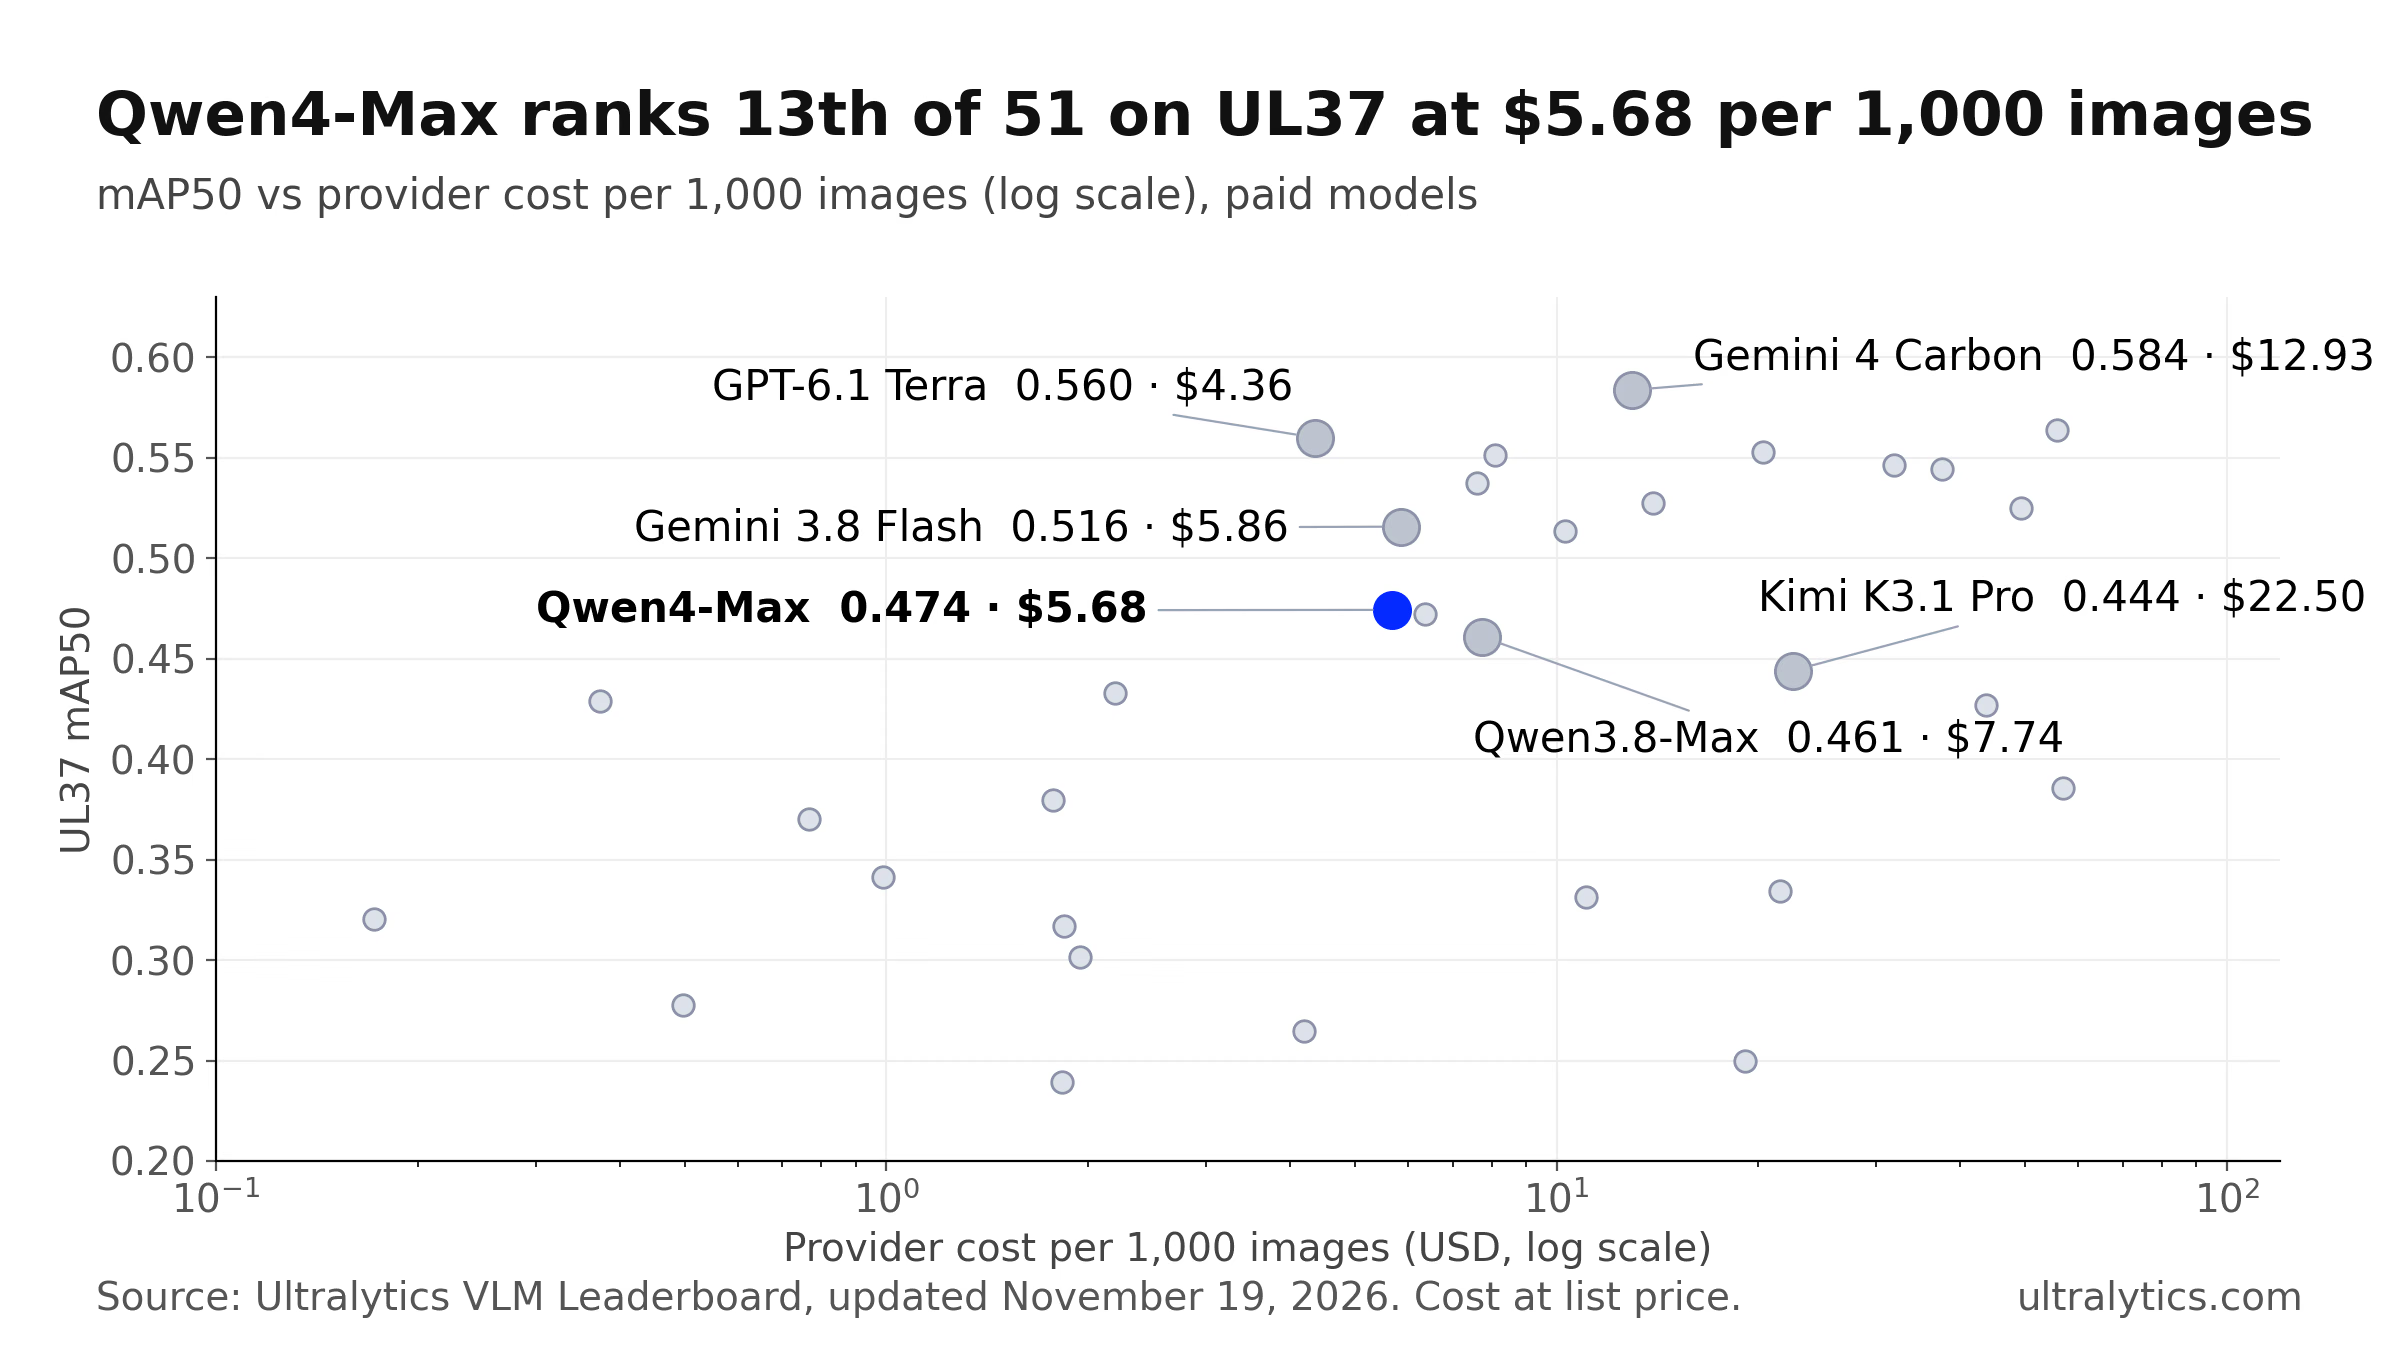
Jeder Punkt steht für ein kostenpflichtiges Modell auf der Ultralytics VLM-Bestenliste.
Wofür Alibaba Qwen4-Max entwickelt hat#
In der Ankündigung zur Veröffentlichung beschreibt Alibaba Qwen4-Max als sparsames Mixture-of-Experts-Modell mit insgesamt 2,4 Billionen Parametern, von denen pro Token 71 Milliarden aktiv sind, und mit nativer Bildverarbeitung. Als Stärken nennt Alibaba Programmierung, agentische Aufgaben und visuelles Schlussfolgern. Außerdem berichtet das Unternehmen, dass Qwen4-Max im eigenen Work360-Benchmark Qwen3.8-Max übertrifft und zugleich die durchschnittlichen Kosten pro Aufgabe um etwa 60 % senkt.
In den Versionshinweisen zu Model Studio bezeichnet Alibaba Cloud das Modell als „das multimodale Flaggschiffmodell der nächsten Generation in der Qwen-Familie, das Textgenerierung, Bild- und Videoverständnis sowie tiefgehendes Schlussfolgern vereint“. Der internationale Preis beträgt 1,50 $ pro Million Eingabe-Tokens und 4,50 $ pro Million Ausgabe-Tokens, gegenüber 2 $ und 6 $ für Qwen3.8-Max. Das Modell ist über die API von Alibaba verfügbar. Alibaba zufolge sollen kleinere Qwen4-Modelle mit offenen Gewichten folgen.
Weder die Ankündigung noch die Versionshinweise enthalten Ergebnisse zur Objekterkennung – genau das haben wir daher gemessen.
Qwen4-Max und Qwen3.8-Max im Vergleich: günstiger, aber uneinheitliche Verbesserungen#
Qwen4-Max übertrifft seinen Vorgänger bei 19 Datensätzen, liegt bei 16 darunter und erzielt bei einem Gleichstand. Der durchschnittliche Zuwachs von 0,013 mAP50 ergibt sich aus großen Verbesserungen bei einigen Datensätzen, die deutliche Rückgänge bei anderen überwiegen.
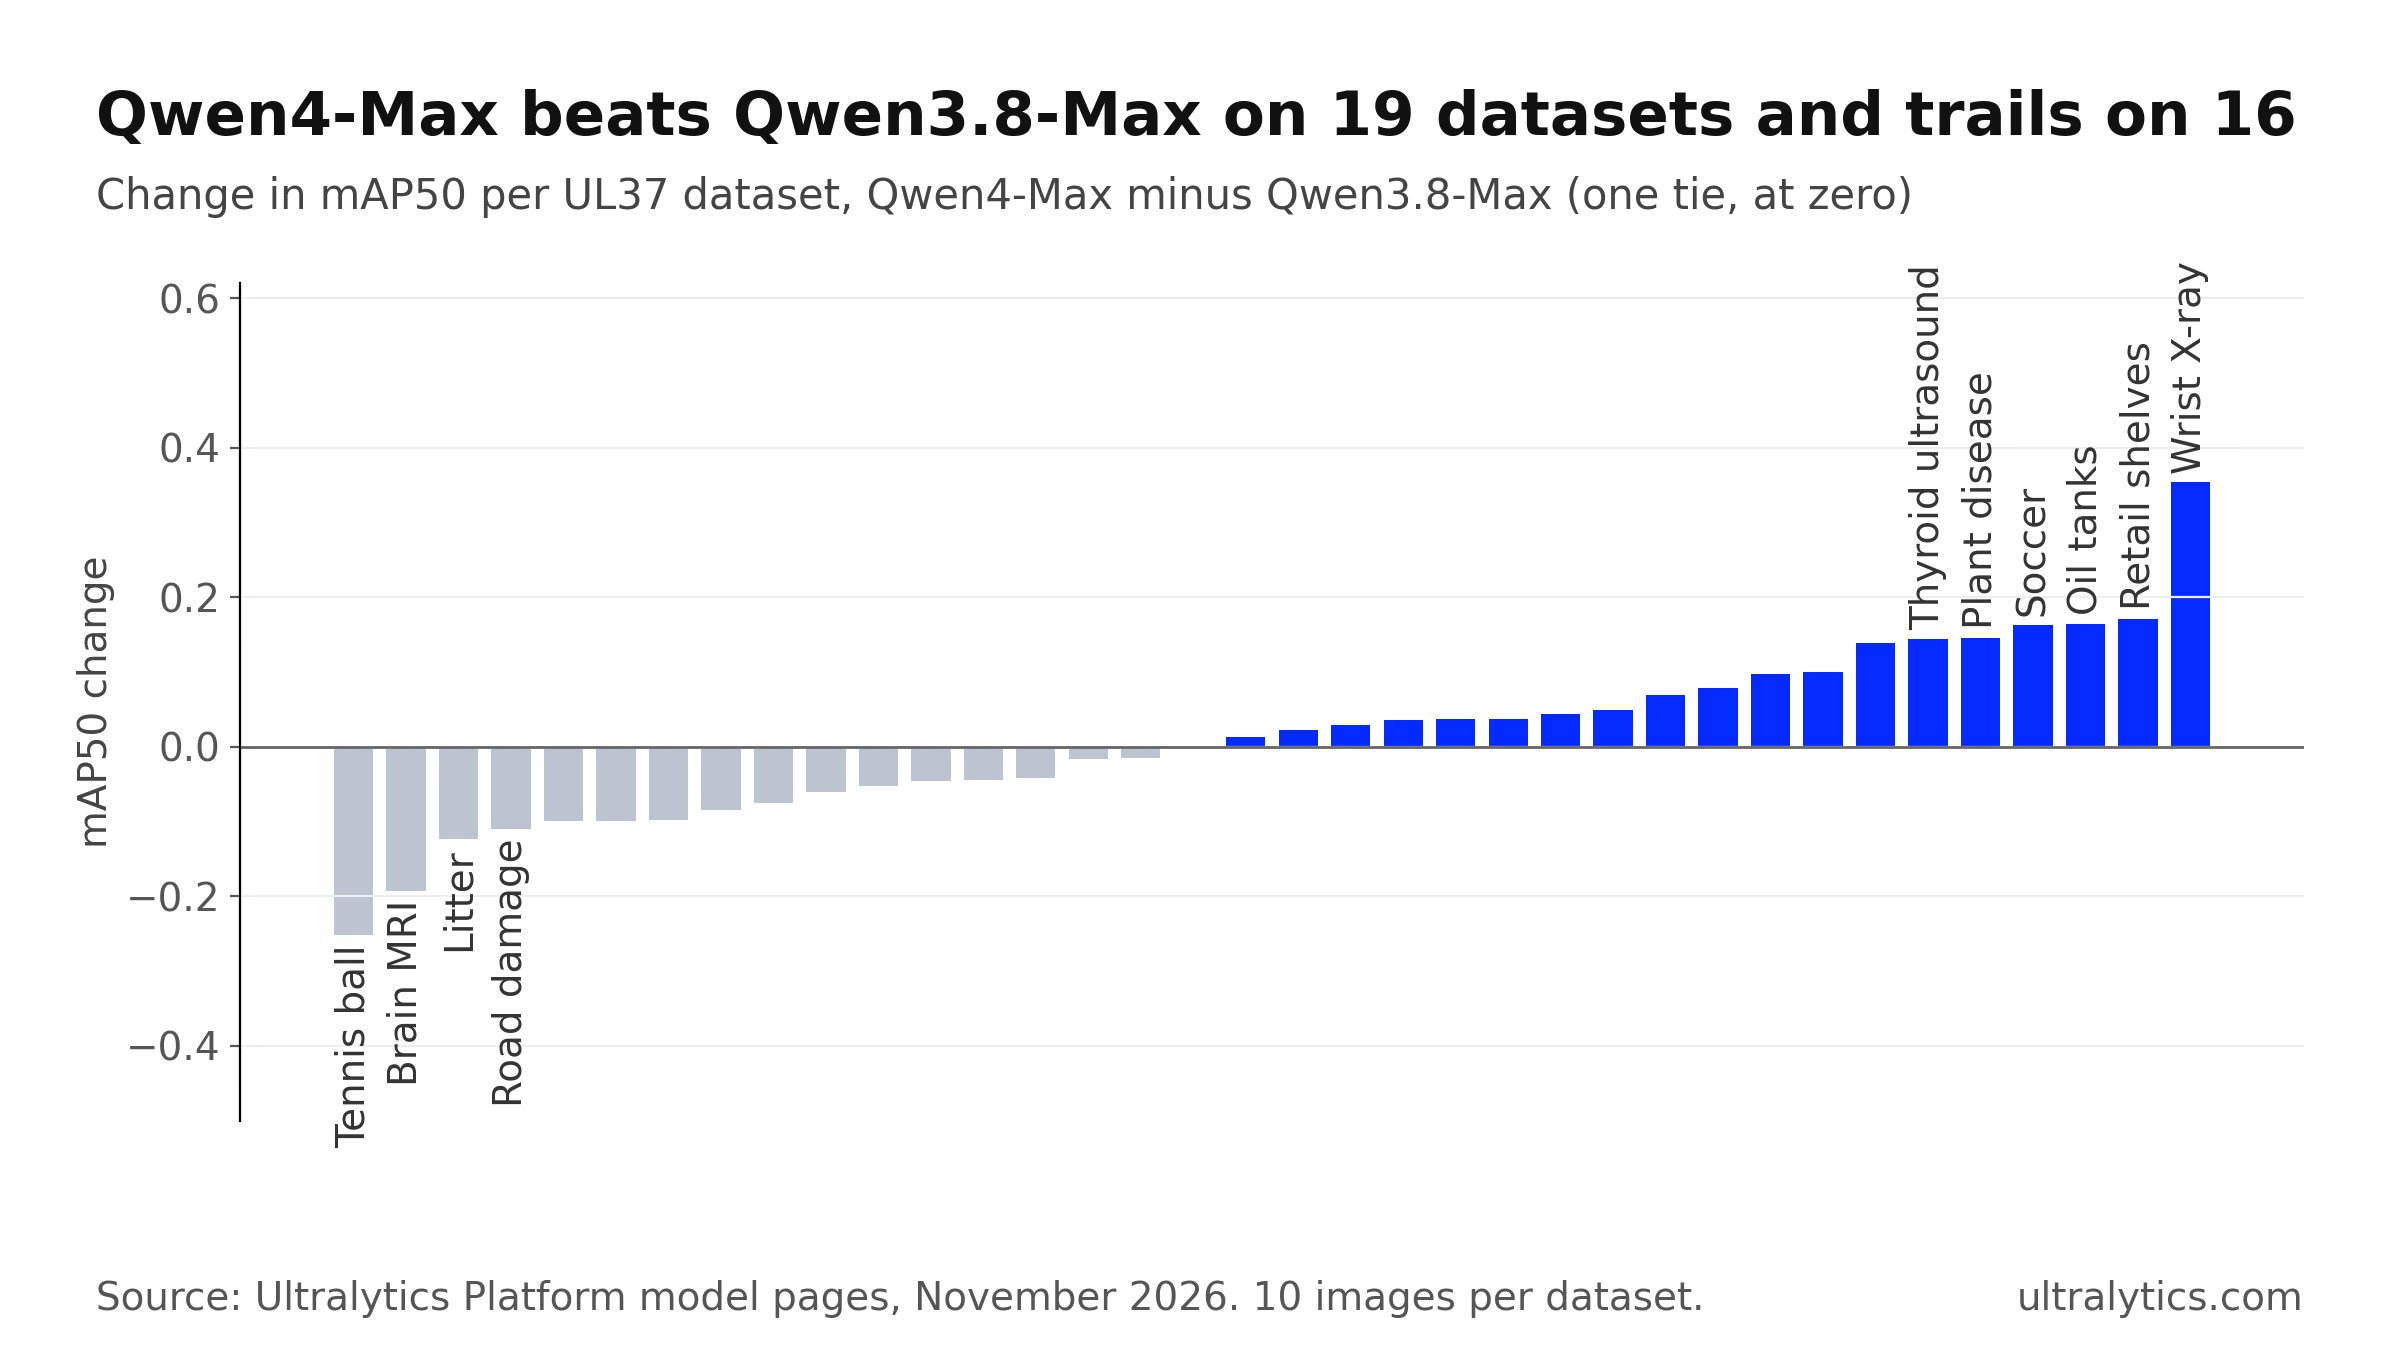
Jeder Balken steht für einen UL37-Datensatz. Die Sortierung reicht vom größten Rückgang bis zum größten Zuwachs.
| Datensatz | Qwen4-Max | Qwen3.8-Max | Veränderung |
|---|---|---|---|
| GRAZPEDWRI-DX Röntgenaufnahmen von Kinderhandgelenken | 0.4975 | 0.1437 | +0.3538 |
| SKU110K dicht bestückte Verkaufsregale | 0.6230 | 0.4516 | +0.1714 |
| Airbus Öllagertanks | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB Fußball | 0.8345 | 0.6715 | +0.1630 |
| RacketVision Tennisball | 0.3775 | 0.6299 | −0.2524 |
| Cheng Gehirntumor-MRT | 0.4421 | 0.6350 | −0.1929 |
UL37-mAP50 je Datensatz, jeweils 10 Bilder, auf vier Dezimalstellen gerundet, damit jede Veränderung mit den beiden zugehörigen Werten übereinstimmt.
Der Kostenrückgang ist deutlicher. In unserem Test kostet Qwen4-Max mit 5,68 $ pro 1.000 Bilder gegenüber 7,74 $ etwa 27 % weniger pro Bild. Alibabas eigene Angabe von rund 60 % basiert auf einem anderen Benchmark mit anderen Einstellungen und ist daher nicht direkt vergleichbar.
Wo Qwen4-Max besonders gut abschneidet#
Drei Ergebnisse bringen Qwen4-Max an die Spitze der gesamten Bestenliste – nicht nur der Qwen-Familie.
| Datensatz | Qwen4-Max | Platz von 51 | Spitzenreiter |
|---|---|---|---|
| GRAZPEDWRI-DX: Röntgenaufnahmen von Kinderhandgelenken | 0.4975 | 1st | Qwen4-Max (danach: Muse Ember 1.0 mit 0,378) |
| RUOD Unterwasserobjekte | 0.774 | 2nd | Gemini 4 Carbon, 0,788 |
| SKU110K: dicht bestückte Verkaufsregale | 0.623 | 2nd | Gemini 4 Carbon, 0,671 |
UL37-mAP50 je Datensatz. Platzierung unter allen 51 Modellen auf der Ultralytics VLM-Bestenliste.
Röntgenaufnahmen von Handgelenken. Bei Röntgenaufnahmen von Kinderhandgelenken nach Verletzungen erzielt Qwen4-Max 0,4975. Damit liegt das Modell vor allen anderen von uns getesteten Modellen und mehr als dreimal so hoch wie Qwen3.8-Max. Da jeder Datensatz 10 Bilder umfasst, solltest du diesen Wert als starkes Signal für weitere Tests verstehen, nicht als endgültiges Urteil. Er ist außerdem weder eine Diagnose noch eine klinische Validierung: Für Forschungsannotationen in der medizinischen Bildanalyse kann Qwen4-Max Boxen erstellen, die klinische Fachleute prüfen und korrigieren.
Verkaufsregale. Über die beiden UL37-Datensätze für den Einzelhandel gemittelt erzielt Qwen4-Max 0,752 und liegt damit vor den 0,724 von GPT-6.1 Terra. Bei SKU110K, wo die Regale dicht an dicht mit Produkten einer einzigen Klasse gefüllt sind, liegt das Modell nur hinter Gemini 4 Carbon.
Unterwasseraufnahmen. Bei den Unterwasserobjekten von RUOD liegt Qwen4-Max mit 0,774 auf Platz 2 von 51 und damit vor den 0,658 von GPT-6.1 Terra.
Wo Qwen4-Max Schwächen zeigt#
Die Schwächen sind ebenso deutlich wie die Erfolge. Qwen4-Max erzielt 0,000 bei Defekten auf unbestückten Leiterplatten in DeepPCB und 0,05 bei Sicherheitskontrollen mit Röntgenaufnahmen in IEDXray. Die Gemini-4-Modelle erreichen dort etwa 0,30. Bei Röntgenaufnahmen des Brustkorbs zur Tuberkuloseerkennung liegt der Wert bei 0,037. Beim Datensatz für Gehirntumor-MRT schneidet Qwen4-Max mit 0,442 deutlich schlechter ab als GPT-6.1 Terra mit 0,904.
Auch nach Bereichen gemittelt liegt Qwen4-Max hinter GPT-6.1 Terra: bei Dokumenten, Benutzeroberflächen und CAD-Zeichnungen (0,357 gegenüber 0,494), bei Straßen und Verkehr (0,396 gegenüber 0,572) sowie insgesamt bei medizinischen Aufnahmen (0,325 gegenüber 0,505). Bevor du in einem dieser Bereiche einen großen Datensatz annotierst, öffne die Modellseite von Qwen4-Max. Dort werden die aufgezeichneten Boxen des Modells für jeden Benchmark-Datensatz neben den erwarteten Labels angezeigt.
Qwen4-Max im Vergleich zu GPT-6.1 Terra, Gemini 3.8 Flash und Kimi K3.1 Pro#
| Direkter Vergleich auf 36 UL37-Datensätzen | Siege von Qwen4-Max | Niederlagen | Unentschieden |
|---|---|---|---|
| gegen GPT-6.1 Terra | 11 | 23 | 2 |
| gegen Gemini 3.8 Flash | 17 | 18 | 1 |
| gegen Kimi K3.1 Pro | 21 | 14 | 1 |
| gegen Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra ist die leistungsfähigere allgemeine Wahl: Das Modell gewinnt bei 23 Datensätzen gegenüber 11 für Qwen4-Max, kostet weniger und hat eine mediane Antwortzeit von weniger als der Hälfte. Gemini 3.8 Flash ist bei ähnlichem Preis nahezu gleichauf, erzielt im Durchschnitt aber einen höheren Wert. Gegen Kimi K3.1 Pro gewinnt Qwen4-Max bei 21 Datensätzen gegenüber 14 und kostet pro Bild etwa ein Viertel.
So führt die Ultralytics Platform Qwen4-Max aus#
Zwei Einstellungen beeinflussen die Ergebnisse von Qwen4-Max in Platform. Erstens wird das Modell mit Alibabas „niedrigem“ statt dem standardmäßig eingestellten „hohen“ Schlussfolgerungsaufwand ausgeführt. In den Ultralytics-Tests mit den 370 Benchmark-Bildern (den 360 bewerteten Bildern plus 10 COCO-Referenzbildern) überschritt die Standardeinstellung bei 11 Anfragen das Platform-Zeitlimit von 115 Sekunden, die Einstellung „niedrig“ bei 3 Anfragen – bei identischem mAP50. Zweitens fordert Platform von Qwen-Modellen eine kompakte JSON-Ausgabe an, da der mAP50-Wert ohne diese Ausgabe um etwa 0,02 sinkt.
Du musst dafür nichts tun: Wähle Qwen4-Max in der Modellauswahl aus, und Platform übernimmt beide Einstellungen.
Was ein Qwen4-Max-Annotationslauf kostet#
Die Anbieterkosten basieren auf dem von Alibaba angegebenen Tokenverbrauch, berechnet zu den Platform-Tarifen für das Modell pro 1.000 erfolgreich annotierte Bilder. Deine Bilder können mehr oder weniger Tokens verbrauchen. Für Batch Annotation fällt zusätzlich eine Platform-Bearbeitungsgebühr von 1,00 $ pro 1.000 Bilder an, mindestens jedoch 0,01 $ pro Lauf.
| Pro 1.000 Bilder | Qwen4-Max |
|---|---|
| Gebühren von Alibaba | $5.68 |
| Bearbeitung durch die Ultralytics Platform | $1.00 |
| Gesamt | $6.68 |
Du zahlst Alibaba direkt über deinen eigenen API-Schlüssel, auch für die Testvorhersagen, die du zuerst ausführst. Ultralytics berechnet keinen Aufschlag auf die Tokens. Wenn du keinen kostenpflichtigen API-Schlüssel verwenden möchtest, läuft das gehostete Qwen3.8 27B in Platform ohne Schlüssel und erzielt auf UL37 einen mAP50-Wert von 0,351.
So verwendest du die automatische Annotation mit Qwen4-Max in der Ultralytics Platform#
Qwen4-Max ist ein Modell mit Klassenprompting für Erkennungsdatensätze mit 1 bis 200 Klassen. Das Modell gibt Begrenzungsrahmen für die eigenen Klassennamen deines Datensatzes zurück, die du anschließend prüfst und korrigierst.
- Erstelle in Alibaba Cloud Model Studio einen API-Schlüssel für die internationale Region (Singapur), deren Endpunkt Platform verwendet.
- Bitte den Workspace-Inhaber, den Schlüssel unter Alibaba in den Einstellungen > API-Schlüssel des Workspaces hinzuzufügen, in dem dein Datensatz gespeichert ist. Weitere Informationen findest du in der Dokumentation zu Anbieterschlüsseln.
- Wechsle im Annotationseditor in den Modus Smart und wähle Qwen4-Max unter Alibaba in der Modellauswahl aus.
- Klicke bei einigen Bildern, die für deine Daten repräsentativ sind, auf Vorhersagen, oder verwende
P. - Wenn du mit den Ergebnissen zufrieden bist, öffne die Datensatzseite und wähle Weitere Aktionen > Batch Annotation, um alle noch nicht beschrifteten Bilder zu annotieren. Batch Annotation funktioniert mit in Platform gehosteten Datensätzen mit bis zu drei Bildkanälen. Platform speichert vorher eine Datensatzversion, sodass du die Änderungen rückgängig machen kannst.
- Überprüfe die Begrenzungsrahmen, speichere sie und trainiere ein Ultralytics YOLO26-Modell mit den Ergebnissen im selben Workspace.
Die Dokumentation zur Annotation erläutert den Smart-Modus und Batch Annotation ausführlich. Unser Leitfaden zur Auswahl eines VLM anhand von Präzision und Trefferquote hilft dir dabei, ein Modell für deinen Prüfablauf auszuwählen.
Für wen eignet sich Qwen4-Max?#
| Wenn du Folgendes brauchst … | Beginne mit |
|---|---|
| Ein kostenpflichtiges Allzweckmodell für Annotationen | GPT-6.1 Terra: höherer UL37-Wert, geringere Kosten und schneller als Qwen4-Max |
| Entwürfe für Röntgenaufnahmen von Kinderhandgelenken zur Prüfung durch Fachleute | Qwen4-Max: höchster UL37-Wert unter 51 Modellen bei diesem Datensatz |
| Dicht bestückte Verkaufsregale oder Unterwasseraufnahmen | Qwen4-Max – und vergleiche das Modell mit Gemini 4 Carbon anhand deiner Bilder |
| Ein Alibaba-Modell oder der Wechsel von Qwen3.8-Max | Qwen4-Max: höhere Werte, geringere Kosten pro Bild, keine fehlgeschlagenen Anfragen in unserem Test |
| Kein kostenpflichtiger API-Schlüssel | Gehostetes Qwen3.8 27B, Gemma 4 26B oder SAM 3.1 Text in Platform |
Für die meisten Annotationsaufgaben bleibt GPT-6.1 Terra die bessere Standardwahl. Qwen4-Max lohnt sich, wenn deine Daten den herausragenden Datensätzen des Modells ähneln. Teste es daher zuerst mit einer Stichprobe deiner eigenen Bilder.
Häufig gestellte Fragen
Im Benchmark belegt das Modell Platz 13 von 51 und erzielt einige herausragende Ergebnisse. In unserem UL37-Benchmark erreicht es 0,474 mAP50 und belegt unter 51 Modellen Platz 13. Keine Anfrage ist fehlgeschlagen. Bei Röntgenaufnahmen von Kinderhandgelenken liegt das Modell auf Platz 1 von 51, bei Unterwasserobjekten und dicht bestückten Verkaufsregalen auf Platz 2. Bei Defekten auf Leiterplatten und Röntgenaufnahmen für Sicherheitskontrollen schneidet es jedoch schlecht ab.
Im Durchschnitt ja. Qwen4-Max erzielt 0,474 mAP50 gegenüber 0,461, kostet 5,68 $ statt 7,74 $ pro 1.000 Bilder und schließt alle Anfragen ab, während Qwen3.8-Max bei 1,7 % der Anfragen scheitert. Die Verbesserungen sind uneinheitlich: Qwen4-Max übertrifft Qwen3.8-Max bei 19 Datensätzen und liegt bei 16 darunter. Besonders deutliche Rückgänge gibt es bei der Erkennung von Tennisbällen und Gehirn-MRT.
Für die allgemeine Beschriftung erreicht GPT-6.1 Terra einen Wert von 0.560 mAP50, liegt bei 23 von 36 Datensätzen vor Qwen4-Max, kostet 4,36 $ pro 1.000 Bilder und hat eine mediane Antwortzeit von 5,1 Sekunden. Wähle Qwen4-Max, wenn deine Daten seinen stärksten Datensätzen ähneln, etwa Röntgenbildern von Handgelenken, dicht bestückten Verkaufsregalen oder Unterwasserszenen, und prüfe die Ergebnisse anhand deiner eigenen Bilder.
Qwen4-Max kann Vorschläge für Begrenzungsrahmen zur Forschungsannotation erstellen, die von Fachleuten geprüft werden; Diagnosen stellt es nicht. Bei Röntgenbildern von Handgelenken von Kindern erzielt Qwen4-Max mit 0.4975 mAP50 den höchsten UL37-Wert unter 51 Modellen, erreicht jedoch über unsere acht medizinischen Datensätze hinweg durchschnittlich 0.325 und liegt damit unter GPT-6.1 Terra mit 0.505; bei Röntgenbildern des Brustkorbs schneidet Qwen4-Max schlecht ab.
Etwa 5,68 $ an Gebühren von Alibaba: Der von Alibaba gemeldete Tokenverbrauch wird zu den Tarifen der Plattform für das Modell berechnet, und zwar pro 1.000 erfolgreich annotierte Bilder. Der internationale Listenpreis von Alibaba beträgt 1,50 $ pro Million Eingabetoken und 4,50 $ pro Million Ausgabetoken. Die Ultralytics Platform berechnet zusätzlich 1,00 $ Gebühr für die Stapelannotation pro 1.000 Bilder, sodass die Gesamtkosten etwa 6,68 $ betragen.
Erstelle einen API-Schlüssel für Alibaba Cloud Model Studio für internationale Nutzer und lass deinen Workspace-Inhaber den Schlüssel unter Alibaba in Einstellungen > API-Schlüssel hinzufügen. Wähle anschließend im Annotationseditor den Smart-Modus und Qwen4-Max aus. Teste einige Bilder, starte die Stapelannotation, prüfe die Begrenzungsrahmen und trainiere im selben Workspace ein Ultralytics YOLO26-Modell.
Verfasst von
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









