5 motivos por los que fallan los modelos de visión artificial en producción
Descubre por qué fallan los modelos de visión artificial en producción, desde las discrepancias en los datos hasta la latencia, y cómo pueden los equipos mejorar el rendimiento de los modelos en sistemas de IA visual del mundo real.
 Abirami Vina10 min de lectura
La visión artificial es ahora una tecnología clave de inteligencia artificial adoptada en la mayoría de los sectores, que permite a las máquinas interpretar y analizar datos visuales para realizar diversas tareas. Estos sistemas son compatibles con numerosas aplicaciones del mundo real, desde el diagnóstico por imagen y la robótica hasta la fabricación y la automatización del comercio minorista.
Sin embargo, crear un sistema de visión artificial no siempre es sencillo. Normalmente implica desarrollar un modelo de IA visual entrenado para identificar patrones en imágenes y vídeos con el fin de realizar tareas como la detección y el seguimiento de objetos.
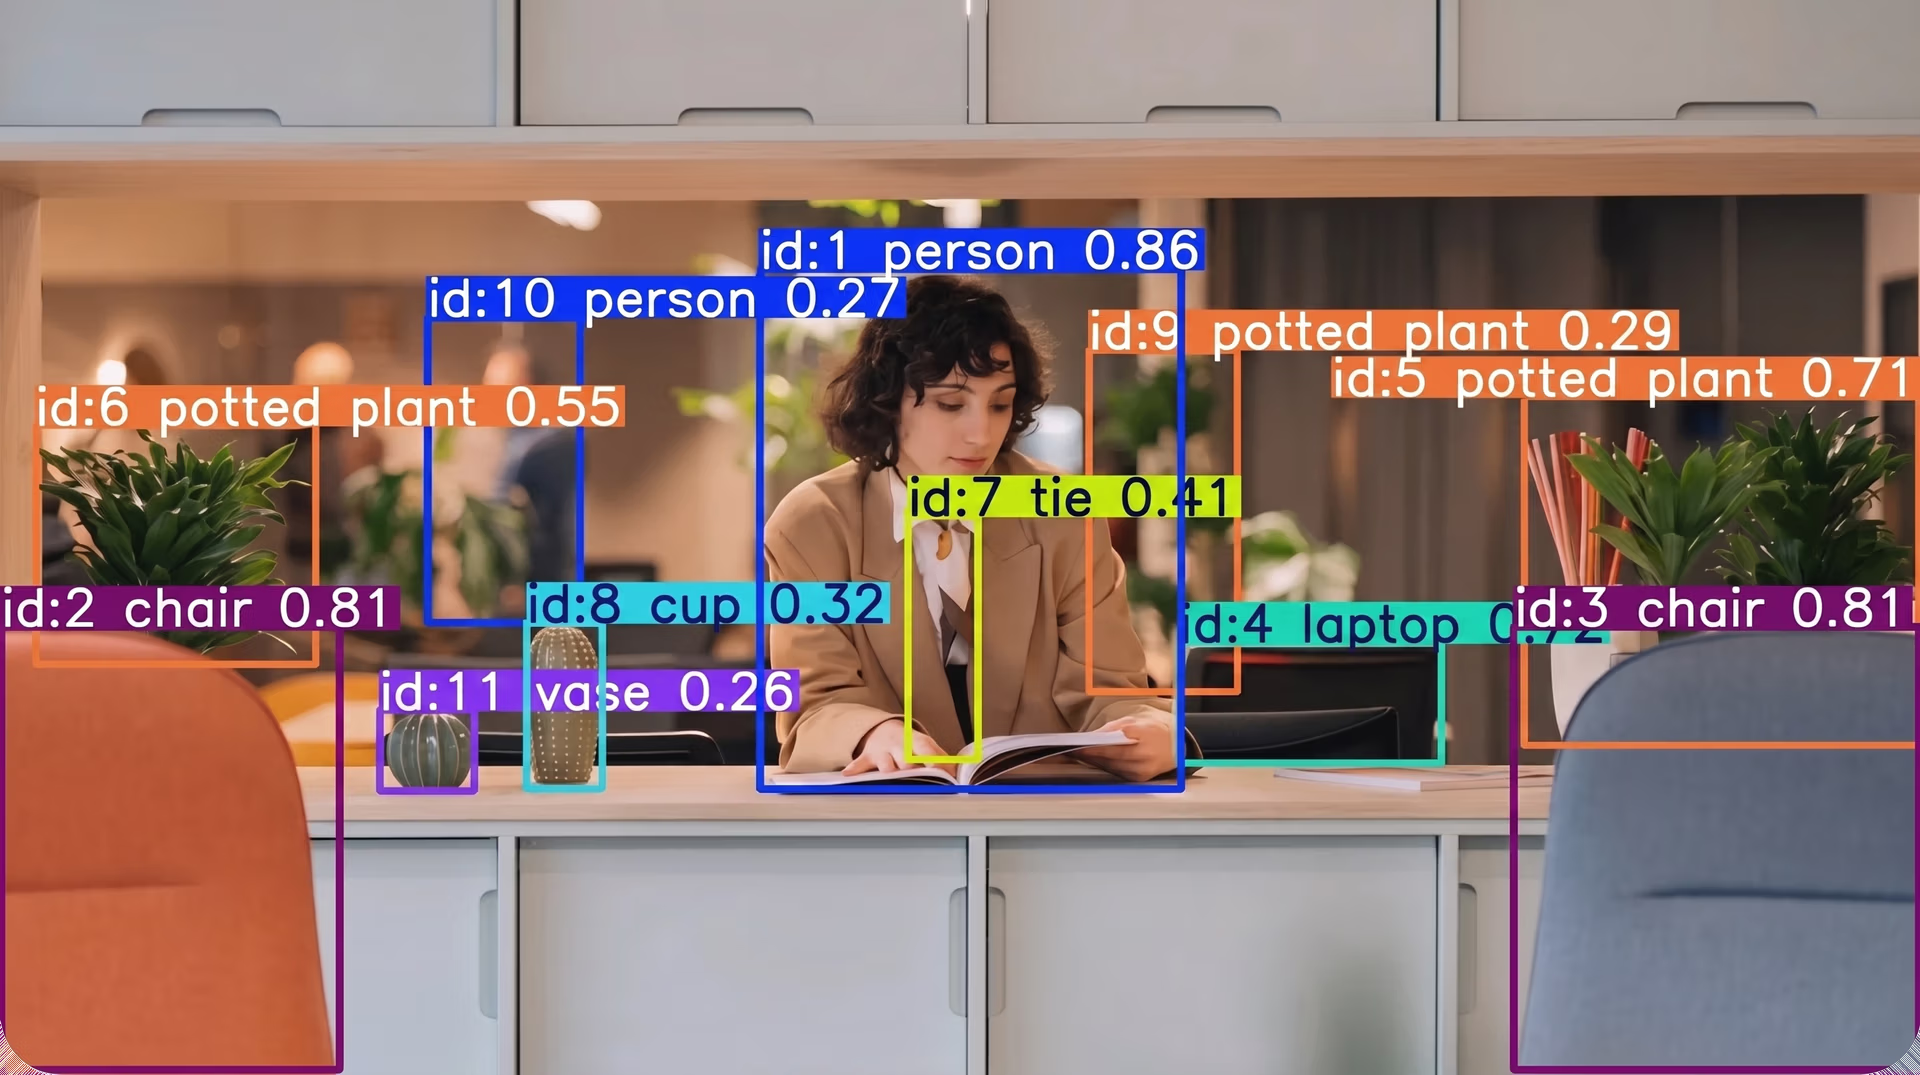
Fig. 1. Ejemplo de detección y seguimiento de objetos (Fuente)
Aunque los modelos de visión artificial se han vuelto más avanzados con los años, su comportamiento durante el desarrollo todavía puede ser distinto del que muestran tras desplegarse en entornos reales. Esto se debe a que desplegar modelos fuera de entornos de desarrollo controlados plantea dificultades nuevas y, a menudo, inesperadas.
Factores como la falta de diversidad en los conjuntos de datos, una supervisión deficiente de los modelos y las limitaciones de infraestructura pueden hacer que un mismo modelo se comporte de forma distinta en el mundo real tras su despliegue.
En este artículo exploraremos cinco motivos habituales por los que los modelos de visión artificial pueden no rendir como se espera en producción.
La brecha entre el entrenamiento del modelo y la producción#
El entrenamiento de modelos suele realizarse en un entorno controlado. Durante esta fase, los desarrolladores de IA trabajan con conjuntos de datos de entrenamiento preparados cuidadosamente.
Estas amplias colecciones de datos visuales incluyen anotaciones bien estructuradas, o etiquetas que describen el contenido de cada imagen. El entrenamiento también se lleva a cabo en condiciones uniformes, lo que permite que los modelos de IA visual aprendan patrones visuales de forma eficaz.
Para garantizar que estos patrones se aprendan correctamente, los modelos pueden evaluarse sistemáticamente durante el desarrollo mediante métricas de evaluación estándar y conjuntos de datos de referencia. Al igual que los conjuntos de datos de entrenamiento, estos conjuntos de datos de referencia también se preparan cuidadosamente.
Sin embargo, los datos con los que se encuentran los sistemas de visión artificial en el mundo real pueden ser muy distintos de los utilizados durante el entrenamiento y la evaluación. Una vez desplegados, estos modelos rara vez funcionan en condiciones controladas.
Pueden acabar procesando imágenes y vídeos de entornos impredecibles, donde la iluminación cambia constantemente, los ángulos de cámara varían y los fondos cambian con el tiempo. Por ejemplo, un modelo de IA visual entrenado para detectar tráfico puede tener dificultades para detectar vehículos de noche si se ha entrenado y evaluado principalmente con imágenes diurnas.
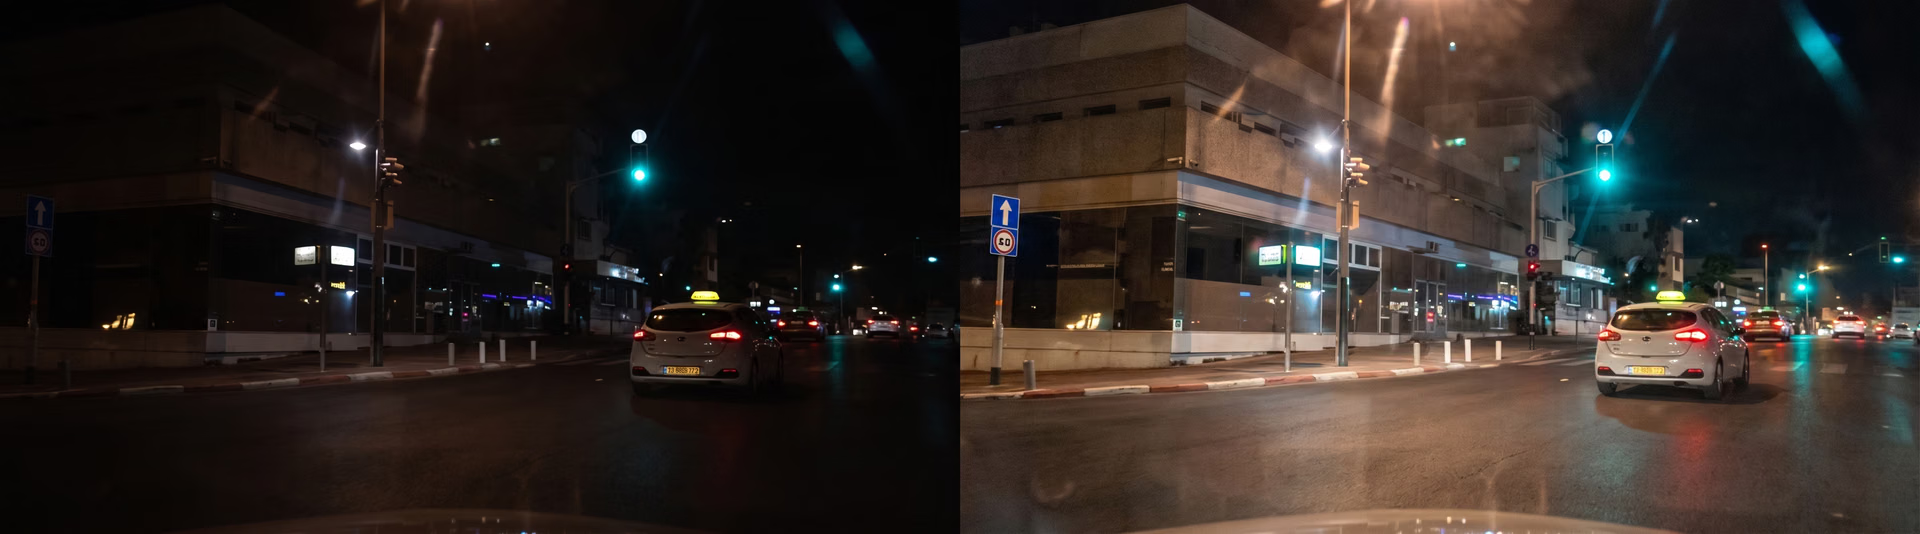
Fig. 2. Incluso tras mejorarlas, las imágenes nocturnas son difíciles de interpretar para los modelos entrenados con imágenes diurnas. (Fuente)
Esta diferencia entre el desarrollo y la implementación en el mundo real es la brecha entre el entrenamiento y la producción. Debido a esta brecha, muchos fallos de los modelos solo se hacen visibles después de la implementación, por lo que conocer pronto el camino del laboratorio a producción es fundamental para crear sistemas de visión artificial más fiables y robustos.
5 motivos habituales por los que fallan los modelos de visión artificial en producción#
A continuación, analizaremos más de cerca cinco motivos habituales por los que fallan los modelos de visión artificial en producción.
1. Conjuntos de datos de entrenamiento de baja calidad#
Los conjuntos de datos desempeñan un papel fundamental en el entrenamiento de modelos de visión artificial, porque determinan qué aprende el modelo durante el entrenamiento y cómo responde a las entradas del mundo real tras el despliegue. Esto es especialmente importante en el aprendizaje supervisado, donde los modelos aprenden a partir de ejemplos etiquetados que muestran qué representa cada imagen.
Muchos modelos de aprendizaje profundo, incluidas las redes neuronales convolucionales (CNNs), se basan en estos ejemplos etiquetados para reconocer patrones en datos visuales. Sin embargo, cuando el conjunto de datos de entrenamiento no refleja las condiciones reales, el modelo puede aprender patrones que no representan plenamente cómo aparecen los objetos fuera de los datos de entrenamiento.
Por ejemplo, un modelo entrenado con un conjunto de datos de defectos de grietas grandes podría no detectar en procesos de fabricación reales un tipo poco frecuente de grieta pequeña. Del mismo modo, la calidad de las anotaciones también puede afectar al comportamiento del modelo. Las etiquetas incoherentes o la falta de detalles en los datos etiquetados pueden hacer que el modelo aprenda información incorrecta durante el entrenamiento.
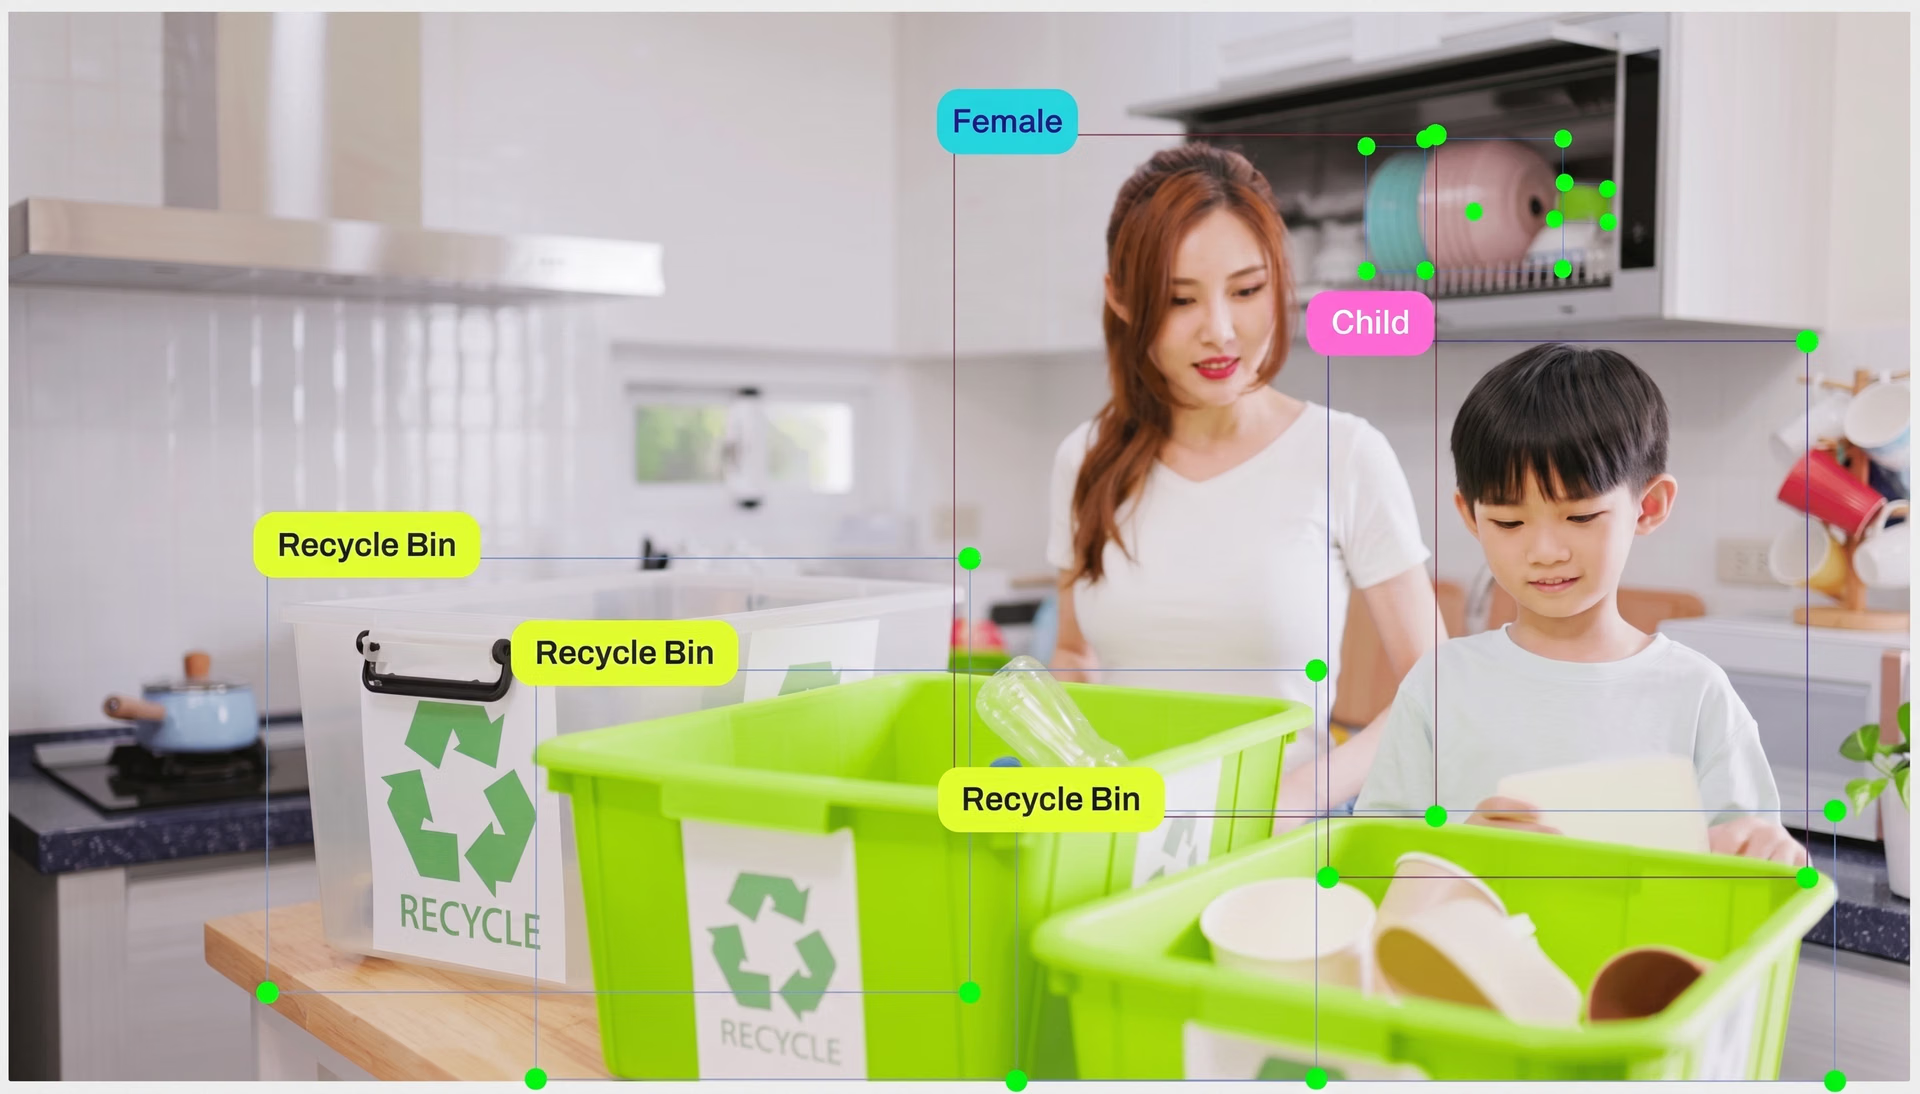
Fig. 3. Un vistazo a las anotaciones de imágenes (Fuente)
En definitiva, la calidad y la diversidad de los datos de entrenamiento son fundamentales y pueden determinar el rendimiento de un modelo en aplicaciones reales. Cuando los conjuntos de datos son representativos y están etiquetados con precisión, el modelo suele rendir de forma más fiable una vez desplegado.
2. Sobreajuste y generalización#
Los modelos de aprendizaje automático, como los modelos de visión, aprenden patrones a partir de conjuntos de datos de entrenamiento. Sin embargo, a veces un modelo puede depender demasiado de unos pocos patrones.
En lugar de aprender relaciones visuales más amplias, puede acabar memorizando los patrones limitados de los datos de entrenamiento. Este comportamiento se conoce como sobreajuste.
El sobreajuste suele producirse cuando los conjuntos de datos de entrenamiento son pequeños o carecen de suficiente diversidad. En esos casos, el modelo aprende a reconocer bien las imágenes que ya ha visto, pero tiene dificultades para interpretar datos nuevos o entradas desconocidas.
Como resultado, un modelo puede rendir bien con los datos de prueba (porque son similares a los datos de entrenamiento), pero comportarse de forma distinta en nuevas condiciones tras la implementación. Por eso es fundamental el concepto de generalización. En pocas palabras, se refiere a lo bien que los modelos aplican lo aprendido durante el entrenamiento a situaciones nuevas.
Para reducir el sobreajuste, los profesionales suelen entrenar los modelos con conjuntos de datos más diversos y aplicar el aumento de datos, un método que modifica ligeramente las imágenes de entrenamiento para aumentar su variedad. Sin tener en cuenta estos aspectos, el rendimiento del modelo puede caer rápidamente cuando el sistema empieza a funcionar en entornos reales.
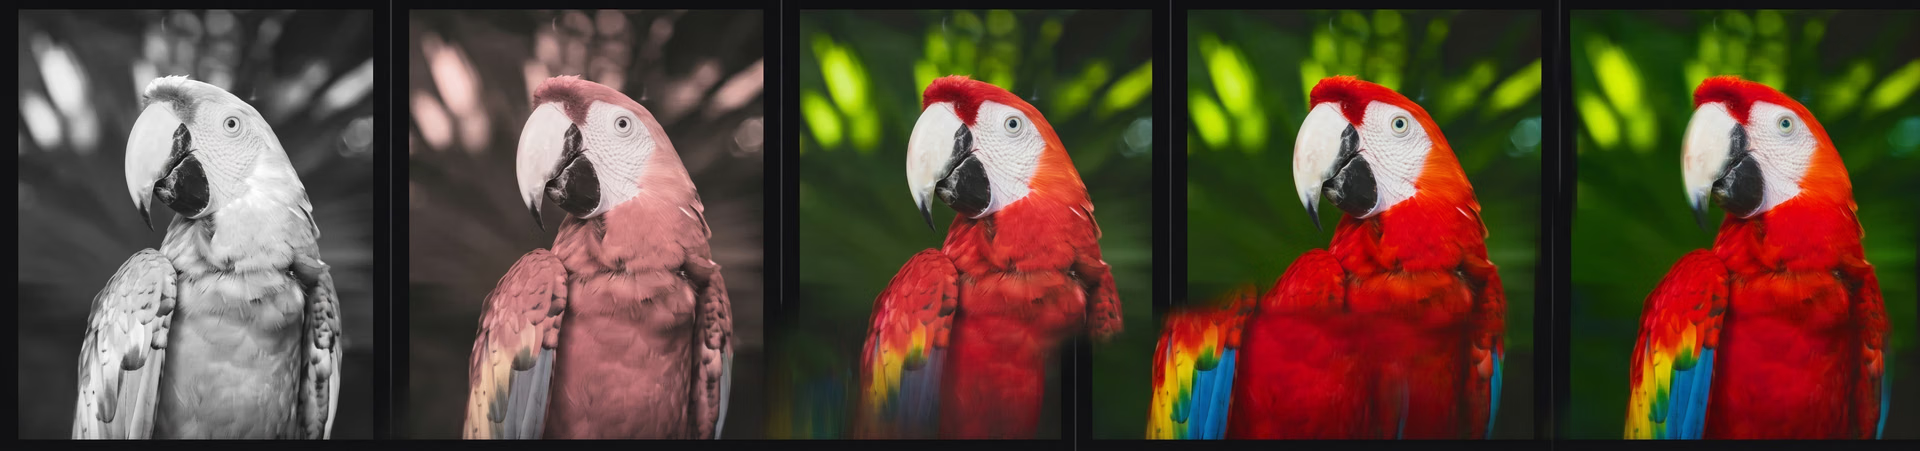
Fig. 4. El aumento de datos puede ayudar a crear variaciones de una misma imagen dentro de un conjunto de datos. (Fuente)
3. Casos límite ocultos en entornos reales#
Aunque los modelos de visión artificial generalicen bien a datos nuevos, los entornos reales todavía pueden presentar casos límite inesperados. Se trata de situaciones poco habituales que difieren de los patrones típicos que el modelo aprende durante el entrenamiento.
Muchos de estos escenarios son difíciles de reproducir durante el desarrollo porque se dan con poca frecuencia, cuesta recrearlos o puede resultar caro recopilarlos como datos de entrenamiento. Por ejemplo, los objetos pueden presentar formas poco habituales, moverse de manera impredecible o quedar parcialmente ocultos detrás de otros objetos.
Los cambios en la iluminación, los ángulos de cámara o las condiciones del fondo también pueden crear situaciones que dificulten el reconocimiento. Estos casos límite suelen hacerse evidentes solo después de desplegar el sistema en aplicaciones reales.
Por ejemplo, en robótica y automatización de la fabricación, los objetos pueden colocarse o situarse de forma distinta a la esperada, creando situaciones para las que el modelo no se diseñó. En definitiva, las predicciones que parecían fiables durante las pruebas pueden volverse menos uniformes cuando el sistema funciona en entornos reales.
4. Falta de supervisión y depuración tras el despliegue#
Además de desarrollar un modelo de IA visual, es esencial supervisar y mejorar su rendimiento. Sin embargo, una vez que el sistema está en funcionamiento, la atención suele centrarse simplemente en mantenerlo operativo, en lugar de hacer un seguimiento minucioso de su rendimiento a lo largo del tiempo. Como resultado, los cambios en el comportamiento del modelo pueden pasar desapercibidos.
Al mismo tiempo, factores como los cambios en los datos de entrada, la configuración de las cámaras o los entornos operativos pueden afectar gradualmente a la precisión con la que el modelo detecta o clasifica objetos. Estos cambios no siempre son evidentes y pueden pasar inadvertidos durante el funcionamiento diario.
Supervisar las salidas del modelo y el comportamiento general del sistema puede ayudar a los equipos a identificar estos problemas antes. Las comprobaciones periódicas, los procesos de validación y los flujos de trabajo de depuración permiten a los equipos investigar resultados inusuales y entender qué puede estar causándolos.
En ámbitos como la fabricación, un modelo podría empezar de repente a identificar incorrectamente objetos en una cadena de montaje tras un cambio en la configuración de la cámara. Hacer un seguimiento del comportamiento de un sistema de IA visual desplegado facilita la respuesta a estos cambios y permite mantener un rendimiento estable en entornos reales.
5. Limitaciones de infraestructura y latencia#
Muchos sistemas de visión artificial deben funcionar en tiempo real, lo que puede ejercer una presión considerable sobre el hardware, las redes y los procesos de procesamiento. Cuando los recursos son limitados, pueden producirse retrasos de cálculo o latencia de red, haciendo que las predicciones lleguen demasiado tarde y afectando al rendimiento general del sistema.
En algunos casos, los modelos avanzados de aprendizaje profundo también pueden plantear dificultades de infraestructura. Por ejemplo, las arquitecturas basadas en Transformer están diseñadas para procesar grandes cantidades de datos visuales y aprender relaciones complejas dentro de las imágenes, pero suelen requerir muchos recursos computacionales. Ejecutar estos modelos puede exigir hardware más potente o caro.
Sin una optimización adecuada, incluso los modelos que se ejecutan rápidamente durante las pruebas pueden ralentizarse o comportarse de forma incoherente tras el despliegue. Para solucionarlo, los equipos suelen optimizar los procesos, reducir la complejidad del modelo siempre que sea posible y equilibrar la precisión con la velocidad.
Esto puede implicar comprimir modelos grandes para crear versiones más ligeras, utilizar arquitecturas más eficientes o procesar imágenes a menor resolución para que el sistema funcione con fluidez en el hardware disponible. En muchos casos, los equipos también optan por modelos ligeros y más rápidos, como Ultralytics YOLO26, para cumplir las limitaciones del despliegue.
Buenas prácticas para evitar fallos en los modelos de visión artificial#
Estas son algunas buenas prácticas que pueden ayudar a reducir los fallos al desplegar modelos de visión artificial en producción:
- Usa estrategias de despliegue por fases: Introduce los modelos en producción de forma gradual para que los equipos puedan observar su comportamiento y hacer ajustes cuando sea necesario.
- Incorpora ciclos de retroalimentación: Recopila imágenes nuevas y revisa las predicciones incorrectas para volver a entrenar los modelos con conjuntos de datos actualizados y mejorar el rendimiento con el tiempo.
- Documenta las limitaciones del modelo: Registra claramente las situaciones en las que el modelo puede tener dificultades para que los equipos puedan anticipar posibles problemas durante el despliegue.
- Diseña teniendo en cuenta la variabilidad del mundo real: Planificar con antelación las variaciones de iluminación, los ángulos de cámara, la ubicación de los objetos o las condiciones del fondo puede ayudar a que los modelos se mantengan estables en distintos escenarios operativos.
Conclusiones clave#
Los modelos de visión artificial rara vez fallan porque los algoritmos en sí sean deficientes. En la mayoría de los casos, el verdadero reto está en los entornos en los que funcionan estos sistemas. Los modelos que rinden bien durante el entrenamiento suelen encontrarse con condiciones impredecibles del mundo real que pueden afectar a su comportamiento.
Por eso, crear sistemas de IA visual fiables exige algo más que entrenar un modelo. También implica preparar cuidadosamente los conjuntos de datos, supervisar el rendimiento del modelo tras el despliegue y adaptar continuamente los sistemas a las condiciones reales.
¿Quieres profundizar en la IA visual? Únete a nuestra comunidad y descubre aplicaciones como la IA en la automoción y la visión artificial en la logística. Consulta nuestras opciones de licencia para empezar tus proyectos de visión artificial. Visita nuestro repositorio de GitHub para obtener más información.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









