Exportar Ultralytics YOLO a LiteRT
Descubre cómo la nueva integración de exportación a LiteRT lleva la inferencia de Ultralytics YOLO a entornos móviles, integrados, edge y de navegador en un único formato unificado.
En Ultralytics, observamos una tendencia creciente a ejecutar modelos de visión artificial directamente en los dispositivos donde se necesitan, en lugar de depender de una conexión a la nube. Las aplicaciones móviles, los sistemas integrados, los sensores IoT y las herramientas basadas en el navegador necesitan cada vez más ejecutar inferencias localmente, a menudo en hardware con limitaciones estrictas de consumo energético y capacidad de cálculo. Por eso, nos complace anunciar que ahora se pueden exportar directamente los modelos Ultralytics YOLO a LiteRT.
Para responder a esa demanda, hace falta un formato de modelo que funcione en todos estos entornos sin obligar a los desarrolladores a mantener un flujo de exportación distinto para cada uno.
Esta capacidad ya existía gracias a un paquete no oficial de terceros, pero esta nueva integración es fruto de una colaboración oficial con Google. Hemos trabajado estrechamente con el equipo de LiteRT para crear un flujo integral que permite exportar modelos Ultralytics YOLO a TFLite mediante LiteRT. Con esta integración, un único modelo Ultralytics YOLO exportado se implementa en entornos móviles, integrados, edge y de navegador, y unifica en un solo formato optimizado las funciones que antes se repartían entre los formatos de exportación TFLite y TF.js.
¿Qué es LiteRT?#
LiteRT (abreviatura de Lite Runtime) es el entorno de ejecución de alto rendimiento de Google para la IA en el dispositivo. Es la nueva generación y el nuevo nombre de TensorFlow Lite (TFLite), y ejecuta el mismo formato de modelo .tflite que los desarrolladores ya conocen.
LiteRT es un framework de código abierto diseñado específicamente para la inferencia en el dispositivo, también conocida como computación en el edge. Proporciona a los desarrolladores herramientas para ejecutar modelos entrenados en dispositivos móviles, integrados e IoT, en ordenadores convencionales y, mediante LiteRT.js, directamente en navegadores web y Node.js. El formato de exportación LiteRT optimiza los modelos para tareas como la detección de objetos, la segmentación, la estimación de pose y la clasificación, para que se ejecuten rápido y sin conexión en una amplia variedad de dispositivos.
¿Por qué exportar modelos Ultralytics YOLO a LiteRT?#
Ahora, un solo formato de modelo cubre todos los destinos de implementación:
• Móviles e integrados. Android, iOS, ordenadores de sobremesa, Linux integrado y microcontroladores (MCU).
• Aceleradores edge. Compatible con Coral Edge TPU para acelerar aún más el procesamiento.
• Navegador y Node.js. LiteRT.js ejecuta el mismo modelo .tflite en la web con aceleración WebGPU/WASM, por lo que ya no hace falta exportar por separado a TensorFlow.js.
• Ordenador de sobremesa
Esta consolidación es importante porque elimina una fuente real de fricción en las implementaciones de producción. En lugar de mantener un flujo de exportación para móviles, otro para el navegador y un tercero para los aceleradores edge, los equipos pueden exportar una sola vez e implementar el modelo en cualquier entorno donde se ejecute LiteRT.
Características principales de los modelos LiteRT#
• Optimización en el dispositivo. Reduce la latencia al procesar los datos localmente, mejora la privacidad al no transmitir datos personales y minimiza el tamaño del modelo para ahorrar espacio.
• Compatibilidad con varias plataformas. Se ejecuta en Android, iOS, Linux integrado, microcontroladores y navegadores web modernos.
• Aceleración por hardware. Aprovecha XNNPACK en CPU y la aceleración de GPU mediante OpenCL, Metal y WebGPU. La aceleración de GPU se ejecuta en FP16 de forma predeterminada para ofrecer más velocidad.
• Cuantización. Admite FP32, INT8 estático, activaciones INT16 estáticas e INT8 dinámico para comprimir los modelos y acelerar la inferencia con una pérdida mínima de precisión.
• Compatibilidad con diversos lenguajes. Compatible con Java/Kotlin, Swift, Objective-C, C++, Python y JavaScript.
Primeros pasos con la exportación a LiteRT#
El paquete Python de Ultralytics y Ultralytics Platform ofrecen un entorno completo y unificado para entrenar, evaluar e implementar modelos YOLO en las cinco tareas de visión artificial. El formato de exportación LiteRT admite los modos Exportar, Predecir y Validar, de modo que puedes exportar un modelo y utilizarlo inmediatamente para inferencias o para validar su precisión localmente.
Exportar un modelo requiere un único comando:
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato LiteRT
model.export(format="litert") # crea 'yolo26n.tflite'
Para los equipos que implementan modelos en hardware con recursos limitados, LiteRT también admite la exportación cuantizada, que permite comprimir los modelos para acelerar la inferencia con una pérdida mínima de precisión:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# INT8 dinámico: pesos int8, activaciones FP32; no requiere datos de calibración
model.export(format="litert", quantize="w8a32")

# INT8 estático: pesos int8 y activaciones int8; requiere datos de calibración
model.export(format="litert", quantize=8, data="coco8.yaml")
Una vez exportado, puedes cargar el modelo y ejecutar inferencias directamente:
from ultralytics import YOLO

# Carga el modelo LiteRT exportado
model = YOLO("yolo26n.tflite")

# Ejecuta la inferencia
results = model("https://ultralytics.com/images/bus.jpg")
Actualmente, la exportación a LiteRT es compatible con Linux x86_64 y macOS. El modelo .tflite exportado se ejecuta en todas las plataformas compatibles con LiteRT, incluidos móviles, sistemas integrados, dispositivos edge y navegadores.
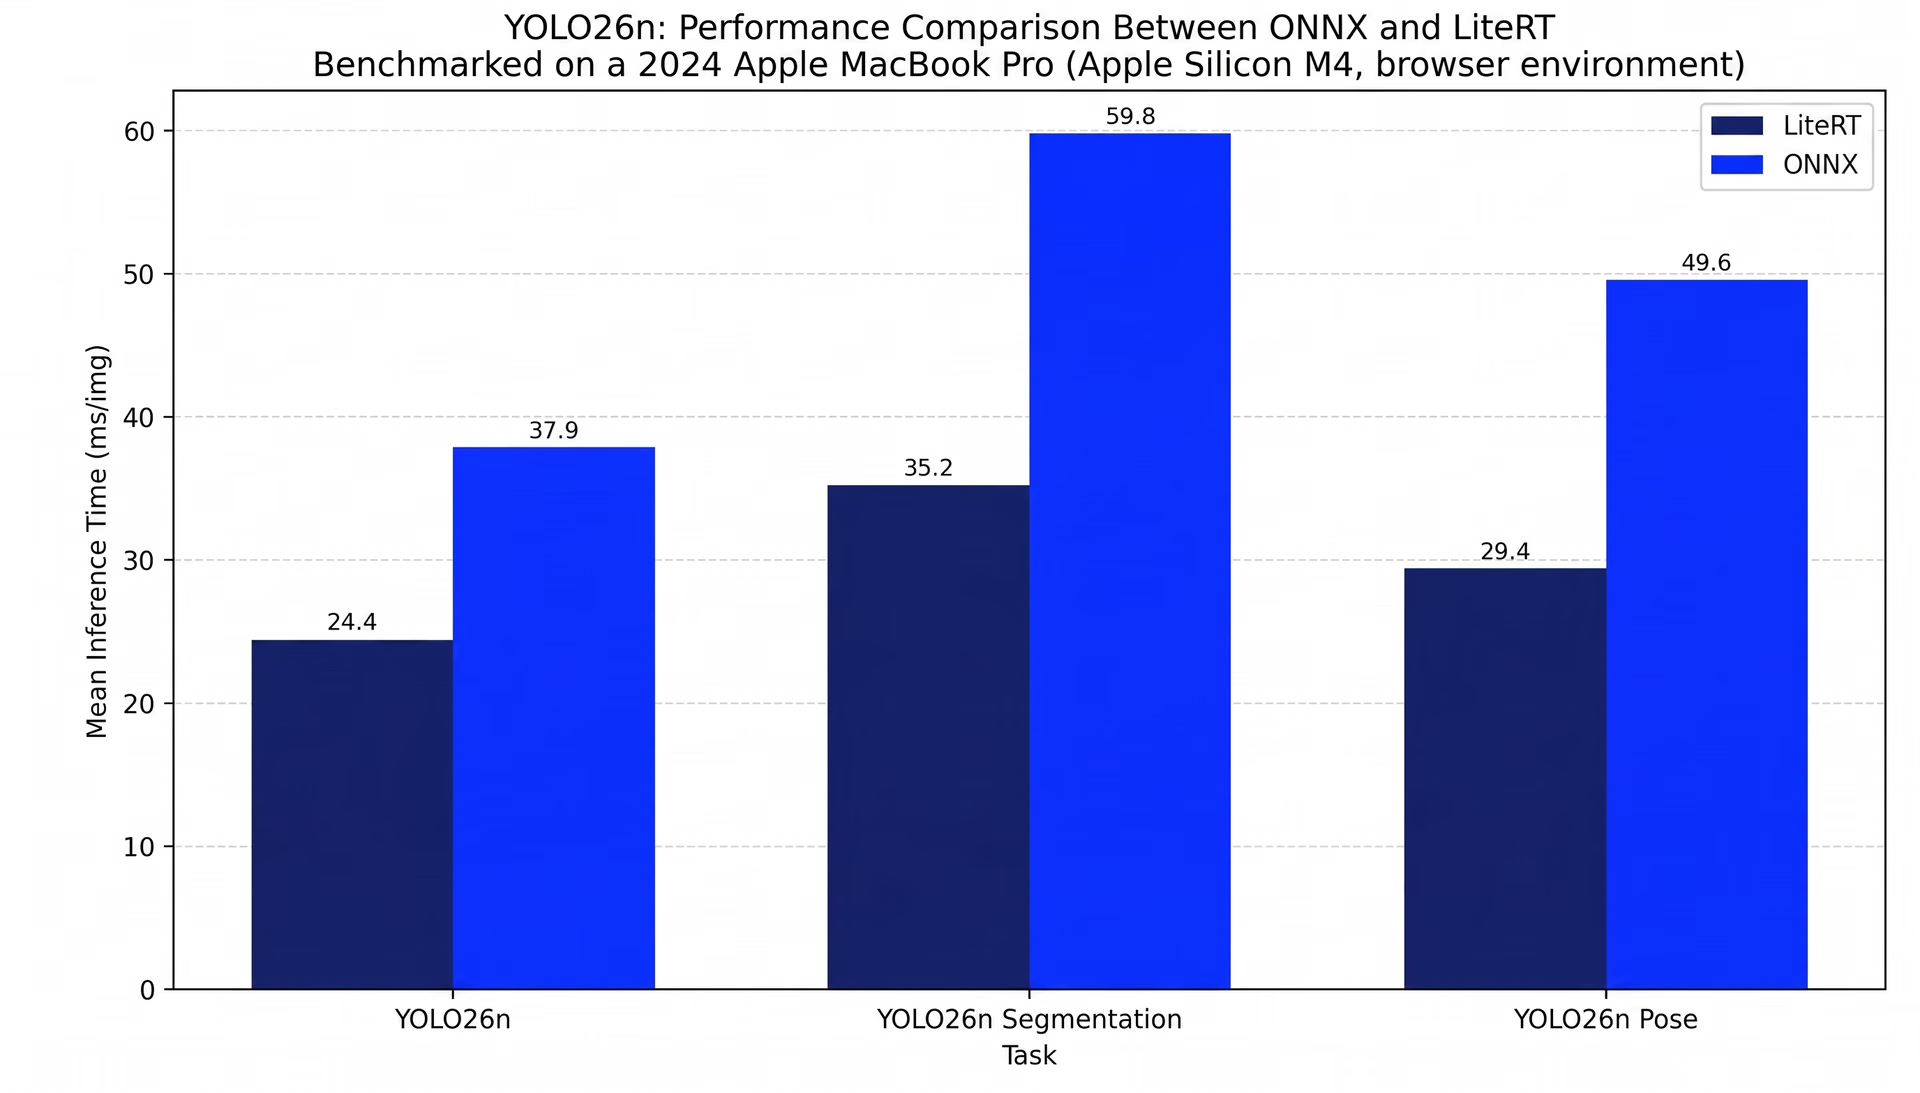 Fig. 1. Comparación del rendimiento entre ONNX y LiteRT.
La imagen anterior compara el tiempo medio de inferencia para detección, segmentación y estimación de pose con YOLO26n, ejecutado en el navegador mediante @ultralytics/yolo, el paquete npm de Ultralytics para inferencias en el cliente con WebGPU/WASM mediante ONNX Runtime Web. Pruebas realizadas en un Apple MacBook Pro de 2024 (Apple Silicon M4) en un entorno de navegador controlado.
Llevamos Ultralytics YOLO al edge#
Con LiteRT, implementar modelos Ultralytics YOLO en entornos móviles, integrados, edge y de navegador ya no requiere flujos de exportación distintos para cada destino. Una exportación, un formato de modelo y una ruta coherente desde el entrenamiento hasta la producción, allí donde se necesite ejecutar la inferencia.
¿Te interesa la IA visual? Descubre nuestras opciones de licencia para incorporar la visión artificial a tus proyectos. Visita nuestro repositorio de GitHub para explorar todas las integraciones de exportación de Ultralytics y echa un vistazo a Ultralytics Platform para empezar a crear tus propios flujos de trabajo integrales de IA visual.









