Cómo simplifica Ultralytics Platform el despliegue de modelos de visión artificial
Descubre cómo Ultralytics Platform reúne todo lo necesario para desplegar modelos de visión artificial, desde las pruebas hasta las API listas para producción.
Ultralytics lleva años colaborando con la comunidad de visión artificial, creando modelos y herramientas que hacen que la IA de visión sea más accesible para todo el mundo. Con Ultralytics Platform, damos un paso más al reunir todo el flujo de trabajo de desarrollo de visión artificial en un entorno unificado, desde la gestión y anotación de conjuntos de datos hasta el entrenamiento, la validación y la implementación de modelos.
En particular, nos entusiasma facilitar la implementación de modelos de visión artificial. A medida que la visión artificial se incorpora a aplicaciones del mundo real, analizar imágenes y vídeos fuera de entornos controlados sigue siendo complejo.
A diferencia de los entornos de prueba, en los que las condiciones son predecibles, los escenarios del mundo real implican una iluminación variable, entradas cambiantes y cargas de trabajo impredecibles, lo que convierte la implementación en una de las partes más difíciles del flujo de trabajo de visión.
La implementación implica mucho más que poner un modelo a disposición para su uso. Requiere configurar procesos capaces de gestionar datos del mundo real y garantizar que todo funcione correctamente a medida que aumenta el uso y escalan los proyectos.
Los equipos también necesitan hacer un seguimiento del rendimiento y mantener la fiabilidad a lo largo del tiempo. Esto suele implicar cambiar entre distintas herramientas de IA para las pruebas, la integración, la implementación y la supervisión, lo que puede ralentizar el desarrollo de modelos y añadir complejidad innecesaria.
Los flujos de trabajo acaban fragmentándose. Ultralytics Platform unifica y simplifica este proceso.
Ofrece compatibilidad integrada con el servicio, las pruebas y la supervisión de modelos dentro de un único entorno. Los equipos pueden validar modelos mediante inferencia en el navegador, integrarlos en aplicaciones a través de servicios de inferencia compartidos e implementarlos en endpoints dedicados con funciones de supervisión del rendimiento.
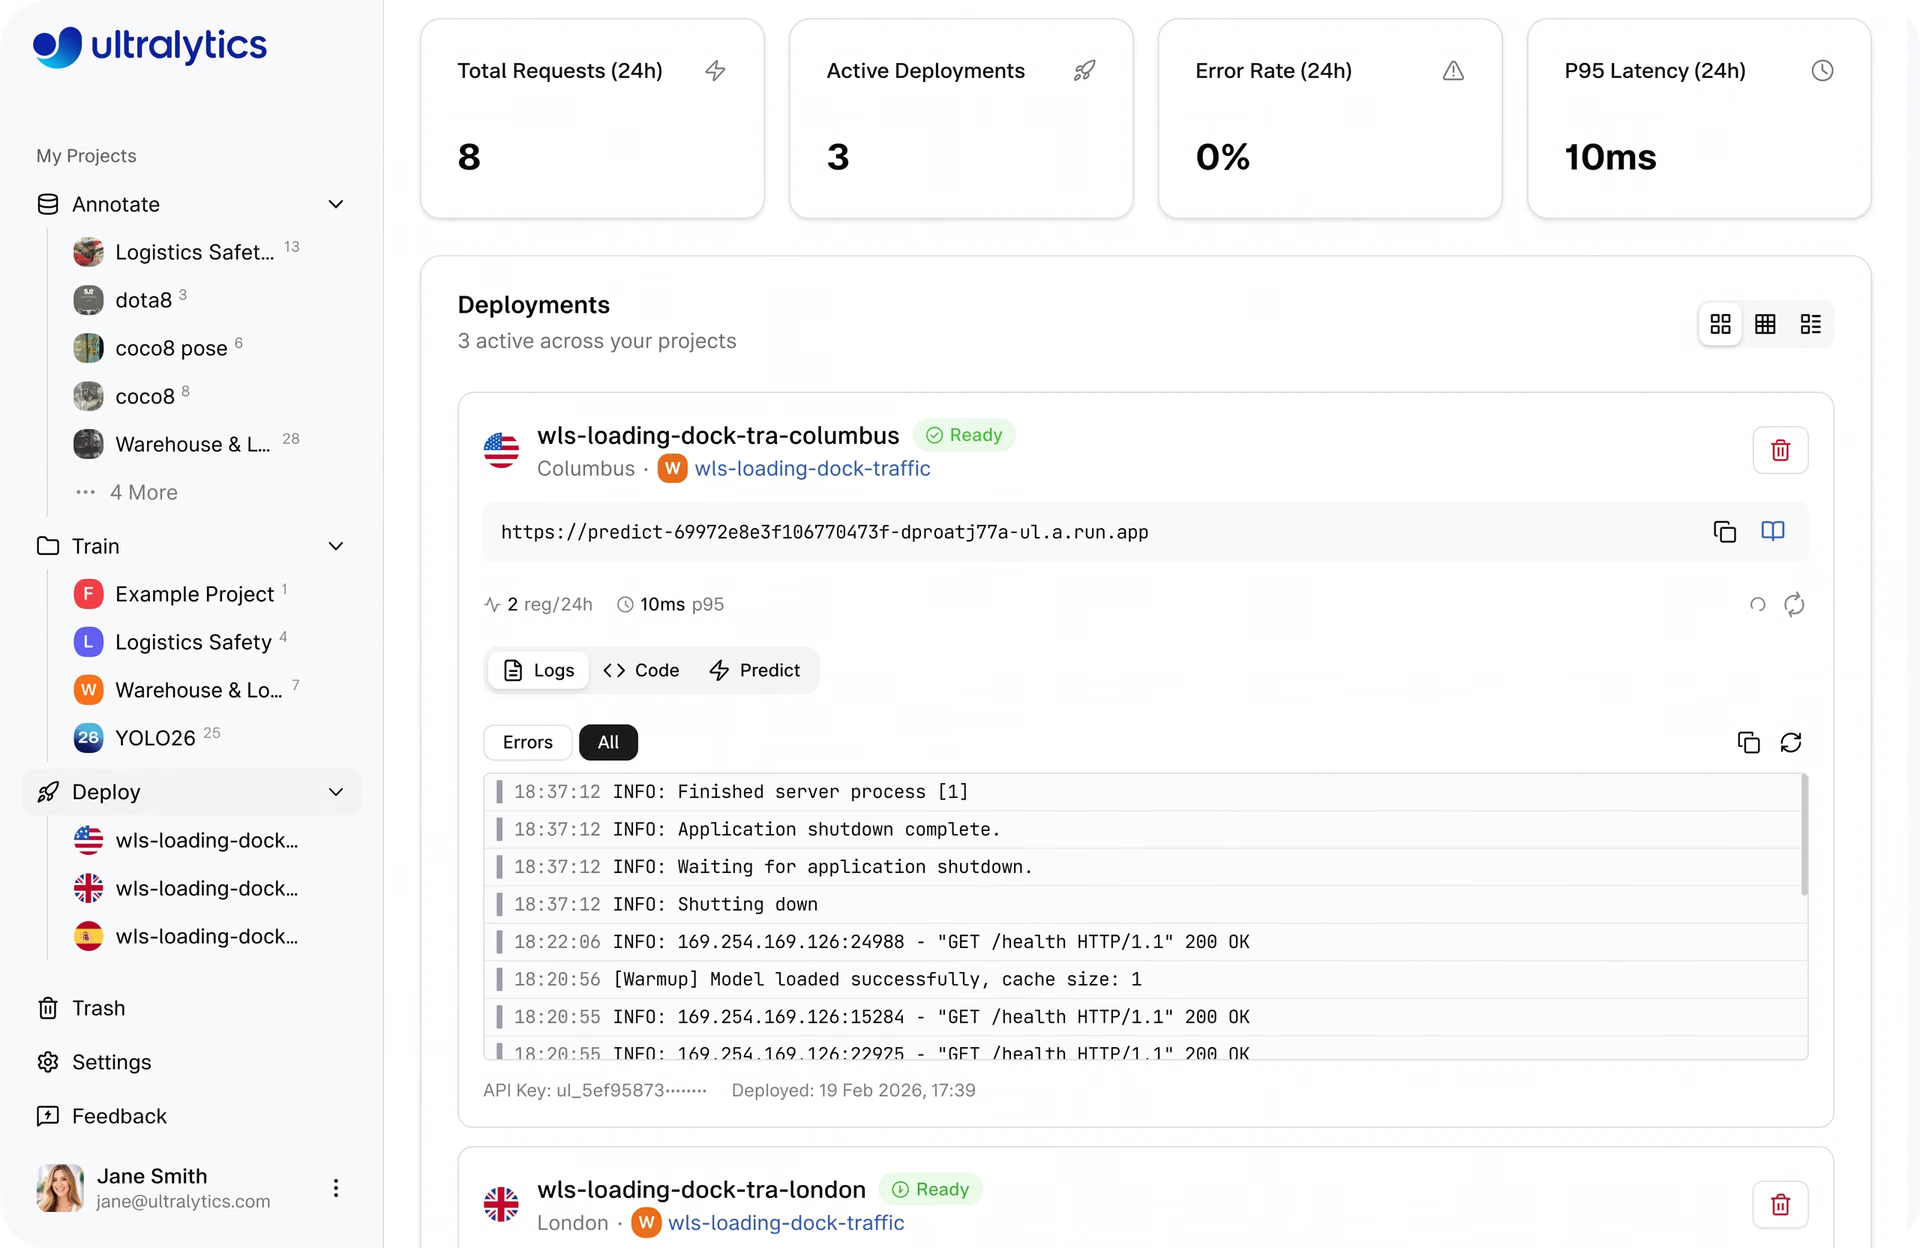
Fig. 1. Vista de la página de implementación de Ultralytics Platform (Fuente)
En este artículo, exploraremos cómo Ultralytics Platform redefine la implementación de modelos de visión artificial, desde las pruebas y la integración hasta la implementación en producción y la supervisión. ¡Empecemos!
Descripción general de la implementación de modelos de visión artificial#
En el ciclo de vida del aprendizaje automático, la implementación de modelos es la etapa en la que un modelo pasa de la experimentación al uso en el mundo real. En el caso de los modelos de visión artificial creados mediante aprendizaje profundo y redes neuronales convolucionales, esto generalmente significa ponerlos a disposición para procesar imágenes y vídeos en tiempo real.
Una vez implementados, estos modelos reciben datos nuevos, que normalmente pasan por pasos de preprocesamiento como el cambio de tamaño, la normalización o el formateo. A continuación, los datos procesados se introducen en el modelo, que aplica los patrones aprendidos durante el entrenamiento para generar predicciones de gran precisión.
Según el caso de uso, esto puede incluir distintas tareas de visión artificial. Por ejemplo, los modelos Ultralytics YOLO, como Ultralytics YOLO26, admiten una amplia variedad de tareas de visión, como la detección de objetos, la clasificación de imágenes, la segmentación de instancias, la estimación de poses y la detección de cajas delimitadoras orientadas (OBB).
Para que esto resulte práctico en aplicaciones del mundo real, los modelos suelen tener que integrarse en sistemas capaces de gestionar de forma eficiente tanto el preprocesamiento como la inferencia. Aquí es donde la infraestructura de implementación se vuelve esencial.
En entornos de producción, normalmente se accede a los modelos mediante REST API o sistemas de servicio de modelos. Estas interfaces permiten a las aplicaciones enviar datos y recibir predicciones mediante programación, lo que facilita la integración con aplicaciones externas, dispositivos IoT o sistemas robóticos que dependen de la comprensión visual en tiempo real.
Limitaciones de las herramientas tradicionales de implementación de visión artificial#
La implementación de modelos de visión artificial puede parecer sencilla, pero hasta ahora ha sido bastante diferente en la práctica. Considera una configuración habitual: primero se capturan datos de cámaras o sensores, se envían a un modelo para realizar la inferencia y, después, se devuelven a una aplicación en forma de predicciones.
En realidad, cada uno de estos pasos suele gestionarse mediante herramientas y servicios independientes. Un sistema puede encargarse de la captura de datos, otro gestionar el servicio de modelos y otras herramientas adicionales utilizarse para el escalado, la supervisión y el registro. Mantener estos componentes conectados y funcionando de forma fiable puede volverse complejo rápidamente.
A medida que aumenta el uso, esta complejidad crece. Gestionar la infraestructura, controlar las dependencias y mantener un rendimiento uniforme en todo el flujo de extremo a extremo puede ralentizar el desarrollo y dificultar la implementación de modelos de visión artificial en aplicaciones del mundo real.
Ultralytics Platform reúne estos componentes en un único entorno unificado. Esto proporciona una forma más cohesionada de gestionar todo el flujo de trabajo de implementación, al tiempo que ofrece rendimiento y fiabilidad a escala.
Opciones de implementación de modelos disponibles en Ultralytics Platform#
Además de unificar el proceso de implementación de modelos, Ultralytics Platform también aporta flexibilidad a la forma de implementar y utilizar los modelos.
Para admitir las distintas etapas de la implementación de modelos de visión artificial, la plataforma ofrece cuatro opciones: pruebas en el navegador con inferencia instantánea, inferencia compartida mediante API para el desarrollo, endpoints dedicados para implementaciones de producción escalables en regiones de todo el mundo y exportación de modelos para ejecutarlos en infraestructura externa o dispositivos periféricos.
Veamos más de cerca cómo funciona cada una de estas opciones.
Valida modelos rápidamente mediante la pestaña Predict#
Antes de pasar un modelo a producción, es importante comprender cómo funciona con datos nuevos que no haya visto. Ultralytics Platform incluye una pestaña Predict integrada que te permite ejecutar inferencias directamente en el navegador, sin configuración, infraestructura ni dependencias.
La pestaña Predict hace que la validación de modelos sea rápida e interactiva. Puedes cargar imágenes, utilizar ejemplos precargados o capturar entradas con una cámara web, y la inferencia se ejecuta automáticamente en cuanto se proporcionan los datos.
Los resultados aparecen al instante con superposiciones visuales, puntuaciones de confianza y salidas detalladas, lo que te ofrece una visión clara del comportamiento del modelo.
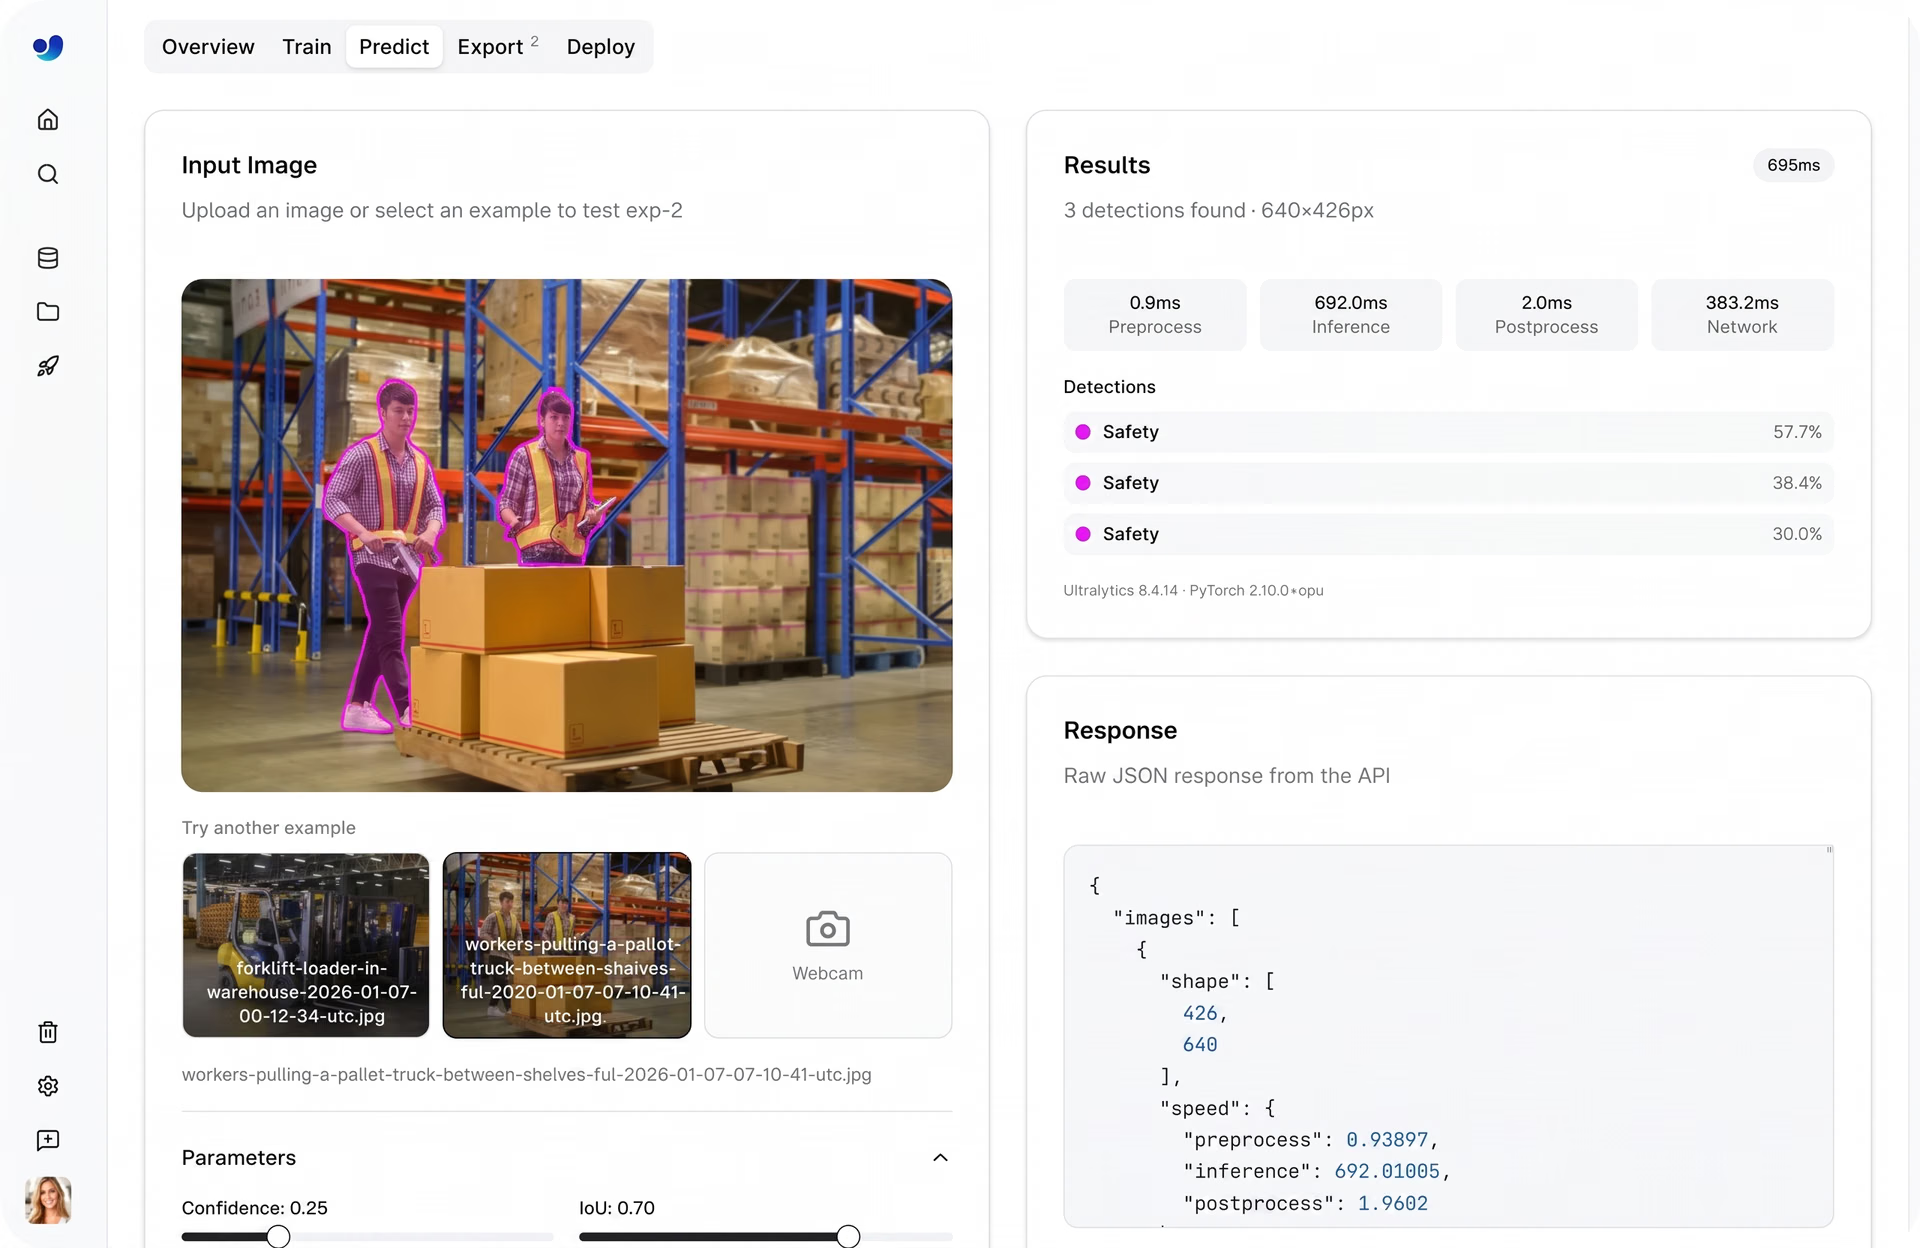
Fig. 2. Ejemplo de validación de un modelo mediante la pestaña Predict (Fuente)
Esto significa que, con unos pocos clics, puedes probar distintas entradas, ajustar parámetros y evaluar el rendimiento en una única interfaz antes de pasar a la implementación.
Ejecución de inferencias compartidas para pruebas o un uso moderado#
Supongamos que has entrenado un modelo y lo has validado mediante la pestaña Predict. El siguiente paso suele ser empezar a integrar ese modelo en una aplicación o flujo de trabajo.
En lugar de configurar infraestructura o gestionar servidores, Ultralytics Platform ofrece servicios de inferencia compartidos que te permiten enviar datos a tu modelo y recibir predicciones mediante REST API sencillas.
Entre bastidores, la inferencia compartida se ejecuta en un sistema multiinquilino distribuido en varias regiones principales, donde las solicitudes se dirigen automáticamente al servicio disponible más cercano. Esto ayuda a mantener un rendimiento ágil y permite que los usuarios de distintas ubicaciones accedan a los modelos de forma coherente.
Puedes enviar entradas mediante solicitudes HTTP estándar y recibir a cambio salidas estructuradas, lo que facilita la conexión de modelos con aplicaciones, scripts o flujos de automatización. Esta configuración es una excelente opción para el desarrollo, las pruebas, las integraciones o un uso más ligero antes de pasar a implementaciones de producción más escalables.
Implementa modelos globalmente mediante endpoints dedicados#
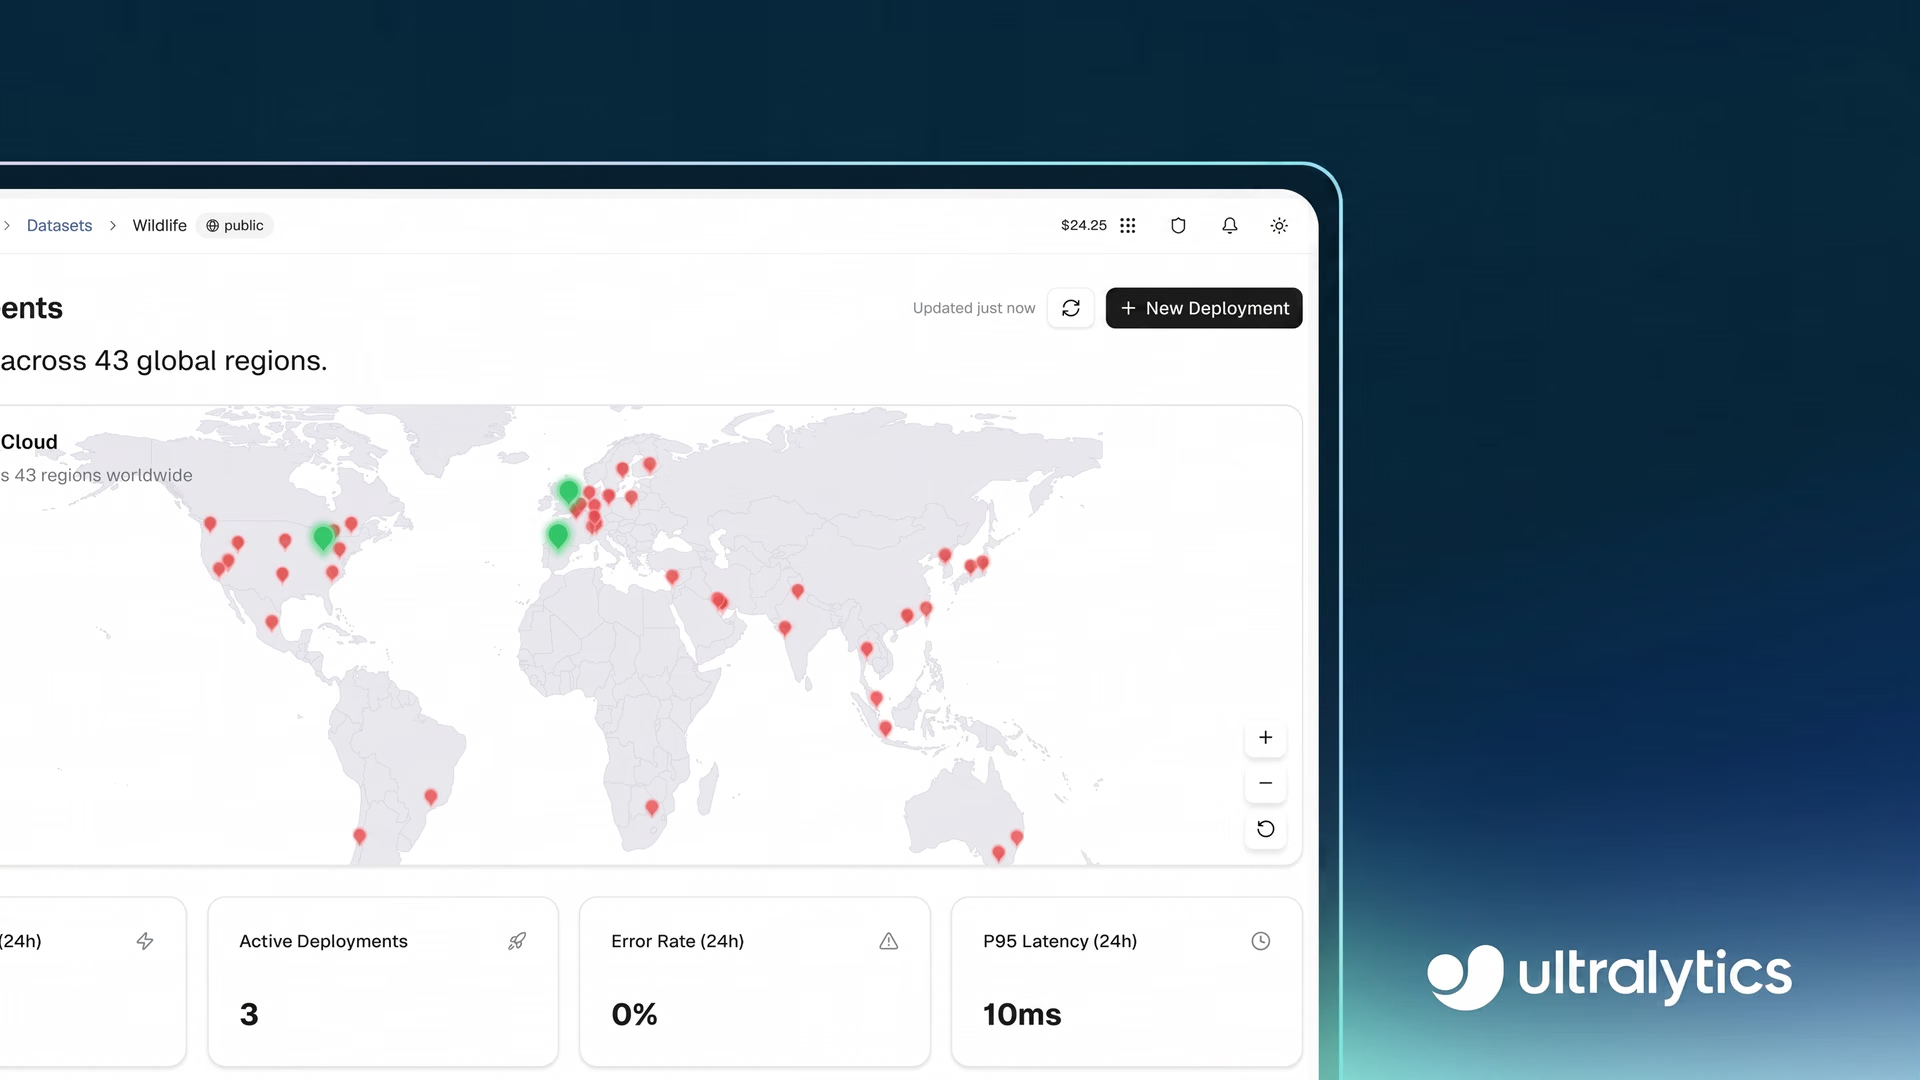
Una vez que un modelo está listo para producción, debe gestionar el tráfico del mundo real de forma fiable y a escala. Ultralytics Platform lo permite mediante endpoints dedicados, en los que los modelos se ejecutan como servicios de un solo inquilino en 43 regiones de todo el mundo. Implementar los modelos más cerca de los usuarios finales ayuda a reducir la latencia y mantener un rendimiento uniforme en distintas ubicaciones.
Cada endpoint se ejecuta con sus propios recursos informáticos asignados y una URL única para las solicitudes de inferencia. Este nivel de control facilita el ajuste de las implementaciones según las necesidades de rendimiento, desde casos de uso ligeros hasta aplicaciones más exigentes y de alto rendimiento que requieren más recursos computacionales.
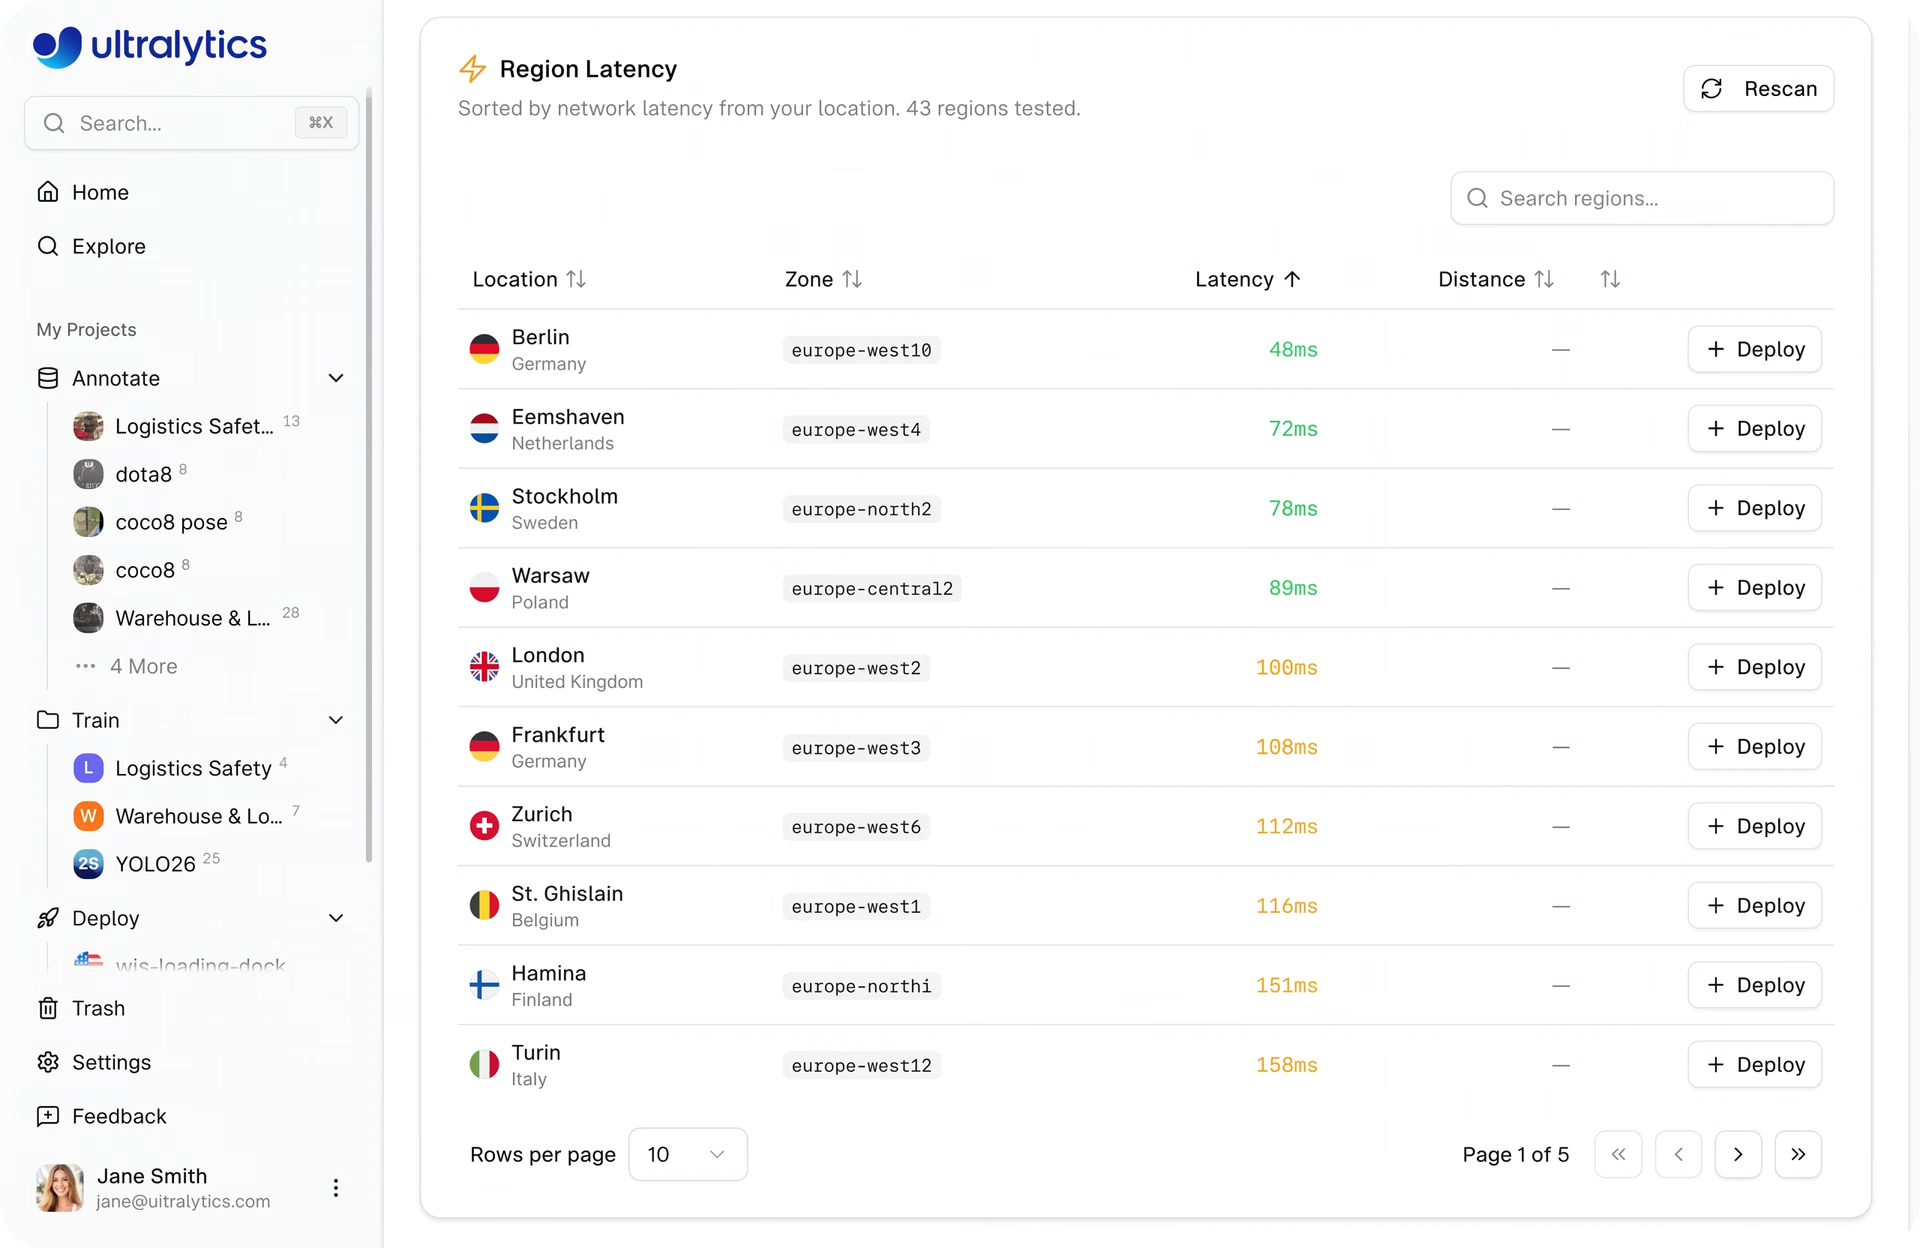
Fig. 3. Puedes implementar modelos en 43 regiones de todo el mundo mediante Ultralytics Platform (Fuente)
Sin embargo, los endpoints dedicados están diseñados para gestionar por sí mismos las cargas de trabajo cambiantes, con un escalado automático que ajusta los recursos en función del tráfico entrante. Escalan durante los periodos de alta demanda y reducen su escala cuando disminuye el uso. Con el escalado a cero activado de forma predeterminada, los endpoints inactivos se apagan automáticamente y se reinician cuando llegan nuevas solicitudes, lo que ayuda a optimizar el uso de recursos sin intervención manual.
Exporta tu modelo fácilmente con Ultralytics Platform#
Hoy en día, la IA periférica es cada vez más esencial, ya que más aplicaciones dependen de ejecutar modelos directamente en dispositivos como smartphones, cámaras y sistemas integrados. Ejecutar los modelos localmente también puede ayudar a cumplir los requisitos de privacidad de datos, puesto que los datos confidenciales, como imágenes o secuencias de vídeo, se pueden procesar directamente en el dispositivo sin enviarlos a servidores externos.
En estos escenarios, los modelos deben ejecutarse fuera de Ultralytics Platform, por lo que la exportación de modelos es una parte esencial del proceso de implementación. Los modelos Ultralytics YOLO suelen entrenarse con Python y PyTorch, y después pueden exportarse a más de 17 formatos diferentes, incluidos ONNX, TensorRT, CoreML y OpenVINO.
Esta amplia variedad de formatos garantiza la compatibilidad con hardware diverso, desde unidades de procesamiento gráfico (GPUs) de alto rendimiento hasta dispositivos móviles e integrados. Además, la exportación permite ajustar el rendimiento para entornos específicos.
Según el formato, los modelos pueden alcanzar velocidades de inferencia superiores, como un mejor rendimiento de GPU con TensorRT o una ejecución optimizada en CPU con ONNX y OpenVINO. Opciones como la cuantización FP16 e INT8 pueden reducir aún más el tamaño del modelo y mejorar el rendimiento, lo que resulta especialmente útil para implementaciones periféricas.
En Ultralytics Platform, la exportación está integrada directamente en el flujo de trabajo, lo que permite generar rápidamente modelos optimizados con solo unos clics. Los equipos pueden pasar del entrenamiento a la ejecución de modelos en sistemas externos sin añadir una sobrecarga adicional.
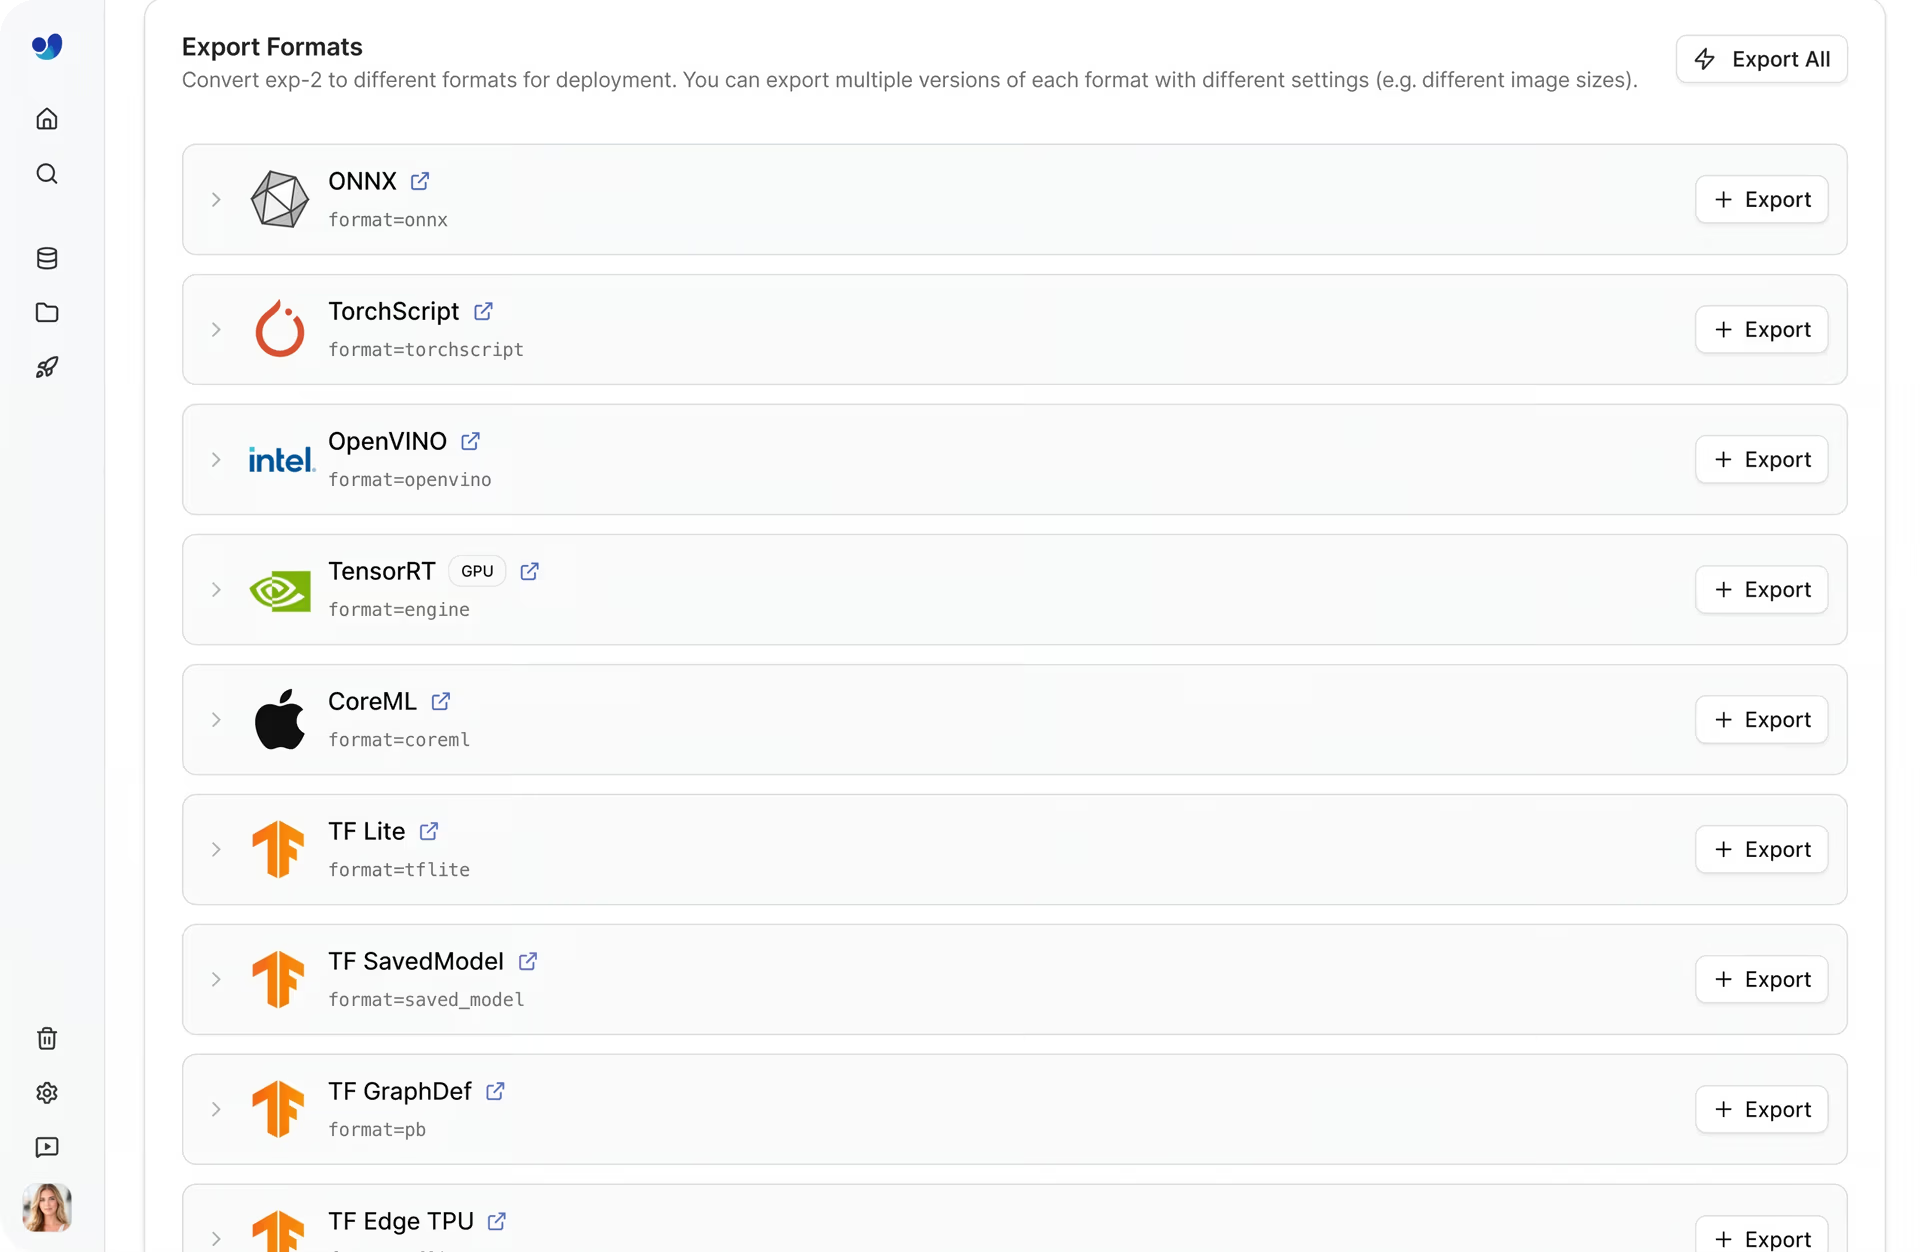
Fig. 4. Selección de formatos de exportación en Ultralytics Platform.
Elige la opción de implementación de modelos adecuada#
Cada opción de implementación de Ultralytics Platform admite una etapa distinta del flujo de trabajo, desde las primeras pruebas hasta el uso en producción. Este es un resumen de cuándo puedes utilizar cada una:
- Pestaña Predict: normalmente se utiliza justo después del entrenamiento o ajuste fino, cuando quieres validar cómo funciona un modelo con datos nuevos mediante inferencia en el navegador.
- Inferencia compartida: en esta etapa, los modelos se pueden integrar en aplicaciones mediante API, lo que permite probar interacciones del mundo real durante el desarrollo.
- Endpoints dedicados: se utilizan para implementaciones de producción en las que los modelos necesitan un rendimiento uniforme, recursos dedicados y capacidad para escalar en regiones de todo el mundo.
- Exportación de modelos: cuando los modelos deben ejecutarse fuera de la plataforma, la opción de exportarlos permite implementarlos en dispositivos periféricos, aplicaciones móviles o infraestructura personalizada.
Los equipos suelen avanzar por estas opciones paso a paso, desde la validación hasta la integración y, finalmente, la implementación en producción, todo dentro de la plataforma.
Supervisa los modelos implementados mediante Ultralytics Platform#
Aunque la implementación es fundamental, el flujo de visión no termina ahí. Una vez que un modelo se ejecuta en producción, la supervisión continua es clave para garantizar que funcione de forma fiable a lo largo del tiempo.
Ultralytics Platform ofrece herramientas de supervisión integrada que proporcionan a los equipos una visibilidad clara del comportamiento de sus modelos de IA de visión a lo largo del tiempo, favoreciendo un flujo de trabajo más estructurado de operaciones de aprendizaje automático (MLOps).
La página Deploy incluye un panel que realiza un seguimiento de métricas clave, como el total de solicitudes, las implementaciones activas, la latencia de respuesta y las tasas de error. Estos datos ayudan a los equipos a comprender los patrones de uso, evaluar la capacidad de respuesta del sistema y garantizar un rendimiento de baja latencia con distintas cargas de trabajo.
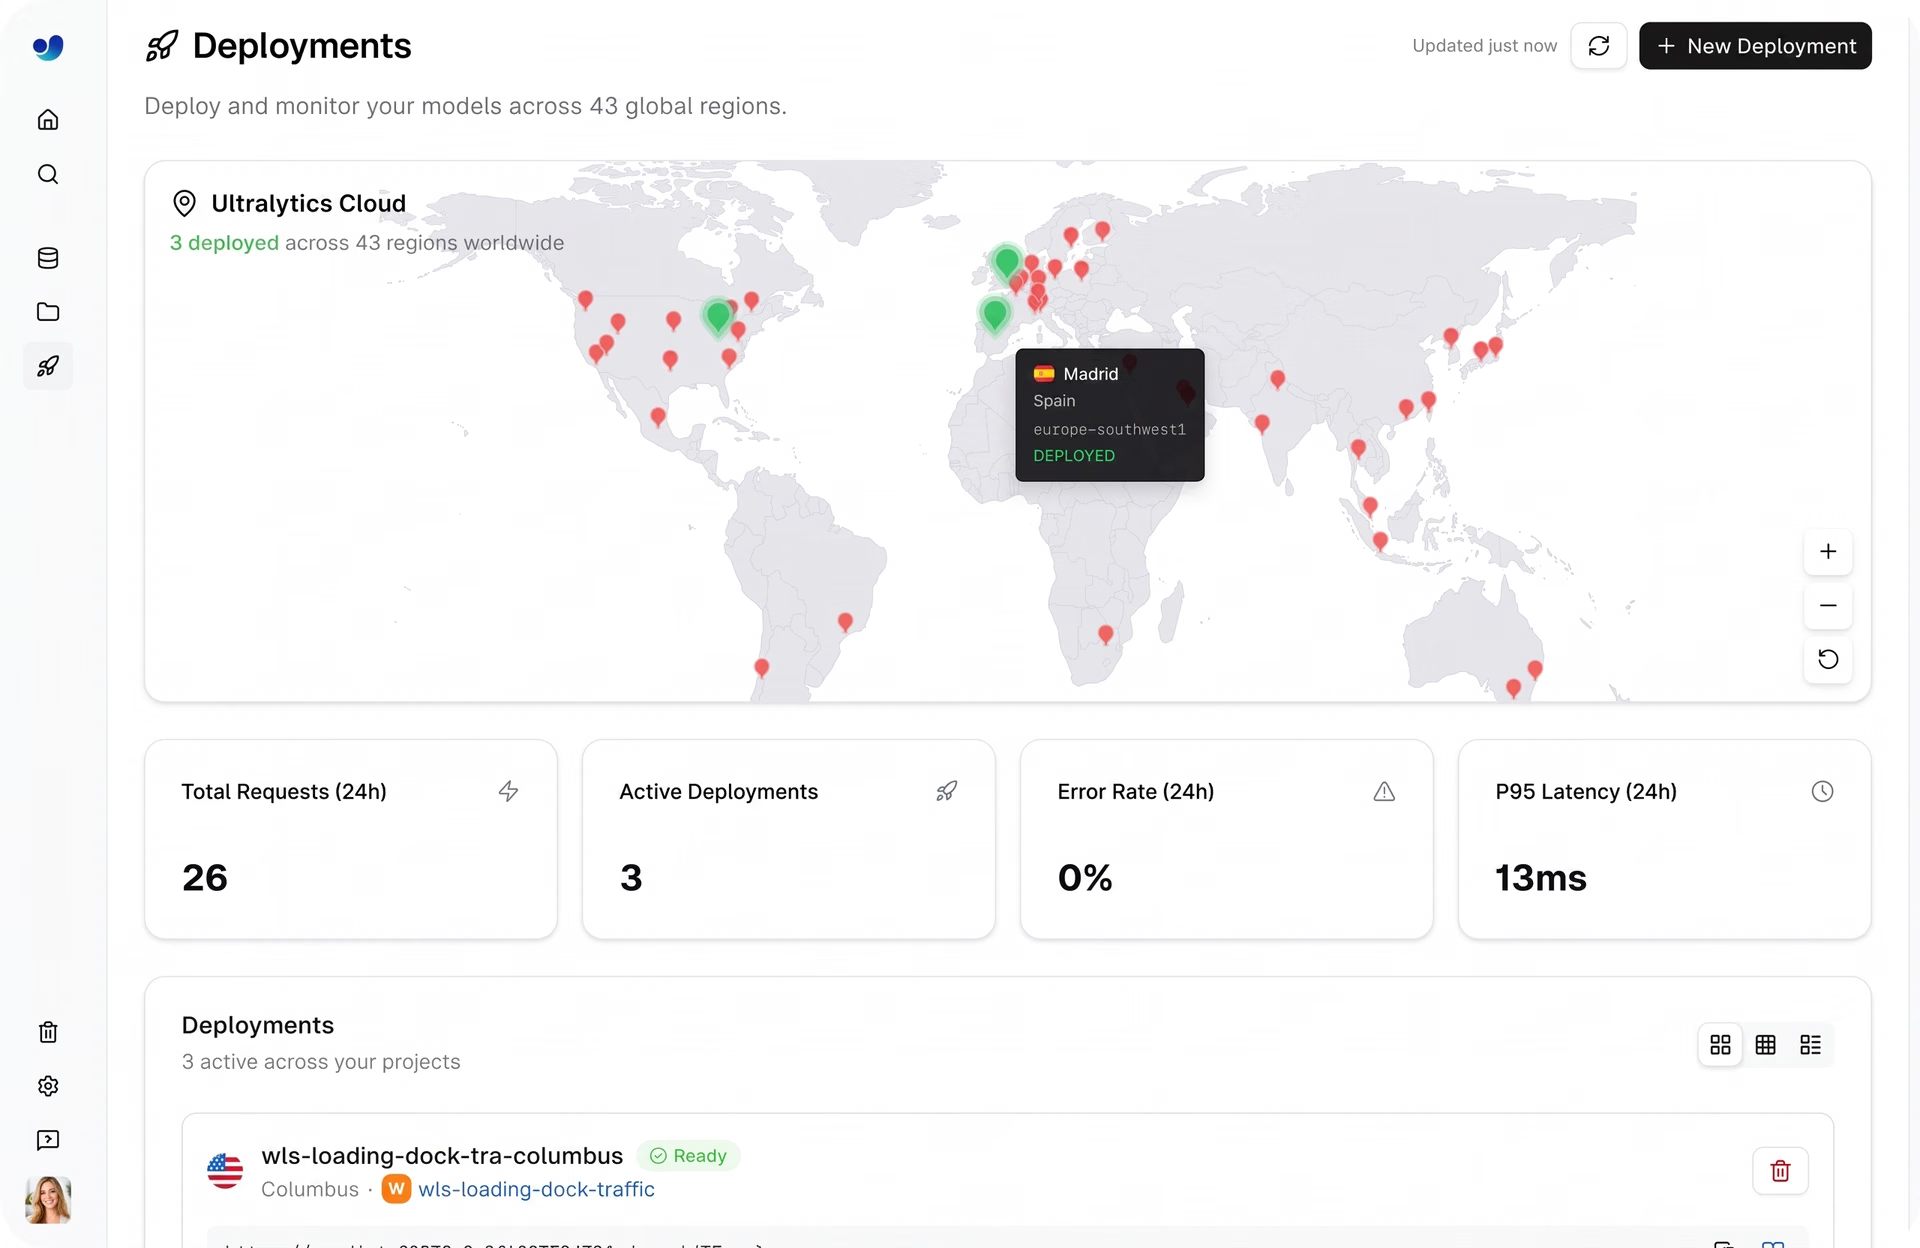
Fig. 5. Ultralytics Platform facilita la supervisión de los modelos implementados. (Fuente)
Cada endpoint dedicado también proporciona una observabilidad detallada mediante vistas individuales de las implementaciones. Esto incluye acceso a registros, el estado de salud del modelo y datos de rendimiento en tiempo real. Los registros se pueden utilizar para depurar problemas, rastrear solicitudes fallidas e identificar posibles problemas relacionados con dependencias o infraestructura.
A medida que evolucionan los entornos de producción, factores como los cambios en los datos de entrada, las necesidades de escalado o la modificación de los patrones de uso pueden afectar a la precisión y la robustez del modelo. Al supervisar continuamente las métricas de rendimiento, los equipos pueden detectar anomalías, identificar cuellos de botella y aplicar medidas correctivas, como optimizar el modelo o ajustar los recursos, para mantener un servicio de modelos uniforme y fiable.
Integra la escalabilidad en las implementaciones de modelos de visión artificial#
Tradicionalmente, escalar sistemas de visión artificial ha significado unir flujos de trabajo y frameworks que nunca se diseñaron para funcionar como uno solo. Las canalizaciones de datos, los ciclos de entrenamiento, la infraestructura de implementación y los sistemas de supervisión suelen estar en lugares separados, lo que genera dificultades en cada etapa.
El verdadero reto no consiste solo en crear modelos, sino en mantenerlos en movimiento: pasar de los datos a producción, adaptarse a nuevas entradas, gestionar una demanda creciente y mejorar continuamente sin ralentizarse.
Lo que distingue a Ultralytics Platform es que este movimiento está integrado. En lugar de tratar cada etapa como un paso independiente, las conecta en un ciclo continuo en el que los modelos se pueden desarrollar, implementar, observar y actualizar dentro del mismo entorno.
Este cambio transforma la forma en que escalan los equipos. Ya no se trata de orquestar herramientas o infraestructura, sino de mantener el impulso a medida que crecen los sistemas.
Conclusiones clave#
Incorporar modelos de aprendizaje automático, como los modelos de visión artificial, a aplicaciones del mundo real requiere que sean fiables, escalables y fáciles de gestionar. Ultralytics Platform simplifica este proceso al combinar diversas funciones, como el servicio de modelos, la implementación y la supervisión, en un único entorno unificado. Con opciones de implementación flexibles y herramientas integradas, los equipos pueden pasar de la experimentación a la producción más rápidamente y con menos complejidad.
Visita nuestra comunidad y explora nuestro repositorio de GitHub para obtener más información. Explora nuestras páginas de soluciones para descubrir distintas aplicaciones, como la IA en el sector sanitario y la visión artificial en logística. Descubre nuestras opciones de licencia y ¡empieza a crear hoy mismo!








