Tirer parti de l’apprentissage par renforcement dans les projets de vision par ordinateur
Découvre le fonctionnement de l’apprentissage par renforcement et son association à la vision par ordinateur dans les robots d’entrepôt, les véhicules autonomes et la robotique chirurgicale, ainsi que ses compromis.
 Abirami Vina10 min de lecture
Une façon simple d’expliquer l’intelligence artificielle (AI) consiste à la présenter comme un domaine qui vise à reproduire la façon dont les humains pensent et apprennent. C’est de là que vient l’idée des techniques d’apprentissage en IA : différentes méthodes qui permettent aux machines d’améliorer leurs performances au fil du temps, comme le font les humains.
Nous avons déjà exploré plusieurs techniques d’apprentissage de l’IA, notamment l’apprentissage supervisé, non supervisé, par renforcement et par transfert, ainsi que le rôle important que chacune joue pour aider les modèles d’IA à traiter l’information et à prendre des décisions.
Aujourd’hui, nous allons nous pencher sur l’apprentissage par renforcement, une technique qui apprend aux systèmes d’IA à progresser par l’expérience, en interagissant avec un environnement et en s’améliorant grâce aux retours reçus. Nous verrons plus particulièrement comment appliquer l’apprentissage par renforcement aux applications de vision par ordinateur, des systèmes qui permettent aux machines d’interpréter et de comprendre les informations visuelles du monde qui les entoure.
La combinaison de notions comme l’apprentissage par renforcement et la vision par ordinateur ouvre de nouvelles perspectives passionnantes et constitue un domaine de recherche actif. Elle permet aux systèmes d’IA de reconnaître ce qu’ils voient et de prendre des décisions éclairées à partir des informations visuelles.
Qu’est-ce que l’apprentissage par renforcement ?#
L’apprentissage par renforcement est une branche de l’apprentissage automatique dans laquelle un agent d’IA apprend en effectuant des actions et en recevant des retours sous forme de récompenses ou de pénalités. L’objectif est de déterminer quelles actions mènent aux meilleurs résultats au fil du temps.
Tu peux comparer l’apprentissage par renforcement au dressage d’un chien. Quand un chien s’assoit sur commande, tu lui donnes une friandise. Au bout d’un moment, il apprend que s’asseoir lui vaut une récompense. En apprentissage par renforcement, l’agent d’IA ou le modèle représente le chien, l’environnement correspond au monde qui l’entoure et la récompense l’aide à comprendre s’il a fait le bon choix.
Cette méthode diffère de l’apprentissage supervisé, où le modèle d’IA reçoit de nombreux exemples de bonnes réponses. On peut, par exemple, lui montrer une image de chien et lui dire : « C’est un chien. »
L’apprentissage par renforcement, lui, ne repose pas sur des données annotées. Il consiste plutôt à essayer différentes actions et à tirer des enseignements des résultats, un peu comme lorsqu’on joue à un jeu et qu’on cherche les mouvements qui permettent de gagner.
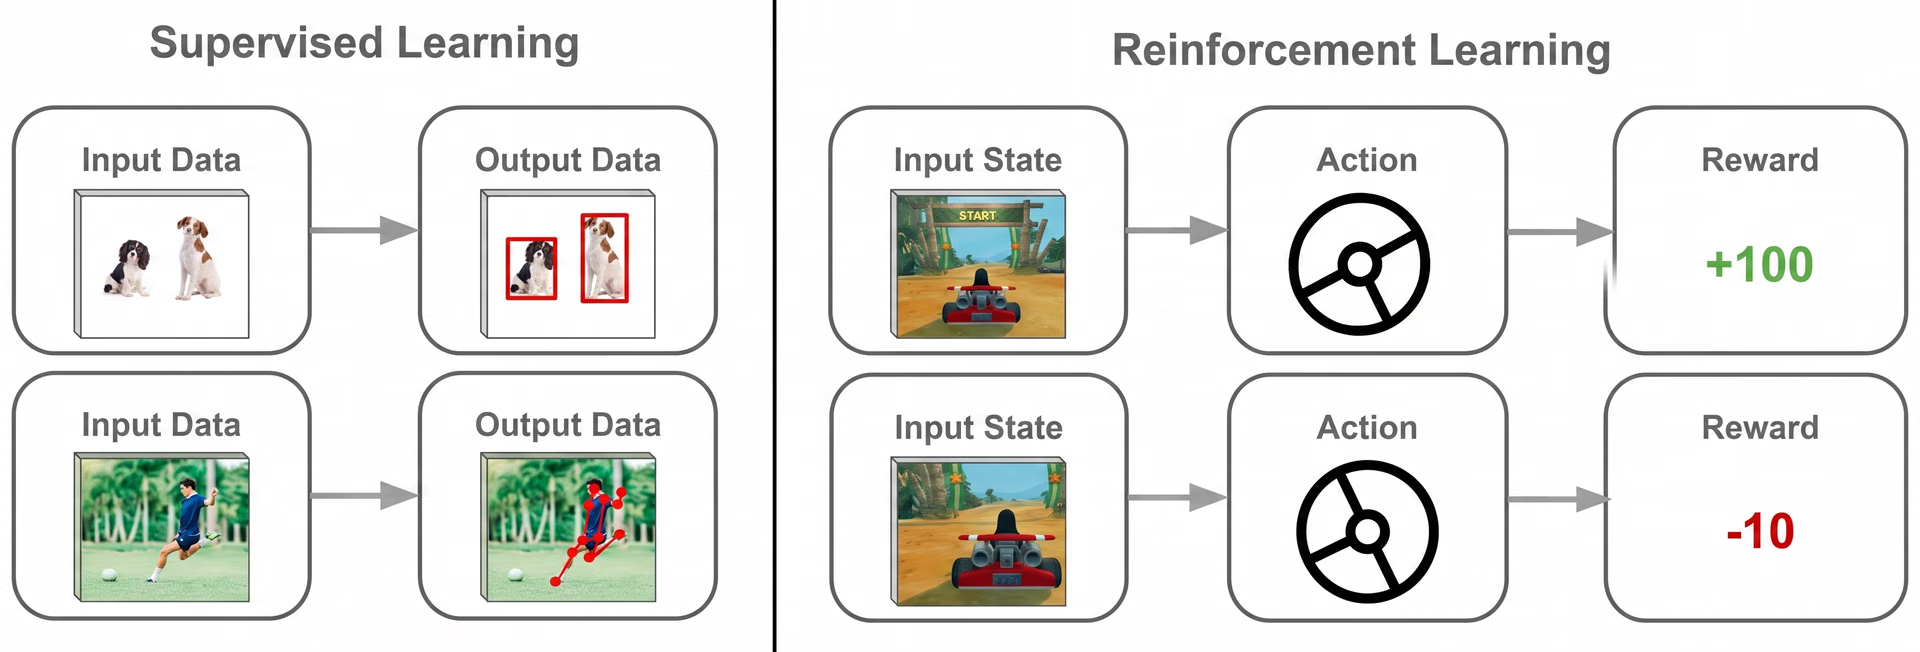
Fig 1. Apprentissage par renforcement et apprentissage supervisé.
L’apprentissage par renforcement est essentiel pour les tâches où les décisions se prennent étape par étape et où chaque choix influe sur la suite des événements. Cette méthode est utilisée dans les jeux vidéo de stratégie pour rendre les parties plus stimulantes et captivantes.
Fonctionnement de l’apprentissage par renforcement dans les solutions d’IA#
Pense à la façon dont tu apprends à faire du vélo. Au début, tu risques de tomber. Mais avec de l’entraînement, tu comprends peu à peu ce qui t’aide à garder l’équilibre. Plus tu roules, plus tu progresses. Tu apprends en pratiquant, et pas seulement en écoutant des instructions.
L’apprentissage par renforcement fonctionne de manière similaire en IA. Il apprend par l’expérience : en essayant différentes actions, en observant ce qui se passe et en améliorant progressivement sa capacité à faire les bons choix au fil du temps.
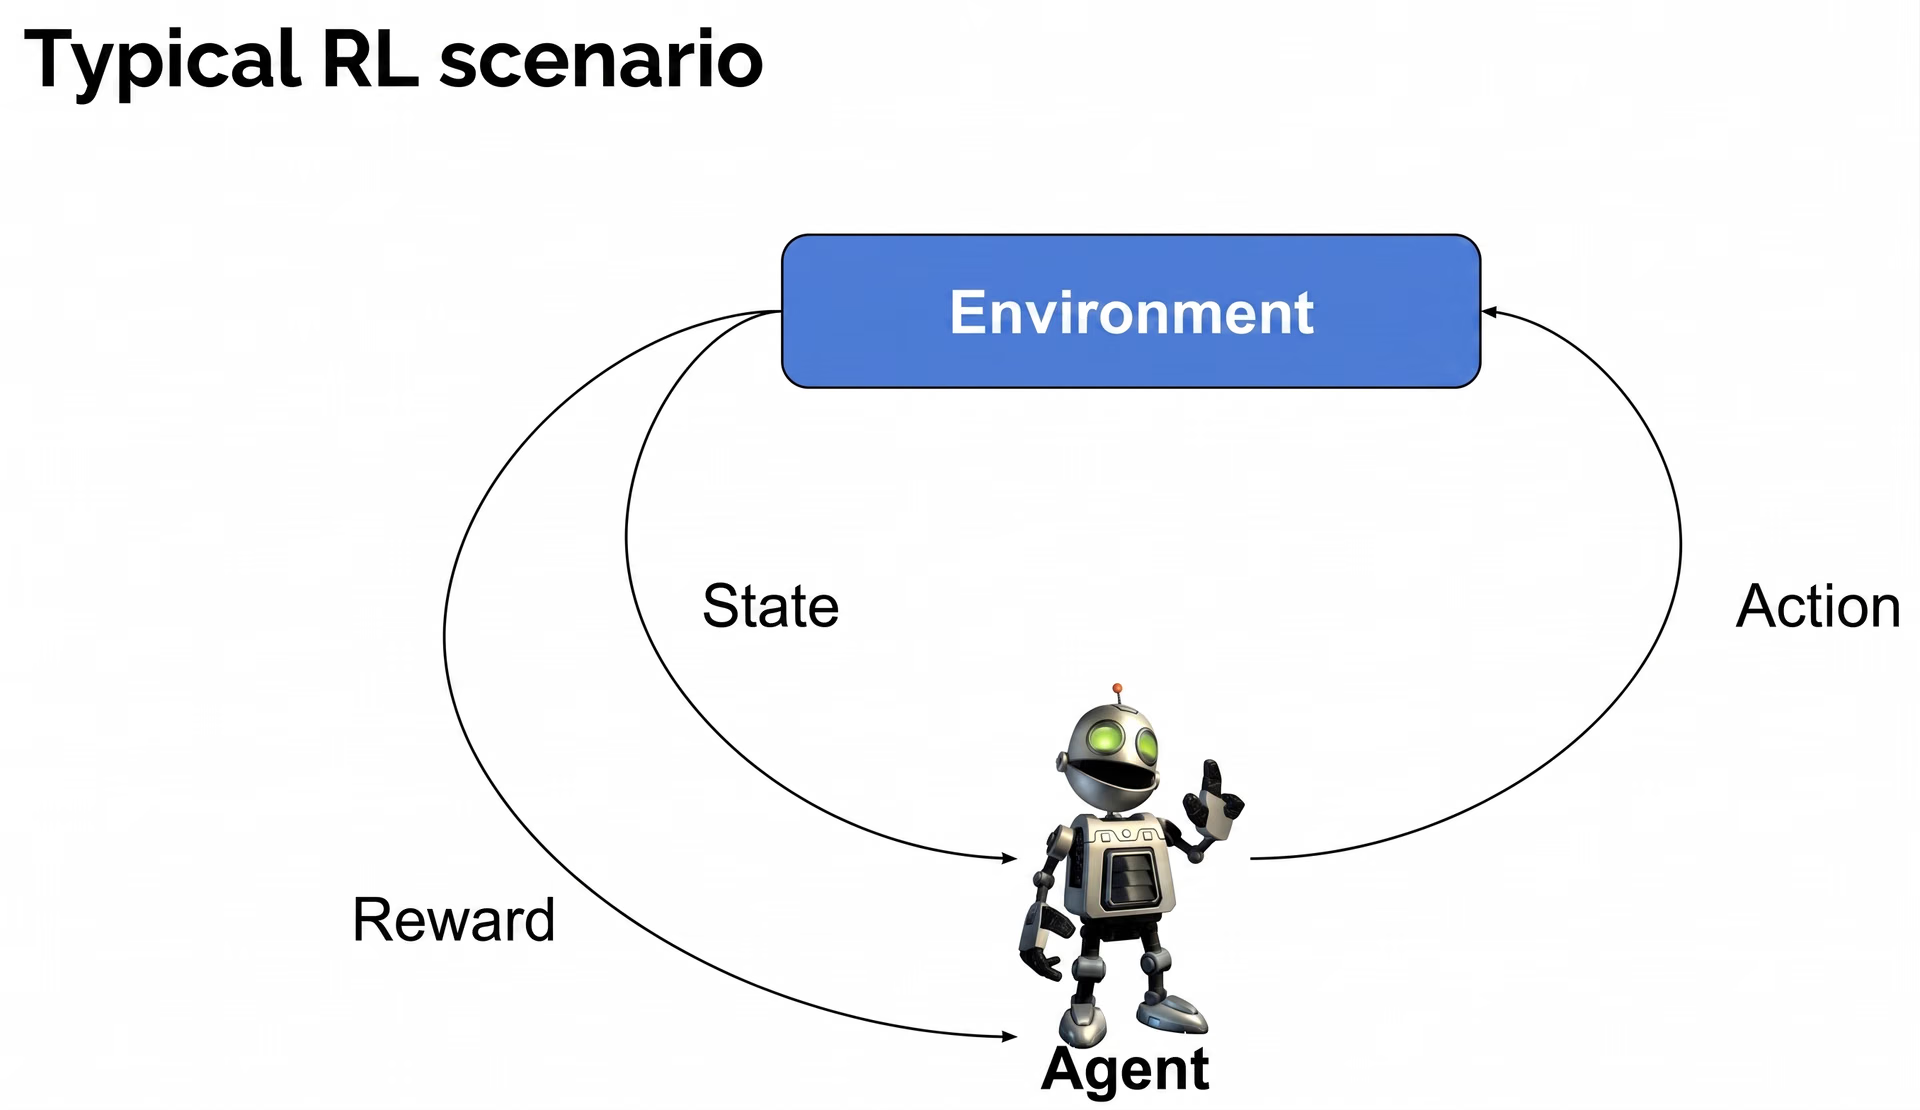
Fig 2. Comprendre le fonctionnement de l’apprentissage par renforcement.
Voici quelques-uns des principaux composants de l’apprentissage par renforcement :
- Agent : l’agent est l’apprenant ou le décideur. Il interagit avec l’environnement en effectuant des actions et vise à atteindre un objectif précis.
- Environnement : l’environnement comprend tout ce avec quoi l’agent interagit. Il évolue en réponse aux actions de l’agent et fournit des commentaires en fonction des résultats.
- État : un état représente un instantané de la situation actuelle dans l’environnement. L’agent observe l’état pour comprendre ce qui l’entoure et déterminer quelle action effectuer ensuite.
- Action : une action est un mouvement ou une décision de l’agent qui influe sur l’environnement. Chaque action mène à un nouvel état et peut influencer les récompenses futures.
- Récompense : une récompense est simplement un commentaire de l’environnement qui indique à l’agent si son action a été bénéfique ou non. Les récompenses positives encouragent l’agent à répéter les bonnes actions, tandis que les récompenses négatives le dissuadent de recommencer les mauvaises.
- Politique : une politique est la stratégie de l’agent pour choisir des actions en fonction de l’état actuel. Au fil du temps, l’agent affine sa politique afin de maximiser le total des récompenses qu’il peut obtenir.
En combinant ces éléments, l’apprentissage par renforcement permet aux systèmes d’IA d’acquérir des comportements efficaces par essais et erreurs continus. À chaque tentative, l’agent s’améliore dans le choix des actions qui lui apportent des récompenses plus élevées et de meilleurs résultats.
Innovations en apprentissage par renforcement dans la vision par ordinateur#
La vision par ordinateur est utilisée pour des tâches comme la détection d’objets dans des images, la classification du contenu d’une image et la segmentation d’une image en différentes parties. Les modèles de vision par ordinateur comme Ultralytics YOLO11 prennent en charge ces tâches et peuvent servir à créer des applications à fort impact capables de recueillir des informations visuelles.
Cependant, lorsque ces tâches d’IA visuelle sont combinées à l’apprentissage par renforcement, on obtient une solution d’IA qui ne se contente pas de voir : elle apprend aussi à agir à partir des informations visuelles et s’améliore au fil du temps.
Un exemple intéressant d’apprentissage par renforcement dans les applications de vision par ordinateur est l’utilisation de robots dans les entrepôts. Équipés de caméras et de systèmes de vision par ordinateur, ces robots peuvent analyser leur environnement, détecter l’emplacement de chaque article, en déterminer la forme et la taille et comprendre comment il est placé sur l’étagère.
Chaque fois que le robot essaie de saisir un article, il reçoit un retour : il réussit si l’article est correctement saisi et échoue s’il le fait tomber. Au fil du temps, le robot apprend quelles actions sont les plus efficaces selon les articles. Au lieu de suivre une série d’instructions fixes, il s’améliore constamment par l’expérience.
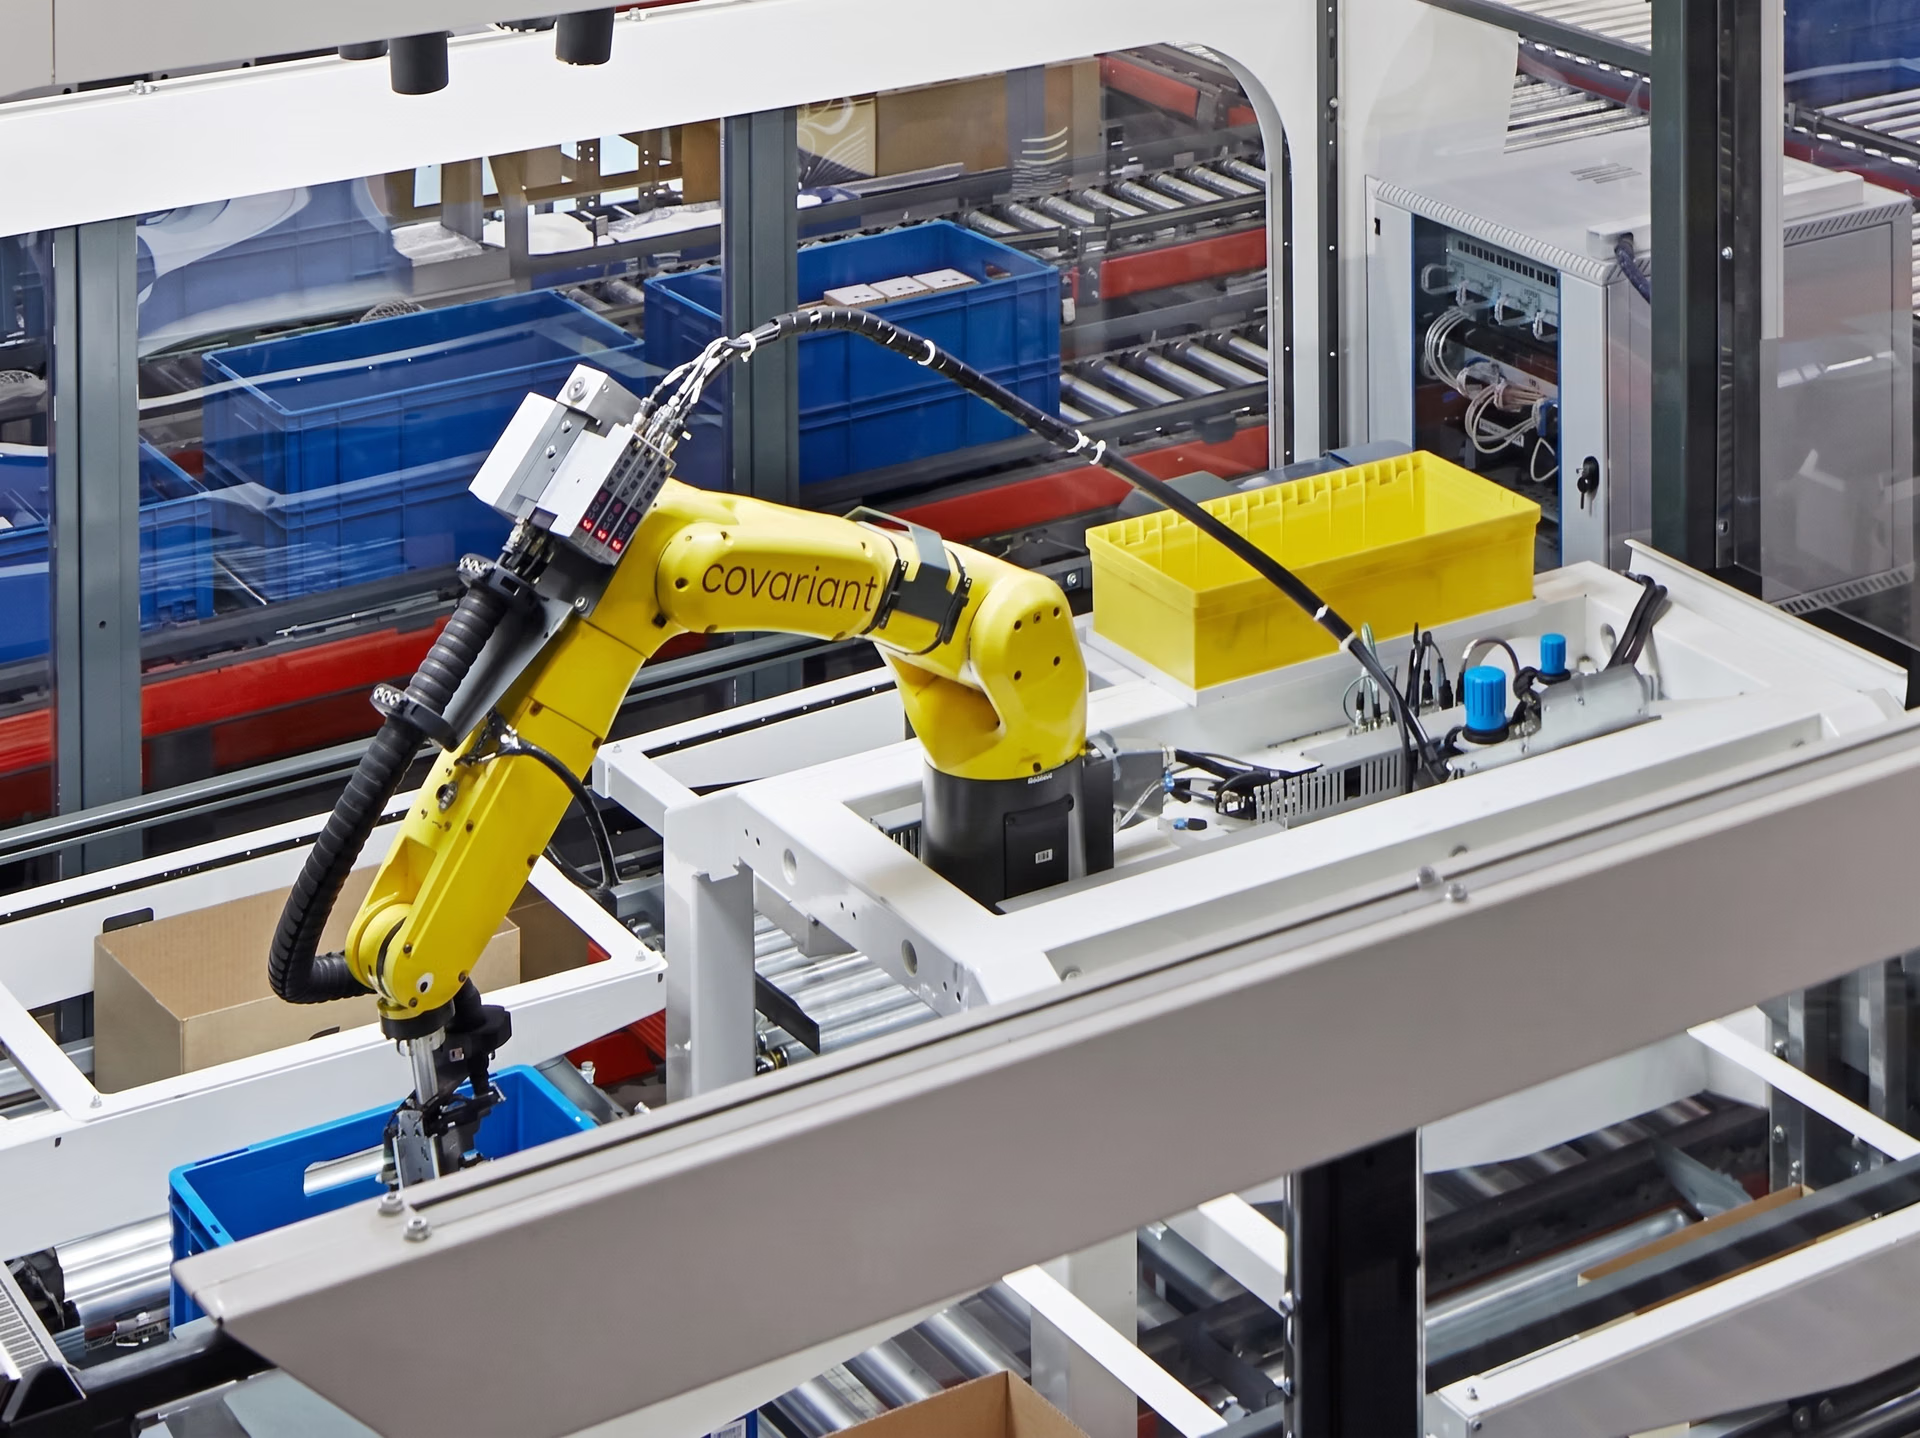
Fig. 3. Un bras robotisé utilisant la vision par IA et l’apprentissage par renforcement pour saisir des objets.
Applications de l’apprentissage par renforcement en vision par ordinateur#
Maintenant que nous comprenons mieux ce qu’est l’apprentissage par renforcement et quel rôle il joue en vision par ordinateur, examinons quelques exemples d’utilisation conjointe de l’apprentissage par renforcement et de la vision par ordinateur.
Associer la vision par IA à l’apprentissage par renforcement pour des véhicules plus intelligents#
Les véhicules autonomes peuvent s’appuyer à la fois sur l’IA visuelle pour comprendre leur environnement et sur l’apprentissage par renforcement pour prendre des décisions en fonction de ce qu’ils voient. AWS DeepRacer en est un excellent exemple concret.
L’AWS DeepRacer est une voiture de course entièrement autonome à l’échelle 1/18 qui apprend à conduire à l’aide d’une caméra et de l’apprentissage par renforcement. Au lieu de recevoir des instructions, elle se débrouille toute seule en essayant, en faisant des erreurs et en en tirant des leçons.
La caméra de cette petite voiture fonctionne comme une paire d’yeux et capture la piste devant elle. En fonction de ce qu’elle voit, la voiture apprend à diriger et à régler sa vitesse. À chaque tour, elle s’améliore. Par exemple, elle peut apprendre à prendre des virages plus larges ou à ralentir avant les virages serrés en tirant des leçons de ses essais précédents.
L’entraînement du DeepRacer commence dans un environnement virtuel, où le modèle s’exerce et affine ses compétences de conduite. Une fois un certain niveau de performance atteint, ces compétences sont transférées sur des circuits réels avec des voitures physiques.
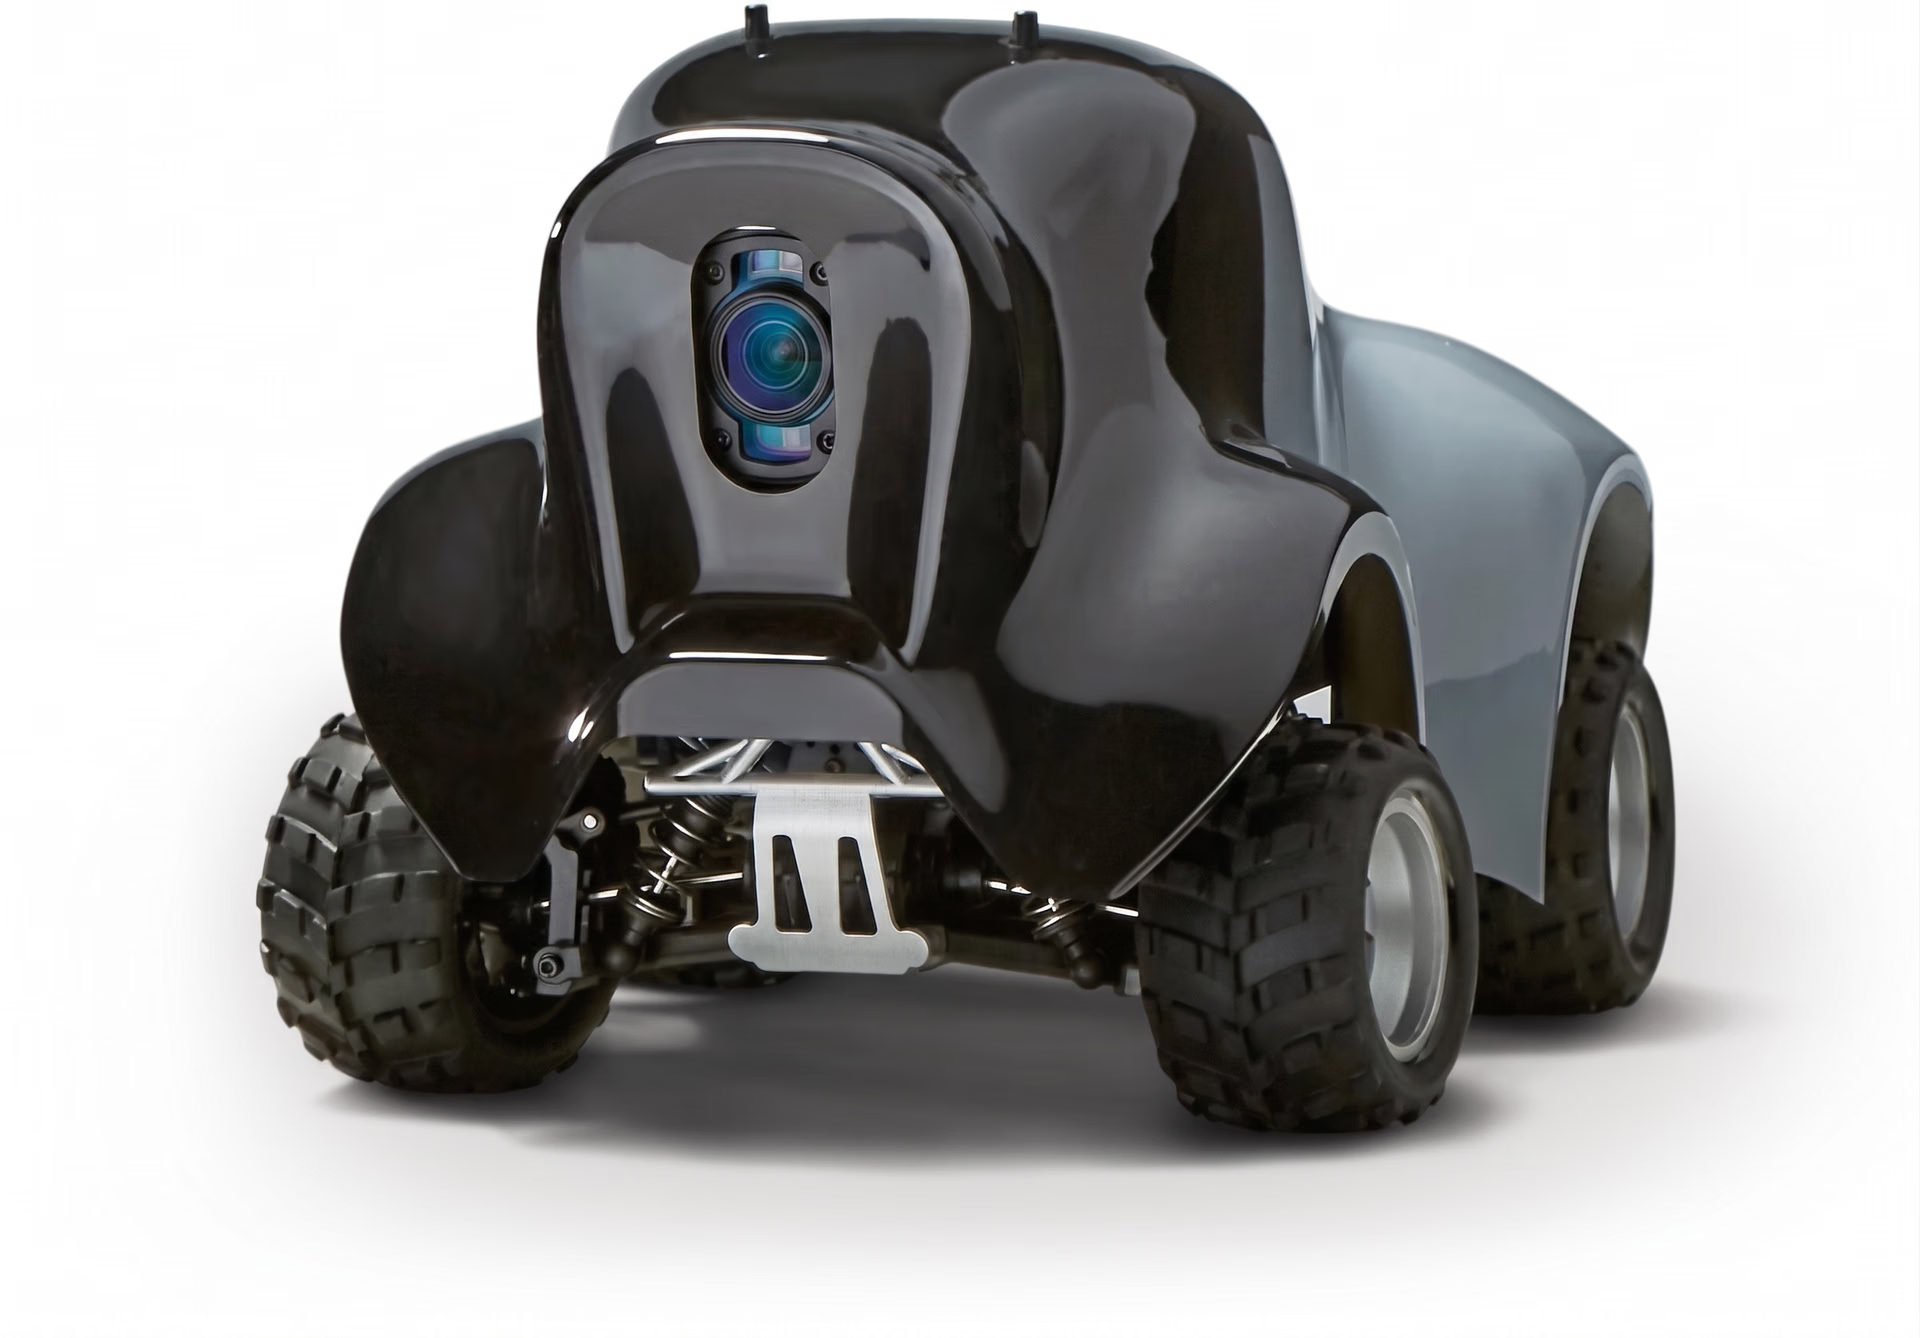
Fig. 4. L’AWS DeepRacer utilise la vision et l’apprentissage par renforcement pour conduire de manière autonome. Source de l’image : Amazon.
Vers des robots chirurgicaux autonomes#
L’intégration de l’IA visuelle et de l’apprentissage par renforcement en chirurgie robotique est un domaine de recherche prometteur qui suscite de plus en plus d’intérêt. Pour l’instant, cette application reste largement théorique. Les chercheurs réalisent des simulations dans des environnements virtuels.
Toutefois, les premières expériences donnent des résultats prometteurs et laissent penser que les robots chirurgicaux pourraient, à terme, réaliser des interventions complexes et délicates avec une plus grande précision, une meilleure adaptabilité et une intervention humaine minimale.
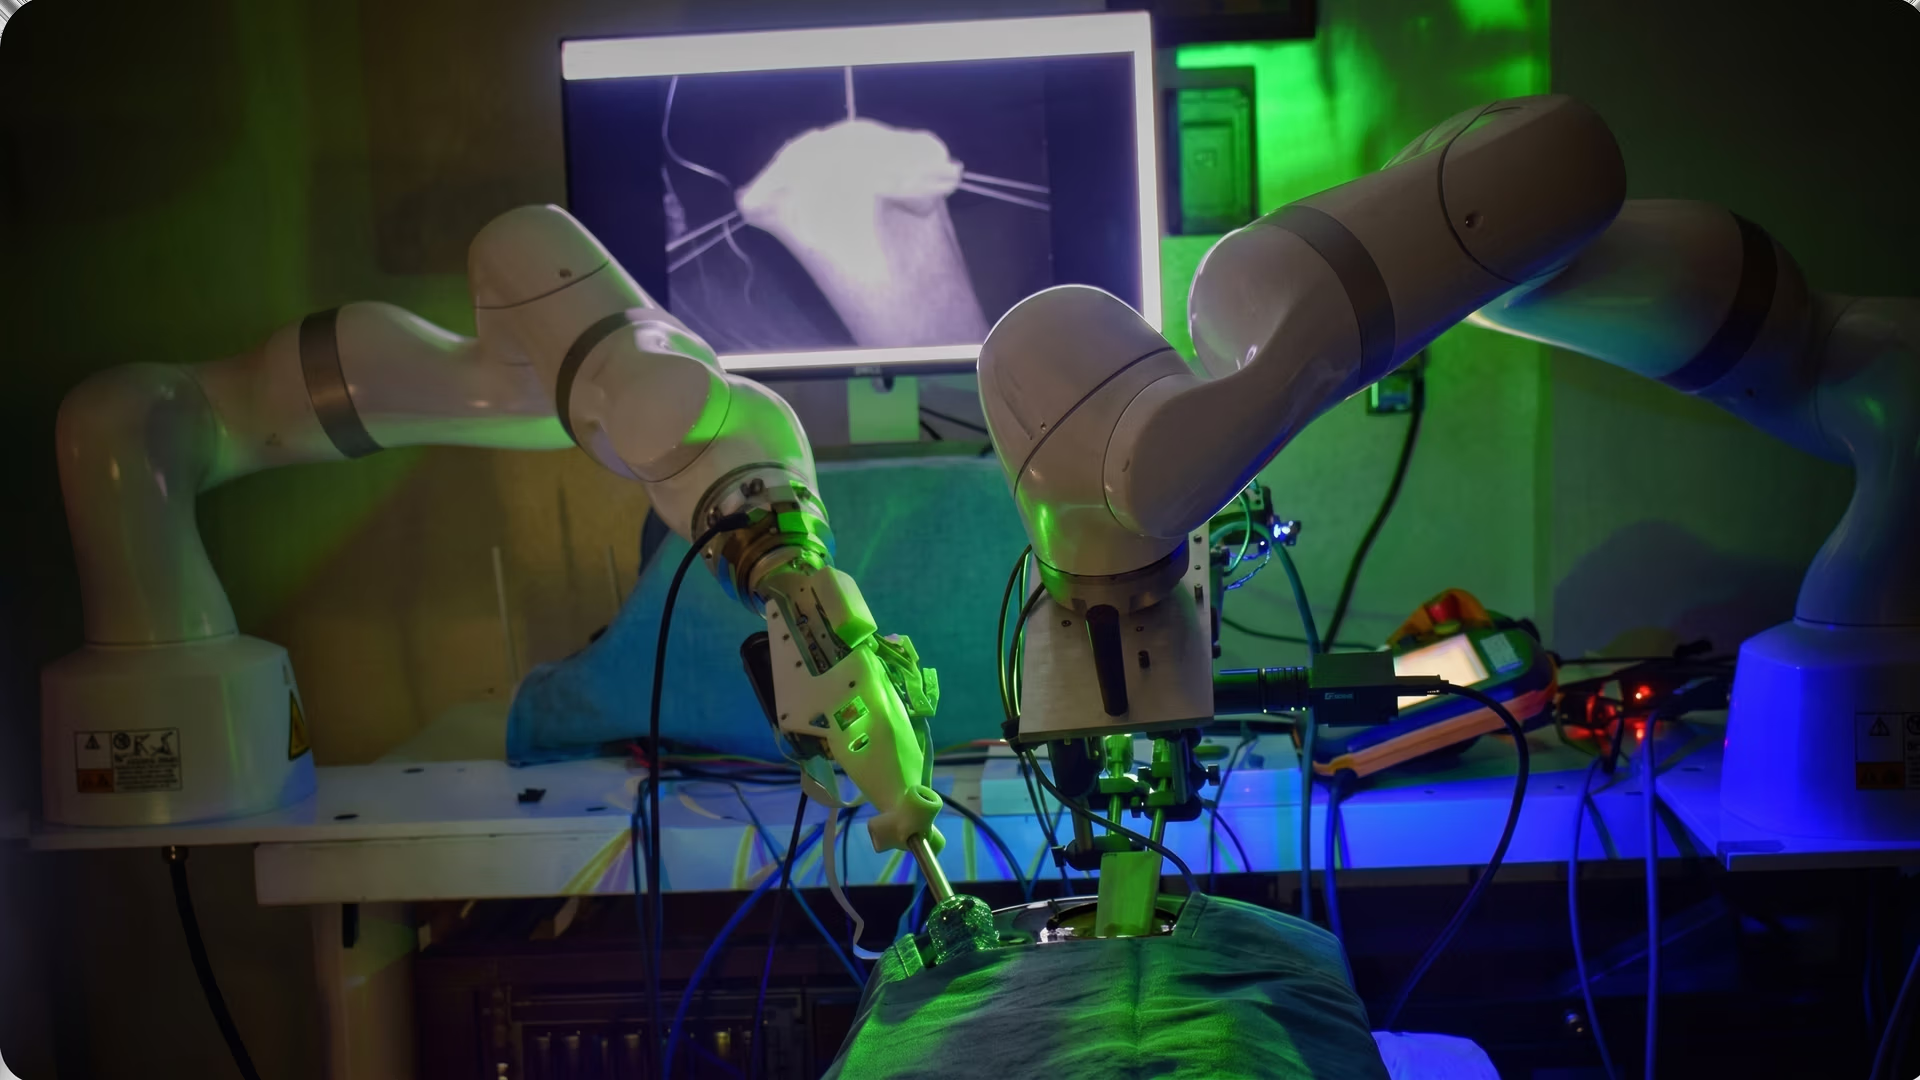
Fig. 5. Les robots chirurgicaux sont de plus en plus perfectionnés.
Par exemple, imaginons qu’il faille soulever délicatement une compresse sur un site opératoire. Un robot équipé d’IA visuelle analyserait d’abord la scène en utilisant la segmentation pour repérer la compresse et les tissus environnants.
L’apprentissage par renforcement aiderait ensuite le robot chirurgical à décider comment s’y prendre, en déterminant le meilleur angle pour saisir la compresse, la pression à appliquer et la manière de la soulever sans perturber les zones sensibles voisines. Au fil du temps et des exercices répétés dans des environnements simulés, le robot pourrait apprendre à effectuer ces mouvements subtils et cruciaux avec une habileté et une confiance toujours plus grandes.
Avantages et inconvénients de l’apprentissage par renforcement en vision par IA#
L’apprentissage par renforcement permet aux systèmes d’IA visuelle de dépasser la simple reconnaissance et de commencer à prendre des décisions en fonction de ce qu’ils voient. Cela ouvre de nouvelles possibilités dans des domaines comme la robotique, l’automatisation et les interactions en temps réel.
Voici quelques-uns des principaux avantages de l’intégration de l’apprentissage par renforcement aux workflows d’IA visuelle :
- Moindre dépendance aux données annotées : ces systèmes peuvent apprendre par interaction. Ils n’ont donc pas besoin d’énormes jeux de données annotés pour démarrer.
- Meilleure gestion de l’incertitude : l’apprentissage par renforcement peut composer avec des informations visuelles incomplètes ou bruitées en ajustant les actions en fonction des retours, plutôt qu’en s’appuyant uniquement sur des données parfaites.
- Favorise l’apprentissage à long terme : il aide les modèles à s’améliorer au fil du temps en tirant des leçons de séquences d’actions, et pas seulement de décisions isolées.
Voici quelques limites de l’apprentissage par renforcement dont il faut tenir compte :
- Problème d’attribution du crédit : il peut être difficile pour l’agent de déterminer quelles actions précises ont contribué au résultat final, surtout dans de longues séquences de décisions.
- Risque d’exploration non sécurisée : pendant l’entraînement, l’agent peut essayer des actions dangereuses ou indésirables qui seraient inacceptables dans des applications réelles comme les soins de santé ou la conduite autonome.
- Convergence lente : le modèle peut mettre longtemps à atteindre un bon niveau de performance, surtout pour les tâches complexes.
Points clés à retenir#
L’apprentissage par renforcement dans les projets de vision par ordinateur permet aux systèmes d’IA de comprendre leur environnement et d’apprendre à agir grâce à l’expérience. Avec des modèles comme Ultralytics YOLO11 qui assurent la détection d’objets en temps réel, le système peut prendre des décisions éclairées en fonction de ce qu’il voit.
Cette approche va au-delà des méthodes traditionnelles en permettant à l’IA de s’améliorer par essais et grâce aux retours reçus, plutôt que de s’appuyer uniquement sur des données étiquetées. Elle favorise l’apprentissage continu et contribue à créer des systèmes d’IA visuelle plus flexibles, adaptatifs et intelligents, qui s’améliorent au fil du temps.
Rejoins notre communauté en pleine croissance. Consulte notre dépôt GitHub pour approfondir tes connaissances en IA. Tu souhaites te lancer dans tes propres projets de vision par ordinateur ? Découvre nos options de licence. Pour en savoir plus, consulte nos pages consacrées aux solutions d’IA dans le secteur manufacturier et à l’IA visuelle dans l’industrie automobile.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









