Ultralytics Platform : déployer des modèles de vision par ordinateur dans n’importe quelle région
Découvre comment déployer des modèles de vision par ordinateur sur des points de terminaison dédiés dans 42 régions du monde avec Ultralytics Platform, qui intègre la surveillance.
Plus tôt cette semaine, Ultralytics a lancé Ultralytics Platform, un nouvel environnement de bout en bout conçu pour accélérer la mise en production des systèmes de vision par ordinateur (CV) en simplifiant chaque étape du flux de travail de l’IA visuelle, de la préparation des données et du développement des modèles jusqu’au déploiement.
L’un des principaux objectifs d’Ultralytics Platform est de répondre au constat qu’amener une solution de vision par ordinateur de l’idée à un impact concret ne se limite pas à créer un modèle performant. Une fois entraîné et validé, le modèle doit être déployé afin que les applications puissent envoyer des images, recevoir des prédictions et exécuter l’inférence de manière fiable dans des environnements réels.
C’est à cette étape du cycle de vie de l’apprentissage automatique que les modèles de vision par ordinateur dépassent le stade de l’expérimentation et commencent à alimenter des systèmes pratiques. Même si les étapes précédentes, comme la préparation des jeux de données, l’annotation, l’entraînement et les tests des modèles, se déroulent sans problème, ces résultats ne peuvent rien changer sans un moyen fiable de déployer les modèles.
Dans de nombreux projets de vision par ordinateur, le déploiement peut être l’une des étapes les plus complexes du flux de travail.
Les équipes doivent souvent configurer des API d’inférence, gérer les ressources de calcul, déployer les modèles près des utilisateurs pour réduire la latence et surveiller les performances une fois les systèmes en production.
Ultralytics Platform simplifie et automatise ce processus en proposant plusieurs options de déploiement, notamment des formats d’exportation de modèles, des services d’inférence partagés et des points de terminaison dédiés dans différentes régions du monde. Grâce à une infrastructure gérée et à la surveillance intégrée, les équipes peuvent facilement passer des modèles entraînés à des systèmes de vision par ordinateur prêts pour la production.
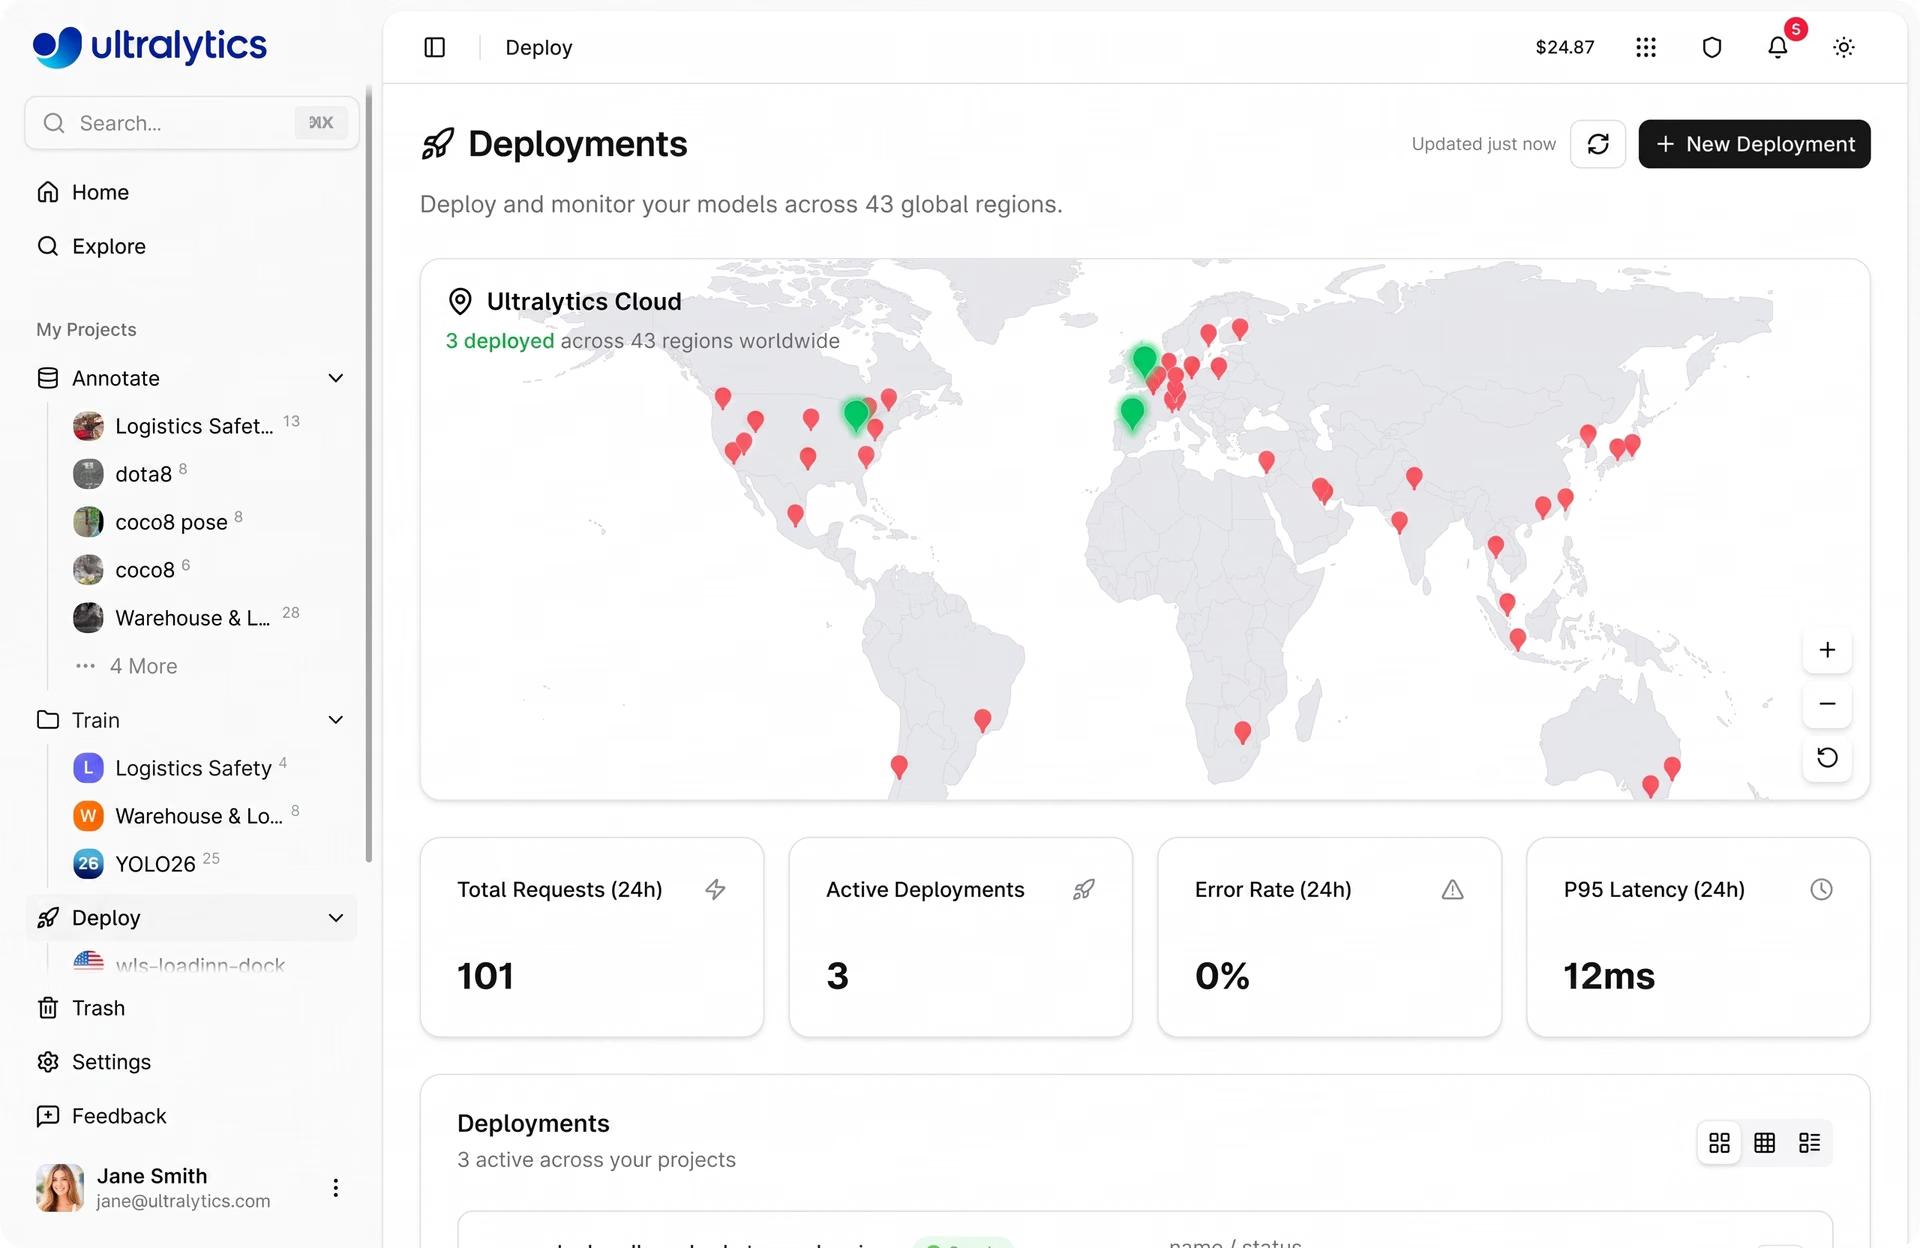
Fig. 1. Aperçu du déploiement de modèles avec Ultralytics Platform (Source)
Dans cet article, nous verrons comment déployer des modèles de vision par ordinateur dans n’importe quelle région à l’aide de points de terminaison dédiés sur Ultralytics Platform.
Qu’est-ce que le déploiement de modèles de vision par ordinateur ?#
Avant d’aborder le déploiement de modèles d’apprentissage profond avec Ultralytics Platform, voyons plus en détail ce que signifie réellement le déploiement de modèles de vision par ordinateur.
Le déploiement de modèles de vision par ordinateur consiste à rendre un modèle entraîné disponible pour une utilisation dans le monde réel. Au lieu de s’exécuter uniquement dans un environnement d’entraînement, le modèle est configuré pour que les applications puissent lui envoyer des images ou des vidéos et recevoir des prédictions en retour.
Par exemple, un modèle peut détecter des objets dans une image, segmenter une image, identifier des articles dans un entrepôt ou reconnaître des motifs dans des séquences vidéo. Dans la plupart des systèmes réels, cela se fait par l’intermédiaire d’une API ou d’un point de terminaison d’inférence.
Une application envoie une image au modèle, le modèle la traite et renvoie une prédiction en quelques millisecondes. C’est ce qui permet aux modèles de vision par ordinateur comme Ultralytics YOLO de prendre en charge des applications en temps réel.
Les modèles peuvent être déployés dans différents environnements selon le cas d’usage. Certains s’exécutent dans le cloud (via des plateformes cloud) et sont accessibles à de nombreuses applications, tandis que d’autres fonctionnent sur des appareils périphériques, comme des caméras sur site, des robots ou des systèmes embarqués qui nécessitent des prédictions locales rapides.
Options de déploiement des modèles d’IA sur Ultralytics Platform#
Ultralytics Platform répond à bon nombre des difficultés que rencontre la communauté de la vision par ordinateur lors du déploiement de modèles et propose différentes façons d’exécuter l’inférence selon les besoins de ton application.
Voici un aperçu des options de déploiement de modèles disponibles sur la plateforme :
- Exportation des modèles : tu peux exporter les modèles dans 22 formats différents, notamment ONNX, TensorRT, CoreML et TFLite, afin de les exécuter dans un large éventail d’environnements : appareils en périphérie comme Raspberry Pi et NVIDIA Jetson, applications mobiles, conteneurs Docker et infrastructures personnalisées.
- Inférence partagée : La plateforme te permet d’exécuter des prédictions via un service d’inférence partagé et géré, idéal pour tester rapidement des modèles.
- Points de terminaison dédiés : déploie facilement tes modèles en tant que services indépendants, avec des URL d’API uniques disponibles dans 42 régions du monde, ainsi que la mise à l’échelle à zéro, la surveillance et les contrôles d’état pour les déploiements en production.
Déploiement à l’aide de points de terminaison dédiés#
L’une des façons les plus évolutives d’exécuter des modèles préentraînés ou des modèles de vision par ordinateur entraînés sur mesure en production sur Ultralytics Platform consiste à utiliser des points de terminaison dédiés. Un point de terminaison dédié te permet de déployer un modèle entraîné sous forme de service autonome, afin que les applications puissent lui envoyer des images et recevoir des prédictions via une API.
Au lieu d’exécuter un modèle uniquement dans un environnement d’entraînement ou un notebook local, le déployer sous forme de point de terminaison le rend accessible aux applications réelles. Par exemple, un système d’entrepôt pourrait envoyer des images de colis pour la détection d’objets, une caméra intelligente pourrait analyser des images vidéo ou un système robotique pourrait utiliser les prédictions pour guider ses actions.
Chaque point de terminaison dédié fonctionne comme un service à locataire unique, ce qui signifie que l’infrastructure qui exécute ton modèle n’est pas partagée avec d’autres utilisateurs. Cela garantit des performances plus prévisibles et facilite la surveillance du comportement du modèle en production.
Comprendre le fonctionnement des points de terminaison d’inférence dédiés#
Tu peux considérer un point de terminaison dédié comme un service hébergé pour ton modèle. Ultralytics Platform fournit une URL de point de terminaison unique qui sert de point d’entrée aux applications.
Lorsqu’une application envoie une requête à cette URL, elle inclut une image et des paramètres facultatifs, comme des seuils de confiance ou la taille de l’image, ainsi qu’une clé API pour l’authentification.
Le service exécute l’inférence sur l’image à l’aide de ton modèle et renvoie les prédictions dans une réponse structurée. Cette configuration permet aux développeurs d’intégrer des modèles de vision par ordinateur à des systèmes réels à l’aide d’outils Web standard.
Les applications peuvent envoyer des requêtes à l’aide de Python, JavaScript, cURL ou d’autres clients HTTP, ce qui facilite la connexion des modèles à des tableaux de bord, des systèmes robotiques ou des applications cloud. Comme le point de terminaison fonctionne de manière indépendante, il peut également prendre en charge la mise à l’échelle, la surveillance et le déploiement mondial, aidant ainsi les équipes à créer des systèmes de vision par ordinateur fiables pour la production.
Le déploiement multirégional améliore l’inférence en temps réel#
L’un des principaux avantages des points de terminaison dédiés sur Ultralytics Platform est la possibilité de déployer des modèles dans 42 régions du monde. Ces régions couvrent différentes parties du globe, notamment l’Amérique du Nord, l’Amérique du Sud, l’Europe, l’Asie-Pacifique, ainsi que le Moyen-Orient et l’Afrique.
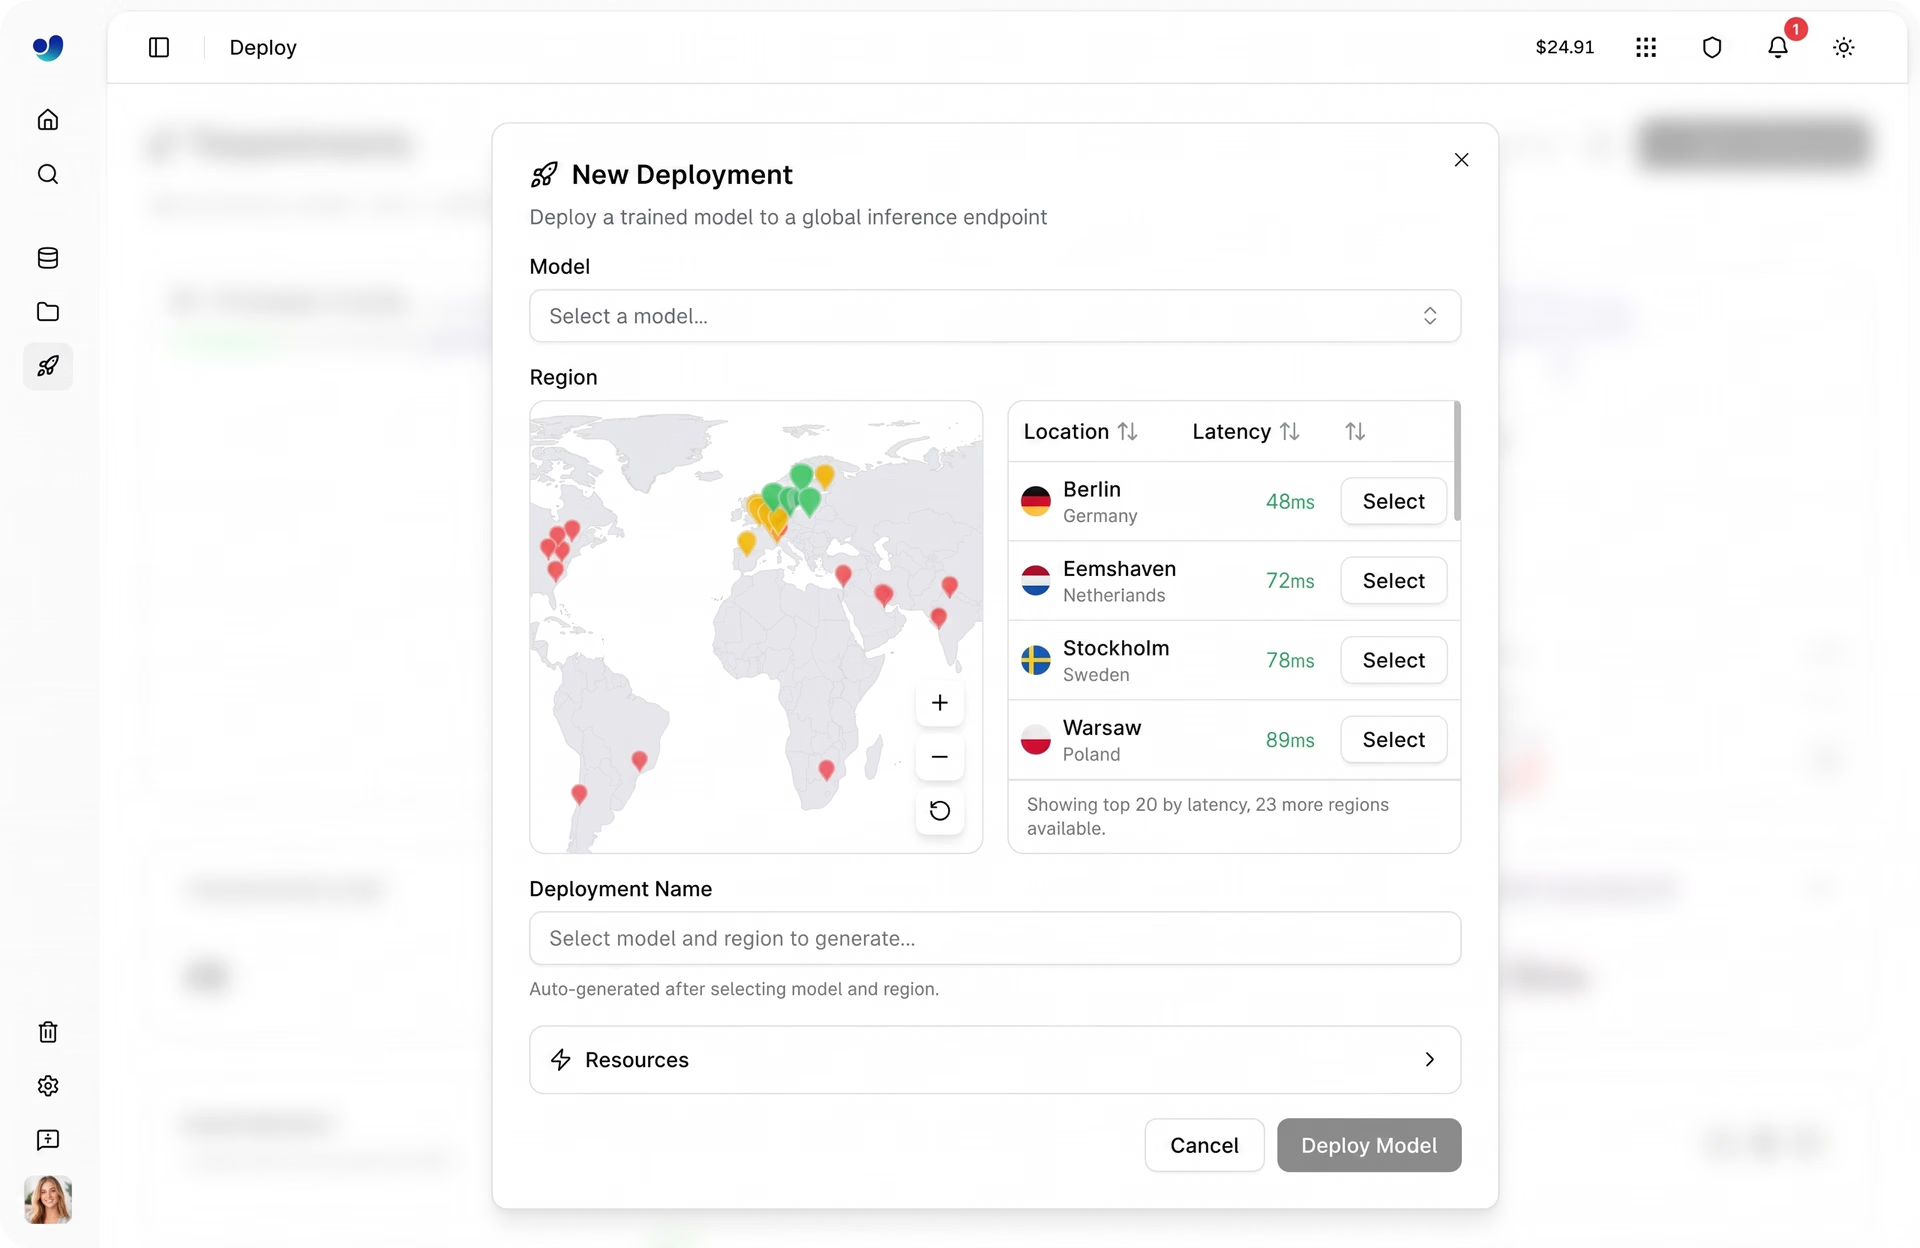
Fig. 2. Ultralytics Platform prend en charge 42 régions du monde (Source)
Déployer des modèles dans des régions proches de l’emplacement des applications permet de réduire la latence, c’est-à-dire le temps nécessaire à une application pour envoyer une image et recevoir une prédiction. Cela peut également aider les organisations à respecter les exigences en matière de confidentialité et de localisation des données, en rapprochant le traitement des données de leur lieu d’origine.
Une faible latence est importante pour de nombreuses applications de vision par ordinateur qui reposent sur l’inférence en temps réel, comme les systèmes robotiques, les appareils de l’Internet des objets (IoT), les chaînes d’inspection industrielle et les infrastructures des villes intelligentes.
Par exemple, si une application est principalement utilisée en Europe, déployer le modèle dans une région européenne peut considérablement améliorer les temps de réponse par rapport à l’exécution du modèle dans une région éloignée.
Comment déployer dans n’importe quelle région avec Ultralytics Platform#
Déployer un modèle dans une région précise est simple et ne prend généralement que quelques minutes. La plateforme gère la configuration de l’infrastructure afin que les développeurs puissent se concentrer sur l’intégration du modèle à leurs applications. Voyons les étapes à suivre.
Étape 1 : entraîner ou importer un modèle#
Avant le déploiement, tu dois disposer d’un modèle entraîné dans ton projet. Il peut s’agir d’un modèle entraîné directement sur Ultralytics Platform, d’un modèle importé après avoir été entraîné ailleurs ou d’un modèle cloné à partir d’un projet communautaire trouvé dans l’onglet « Explorer », où tu peux copier en un clic sur ton compte les projets publics partagés par d’autres utilisateurs.
Une fois le modèle prêt, ouvre sa page dans ton projet pour continuer.
Étape 2 : ouvrir l’onglet Deploy#
Accède à l’onglet Deploy du modèle. Cette section de la plateforme te permet de configurer et de lancer des déploiements.
Sur cette page, tu verras un tableau des régions et une carte interactive présentant les emplacements de déploiement disponibles dans le monde. La plateforme mesure la latence depuis ton emplacement et classe les régions en conséquence pour t’aider à choisir celle qui te convient le mieux.
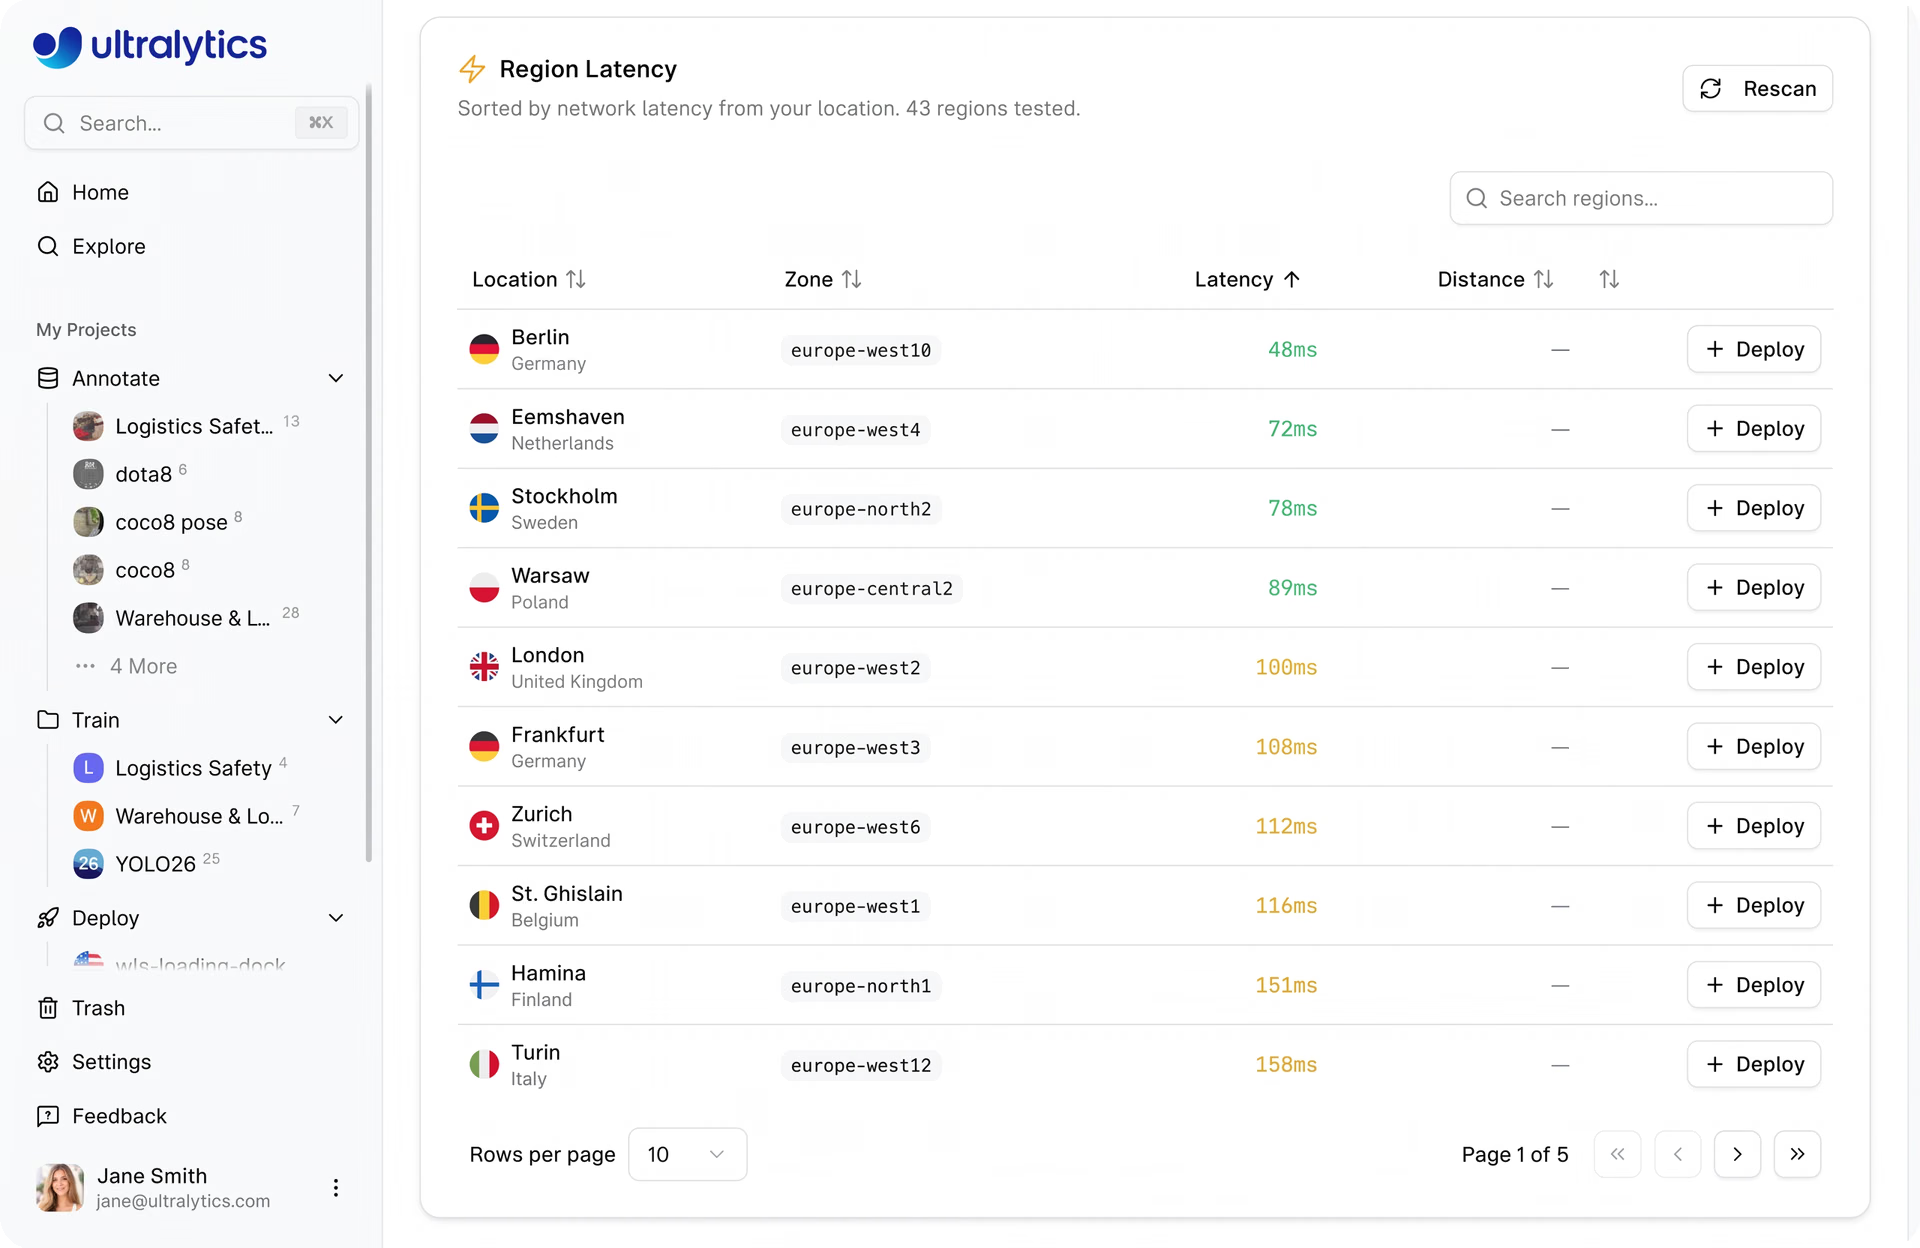
Fig. 3. Régions classées par latence sur Ultralytics Platform (Source)
Étape 3 : choisir une région de déploiement#
Choisis une région en fonction de l’emplacement de tes utilisateurs ou de tes applications. Déployer le modèle plus près de la source des requêtes peut considérablement réduire les temps de réponse.
Étape 4 : déployer le point de terminaison#
Après avoir sélectionné la région et confirmé la configuration, tu peux cliquer sur Deploy.
La plateforme prépare ensuite l’environnement de déploiement, récupère l’image du modèle, démarre le service et effectue une vérification de l’état de santé pour s’assurer que le point de terminaison est prêt. Ce processus prend généralement une à deux minutes.
Une fois le déploiement terminé, la plateforme génère une URL unique de point de terminaison que les applications peuvent utiliser pour envoyer des requêtes d’inférence.
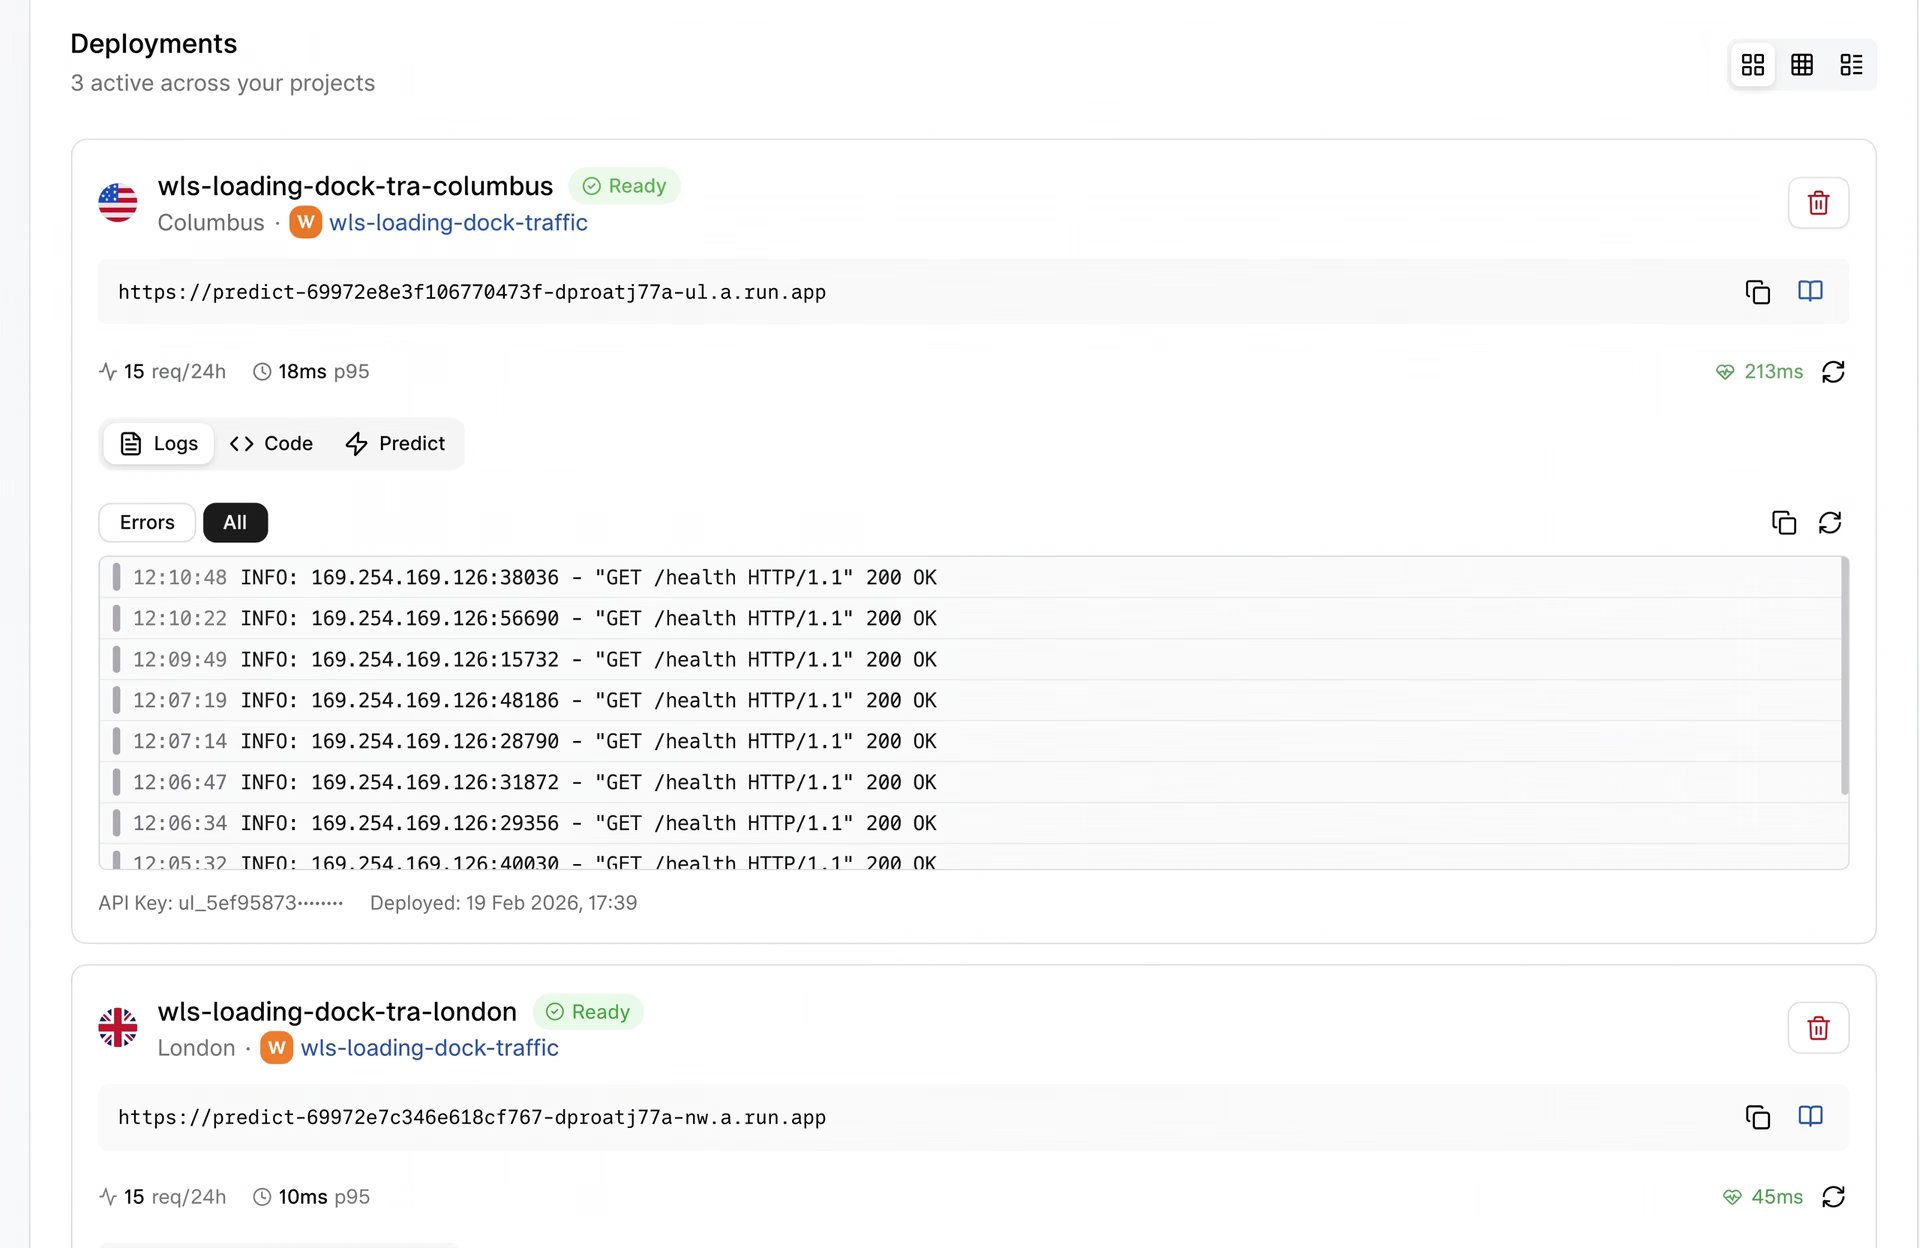
Fig. 4. Exemple de point de terminaison déployé (Source)
Étape 5 : commencer à envoyer des requêtes d’inférence#
Une fois le point de terminaison opérationnel, les applications peuvent commencer à envoyer des images au modèle à l’aide du point de terminaison REST API fourni et d’une clé API transmise dans l’en-tête Authorization. Le point de terminaison traite chaque requête et renvoie des prédictions, telles que les objets détectés, les boîtes englobantes ou d’autres sorties propres à la tâche.
Pour en savoir plus sur le déploiement des modèles, consulte la documentation officielle d’Ultralytics Platform.
Surveiller les performances et les métriques des modèles pour les points de terminaison déployés#
Une fois un modèle de vision par ordinateur déployé, surveiller ses performances devient essentiel pour maintenir la fiabilité et la robustesse du système. Même un modèle bien entraîné doit être observé en production afin de vérifier qu’il continue à répondre rapidement, à traiter correctement les requêtes entrantes et à fournir des prédictions exactes.
Ultralytics Platform fournit des outils de surveillance intégrés qui permettent aux équipes de suivre les performances des points de terminaison déployés. La page Deploy de la plateforme sert de tableau de bord de surveillance et propose une vue centralisée de tous les points de terminaison actifs, ainsi que des métriques clés pour suivre l’état et l’utilisation du système.
Voici quelques métriques que tu peux surveiller avec la plateforme :
- Latence P95 : cette métrique mesure le temps de réponse côté serveur au 95e percentile pour les requêtes d’inférence. Elle indique le temps nécessaire au traitement de la plupart des requêtes d’inférence et permet de repérer les ralentissements.
- Taux d’erreur : il correspond au pourcentage de requêtes ayant échoué ou renvoyé des erreurs pendant la période de surveillance sélectionnée. Surveiller les taux d’erreur permet aux équipes de détecter rapidement les problèmes liés aux déploiements ou aux requêtes entrantes.
- Nombre total de requêtes : cette métrique indique le nombre total de requêtes d’inférence traitées par les points de terminaison déployés pendant la période sélectionnée (par exemple, les dernières 24 heures). Elle aide les équipes à comprendre le volume du trafic et la fréquence d’utilisation de leurs modèles.
En plus de ces métriques, la plateforme fournit également des contrôles d’état des points de terminaison et des journaux de déploiement. Les contrôles d’état indiquent si un point de terminaison répond correctement, tandis que les journaux fournissent des informations détaillées sur les requêtes récentes et l’activité du système.
Points clés à retenir#
Le déploiement de modèles de vision par ordinateur est une étape essentielle pour transformer des modèles entraînés en systèmes qui alimentent des applications concrètes. Avec Ultralytics Platform, les équipes peuvent facilement déployer des modèles sur des points de terminaison dédiés dans 42 régions du monde, exécuter l’inférence en temps réel via des API et surveiller les performances depuis un environnement unique. En combinant des options de déploiement flexibles, une surveillance intégrée et une infrastructure évolutive, la plateforme aide les développeurs à passer plus rapidement de modèles d’apprentissage automatique entraînés à des applications de vision par ordinateur fiables.
Rejoins notre communauté en pleine croissance ! Explore notre dépôt GitHub pour en savoir plus sur l’IA. Si tu souhaites créer des solutions de vision par ordinateur, consulte nos options de licence. Découvre les avantages de la vision par ordinateur dans le secteur de la santé et vois comment l’IA dans la logistique fait la différence !
Comments
Ask a question, share your results, or help someone else.









