Comment exporter des modèles Ultralytics YOLO avec Ultralytics Platform
Exporte facilement des modèles d’IA pour la vision avec Ultralytics Platform. Découvre comment préparer des modèles en quelques clics pour un déploiement en périphérie, sur mobile et dans le cloud.
Le mois dernier, nous avons lancé Ultralytics Platform, un espace de travail unifié conçu pour simplifier l’ensemble du flux de travail de vision par ordinateur. Il réunit les principales fonctionnalités de l’IA visuelle — gestion des jeux de données, annotation, entraînement des modèles, tests, déploiement et suivi — dans une interface unique et fluide.
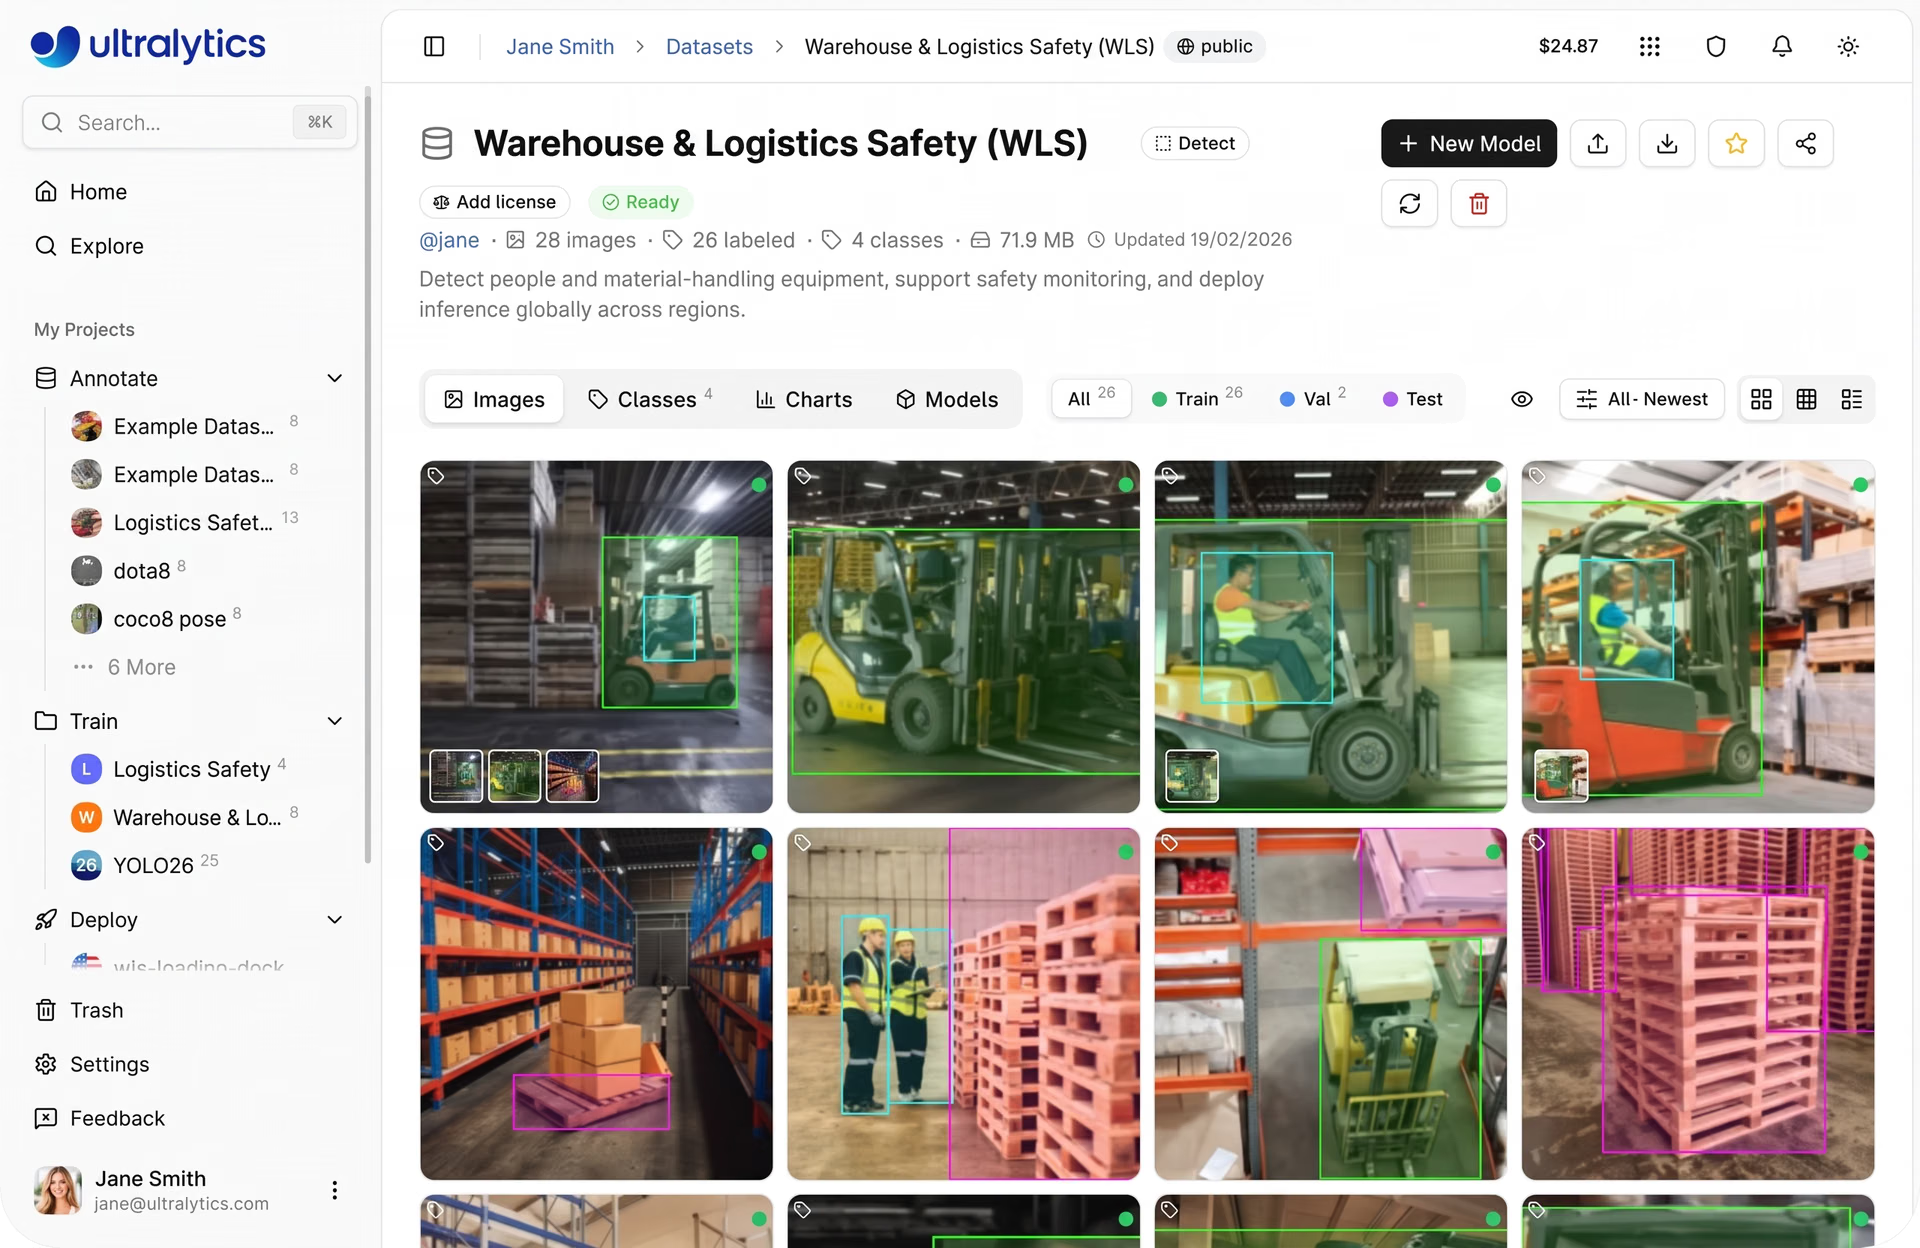
Fig. 1. Aperçu d’Ultralytics Platform (Source)
Dans ce flux de travail de bout en bout, le déploiement joue un rôle essentiel pour passer de l’expérimentation à une utilisation concrète des modèles. Nous avons précédemment présenté les différentes options de déploiement disponibles sur la plateforme, notamment l’inférence partagée via des API, des points de terminaison dédiés aux déploiements en production évolutifs et l’exportation de modèles pour les exécuter sur des appareils en périphérie ou une infrastructure externe.
Examinons maintenant de plus près l’exportation des modèles et la façon dont elle facilite leur déploiement dans différents environnements. Contrairement à l’inférence partagée et aux points de terminaison dédiés, qui exécutent les modèles sur l’infrastructure gérée par Ultralytics Platform, l’exportation permet de déployer et d’exécuter les modèles dans des environnements externes, comme des appareils en périphérie, des applications mobiles et des infrastructures personnalisées.
Avant de pouvoir exécuter les modèles dans ces environnements, il faut les convertir dans des formats pris en charge par l’environnement d’exécution cible. Chaque configuration de déploiement a ses propres exigences, qu’il s’agisse de formats légers pour les appareils mobiles et en périphérie ou de formats hautes performances pour le cloud et les systèmes reposant sur un GPU.
Traditionnellement, ce processus peut prendre beaucoup de temps et nécessite des scripts, des dépendances et plusieurs outils. Avec Ultralytics Platform, l’exportation est beaucoup plus simple. Les modèles se convertissent et s’optimisent en quelques clics, sans configuration supplémentaire.
Dans cet article, nous allons expliquer ce que signifie l’exportation de modèles, présenter les formats pris en charge par Ultralytics Platform et t’aider à choisir celui qui convient à ton cas d’utilisation. Commençons !
Présentation de l’exportation d’un modèle#
L’exportation d’un modèle consiste à convertir un modèle préentraîné ou entraîné sur mesure dans un format utilisable en dehors de son framework d’origine. Les modèles Ultralytics YOLO sont conçus avec PyTorch et enregistrés dans leur format natif, qui convient parfaitement à l’entraînement, à l’évaluation et à l’expérimentation dans l’écosystème PyTorch.
Cependant, les environnements de déploiement utilisent souvent des environnements d’exécution et des composants matériels différents. Le format utilisé pendant l’entraînement ne convient donc pas toujours au déploiement.
Par exemple, une application mobile peut nécessiter un format léger optimisé pour une faible consommation d’énergie, tandis qu’une application exécutée dans un navigateur a besoin d’un format qui fonctionne efficacement sur le Web.
Les appareils en périphérie, comme les caméras et les systèmes embarqués, tirent parti de modèles compacts et rapides, tandis que les systèmes cloud sont conçus pour l’inférence haute performance. Pour répondre à ces différents besoins, les modèles doivent être exportés dans des formats compatibles.
Pourquoi l’option d’exportation des modèles est plus importante que jamais#
Aujourd’hui, les modèles de vision par ordinateur sont déployés plus près de l’endroit où les données sont générées, en particulier sur les appareils en périphérie. Les smartphones exécutent des applications de vision en temps réel, les caméras de vidéosurveillance effectuent leur suivi directement sur l’appareil et les systèmes autonomes s’appuient sur une prise de décision instantanée.
Le déploiement dans ces environnements présente toutefois ses propres défis. Les appareils en périphérie ont une puissance de calcul limitée, des exigences strictes en matière de latence et des contraintes de mémoire et de consommation d’énergie. Un modèle performant à l’entraînement, lorsque les ressources sont suffisantes, risque de ne pas fonctionner efficacement dans ces conditions restreintes.
Exporter un modèle dans le bon format peut aider à relever ces défis. Une conversion adaptée permet d’optimiser le modèle pour la vitesse, de réduire sa taille et de le rendre compatible avec du matériel spécifique.
L’exportation offre aussi de la flexibilité. Le même modèle peut être adapté à différents environnements de déploiement en le convertissant dans plusieurs formats selon les besoins.
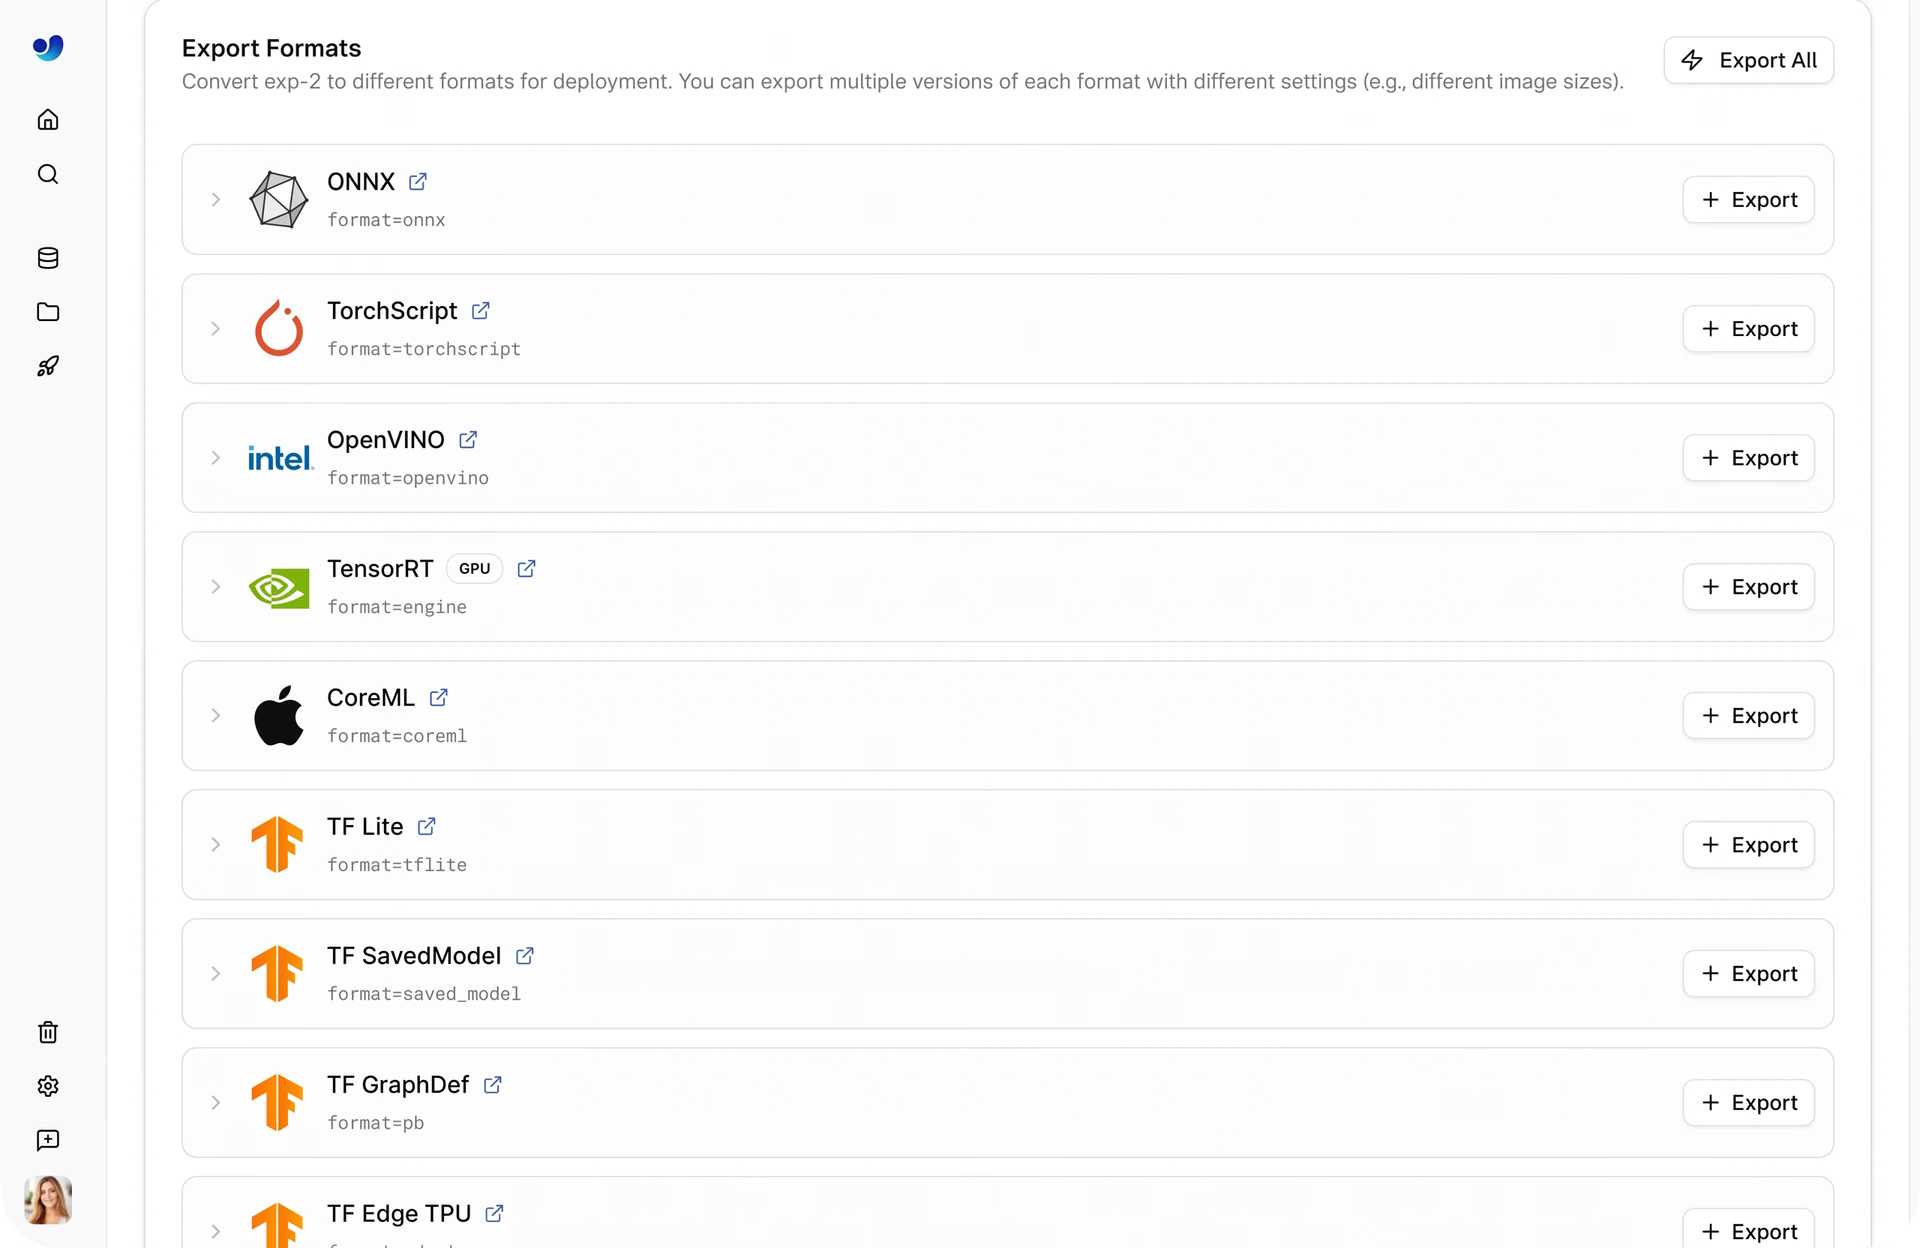
Fig. 2. Quelques formats d’exportation disponibles dans Ultralytics Platform (Source)
Par exemple, le format de modèle NCNN est optimisé pour les appareils mobiles et en périphérie ayant des ressources limitées. Le format OpenVINO, quant à lui, est adapté au matériel Intel et offre de meilleures performances sur les unités centrales de traitement (CPUs), les processeurs graphiques (GPUs) et les processeurs neuronaux (NPUs).
Dans la plupart des cas, atteindre ce niveau de flexibilité impliquait de gérer manuellement les conversions, les dépendances et plusieurs outils, ce qui rendait le processus long et complexe. Ultralytics Platform simplifie ce flux de travail en rendant l’exportation des modèles plus accessible et plus facile à gérer.
Comment Ultralytics Platform simplifie l’exportation des modèles#
L’exportation d’un modèle est généralement considérée comme une étape distincte et complexe des flux de travail de vision par ordinateur. Ultralytics Platform change la donne en intégrant l’option d’exportation directe d’un modèle dans un espace de travail unique qui couvre toutes les étapes, de l’entraînement au déploiement.
L’un de ses principaux avantages est l’exportation sans code. Tu n’as pas besoin d’écrire des scripts, de gérer des environnements ni d’utiliser des commandes propres à un framework. Une interface simple permet d’exporter les modèles en quelques clics.
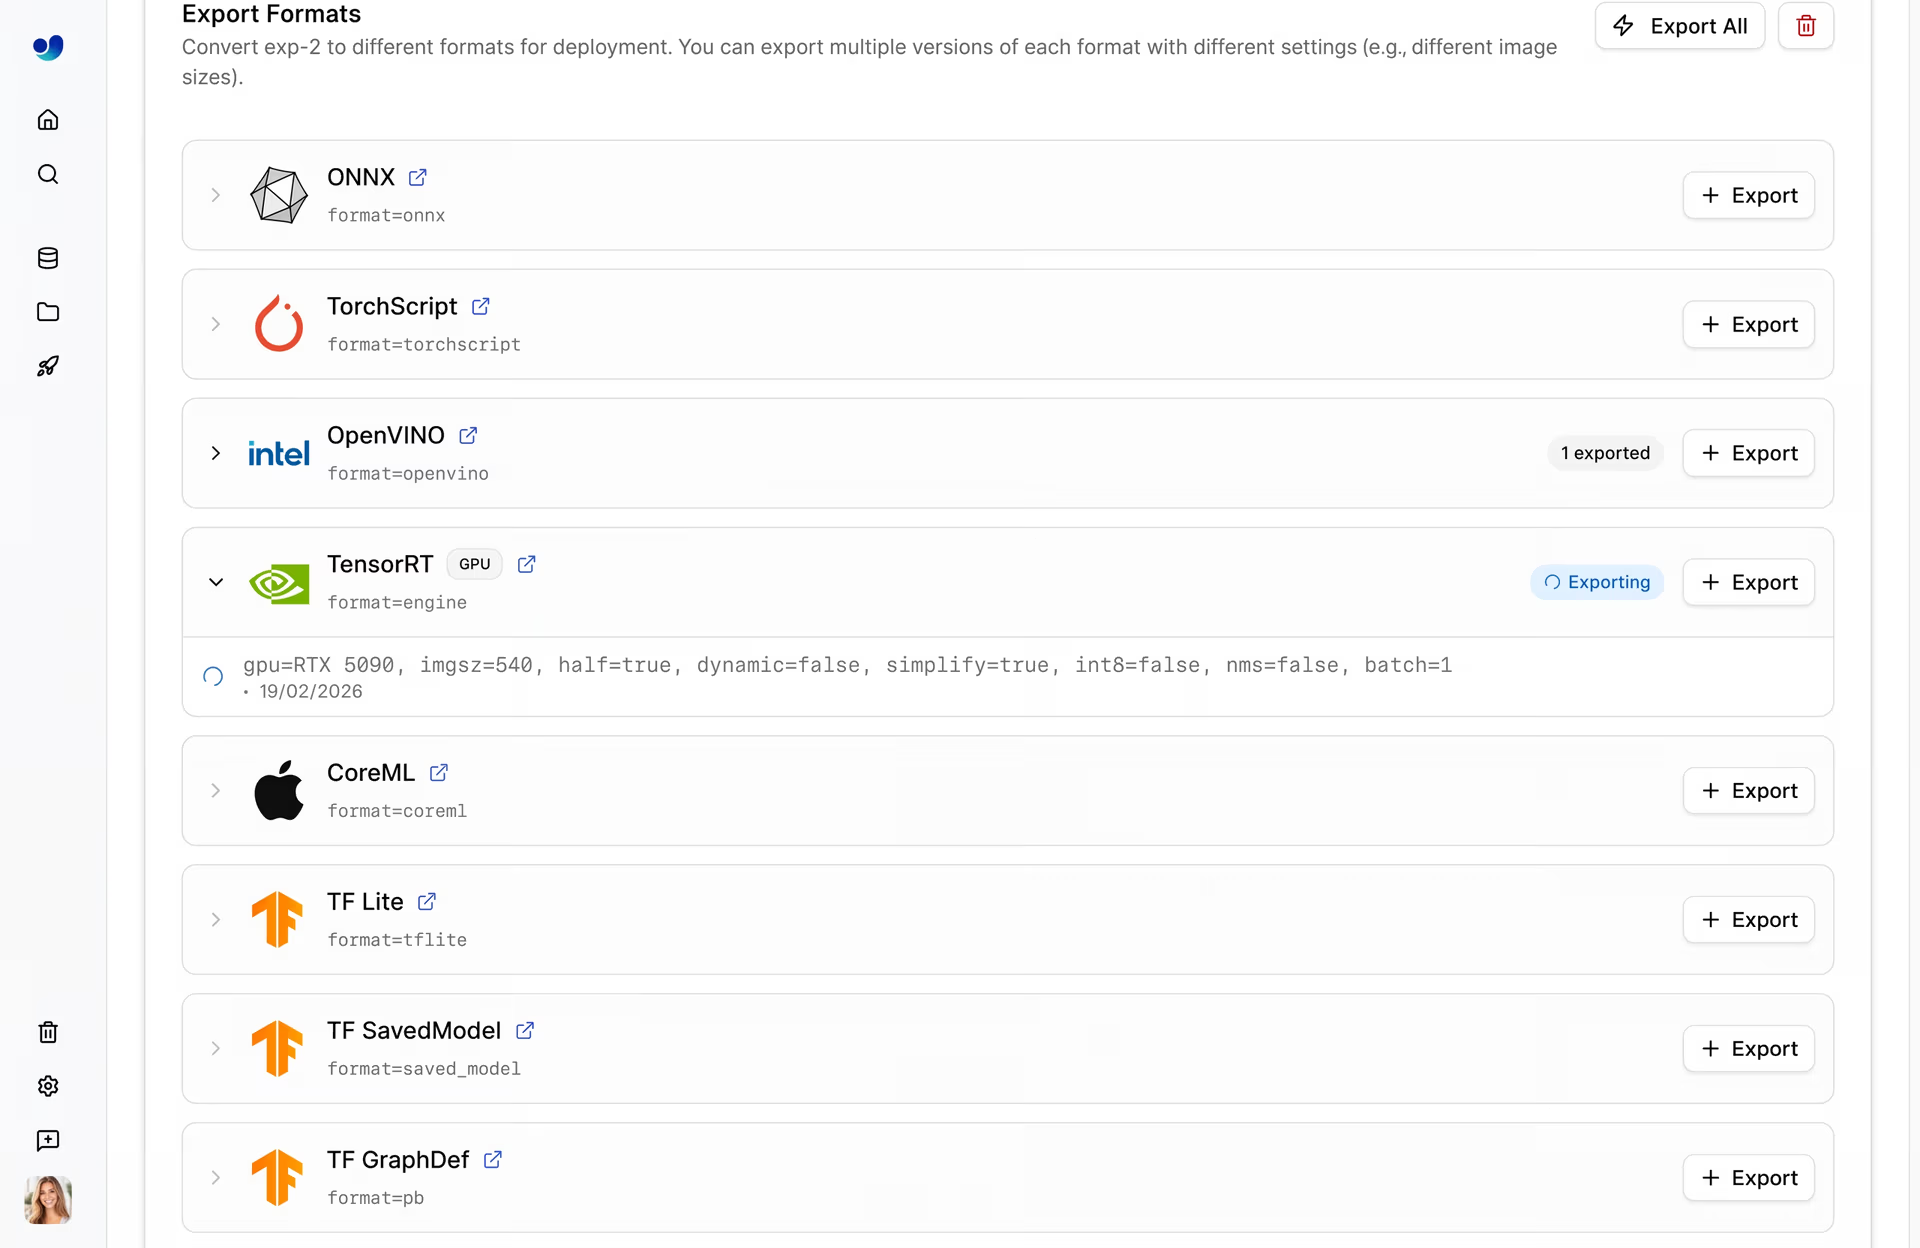
Fig. 3. Exemple d’exportation d’un modèle depuis Ultralytics Platform (Source)
En coulisses, la plateforme se charge des tâches complexes. Les opérations qui nécessiteraient habituellement plusieurs outils et une configuration manuelle sont regroupées dans un processus unique. Tu n’as pas à installer de dépendances supplémentaires ni à gérer de problèmes de compatibilité : il est ainsi beaucoup plus facile de passer d’un modèle entraîné à une solution prête pour la production.
Formats d’exportation pris en charge par Ultralytics Platform#
Ultralytics Platform prend en charge 21 formats d’exportation, ce qui facilite la préparation des modèles pour un large éventail d’environnements de déploiement, sans complexité supplémentaire.
Voici un aperçu de quelques formats d’exportation couramment utilisés :
- Interopérabilité et multiplateforme : ONNX et TorchScript sont largement utilisés pour exécuter des modèles dans différents frameworks et environnements. ONNX sert de passerelle entre les écosystèmes et facilite le transfert des modèles d’un outil à l’autre, tandis que TorchScript permet d’exécuter des modèles PyTorch en production sans environnement d’exécution Python.
- Inférence haute performance sur GPU : TensorRT est conçu pour les GPU NVIDIA et vise à optimiser les modèles afin d’obtenir une faible latence et un débit élevé. Il prend en charge des techniques comme la réduction de précision et la fusion de couches pour accélérer l’inférence, ce qui en fait un excellent choix pour les applications en temps réel et à l’échelle de la production.
- Déploiement mobile et en périphérie : CoreML, LiteRT (TensorFlow Lite) et NCNN sont optimisés pour les appareils aux capacités de calcul et à la mémoire limitées. Ces formats réduisent la taille des modèles et améliorent leur efficacité, ce qui permet d’obtenir de bonnes performances sur les smartphones, les systèmes embarqués et le matériel en périphérie. CoreML est généralement utilisé dans l’écosystème Apple, tandis que LiteRT est courant sur Android.
- Exécution optimisée pour le matériel : OpenVINO est adapté au matériel Intel, notamment aux CPU, aux GPU et aux VPU, et contribue à améliorer la vitesse et l’efficacité de l’inférence sur ces appareils. Ces formats spécifiques au matériel sont utiles lorsque tu veux obtenir les meilleures performances d’un système particulier.
- Environnements d’exécution spécifiques à un framework et spécialisés : des formats comme PaddlePaddle et ExecuTorch répondent aux besoins de certains écosystèmes et déploiements, notamment pour exécuter efficacement des modèles sur des appareils en périphérie ou les intégrer à des piles d’apprentissage profond spécifiques.
Comment exporter un modèle avec Ultralytics Platform#
L’exportation d’un modèle sur Ultralytics Platform est un processus simple qui s’effectue dans l’interface utilisateur. L’ensemble du flux de travail passe par l’interface, sans scripts ni outils en ligne de commande.
Voici comment exporter un modèle avec la plateforme :
- Connecte-toi et choisis ton modèle : accède à ton projet et ouvre le modèle entraîné que tu veux exporter.
- Accède à l’onglet Export : dans le tableau de bord du modèle, clique sur l’onglet Export pour afficher les options d’exportation disponibles.
- Choisis un format d’exportation : sélectionne un format comme ONNX, TensorRT ou CoreML en fonction de tes besoins de déploiement.
- Configure les paramètres d’exportation (facultatif) : ajuste des paramètres comme la taille des images, la précision ou la taille du lot pour optimiser les performances.
- Lance le processus d’exportation : clique sur « Start Export » pour démarrer. La plateforme effectue automatiquement la conversion.
- Télécharge le modèle exporté : une fois l’exportation terminée, tu peux télécharger le modèle et l’utiliser dans ton pipeline de déploiement.
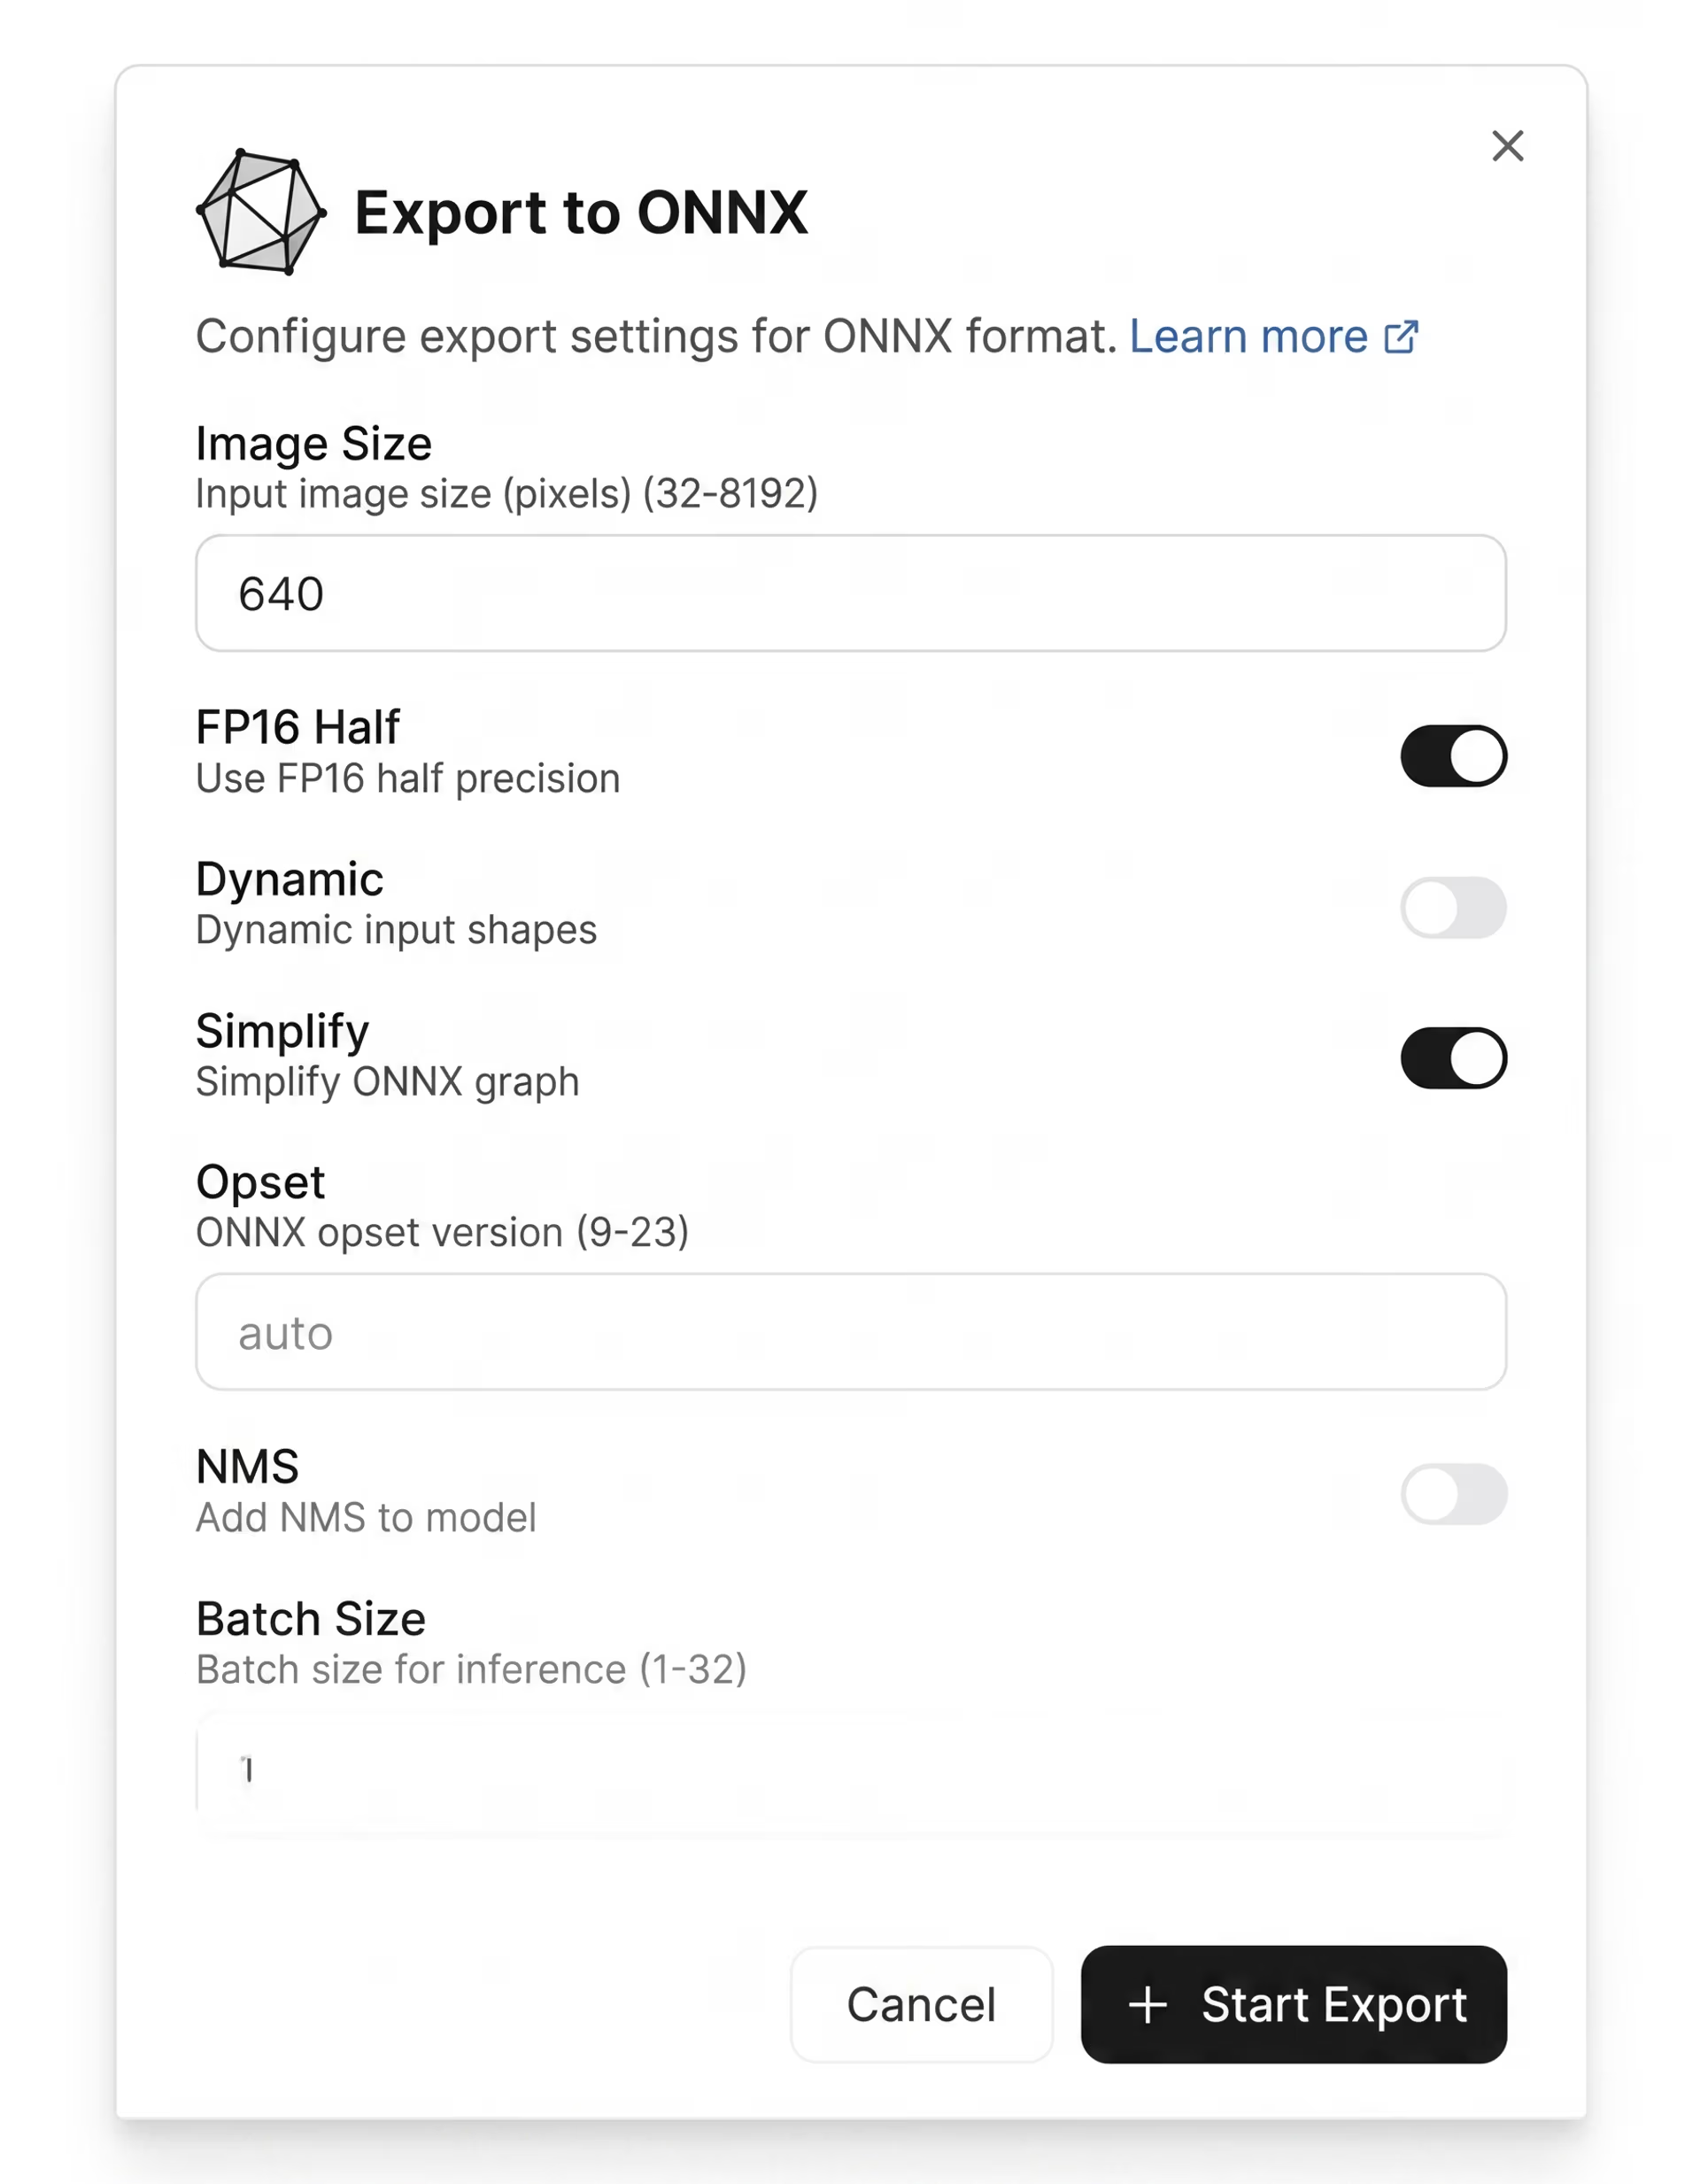
Fig. 4. Configuration des paramètres d’exportation dans Ultralytics Platform
Choisir le bon format d’exportation#
En découvrant les différents formats d’exportation pris en charge par Ultralytics Platform, tu te demandes peut-être lequel choisir. La réponse dépend vraiment de l’endroit et de la façon dont tu comptes utiliser ton modèle.
Voici quelques facteurs à prendre en compte :
- Exigences de latence : pour les applications en temps réel, comme l’analyse vidéo ou les systèmes autonomes, une faible latence est essentielle. Les formats optimisés pour l’inférence haute performance, comme TensorRT, sont souvent plus adaptés.
- Contraintes matérielles : les appareils à mémoire et à puissance de traitement limitées, comme les téléphones mobiles ou les systèmes embarqués, nécessitent des formats légers comme LiteRT ou NCNN.
- Taille du modèle et consommation d’énergie : lorsque tu travailles avec des appareils en périphérie, la taille du modèle et la consommation d’énergie deviennent importantes. Des modèles plus petits et optimisés contribuent à garantir des performances constantes sans épuiser les ressources.
- Environnement de déploiement : si ton modèle doit fonctionner sur différentes plateformes, des formats comme ONNX offrent de la flexibilité. Pour des cas d’utilisation propres à une plateforme, comme les applications iOS, CoreML est souvent le meilleur choix.
Il n’existe pas de format universel. Tout dépend de l’équilibre entre performances, compatibilité et limites de ton environnement cible. Ultralytics Platform facilite ce choix en te permettant d’essayer et de comparer différents formats sans effort supplémentaire.
Points clés à retenir#
L’exportation est une étape essentielle pour préparer ton modèle à une utilisation réelle dans différents environnements. Avec Ultralytics Platform, le processus devient beaucoup plus simple : tu peux convertir et optimiser tes modèles sans configuration ni complexité supplémentaires. En choisissant le format adapté à ton cas d’utilisation, tu peux garantir le bon fonctionnement de ton modèle dans l’environnement où tu le déploies.
Rejoins notre communauté en pleine expansion et consulte notre dépôt GitHub pour en savoir plus sur la vision par ordinateur. Découvre nos pages de solutions pour en savoir plus sur des applications comme l’IA en robotique et la vision par ordinateur dans la logistique. Découvre nos options de licence et commence à créer avec l’IA visuelle !









