コンピュータービジョンにおける教師あり学習と教師なし学習を探る
コンピュータービジョンにおける教師あり学習と教師なし学習の違い、データやプロジェクトの目標に合ったアプローチの選び方をご紹介します。
人工知能(AI)は、人間の知能に似た方法で機械に学習や推論を行わせるという中核的な考え方に基づいています。人が直接教わったり、パターンや経験を観察したりするなど、さまざまな方法で学ぶのと同様に、AIや機械学習のシステムも、こうした方法に従うよう設計されています。
具体的には、機械学習アルゴリズムでは、システムは個々のタスクについて明示的にプログラミングされるのではなく、データから学習するようにトレーニングされます。固定されたルールに頼るのではなく、機械学習モデルはデータ内のパターンを特定し、そのパターンを使って予測や判断を行います。
たとえば、コンピュータービジョンはAIと機械学習の一分野であり、画像や動画などの視覚情報をシステムが解釈し、理解できるようにすることを目指しています。物体の認識から大規模なデータセットに潜むパターンの特定まで、こうしたシステムは学習方法に大きく依存します。
利用可能なデータの種類や解決する問題に応じて、これらのシステムのトレーニングにはさまざまなAI学習手法が用いられます。
一部のコンピュータービジョンモデルは、各入力に正解が対応付けられたラベル付きデータから学習します。つまり、すべての画像やデータポイントに、モデルが何を表しているかを示す事前定義済みのラベルが付いています。これにより、モデルは入力と期待される出力の関係を学習し、新しい未知のデータに対する正確な予測能力を高めることができます。
ほかのビジョンモデルは、事前定義済みの正解が与えられていないラベルなしデータから学習し、データそのものに含まれるパターンや関係性の特定に取り組みます。これらの手法はそれぞれ教師あり学習と教師なし学習と呼ばれ、最先端のコンピュータービジョンシステムの多くを支える基盤となっています。
この記事では、教師あり学習と教師なし学習、それらがコンピュータービジョンでどのように使われるか、そしてビジョンAIプロジェクトに最適な手法の選び方について解説します。さっそく始めましょう!
AIの学習手法がコンピュータービジョンを支える仕組み#
人工知能は、人間の知能を必要とすることが多いタスクを機械が実行できるようにする、さまざまなテクノロジーを含む傘のようなものと考えることができます。この傘の中で、機械学習は重要な分野であり、固定されたルールだけに頼らず、システムがデータから学習できるようにします。
機械学習では、さまざまな学習手法によって、モデルがどのように学習し、時間とともに改善するかが決まります。教師あり学習(正解付きのラベル付きデータから学習)、教師なし学習(ラベルなしデータ内のパターンを特定)、強化学習(フィードバックや報酬を用いて試行錯誤しながら学習)、半教師あり学習(少量のラベル付きデータと大量のラベルなしデータを組み合わせる)などの手法によって、システムが入力データを処理し、出力データを生成する方法が定まります。
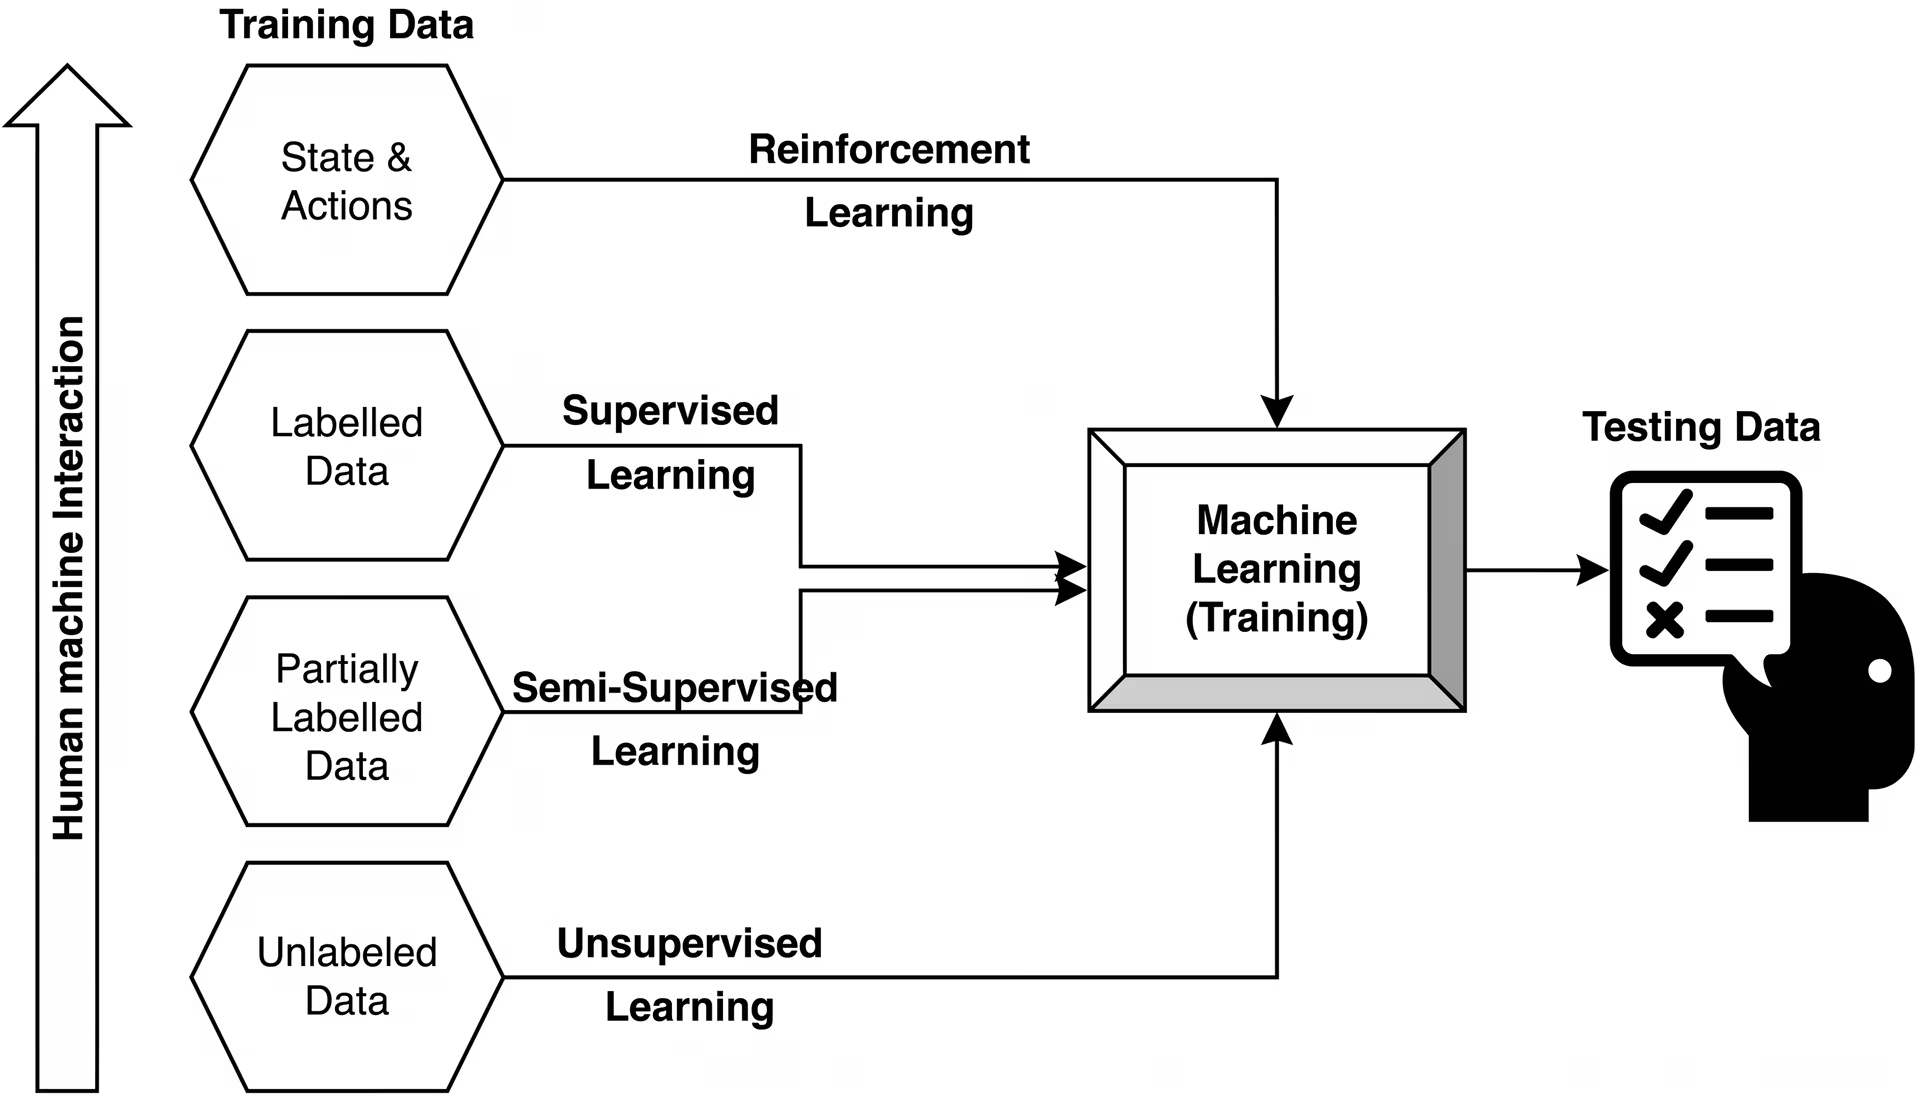
図1. AI学習手法の概要(出典)
特に、コンピュータービジョンシステムは、視覚データを解釈して理解するために、こうした学習手法を用いて構築されます。教師あり学習は、モデルが明確にラベル付けされた例から学習し、正確で信頼性の高い結果を出せるため、最も一般的に用いられる手法です。
たとえば、「猫」や「犬」とラベル付けされた画像でモデルをトレーニングすると、形状、耳、顔の構造などの特徴を学習し、分類アルゴリズムを使って新しい画像を正しく分類できるようになります。一方、教師なし学習と半教師あり学習もコンピュータービジョンで使われており、多くの場合、データ内のパターンを調べたり、ラベル付きデータが限られている状況で性能を向上させたりするために利用されます。
コンピュータービジョンにおける教師あり学習モデルの活用#
教師あり学習アルゴリズムは、教師が例と正解を示し、生徒が何が正しく何が間違っているかを学ぶ教室の状況にたとえることができます。機械学習では、各入力に既知の出力が対応付けられたラベル付きデータを使って、モデルが同じように学習します。
たとえば、野球の試合分析を自動化するコンピュータービジョンシステムの構築に取り組んでいるとします。ボール、バット、選手などの物体にラベルを付けた画像や動画フレームを使って、Ultralytics YOLO26のようなモデルをトレーニングできます。
各物体には位置とカテゴリを示すマークを付け、モデルが何を探すべきか学習できるようにします。時間の経過とともに、モデルは新しい映像内でこれらの物体を検出して位置を特定できるようになり、フレーム間のボール追跡や選手検出などのユースケースを支援します。
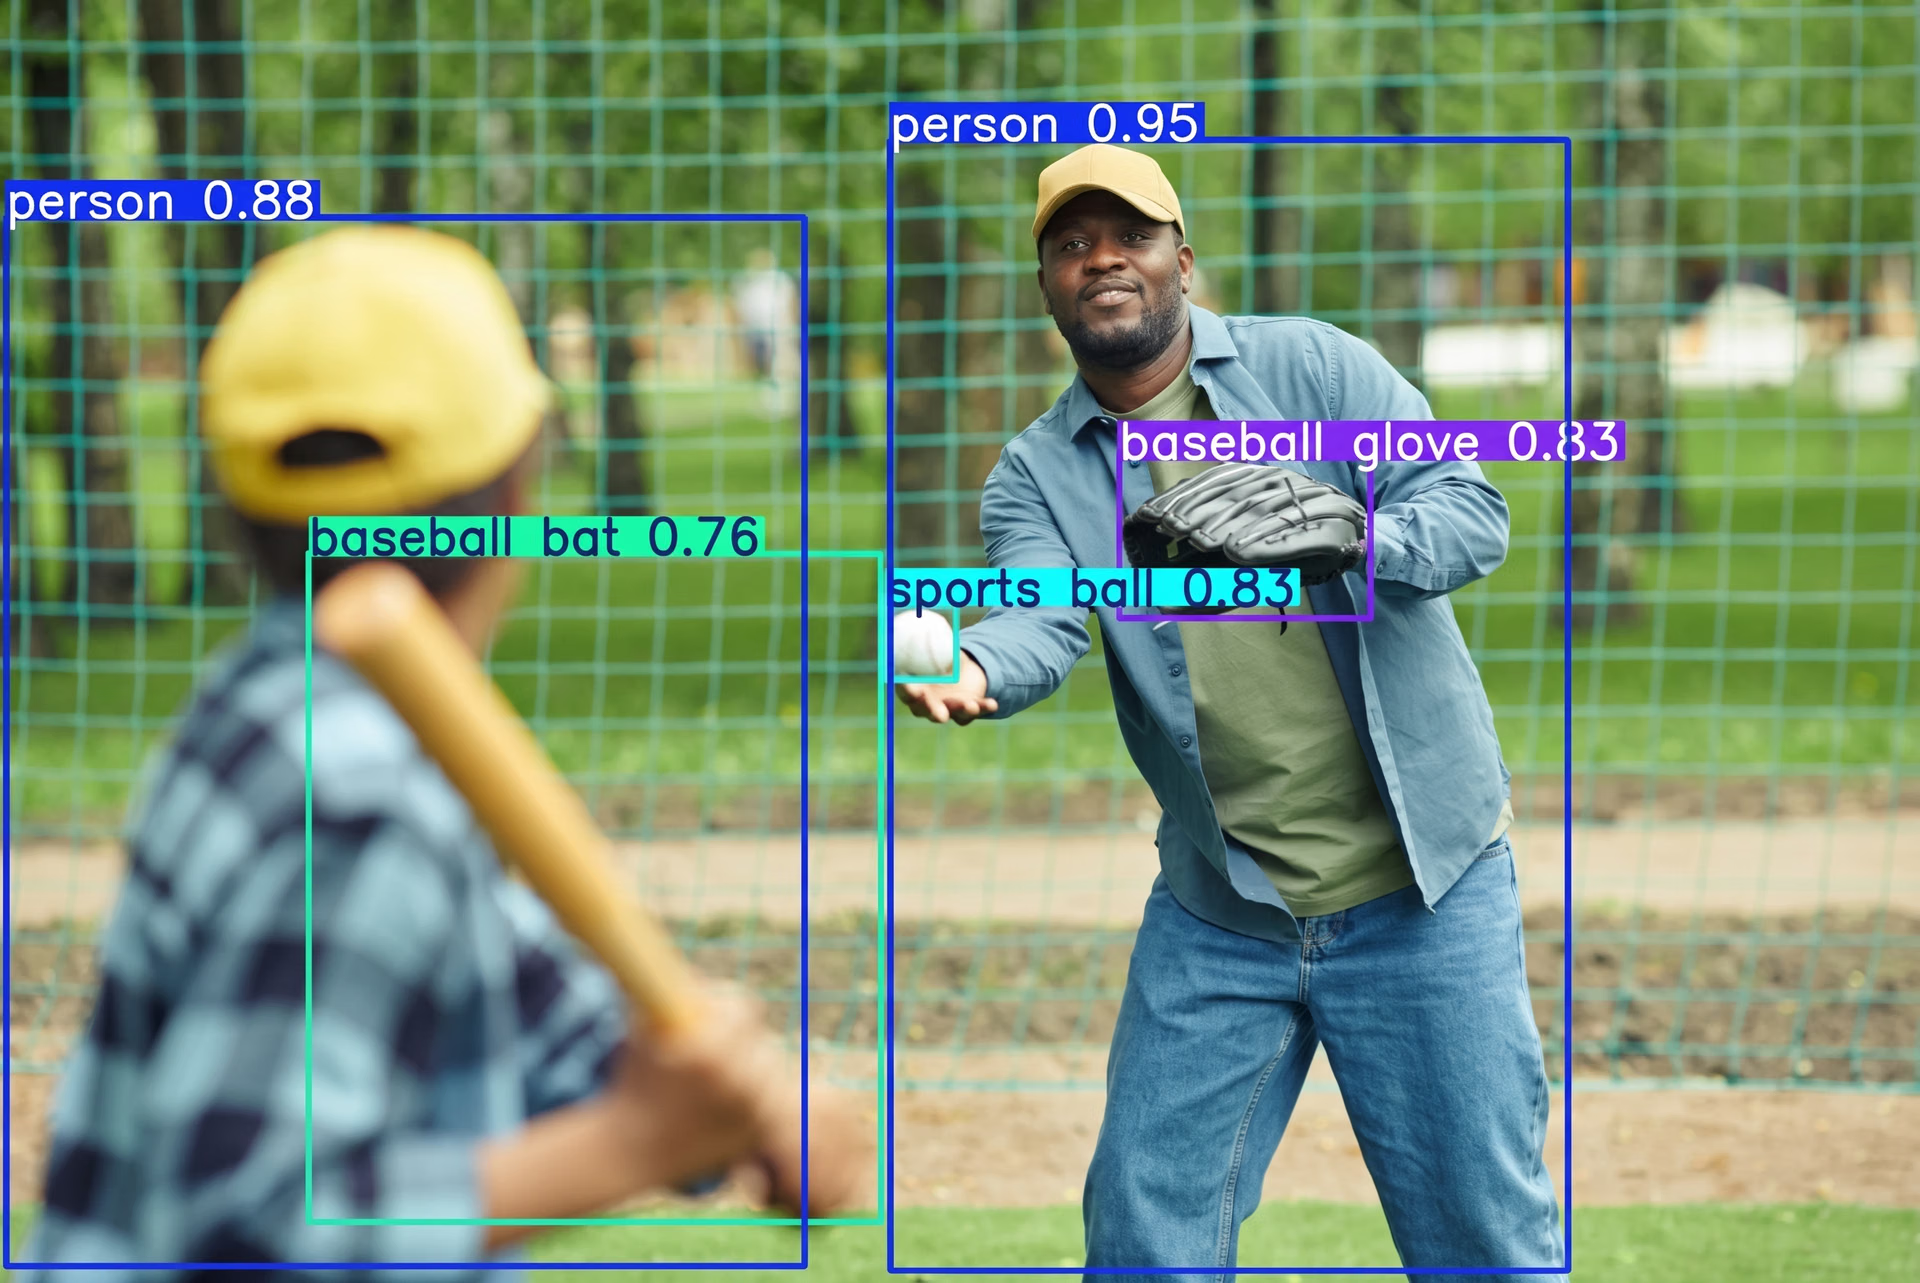
図2. 教師あり学習による物体検出の例(出典)
物体検出だけでなく、教師あり学習は画像分類、インスタンスセグメンテーション、姿勢推定など、精度と一貫性が重要となる幅広いコンピュータービジョンタスクで広く使われています。これらの各タスクでは、モデルはラベル付きデータから学習して特定のパターンを識別し、新しい入力に対して信頼性の高い予測を行います。
こうしたモデルは通常、深層学習を使って構築されます。深層学習は、ニューラルネットワークを利用してデータから直接パターンを学習する機械学習の一種です。ニューラルネットワークは、人間の脳の働きに大まかに着想を得た方法で情報を処理するよう設計されており、大規模なデータセットから複雑な視覚的特徴をモデルが学べるようにします。
従来のコンピュータービジョン手法では、サポートベクターマシン(SVMはカテゴリ間の最適な境界を見つけてデータを分類するモデルです)や決定木(データを枝分かれさせて判断を行うモデルです)などのアルゴリズムと、手作業で設計した特徴量を組み合わせることがよくありました。
対照的に、現在のコンピュータービジョンモデルは深層学習を使ってデータからこれらの特徴量を自動的に学習するため、大規模で詳細な視覚タスクへの対応能力が高まっています。
ビジョンAIにおける教師なし学習モデルの必要性#
教師あり学習はコンピュータービジョンで主流の手法ですが、ラベル付きデータが存在しない、または作成に費用と時間がかかりすぎるビジョンアプリケーションもあります。
このような場合、教師なし学習アルゴリズムが有効な代替手段となります。野生動物カメラで撮影した、ラベルのない大量の写真があるとします。
各画像に何が写っているかを示すラベルはありませんが、それでもデータを整理したり理解したりしたいとします。教師なしモデルはこれらの画像を分析して、似た画像をまとめることができます。正確なラベルが分からなくても、見た目の似た動物をクラスタに分けられます。
コンピュータービジョンにおける教師なし学習の仕組み#
では、教師なし機械学習はどのように機能するのでしょうか。モデルは正解から学習するのではなく、自らデータ内のパターンや構造を特定して学習します。ラベル付きの例に頼らず、データ全体にわたる類似点や相違点を探します。
一般的なユースケースの1つが異常検知です。モデルは正常なデータの特徴を学習し、そこから逸脱するものを特定します。異常や外れ値の検出は、産業分野で特に大きな効果を発揮するアプリケーションの1つです。たとえば、製造ラインの不良品の発見、放射線科医の確認用に通常と異なる医療画像を検出すること、監視映像内の不審な動きを検知することなどが挙げられます。不良や異常は発生頻度が低く種類も多様なことが多いため、考えられるすべてのケースにラベルを付けるのは現実的ではなく、教師なし手法が適しています。
これを支援するために、クラスタリングや次元削減などの手法がよく使われます。通常は生の画像そのものではなく、画像から抽出した特徴量が対象となります。k-meansクラスタリングなどのクラスタリング手法は、共通するパターンに基づいて似た画像をグループ化します。一方、主成分分析(PCA)などの次元削減手法は、最も重要な特徴に絞ることでデータを簡素化します。
これにより、大規模で複雑なデータセット内の有意なパターンや構造をモデルが特定しやすくなります。教師なし学習の主な利点は、ラベルなしデータを効果的に扱い、すぐには明らかでないパターンを明らかにできることです。ただし、教師あり学習と比べて評価が難しく、最終的な出力を制御しにくくなります。
コンピュータービジョンにおける自己教師あり学習と半教師あり学習#
教師あり学習と教師なし学習について調べるうちに、その中間的な手法はないのかと疑問に思うかもしれません。自己教師あり学習と半教師あり学習は、教師あり学習と教師なし学習の間をつなぐ手法です。
これらの手法を使うと、モデルはラベルなしデータからより効果的に学習できます。ラベル付きの例だけに頼るのではなく、データから独自の学習タスクを作成するか、少量のラベル付きデータと大量のラベルなしデータを組み合わせます。
自己教師あり学習では、モデルはデータそのものから作成したタスクを解くことで学習します。たとえば、一部が欠けた画像を与えて、空白部分に何が入るかを予測させたり、同じ物体をさまざまな角度から見た画像を認識させたりできます。これにより、手動でラベルを付けなくても、モデルが有用な特徴量を学べます。
一方、半教師あり学習では、少量のラベル付きデータを大量のラベルなしデータと併用して、性能を高めます。場合によっては、モデルがラベルなしデータにラベルを生成し、そのラベルを使って学習を続けることもできます。
これらの手法の主な利点は、作成に費用と時間がかかることの多い、大規模なラベル付きデータセットの必要性を減らせることです。ただし、完全な教師あり手法と比べて、設計や評価が複雑になる場合があります。
教師あり学習と教師なし学習の主な違い#
教師あり学習と教師なし学習の違いは、モデルの学習方法と目標にあります。教師あり学習はラベル付きデータと明確な指針に基づいて特定のタスクを学習するのに対し、教師なし学習は事前定義された正解を使わず、データ内のパターンや構造の発見に重点を置きます。
たとえば、交通監視システムでは、教師あり学習モデルをラベル付き画像でトレーニングし、車両、歩行者、交通信号を検出できます。対照的に、教師なしモデルは大量の動画映像を分析して、似た交通パターンをグループ化したり、異常な渋滞や不自然な動きなどの予期しない出来事を特定したりできます。何を探すべきかを明示的に教える必要はありません。
コンピュータービジョンで教師あり学習を使う場面#
教師あり学習は、目標が明確に定義され、モデルに入力データと正確な出力を対応付ける必要があるコンピュータービジョンタスクに適しています。信頼性の高いラベル付きデータセットがあり、一貫性のある予測可能な結果が必要な場合に特に効果を発揮します。
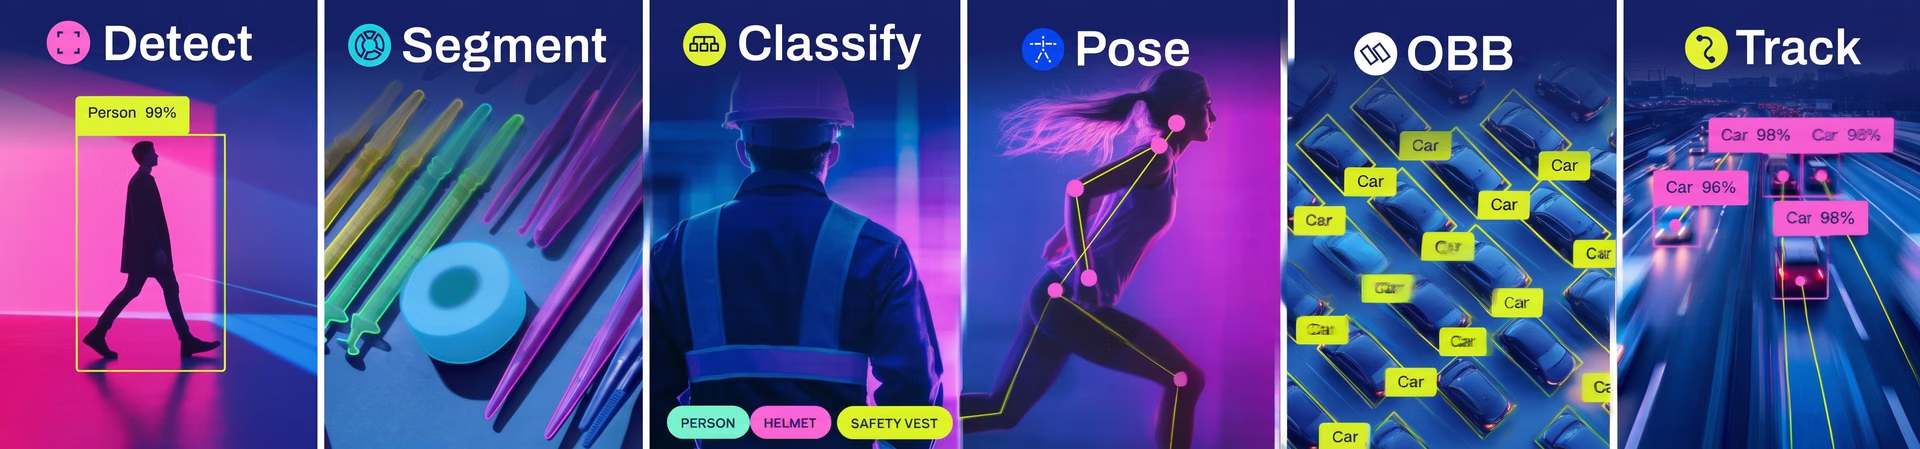
図3. 教師あり学習を活用するコンピュータービジョンタスク(出典)
モデルが既知のカテゴリを区別したり、特定の結果を予測したりする必要がある問題で一般的に使われます。パターンを探索するのではなく、ラベル付きデータから正確な関係性を学ぶことに重点を置くため、モデルを望ましい結果へと導きやすくなります。
もう1つの重要な利点は、制御性です。教師あり学習では、明確な指標を使って性能を測定し、モデルを微調整し、デプロイ後の安定した動作を確保しやすくなります。そのため、長期にわたる一貫性と信頼性が求められるシステムに適しています。
ただし、これにはトレードオフがあります。モデルはラベル付きデータの品質と規模に大きく依存し、そのようなデータの収集とアノテーションには時間がかかる場合があります。
教師ありコンピュータービジョンの実世界での活用例#
Ultralytics YOLOモデルのようなビジョンAIモデルは、特にリアルタイムアプリケーションで、高精度の物体検出などのタスクを実行するために教師あり学習を利用します。教師あり学習が効果を発揮する、実世界での一般的なビジョンのユースケースをいくつか紹介します。
- 医療・医用画像: 医師は、X線やMRIなどのラベル付き画像でトレーニングしたコンピュータービジョンシステムを活用できます。分類器を使って腫瘍や骨折などの症状を特定し、より迅速で正確な診断を支援します。
- 産業用品質検査: 製造現場では、ラベル付きデータでトレーニングしたビジョンシステムが、形状、表面の欠陥、質感、サイズなど、品質に関わる複数の特徴を分析して製品を検査できます。良品と不良品の両方の例から学習することで、こうしたシステムは一貫して欠陥を特定し、生産基準を維持できます。
- 自動運転: 自動運転システムは、ラベル付きの走行データでトレーニングしたモデルを使って車線、車両、歩行者、交通標識を認識し、車両がリアルタイムで安全に走行できるよう支援します。
- 小売・セルフレジシステム: 店舗では、ラベル付きの商品画像でトレーニングしたモデルを使い、棚やレジで商品を識別することで、会計の自動化と在庫管理の効率化を実現しています。こうしたシステムは、追加データと組み合わせることで顧客セグメンテーションなどのタスクも支援でき、企業が購買パターンをより深く理解するのに役立ちます。
- 農業・作物モニタリング: 農家は、ラベル付き画像でトレーニングしたモデルを使って作物を検出・分類できます。たとえば、健全なジャガイモと損傷したジャガイモを識別して数えることで、品質管理を改善し、損失を減らせます。
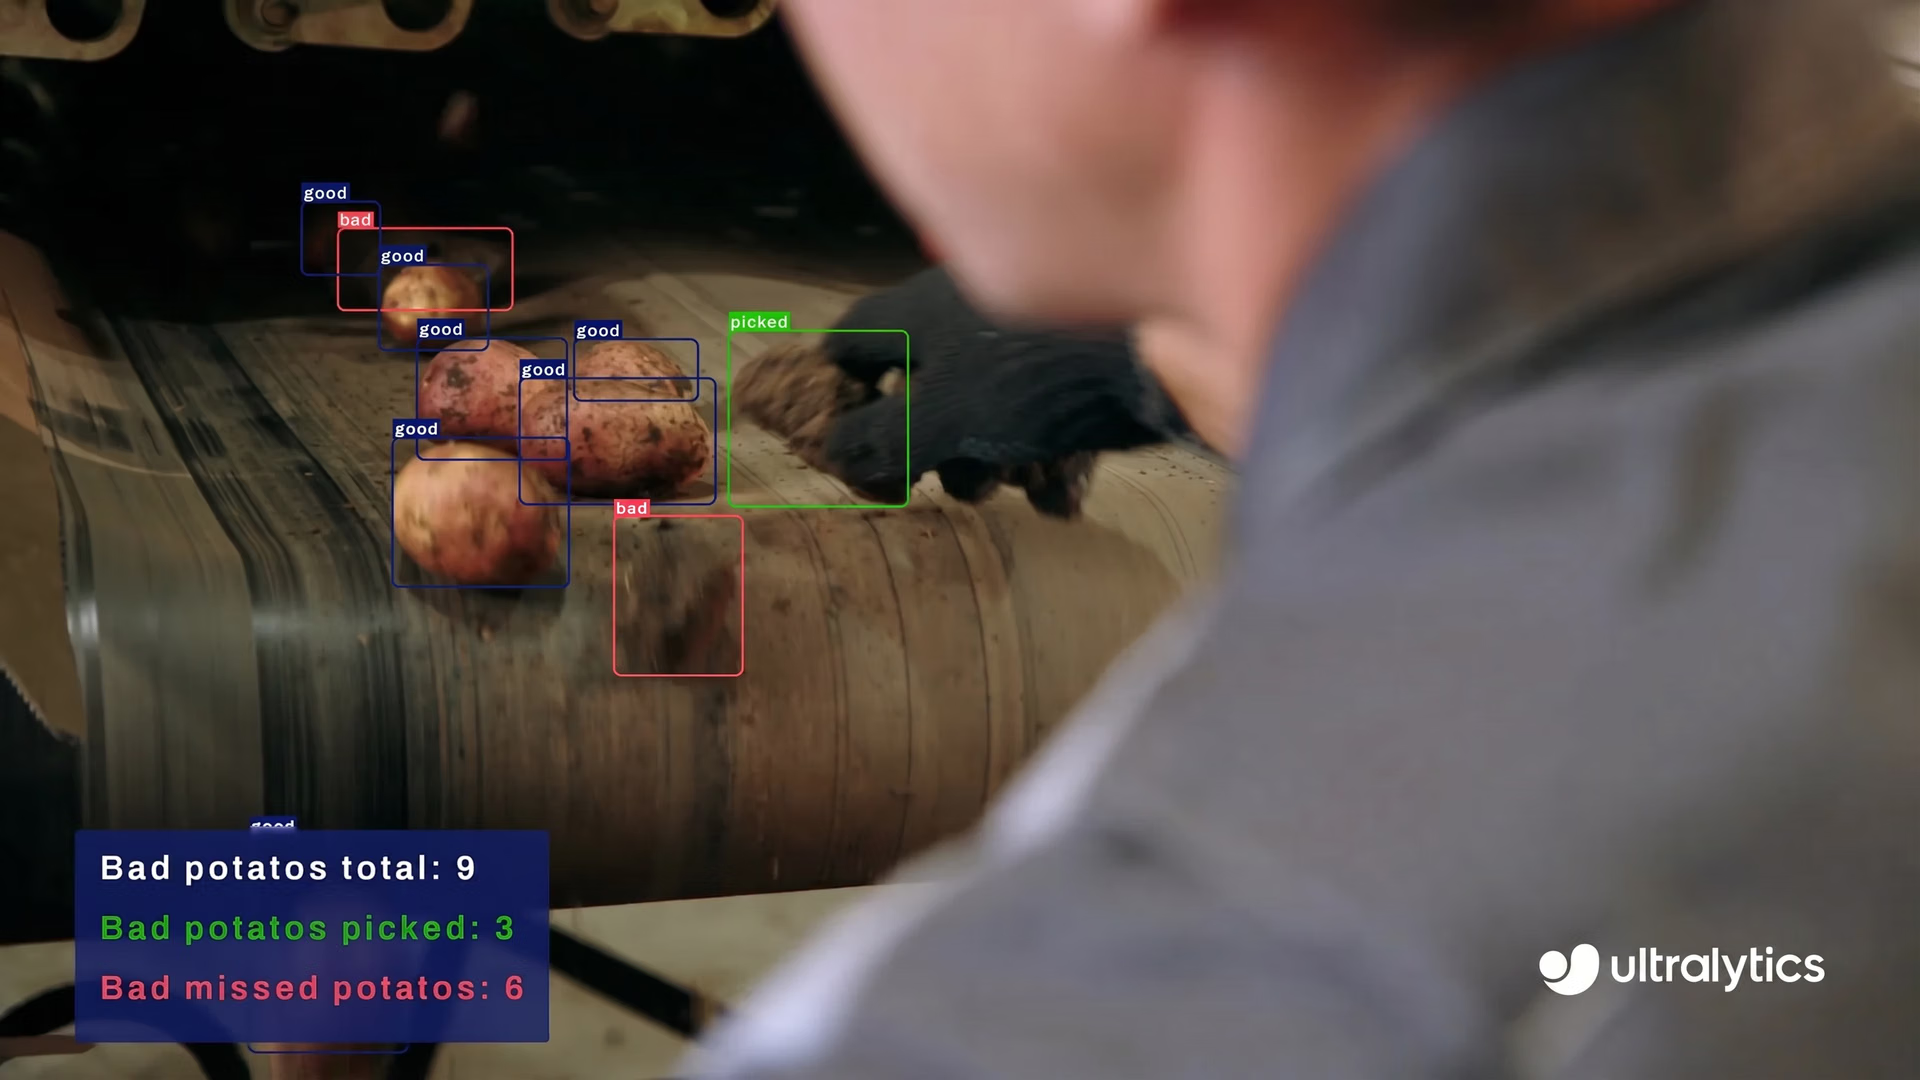
図4. YOLOを使った健全なジャガイモと不良ジャガイモの検出・カウント
教師なし学習で解決できるコンピュータービジョンの課題#
教師なし学習は、十分なラベル付きデータがない場合や、データに明確な正解が付いていない場合に役立ちます。このような状況では、正確な予測を行うのではなく、データ内のパターンや構造を理解することが目標となります。
ラベルなしデータセットを初めて調べる際によく使われます。モデルに探す対象を指示するのではなく、類似点の特定、関連する画像のグループ化、通常と異なるパターンの検出をモデルに任せます。
大量の画像を含むコレクションでは、教師なし手法を使って似た画像をまとめたり、さらに確認が必要な外れ値を検出したりできます。そのため、データサイエンスプロジェクトの出発点として役立ちます。
GAN、変分オートエンコーダー、拡散モデルなどの生成モデルは、画像の基礎となる分布を学習して、まったく新しい画像を作成します。こうしたモデルは、画像生成、インペインティング、超解像、スタイル変換などのアプリケーションを支え、現在の生成AIシステムの中核を成しています。
教師なしセグメンテーションでは、ラベル付きマスクに頼らずにピクセルや領域をまとまりのあるセグメントに分類する手法があります。アノテーションに費用がかかりすぎる場合や、事前定義されたカテゴリに合わせるのではなく構造の発見を目指す場合に有用です。
ラベル付けに時間がかかる、または現実的でない大規模なデータセットを扱う場合も、教師なし学習は大きな効果を発揮します。そのようなケースでは、ラベル付きのトレーニングデータに頼らず、データから知見を得ることができます。
また、新しい画像、テキスト、音声などを生成するモデルを扱う生成AIや、生データから有用な特徴やパターンを学習するモデルを扱う表現学習など、モデルが大量のデータから汎用的な特徴を学習する分野でもよく使われます。全体として、問題に探索、パターンの発見、またはラベルなしデータの活用が含まれる場合、教師なし学習は柔軟で実用的な選択肢となります。
コンピュータービジョンにおける教師なし学習の実世界での活用例#
コンピュータービジョンで教師なし学習を適用するユースケースをいくつか紹介します。
- 製造業における異常検知: モデルは正常な製品の特徴を学習し、考えられるすべての不良品のラベル付き例がなくても、欠陥や異常を検出できます。
- 画像の整理・検索: 写真ライブラリやeコマースカタログなどの大量の画像を、視覚的な類似性に基づいて自動的にグループ化できます。これにより、データサイエンティストは大規模なデータセットを整理、探索、検索しやすくなります。
- 監視・セキュリティ: システムは動画映像を分析して、予期しない動きや群衆の変化など、通常と異なるパターンや行動を特定できます。ラベル付きイベントで明示的にトレーニングする必要はありません。
- 前処理・データ探索: 教師なし手法は、教師ありモデルをトレーニングする前に、生の画像データを調べて構造化するためによく使われます。これにより、データ品質の向上と手作業の削減につながります。
教師あり学習と教師なし学習の実用上の制約#
どちらの学習手法にも利点がある一方で、考慮すべき制約もあります。コンピュータービジョンモデルを構築する際に押さえておきたい実務上の要素を紹介します。
- 教師ありモデルの過学習: 教師あり学習では、モデルが汎用的なパターンを学ぶのではなく、トレーニングデータに過度に適合することがあります。これは、データセットが小さい場合や多様性に乏しい場合によく起こります。たとえば、ある種類の製品の欠陥を検出するようトレーニングしたモデルは、製品や照明条件が少し異なる新しいデータでテストすると、機能しないことがあります。
- クラスタリングアルゴリズムの課題: 教師なし学習では、モデルが類似するデータポイントをまとめることができます。しかし、データにノイズや一貫性のなさがある場合や、明確な構造がない場合はうまく機能しないことがあります。たとえば、画像のグループ化では、色は似ていても被写体が異なる画像が誤って同じグループにまとめられることがあります。
- 適切な前処理の重要性: トレーニングの前に、データをクリーニングして準備する必要があります。通常は、画像処理とデータ変換を行うPythonライブラリを使って処理します。画像のサイズ、品質、照明が異なる場合があるコンピュータービジョンでは、特に重要です。適切な前処理を行わないと、モデルは有意なパターンではなくノイズから学習し、性能が低下する可能性があります。
重要なポイント#
コンピュータービジョンでは、教師あり学習と教師なし学習のどちらも重要な役割を果たします。適切な手法は、データにラベルが付いているかどうかを含むデータの種類、解決しようとしている問題、デプロイの要件によって異なります。
目標が高い精度と明確な出力であれば、教師あり機械学習のほうが適していることがよくあります。データを探索する場合やラベルがない場合は、教師なし学習のほうが適している可能性があります。
AIについてもっと知りたいですか?コミュニティとGitHubリポジトリをご覧ください。ロボティクス分野のAIと農業分野のコンピュータービジョンについて、ソリューションページをご覧ください。ライセンスの選択肢を確認して、今日からコンピュータービジョンの開発を始めましょう!









