GPT-6.1 Terraが自動アノテーションで第1位を獲得し、OpenAIの最上位モデルを上回りました
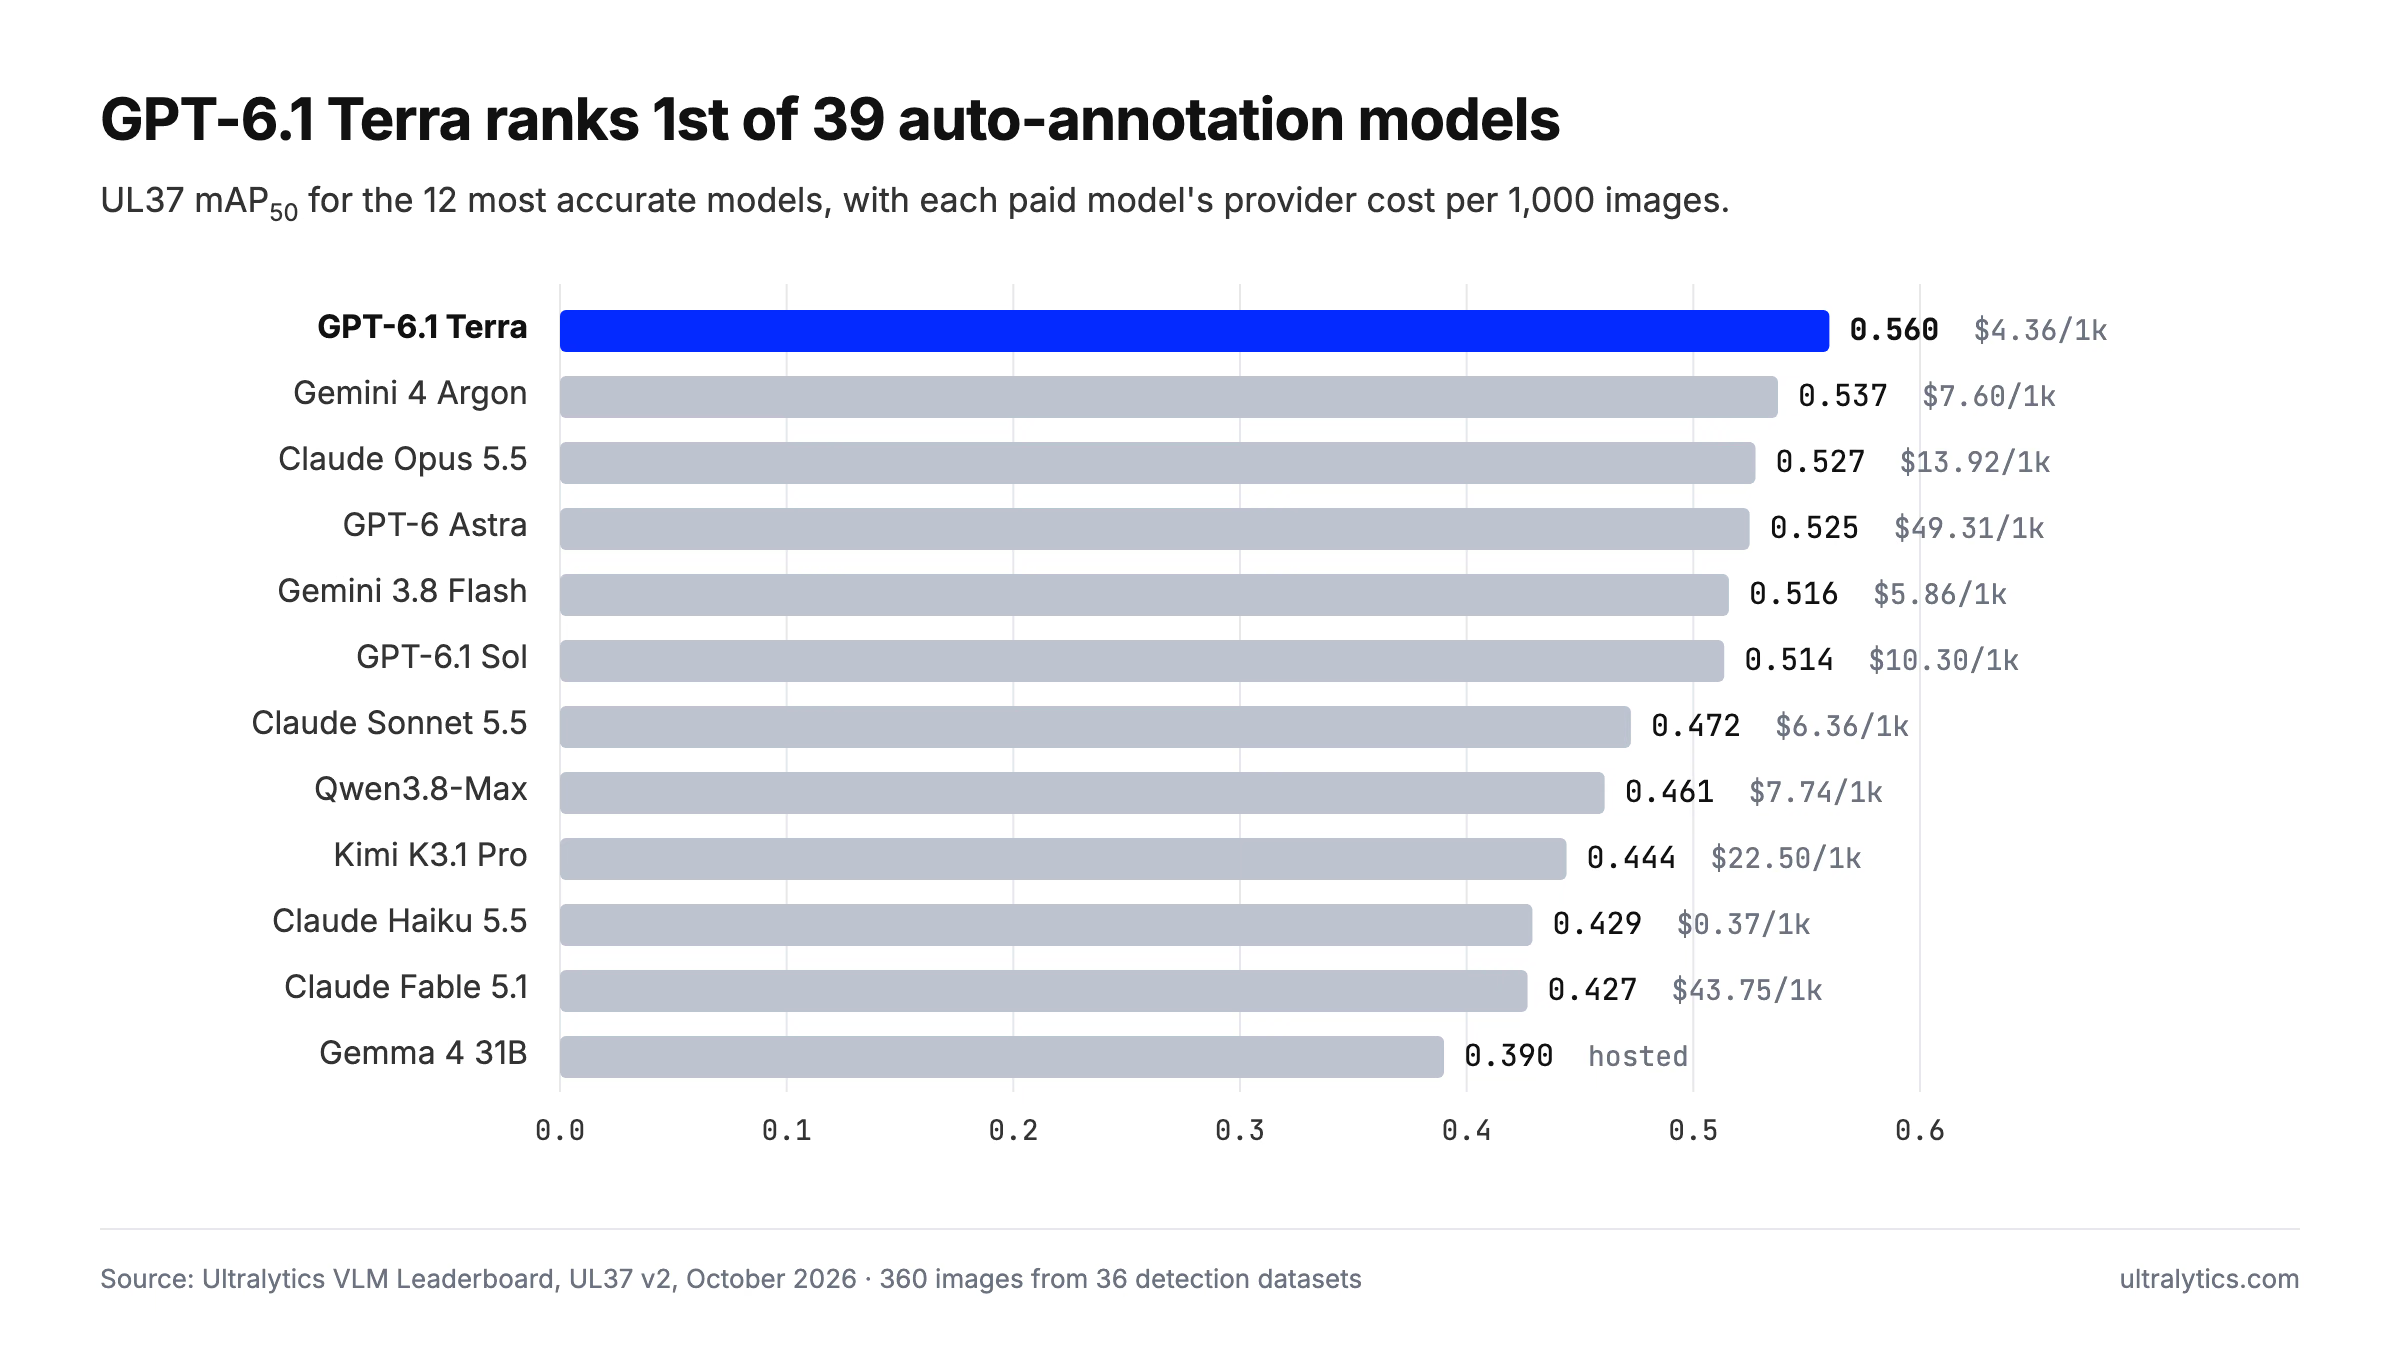
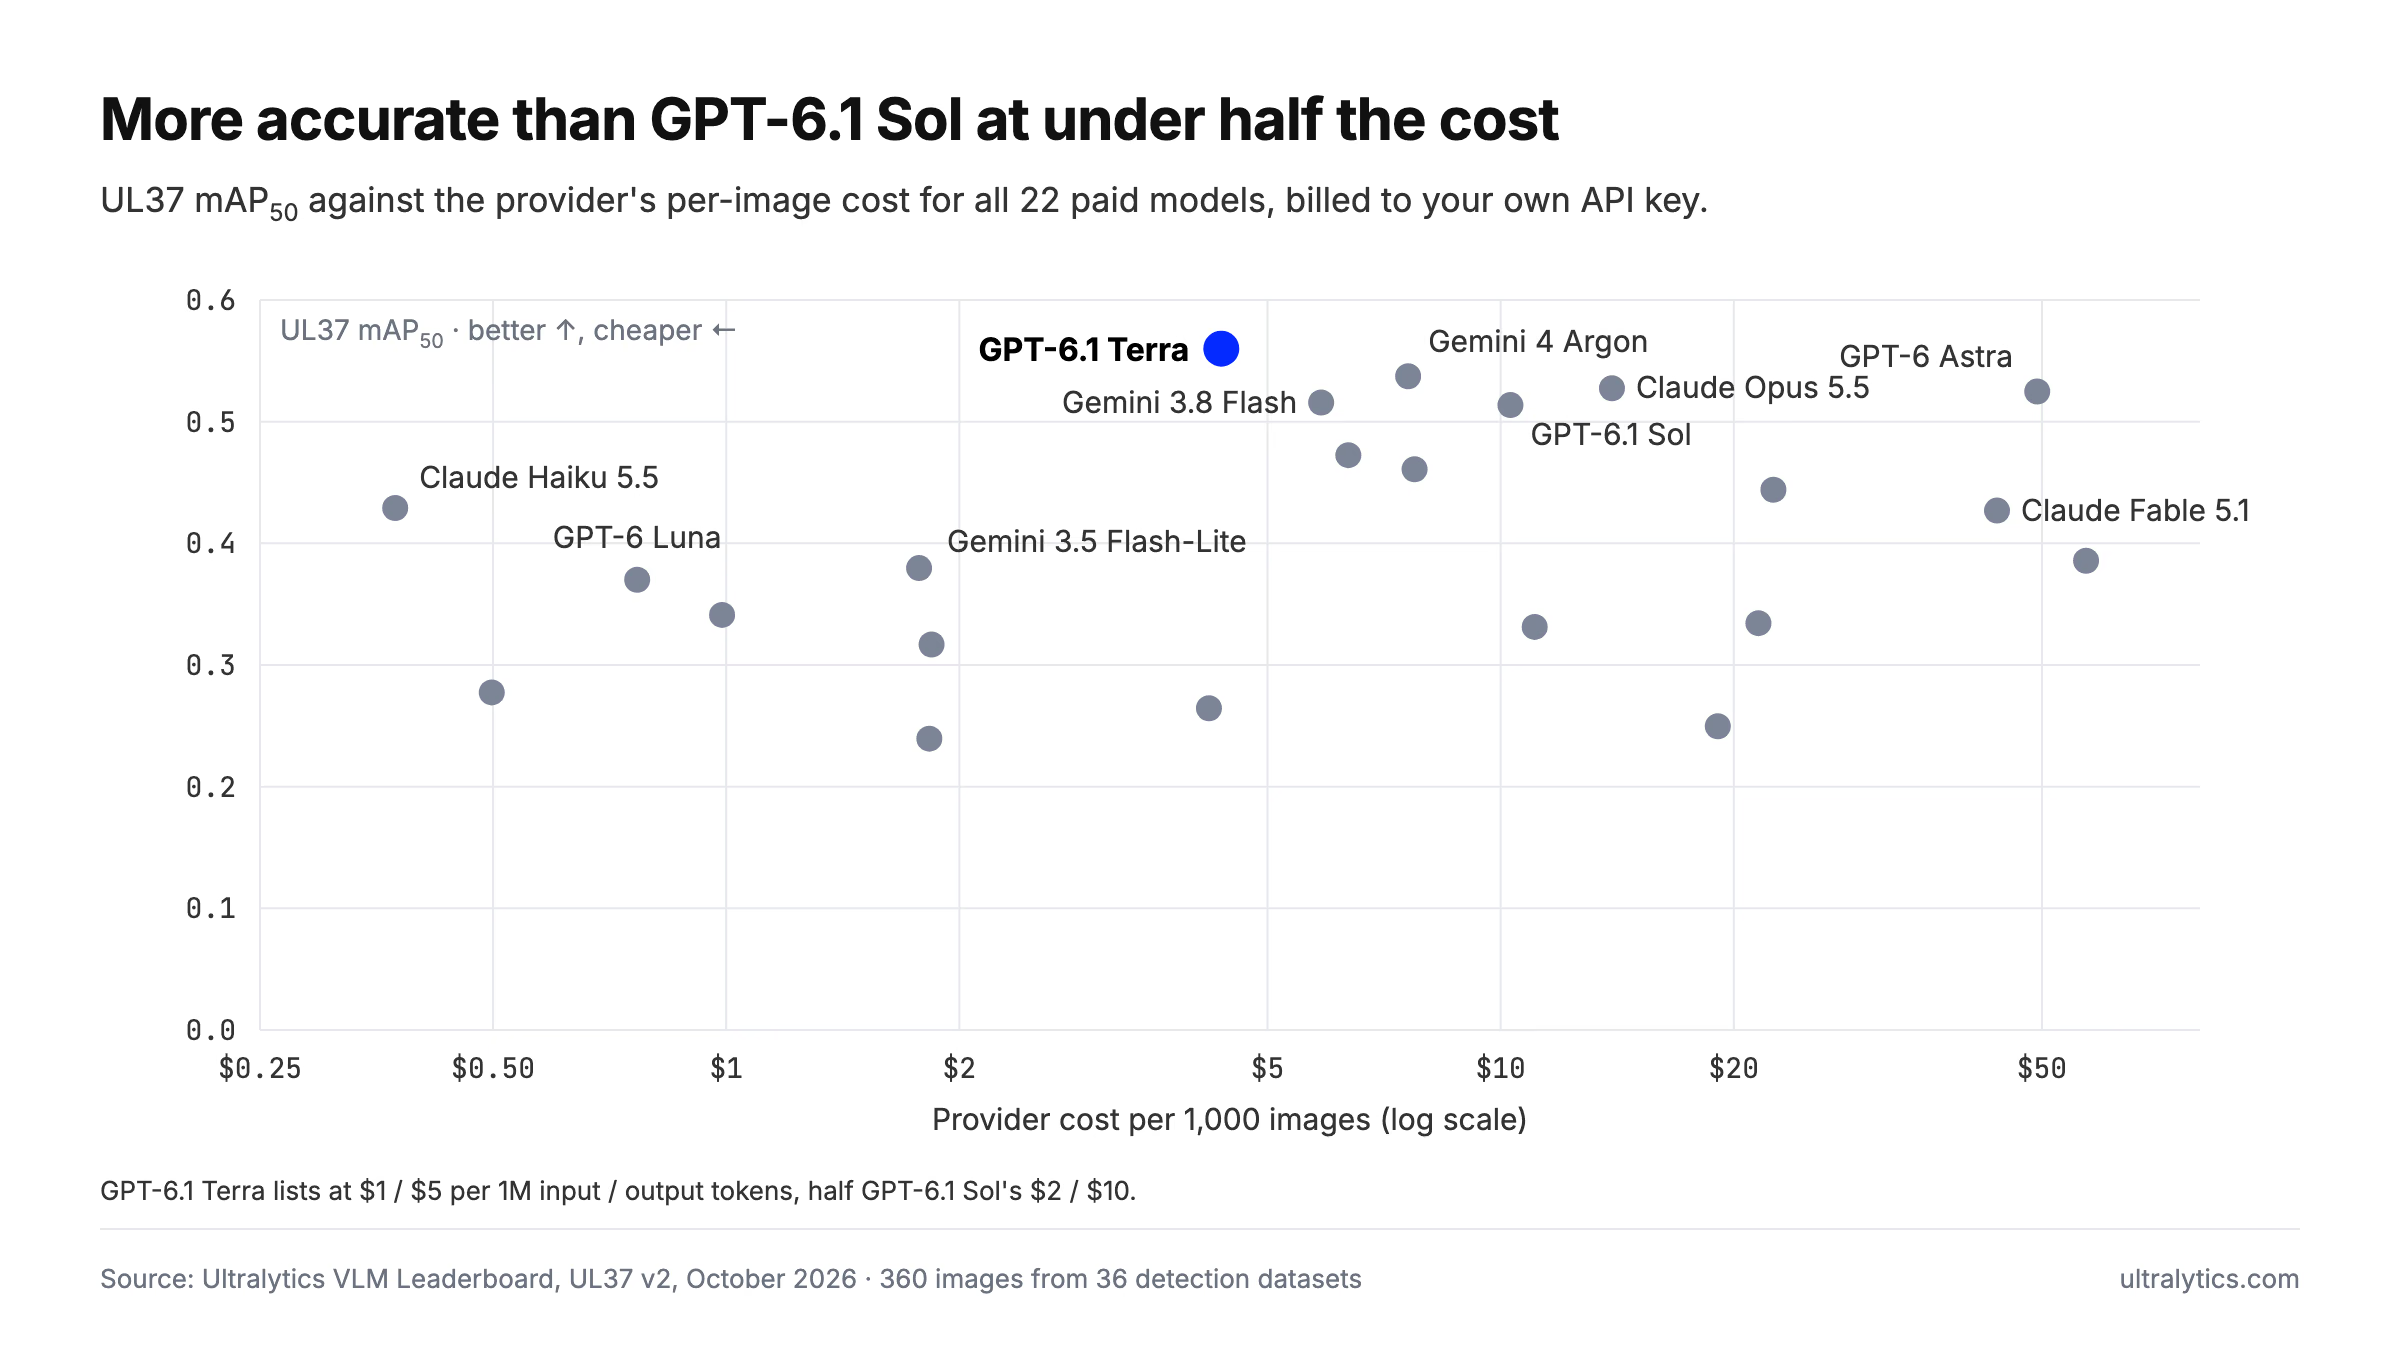
GPT-6.1 Terraの自動アノテーションは、VLM Leaderboardで39モデル中トップです。1,000枚あたり$4.36で0.560 mAP50を達成し、GPT-6.1 SolとGemini 4 Argonを上回りました。
OpenAIの発表資料では、GPT-6.1 Terraは視覚的推論において上位モデルにほぼ匹敵するとされています。バウンディングボックスを描画させてみると、「ほぼ」という表現は適切ではないことが分かりました。
2026年10月26日、OpenAIがリリースした当日に、GPT-6.1 Terraの自動アノテーションを、36データセットを対象とする検出ベンチマーク UL37で評価しました。0.560 mAP50を記録し、VLM Leaderboardに掲載された39モデルすべての中で最高の結果となりました。OpenAIの中価格帯モデルは、GPT-6.1 Sol、フラッグシップのGPT-6 Astra、そして今週まで首位を維持していたGemini 4 Argonを上回りました。
1,000枚あたり$4.36、1画像あたり5.1秒で処理し、リクエストの失敗は一度もありませんでした。今すぐUltralytics Platformでご利用いただけます。以下では、得意なこと、苦手なこと、ラベリングのワークフローに取り入れるべきかどうかを判断する方法を紹介します。
GPT-6.1 TerraがUL37で首位を獲得#
UL37では、36の実際の物体検出データセットから各10枚、計360枚の画像を使い、モデルのボックスが人手によるラベルとどれほど一致するかを測定します。対象は医療スキャン、航空画像、小売店の棚、スポーツ、文書、回路基板など多岐にわたります。各画像は、Platformユーザーが利用するものと同じ本番パイプラインで処理され、データセット固有のクラス名が使われます。また、SAM 3.1によって各ボックスを調整します。評価手法は公開されています。
Terraのスコアは次のとおりです。
- mAP50: 0.560、39モデル中第1位
- mAP50-95: 0.345、こちらも第1位です。大まかな位置だけでなく、ボックスが対象にぴったり合っていることを示しています。
- Precisionとrecall: 0.646と0.613
- プロバイダー料金: 1,000枚あたり$4.36
- 画像あたりの中央値処理時間: 5.1秒
- リクエストの失敗: なし
UL37では6モデルが0.51を超えており、Claude Opus 5.5が3位に入っています。Terraはこの6モデルの中で最も精度が高く、料金も最安です。
この結果の背景に、調整の工夫はありません。TerraはOpenAIのデフォルトの推論レベルで動作し、モデルドキュメントではmediumに設定されています。Platform内の他のOpenAIモデルと同じリクエストを受け取り、ボックスの座標は0~1000のグリッドで指定します。組み込んだだけで、すぐに首位となりました。
OpenAIの最上位モデルを上回る中価格帯モデル#
OpenAIはGPT-6.1 Terraを、ラインアップの中で高速かつ効率的な中価格帯モデルと位置付けています。The DecoderとBleepingComputerのリリース報道によると、GPT-5.6 Terraの後継であり、コンピューター操作、視覚的推論、コーディング、日常業務を対象としています。APIではgpt-6.1-terraとして利用でき、ChatGPT WorkとCodexではPlus、Pro、Enterprise、Eduのユーザーが利用できます。OpenAIのドキュメントでは、「視覚的推論、正確なコンピューター操作、明瞭で自然な文章作成のための、高速で効率的なモデル」と説明されており、テキストと画像の入力に対応し、コンテキストウィンドウは1,050,000トークンです。
料金は入力トークン100万個あたり$1、出力トークン100万個あたり$5で、キャッシュされた入力は$0.05です。OpenAIのGPT-6.1 SolとGPT-6 Astraのページによると、GPT-6.1 Solの$2と$10の半額であり、GPT-6 Astraの$10と$50の10分の1です。
OpenAIのリリース時のベンチマークでは、Terraは上位モデルを上回るのではなく、ほぼ同等とされています。視覚的推論テストのMMMU-Proでは、OpenAIはTerraがAstraとSolにほぼ匹敵すると報告しています。Terminal-Bench 4.0では、GPT-5.6 Terraの21.5%から向上して50.3%と報告しています。また、最も難しいコーディング作業には、引き続きSolまたはAstraを推奨しています。
机上では、Terraは妥協案として選ぶモデルです。しかし、私たちのベンチマークでは、OpenAIで最も優れた検出モデルです。
| OpenAIのモデル | UL37 mAP50 | 1,000枚あたりのコスト | 画像1枚あたりの中央値 |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1秒 |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terraの画像あたりの料金は、GPT-6.1 Solの半額未満、GPT-6 Astraの10分の1未満です。応答速度もどちらと比べても約2倍です。直接比較では、36データセット中22データセットでSolを上回っています。
OpenAIによると、TerraはSolやAstraより3倍以上速くタスクを完了しますが、これはエージェントのワークロードに関する主張です。アノテーションは別のタスクであり、こちらで測定したSolに対する速度は約2倍でした。何千枚もの画像をラベリングする場合、この差は積み重なります。
TerraのSolに対する優位性はprecisionです#
2つのモデルが検出するラベル付きオブジェクトの割合はほぼ同じです。Terraのrecallは0.613、Solは0.618です。差が開くのはprecisionで、Terraは0.646、Solは0.551です。Terraのボックスは、より高い割合で正しいラベルが付いた実物体に対応しています。
SKU110Kを見ると、その違いがはっきり分かります。画像には商品が隙間なく並ぶスーパーマーケットの棚が写っており、クラスは1つだけです。このデータセットでは、両モデルのrecallはほぼ同じで、Terraが0.73、Solが0.77です。しかし、棚画像でのSolのprecisionは0.49なのに対し、Terraは0.79です。Solのボックスは約半数が誤検出ですが、Terraでは約5分の1です。SKU110KでTerraが記録した0.62 mAP50は、どのモデルよりも高いスコアです。
データラベリングでは、エラーによるコストが同じではないため、これは重要です。商品を見逃した場合は、ボックスを1つ描画するだけです。誤ったボックスの場合は、正しいボックスが何十個もある中から見つけて削除する必要があります。誤検出が少なければ、レビュー担当者はより整った初稿を確認できます。
医用画像はGPT-6.1 Terraの際立った強みです#
Terraの結果で最も際立つ傾向は、医療分野です。UL37には8つの医療データセットが含まれており、Terraの平均は0.505 mAP50で39モデル中第1位です。次点はGemini 3.8 Flashの0.387、Gemini 4 Argonの0.379です。Leaderboardのどのモデルも、他の分野でこれほど大きな差をつけていません。
8つのデータセットすべてでのスコアと、各データセットにおける他の38モデルの最高スコアは次のとおりです。
| データセット | GPT-6.1 Terra | 他モデルの最高スコア |
|---|---|---|
| 甲状腺超音波(TN5000) | 0.94 | Gemini 3.8 Flash、0.88 |
| 脳腫瘍MRI(Cheng) | 0.90 | Gemma 4 31B、0.80 |
| 血球顕微鏡画像(TXL-PBC) | 0.89 | Gemini 4 Argon、0.78 |
| 大腸ポリープ内視鏡画像(Kvasir-SEG) | 0.71 | Gemini 4 Argonを含む7モデルが同率、0.81 |
| 小児の手首X線画像(GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra、0.35 |
| 胸部X線、結核(TBX11K) | 0.14 | GPT-6 Astra、0.33 |
| 網膜病変(DDR) | 0.13 | Claude Opus 5.5、0.13 |
| 歯科X線画像(DENTEX) | 0.06 | Gemini 4 Argon、0.21 |
上位3つのデータセットが結果を大きく押し上げていますが、いずれも病変の位置を見つけるだけのタスクではありません。TN5000では、各ボックスにデータセットの良性または悪性の結節ラベルも付与されます。これは臨床医による確認が必要な判断そのものです。Gemini 4 Argonはそこで0.29、GPT-6.1 Solは0.53を記録しています。脳MRIのクラスは髄膜腫、神経膠腫、下垂体腫瘍で、Solのスコアは0.52です。血球データセットでは、Terraに白血球、赤血球、血小板を分類させます。
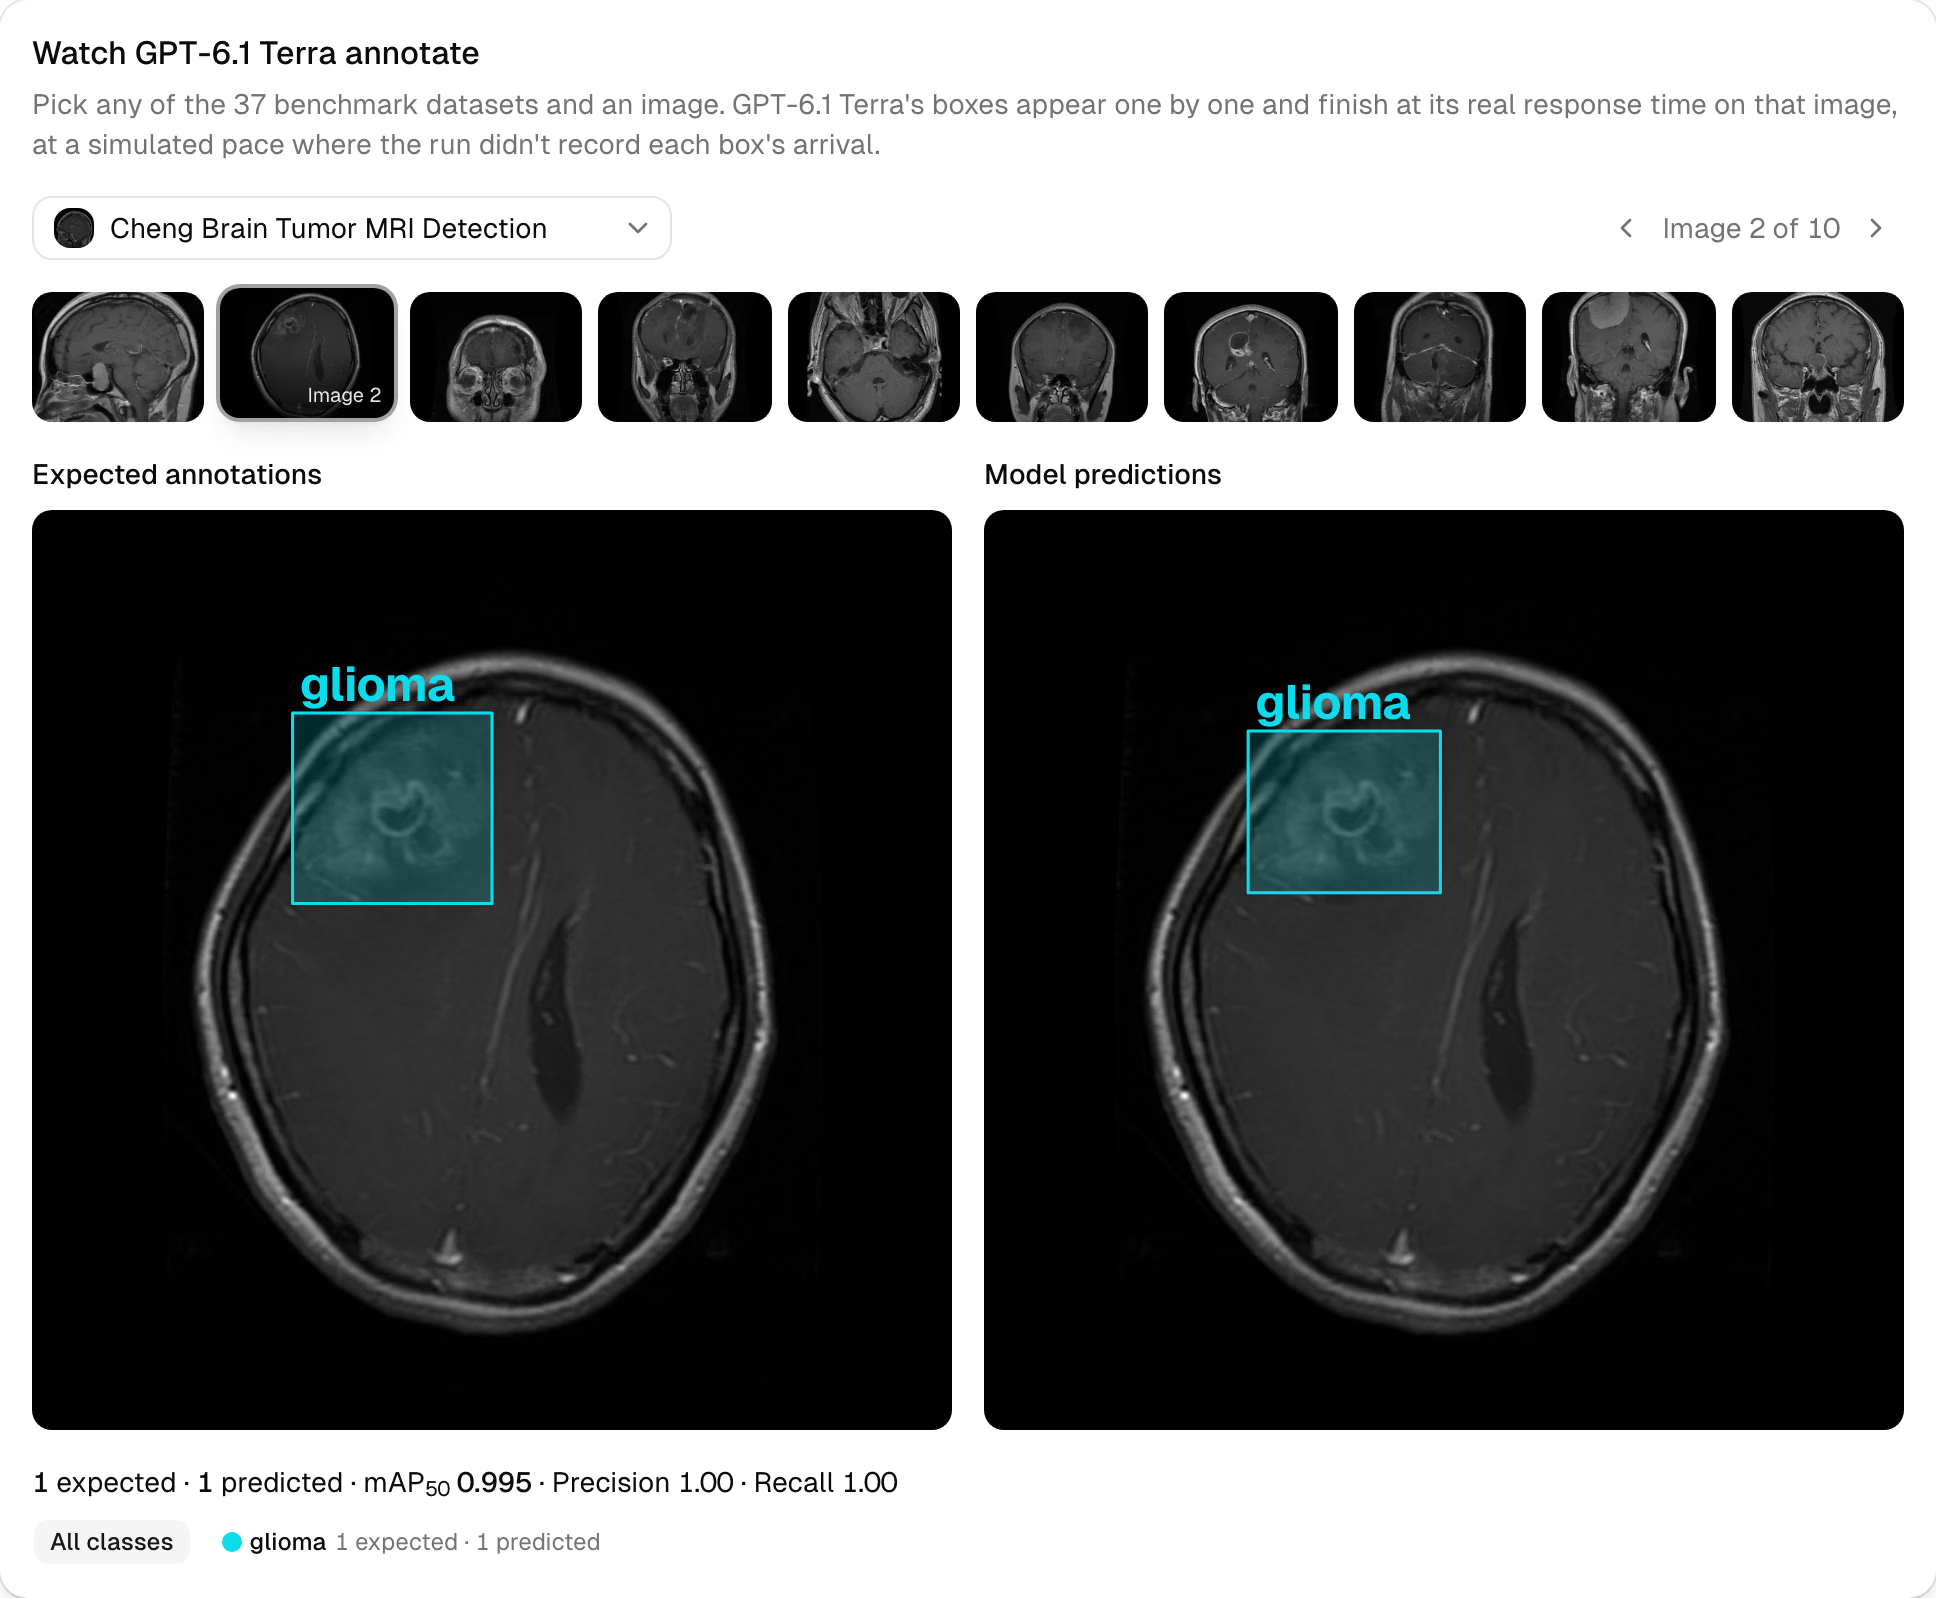
上の再生画面はTerraのモデルページからのもので、典型的な正検出を示しています。脳MRI上の神経膠腫1つに対し、Terraがボックスを1つ出力し、正解アノテーションと一致する位置とラベルを付けています。
これらの数値には、2つの注意点があります。まず、各データセットの画像数は10枚なので、単一データセットのスコアは結論ではなく、調査すべき兆候です。次に、これは診断ではありません。医用画像解析チームにとって、Terraは超音波、MRI、顕微鏡画像にボックスの初稿を迅速に作成する手段です。その後、臨床の専門家が確認、修正、承認します。この人間参加型レビューはワークフローの中核であり、任意の追加工程ではありません。
GPT-6.1 Terraの弱点:X線画像と回路基板#
表の下位部分には明確な傾向があります。医療分野かどうかを問わず、UL37のすべてのX線データセットで、別のモデルのほうが高いスコアを記録しています。Terraは小児の手首、胸部、歯科のX線画像で首位に及ばず、保安検査用X線画像ではさらに差が開きます。IEDXrayでは0.00で、Gemini 4 Argonは0.30です。
最も顕著な見逃しはIEDXrayです。ノートPC、携帯電話、ポケットベル、バッテリー、手製の装置が写ったスキャン画像が含まれますが、Terraはどの画像でも正しいボックスを1つも出力できませんでした。
回路基板ももう1つの弱点です。産業用PCBデータセットでのTerraの平均は0.13ですが、GPT-6.1 Solは0.39です。断線、短絡、ネズミ食い状の欠け、突起など、未実装基板の欠陥を扱うDeepPCBでは、Terraのスコアは0.03、Solは0.39です。PCB検査データでは、Solのほうが適したOpenAIモデルです。
これらの分野のいずれかで大規模なデータセットをラベリングする前に、GPT-6.1 Terraのモデルページを開いてください。ベンチマーク対象の36データセットとCOCOについて、Terraが記録したボックスを正解ボックスと並べて再生し、それぞれのスコアを表示します。
GPT-6.1 TerraとGemini 4 Argonの比較:順位が示す以上に接戦#
Terraが登場するまでLeaderboardをリードしていたGemini 4 Argonですが、両者の差はわずかです。Terraは19データセット、Argonは16データセットで上回り、1つは同率です。
Terraの0.023のリードの大部分は、1つのデータセットによるものです。TN5000の甲状腺超音波画像では、Terraが0.94、Argonが0.29です。このデータセットを除くと、平均スコアはTerraが0.549、Argonが0.544となり、ほぼ同等です。Terraの首位は確かなものですが、その優位性は主に医用画像に支えられています。
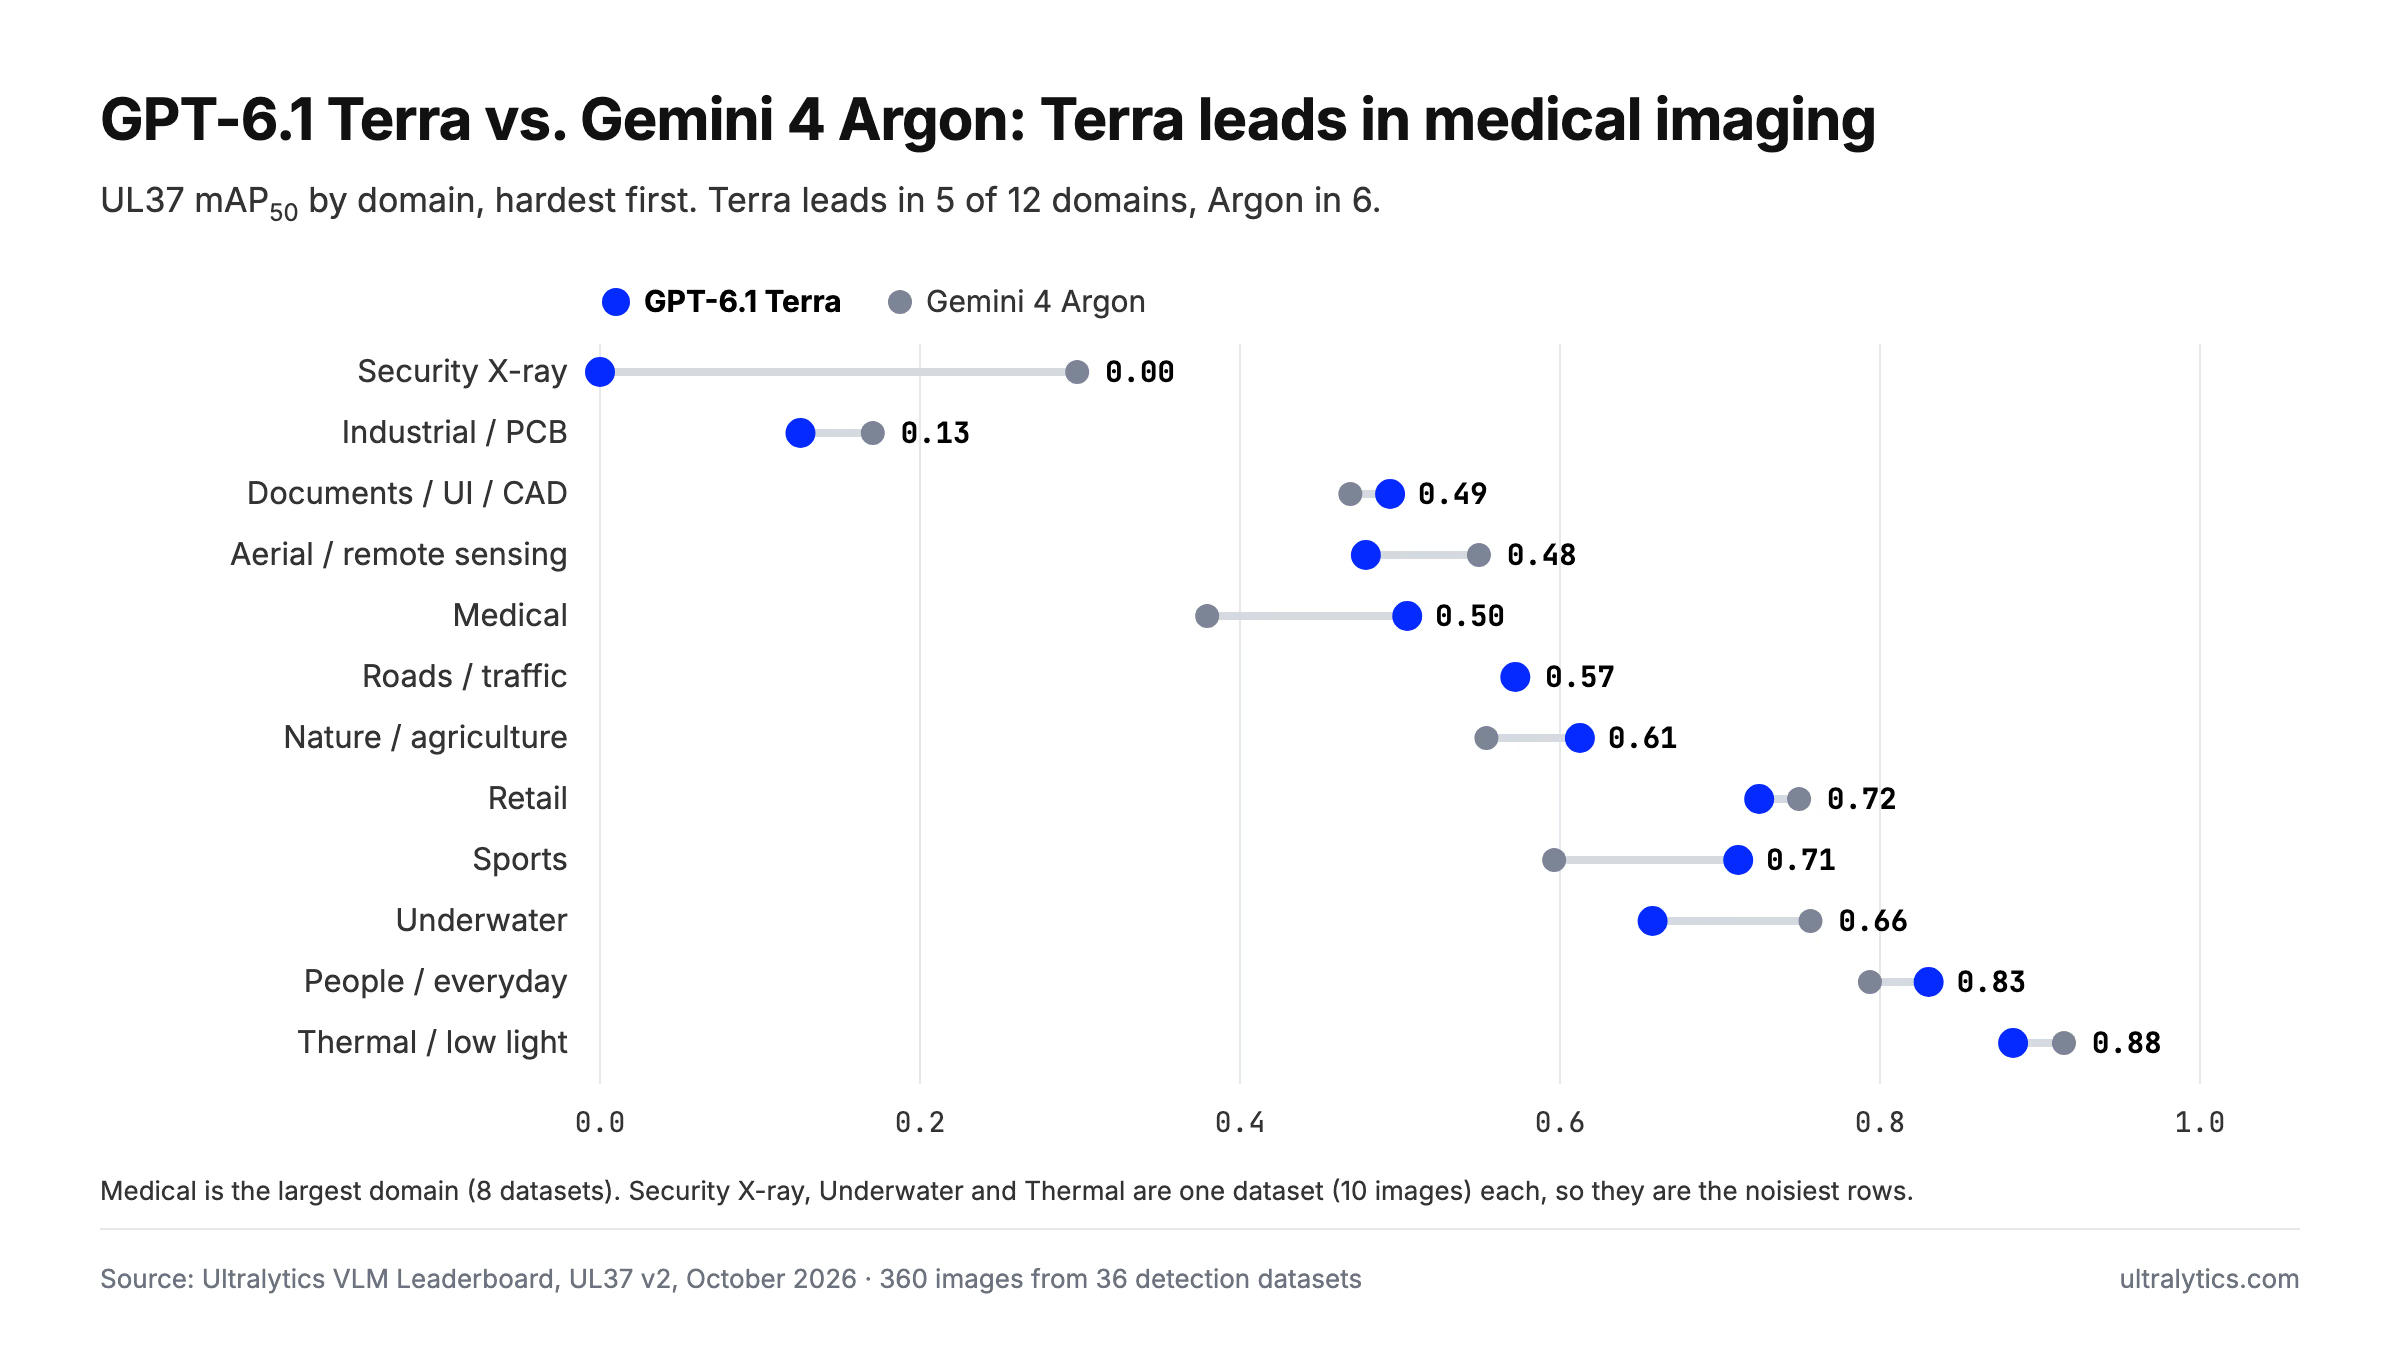
ドメイン別ではTerraが5分野で優位で、そのうち医療と文書・UI・CADの2分野で39モデル中第1位です。Argonは6分野で優位を保ち、航空、水中、熱画像の各カテゴリでも首位を維持しています。道路・交通は同率です。
2つのモデルでは、誤りの傾向も異なります。Argonはprecisionがわずかに高く、0.667対0.646です。一方、Terraはより多くのオブジェクトを検出し、recallは0.613対0.585です。Googleのリリース時の料金では、Terraは1,000枚あたり$4.36、Argonは$7.60です。Argonのほうがやや高速で、1画像あたり4.6秒です。
実務での使い分けは、医療、文書、スポーツ画像にはTerra、航空、水中、熱画像、保安画像にはArgonです。Gemini 4 Argonの自動アノテーション結果で、Argonの評価内容をご覧いただけます。
GPT-6.1 Terraのバッチ処理にかかる費用#
1,000枚あたり$4.36はプロバイダーへの支払い額で、OpenAIが報告したトークン使用量に定価を適用して算出しています。画像1枚あたりの入力トークン数は中央値で約1,300、出力は370でした。Batch AnnotationではPlatformの処理手数料として1,000枚あたり$1.00が加算されるため、1,000枚の処理には合計約$5.36かかります。
今回の実行で分かった追加情報は、ほかに3つあります。
- リクエストの失敗なし。 Terraのベンチマーク用リクエストはすべて、Platformの115秒制限内に完了しました。GPT-6.1 Solは2枚、GPT-6 Astraは4枚で失敗しました。
- 元のボックスの精度がすでに高い。 SAM 3.1による調整前でも、Terraのボックスは0.559 mAP50を記録しています。調整後は0.560となり、ほぼすべての処理をモデル自身が行っています。
- 設定は不要。 デフォルトの推論レベルと標準のOpenAIリクエストだけで動作しました。
精度をあと数ポイント上げることより予算を重視する場合は、より安価な選択肢があります。Claude Haiku 5.5は1,000枚あたり$0.37で0.429、Gemini 3.5 Flash-Liteは$1.77で0.380を記録しています。Qwen3.8 27B、Gemma 4 26B、SAM 3.1 Textなどのホスト型モデルはAPIキーが不要で、独自のUltralytics YOLOモデルも同様です。
OpenAIのキーからラベル付きデータセットまで#
GPT-6.1 Terraは、1~200クラスの検出データセットに対応する、クラスプロンプト型のモデルです。データセット固有のクラス名に基づいてバウンディングボックスを返し、保存する前にレビューできます。設定手順は次のとおりです。
- OpenAI APIキーのページでキーを作成します。
- データセットを所有するPlatformワークスペースのSettings > API Keysにキーを追加します。OpenAIへの支払いは直接行い、Ultralyticsがトークンに上乗せ料金を課すことはありません。詳細はプロバイダーキーのドキュメントをご覧ください。
- アノテーションエディターでSmartモードに切り替え、モデル選択メニューのOpenAIからGPT-6.1 Terraを選びます。
- Predictまたは
Pを押すと、現在の画像にラベルが付けられます。規模を拡大する前に、データを代表する画像を数枚試してください。 - 結果に問題がなければ、データセットページに移動し、More actions > Batch Annotationを選択して、未ラベルの画像すべてに一括でラベルを付けます。Platformは先にデータセットのバージョンを保存するため、変更をロールバックできます。
- ボックスを確認して保存したら、同じワークスペースでその結果を使ってUltralytics YOLO26モデルをトレーニングします。トレーニングドキュメントで手順を説明しています。
これらのモデルがエディターにどのように組み込まれているかを詳しく知るには、Ultralytics PlatformがAIを使ってアノテーションを自動化する方法と、ビジョン言語モデルの入門記事をご覧ください。
GPT-6.1 Terraへの切り替えが適しているユーザー#
一般的な物体検出のラベリングでは、GPT-6.1 Terraを有料モデルのデフォルトにしてください。ベンチマークで評価したモデルの中で最も精度が高く、上位6モデルの中で最安であり、今回の実行ではリクエストの失敗が一度もありませんでした。
超音波、MRI、顕微鏡画像の初稿アノテーションに特に適しており、専門家によるレビューを前提とする用途や、誤ったボックスがすぐに増えてしまう商品が密集した小売店の棚にも有効です。あらゆる種類のX線画像やPCB欠陥には、Gemini 4 Argon、GPT-6 Astra、GPT-6.1 Solのほうが優れているため、別のモデルを選んでください。
現在、画像のラベリングだけにSolまたはAstraの料金を支払っている場合、切り替えは簡単です。TerraならSolの半額未満で、より精度の高いボックスを得られます。
よくある質問
はい。私たちのUL37ベンチマークでは、GPT-6.1 Terraは36の実世界の検出データセットの平均で0.560 mAP50を記録し、Ultralytics VLM Leaderboardの39モデル中で最高スコアとなりました。より厳密なmAP50-95指標でも0.345で第1位です。最も苦手とする分野はX線画像と回路基板の欠陥です。
私たちのベンチマークでは、はい。Terraは0.560 mAP50で、Solの0.514を上回り、36データセット中22データセットで勝っています。1,000枚あたりの料金は$4.36で、Solの$10.30に対して半額未満であり、速度も約2倍です。PCB欠陥の検出では、引き続きSolのほうが優れたOpenAIの選択肢です。
Terraは0.560 mAP50でArgonの0.537を上回り、画像あたりの料金も安価ですが、接戦です。Terraは19データセット、Argonは16データセットで勝ち、1つは同率です。TN5000の甲状腺超音波データセットを除くと、両者はほぼ同等です。医療画像と文書画像にはTerra、航空、水中、熱画像、保安検査用X線画像にはArgonを選んでください。
プロバイダーが報告したトークン使用量に基づくと、OpenAIへの料金は約4.36ドルです。料金は入力トークン100万件あたり1ドル、出力トークン100万件あたり5ドルの標準価格で計算しています。Ultralytics Platformの一括アノテーションでは、画像1,000枚あたり1.00ドルの処理手数料がかかります。ご自身のAPIキーを使って、OpenAIに直接お支払いください。
8つの医療データセットで最も高い性能を示し、平均mAP50は0.505です。甲状腺超音波検査、脳腫瘍MRI、血球顕微鏡画像で最高スコアを記録しています。一方、X線画像での性能は大幅に低く、結腸ポリープ内視鏡検査でも他のモデルに劣ります。専門家による確認用のボックスの下書き作成に使用し、診断ツールとしては決して使用しないでください。
いいえ。PlatformはOpenAIのデフォルトの推論レベルであるmediumでGPT-6.1 Terraを呼び出し、すべてのOpenAIモデルで使用しているものと同じボックス要求を送信します。その後、SAM 3.1が各ボックスを調整します。ベンチマークでのリクエストの所要時間の中央値は5.1秒で、失敗したリクエストはありませんでした。









