コンピュータービジョン推論におけるONNXとTensorRTの比較:ベンチマークと選び方
コンピュータービジョン推論におけるONNX RuntimeとTensorRTの比較:19種類のNVIDIA GPUでUltralytics YOLO26の速度と精度を測定し、選び方を解説します。
 Miles Deans12 分で読めます
ONNXとTensorRTは、実際には競合するものではありません。ONNXはモデルフォーマットであり、TensorRTはNVIDIAの推論エンジンです。TensorRTは通常、入力としてONNXファイルを使用します。実際に選ぶのは、そのファイルの実行方法です。ハードウェアを問わず動作し、TensorRTに処理を委ねることもできるONNX Runtimeを使うか、NVIDIA GPUでのみ動作するスタンドアロンのTensorRTエンジンにコンパイルするかです。19種類のNVIDIA GPU上でUltralytics YOLO26を対象に実施したUltralytics Platformのベンチマークでは、TensorRT FP16はすべてのGPUとモデルサイズで公表済みのONNX FP16結果を上回る速度を示し、精度差は0.001 mAP50-95以内でした。モデルサイズごとの速度向上率の中央値は1.85倍から2.55倍でした。このベンチマークでは、ONNXの結果を得るためにどのONNX Runtime実行プロバイダーを使用したかが示されていないため、ONNX Runtime全般やTensorRT実行プロバイダーとの比較について結論を出すことはできません。NVIDIA GPU上でUltralytics YOLO26を使う場合、レイテンシが重要ならTensorRT FP16から始め、1つのモデルファイルを複数種類のハードウェアで実行する必要があるならONNX Runtimeを使用してください。Ultralytics YOLOは、引数1つでどちらの形式にもエクスポートできます。
Ultralytics YOLOの活用を始めるには:
| デプロイ | まずは次から | Ultralytics YOLOのエクスポート |
|---|---|---|
| NVIDIA GPU、レイテンシが重要 | TensorRT FP16 | format="engine", quantize=16 |
| CPU、NVIDIA以外のハードウェア、または混在するデバイス構成 | ONNX Runtime | format="onnx" |
| NVIDIA GPU上でのONNX RuntimeのAPI | TensorRT実行プロバイダーを使用するONNX Runtime | format="onnx" |
ONNXとTensorRTの比較:フォーマット、ランタイム、エンジン#
この比較では、3つの異なるものが混同されています。
- オープンニューラルネットワーク交換(ONNX)は、トレーニング済みモデルのグラフと重みをフレームワークに依存しない形式で保存するファイルフォーマットです。PyTorchからONNXにエクスポートすると、ほかのツールでモデルを読み込めるようになります。
- ONNX RuntimeはONNXモデルを実行します。CPU、CUDA、TensorRTなどの実行プロバイダーと呼ばれるハードウェアバックエンドに処理を委ねるため、同じファイルをノートPCのCPUでもクラウドGPUでも実行できます。
- TensorRTは、通常はONNXファイルであるモデルを、ONNXパーサーを通じて読み込みます。レイヤーを融合し、構築先のGPU上で各演算に最速のカーネルを選択して、最適化されたエンジンを書き出します。
したがって、実際に比較すべきなのはONNX RuntimeとTensorRTです。ONNX RuntimeはTensorRT実行プロバイダーを通じてTensorRTを呼び出すこともできます。これにより、ONNX RuntimeのAPIを維持したまま、TensorRTが対応するサブグラフを実行できます。TensorRTが対応していないノードをCUDAで実行できるよう、ONNX RuntimeではCUDA実行プロバイダーを後から登録することが推奨されています。
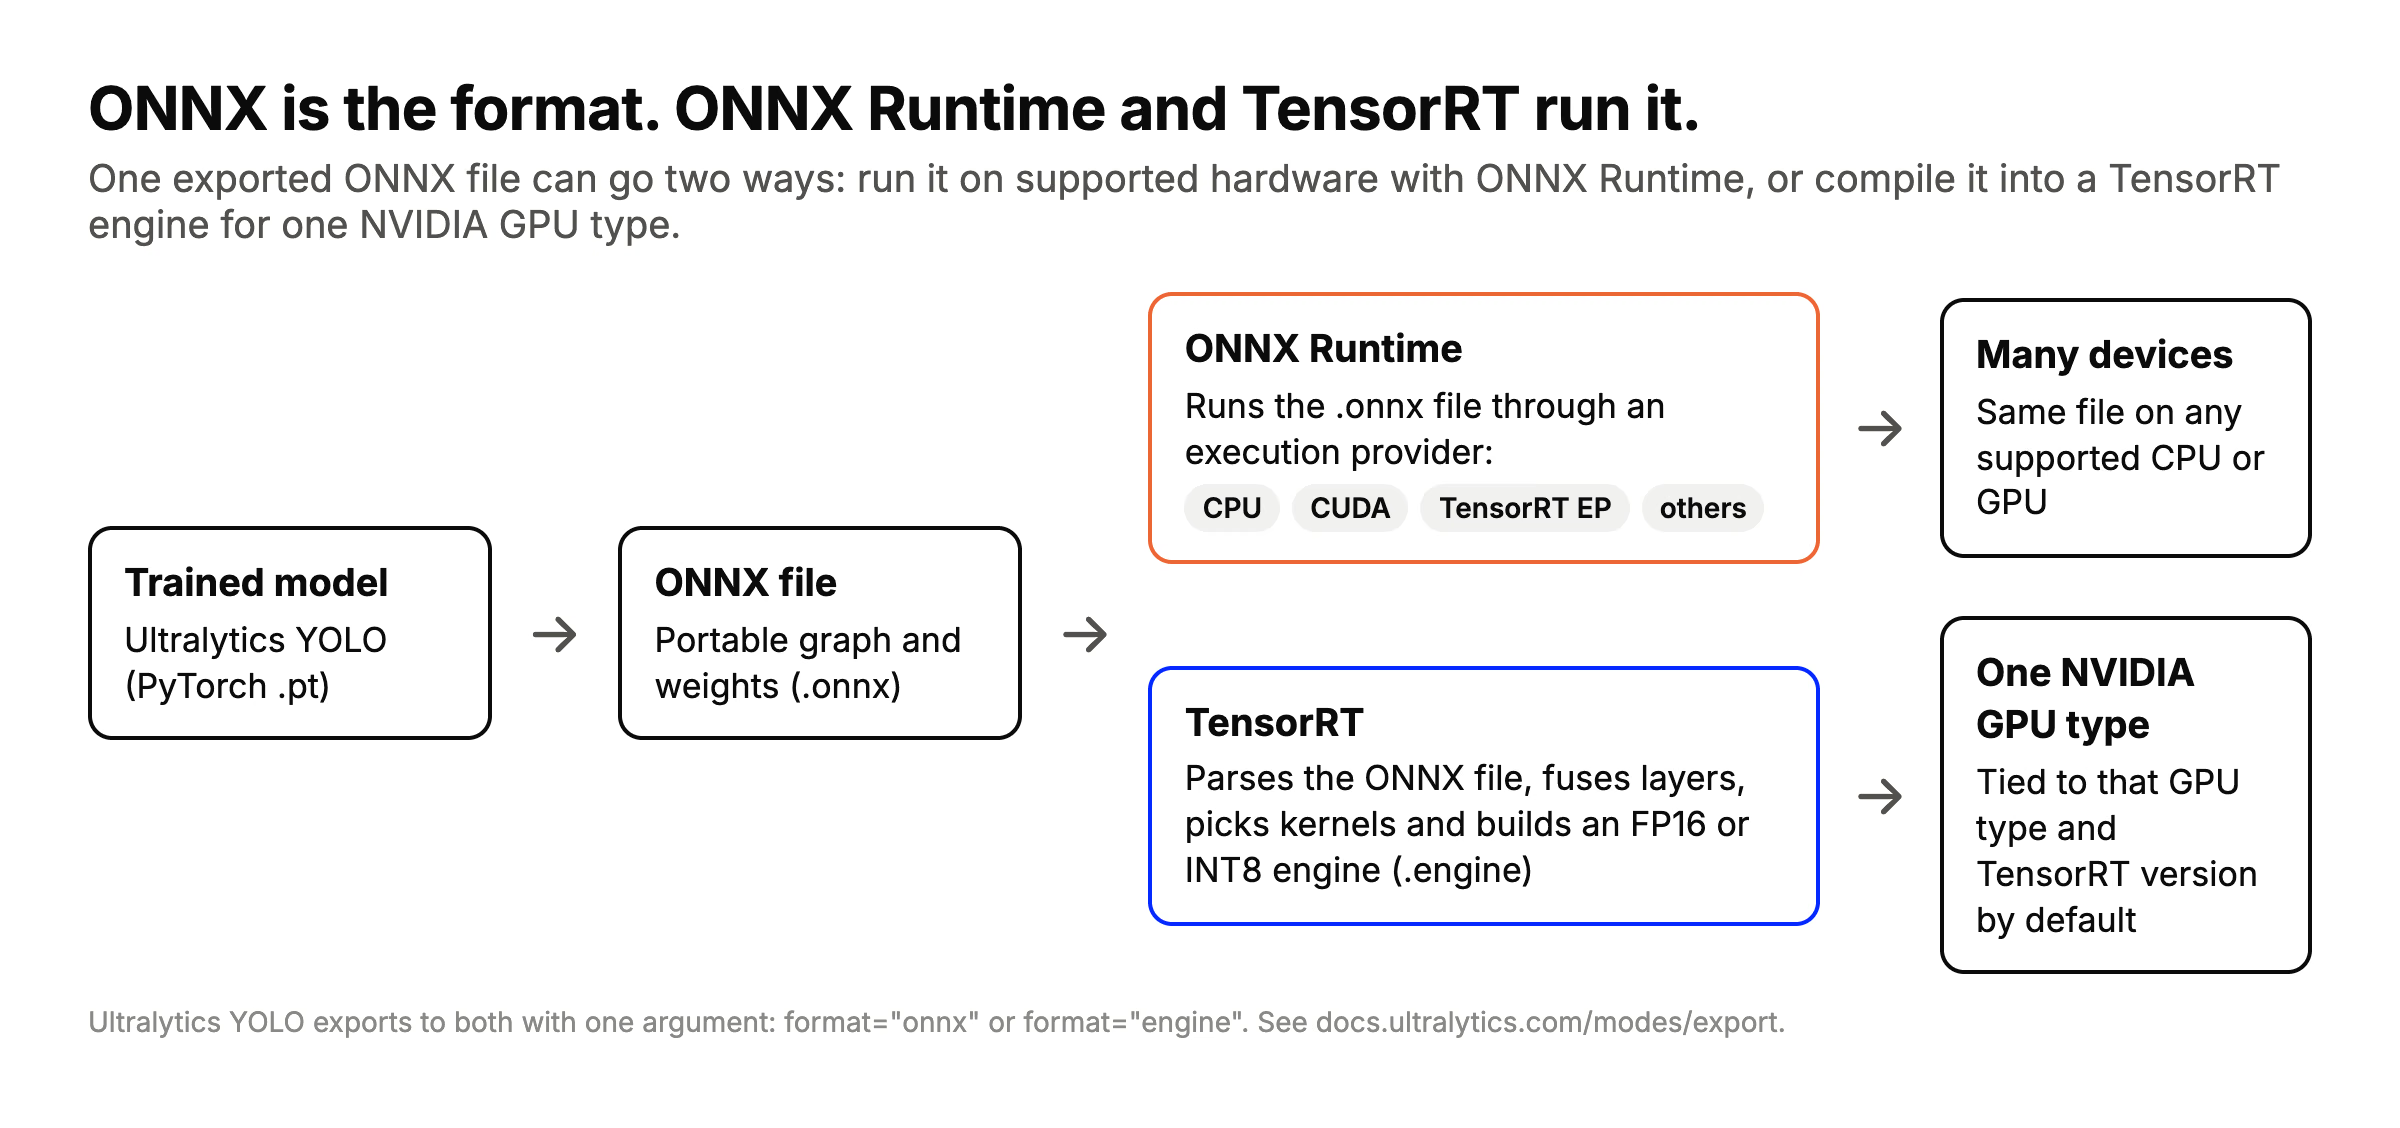
1つのONNXファイルから2つの実行方法があります。ONNX Runtimeは対応ハードウェア上でファイルを実行し、TensorRTは1種類のNVIDIA GPU向けにファイルをエンジンへコンパイルします。Ultralytics YOLOはどちらにもエクスポートできます。
ベンチマーク:ONNX RuntimeとTensorRTでのYOLO26#
以下の数値は、Ultralytics Platformの推論ベンチマークから引用しています。各Ultralytics YOLO26検出モデルを表示された形式にエクスポートし、Ultralytics PlatformのGPU上でCOCO val2017を使用して、バッチサイズ1、640ピクセルで推論レイテンシを計測しました。ウォームアップ時間は除外し、各実行時間にはシグマクリッピングを適用しています。精度はCOCO val2017でのmAP50-95で、形式と精度ごとに1回測定しています。この比較では、4つすべての形式の結果がある19種類のNVIDIA GPU(Ampere、Ada、Hopper)を使用しています。
ベンチマークページには、ONNXの結果を得るためにどのONNX Runtime実行プロバイダーを使用したかが記載されておらず、モデルの対応部分をTensorRTに委ねるONNX RuntimeのTensorRT実行プロバイダーを使用した結果とも明記されていません。これらのONNX結果は、ベンチマークで使用した構成を示すものです。パフォーマンスはONNX Runtime実行プロバイダーによって異なる場合があります。TensorRTをバックエンドにしてONNX RuntimeのAPIを使いたい場合は、お使いのハードウェアでその組み合わせをベンチマークしてください。
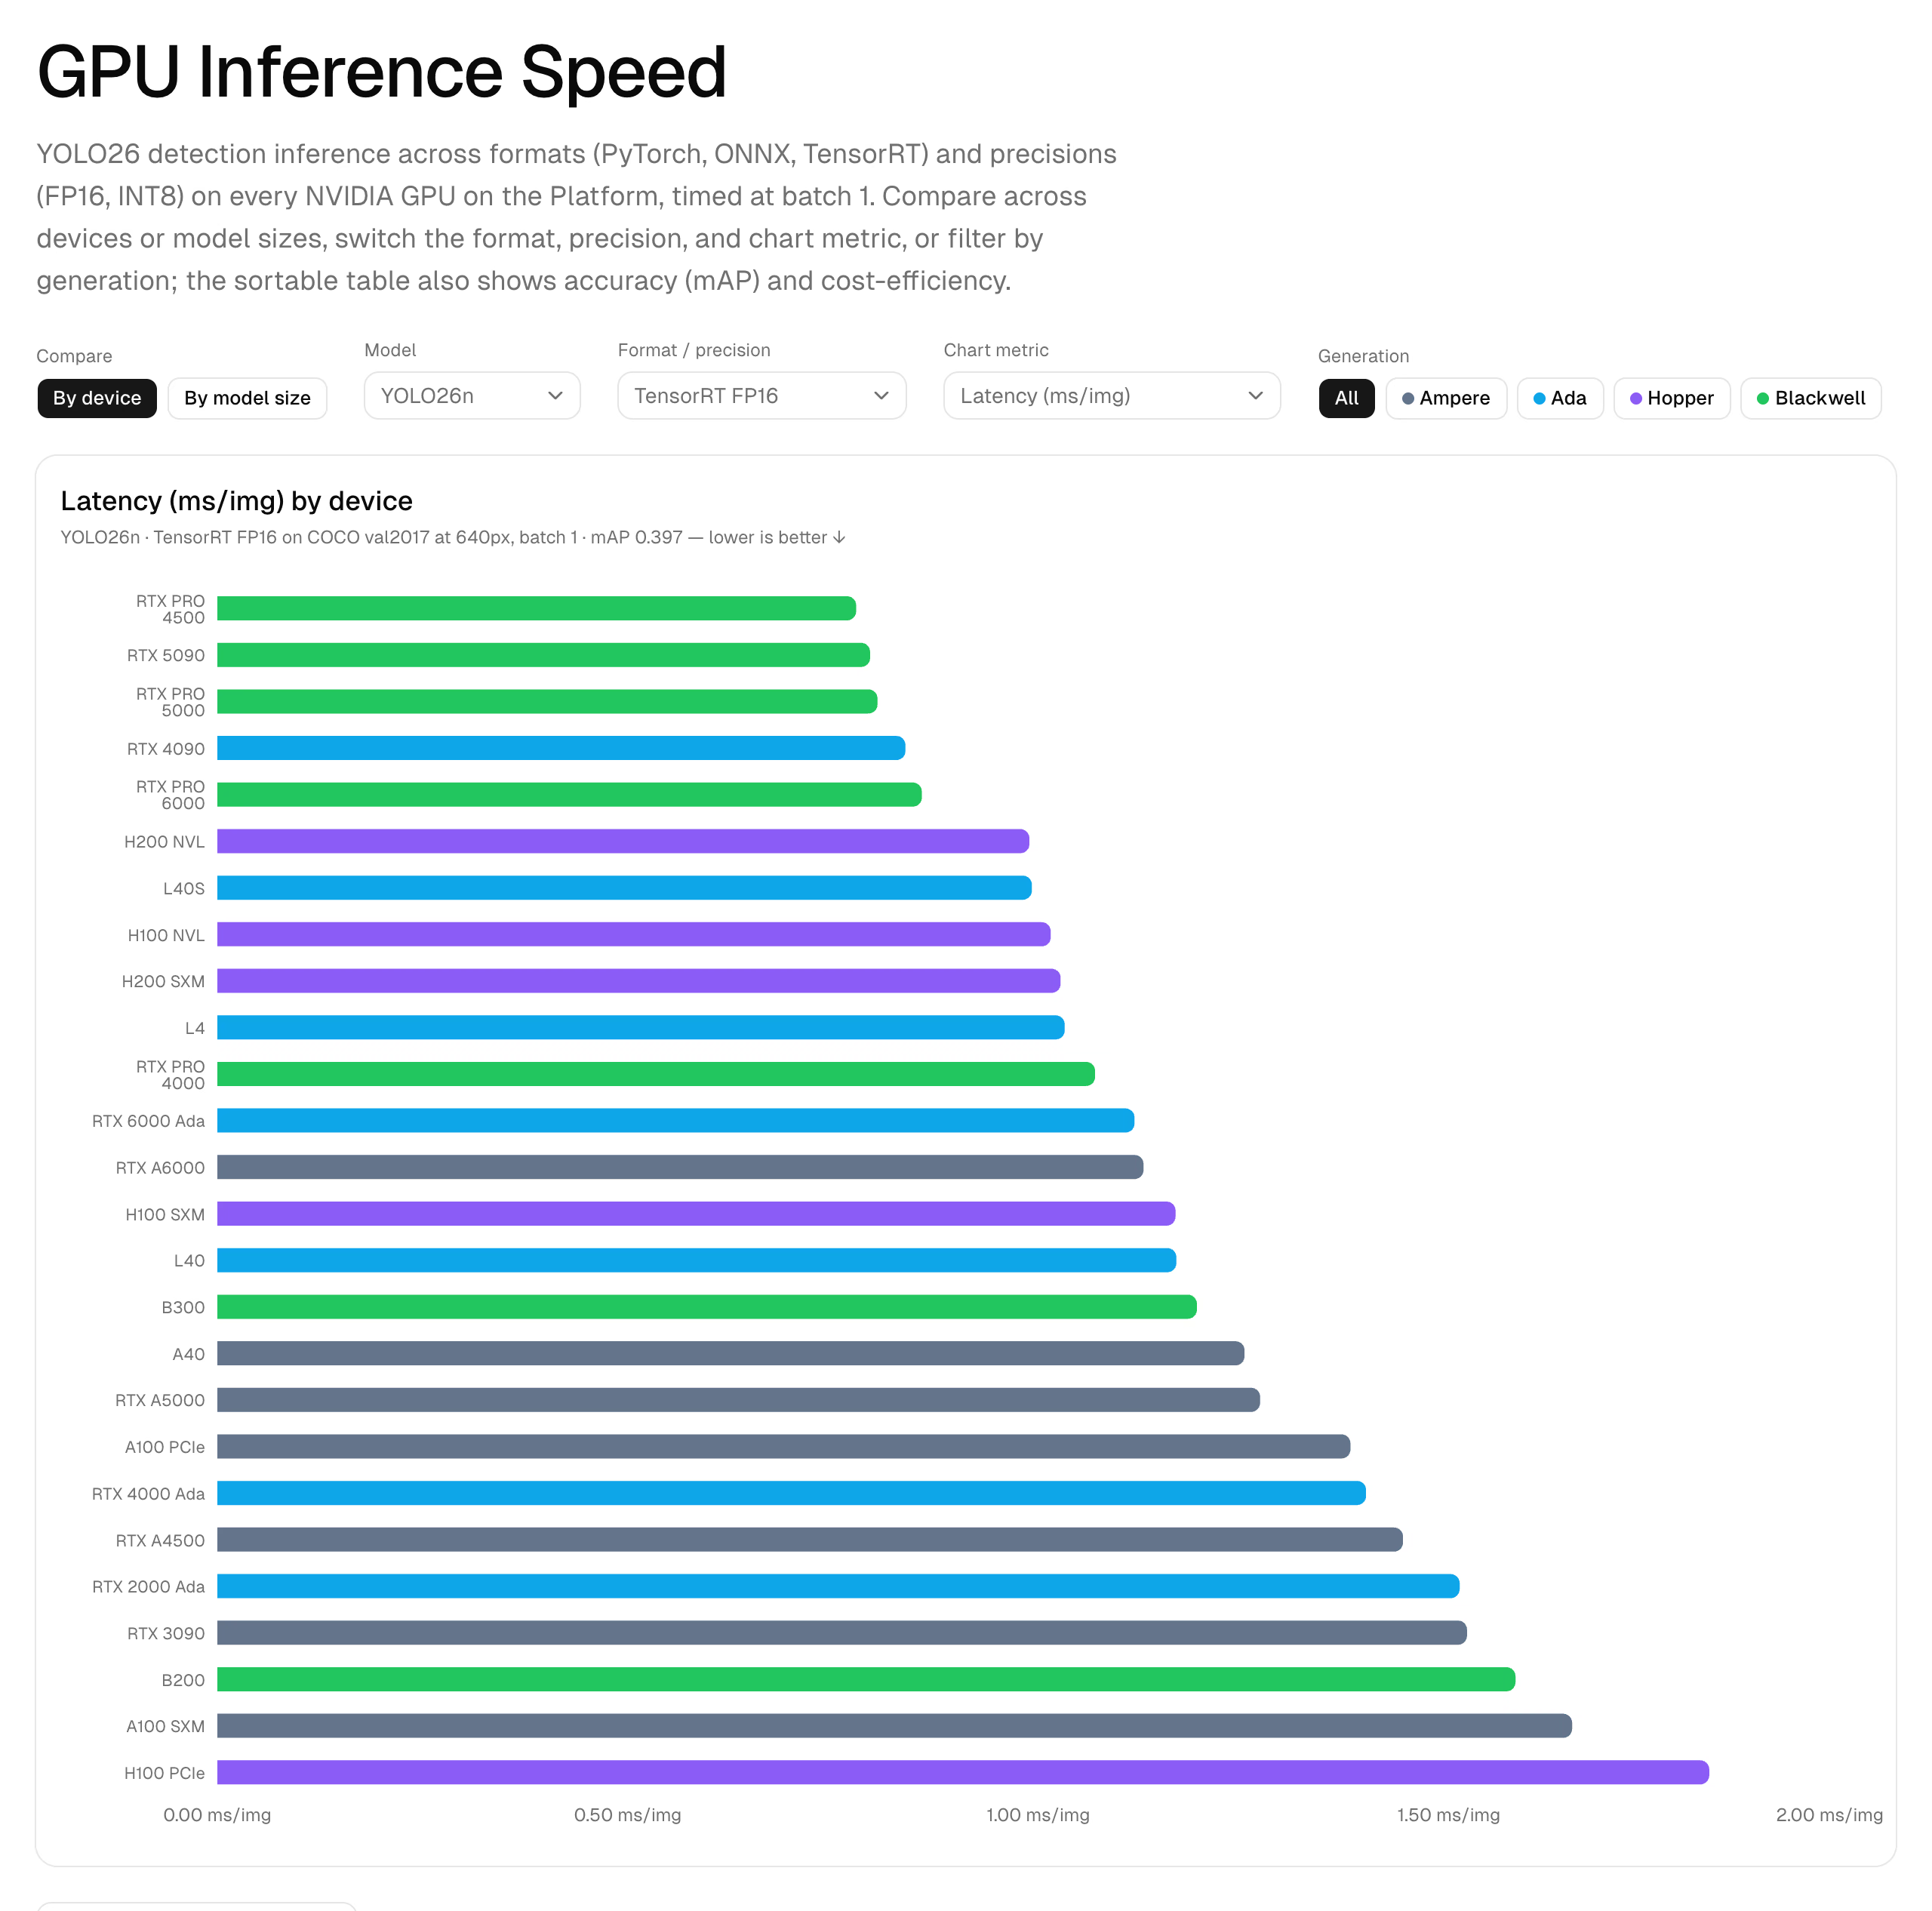
推論タブでは、モデルサイズ、形式、精度を切り替えたうえで、すべてのGPUをレイテンシ、精度、コストのいずれかで並べ替えられます。
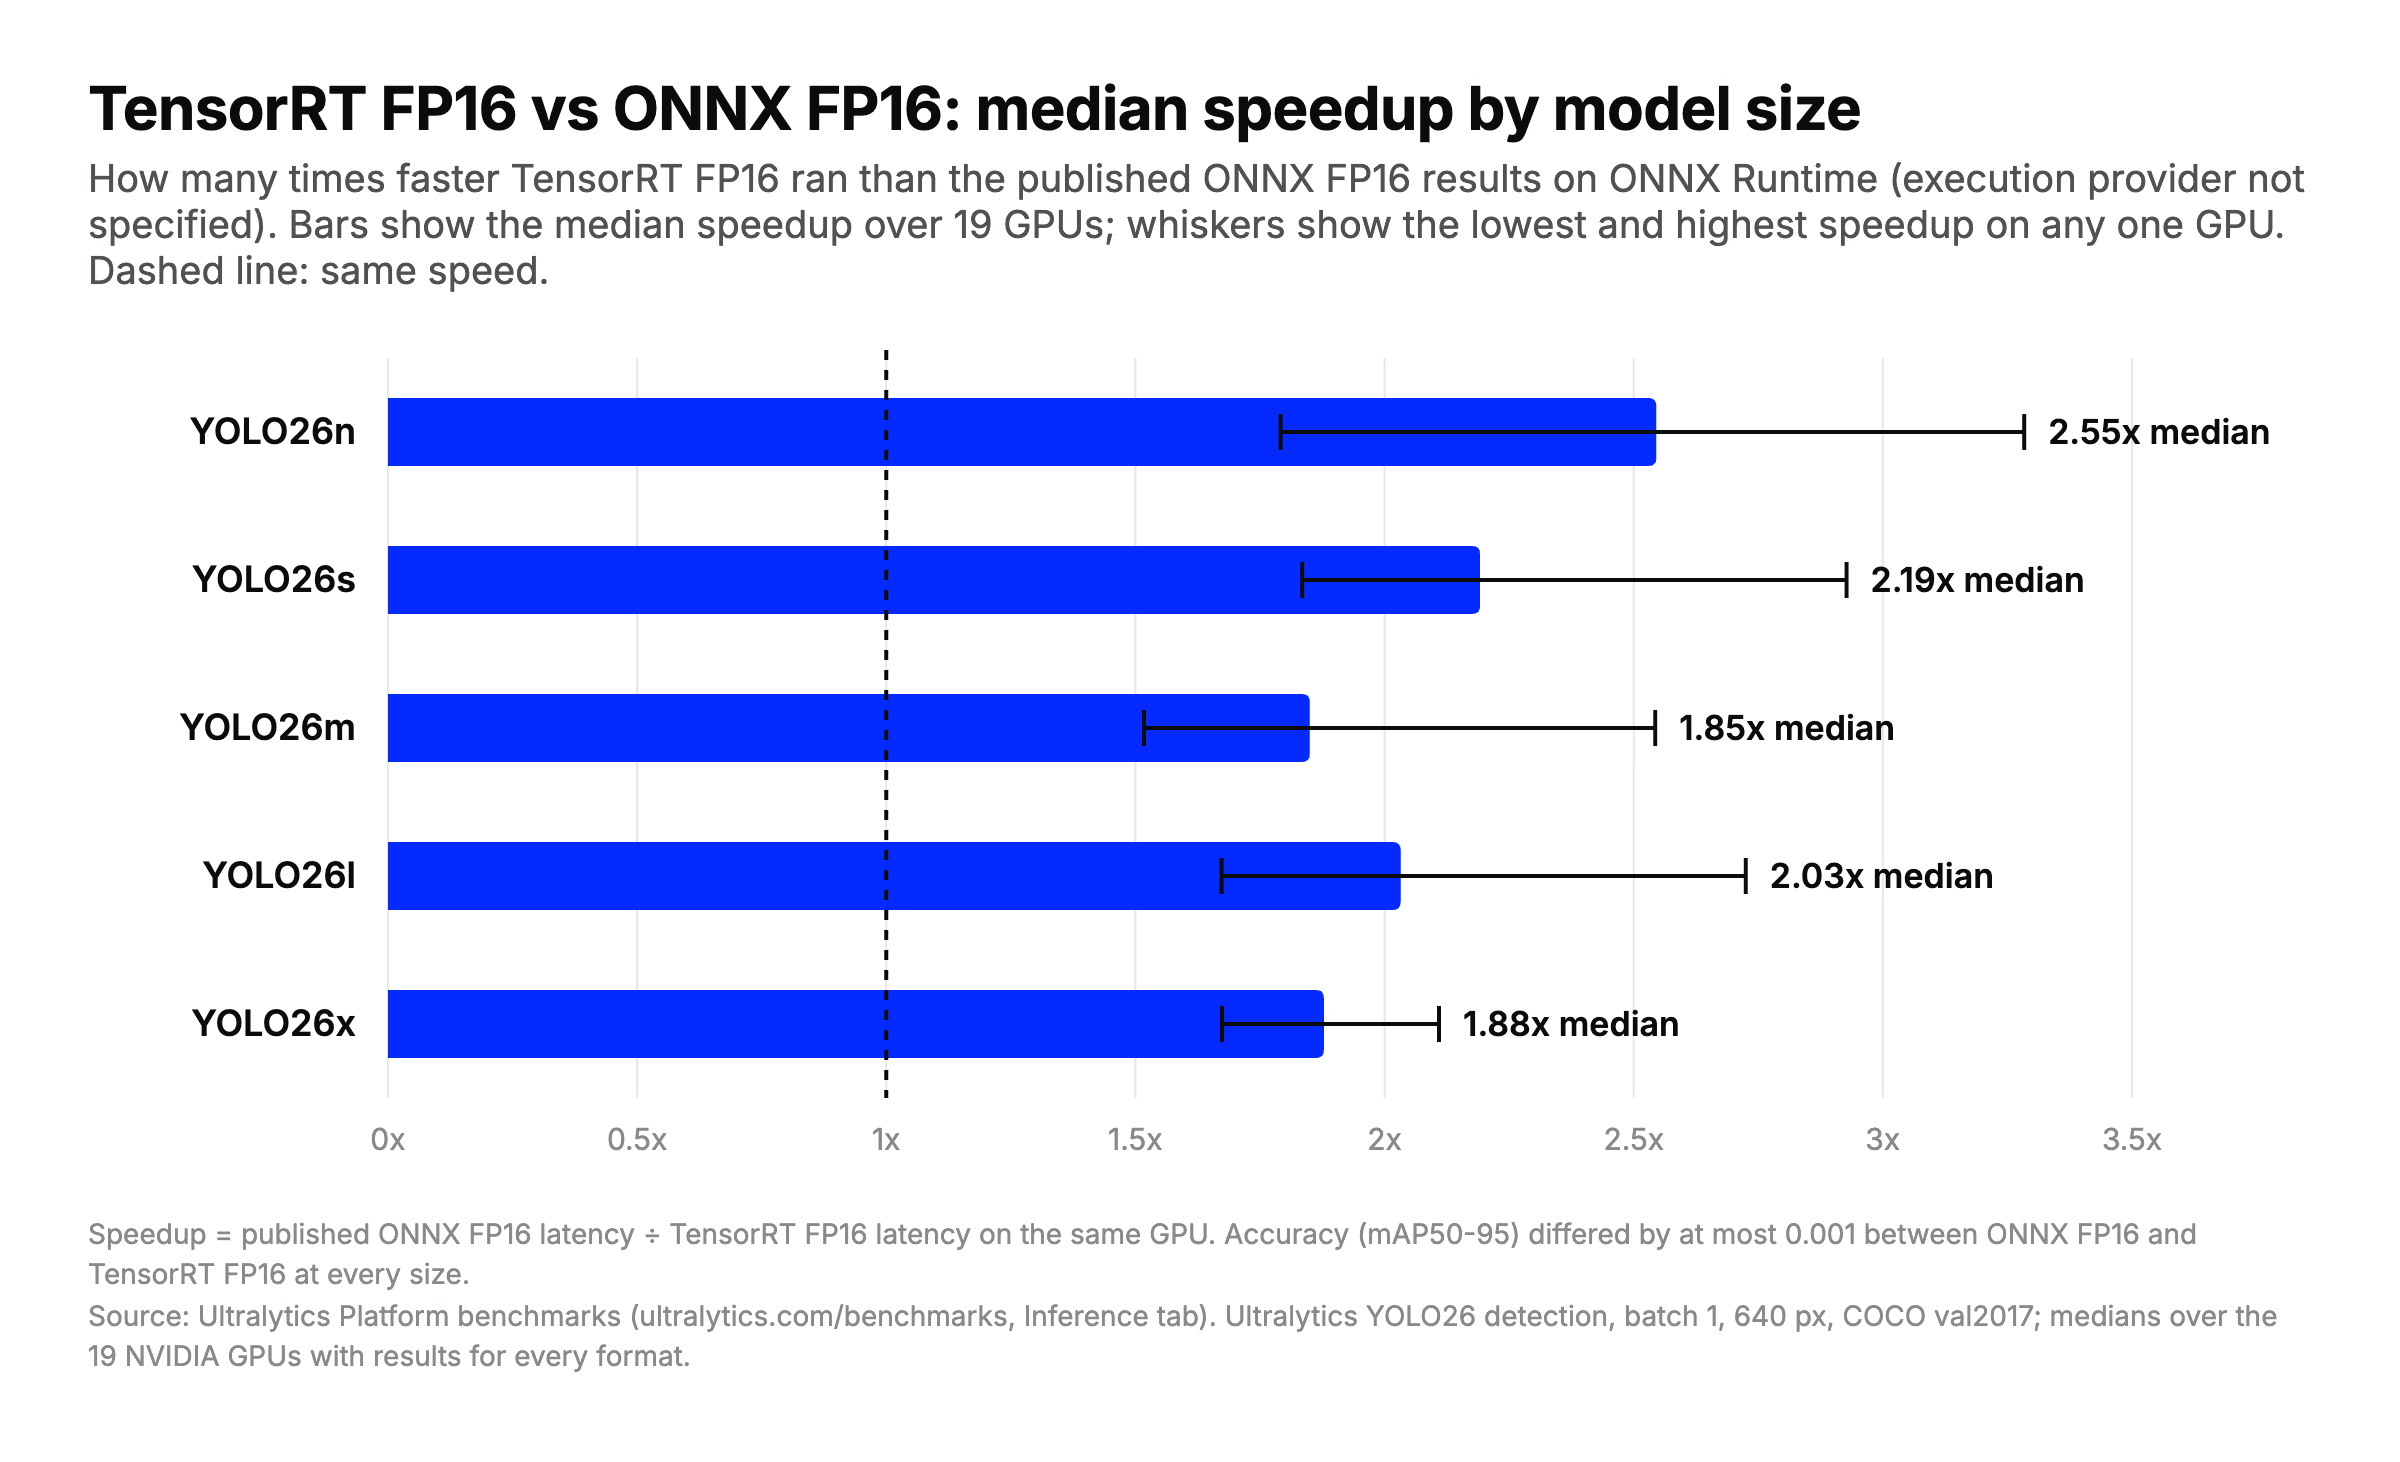
すべてのGPUとモデルサイズで、TensorRT FP16は公表済みのONNX FP16結果より高速でした。ただし、ONNX Runtime実行プロバイダーの種類はページに記載されていません。棒は19種類のGPUでの速度向上率の中央値、ひげは各GPUでの最小値と最大値を示しています。Ultralytics Platformの推論ベンチマークから算出しました。
| モデル | mAP50-95:ONNX FP16 | mAP50-95:TensorRT FP16 | mAP50-95:TensorRT INT8 | ONNX FP16に対するTensorRT FP16の速度向上率(中央値、範囲) | TensorRT FP16に対するTensorRT INT8の速度向上率(中央値、範囲) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55倍(1.79~3.28倍) | 0.90倍(0.79~1.07倍) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19倍(1.83~2.93倍) | 1.04倍(0.89~1.19倍) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85倍(1.52~2.54倍) | 1.20倍(0.90~1.38倍) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03倍(1.67~2.73倍) | 1.08倍(0.92~1.33倍) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88倍(1.67~2.11倍) | 1.19倍(0.92~1.67倍) |
Ultralytics Platformの推論ベンチマークから算出しました。速度向上率は、同じGPUでのONNX FP16レイテンシ÷TensorRT FP16レイテンシ、またはTensorRT FP16レイテンシ÷TensorRT INT8レイテンシです。そのため、1倍を超える値はTensorRT FP16(またはINT8)の方が高速であることを示します。中央値は4つすべての形式に対応する19種類のNVIDIA GPUで算出し、範囲はそれらのGPU全体における比率の最小値と最大値です。精度は、各形式と精度で報告されたmAP50-95です。ONNX FP16は公表済みのONNX Runtimeの結果を指し、実行プロバイダーは明記されていません。
ベンチマークページに掲載されている、一般的な4種類のGPUでの画像1枚あたりのレイテンシ(ミリ秒):
| GPU | モデル | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
特に注目すべき点は3つあります。
- TensorRT FP16は、すべてのGPUとモデルサイズで公表済みのONNX FP16結果を上回り、精度差は0.001 mAP50-95以内でした。これらのNVIDIA GPUにデプロイし、低レイテンシが必要なら、TensorRT FP16から始めるのがおすすめです。
- INT8が常に有利とは限りません。YOLO26nでは、19種類のGPUのうち17種類でTensorRT FP16より低速で、mAP50-95が0.04低下しました。より大きなモデルでは効果が得られることが多く、L4上のYOLO26xでは最大1.67倍の速度向上がありましたが、mAP50-95は0.034~0.076低下しました。
- Blackwell GPU 7種類ではONNXの結果がありません。ベンチマークページでは、テスト環境にONNX Runtime用のBlackwellカーネルがなかったことが理由として挙げられています。TensorRTは7種類すべてで動作しました。
これらの結果は、ベンチマークページに記載された構成(バッチサイズ1、640ピクセル)を対象としています。選択する前に、デプロイ先のデバイスで独自のデータを使い、ご自身のモデルをベンチマークしてください。
TensorRTにおけるFP16とINT8の比較#
精度を下げることも大きな最適化手段ですが、ベンチマーク結果からは、テストが必要な理由がわかります。
- FP16(半精度)では、FP32と比べて重みとアクティベーションのサイズが半分になります。Ultralytics Platformのベンチマークでは、TensorRT FP16とONNX FP16、PyTorch FP16の精度差は0.003 mAP50-95以内でした。
- INT8では、重みとアクティベーションを8ビット整数で保存します。これはモデル量子化の一種です。キャリブレーションが必要です。代表的な画像セットをモデルに入力し、アクティベーションの範囲を測定します。Ultralytics Platformのベンチマークでは、キャリブレーションデータとしてCOCO128を使用し、NVIDIA ModelOptでキャリブレーションしました。
ベンチマーク手法の説明にもあるように、INT8の効果が最も高いのは、規模が大きく演算負荷の高いモデルです。最小モデルでは、量子化に伴う追加処理によってFP16と同等の速度になるか、FP16より遅くなる場合があります。INT8エンジンをデプロイする前に、独自のドメインの画像でキャリブレーションし、独自のデータで精度を検証してください。
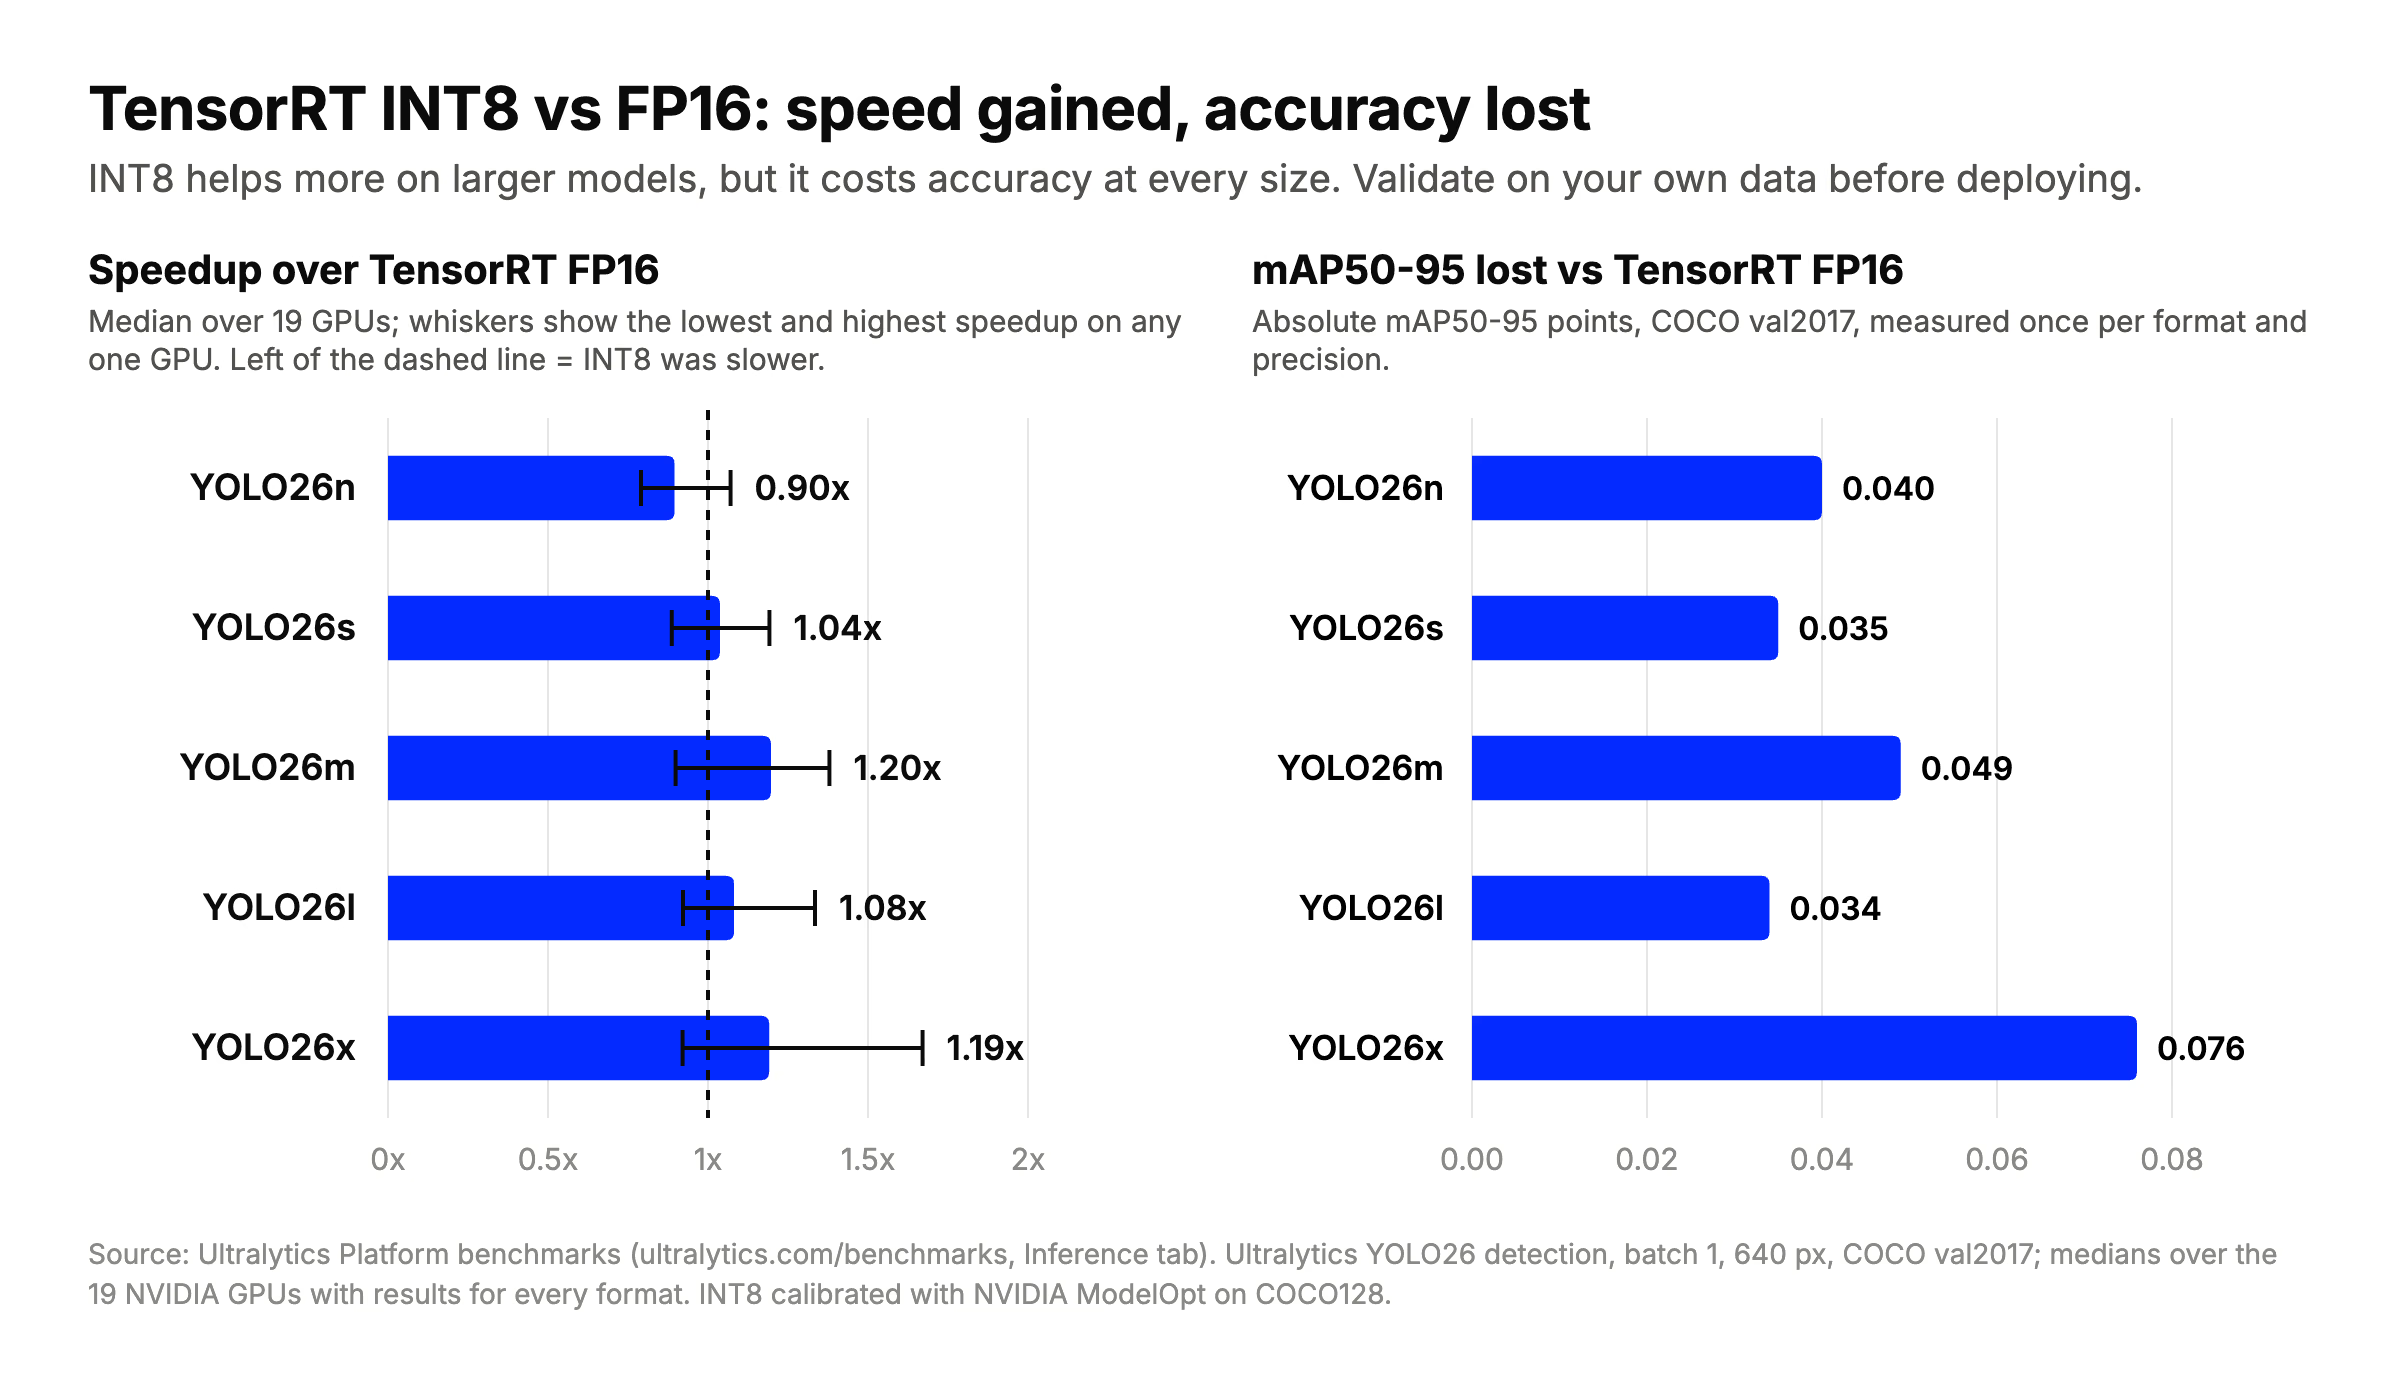
19種類のGPUの中央値では、YOLO26nでINT8はFP16より低速でした。一方、大きなモデルでは約1.2倍高速になる場合がありました。ただし、どのモデルサイズでもmAP50-95は0.034~0.076低下しました。Ultralytics Platformの推論ベンチマークから算出しました。
エンジンの移植性と動的な入力サイズ#
デフォルトでは、TensorRTエンジンは構築元のGPUと構築時に使用したTensorRTのバージョンに依存するため、RTX 4090上で構築したエンジンをH100やJetsonにコピーして使用することは想定されていません。TensorRTには、これらの制約を緩和するハードウェアおよびバージョンの互換性オプションがありますが、安全を期すなら、デプロイ先のデバイス上で、またはそのデバイス向けに構築し、TensorRTのアップグレード後に再構築するのが基本です。このため、Ultralytics Platformでは、エクスポートタブでTensorRTへのエクスポート時に使用するGPUの種類を選択するよう求められます。ONNXファイルにはこのような依存関係がなく、ONNX Runtimeと適切な実行プロバイダーが利用可能な環境であれば、同じファイルを実行できます。
どちらの形式も可変の入力サイズに対応しています。TensorRTで動的シェイプを使うには、入力の最小、最適、最大の次元を指定する最適化プロファイルが必要で、実行時の入力はその範囲内に収める必要があります。Ultralytics YOLOモデルのエクスポート時に、dynamic=Trueを指定すると、ONNXとTensorRTで動的な入力シェイプが有効になります。NVIDIAの動的シェイプのガイドで説明されているように、固定シェイプの方がTensorRTの最適化の余地が大きくなります。入力サイズが実際に変動する場合は動的シェイプを使用し、両方の方法をベンチマークしてください。
ONNX RuntimeとTensorRTの使い分け#
- クラウドまたはオンプレミスのNVIDIA GPUで、レイテンシが重要な場合:TensorRTを使用し、まずFP16から始めます。大きなモデルでは、キャリブレーションと検証を行ったうえでINT8を試してください。
- エッジデバイスのNVIDIA Jetson:TensorRTを使用します。NVIDIA Jetsonガイドを参照してください。
- CPU、NVIDIA以外のハードウェア、または異種デバイス構成:ONNXとONNX Runtimeを使い、各マシンが対応する実行プロバイダーを使用します。
- デプロイ先のハードウェアがまだ決まっていない場合:まずONNXにエクスポートしてください。後から同じモデルからTensorRTエンジンを構築できます。
- Intel CPU、GPU、またはNPU:Intelの推論ツールキットであるOpenVINOを検討してください。
フォーマットの全一覧と比較については、モデルデプロイオプションのガイドを参照してください。最適化の手段は精度だけではありません。モデルサイズや入力解像度も重要です。プルーニングと量子化のガイドでは、モデルを小さくするほかの2つの方法を紹介しています。
Ultralytics YOLOをONNXとTensorRTにエクスポートする#
Ultralytics YOLOはformat引数1つでどちらの形式にもエクスポートでき、エクスポートしたモデルを使って直接推論や検証を実行できます。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX Runtime用のONNX FP16
model.export(format="engine", quantize=16)  # このGPU上で構築するTensorRT FP16エンジン
# INT8を使用する場合は、データセットのYAMLファイルでキャリブレーションしてください(coco8.yamlは小規模なデモ用データセットです。実際の用途では独自のデータセットを使用してください)。
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")quantize=16はFP16を選択し、quantize=8はINT8を選択します。どちらのエンジンエクスポートでもyolo26n.engineが書き出されるため、いずれか一方を実行してください。INT8の場合は、dataに独自のデータセットYAMLファイルを指定し、デプロイ時に使う画像に似た画像でキャリブレーションしてください。すべてのオプションについては、エクスポート引数とONNX、TensorRTの統合ガイドを参照するか、ONNXへのエクスポートとTensorRTによる最適化の手順を順に解説する記事をご覧ください。Ultralytics Platformでは、ブラウザー上でトレーニング済みモデルをエクスポートすることもできます。
よくある質問
ONNXはモデルフォーマットであり、エンジンではないため、公平に比較するにはONNX RuntimeとTensorRTを比べる必要があります。19種類のNVIDIA GPU上でUltralytics YOLO26を対象に実施したUltralytics Platformのベンチマークでは、TensorRT FP16はすべてのGPUでONNX Runtimeの公表済みONNX FP16結果を上回る速度を示しました。モデルサイズごとの速度向上率の中央値は1.85倍から2.55倍で、mAP50-95の差は最大でも0.001でした。このベンチマークでは、ONNXの結果を得るためにどのONNX Runtime実行プロバイダーを使用したかが示されておらず、TensorRT実行プロバイダーを使用した結果も明記されていません。ONNX RuntimeのAPIが必要な場合は、その組み合わせをご自身でテストしてください。
はい。ONNXはTensorRTで一般的に使用される入力形式です。TensorRTのONNXパーサーがモデルを読み込み、そこからエンジンを構築します。ONNX Runtimeも、TensorRT実行プロバイダーを通じてTensorRTを呼び出すことができます。
いいえ。Ultralytics Platformのベンチマークでは、19種類のGPUのうち17種類で、YOLO26nのTensorRT INT8はTensorRT FP16より低速でした。より大きなモデルではINT8の方が高速になることが多く、すべての形式を実行した19種類のGPUでの中央値はYOLO26mとYOLO26xで約1.2倍でした。ただし、いずれの場合もmAP50-95は0.034~0.076低下したため、まず独自のデータでINT8モデルを検証してください。
そのまま使えるとは限りません。デフォルトでは、TensorRTエンジンは構築に使用したGPUとTensorRTのバージョンに依存するため、デプロイ先のデバイス上で、またはデプロイ先のデバイス向けに構築してください。ONNXファイルを移植可能なコピーとして保存し、ターゲットごとにエンジンを再構築してください。
通常はTensorRTが適しています。NVIDIAのJetPackにはTensorRTが含まれており、Jetson本体でエンジンを構築すると、そのデバイスに合わせて最適化されます。上記のベンチマークにはJetsonが含まれていないため、選択する前にご使用のモジュールで測定してください。NVIDIA Jetsonガイドでは、Ultralytics YOLOのセットアップとエクスポートの手順を説明しています。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









