自動アノテーションにおけるQwen4-Max:際立つデータセットとばらつきのある向上
Qwen4-Maxは自動アノテーションのベンチマークで51モデル中13位となり、手首のX線画像で1位、小売店の棚で2位です。精度、コスト、実行方法を紹介します。
 Miles Deans13 分で読めます
Alibabaは2026年11月16日にQwen4-Maxをリリースし、Qwenファミリーでこれまで最も高性能なモデルと位置づけました。ネイティブのビジョン機能と100万トークンのコンテキストウィンドウを備えています。同日、36データセットの物体検出ベンチマークであるUL37で評価しました。
全体では、Qwen4-Maxは当社のVLMリーダーボードで51モデル中13位となり、1,000枚あたり5.68ドルで0.474 mAP50を記録しています。この平均値だけでは、より顕著な結果が見えません。小児の手首のX線画像では、これまでにテストしたどのモデルよりも高いスコアを記録し、水中シーンと商品が密集した小売店の棚ではGemini 4 Carbonに次ぐ2位です。
Ultralytics Platformの自動アノテーションで、AlibabaのモデルとしてQwen3.8-Maxに代わりQwen4-Maxが利用できるようになりました。以下では、優れている点や弱点、比較対象となるモデルとの違い、ラベリングバッチのコストを紹介します。
Qwen4-MaxはUL37で51モデル中13位、手首のX線画像では1位#
UL37は、医療スキャンや航空画像から小売店の棚、スポーツ、回路基板に至るまでを含む36種類の実世界の物体検出データセットから各10枚ずつ、計360枚の画像を使い、モデルのバウンディングボックスが人手によるラベルとどの程度一致するかを測定します。平均値の算出では各データセットに同じ重みが与えられ、すべての画像がPlatformユーザーが利用するものと同じ本番パイプラインを通り、各データセット固有のクラス名を使ってSAM 3.1が各ボックスを精緻化するため、スコアはモデルの生の出力ではなく、精緻化後のパイプラインを反映します。評価方法は公開されています。
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| リーダーボード順位 | 51モデル中#13 | 51モデル中#15 | 51モデル中#3 | 51モデル中#11 | 51モデル中#16 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| 適合率 | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| 再現率 | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| プロバイダーの1,000枚あたりのコスト | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| 画像1枚あたりの中央値 | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| 失敗したリクエスト | 0% | 1.7% | 0% | 0% | 6.4% |
Ultralytics VLMリーダーボードのUL37結果。2026年11月19日更新。Qwen3.8-MaxはPlatformで提供されなくなりました。
Qwen4-Maxは主要なすべての指標でQwen3.8-Maxを上回り、画像あたりのコストも低く、すべてのベンチマークリクエストを完了しました。ただし、平均では依然として上位モデルに大きく後れを取っています。GPT-6.1 Terraは、より低いコストで0.560を記録し、所要時間も半分未満です。
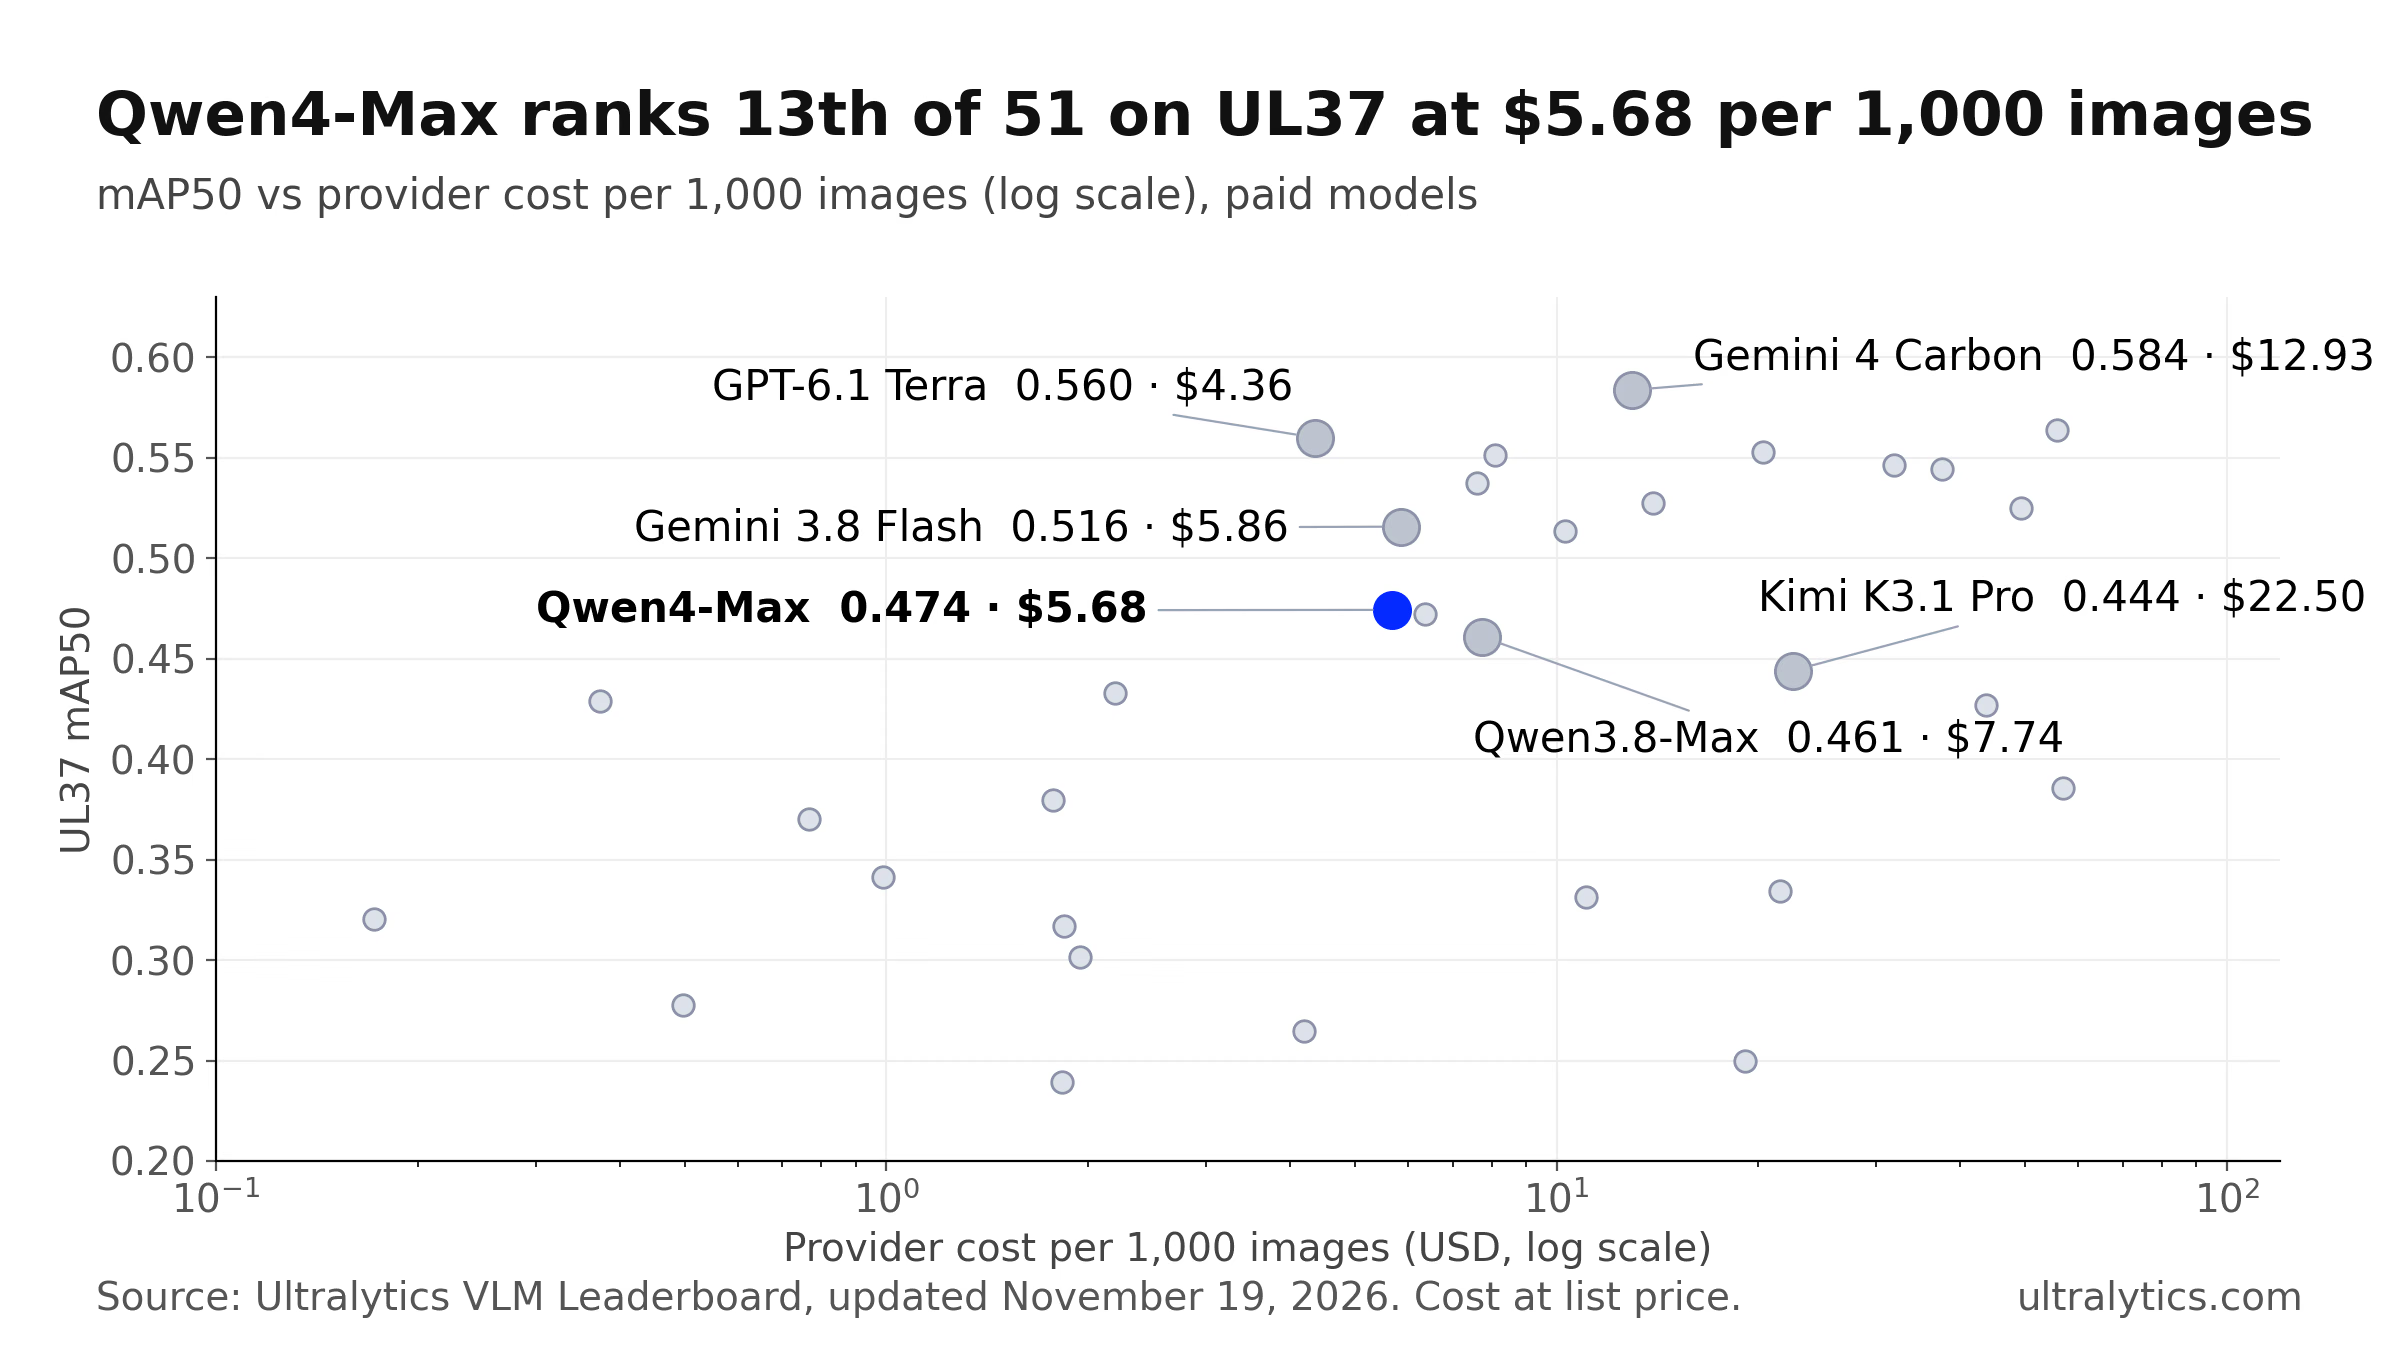
各点はUltralytics VLMリーダーボードに掲載された有料モデルです。
AlibabaがQwen4-Maxを開発した目的#
Alibabaはローンチ発表で、Qwen4-Maxを、総パラメーター数2.4兆、そのうち各トークンで有効になるのは710億の、ネイティブのビジョン機能を備えたスパースMixture-of-Expertsモデルと説明しています。コーディング、エージェントタスク、視覚的推論を主な用途として挙げています。また、自社のWork360ベンチマークではQwen4-MaxがQwen3.8-Maxを上回り、タスクあたりの平均コストを約60%削減したと報告しています。
Alibaba CloudのModel Studioリリースノートでは、「テキスト生成、画像・動画の理解、深い推論を組み合わせた、Qwenファミリーの次世代フラッグシップマルチモーダルモデル」と紹介されています。国際向けの価格は、入力トークン100万あたり1.50ドル、出力トークン100万あたり4.50ドルで、Qwen3.8-Maxの2ドルと6ドルから値下げされています。このモデルはAlibabaのAPIから利用でき、Alibabaによると、より小型のオープンウェイトQwen4モデルも今後提供される予定です。
発表にもリリースノートにも物体検出の結果は記載されていないため、今回それを測定しました。
Qwen4-MaxとQwen3.8-Maxの比較:低コスト、向上幅にはばらつき#
Qwen4-Maxは19のデータセットで前世代モデルを上回り、16で下回り、1つで同等でした。平均で0.013 mAP50向上したのは、一部のデータセットでの大幅な改善が、他のデータセットでの明確な低下を補ったためです。
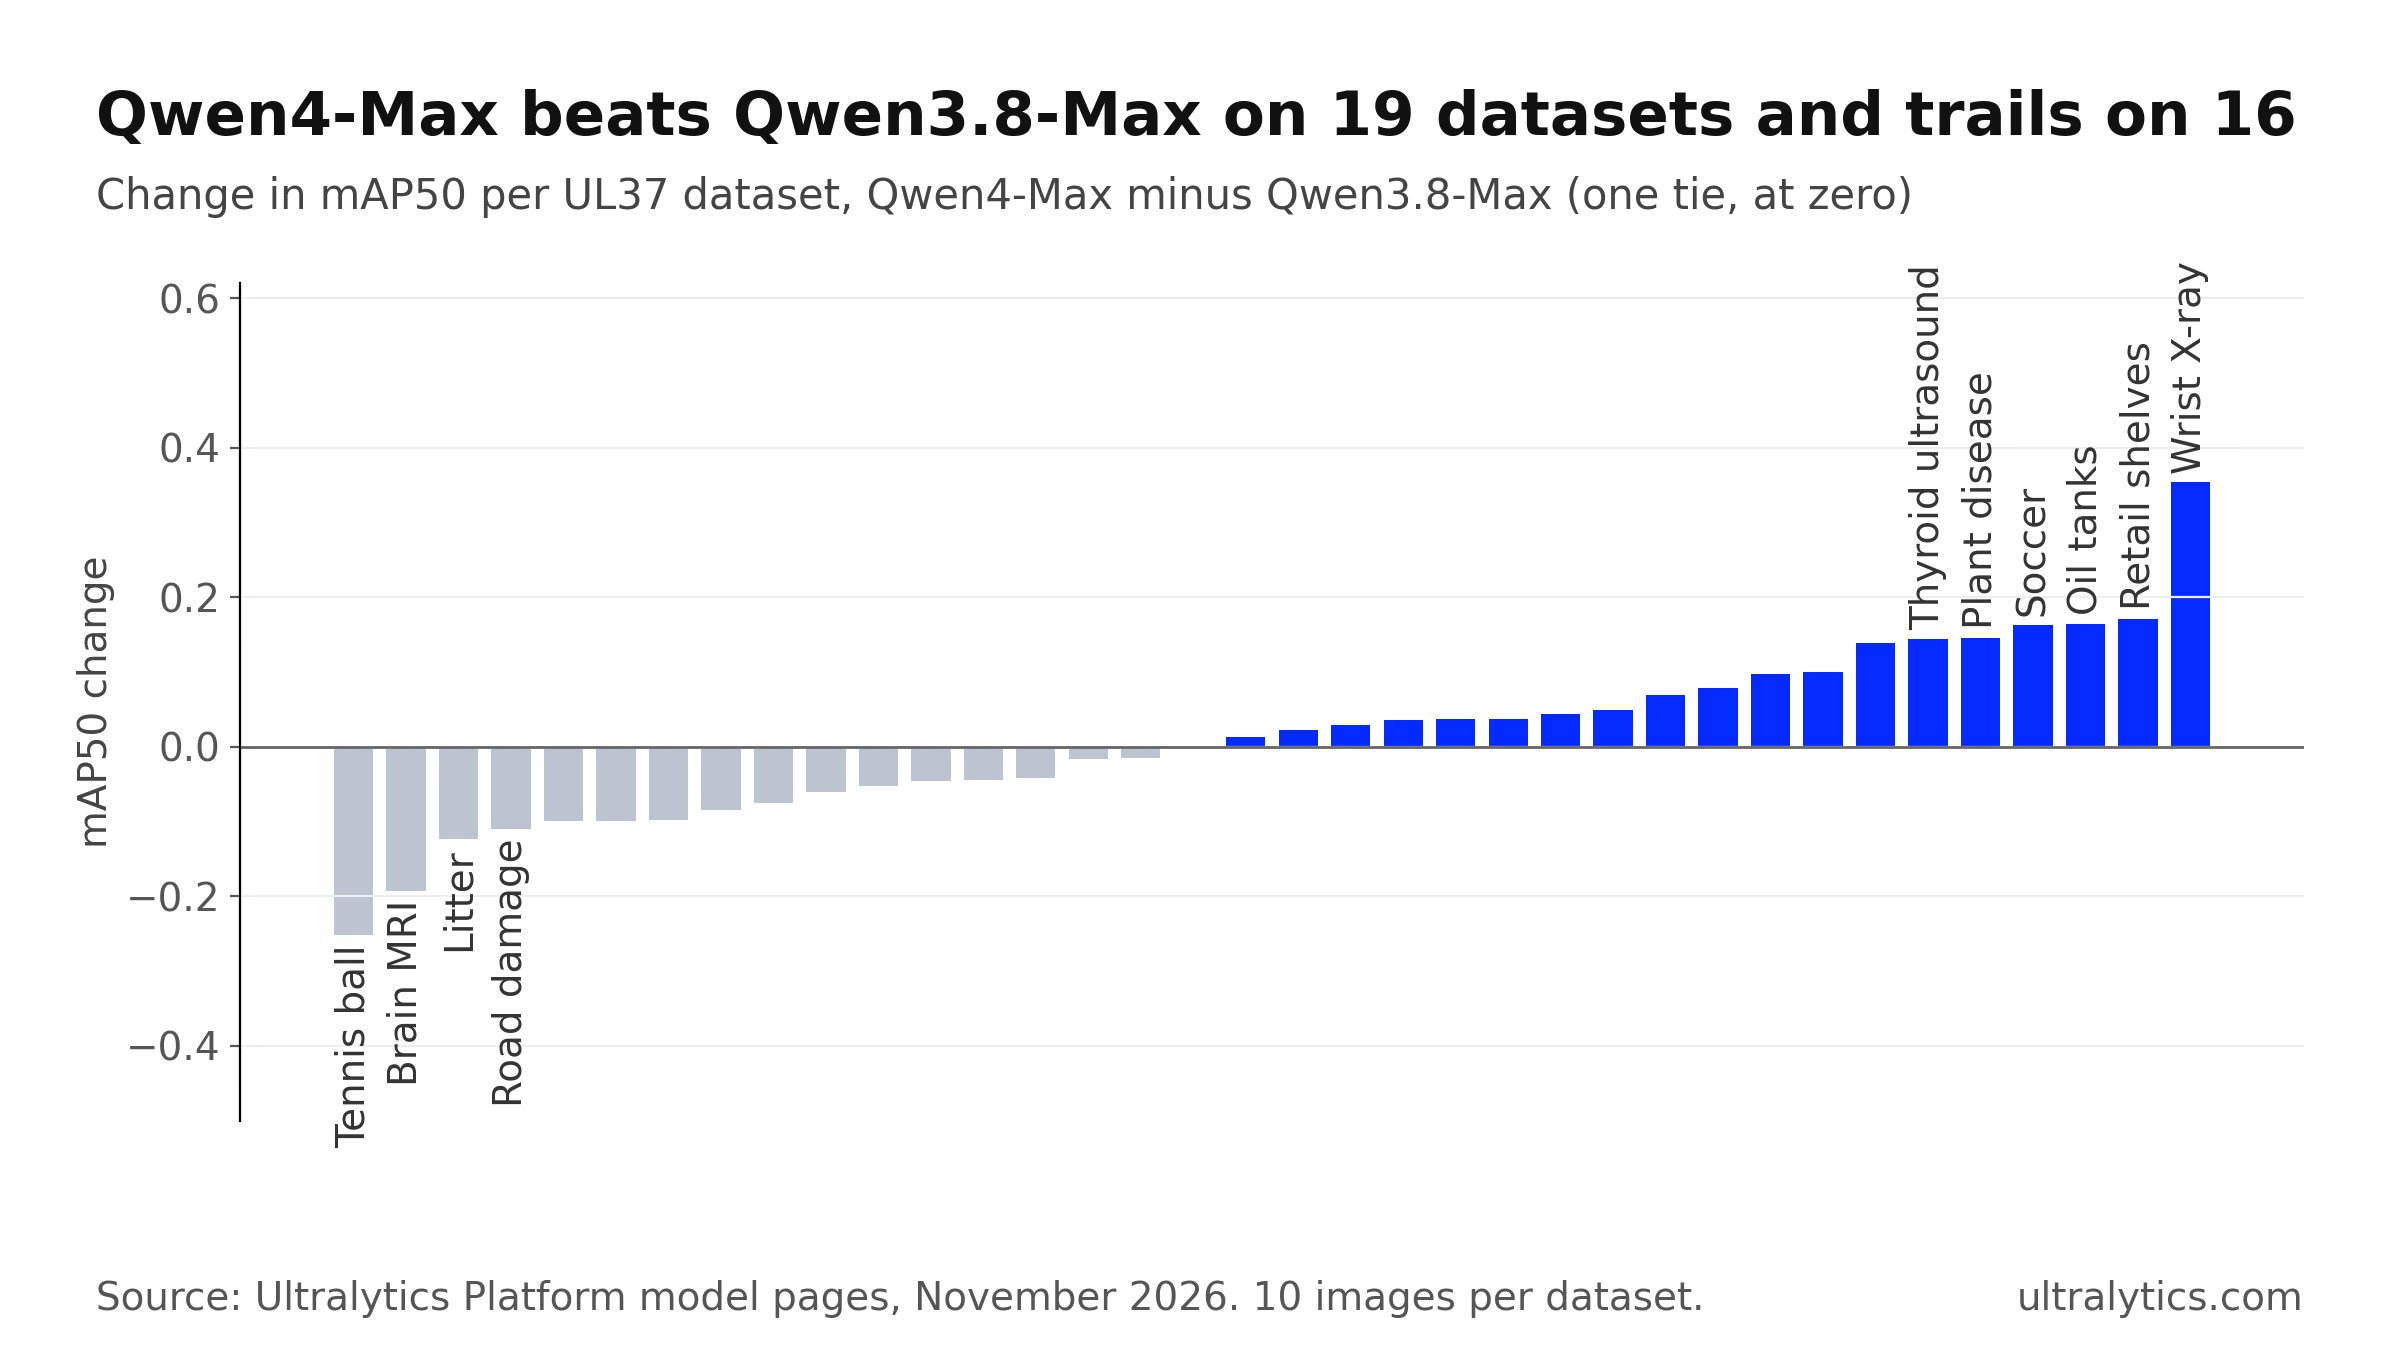
各棒はUL37の1つのデータセットを表し、低下幅の大きい順から向上幅の大きい順に並んでいます。
| データセット | Qwen4-Max | Qwen3.8-Max | 変化量 |
|---|---|---|---|
| GRAZPEDWRI-DX小児の手首のX線画像 | 0.4975 | 0.1437 | +0.3538 |
| SKU110K商品が密集した小売店の棚 | 0.6230 | 0.4516 | +0.1714 |
| Airbus石油貯蔵タンク | 0.3005 | 0.1363 | +0.1642 |
| SoccerDBサッカー | 0.8345 | 0.6715 | +0.1630 |
| RacketVisionテニスボール | 0.3775 | 0.6299 | −0.2524 |
| Cheng脳腫瘍のMRI画像 | 0.4421 | 0.6350 | −0.1929 |
UL37のデータセット別mAP50。各10枚の画像を使用し、各変化量が2つのスコアと一致するよう小数点以下4桁で表示しています。
コストの低下はさらに明確です。当社の実行では、Qwen4-Maxは1,000枚あたり5.68ドルで、7.74ドルのQwen3.8-Maxより画像あたり約27%低コストでした。Alibabaが示す約60%という数値は、異なる設定の別のベンチマークに基づいているため、直接比較はできません。
Qwen4-Maxが優れている点#
次の3つの結果により、Qwen4-MaxはQwenファミリー内だけでなく、リーダーボード全体でも上位に位置しています。
| データセット | Qwen4-Max | 51モデル中の順位 | トップモデル |
|---|---|---|---|
| GRAZPEDWRI-DXの小児の手首のX線画像 | 0.4975 | 1st | Qwen4-Max(次点:Muse Ember 1.0、0.378) |
| RUOD水中の物体 | 0.774 | 2nd | Gemini 4 Carbon、0.788 |
| SKU110Kの商品が密集した小売店の棚 | 0.623 | 2nd | Gemini 4 Carbon、0.671 |
UL37のデータセット別mAP50。Ultralytics VLMリーダーボードに掲載された全51モデル中の順位です。
手首のX線画像。小児の手首の外傷を写したX線画像で、Qwen4-Maxは0.4975を記録しました。これは、これまでにテストしたすべてのモデルを上回り、Qwen3.8-Maxの3倍を超えるスコアです。各データセットの画像数は10枚なので、結論ではなく、テストする価値のある強いシグナルとして捉えてください。また、この結果は診断や臨床的な検証を意味するものではありません。医用画像解析の研究用アノテーションでは、Qwen4-Maxでボックスの下書きを作成し、臨床の専門家が確認・修正できます。
小売店の棚。UL37の小売関連2データセットの平均で、Qwen4-Maxは0.752を記録し、GPT-6.1 Terraの0.724を上回りました。商品が端から端まで詰まり、クラスが1つだけのSKU110Kでは、Gemini 4 Carbonに次ぐ2位です。
水中シーン。RUODの水中物体データセットで0.774を記録し、51モデル中2位となりました。GPT-6.1 Terraの0.658を上回っています。
Qwen4-Maxの弱点#
強みと同じくらい、弱点も明確です。Qwen4-Maxは、基板むき出しの欠陥を扱うDeepPCBで0.000、保安検査の画像を扱うIEDXrayで0.05を記録しました。一方、Gemini 4モデルは約0.30に達しています。結核の胸部X線画像では0.037で、脳腫瘍MRIデータセットではGPT-6.1 Terraに0.442対0.904で後れを取っています。
分野別の平均でも、Qwen4-Maxは文書、UI、CAD図面(0.357対0.494)、道路と交通(0.396対0.572)、医用画像全般(0.325対0.505)でGPT-6.1 Terraを下回っています。これらの分野で大規模なデータセットにラベル付けする前に、Qwen4-Maxのモデルページを開いてください。各ベンチマークデータセットで記録されたボックスと正解ラベルを並べて確認できます。
Qwen4-MaxとGPT-6.1 Terra、Gemini 3.8 Flash、Kimi K3.1 Proの比較#
| 36のUL37データセットでの直接比較 | Qwen4-Maxの勝利数 | 敗北数 | 引き分け数 |
|---|---|---|---|
| GPT-6.1 Terraとの比較 | 11 | 23 | 2 |
| Gemini 3.8 Flashとの比較 | 17 | 18 | 1 |
| Kimi K3.1 Proとの比較 | 21 | 14 | 1 |
| Qwen3.8-Maxとの比較 | 19 | 16 | 1 |
GPT-6.1 Terraは、総合的により優れた選択肢です。Qwen4-Maxの11データセットに対して23データセットで勝利し、コストも低く、応答時間の中央値は半分未満です。Gemini 3.8 Flashは、同程度の価格でデータセット別の勝敗がほぼ互角ですが、平均スコアはより高くなっています。Kimi K3.1 Proとの比較では、Qwen4-Maxは画像あたり約4分の1のコストで、21データセット対14データセットで勝利しています。
Ultralytics PlatformでのQwen4-Maxの実行方法#
PlatformでのQwen4-Maxの結果には、2つの設定が影響します。1つ目は、Alibabaのデフォルト設定である「high」ではなく、推論レベル「low」で実行することです。Ultralyticsがベンチマーク画像370枚(スコア対象の360枚とCOCOの参照画像10枚)でテストしたところ、「high」では11件、「low」では3件がPlatformの115秒のリクエスト上限に達しましたが、mAP50は同じでした。2つ目は、Qwenモデルに簡潔なJSON出力を要求することです。これを指定しないと、mAP50が約0.02低下します。
どちらの設定もユーザー側で操作する必要はありません。モデル選択メニューでQwen4-Maxを選ぶと、Platformが両方を適用します。
Qwen4-Maxのアノテーションバッチのコスト#
プロバイダー料金は、Alibabaが報告するトークン使用量にPlatformのモデル別料金を適用して算出したもので、アノテーションに成功した画像1,000枚あたりの金額です。実際の画像では、トークン使用量がこれより多くなることも少なくなることもあります。Batch Annotationでは、画像1,000枚あたり1.00ドルのPlatform処理手数料が加算され、1回の実行あたり最低0.01ドルがかかります。
| 画像1,000枚あたり | Qwen4-Max |
|---|---|
| Alibabaへの支払い | $5.68 |
| Ultralytics Platformの処理料金 | $1.00 |
| 合計 | $6.68 |
テスト予測の実行分を含め、Alibabaにはご自身のAPIキーを使って直接支払います。Ultralyticsがトークン料金に上乗せすることはありません。有料キーをまったく使いたくない場合は、ホスト型のQwen3.8 27BをキーなしでPlatform上で実行できます。UL37でのmAP50は0.351です。
Ultralytics PlatformでQwen4-Maxの自動アノテーションを実行する方法#
Qwen4-Maxは、1~200クラスの検出データセット向けのクラスプロンプト型モデルです。データセット独自のクラス名でバウンディングボックスを出力し、その後、ユーザーが確認・修正します。
- Alibaba CloudのModel StudioでAPIキーを作成し、Platformが使用する国際向け(シンガポール)リージョンを選択します。
- ワークスペースの所有者に、データセットを保存しているワークスペースの設定 > APIキーで、Alibabaの下にAPIキーを追加してもらいます。詳細はプロバイダーキーのドキュメントをご覧ください。
- アノテーションエディターでSmartモードに切り替え、モデル選択メニューのAlibabaからQwen4-Maxを選択します。
- Predictを押すか、データを代表する数枚の画像で
Pを実行します。 - 結果に問題がなければ、データセットページを開き、More actions > Batch Annotationを選択して、未ラベルの画像すべてにラベルを付けます。Batch Annotationは、画像チャンネルが最大3つのPlatformホスト型データセットに対応します。Platformは先にデータセットのバージョンを保存するため、必要に応じて元に戻せます。
- ボックスを確認して保存し、同じワークスペースで結果を使ってUltralytics YOLO26モデルをトレーニングします。
アノテーションのドキュメントではSmartモードとBatch Annotationについて詳しく説明しています。また、適合率と再現率に基づいてVLMを選ぶガイドは、モデルをレビューのワークフローに合わせる際に役立ちます。
Qwen4-Maxを使うべきユーザー#
| 必要なものが… | まずは次から |
|---|---|
| 汎用の有料アノテーションモデルを探している場合 | GPT-6.1 Terra:UL37スコアが高く、コストが低く、Qwen4-Maxより高速 |
| 専門家による確認を前提に、小児の手首のX線画像の下書きを作成する場合 | Qwen4-Max:このデータセットでUL37の51モデル中最高スコア |
| 商品が密集した小売店の棚や水中シーンを扱う場合 | Qwen4-Maxを使い、手元の画像でGemini 4 Carbonと比較してください |
| Alibabaのモデルを使いたい場合、またはQwen3.8-Maxから移行する場合 | Qwen4-Max:より高いスコア、画像あたりの低コスト、当社の実行ではリクエスト失敗なし |
| 有料APIキーを使えない場合 | Platformでホスト型のQwen3.8 27B、Gemma 4 26B、またはSAM 3.1 Textを利用できます |
ほとんどのラベリング作業では、引き続きGPT-6.1 Terraがより適切なデフォルトの選択肢です。Qwen4-Maxは、データが得意なデータセットに似ている場合に有力な候補となるため、まず手元の画像サンプルでテストしてください。
よくある質問
ベンチマークでは51モデル中13位で、特に優れた結果を示すデータセットもいくつかあります。UL37ベンチマークでは、リクエスト失敗なしで0.474 mAP50を記録し、51モデル中13位となりました。小児の手首のX線画像では51モデル中1位、水中の物体と商品が密集した小売店の棚では2位ですが、回路基板の欠陥と保安検査のX線画像ではスコアが低くなっています。
平均では、はい。Qwen4-Maxは0.474 mAP50を記録し、Qwen3.8-Maxの0.461を上回っています。1,000枚あたりのコストは5.68ドルで、Qwen3.8-Maxの7.74ドルより低く、Qwen3.8-Maxが1.7%のリクエストに失敗したのに対し、すべてのリクエストを完了しました。ただし、向上幅にはばらつきがあり、19のデータセットでQwen3.8-Maxを上回る一方、16で下回りました。テニスボールと脳MRIの検出では大幅に低下しています。
一般的なラベリングでは、GPT-6.1 Terraは0.560 mAP50を記録し、36個のデータセットのうち23個でQwen4-Maxを上回ります。料金は画像1,000枚あたり4.36ドルで、応答時間の中央値は5.1秒です。手首のX線画像、商品が密集した小売店の棚、水中シーンなど、最も得意とするデータセットに自分のデータが似ている場合はQwen4-Maxを選び、必ず自分の画像で確認してください。
研究用アノテーションのボックス案を作成でき、専門家が確認できますが、診断は行いません。小児の手首X線画像では、51モデル中で最も高いUL37スコアの0.4975 mAP50を記録しますが、8つの医療データセット全体の平均は0.325で、GPT-6.1 Terraの0.505を下回り、胸部X線画像では低いスコアです。
Alibabaへの支払いは約5.68ドルです。Alibabaが報告するトークン使用量に、モデルのPlatform料金を適用した金額で、アノテーションが正常に完了した画像1,000枚あたりの費用です。Alibabaの海外向け公開価格は、入力トークン100万個あたり1.50ドル、出力トークン100万個あたり4.50ドルです。Ultralytics Platformでは、画像1,000枚あたり1.00ドルのBatch Annotation料金が加算され、合計は約6.68ドルです。
Alibaba Cloud Model Studioの海外向けAPIキーを作成し、ワークスペースのオーナーにSettings > API KeysのAlibaba欄へキーを追加してもらいます。その後、アノテーションエディターのSmartモードでQwen4-Maxを選択してください。数枚の画像でテストしてからBatch Annotationを実行し、ボックスを確認して、同じワークスペースでUltralytics YOLO26モデルをトレーニングします。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









