GPT-6.1 Terra, 자동 어노테이션에서 OpenAI의 플래그십 모델을 제치고 1위 차지
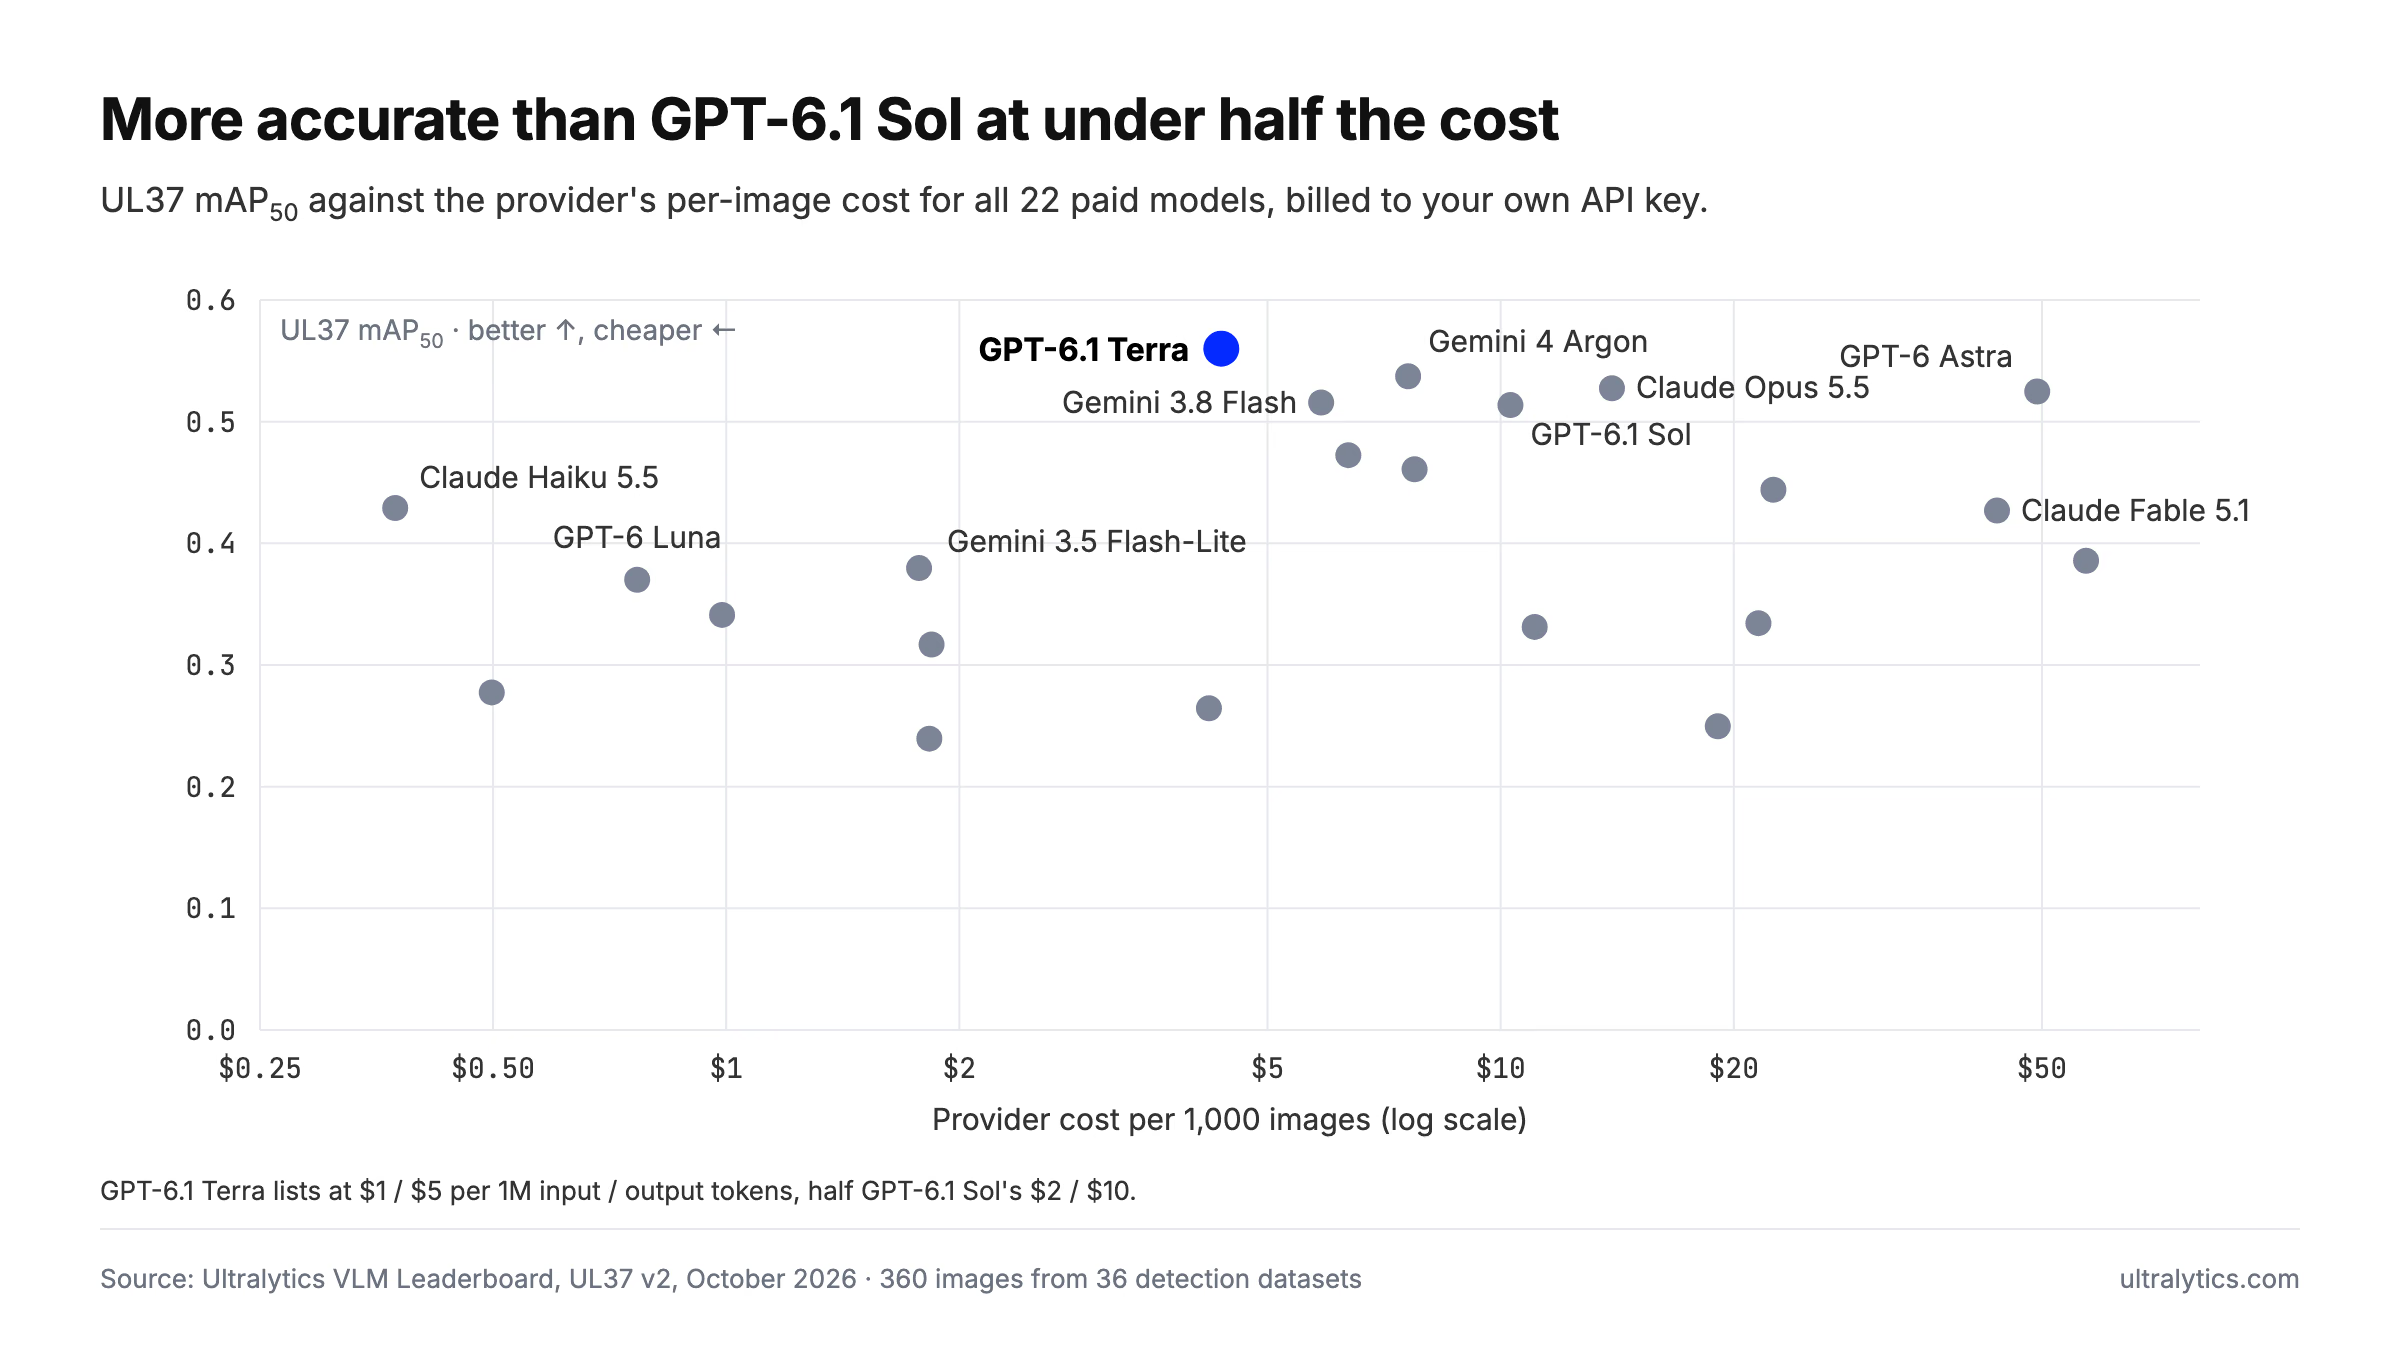
GPT-6.1 Terra의 자동 어노테이션이 VLM Leaderboard에서 39개 모델을 제치고 1위를 차지했습니다. 이미지 1,000장당 $4.36의 비용으로 0.560 mAP50을 기록해 GPT-6.1 Sol과 Gemini 4 Argon을 앞섰습니다.
OpenAI의 출시 자료에 따르면 GPT-6.1 Terra는 시각적 추론에서 더 큰 형제 모델에 거의 근접합니다. 바운딩 박스를 그리도록 요청해 보니, "거의"는 적절한 표현이 아니었습니다.
OpenAI가 GPT-6.1 Terra를 출시한 2026년 10월 26일, UL37을 사용해 자동 어노테이션 성능을 평가했습니다. UL37은 36개 데이터셋으로 구성된 객체 탐지 벤치마크입니다. GPT-6.1 Terra는 0.560 mAP50을 기록해 VLM Leaderboard의 39개 모델 중 최고 성적을 거뒀습니다. OpenAI의 중간 가격대 모델은 GPT-6.1 Sol, 플래그십 GPT-6 Astra, 그리고 이번 주까지 1위를 지키던 Gemini 4 Argon을 앞섰습니다.
이미지 1,000장당 $4.36, 이미지당 5.1초의 비용과 속도로 이 성적을 거뒀으며, 요청 실패는 한 건도 없었습니다. 오늘 바로 Ultralytics Platform에서 사용할 수 있습니다. 아래에서는 이 모델이 뛰어난 부분과 약한 부분, 그리고 라벨링 워크플로에 도입할지 결정하는 방법을 살펴봅니다.
GPT-6.1 Terra, UL37에서 1위 차지#
UL37은 모델의 박스가 사람의 라벨과 얼마나 일치하는지 측정합니다. 의료 스캔, 항공 이미지, 소매점 진열대, 스포츠, 문서, 회로 기판 등 실제 객체 탐지 데이터셋 36개에서 각각 이미지 10장씩, 총 360장을 사용합니다. 각 이미지는 Platform 사용자가 이용하는 것과 동일한 프로덕션 파이프라인을 거치며, 데이터셋의 클래스명을 그대로 사용하고 SAM 3.1로 모든 박스를 정밀하게 조정합니다. 평가 방법론은 공개되어 있습니다.
Terra의 성적표는 다음과 같습니다.
- mAP50: 0.560, 39개 모델 중 1위
- mAP50-95: 0.345로 역시 1위입니다. 이는 박스가 대략적으로만 맞는 것이 아니라 정확하게 들어맞는다는 뜻입니다.
- 정밀도 및 재현율: 0.646 및 0.613
- 제공업체 비용: 이미지 1,000장당 $4.36
- 이미지당 중앙값 처리 시간: 5.1초
- 요청 실패: 없음
UL37에서 0.51을 넘는 모델은 6개이며, Claude Opus 5.5가 3위입니다. Terra는 이 6개 모델 중 정확도가 가장 높고 비용도 가장 저렴합니다.
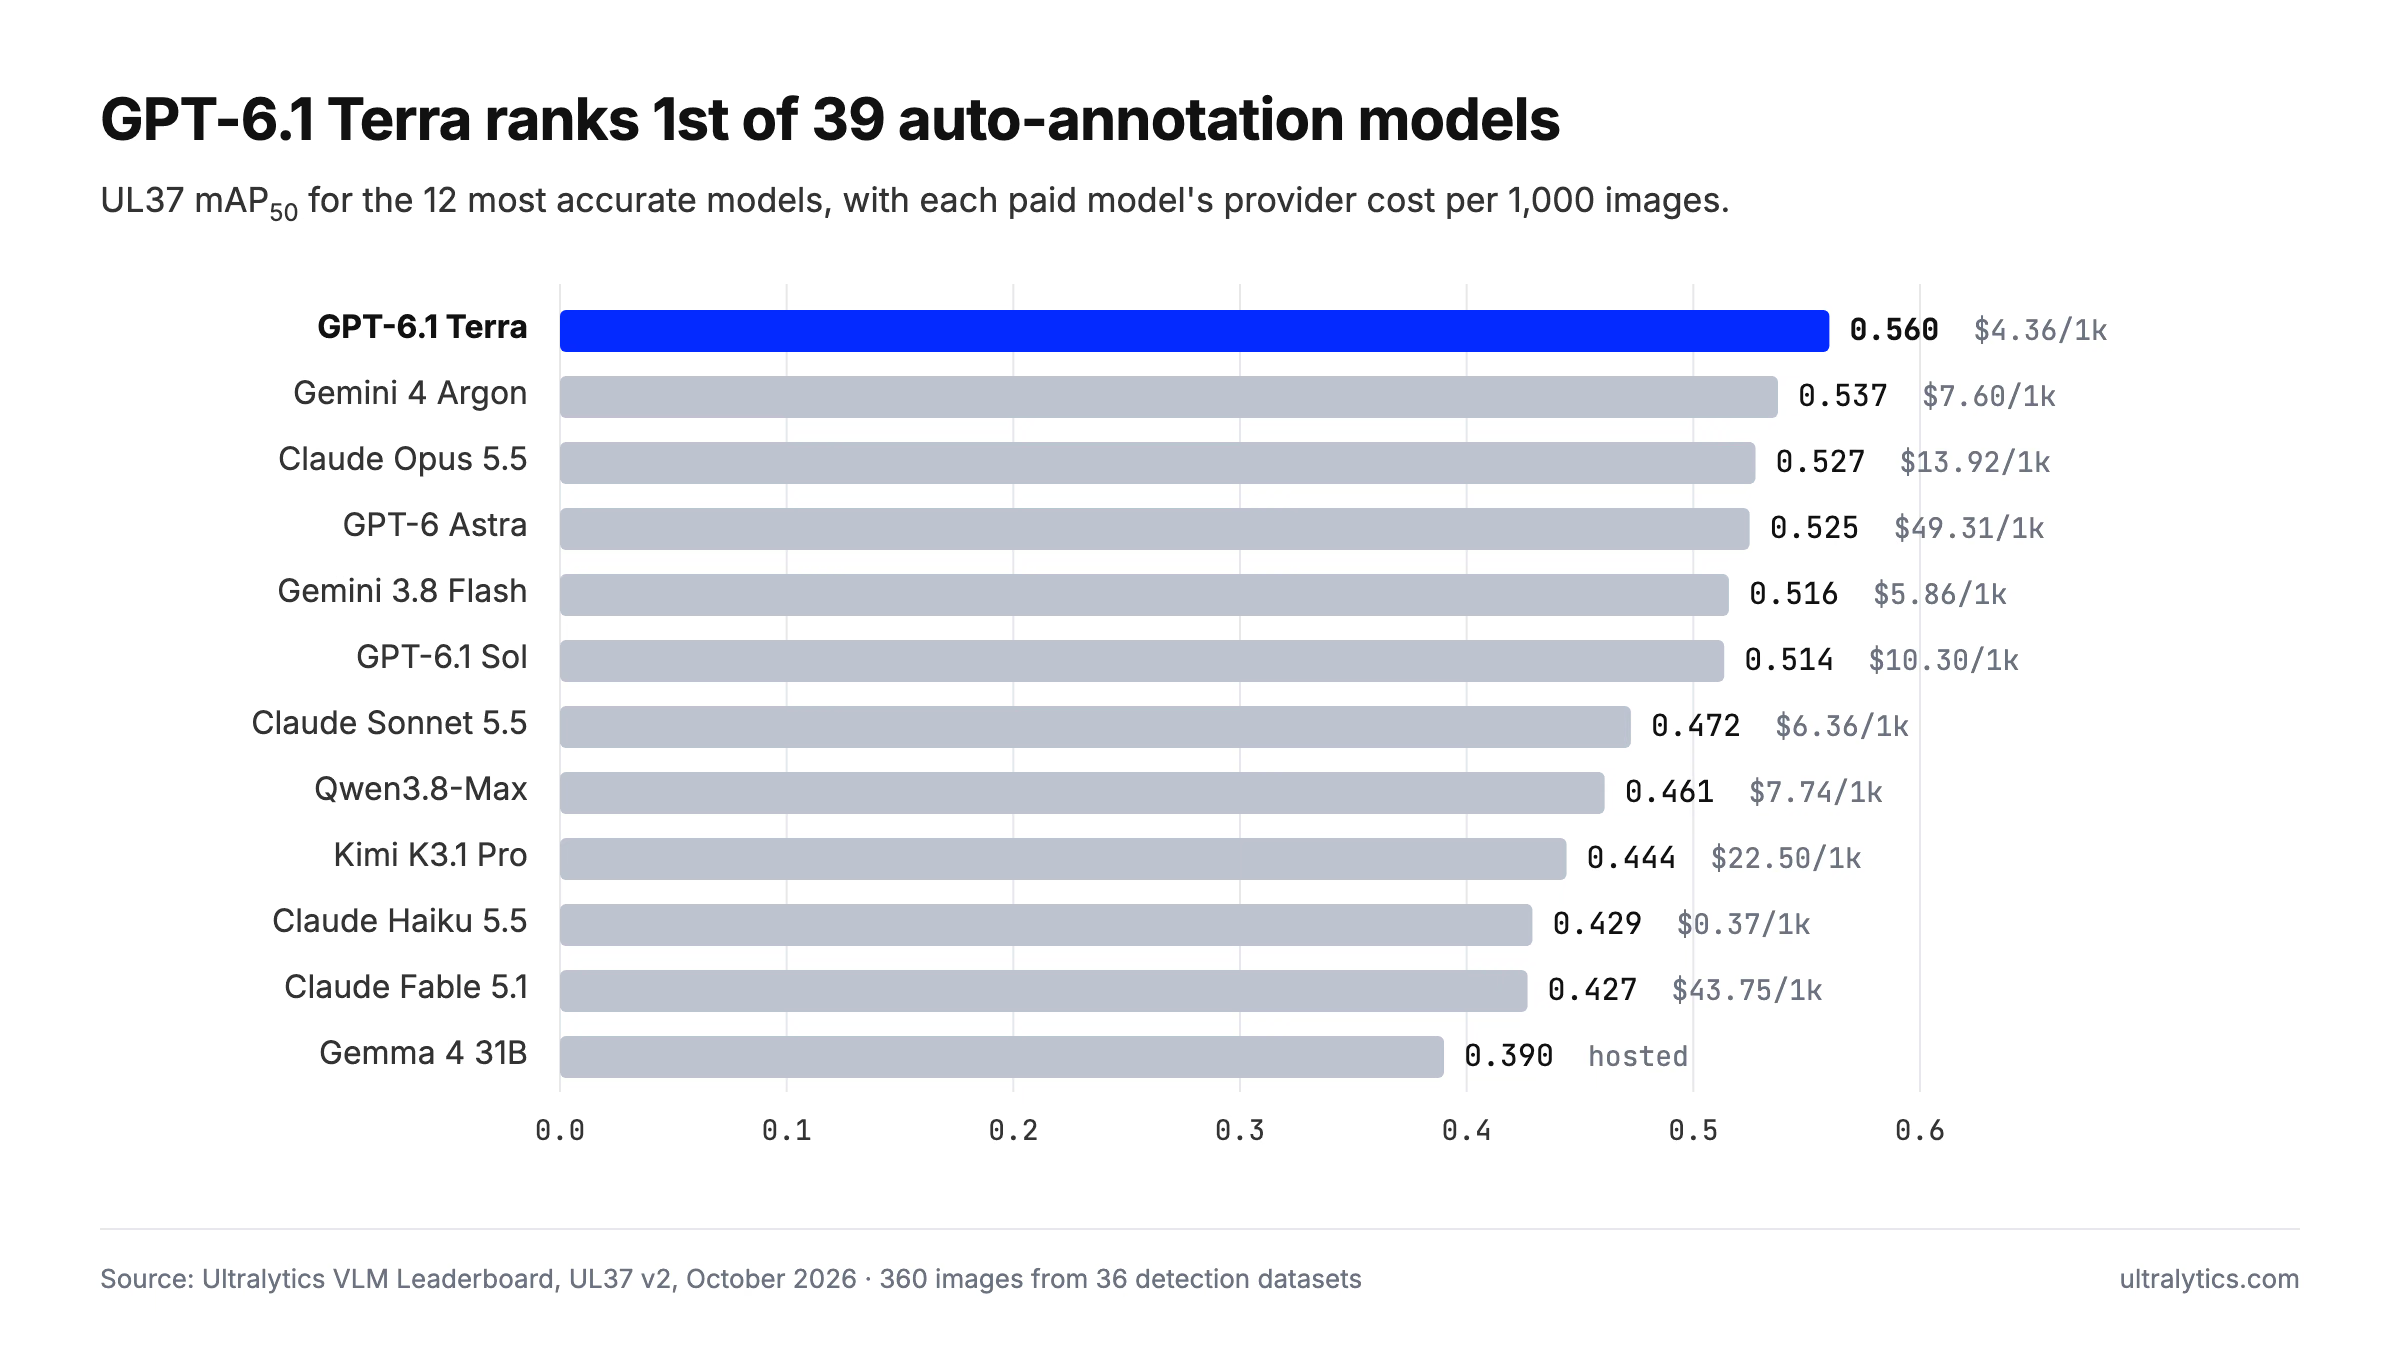
이 결과를 얻기 위해 복잡한 튜닝을 거치지 않았습니다. Terra는 OpenAI의 기본 추론 수준으로 실행되며, 모델 문서에는 이 설정이 중간으로 명시되어 있습니다. Platform의 다른 OpenAI 모델과 동일한 요청을 받고, 박스 좌표는 0–1000 그리드로 출력합니다. 모델을 연결하자마자 곧바로 1위에 올랐습니다.
OpenAI 플래그십 모델보다 높은 점수를 기록한 중간 가격대 모델#
OpenAI는 GPT-6.1 Terra를 라인업의 빠르고 효율적인 중간 모델로 소개합니다. The Decoder와 BleepingComputer의 출시 보도에 따르면, 이 모델은 GPT-5.6 Terra의 후속 모델이며 컴퓨터 사용, 시각적 추론, 코딩, 일상 업무를 대상으로 합니다. API에서 gpt-6.1-terra로 제공되며, Plus, Pro, Enterprise, Edu 사용자는 ChatGPT Work와 Codex에서도 사용할 수 있습니다. OpenAI 문서에서는 이 모델을 "시각적 추론, 정밀한 컴퓨터 사용, 명확하고 자연스러운 글쓰기를 위한 빠르고 효율적인 모델"이라고 설명하며, 텍스트 및 이미지 입력과 1,050,000토큰 컨텍스트 윈도우를 지원합니다.
가격은 입력 토큰 100만 개당 $1, 출력 토큰 100만 개당 $5이며, 캐시된 입력은 $0.05입니다. 이는 GPT-6.1 Sol의 $2 및 $10의 절반이며, GPT-6 Astra의 $10 및 $50의 10분의 1입니다. 자세한 내용은 OpenAI의 GPT-6.1 Sol 및 GPT-6 Astra 페이지를 참조하세요.
OpenAI의 출시 벤치마크에서는 Terra가 더 큰 형제 모델을 능가하기보다는 그에 근접한 성능을 낸다고 소개합니다. 시각적 추론 테스트인 MMMU-Pro에서 OpenAI는 Terra가 Astra와 Sol에 거의 근접한다고 보고합니다. Terminal-Bench 4.0에서는 GPT-5.6 Terra의 21.5%에서 상승한 50.3%를 기록했다고 보고합니다. 또한 가장 어려운 코딩 작업에는 여전히 Sol 또는 Astra를 권장합니다.
수치만 보면 Terra는 절충형 모델입니다. 하지만 자체 벤치마크에서는 OpenAI 최고의 탐지 모델입니다.
| OpenAI 모델 | UL37 mAP50 | 이미지 1,000장당 비용 | 이미지당 중앙값 처리 시간 |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1초 |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra의 이미지당 비용은 GPT-6.1 Sol의 절반 미만이고 GPT-6 Astra의 10분의 1 미만입니다. 응답 속도도 두 모델보다 약 2배 빠릅니다. 직접 비교했을 때 Terra는 36개 데이터셋 중 22개에서 Sol을 앞섭니다.
OpenAI는 에이전트 워크로드를 기준으로 Terra가 Sol과 Astra보다 작업을 3배 이상 빠르게 완료한다고 주장합니다. 어노테이션은 다른 작업이며, 이 경우 측정된 속도는 Sol보다 약 2배 빠릅니다. 이미지 수천 장을 라벨링할 때는 이 차이도 상당합니다.
Terra의 Sol 대비 강점은 정밀도입니다#
두 모델은 라벨링된 객체를 비슷한 비율로 찾아냅니다. Terra의 재현율은 0.613, Sol은 0.618입니다. 차이는 정밀도에서 벌어집니다. Terra는 0.646, Sol은 0.551입니다. Terra의 박스는 실제 객체를 올바른 라벨과 함께 가리키는 비율이 훨씬 높습니다.
SKU110K에서는 차이가 확연히 드러납니다. 이 데이터셋의 이미지에는 제품이 가장자리까지 빼곡하게 진열된 슈퍼마켓 선반이 담겨 있으며, 클래스는 하나뿐입니다. 두 모델의 재현율은 비슷해 Terra가 0.73, Sol이 0.77입니다. 하지만 선반 이미지에서 Sol의 정밀도는 0.49인 반면 Terra는 0.79입니다. Sol의 박스는 약 절반이 오탐인 데 비해 Terra는 약 5개 중 1개만 오탐입니다. Terra가 SKU110K에서 기록한 0.62 mAP50은 어떤 모델보다도 높은 점수입니다.
데이터 라벨링에서는 오류마다 수정 비용이 다르기 때문에 이 차이가 중요합니다. 제품 하나를 놓치면 박스 하나를 그리면 됩니다. 잘못된 박스가 생기면 올바른 박스 수십 개 사이에서 찾아 삭제해야 합니다. 오탐이 적으면 검토자에게 더 깔끔한 초안을 제공할 수 있습니다.
의료 영상은 GPT-6.1 Terra의 두드러진 강점입니다#
Terra의 결과에서 가장 두드러지는 특징은 의료 분야입니다. UL37에는 의료 데이터셋 8개가 포함되어 있으며, Terra는 이 데이터셋 전반에서 평균 0.505 mAP50을 기록해 39개 모델 중 1위입니다. 그다음은 Gemini 3.8 Flash(0.387)와 Gemini 4 Argon(0.379)입니다. 리더보드에서 다른 어떤 모델도 다른 분야에서 이보다 큰 격차로 앞서지 못했습니다.
다음은 의료 데이터셋 8개 모두에서 Terra가 기록한 점수와 각 데이터셋에서 나머지 38개 모델 중 최고 점수를 비교한 결과입니다.
| 데이터셋 | GPT-6.1 Terra | 그 밖의 최고 모델 |
|---|---|---|
| 갑상선 초음파(TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| 뇌종양 MRI(Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| 혈구 현미경 이미지(TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| 대장 용종 내시경(Kvasir-SEG) | 0.71 | Gemini 4 Argon을 포함한 7개 모델 공동 1위, 0.81 |
| 소아 손목 X선(GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| 흉부 X선, 결핵(TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| 망막 병변(DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| 치과 X선(DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
표의 상위 세 행이 전체 결과를 이끌며, 이 세 데이터셋은 단순히 위치를 찾는 것만으로 해결되지 않습니다. TN5000에서는 각 박스에 데이터셋의 양성 또는 악성 결절 라벨도 지정해야 하며, 이는 임상의가 확인해야 하는 유형의 판단입니다. Gemini 4 Argon은 여기서 0.29, GPT-6.1 Sol은 0.53을 기록합니다. 뇌 MRI 클래스는 수막종, 신경교종, 뇌하수체 종양이며, Sol은 여기서 0.52를 기록합니다. 혈구 데이터셋에서는 Terra가 백혈구, 적혈구, 혈소판을 분류해야 합니다.
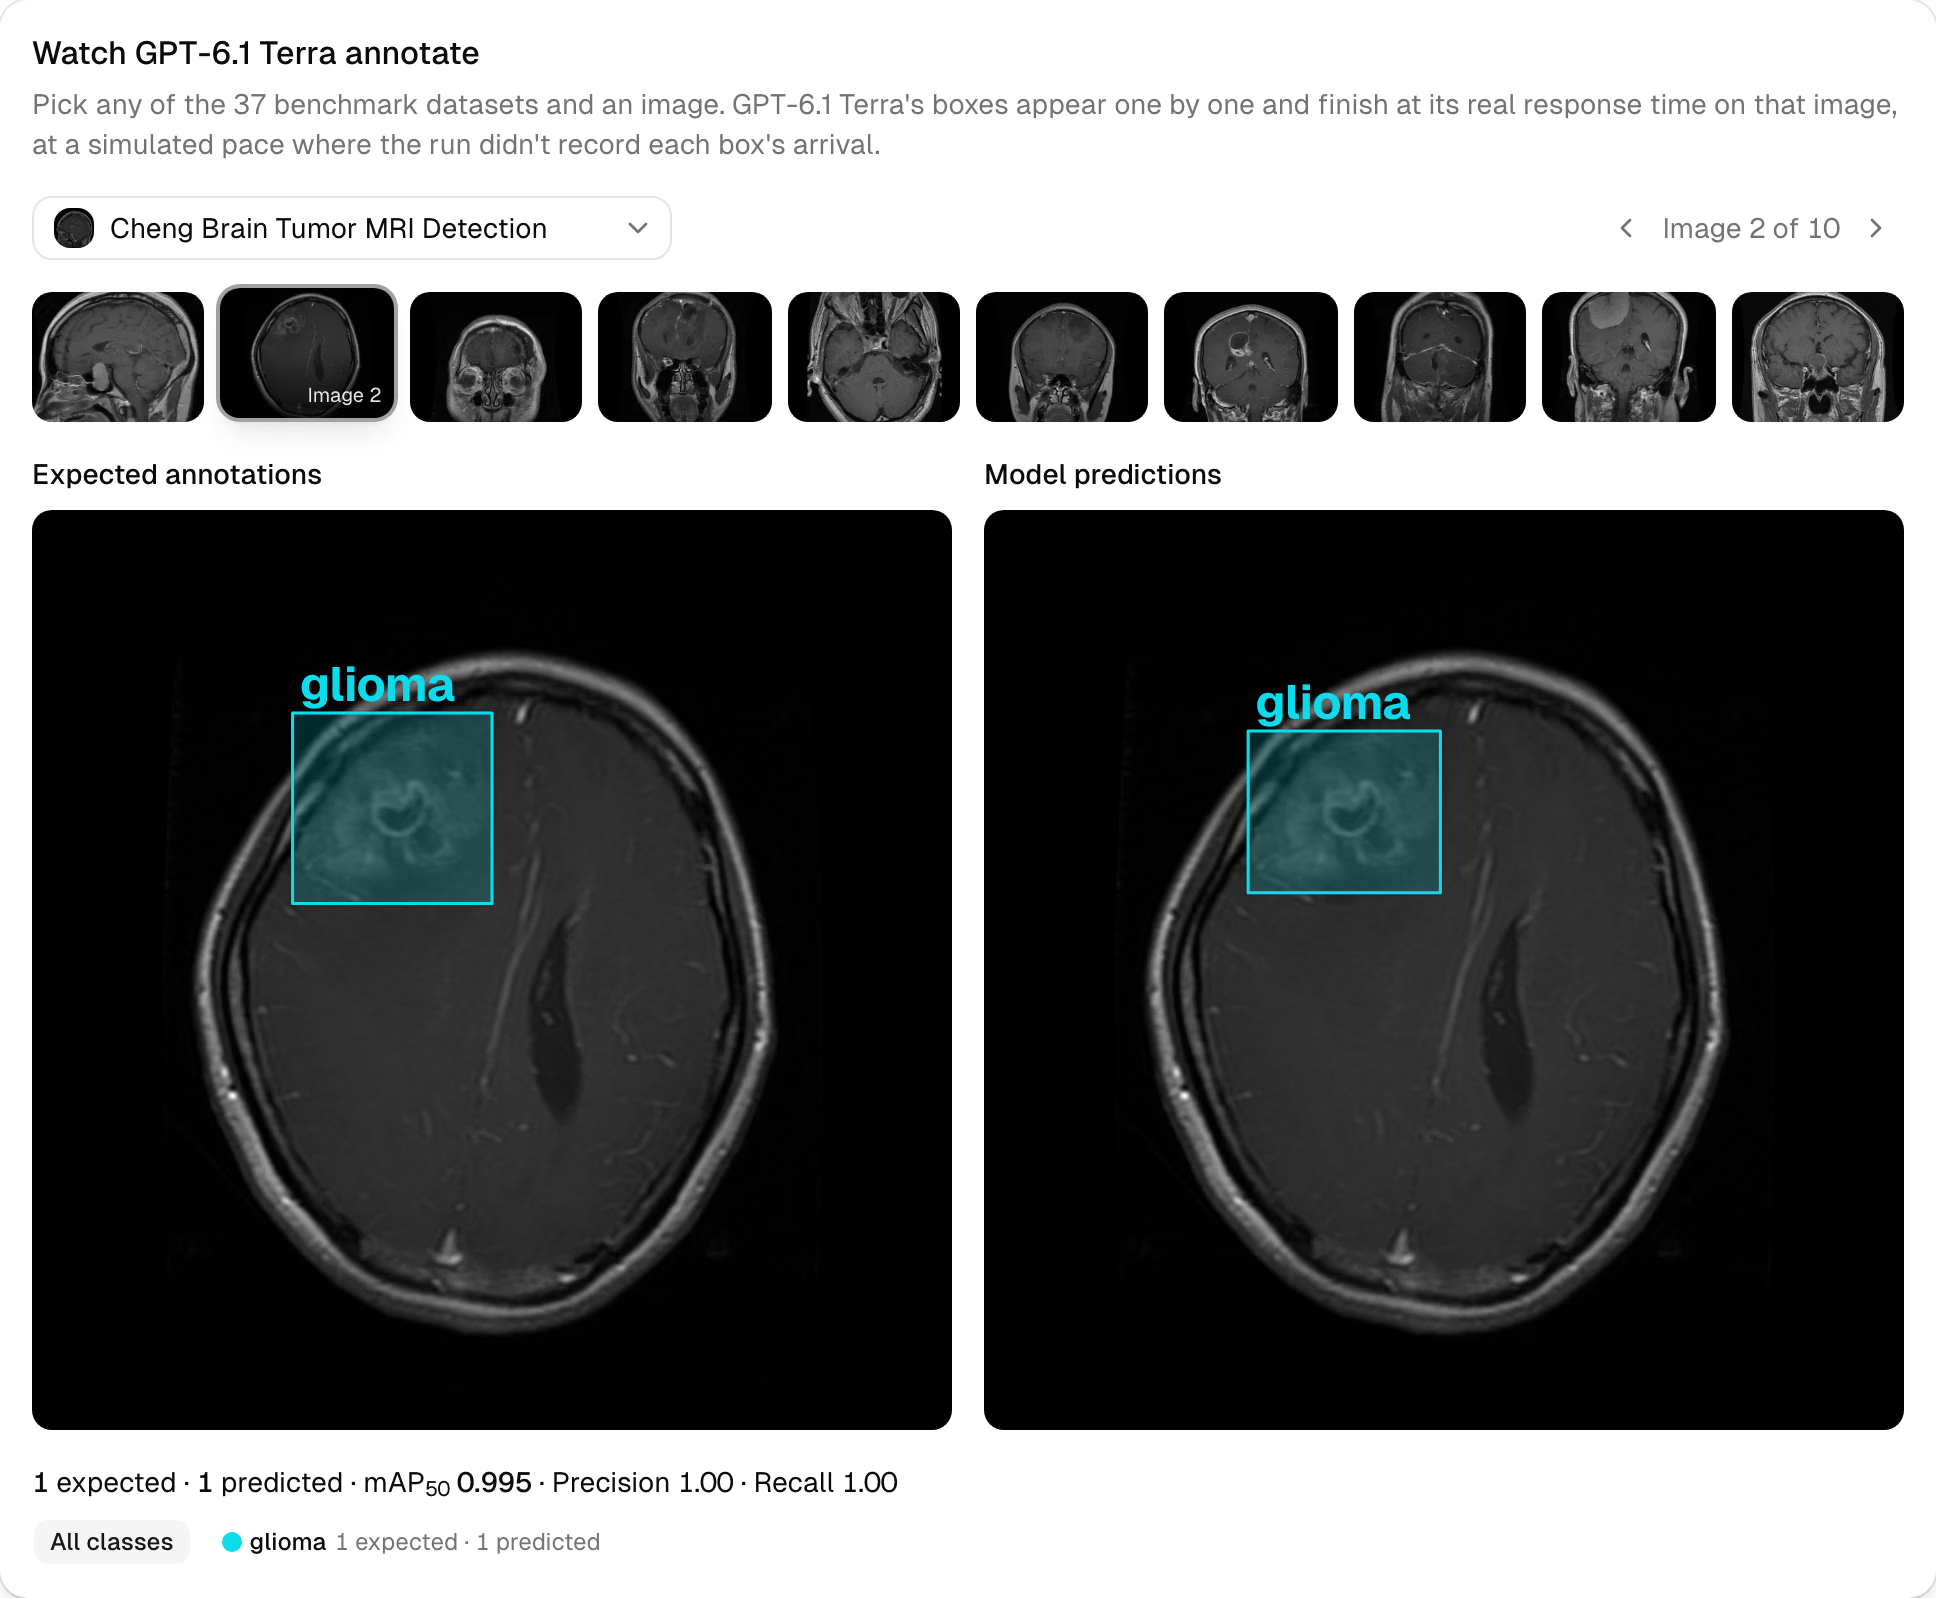
위 화면은 Terra 모델 페이지에서 재생한 사례로, 일반적인 성공 사례를 보여줍니다. 뇌 MRI의 신경교종 하나에 대해 Terra가 박스 하나를 예측해 정답 어노테이션과 일치하도록 배치하고 라벨링했습니다.
이 수치와 함께 두 가지 유의사항을 고려해야 합니다. 첫째, 각 데이터셋에서는 이미지 10장만 사용하므로 단일 데이터셋 점수는 결론이 아니라 추가로 살펴볼 신호입니다. 둘째, 이 결과는 진단을 의미하지 않습니다. 의료 영상 분석 팀은 Terra를 사용해 초음파, MRI, 현미경 이미지의 박스 초안을 빠르게 작성하고, 임상 전문가가 이를 확인하고 수정한 뒤 승인할 수 있습니다. 휴먼 인 더 루프 검토는 선택 사항이 아니라 워크플로의 핵심입니다.
GPT-6.1 Terra의 약점: X선과 회로 기판#
표의 하위 항목은 뚜렷한 경향을 보여줍니다. UL37에 포함된 모든 X선 데이터셋에서는 의료 분야인지 여부와 관계없이 다른 모델이 더 나은 성능을 냅니다. Terra는 소아 손목, 흉부, 치과 X선에서 선두 모델에 뒤처지며, 보안 검색용 X선에서는 성적이 더 나쁩니다. IEDXray에서 0.00을 기록한 반면 Gemini 4 Argon은 0.30을 기록했습니다.
IEDXray에서 가장 큰 실패를 보였습니다. 이 스캔에는 노트북, 휴대전화, 호출기, 배터리, 사제 장치가 담겨 있지만 Terra는 어느 이미지에서도 정확한 박스를 생성하지 못했습니다.
회로 기판도 또 다른 취약 영역입니다. Terra의 산업용 PCB 데이터셋 평균 점수는 0.13인 반면 GPT-6.1 Sol은 0.39입니다. 단선, 단락, 마우스 바이트, 돌기 등 베어 보드 결함을 다루는 DeepPCB에서 Terra는 0.03, Sol은 0.39를 기록했습니다. PCB 검사 데이터에는 Sol이 더 나은 OpenAI 모델입니다.
이 분야에서 대규모 데이터셋에 라벨을 지정하기 전에 GPT-6.1 Terra 모델 페이지를 확인하세요. 이 페이지에서는 36개 벤치마크 데이터셋과 COCO에 대해 Terra가 기록한 박스를 정답 박스와 나란히 재생하고 각 데이터셋의 점수를 보여줍니다.
GPT-6.1 Terra와 Gemini 4 Argon 비교: 순위가 보여주는 것보다 더 팽팽한 경쟁#
Terra가 등장하기 전까지 Gemini 4 Argon이 리더보드 1위를 지켰으며 두 모델의 성능은 비슷합니다. Terra는 19개 데이터셋에서 더 높은 점수를, Argon은 16개 데이터셋에서 더 높은 점수를 기록했고, 한 데이터셋에서는 동률입니다.
Terra의 0.023점 우위 중 상당 부분은 한 데이터셋에서 나옵니다. TN5000 갑상선 초음파에서 Terra는 0.94, Argon은 0.29를 기록합니다. 이 데이터셋을 제외하면 평균 점수는 Terra 0.549, Argon 0.544로 사실상 비슷합니다. Terra의 1위는 실제 성과지만, 상당 부분은 의료 영상에서 비롯됩니다.
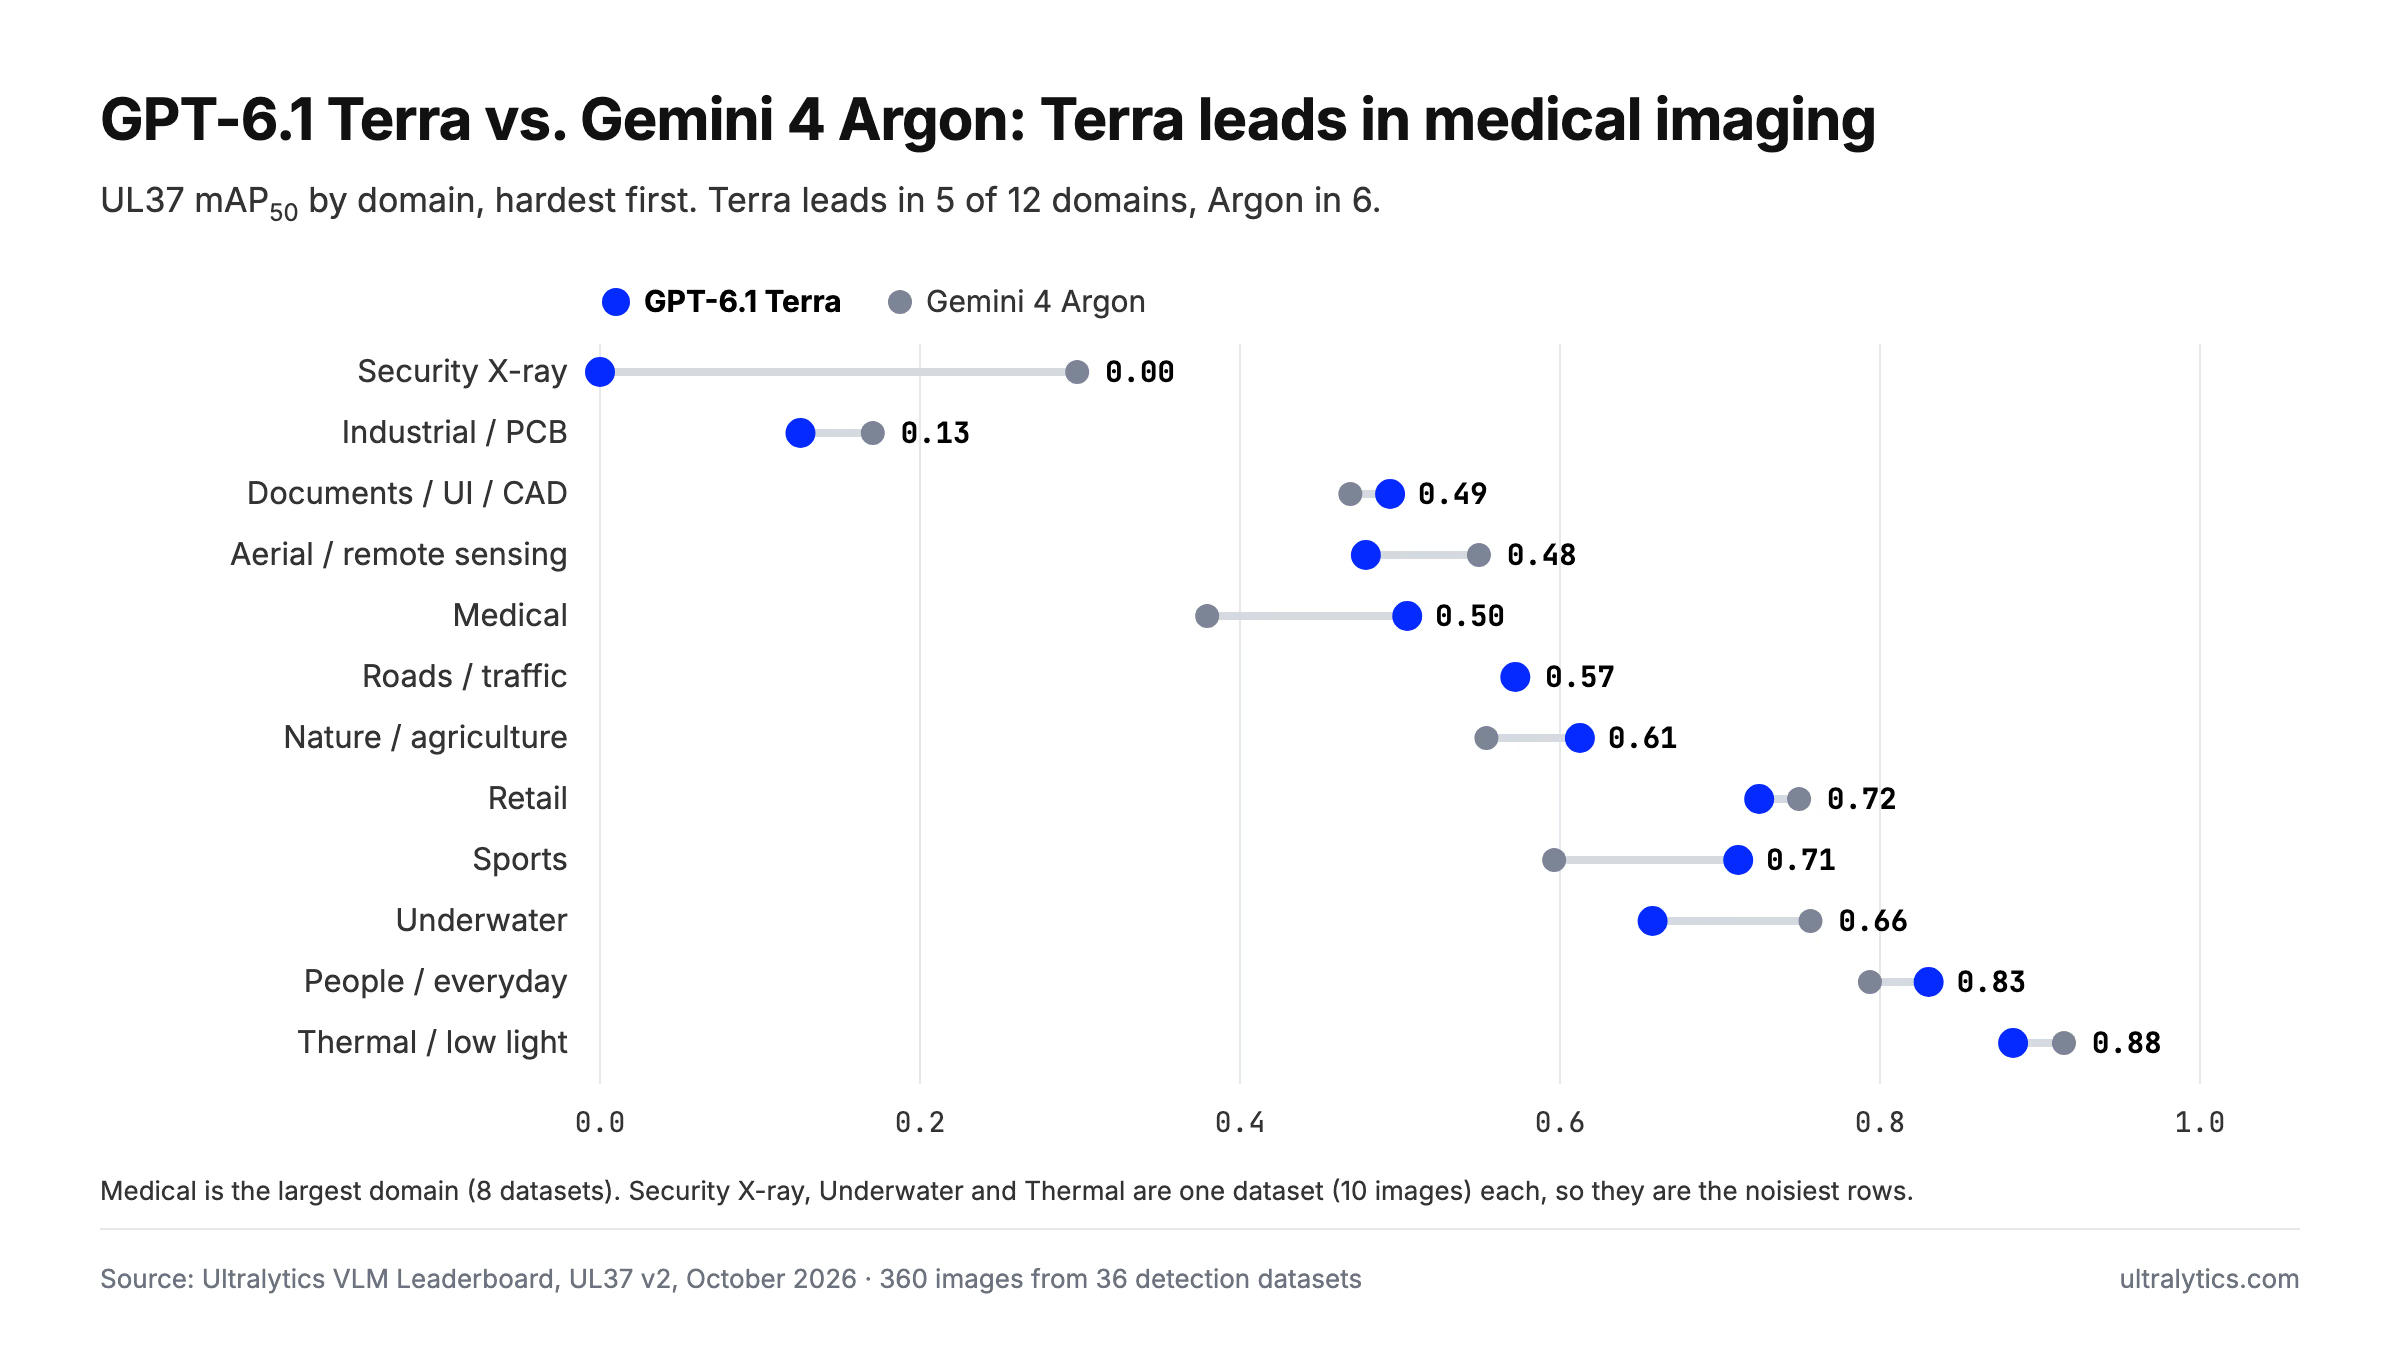
도메인별로 보면 Terra는 5개 분야에서 앞서며, 그중 의료와 문서·UI·CAD 분야에서는 39개 모델 전체 중 1위입니다. Argon은 6개 분야에서 앞서며, 항공·수중·열화상 분야에서는 여전히 1위를 지킵니다. 도로 및 교통 분야에서는 두 모델이 동률입니다.
두 모델은 서로 다른 유형의 오류를 내기도 합니다. Argon은 정밀도가 0.667로 Terra의 0.646보다 약간 높고, Terra는 재현율이 0.613으로 Argon의 0.585보다 높아 더 많은 객체를 찾아냅니다. Google의 출시 가격 기준으로 Terra의 비용은 이미지 1,000장당 $4.36인 반면 Argon은 $7.60입니다. Argon은 이미지당 4.6초로 조금 더 빠릅니다.
실무적인 선택 기준은 다음과 같습니다. 의료, 문서, 스포츠 이미지에는 Terra를 사용하세요. 항공, 수중, 열화상, 보안 이미지에는 Argon을 사용하세요. 자세한 내용은 Gemini 4 Argon 자동 어노테이션 결과에서 Argon의 성능을 확인하세요.
GPT-6.1 Terra로 배치 작업을 실행할 때 드는 비용#
이미지 1,000장당 $4.36은 OpenAI가 보고한 토큰 사용량에 정가를 적용해 계산한 제공업체 비용입니다. 이미지당 중앙값은 입력 토큰 약 1,300개, 출력 토큰 370개였습니다. Batch Annotation에는 이미지 1,000장당 Platform 처리 수수료 $1.00이 추가되므로 이미지 1,000장을 처리하면 총비용은 약 $5.36입니다.
실행 결과에서 확인할 수 있는 세부 사항을 더 살펴보겠습니다.
- 요청 실패 없음. Terra의 벤치마크 요청은 모두 Platform의 115초 제한 시간 안에 완료되었습니다. GPT-6.1 Sol은 이미지 2장에서, GPT-6 Astra는 4장에서 실패했습니다.
- 원본 박스도 이미 정확합니다. SAM 3.1로 정제하기 전 Terra의 박스는 0.559 mAP50을 기록합니다. 정제 후에는 0.560으로 올라가므로, 대부분의 작업을 모델 자체가 수행합니다.
- 설정할 항목이 없습니다. 기본 추론 수준과 표준 OpenAI 요청만으로 충분했습니다.
정확도를 몇 점 더 높이는 것보다 예산이 중요하다면 더 저렴한 대안이 있습니다. Claude Haiku 5.5는 이미지 1,000장당 $0.37의 비용으로 0.429를, Gemini 3.5 Flash-Lite는 $1.77의 비용으로 0.380을 기록합니다. Qwen3.8 27B, Gemma 4 26B, SAM 3.1 Text와 같은 호스팅 모델은 API 키가 전혀 필요하지 않으며, 자체 Ultralytics YOLO 모델도 마찬가지입니다.
OpenAI 키부터 라벨이 지정된 데이터셋까지#
GPT-6.1 Terra는 클래스가 1개에서 200개인 탐지 데이터셋을 대상으로 클래스 프롬프트를 사용하는 모델입니다. 데이터셋의 클래스명에 맞는 바운딩 박스를 반환하며, 사용자는 저장하기 전에 결과를 검토합니다. 설정 방법은 다음과 같습니다.
- OpenAI API 키 페이지에서 키를 생성합니다.
- 데이터셋이 있는 Platform 워크스페이스에서 Settings > API Keys에 키를 추가합니다. OpenAI가 사용자에게 직접 요금을 청구하며 Ultralytics는 토큰에 추가 비용을 부과하지 않습니다. 자세한 내용은 제공업체 키 문서를 참조하세요.
- 어노테이션 에디터에서 Smart 모드로 전환한 뒤 모델 선택기에서 OpenAI 아래의 GPT-6.1 Terra를 선택합니다.
- Predict를 누르거나
P을 입력해 현재 이미지에 라벨을 지정합니다. 대규모 작업을 시작하기 전에 데이터 특성을 대표하는 이미지 몇 장으로 테스트하세요. - 결과가 만족스러우면 데이터셋 페이지에서 More actions > Batch Annotation을 선택해 라벨이 지정되지 않은 모든 이미지에 한 번에 라벨을 지정합니다. Platform은 먼저 데이터셋 버전을 저장하므로 이전 상태로 되돌릴 수 있습니다.
- 박스를 검토하고 저장한 다음, 동일한 워크스페이스에서 결과를 사용해 Ultralytics YOLO26 모델을 학습합니다. 자세한 절차는 학습 문서에 설명되어 있습니다.
이 모델들을 에디터에서 활용하는 방법을 더 자세히 알아보려면 Ultralytics Platform이 AI로 어노테이션을 자동화하는 방법과 비전 언어 모델 입문서를 참조하세요.
GPT-6.1 Terra로 전환하면 좋은 사용자#
일반 객체 탐지 라벨링의 기본 유료 모델로 GPT-6.1 Terra를 선택하세요. 벤치마크한 모델 중 정확도가 가장 높고, 상위 6개 모델 중 비용이 가장 저렴하며, 테스트 중 요청 실패가 한 건도 없었습니다.
전문가 검토를 거칠 초음파, MRI, 현미경 이미지의 초안을 작성하거나 오탐이 빠르게 쌓이는 빽빽한 소매점 진열대를 처리할 때 특히 뛰어난 어노테이션 모델입니다. 모든 종류의 X선 이미지와 PCB 결함에는 다른 모델을 고려하세요. Gemini 4 Argon, GPT-6 Astra 또는 GPT-6.1 Sol이 더 나은 성능을 냅니다.
현재 이미지 라벨링에 Sol 또는 Astra를 사용하고 있다면 전환은 간단합니다. Terra는 Sol 비용의 절반 미만으로 더 나은 박스를 제공합니다.
자주 묻는 질문
네. 자체 UL37 벤치마크에서 GPT-6.1 Terra는 실제 탐지 데이터셋 36개의 평균 점수로 0.560 mAP50을 기록해 Ultralytics VLM Leaderboard의 39개 모델 중 1위를 차지했습니다. 더 엄격한 지표인 mAP50-95에서도 0.345로 1위입니다. 가장 약한 분야는 X선 이미지와 회로 기판 결함입니다.
자체 벤치마크에서는 그렇습니다. Terra는 Sol의 0.514보다 높은 0.560 mAP50을 기록하고, 36개 데이터셋 중 22개에서 앞서며, 이미지 1,000장당 $10.30인 Sol보다 저렴한 $4.36의 비용으로 약 2배 빠르게 실행됩니다. PCB 결함 탐지에는 Sol이 여전히 더 나은 OpenAI 선택지입니다.
Terra는 0.560 mAP50으로 Argon의 0.537보다 앞서며 이미지당 비용도 더 낮지만, 경쟁은 팽팽합니다. Terra는 데이터셋 19개에서, Argon은 16개에서 앞서고 한 곳에서는 동률입니다. TN5000 갑상선 초음파 데이터셋을 제외하면 두 모델은 거의 비슷합니다. 의료 및 문서 이미지에는 Terra를, 항공·수중·열화상·보안 X선 이미지에는 Argon을 선택하세요.
입력 토큰 100만 개당 $1, 출력 토큰 100만 개당 $5의 정가와 제공업체가 보고한 토큰 사용량을 기준으로 OpenAI 요금은 약 $4.36입니다. Ultralytics Platform의 배치 주석 기능에는 이미지 1,000개당 $1.00의 처리 수수료가 추가됩니다. 본인의 API 키를 사용해 OpenAI에 직접 결제합니다.
GPT-6.1 Terra는 8개의 의료 데이터셋에서 가장 우수한 모델로, 평균 0.505 mAP50을 기록했으며 갑상선 초음파, 뇌종양 MRI, 혈구 현미경 검사에서 최고 점수를 기록했습니다. X선 영상에서는 성능이 훨씬 낮고 대장 용종 내시경 검사에서도 뒤처집니다. 전문가 검토용 박스 초안을 작성하는 데 사용하되, 진단 도구로는 절대 사용하지 마세요.
아니요. Platform은 OpenAI의 기본 추론 수준인 medium으로 GPT-6.1 Terra를 호출하고, 모든 OpenAI 모델에 사용하는 것과 동일한 박스 요청을 전달합니다. 그런 다음 SAM 3.1이 각 박스를 보정합니다. 벤치마크에서 요청 처리 시간의 중앙값은 5.1초였으며, 실패한 요청은 없었습니다.









