Melhores modelos de estimativa de profundidade: como escolher
Compare modelos de profundidade monocular, como Depth Anything, Depth Pro, Metric3D, UniDepth e Ultralytics YOLO26, para profundidade métrica, dispositivos de borda e robótica.
A escolha de um modelo de estimativa de profundidade depende de três fatores: se você precisa de distâncias em metros ou apenas de profundidade relativa, onde o modelo será executado e se a licença permite o uso pretendido. Para profundidade relativa e pesquisa, Depth Anything e Marigold são bons modelos para avaliar primeiro. Para profundidade métrica com uma câmera desconhecida, considere Depth Pro e UniDepth; se você souber a distância focal da câmera, Metric3D v2 e Depth Anything 3 Metric também são opções. Para hardware de borda, considere primeiro Depth Anything V2 Small e os modelos MiDaS v3.1 Swin2-Tiny e LeViT; em seguida, meça a latência no dispositivo. Para obter profundidade com baixa latência em GPUs NVIDIA junto com outras tarefas Ultralytics YOLO, avalie também a profundidade do Ultralytics YOLO26. Este guia compara nove modelos de profundidade monocular e apresenta um caminho de decisão para escolher um.
Se você está começando nessa tarefa, comece entendendo o que é estimativa de profundidade monocular. Esta página trata da escolha de um modelo.
Profundidade relativa ou métrica: decida isso primeiro#
- A profundidade relativa indica quais pixels estão mais perto ou mais longe, até uma escala desconhecida. É suficiente para compreender cenas, criar efeitos de fundo e ordenar objetos por distância.
- A profundidade métrica fornece distâncias em metros. Você precisa dela para fazer medições, planejar o movimento de um robô ou combinar profundidade com outros sensores.
Os modelos métricos chegam à escala real de maneiras diferentes. Alguns estimam a distância focal da câmera por conta própria, outros precisam que você a forneça e alguns usam uma escala fixa que você calibra para sua câmera. Na prática, a forma como um modelo obtém sua escala pode importar mais do que alguns pontos de precisão em benchmarks. Para saber mais sobre os dois tipos, consulte a entrada do glossário sobre estimativa de profundidade.
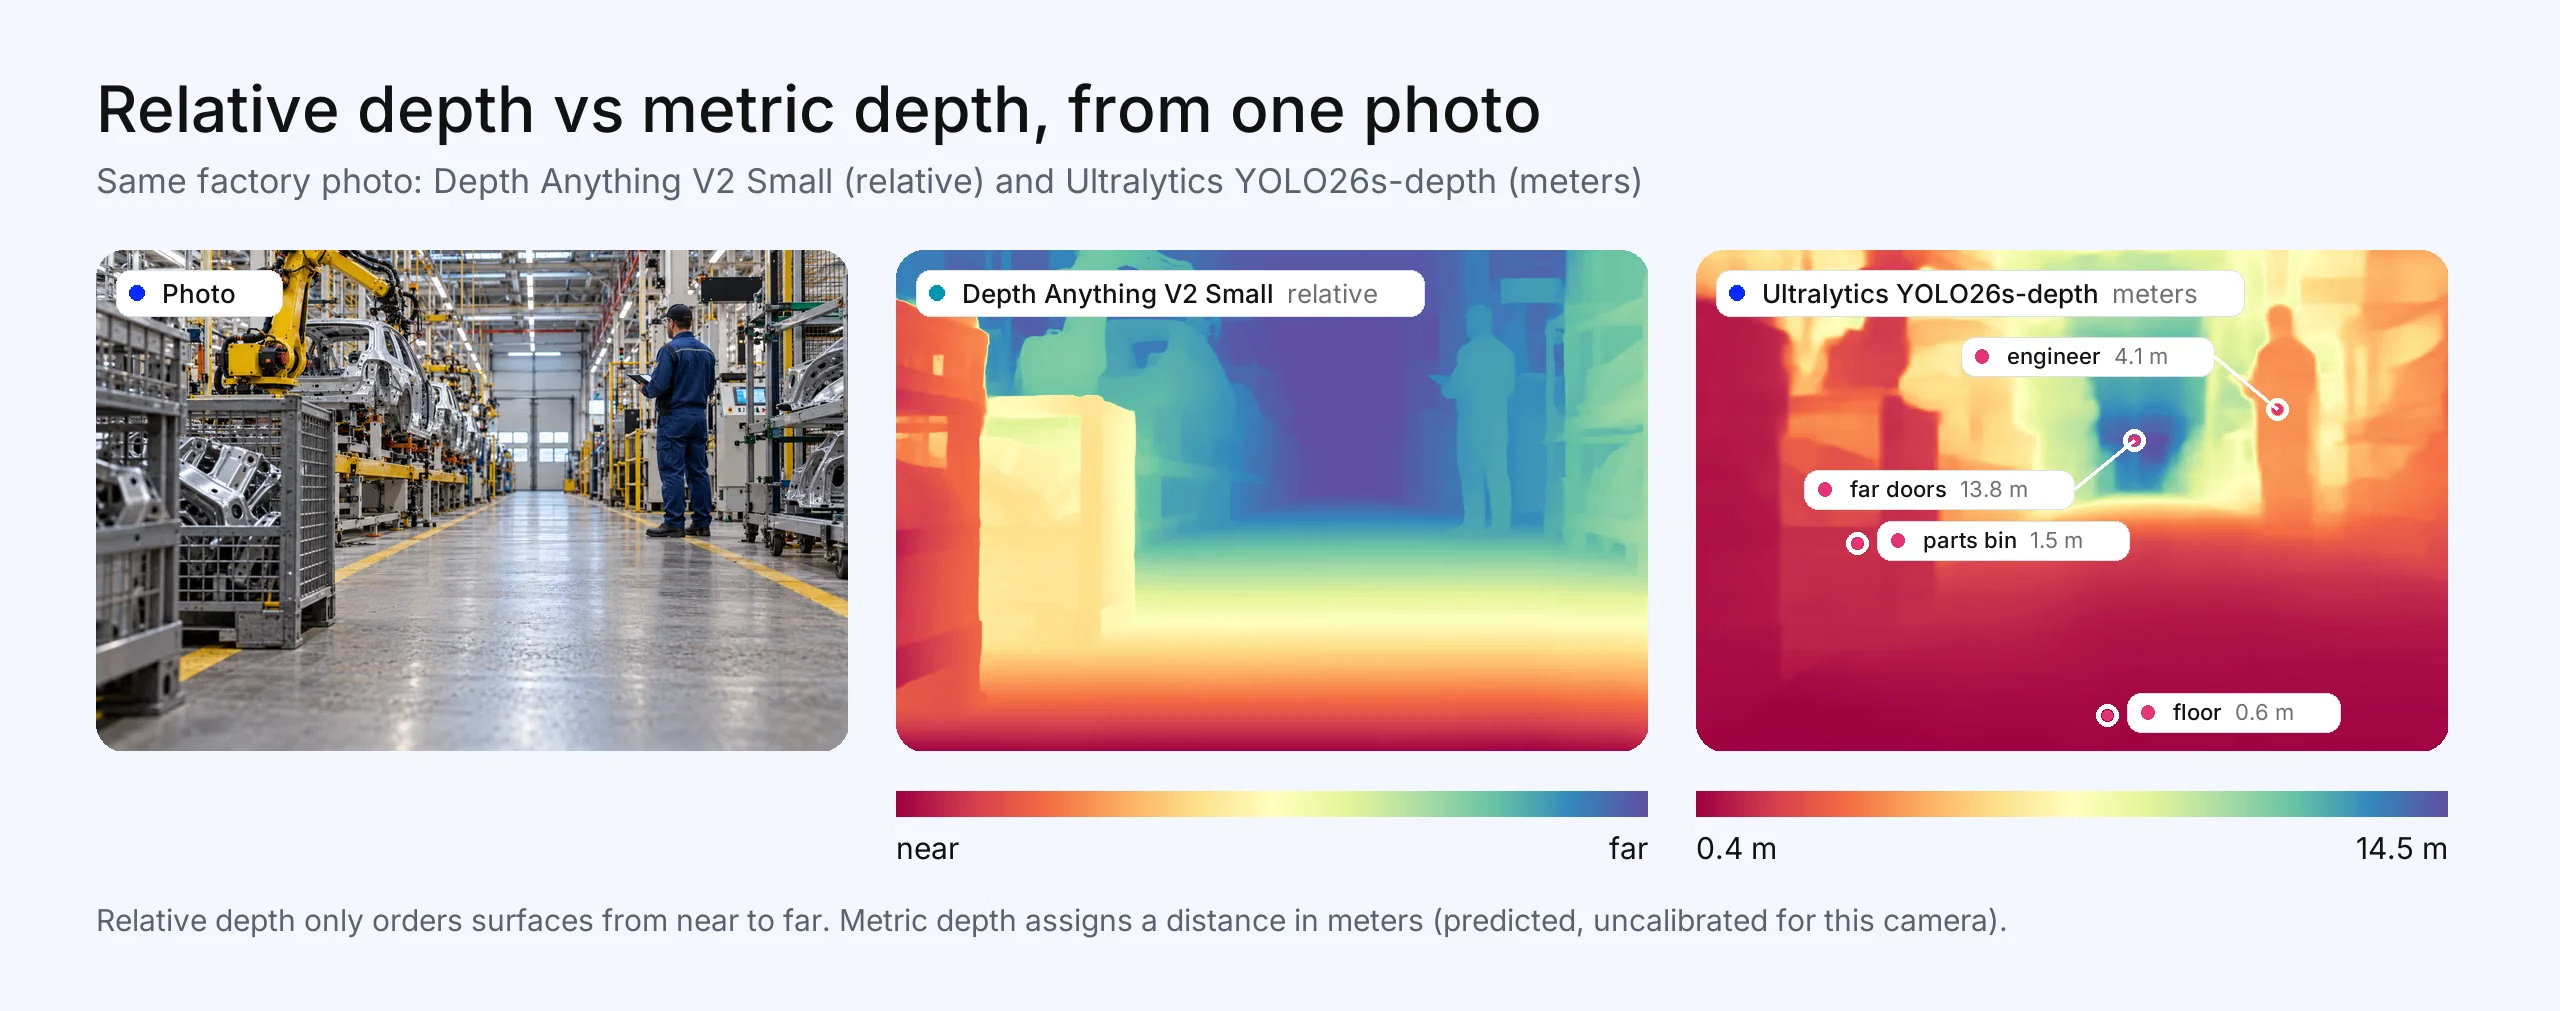
Fig. 1. A mesma foto de fábrica processada pelo Depth Anything V2 Small, que prevê profundidade relativa (mais perto ou mais longe, sem unidades), e pelo Ultralytics YOLO26s-depth, que prevê distâncias em metros: cerca de 1,5 m até o contêiner de peças, 4,1 m até o engenheiro e 13,8 m até as portas ao fundo. A foto foi gerada para este artigo; os dois mapas de profundidade são resultados reais dos modelos. As distâncias são previsões do checkpoint disponibilizado, não calibrado para esta câmera, e não medições.
Comparação de modelos de estimativa de profundidade#
Os modelos estão listados em ordem alfabética, não classificados. Não incluímos valores de precisão entre modelos porque cada artigo usa seu próprio protocolo de benchmark, portanto os resultados não são diretamente comparáveis. As licenças foram verificadas em outubro de 2026 e se aplicam a cada checkpoint.
| Modelo | Saída | Tamanhos | Licença | Ideal para | Principal desvantagem |
|---|---|---|---|---|---|
| Depth Anything 3 | Relativa; métrica com distância focal conhecida (DA3Metric) | De Small, com 0,08B, a Giant, com 1,15B, além de um modelo Nested de 1,40B (conforme listado pelo projeto) | Small, Base, Metric-Large e Mono-Large: Apache 2.0. Large, Giant e Nested: CC BY-NC 4.0 | Geometria multivista e pose da câmera, além de profundidade | Os modelos maiores são para uso não comercial; DA3Metric-Large precisa da distância focal da câmera (o modelo Nested, também não comercial, gera metros diretamente) |
| Depth Anything V2 | Relativa; checkpoints métricos separados para ambientes internos e externos | Small 24,8M, Base 97,5M, Large 335,3M | Small: Apache 2.0. Base e Large: CC-BY-NC-4.0 | Profundidade relativa robusta e de uso geral | Apenas Small tem licença para uso comercial; os checkpoints métricos têm limite de 20 m (ambientes internos) ou 80 m (ambientes externos) |
| Depth Pro (Apple) | Métrica, sem parâmetros intrínsecos da câmera | Um modelo | Licença própria da Apple para código e pesos | Profundidade métrica precisa em fotos de câmeras desconhecidas | Mais pesado que os modelos de borda; verifique os termos da licença para seu uso |
| Marigold | Relativa (invariante a transformações afins) | Baseado em um modelo de difusão latente | Código: Apache 2.0. Modelos: RAIL++-M | Detalhes minuciosos quando a velocidade não importa | Mais lento que os modelos de passagem única, especialmente com ensembles |
| Metric3D v2 | Profundidade métrica e normais de superfície | ViT-Small, ViT-Large, ViT-giant2 | Código: BSD-2-Clause; confira os termos do checkpoint | Profundidade métrica e normais para reconstrução 3D | Precisa de uma distância focal correta para acertar a escala |
| MiDaS | Relativa | v3.1, do BEiT-Large 512 ao Swin2-Tiny 256 e LeViT 224 | MIT | Uma referência conhecida, com licença permissiva e variantes incorporadas | Mais antigo que os modelos fundacionais recentes; o repositório foi arquivado e não é mais mantido |
| Profundidade do Ultralytics YOLO26 | Métrica (metros), com uma escala global única que você pode calibrar | n 6.3M a x 57.0M | AGPL-3.0 ou uma licença Enterprise da Ultralytics | Estimativa de profundidade com baixa latência em GPUs NVIDIA, junto com outras tarefas YOLO | A escala absoluta precisa ser calibrada para sua câmera; não há comparação com outros modelos segundo um protocolo de precisão comum |
| UniDepth V2 | Profundidade métrica e parâmetros intrínsecos da câmera a partir de uma imagem | Backbones ViT-S, ViT-B e ViT-L | CC BY-NC 4.0 | Profundidade métrica quando a câmera é desconhecida | Licença não comercial |
| ZoeDepth | Métrica (cabeças para ambientes internos, externos ou combinados), construída sobre pré-treinamento de profundidade relativa | Baseado em ViT | MIT | Profundidade métrica permissiva para domínios internos ou externos conhecidos | Treinado para domínios internos e externos específicos; o repositório foi arquivado e não é mais mantido |
Como escolher um modelo de estimativa de profundidade#
Responde a estas perguntas pela ordem apresentada:
- Você precisa de metros? Se não, comece com Depth Anything V2 ou Depth Anything 3, ou com MiDaS se quiser uma licença MIT.
- Você conhece os parâmetros intrínsecos da sua câmera? Se não conhecer, escolha um modelo que os estime: Depth Pro ou UniDepth. Se conhecer, Metric3D v2 e Depth Anything 3 Metric podem usá-los.
- Onde ele será executado? Se a latência do servidor não for uma restrição, os grandes modelos fundacionais são uma boa opção. Para estimativa de profundidade com baixa latência em GPUs NVIDIA, junto com outras tarefas YOLO, considere o Ultralytics YOLO26 depth e meça o desempenho no seu dispositivo de borda, como o NVIDIA Jetson. Outras opções incluem Depth Anything V2 Small e os modelos MiDaS v3.1 Swin2-Tiny e LeViT. A latência na CPU depende do processador, do runtime, da resolução de entrada e do modelo. Faça um benchmark da sua configuração exata; a Fig 3 mostra um exemplo com modelos pequenos Ultralytics YOLO26 depth. Consulte a seção sobre dispositivos de borda abaixo.
- Você pode usar a licença? Confira o checkpoint específico. Várias famílias combinam modelos pequenos sob Apache 2.0 com modelos grandes não comerciais.
- Você pode calibrar ou ajustar com fine-tuning? Se puder coletar cerca de 50 a 150 imagens rotuladas da sua própria câmera, com alguns pontos medidos por imagem, teste um modelo calibrado ou ajustado com fine-tuning em comparação com um modelo zero-shot nas suas próprias cenas. Nos testes da Ultralytics com YOLO26s-depth (150 imagens por câmera, 5 pontos medidos por imagem), calibrar dessa forma deixou a escala com uma diferença de cerca de 1% em relação a um ajuste completo com ground truth, em comparação com um desvio de 4% a 46% antes da calibração. Esse valor mede o quão bem a escala foi recuperada, não a precisão geral da profundidade.
Em seguida, teste dois ou três candidatos em imagens da sua própria câmera, na resolução de implantação.
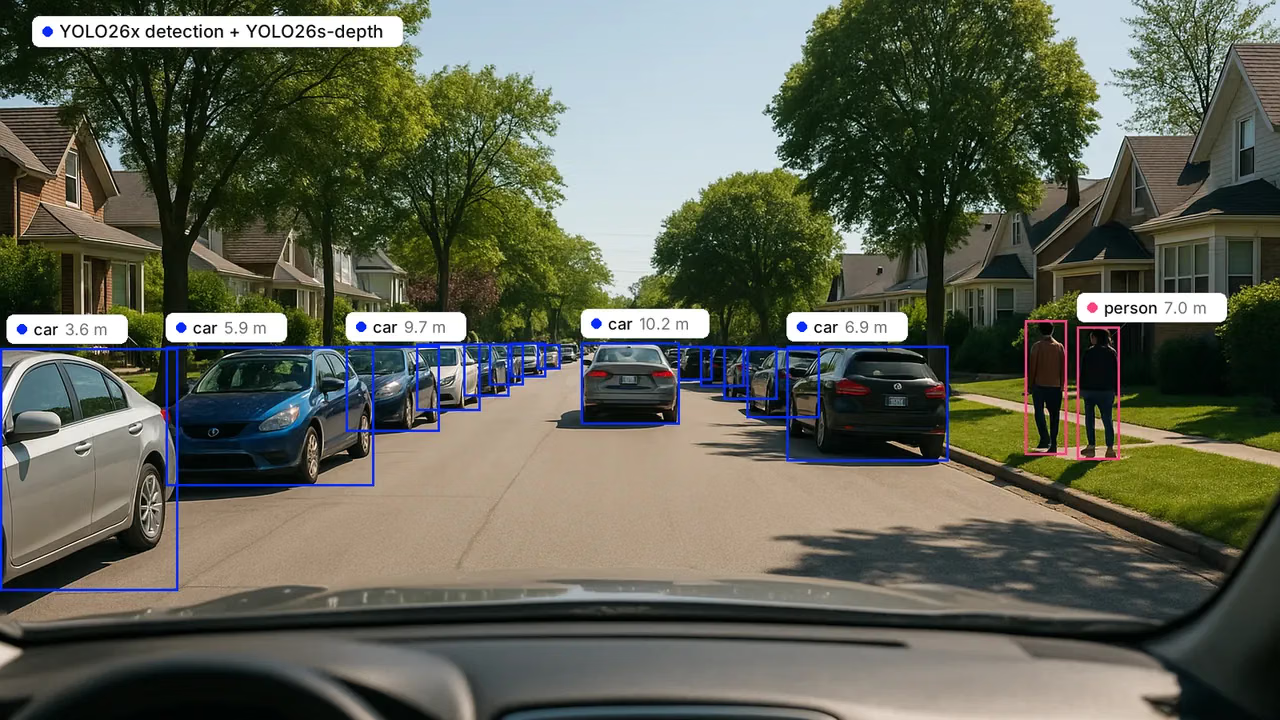
Fig 2. Distância prevista até alguns carros e pessoas detectados, combinando a detecção do Ultralytics YOLO26x com o Ultralytics YOLO26s-depth: 3.6 m até o carro estacionado mais próximo, 6.9 m até o carro à direita e 7.0 m até a pessoa identificada à direita. A foto foi gerada para este artigo; as caixas e as distâncias são resultados reais do modelo, sem calibração para esta câmera. São previsões, não distâncias medidas.
Os modelos em mais detalhe#
Listados por ordem alfabética.
Depth Anything 3#
Depth Anything 3, da ByteDance Seed, amplia o Depth Anything de imagens únicas para qualquer número de vistas. Seus principais modelos estimam a profundidade e a pose da câmera em conjunto, e variantes específicas tratam da profundidade relativa monocular (DA3Mono-Large) e da profundidade métrica monocular (DA3Metric-Large). Saída: profundidade relativa dos modelos principal e Mono; profundidade métrica com uma distância focal fornecida usando o DA3Metric-Large ou diretamente usando o modelo Nested não comercial. Tamanhos: 0.08B (Small) a 1.15B (Giant), além do modelo Nested de 1.40B, conforme indicado nos cartões de modelo do projeto. Licença: Small, Base, Metric-Large e Mono-Large têm licença Apache 2.0; Large, Giant e Nested têm licença CC BY-NC 4.0. Ideal para: cenas com várias vistas e reconstrução 3D. Desvantagem: os checkpoints mais robustos são não comerciais.
Depth Anything V2#
Depth Anything V2 é um modelo aberto amplamente disponível para profundidade relativa, com resultados robustos em cenas internas, externas e incomuns. O projeto também publica checkpoints métricos ajustados com fine-tuning para cenas internas (até 20 m) e externas (até 80 m). Tamanhos: Small 24.8M, Base 97.5M, Large 335.3M. Licença: Small tem licença Apache 2.0; Base e Large têm licença CC-BY-NC-4.0. Ideal para: estimativa de profundidade relativa de uso geral. Desvantagem: se você precisar de uso comercial, ficará limitado ao modelo Small, e os checkpoints métricos não podem prever além da profundidade máxima fixa.
Depth Pro#
Depth Pro, da Apple, prevê profundidade métrica a partir de uma única imagem sem os parâmetros intrínsecos da câmera e estima a distância focal por conta própria. A Apple informa que o modelo gera um mapa de profundidade de 2.25 megapixels em 0.3 segundos em uma GPU padrão, com limites nítidos em torno de estruturas finas. Licença: a licença própria da Apple cobre o código e os pesos. Ideal para: profundidade métrica em fotos nas quais você não controla a câmera. Desvantagem: é um modelo para servidores, não para dispositivos de borda, e você deve ler a licença antes de usá-lo comercialmente.
Marigold#
Marigold reaproveita um modelo de difusão de imagens pré-treinado para estimar profundidade, com treinamento exclusivo em dados sintéticos. Ele produz profundidade relativa muito detalhada. Licença: código sob Apache 2.0, modelos sob RAIL++-M. Ideal para: trabalhos offline em que os detalhes importam mais que a velocidade, como criação de conteúdo e geração de conjuntos de dados. Desvantagem: oferece inferência em uma etapa; usar ensemble para melhorar a precisão multiplica o custo, então avalie se atende aos seus requisitos de latência.
Metric3D v2#
Metric3D v2 prevê profundidade métrica e normais de superfície a partir de uma única imagem, com checkpoints ViT-Small, ViT-Large e ViT-giant2, incluindo exportações ONNX. Licença: o código está sob BSD-2-Clause; confira os termos do checkpoint que você usar. Ideal para: pipelines de reconstrução 3D e robótica que também precisam de normais de superfície. Desvantagem: o modelo mapeia imagens para uma câmera canônica, então você precisa de uma distância focal correta para acertar a escala.
MiDaS#
MiDaS, do ISL da Intel, tornou prática a estimativa robusta de profundidade relativa ao treinar com uma combinação de conjuntos de dados. A versão 3.1 vai de um modelo BEiT-Large voltado à qualidade até os modelos Swin2-Tiny e LeViT, destinados a dispositivos embarcados, além de um modelo pequeno legado MiDaS v2.1 no formato OpenVINO para CPUs Intel e exemplos para dispositivos móveis com iOS e Android. Licença: MIT. Ideal para: uma referência permissiva e bem documentada. Desvantagem: é anterior aos modelos fundacionais mais recentes, e a Intel arquivou o repositório, que não recebe mais correções. Compare-o com um modelo mais recente nas suas próprias imagens.
Profundidade do Ultralytics YOLO26#
Ultralytics YOLO26 oferece estimativa de profundidade (anunciada em julho de 2026) em cinco tamanhos, de 6.3M (n) a 57.0M (x) parâmetros, com entrada de 768 pixels. Os modelos preveem profundidade em metros com uma cabeça de profundidade logarítmica que cobre aproximadamente 0.02 a 150 metros, permitindo que um modelo cubra ambientes internos e cenas externas. Os pesos disponibilizados têm uma escala global única; para obter profundidade absoluta precisa em uma câmera específica, model.calibrate() ajusta a escala com cerca de 50 a 150 imagens rotuladas, sendo suficientes alguns pontos medidos por imagem, sem retreinamento. No nosso benchmark TensorRT FP16 com lote 1, em uma NVIDIA T4 e entrada de aproximadamente 768 pixels, a latência apenas da inferência (excluindo o pré e o pós-processamento) varia de 2.7 ms (n) a 13.6 ms (x), e os cinco tamanhos apresentaram latência menor que Depth Anything V2 Small. Esta é uma comparação de latência, não uma avaliação de precisão com protocolo comum. Os modelos são exportados para ONNX, TensorRT, CoreML, OpenVINO e outros formatos, e treinados com as mesmas API Python e CLI usadas para detecção, segmentação e pose. Licença: AGPL-3.0 ou uma licença Enterprise da Ultralytics para uso comercial de código fechado. Ideal para: estimativa de profundidade com baixa latência em GPUs NVIDIA, junto com outras tarefas YOLO; meça o desempenho no seu dispositivo de borda. Desvantagens: a escala absoluta depende da calibração da sua câmera, e a precisão não é comparada aqui à dos modelos fundacionais segundo um protocolo comum, então teste com seus próprios dados.
UniDepth V2#
UniDepth prevê profundidade métrica e os parâmetros intrínsecos da câmera a partir de uma única imagem RGB, e pode usar os parâmetros intrínsecos conhecidos quando você os tiver. Licença: CC BY-NC 4.0. Ideal para: pesquisa e protótipos que precisam de profundidade métrica a partir de câmeras desconhecidas. Desvantagem: a licença não permite uso comercial.
ZoeDepth#
ZoeDepth combina pré-treinamento de profundidade relativa com cabeças métricas para cenas internas (NYU) e externas (KITTI). Licença: MIT. Ideal para: um modelo métrico com licença permissiva quando suas cenas se parecem com os domínios de treinamento internos ou externos. Desvantagem: foi treinado para domínios internos e externos específicos, enquanto modelos métricos mais recentes, como UniDepth e Metric3D v2, foram projetados para câmeras variadas. A Intel arquivou o repositório, que não recebe mais correções.
Estimativa de profundidade em dispositivos de borda#
Em hardware de borda, a pergunta passa de "qual é o mais preciso?" para "qual é preciso o suficiente na minha taxa de quadros?". Há três grupos de modelos adequados:
- Versões pequenas de famílias grandes. Depth Anything V2 Small (24.8M parâmetros, Apache 2.0) é uma opção com licença permissiva. Os modelos MiDaS v3.1 Swin2-Tiny e LeViT foram projetados para dispositivos embarcados.
- Modelos de tarefas em tempo real. Ultralytics YOLO26 depth executa em 2.7 ms (n) a 13.6 ms (x) apenas para inferência, com lote 1 e excluindo o pré e o pós-processamento, em uma Tesla T4 com TensorRT FP16. Ele pode ser exportado para TensorRT para NVIDIA Jetson, CoreML para dispositivos Apple e OpenVINO para CPUs Intel; o suporte à exportação não equivale a um benchmark em dispositivos de borda.
- Modelos de pesquisa leves. FastDepth (MIT) foi desenvolvido para sistemas embarcados e demonstrado em um NVIDIA Jetson TX2. Lite-Mono (MIT) tem de 2.2M a 8.7M parâmetros e foi treinado com dados de direção do KITTI.
Meça a latência de inferência no dispositivo de destino após a exportação, na resolução que você usará na implantação. Para escolher o hardware, consulte como escolher o dispositivo de borda certo. Para ver as opções de exportação, consulte nosso guia sobre opções de implantação de modelos.
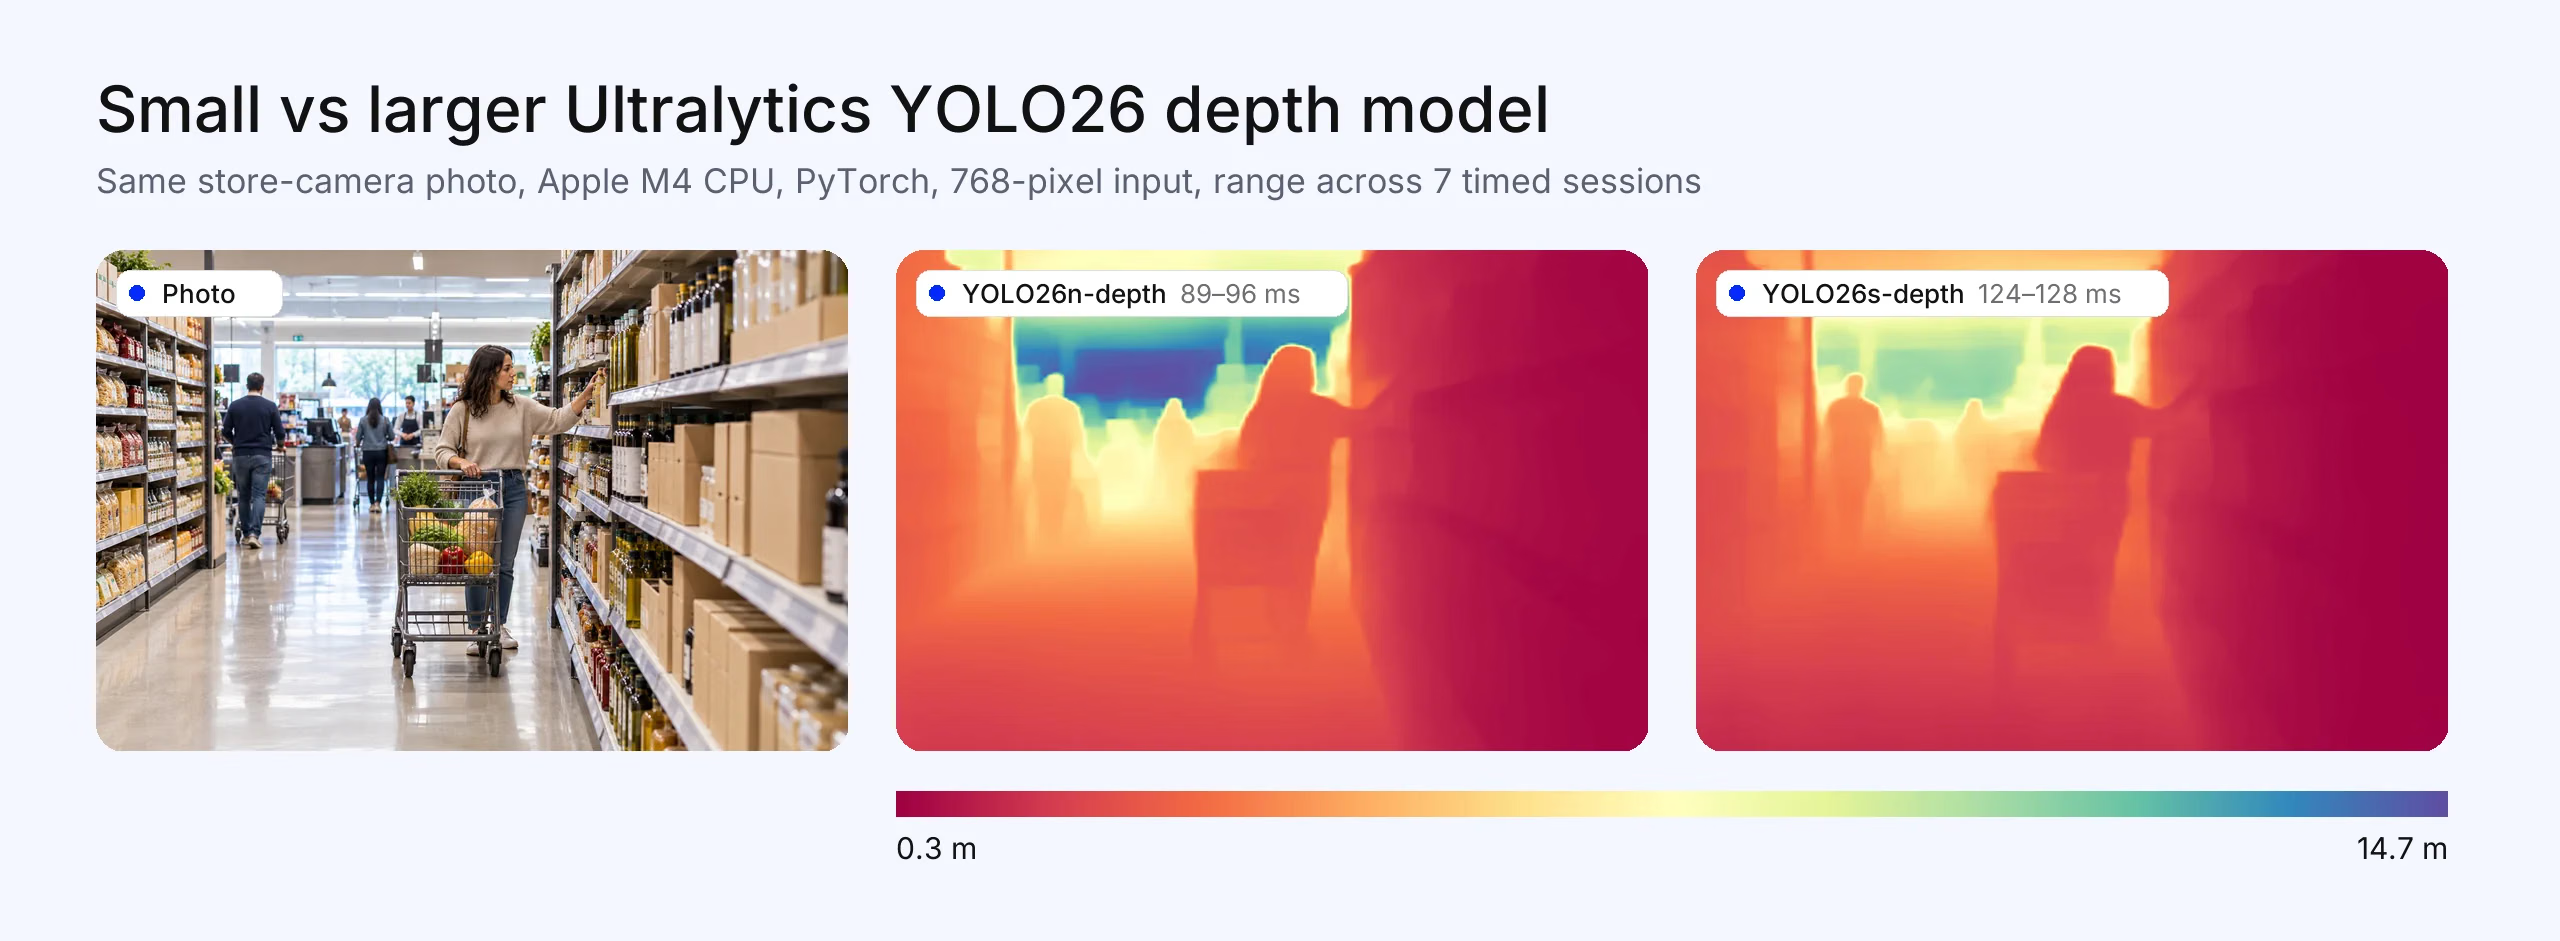
Fig 3. Ultralytics YOLO26n-depth (89 a 96 ms) e YOLO26s-depth (124 a 128 ms) na mesma foto do supermercado, em uma CPU Apple M4 (PyTorch, entrada de 768 pixels, da imagem ao mapa de profundidade concluído). Os tempos em laptops variam conforme a carga em segundo plano, então interprete-os como intervalos. A foto foi gerada para este artigo; os mapas de profundidade e os tempos são reais.
Estimativa de profundidade para robótica#
Robôs geralmente precisam de profundidade métrica estável entre quadros e na taxa de controle do robô. Há três abordagens práticas:
- Modelos métricos monoculares são adequados para robôs com uma única câmera RGB. Use um modelo compatível com sua câmera: Metric3D v2 ou Depth Anything 3 Metric com parâmetros intrínsecos conhecidos, ou um modelo Ultralytics YOLO26 depth calibrado quando precisar de inferência embarcada com baixa latência em uma GPU NVIDIA, junto com outras tarefas YOLO; meça o desempenho no computador do robô.
- Modelos estéreo, como o FoundationStereo da NVIDIA, calculam profundidade métrica a partir de um par de câmeras calibradas. A versão de pesquisa é para uso não comercial; a NVIDIA lista uma versão TAO para uso comercial. Consulte visão estéreo para ver uma comparação entre estéreo e profundidade monocular.
- Sensores de profundidade (câmeras estéreo de profundidade, luz estruturada ou LiDAR) medem a profundidade diretamente.
Quando um modelo monocular não é a escolha certa: para decisões críticas de segurança, como evitar colisões perto de pessoas, use um sensor de profundidade ou um par estéreo e trate a profundidade monocular como complemento, por exemplo, para preencher lacunas quando o sensor não retorna dados.
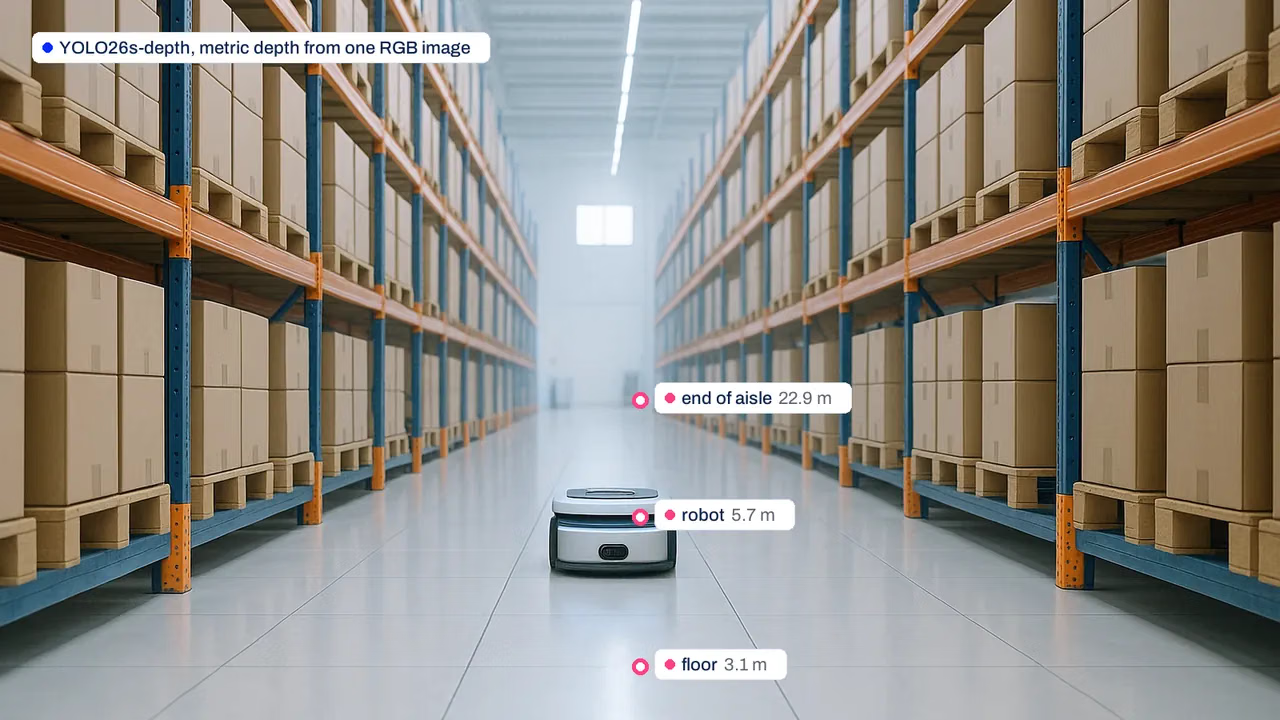
Fig 4. Distâncias previstas lidas em um mapa de profundidade do Ultralytics YOLO26s-depth: 3.1 m até um ponto no chão, 5.7 m até o robô e cerca de 23 m até o fim do corredor. A foto foi gerada para este artigo; as leituras são resultados reais do modelo, sem calibração para esta câmera, portanto são previsões, não medições.
Como testar modelos de profundidade na sua própria câmera#
- Colete cerca de 50 a 150 imagens rotuladas da câmera de implantação, na resolução e com as configurações de lente que serão usadas na implantação, incluindo alguns pontos medidos por imagem. Benchmarks públicos, como NYU Depth V2 (ambientes internos) e KITTI (direção), são úteis para uma primeira comparação, mas os resultados na sua própria câmera são decisivos.
- Um medidor de distância mede a distância em linha reta, enquanto a calibração precisa da profundidade ao longo do eixo da câmera: meça pontos perto do centro da imagem, converta as leituras fora do centro em profundidade no eixo da câmera usando os parâmetros intrínsecos da câmera ou colete profundidade com um sensor de profundidade.
- Compare os candidatos em δ1 e erro relativo absoluto em relação a essas medições, e meça o tempo de execução de cada um no dispositivo de destino. Para modelos métricos, avalie a saída bruta sem redimensionar cada imagem para corresponder ao ground truth; o alinhamento por imagem oculta justamente os erros de escala que você precisa detectar.
- Para um modelo métrico com escala fixa, calibre-o com parte dos dados e teste-o com o restante. O Ultralytics YOLO26 depth inclui esse recurso como
model.calibrate().
Perguntas frequentes
Não há um único melhor modelo para todos os casos. Depth Anything V2 e Depth Anything 3 são opções fortes para avaliar primeiro quanto à profundidade relativa. Depth Pro, UniDepth e Metric3D v2 fornecem profundidade métrica a partir de uma única imagem. Para estimativa de profundidade com baixa latência em GPUs NVIDIA, junto com outras tarefas YOLO, avalie o Ultralytics YOLO26 depth e meça o desempenho no seu dispositivo de borda. Depth Anything V2 Small e os modelos MiDaS v3.1 Swin2-Tiny e LeViT também são opções mais leves para testar.
Faça uma lista curta de modelos pequenos que possam ser exportados para seu runtime: Ultralytics YOLO26 depth (6.3M a 57.0M parâmetros, exportação para TensorRT, CoreML e OpenVINO), Depth Anything V2 Small (24.8M parâmetros) e os modelos MiDaS v3.1 Swin2-Tiny ou LeViT. Em seguida, meça a latência no seu próprio dispositivo; o suporte à exportação não comprova o desempenho em dispositivos de borda.
Robôs geralmente precisam de profundidade métrica. Metric3D v2 e Depth Anything 3 Metric preveem distâncias em metros a partir de uma imagem, usando parâmetros intrínsecos conhecidos da câmera; o UniDepth pode estimar os próprios parâmetros intrínsecos. O Ultralytics YOLO26 depth tem latência apenas de inferência de 2.7 a 13.6 ms com lote 1, excluindo o pré e o pós-processamento, em uma T4 com TensorRT FP16 e entrada de aproximadamente 768 pixels, conforme a documentação; meça o desempenho no próprio computador do robô. Para navegação crítica para a segurança, use uma câmera estéreo ou um sensor de profundidade e trate a profundidade monocular como complemento; FoundationStereo é um modelo estéreo que vale a pena avaliar.
Os principais modelos Depth Anything V2 preveem profundidade relativa. O projeto também publica checkpoints métricos ajustados com fine-tuning para cenas internas de até 20 metros e cenas externas de até 80 metros.
Confira cada checkpoint. MiDaS e ZoeDepth usam MIT (os dois repositórios estão arquivados), o código do Metric3D usa BSD-2-Clause (confira os termos do checkpoint), Depth Anything V2 Small e vários modelos Depth Anything 3 usam Apache 2.0, e os modelos do Marigold usam RAIL++-M. Depth Anything V2 Base e Large, os modelos maiores Depth Anything 3 e UniDepth são não comerciais. Ultralytics YOLO26 depth usa AGPL-3.0, com uma licença Enterprise para uso comercial de código fechado. Depth Pro usa a licença própria da Apple, que permite uso e redistribuição, mas não concede direitos de patente; analise-a antes de distribuir o produto.









