5 lý do khiến model thị giác máy tính thất bại trong môi trường production
Tìm hiểu lý do model thị giác máy tính thất bại trong môi trường production, từ sai lệch dữ liệu đến độ trễ, và cách các nhóm có thể cải thiện hiệu năng model trong hệ thống AI thị giác thực tế.
 Abirami Vina13 phút đọc
Thị giác máy tính hiện là công nghệ trí tuệ nhân tạo chủ chốt được ứng dụng trong hầu hết các ngành, cho phép máy móc diễn giải và phân tích dữ liệu hình ảnh để thực hiện nhiều tác vụ. Các hệ thống này hỗ trợ nhiều ứng dụng thực tế, từ chẩn đoán hình ảnh y tế và robot đến tự động hóa sản xuất và bán lẻ.
Tuy nhiên, việc xây dựng một hệ thống thị giác máy tính không phải lúc nào cũng đơn giản. Quy trình này thường bao gồm phát triển một model vision AI được huấn luyện để nhận diện các mẫu trong hình ảnh và video, hỗ trợ các tác vụ như phát hiện và theo dõi đối tượng.
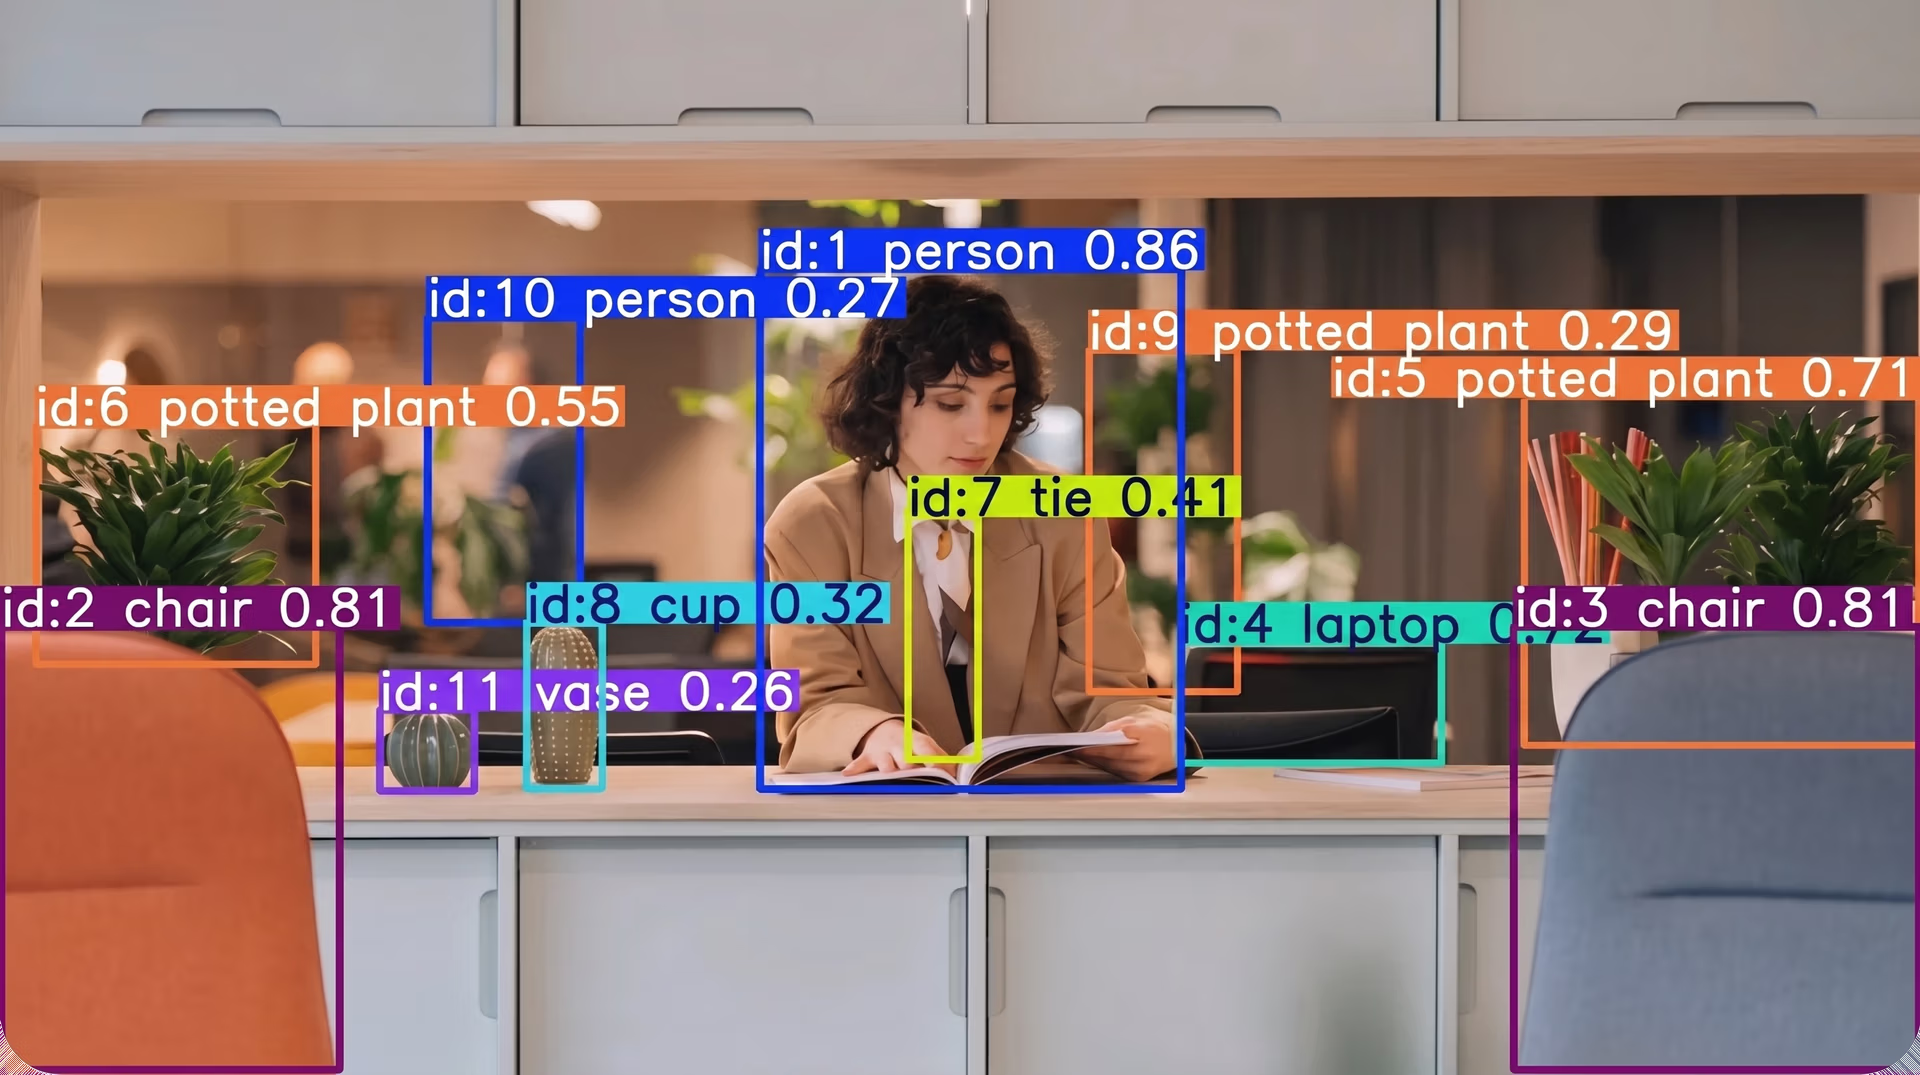
Hình 1. Ví dụ về phát hiện và theo dõi đối tượng (Nguồn)
Dù ngày càng tiên tiến qua các năm, model thị giác máy tính vẫn có thể hoạt động khác nhau trong quá trình phát triển so với sau khi được triển khai trong môi trường thực tế. Nguyên nhân là việc triển khai model bên ngoài môi trường phát triển được kiểm soát sẽ tạo ra những thách thức mới, thường khó lường trước.
Các yếu tố như dataset thiếu tính đa dạng, giám sát model kém và hạn chế về hạ tầng có thể khiến cùng một model hoạt động khác nhau trong thực tế sau khi triển khai.
Trong bài viết này, chúng ta sẽ tìm hiểu năm lý do phổ biến khiến model thị giác máy tính có thể không hoạt động tốt trong môi trường production.
Khoảng cách giữa huấn luyện model và môi trường production#
Huấn luyện model thường diễn ra trong một môi trường được kiểm soát. Ở giai đoạn này, các nhà phát triển AI làm việc với những dataset huấn luyện được chuẩn bị kỹ lưỡng.
Các bộ sưu tập dữ liệu hình ảnh khổng lồ này bao gồm chú thích có cấu trúc tốt, hay nhãn mô tả nội dung của từng hình ảnh. Quá trình huấn luyện cũng diễn ra trong các điều kiện nhất quán, giúp model vision AI học các mẫu hình ảnh một cách hiệu quả.
Để đảm bảo các mẫu này được học chính xác, model có thể được đánh giá một cách có hệ thống trong quá trình phát triển bằng các metric đánh giá tiêu chuẩn và dataset benchmark. Tương tự dataset huấn luyện, các dataset benchmark này cũng được chuẩn bị kỹ lưỡng.
Tuy nhiên, dữ liệu mà các hệ thống thị giác máy tính trong thực tế gặp phải có thể rất khác với dữ liệu được dùng trong huấn luyện và đánh giá. Sau khi triển khai, các model này hiếm khi hoạt động trong điều kiện được kiểm soát.
Chúng có thể phải xử lý hình ảnh và video từ các môi trường khó dự đoán, nơi ánh sáng liên tục thay đổi, góc camera dịch chuyển và phông nền biến đổi theo thời gian. Ví dụ, model vision AI được huấn luyện để phát hiện giao thông có thể khó phát hiện phương tiện vào ban đêm nếu chủ yếu được huấn luyện và đánh giá bằng hình ảnh ban ngày.
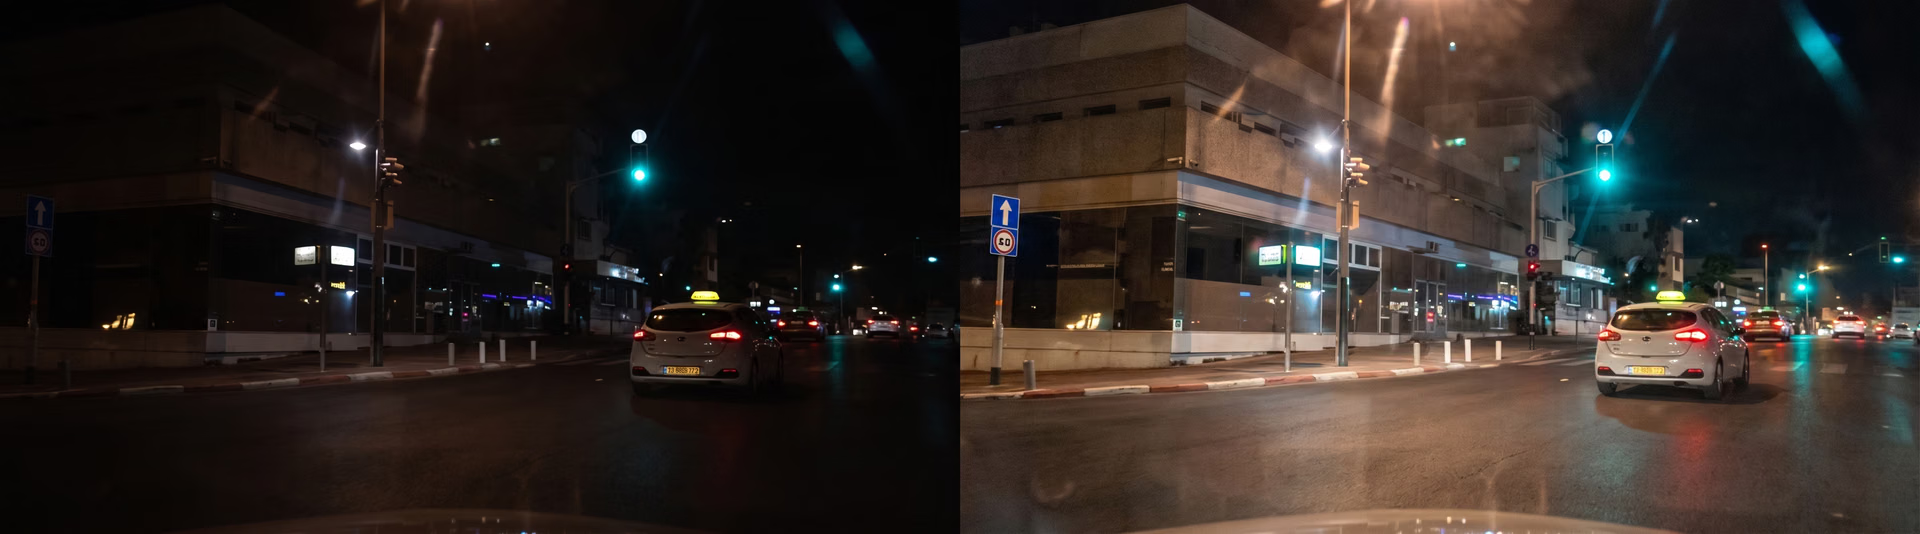
Hình 2. Ngay cả sau khi cải thiện, hình ảnh ban đêm vẫn khó được các model huấn luyện bằng hình ảnh ban ngày diễn giải. (Nguồn)
Sự khác biệt giữa quá trình phát triển và triển khai trong thực tế này được gọi là khoảng cách giữa huấn luyện và production. Do khoảng cách này, nhiều lỗi của model chỉ lộ rõ sau khi triển khai, vì vậy nhận thức sớm về hành trình từ phòng thí nghiệm đến production là điều thiết yếu để xây dựng hệ thống thị giác máy tính đáng tin cậy và mạnh mẽ hơn.
5 lý do phổ biến khiến model thị giác máy tính thất bại trong môi trường production#
Tiếp theo, hãy cùng tìm hiểu kỹ hơn năm lý do phổ biến khiến model thị giác máy tính thất bại trong môi trường production.
1. Dataset huấn luyện chất lượng thấp#
Dataset đóng vai trò trung tâm trong việc huấn luyện model thị giác máy tính vì chúng quyết định model học được gì trong quá trình huấn luyện và phản hồi ra sao trước dữ liệu đầu vào thực tế sau khi triển khai. Điều này đặc biệt quan trọng trong học có giám sát, nơi model học từ các ví dụ đã gắn nhãn cho biết mỗi hình ảnh thể hiện điều gì.
Nhiều model deep learning, bao gồm mạng nơ-ron tích chập (CNN), dựa vào các ví dụ đã gắn nhãn này để nhận diện mẫu trong dữ liệu hình ảnh. Tuy nhiên, khi dataset huấn luyện không phản ánh điều kiện thực tế, model có thể học các mẫu không thể hiện đầy đủ diện mạo của đối tượng bên ngoài dữ liệu huấn luyện.
Ví dụ, model được huấn luyện trên dataset gồm các vết nứt lớn có thể không phát hiện được một loại vết nứt nhỏ hiếm gặp trong quy trình sản xuất thực tế. Tương tự, chất lượng chú thích cũng có thể ảnh hưởng đến hành vi của model. Nhãn không nhất quán hoặc thiếu chi tiết trong dữ liệu đã gắn nhãn có thể khiến model học thông tin không chính xác trong quá trình huấn luyện.
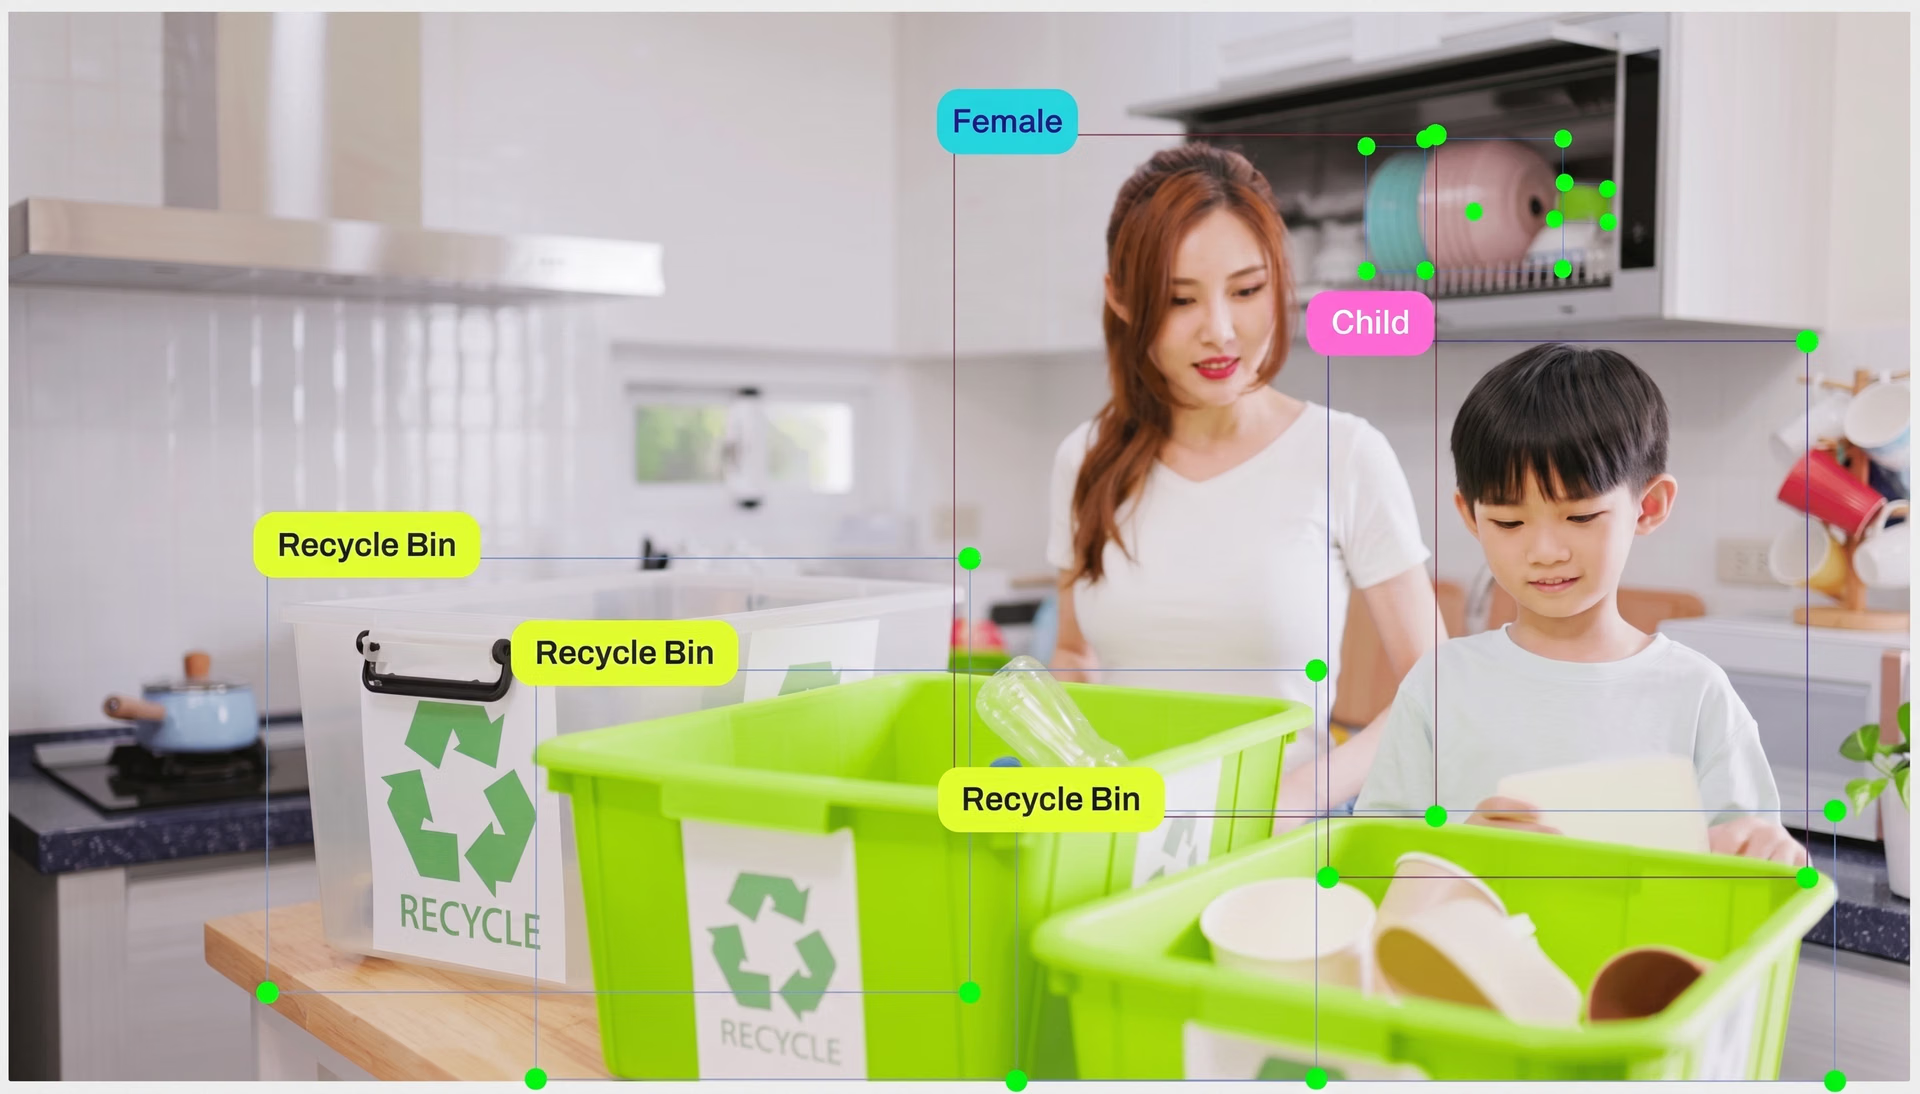
Hình 3. Tìm hiểu về chú thích hình ảnh (Nguồn)
Nhìn chung, chất lượng và tính đa dạng của dữ liệu huấn luyện là yếu tố then chốt và có thể quyết định mức độ hiệu quả của model trong các ứng dụng thực tế. Khi dataset có tính đại diện và được gắn nhãn chính xác, model thường hoạt động đáng tin cậy hơn sau khi triển khai.
2. Overfitting và khả năng tổng quát hóa#
Các model machine learning như model vision học các mẫu từ dataset huấn luyện. Nhưng đôi khi model có thể phụ thuộc quá nhiều vào một vài mẫu.
Thay vì học các mối quan hệ hình ảnh rộng hơn, model có thể ghi nhớ các mẫu hạn chế trong dữ liệu huấn luyện. Hiện tượng này được gọi là overfitting.
Overfitting thường xảy ra khi dataset huấn luyện nhỏ hoặc thiếu tính đa dạng của dữ liệu. Trong những trường hợp này, model nhận diện tốt các hình ảnh đã từng thấy nhưng gặp khó khăn khi diễn giải dữ liệu mới hoặc dữ liệu đầu vào không quen thuộc.
Do đó, model có thể hoạt động tốt trên dữ liệu kiểm thử (vì dữ liệu này tương tự dữ liệu huấn luyện) nhưng lại có hành vi khác trong điều kiện mới sau khi triển khai. Vì vậy, khái niệm khả năng tổng quát hóa rất quan trọng. Nói đơn giản, đó là mức độ model có thể áp dụng những gì đã học trong quá trình huấn luyện vào các tình huống mới.
Để giảm overfitting, người thực hành thường huấn luyện model trên các dataset đa dạng hơn và áp dụng tăng cường dữ liệu, một phương pháp điều chỉnh nhẹ ảnh huấn luyện để tạo thêm sự đa dạng cho dữ liệu. Nếu không cân nhắc những yếu tố này, hiệu năng model có thể giảm nhanh khi hệ thống bắt đầu hoạt động trong môi trường thực tế.
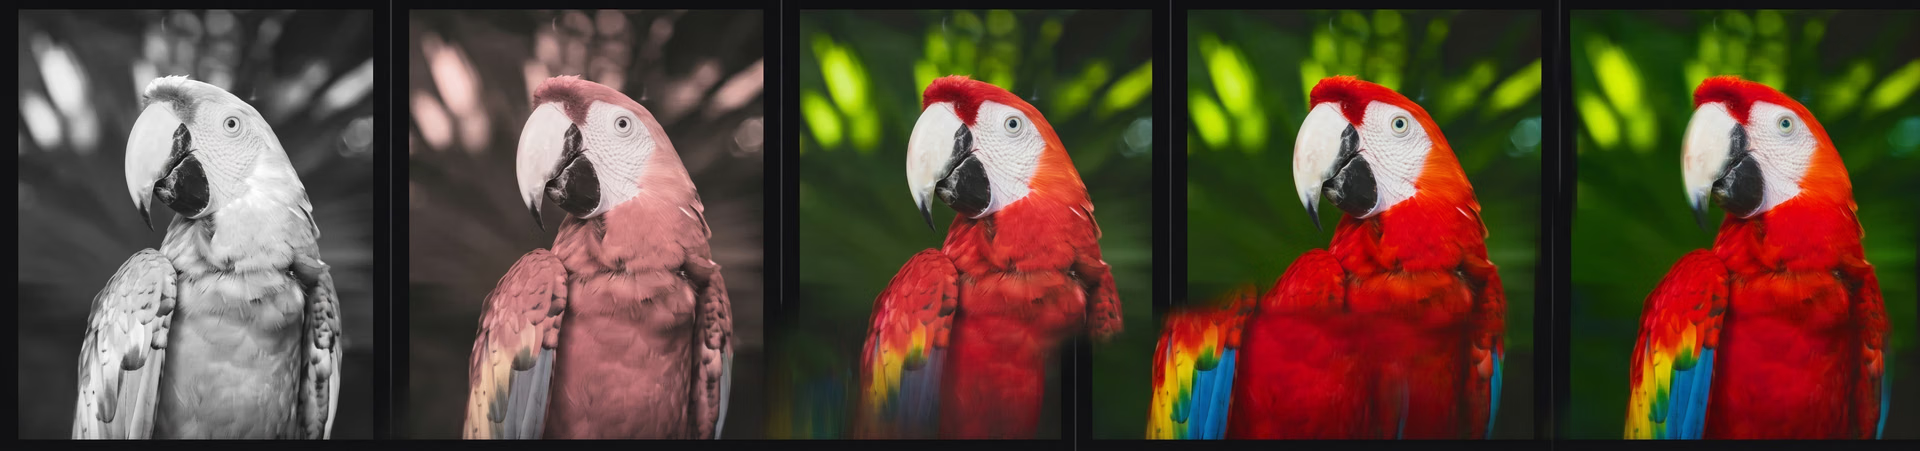
Hình 4. Tăng cường dữ liệu có thể giúp tạo ra các biến thể của cùng một hình ảnh trong dataset. (Nguồn)
3. Các trường hợp ngoại lệ tiềm ẩn trong môi trường thực tế#
Ngay cả khi model thị giác máy tính tổng quát hóa tốt với dữ liệu mới, môi trường thực tế vẫn có thể phát sinh các trường hợp ngoại lệ không mong đợi. Đây là những tình huống bất thường, khác với các mẫu điển hình mà model học được trong quá trình huấn luyện.
Nhiều tình huống như vậy khó được ghi nhận trong quá trình phát triển vì chúng hiếm khi xảy ra, khó tái tạo hoặc tốn kém để thu thập làm dữ liệu huấn luyện. Ví dụ, đối tượng có thể xuất hiện với hình dạng bất thường, di chuyển khó đoán hoặc bị các đối tượng khác che khuất một phần.
Thay đổi về ánh sáng, góc camera hoặc điều kiện phông nền cũng có thể tạo ra những tình huống khiến việc nhận diện trở nên khó khăn hơn. Các trường hợp ngoại lệ này thường chỉ được phát hiện sau khi hệ thống được triển khai trong các ứng dụng thực tế.
Chẳng hạn, trong lĩnh vực robot và tự động hóa sản xuất, các vật phẩm có thể được đặt hoặc định vị khác với dự kiến, tạo ra những tình huống mà model không được thiết kế để xử lý. Cuối cùng, các dự đoán có vẻ đáng tin cậy trong quá trình kiểm thử có thể trở nên kém nhất quán hơn khi hệ thống hoạt động trong môi trường thực tế.
4. Thiếu giám sát và gỡ lỗi sau triển khai#
Bên cạnh việc phát triển model vision AI, việc giám sát và cải thiện hiệu suất của model cũng rất cần thiết. Tuy nhiên, khi hệ thống đã vận hành, trọng tâm thường chuyển sang việc duy trì hoạt động thay vì theo dõi sát hiệu suất theo thời gian. Vì vậy, những thay đổi trong hành vi của model có thể không được phát hiện.
Đồng thời, các yếu tố như thay đổi trong dữ liệu đầu vào, cấu hình camera hoặc môi trường vận hành có thể dần ảnh hưởng đến độ chính xác của model khi phát hiện hoặc phân loại đối tượng. Những thay đổi này không phải lúc nào cũng dễ nhận thấy và có thể không được phát hiện trong quá trình vận hành hằng ngày.
Giám sát đầu ra của model và hành vi tổng thể của hệ thống có thể giúp các nhóm nhận diện vấn đề sớm hơn. Việc kiểm tra thường xuyên, quy trình validation và quy trình gỡ lỗi cho phép các nhóm điều tra những kết quả bất thường và tìm hiểu nguyên nhân có thể gây ra chúng.
Trong các lĩnh vực như sản xuất, model có thể đột nhiên nhận diện sai các đối tượng trên dây chuyền lắp ráp sau khi cấu hình camera thay đổi. Theo dõi hành vi của hệ thống vision AI đã triển khai giúp việc ứng phó với những thay đổi này dễ dàng hơn và duy trì hiệu suất ổn định trong môi trường thực tế.
5. Hạn chế về hạ tầng và độ trễ#
Nhiều hệ thống thị giác máy tính cần chạy theo thời gian thực, điều này có thể gây áp lực đáng kể lên phần cứng, mạng và pipeline xử lý. Khi tài nguyên hạn chế, độ trễ tính toán hoặc độ trễ mạng có thể xảy ra, khiến kết quả dự đoán đến quá chậm và ảnh hưởng đến hiệu suất tổng thể của hệ thống.
Trong một số trường hợp, các model deep learning tiên tiến cũng có thể tạo ra thách thức về hạ tầng. Ví dụ, kiến trúc dựa trên Transformer được thiết kế để xử lý lượng lớn dữ liệu hình ảnh và học các mối quan hệ phức tạp trong hình ảnh, nhưng thường đòi hỏi tài nguyên tính toán đáng kể. Việc chạy các model này có thể cần phần cứng mạnh hơn hoặc đắt tiền hơn.
Nếu không được tối ưu hóa phù hợp, ngay cả những model chạy nhanh trong quá trình kiểm thử cũng có thể chậm lại hoặc hoạt động không nhất quán sau khi triển khai. Để giải quyết vấn đề này, các nhóm thường tối ưu hóa pipeline, giảm độ phức tạp của model khi có thể và cân bằng độ chính xác với tốc độ.
Điều này có thể bao gồm nén các model lớn thành phiên bản gọn nhẹ hơn, sử dụng kiến trúc hiệu quả hơn hoặc xử lý hình ảnh ở độ phân giải thấp hơn để hệ thống chạy ổn định trên phần cứng hiện có. Trong nhiều trường hợp, các nhóm cũng chọn những model nhẹ và nhanh hơn như Ultralytics YOLO26 để đáp ứng các giới hạn khi triển khai.
Các phương pháp tốt nhất để ngăn model thị giác máy tính thất bại#
Dưới đây là một số phương pháp tốt nhất có thể giúp giảm lỗi khi triển khai model thị giác máy tính trong môi trường production:
- Sử dụng chiến lược triển khai theo giai đoạn: Đưa model vào production từng bước để các nhóm có thể quan sát hành vi của model và điều chỉnh khi cần.
- Tích hợp vòng phản hồi: Thu thập hình ảnh mới và xem xét các dự đoán sai để huấn luyện lại model bằng dataset đã cập nhật, qua đó cải thiện hiệu suất theo thời gian.
- Ghi lại các hạn chế của model: Ghi chép rõ những tình huống model có thể gặp khó khăn để các nhóm dự đoán trước các vấn đề tiềm ẩn trong quá trình triển khai.
- Thiết kế để ứng phó với biến thiên thực tế: Lên kế hoạch trước cho những biến đổi về ánh sáng, góc camera, vị trí đối tượng hoặc điều kiện phông nền có thể giúp model duy trì tính ổn định trong các tình huống vận hành khác nhau.
Điểm chính cần ghi nhớ#
Model thị giác máy tính hiếm khi thất bại vì bản thân các thuật toán yếu kém. Trong hầu hết trường hợp, thách thức thực sự đến từ môi trường mà các hệ thống này hoạt động. Model hoạt động tốt trong quá trình huấn luyện thường gặp phải các điều kiện thực tế khó lường, có thể ảnh hưởng đến hành vi của chúng.
Đó là lý do xây dựng hệ thống vision AI đáng tin cậy đòi hỏi nhiều hơn việc chỉ huấn luyện một model. Quy trình này còn bao gồm chuẩn bị dataset cẩn thận, giám sát hiệu suất model sau khi triển khai và liên tục điều chỉnh hệ thống để thích ứng với điều kiện thực tế.
Bạn muốn khám phá sâu hơn về vision AI? Tham gia cộng đồng của chúng tôi và đọc về các ứng dụng như AI trong ngành ô tô và thị giác máy tính trong logistics. Xem các tùy chọn cấp phép để bắt đầu các dự án thị giác máy tính. Truy cập repository GitHub để tìm hiểu thêm.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









