Các model phát hiện đối tượng tốt nhất
Khám phá các model phát hiện đối tượng tốt nhất năm 2026, từ Ultralytics YOLO đến RT-DETR, với phần so sánh kiến trúc, đánh đổi về hiệu năng và các yếu tố triển khai.
 Abirami Vina17 phút đọc
Đầu năm nay, Andrew Ng, người tiên phong trong lĩnh vực AI và machine learning, đã giới thiệu khái niệm phát hiện đối tượng bằng agent. Phương pháp này sử dụng một agent suy luận để phát hiện đối tượng dựa trên prompt văn bản mà không cần lượng lớn dữ liệu huấn luyện.
Khả năng nhận diện đối tượng trong ảnh và video mà không cần dataset gán nhãn khổng lồ là một bước tiến hướng đến các hệ thống thị giác máy tính thông minh và linh hoạt hơn. Tuy nhiên, AI thị giác dựa trên agent vẫn đang ở giai đoạn đầu.
Dù có thể xử lý các tác vụ tổng quát như phát hiện người hoặc biển báo giao thông trong ảnh, các ứng dụng thị giác máy tính đòi hỏi độ chính xác cao hơn vẫn dựa vào các model phát hiện đối tượng truyền thống. Những model này được huấn luyện trên các dataset lớn, được gán nhãn cẩn thận để học chính xác cần tìm gì và đối tượng nằm ở đâu.
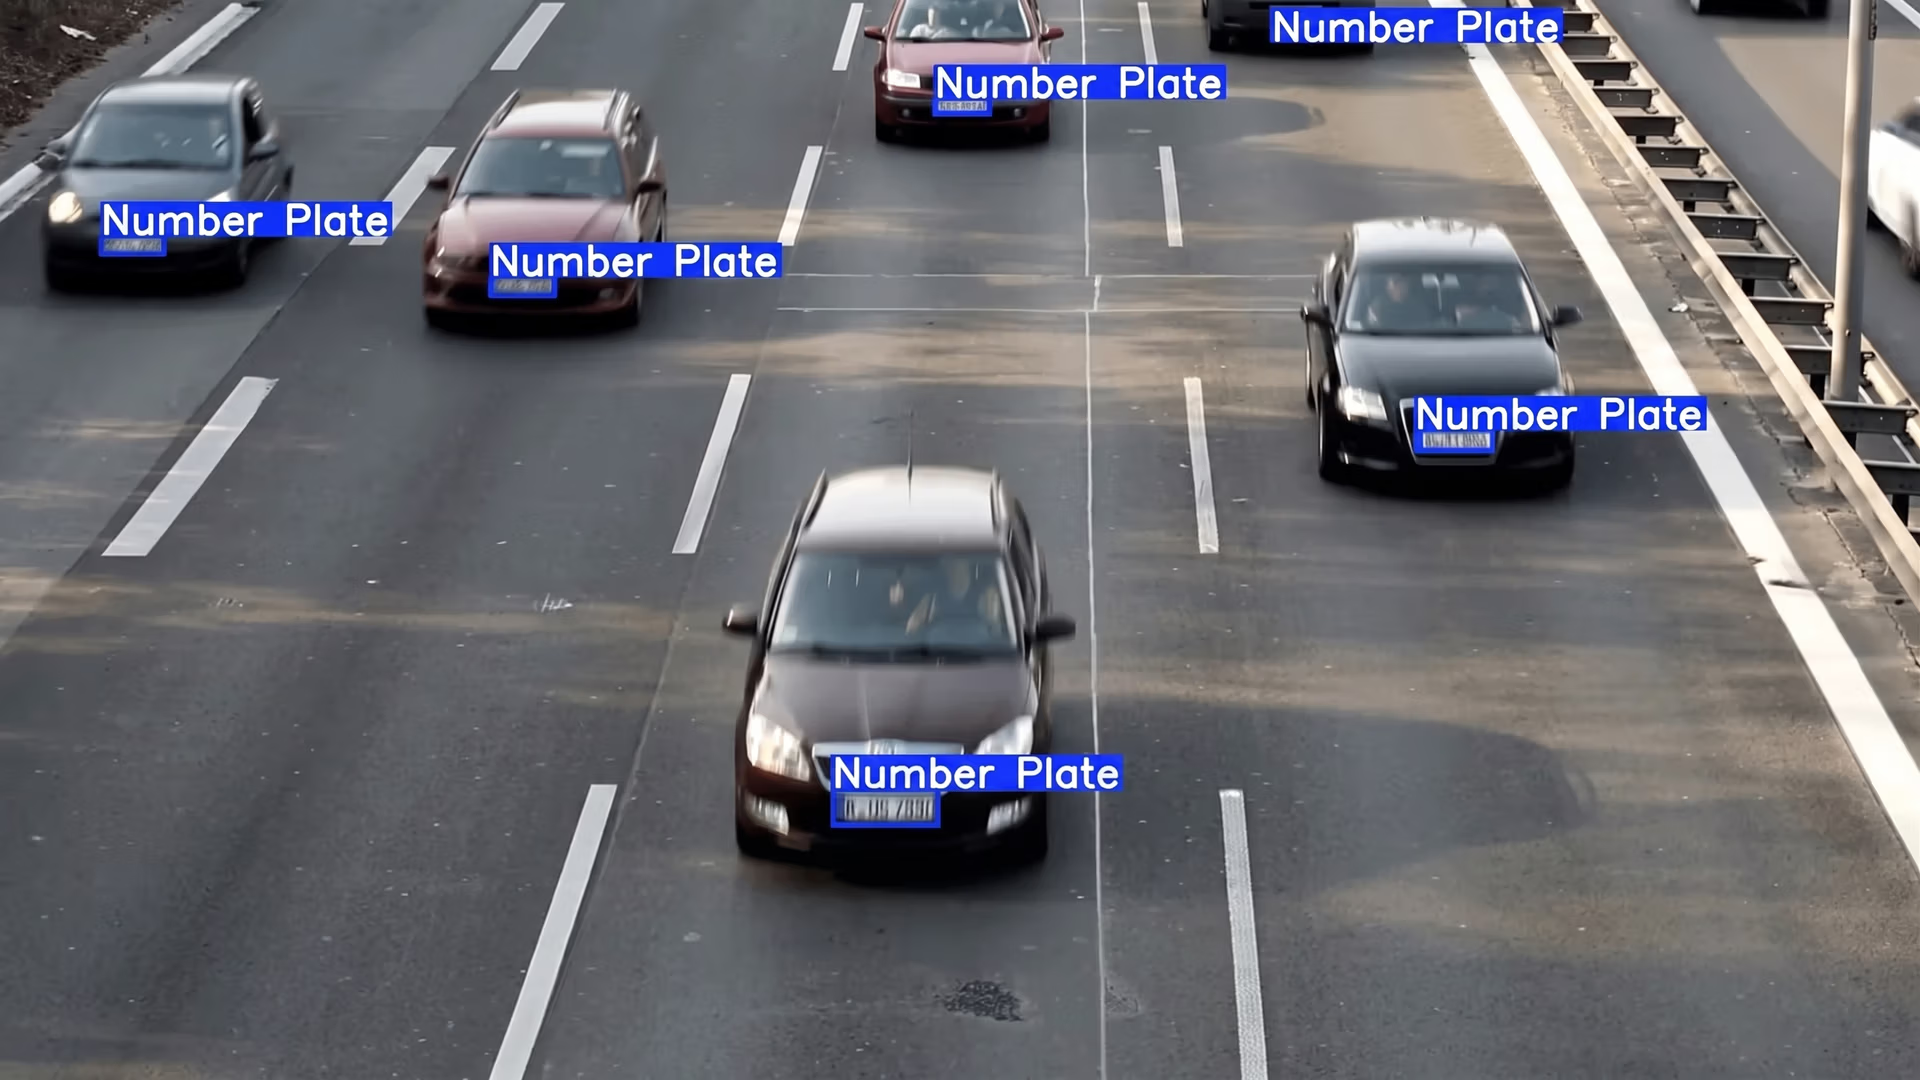
Hình 1. Ví dụ về phát hiện đối tượng. (Nguồn)
Phát hiện đối tượng truyền thống rất cần thiết vì cung cấp cả khả năng nhận diện — xác định đối tượng là gì — và định vị — xác định chính xác vị trí của đối tượng trong ảnh. Sự kết hợp này cho phép máy móc thực hiện đáng tin cậy các tác vụ phức tạp trong thực tế, từ xe tự hành đến tự động hóa công nghiệp và chẩn đoán y tế.
Các model phát hiện đối tượng tiếp tục được cải thiện, ngày càng nhanh hơn, chính xác hơn và phù hợp hơn với môi trường thực tế. Trong bài viết này, chúng ta sẽ điểm qua một số model phát hiện đối tượng tốt nhất hiện nay.
Nhu cầu về phát hiện đối tượng#
Các tác vụ thị giác máy tính như phân loại ảnh có thể xác định liệu một ảnh có chứa ô tô, người hay đối tượng khác hay không. Tuy nhiên, các tác vụ này không thể xác định vị trí của đối tượng trong ảnh.
Đây là lúc phát hiện đối tượng phát huy tác dụng. Model phát hiện đối tượng có thể xác định những đối tượng nào xuất hiện, đồng thời xác định chính xác vị trí của chúng. Quy trình này, gọi là định vị, giúp máy móc hiểu cảnh chính xác hơn và phản hồi phù hợp, dù là dừng xe tự lái, điều khiển cánh tay robot hay làm nổi bật một vùng trong ảnh y khoa.
Sự phát triển của deep learning đã làm thay đổi lĩnh vực phát hiện đối tượng. Thay vì dựa vào các quy tắc được viết thủ công, các model hiện đại học trực tiếp từ dữ liệu gán nhãn và dữ liệu hình ảnh. Những dataset này giúp model học hình dạng của các đối tượng, vị trí chúng thường xuất hiện và cách xử lý các thách thức như đối tượng nhỏ, cảnh lộn xộn hoặc điều kiện ánh sáng thay đổi.
Trên thực tế, các hệ thống phát hiện đối tượng tiên tiến nhất có thể phát hiện chính xác nhiều đối tượng cùng lúc. Điều này khiến phát hiện đối tượng trở thành công nghệ then chốt trong các ứng dụng như xe tự hành, robot học, chăm sóc sức khỏe và tự động hóa công nghiệp.
Cách hoạt động của các tác vụ phát hiện đối tượng#
Đầu vào của model phát hiện đối tượng là một hình ảnh, có thể đến từ camera, khung hình video hoặc thậm chí là ảnh quét y tế. Ảnh đầu vào được xử lý qua mạng nơ-ron, thường là mạng nơ-ron tích chập (CNN), được huấn luyện để nhận diện các mẫu trong dữ liệu hình ảnh.
Bên trong mạng, hình ảnh được phân tích qua nhiều giai đoạn. Dựa trên các đặc trưng phát hiện được, model dự đoán những đối tượng nào xuất hiện và chúng nằm ở đâu.
Các dự đoán này được biểu diễn bằng bounding box, là những hình chữ nhật được vẽ quanh từng đối tượng được phát hiện. Với mỗi bounding box, model gán một nhãn class (ví dụ: ô tô, người hoặc chó) và điểm tin cậy thể hiện mức độ chắc chắn của dự đoán (cũng có thể xem đây là một xác suất).
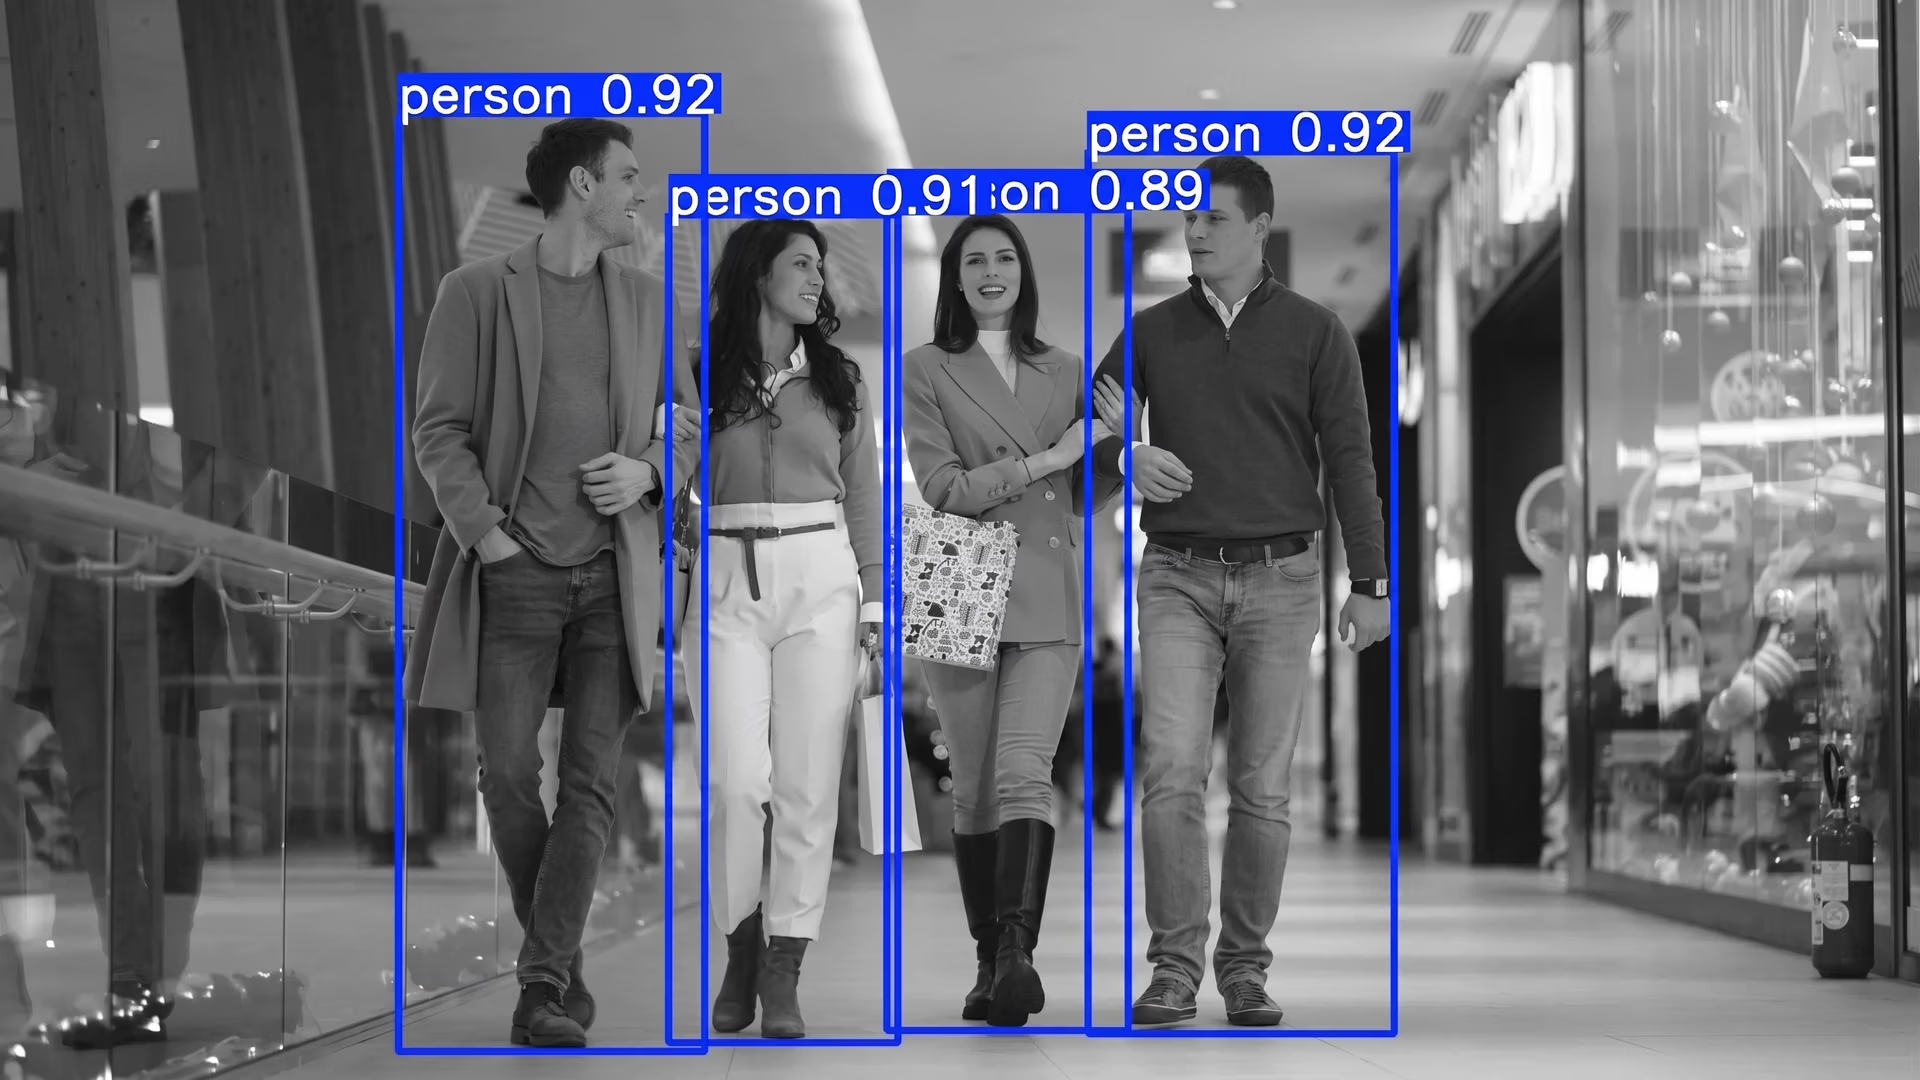
Hình 2. Có thể trực quan hóa các dự đoán phát hiện đối tượng bằng bounding box.
Quy trình tổng thể phụ thuộc nhiều vào việc trích xuất đặc trưng. Model học cách nhận diện các mẫu hình ảnh hữu ích như cạnh, hình dạng, kết cấu và những đặc điểm phân biệt khác. Các mẫu này được mã hóa trong feature map, giúp mạng hiểu hình ảnh ở nhiều mức độ chi tiết.
Phát hiện đối tượng: hai giai đoạn và một giai đoạn#
Tùy theo kiến trúc model, các bộ phát hiện đối tượng sử dụng nhiều chiến lược khác nhau để định vị đối tượng, cân bằng giữa tốc độ, độ chính xác và độ phức tạp.
Nhiều model phát hiện đối tượng, đặc biệt là các bộ phát hiện hai giai đoạn như Faster R-CNN, tập trung vào những phần cụ thể của ảnh được gọi là vùng quan tâm (ROIs). Bằng cách tập trung vào các vùng này, model ưu tiên những khu vực có khả năng chứa đối tượng thay vì phân tích mọi pixel như nhau.
Ngược lại, các model một giai đoạn như những model YOLO đời đầu không chọn các vùng quan tâm (ROIs) cụ thể như model hai giai đoạn. Thay vào đó, chúng chia ảnh thành một lưới và sử dụng các box được xác định trước, gọi là anchor box, cùng với feature map để dự đoán đối tượng trên toàn bộ ảnh chỉ trong một lượt xử lý.
Nhiều model phát hiện đối tượng hiện đại, bao gồm các model Ultralytics YOLO gần đây, sử dụng phương pháp không dùng anchor. Không như các model một giai đoạn truyền thống dựa vào anchor box được định nghĩa sẵn, model không dùng anchor dự đoán trực tiếp vị trí và kích thước đối tượng từ feature map. Cách này có thể đơn giản hóa kiến trúc, giảm chi phí tính toán và cải thiện hiệu năng, đặc biệt khi phát hiện đối tượng có hình dạng và kích thước khác nhau.
Điểm qua các model phát hiện đối tượng tốt nhất#
Hiện nay có nhiều model phát hiện đối tượng, mỗi model được thiết kế cho những mục tiêu cụ thể. Một số model được tối ưu cho hiệu suất thời gian thực, trong khi những model khác tập trung đạt độ chính xác cao nhất. Việc chọn model phù hợp cho giải pháp thị giác máy tính thường phụ thuộc vào trường hợp sử dụng cụ thể và yêu cầu hiệu suất của bạn.
Tiếp theo, hãy cùng khám phá một số model phát hiện đối tượng tốt nhất năm 2026.
1. Các model Ultralytics YOLO#
Một trong những dòng model phát hiện đối tượng được sử dụng rộng rãi nhất hiện nay là dòng model Ultralytics YOLO. YOLO, viết tắt của You Only Look Once, phổ biến trong nhiều ngành vì mang lại hiệu suất phát hiện mạnh mẽ, đồng thời nhanh, đáng tin cậy và dễ sử dụng.
Họ model Ultralytics YOLO bao gồm Ultralytics YOLOv5, Ultralytics YOLOv8, Ultralytics YOLO11 và phiên bản mới nhất Ultralytics YOLO26, cung cấp nhiều lựa chọn đáp ứng các yêu cầu hiệu năng và trường hợp sử dụng khác nhau. Nhờ thiết kế nhẹ và tối ưu hóa tốc độ, các model Ultralytics YOLO lý tưởng cho phát hiện thời gian thực và có thể triển khai trên thiết bị biên với năng lực tính toán và bộ nhớ hạn chế.
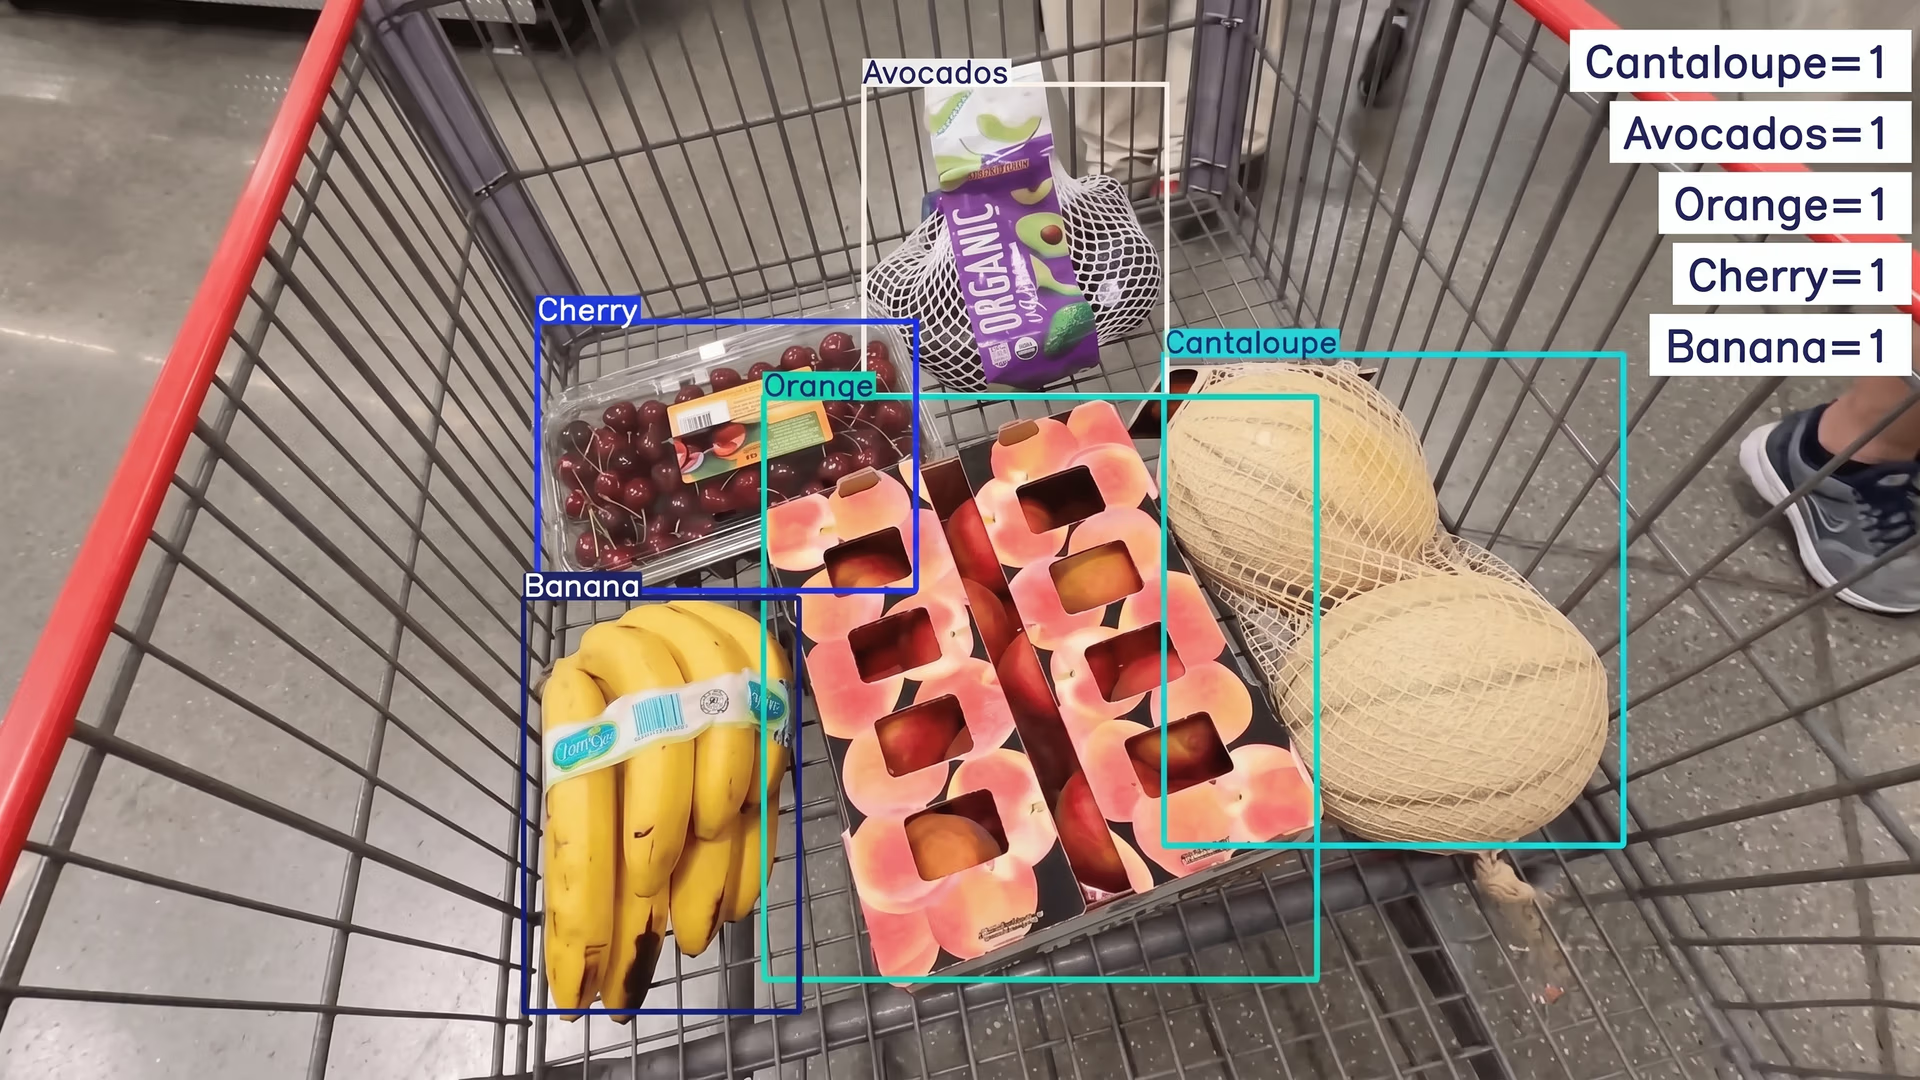
Hình 3. Sử dụng Ultralytics YOLO11 để phát hiện đối tượng (Nguồn)
Ngoài khả năng phát hiện đối tượng cơ bản, các model này còn có tính linh hoạt cao. Chúng cũng hỗ trợ các tác vụ như phân đoạn instance, xác định đường viền đối tượng ở cấp pixel, và ước tính tư thế, xác định các điểm mốc trên người hoặc đối tượng. Tính linh hoạt này khiến các model Ultralytics YOLO trở thành lựa chọn hàng đầu cho nhiều ứng dụng, từ nông nghiệp và logistics đến bán lẻ và sản xuất.
Một lý do quan trọng khác khiến các model Ultralytics YOLO phổ biến là gói Python Ultralytics, cung cấp giao diện đơn giản, thân thiện với người dùng để huấn luyện, fine-tune và triển khai model. Nhà phát triển có thể bắt đầu với trọng số được huấn luyện trước, tùy chỉnh model cho dataset của riêng mình và triển khai chỉ với vài dòng code.
2. RT-DETR và RT-DETRv2#
RT‑DETR (Transformer phát hiện thời gian thực) và RT‑DETRv2 mới hơn là các model phát hiện đối tượng được xây dựng để hoạt động thời gian thực. Không như nhiều model truyền thống, các model này có thể nhận ảnh đầu vào và trực tiếp đưa ra kết quả phát hiện cuối cùng mà không cần dùng triệt tiêu cực đại không cần thiết (NMS).
NMS là bước loại bỏ các bounding box chồng lấn dư thừa khi model dự đoán cùng một đối tượng nhiều lần. Bỏ qua NMS giúp quy trình phát hiện đơn giản và nhanh hơn.
Các model này kết hợp CNN với Transformer. CNN tìm các chi tiết hình ảnh như cạnh và hình dạng, trong khi Transformer là một loại mạng nơ-ron có thể xem toàn bộ ảnh cùng lúc và hiểu mối liên hệ giữa các phần khác nhau. Khả năng nắm bắt toàn diện này giúp model phát hiện các đối tượng ở gần nhau hoặc chồng lấn.
RT‑DETRv2 cải tiến model ban đầu với các tính năng như phát hiện đa tỷ lệ, giúp tìm được cả đối tượng nhỏ lẫn lớn, và khả năng xử lý cảnh phức tạp tốt hơn. Những thay đổi này giúp model duy trì tốc độ đồng thời cải thiện độ chính xác.
3. RF-DETR#
RF‑DETR là model dựa trên Transformer, hoạt động theo thời gian thực và được thiết kế để kết hợp độ chính xác của các kiến trúc Transformer với tốc độ cần thiết cho ứng dụng thực tế. Tương tự RT‑DETR và RT‑DETRv2, model sử dụng Transformer để phân tích toàn bộ ảnh và CNN để trích xuất các đặc trưng hình ảnh chi tiết như cạnh, hình dạng và kết cấu.
Model dự đoán trực tiếp các đối tượng từ ảnh đầu vào, bỏ qua anchor box và bước loại bỏ cực đại không triệt tiêu, giúp đơn giản hóa quy trình phát hiện và duy trì tốc độ suy luận cao. RF‑DETR cũng hỗ trợ phân đoạn instance, cho phép xác định đường viền đối tượng ở cấp pixel bên cạnh việc dự đoán bounding box.
4. EfficientDet#
Được phát hành vào cuối năm 2019, EfficientDet là model phát hiện đối tượng được thiết kế để mở rộng quy mô hiệu quả và đạt hiệu năng cao. Điểm khác biệt của EfficientDet là phương pháp mở rộng đồng bộ, điều chỉnh đồng thời độ phân giải đầu vào, độ sâu và độ rộng của mạng thay vì chỉ điều chỉnh một yếu tố. Cách tiếp cận này giúp model duy trì độ chính xác ổn định dù được mở rộng cho các tác vụ hiệu năng cao hay thu nhỏ để triển khai nhẹ.
Một thành phần quan trọng khác của EfficientDet là mạng kim tự tháp đặc trưng hiệu quả (FPN), cho phép model phân tích ảnh ở nhiều tỷ lệ. Phân tích đa tỷ lệ này rất quan trọng để phát hiện các đối tượng có kích thước khác nhau, giúp EfficientDet nhận diện đáng tin cậy cả đối tượng nhỏ lẫn lớn trong cùng một ảnh.
5. PP-YOLOE+#
Được phát hành năm 2022, PP-YOLOE+ là model phát hiện đối tượng theo phong cách YOLO, nghĩa là model phát hiện và phân loại đối tượng chỉ trong một lượt xử lý ảnh. Cách tiếp cận này giúp model nhanh và phù hợp với các ứng dụng thời gian thực mà vẫn duy trì độ chính xác cao.
Một trong những cải tiến quan trọng của PP-YOLOE+ là học căn chỉnh theo tác vụ, giúp điểm tin cậy của model phản ánh mức độ chính xác khi xác định vị trí đối tượng. Điều này đặc biệt hữu ích khi phát hiện các đối tượng nhỏ hoặc chồng lấn.
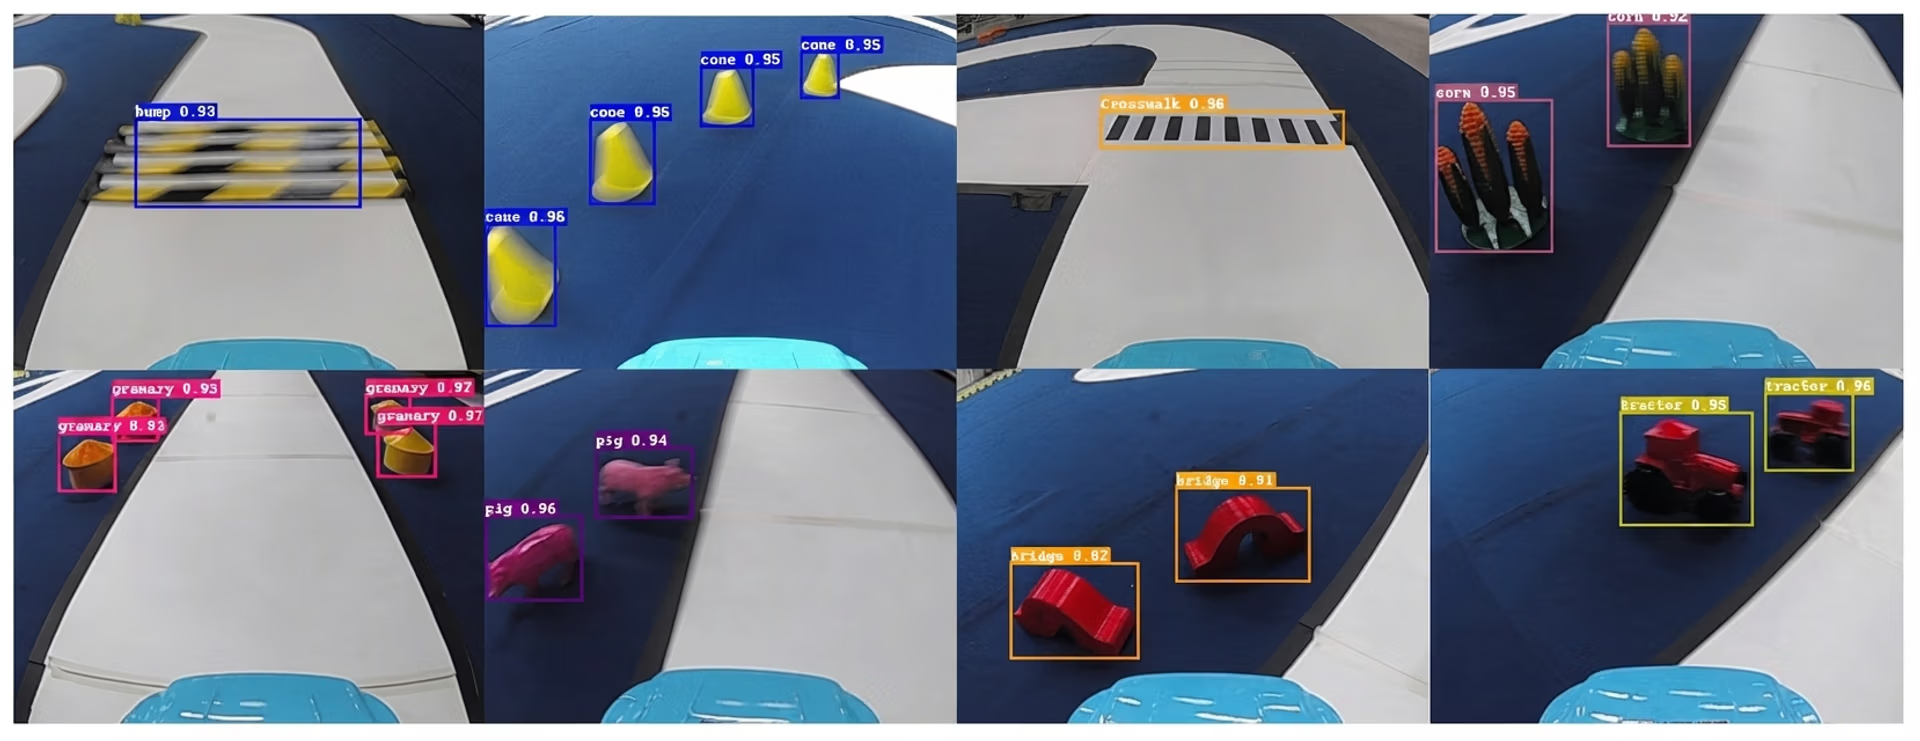
Hình 4. Phát hiện đối tượng bằng PP-YOLOE+ (Nguồn)
Model cũng sử dụng kiến trúc head tách biệt, phân chia nhiệm vụ dự đoán vị trí đối tượng và nhãn lớp. Nhờ đó, model có thể vẽ bounding box chính xác hơn đồng thời phân loại đối tượng đúng.
6. GroundingDINO#
GroundingDINO là model phát hiện đối tượng dựa trên Transformer, kết hợp thị giác và ngôn ngữ. Thay vì dựa vào một tập danh mục cố định, model cho phép người dùng phát hiện đối tượng bằng prompt văn bản ngôn ngữ tự nhiên.
Bằng cách căn chỉnh đặc trưng thị giác trong ảnh với mô tả văn bản, model có thể định vị đối tượng ngay cả khi các nhãn cụ thể đó không có trong dữ liệu huấn luyện. Điều này có nghĩa là bạn có thể nhập prompt mô tả như “một người đội mũ bảo hiểm” hoặc “một chiếc ô tô màu đỏ gần tòa nhà”, và model sẽ vẽ hộp giới hạn quanh các đối tượng khớp với mô tả.
Ngoài ra, nhờ hỗ trợ phát hiện zero-shot, GroundingDINO giảm nhu cầu huấn luyện lại hoặc fine-tune model cho từng trường hợp sử dụng mới, giúp model linh hoạt trong nhiều ứng dụng. Để xem model này so sánh với các bộ phát hiện có từ vựng mở và model ngôn ngữ-thị giác khác trên dataset thực tế như thế nào, hãy xem bảng xếp hạng VLM.
Các metric phổ biến dùng để đánh giá model phát hiện đối tượng#
Khi so sánh các model phát hiện đối tượng khác nhau, có thể bạn sẽ tự hỏi làm thế nào để xác định model nào thực sự hoạt động tốt nhất. Đây là một câu hỏi hợp lý, vì ngoài kiến trúc model và chất lượng dữ liệu, nhiều yếu tố có thể ảnh hưởng đến hiệu năng.
Các nhà nghiên cứu thường dựa vào benchmark dùng chung và metric hiệu năng tiêu chuẩn để đánh giá model nhất quán, so sánh kết quả và hiểu sự đánh đổi giữa tốc độ và độ chính xác. Benchmark tiêu chuẩn đặc biệt quan trọng vì nhiều model phát hiện đối tượng được đánh giá trên cùng bộ dữ liệu, chẳng hạn như bộ dữ liệu COCO.
Đo lường độ chính xác và tốc độ phát hiện#
Dưới đây là một số metric phổ biến dùng để đánh giá model phát hiện đối tượng:
- Độ giao nhau trên hợp (IoU): Chỉ số này đo mức độ chồng lấn giữa hộp giới hạn được dự đoán và đối tượng thực tế trong ảnh. IoU so sánh hộp do model vẽ với hộp ground truth, tức vị trí đối tượng được gán nhãn trong dataset. IoU được tính bằng diện tích phần giao nhau chia cho diện tích hợp của hai hộp. IoU cao hơn cho thấy model đặt hộp chính xác hơn, còn IoU thấp hơn nghĩa là dự đoán kém chính xác hơn. Nói đơn giản, IoU cho biết mức độ khớp giữa dự đoán của model và vị trí thực tế của đối tượng.
- Độ chính xác trung bình trung bình (mAP): Đây là metric chính dùng để đánh giá hiệu năng tổng thể của tác vụ phát hiện đối tượng. Metric này xét cả số lượng đối tượng mà model phát hiện chính xác lẫn độ chính xác của các kết quả phát hiện đó ở nhiều ngưỡng tin cậy và danh mục đối tượng khác nhau.
- Số khung hình mỗi giây (FPS) và độ trễ: FPS cho biết model có thể xử lý bao nhiêu ảnh hoặc khung hình video trong một giây. Ví dụ, model chạy ở 30 FPS có thể xử lý 30 khung hình mỗi giây. FPS cao hơn đồng nghĩa với khả năng phản hồi nhanh hơn, điều này rất quan trọng trong các trường hợp sử dụng như video trực tiếp, giám sát giao thông hoặc robot. Ngược lại, độ trễ đo thời gian model xử lý một ảnh hoặc khung hình, từ lúc nhận được cho đến khi có kết quả.
Ưu và nhược điểm của việc sử dụng thuật toán phát hiện đối tượng#
Dưới đây là một số ưu điểm chính của việc sử dụng model phát hiện đối tượng trong các ứng dụng thực tế:
- Mở rộng được trên nhiều ngành: Phát hiện đối tượng có thể áp dụng cho nhiều trường hợp sử dụng, từ giám sát giao thông và phân tích bán lẻ đến chăm sóc sức khỏe, nông nghiệp và sản xuất.
- Giảm khối lượng công việc thủ công: Tự động hóa các tác vụ kiểm tra và giám sát hình ảnh giúp giảm nhu cầu giám sát liên tục của con người, đồng thời giúp các nhóm tập trung vào công việc có giá trị cao hơn.
- Tận dụng hệ sinh thái mã nguồn mở: Các cộng đồng mã nguồn mở năng động và tài nguyên trên GitHub giúp việc truy cập model đã huấn luyện trước, thử nghiệm và tùy chỉnh giải pháp trở nên dễ dàng hơn.
Dù có những ưu điểm này, vẫn tồn tại các hạn chế thực tế có thể ảnh hưởng đến hiệu năng của model phát hiện đối tượng. Dưới đây là một số yếu tố quan trọng cần cân nhắc:
- Yêu cầu dữ liệu chất lượng cao: Model phát hiện đối tượng cần các bộ dữ liệu lớn, được gán nhãn kỹ lưỡng để huấn luyện. Việc tạo và duy trì dữ liệu này có thể tốn thời gian, chi phí cao và khó mở rộng quy mô.
- Nhu cầu tính toán: Các model đạt độ chính xác phát hiện cao hơn thường cần năng lực xử lý đáng kể, cả trong quá trình huấn luyện lẫn triển khai theo thời gian thực. Điều này thường đồng nghĩa với việc sử dụng GPU hiệu năng cao, làm tăng chi phí hạ tầng.
- Độ nhạy với điều kiện thực tế: Sự thay đổi về ánh sáng, góc camera, thời tiết và cảnh đông đúc có thể ảnh hưởng đến hiệu năng phát hiện, khiến việc kiểm thử và tinh chỉnh liên tục trở nên cần thiết.
Điểm chính cần ghi nhớ#
Model phát hiện đối tượng phù hợp nhất cho dự án thị giác máy tính của bạn phụ thuộc vào trường hợp sử dụng, thiết lập dữ liệu, yêu cầu hiệu năng và giới hạn phần cứng. Một số model được tối ưu về tốc độ, trong khi những model khác tập trung vào độ chính xác; phần lớn ứng dụng thực tế cần cân bằng cả hai. Nhờ các framework mã nguồn mở và cộng đồng năng động trên GitHub, việc đánh giá, điều chỉnh và triển khai các model này cho ứng dụng thực tế ngày càng dễ dàng hơn.
Để tìm hiểu thêm, hãy khám phá repository GitHub của chúng tôi. Tham gia cộng đồng và xem các trang giải pháp để đọc về những ứng dụng như AI trong chăm sóc sức khỏe và thị giác máy tính trong ngành ô tô. Khám phá các tùy chọn cấp phép để bắt đầu với AI thị giác ngay hôm nay.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









