Tìm hiểu về học có giám sát và học không giám sát trong thị giác máy tính
Tìm hiểu sự khác biệt giữa học có giám sát và học không giám sát trong thị giác máy tính, cũng như cách chọn phương pháp phù hợp với dữ liệu và mục tiêu dự án.
Trí tuệ nhân tạo (AI) dựa trên ý tưởng cốt lõi là dạy máy móc học hỏi và suy luận theo những cách mô phỏng trí thông minh của con người. Tương tự như cách con người học bằng nhiều phương thức khác nhau, chẳng hạn như được hướng dẫn trực tiếp hoặc quan sát các quy luật và trải nghiệm, các hệ thống AI và machine learning được thiết kế để áp dụng những phương thức tương tự.
Cụ thể, trong các thuật toán machine learning, hệ thống được huấn luyện để học từ dữ liệu thay vì được lập trình tường minh cho từng tác vụ. Thay vì dựa vào các quy tắc cố định, model machine learning nhận diện quy luật trong dữ liệu và sử dụng các quy luật đó để đưa ra dự đoán hoặc quyết định.
Ví dụ, thị giác máy tính là một nhánh của AI và machine learning, tập trung giúp hệ thống diễn giải và hiểu thông tin hình ảnh như ảnh và video. Từ nhận diện đối tượng đến phát hiện các quy luật ẩn trong tập dữ liệu lớn, những hệ thống này phụ thuộc nhiều vào cách chúng được huấn luyện để học.
Nhiều kỹ thuật học AI được sử dụng để huấn luyện các hệ thống này, tùy thuộc vào loại dữ liệu hiện có và vấn đề cần giải quyết.
Một số model thị giác máy tính học từ dữ liệu có nhãn, trong đó mỗi đầu vào được ghép với một đáp án chính xác; nghĩa là mỗi ảnh hoặc điểm dữ liệu đều có nhãn được xác định trước cho biết nội dung đại diện cho điều gì. Nhờ đó, model học được mối quan hệ giữa đầu vào và đầu ra mong đợi, cải thiện khả năng đưa ra dự đoán chính xác trên dữ liệu mới chưa từng thấy.
Các model thị giác khác học từ dữ liệu không nhãn, không có đáp án được xác định trước mà thay vào đó tập trung nhận diện các quy luật và mối quan hệ ngay trong dữ liệu. Những phương pháp này lần lượt được gọi là học có giám sát và học không giám sát, đồng thời là nền tảng của nhiều hệ thống thị giác máy tính tiên tiến.
Trong bài viết này, chúng ta sẽ tìm hiểu về học có giám sát và học không giám sát, cách áp dụng các phương pháp này trong thị giác máy tính, cũng như cách chọn phương pháp phù hợp nhất với dự án AI thị giác của bạn. Bắt đầu nào!
Các phương pháp học AI thúc đẩy thị giác máy tính như thế nào#
Bạn có thể hình dung trí tuệ nhân tạo như một chiếc ô bao trùm nhiều công nghệ, cho phép máy móc thực hiện những tác vụ thường đòi hỏi trí thông minh của con người. Trong phạm vi đó, machine learning là một lĩnh vực then chốt giúp hệ thống học từ dữ liệu thay vì chỉ dựa vào các quy tắc cố định.
Trong machine learning, các kỹ thuật học khác nhau quyết định cách model học và cải thiện theo thời gian. Các phương pháp như học có giám sát (học từ dữ liệu có nhãn với đáp án chính xác), học không giám sát (nhận diện quy luật trong dữ liệu không nhãn), học tăng cường (học qua thử và sai dựa trên phản hồi hoặc phần thưởng) và học bán giám sát (kết hợp một lượng nhỏ dữ liệu có nhãn với lượng lớn dữ liệu không nhãn) xác định cách hệ thống xử lý dữ liệu đầu vào và tạo ra dữ liệu đầu ra.
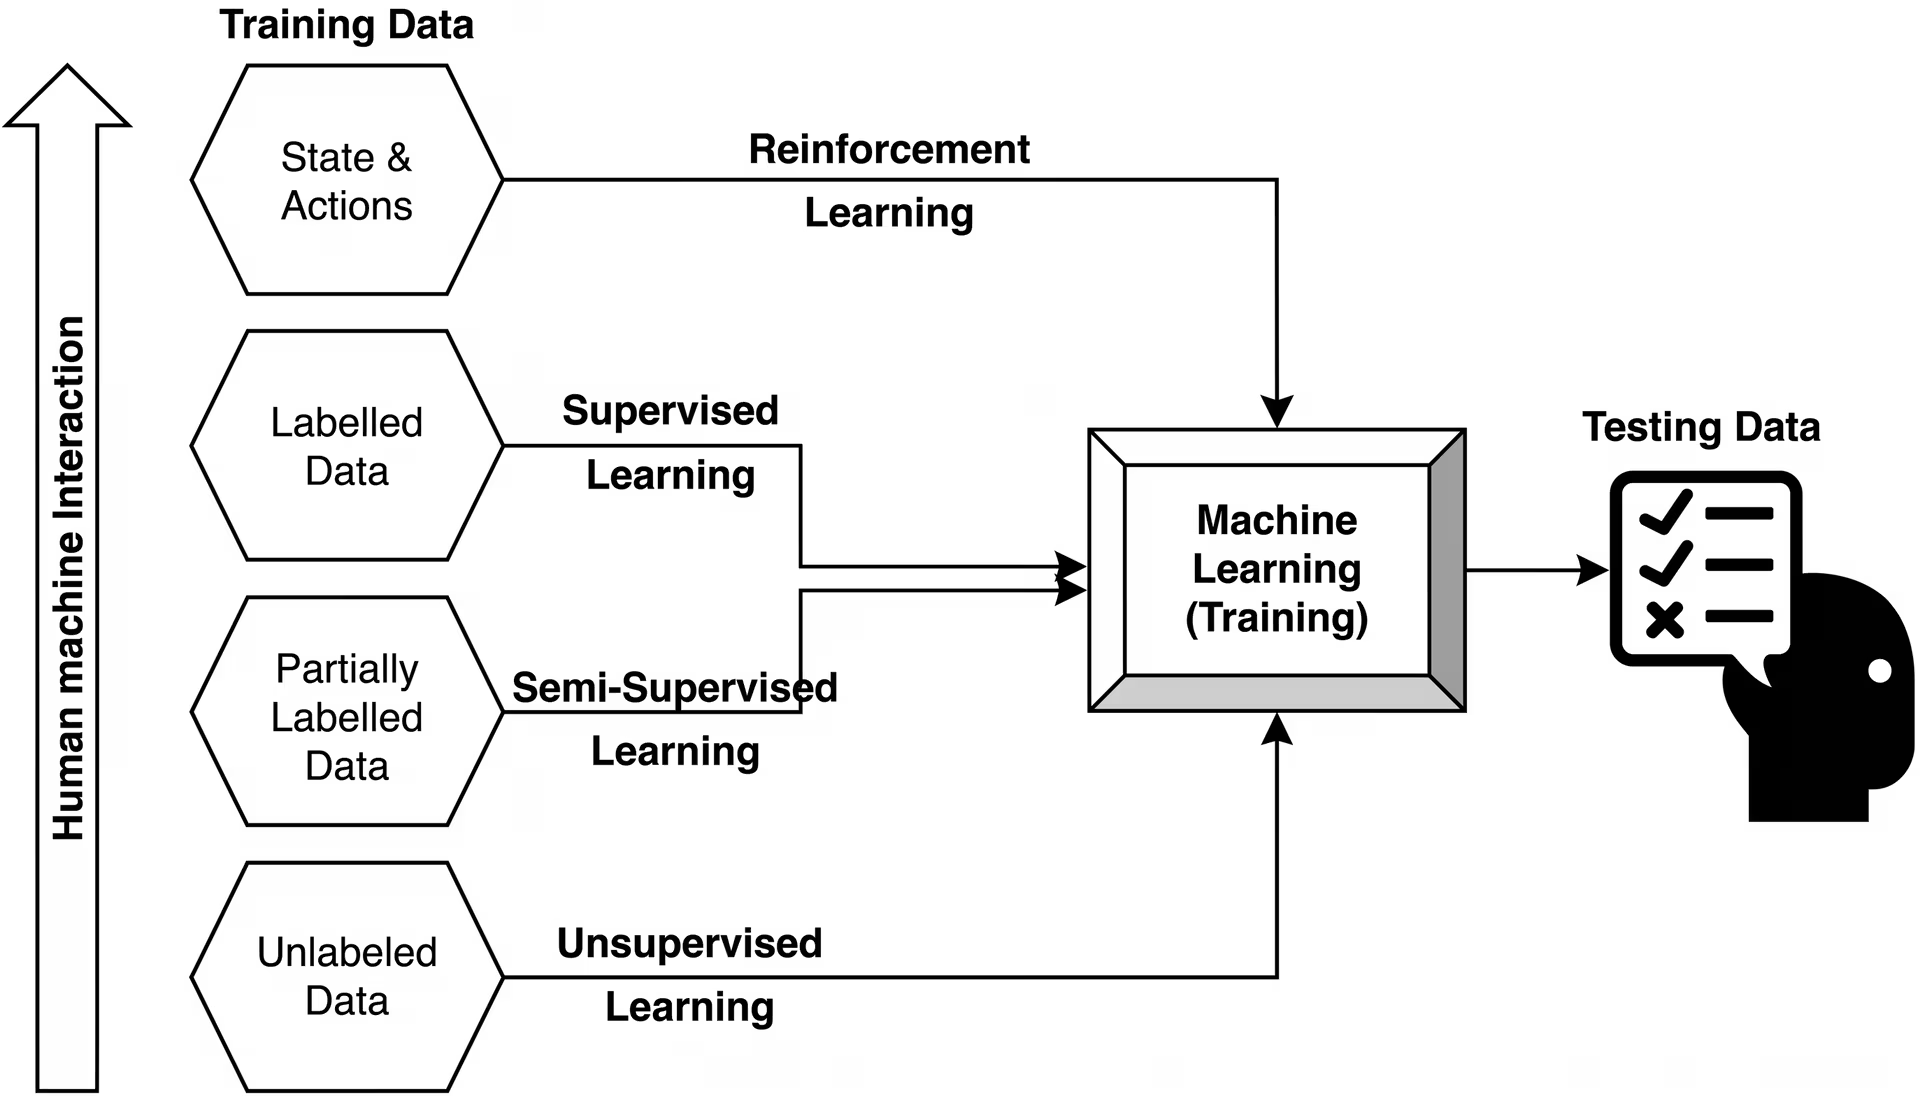
Hình 1. Tổng quan về các phương pháp học AI (Nguồn)
Cụ thể, các hệ thống thị giác máy tính được xây dựng bằng những phương pháp học này để diễn giải và hiểu dữ liệu hình ảnh. Học có giám sát là phương pháp được sử dụng phổ biến nhất vì cho phép model học từ các ví dụ có nhãn rõ ràng và tạo ra kết quả chính xác, đáng tin cậy.
Chẳng hạn, model có thể được huấn luyện trên các ảnh được gắn nhãn “mèo” và “chó”, từ đó học các đặc trưng như hình dáng, tai và cấu trúc khuôn mặt để phân loại chính xác ảnh mới bằng các thuật toán phân loại. Trong khi đó, học không giám sát và học bán giám sát cũng được sử dụng trong thị giác máy tính, thường để khám phá quy luật trong dữ liệu hoặc cải thiện hiệu suất khi dữ liệu có nhãn còn hạn chế.
Tìm hiểu cách sử dụng model học có giám sát trong thị giác máy tính#
Bạn có thể so sánh thuật toán học có giám sát với môi trường lớp học, nơi giáo viên đưa ra ví dụ kèm đáp án chính xác để học sinh biết điều gì đúng và điều gì sai. Trong machine learning, model học theo cách tương tự bằng dữ liệu có nhãn, trong đó mỗi đầu vào được ghép với một đầu ra đã biết.
Giả sử bạn đang xây dựng một hệ thống thị giác máy tính để tự động phân tích các trận bóng chày. Bạn có thể huấn luyện một model như Ultralytics YOLO26 trên ảnh hoặc khung hình video có gắn nhãn cho các đối tượng như bóng, gậy và cầu thủ.
Mỗi đối tượng sẽ được đánh dấu vị trí và danh mục, giúp model học được những gì cần tìm. Theo thời gian, model có thể phát hiện và xác định vị trí các đối tượng này trong cảnh quay mới, hỗ trợ những trường hợp sử dụng như theo dõi bóng và phát hiện cầu thủ qua các khung hình.
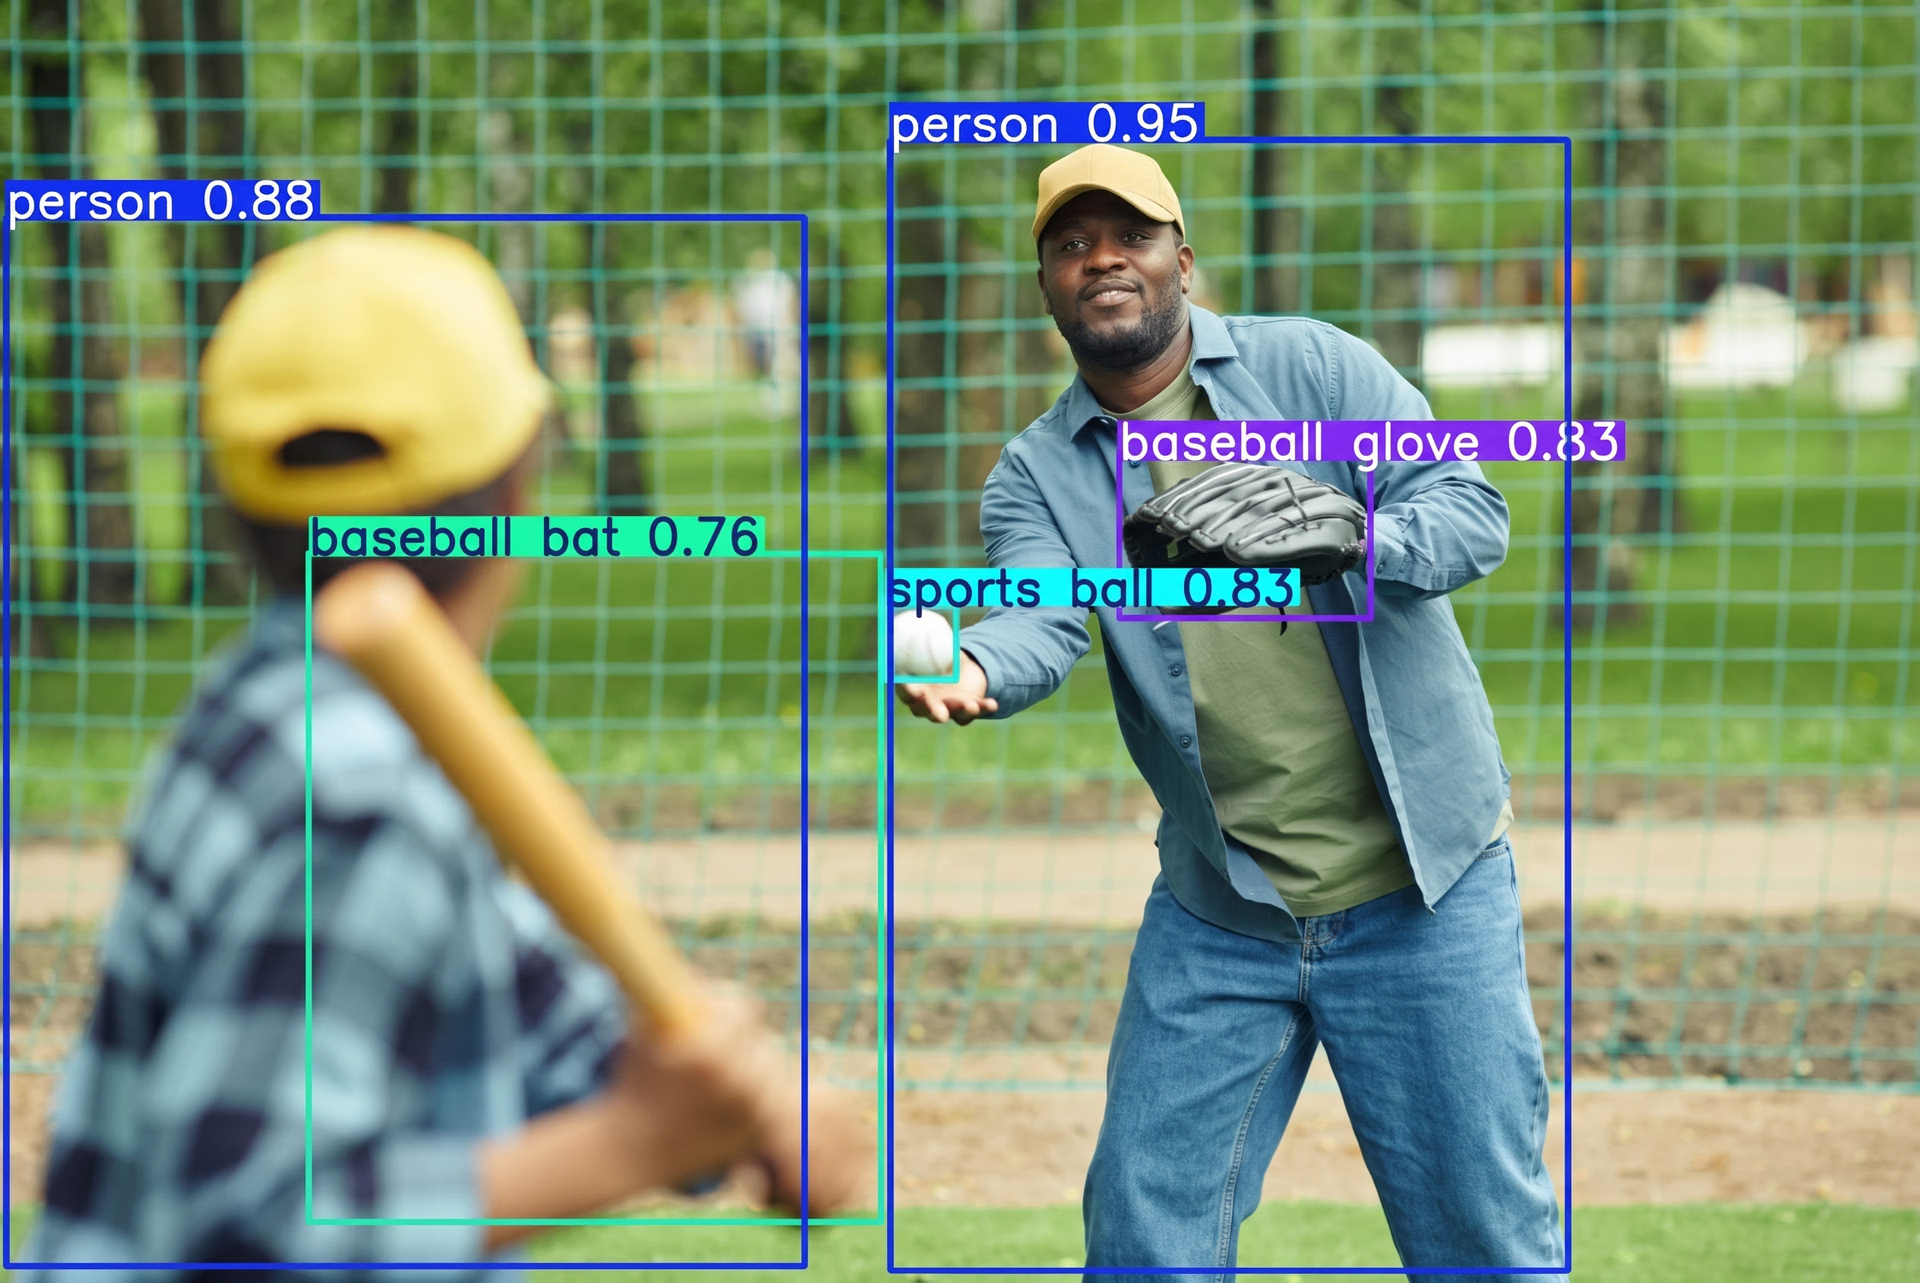
Hình 2. Ví dụ về phát hiện đối tượng bằng học có giám sát (Nguồn)
Ngoài phát hiện đối tượng, học có giám sát còn được sử dụng rộng rãi trong nhiều tác vụ thị giác máy tính như phân loại ảnh, phân đoạn instance và ước lượng tư thế, nơi độ chính xác và tính nhất quán rất quan trọng. Trong mỗi tác vụ này, model học từ dữ liệu có nhãn để nhận diện các quy luật cụ thể và đưa ra dự đoán đáng tin cậy trên đầu vào mới.
Các model này thường được xây dựng bằng deep learning, một dạng machine learning sử dụng mạng nơ-ron để học trực tiếp các quy luật từ dữ liệu. Mạng nơ-ron được thiết kế để xử lý thông tin theo cách lấy cảm hứng khái quát từ hoạt động của não người, cho phép model học các đặc trưng hình ảnh phức tạp từ tập dữ liệu lớn.
Các phương pháp thị giác máy tính trước đây thường dựa vào đặc trưng được thiết kế thủ công kết hợp với những thuật toán như máy vector hỗ trợ (SVM là các model phân loại dữ liệu bằng cách tìm ranh giới tốt nhất giữa các nhóm) hoặc cây quyết định (model đưa ra quyết định bằng cách chia dữ liệu thành các nhánh).
Ngược lại, các model thị giác máy tính ngày nay dùng deep learning để tự động học những đặc trưng này từ dữ liệu, nhờ đó xử lý hiệu quả hơn các tác vụ thị giác quy mô lớn và có độ chi tiết cao.
Tìm hiểu nhu cầu về model học không giám sát trong AI thị giác#
Dù học có giám sát là phương pháp phổ biến trong thị giác máy tính, một số ứng dụng thị giác không có dữ liệu gắn nhãn hoặc việc tạo nhãn quá tốn kém và mất thời gian.
Trong những trường hợp này, thuật toán học không giám sát có thể là một lựa chọn thay thế hữu ích. Giả sử bạn có một bộ sưu tập lớn ảnh không nhãn từ camera quan sát động vật hoang dã.
Không có nhãn cho biết từng ảnh chứa gì, nhưng bạn vẫn muốn sắp xếp hoặc tìm hiểu dữ liệu. Model không giám sát có thể phân tích những ảnh này và nhóm các ảnh tương tự lại với nhau, gom các loài vật có ngoại hình giống nhau thành từng cụm, ngay cả khi không biết nhãn chính xác của chúng.
Học không giám sát hoạt động như thế nào trong thị giác máy tính#
Vậy machine learning không giám sát hoạt động như thế nào? Thay vì học từ đáp án chính xác, model tự học bằng cách nhận diện quy luật và cấu trúc trong dữ liệu. Model tìm kiếm điểm tương đồng và khác biệt giữa các dữ liệu mà không dựa vào ví dụ có nhãn.
Một trường hợp sử dụng phổ biến là phát hiện bất thường, trong đó model học hình dạng của dữ liệu bình thường rồi nhận diện mọi thứ sai khác với dữ liệu đó. Phát hiện bất thường và ngoại lệ là một trong những ứng dụng công nghiệp có tác động lớn nhất. Ví dụ gồm phát hiện sản phẩm lỗi trên dây chuyền sản xuất, đánh dấu ảnh chụp y tế bất thường để bác sĩ chẩn đoán hình ảnh xem xét hoặc phát hiện hoạt động đáng ngờ trong video giám sát. Vì lỗi và bất thường thường hiếm gặp và đa dạng, việc gắn nhãn mọi trường hợp có thể xảy ra là không thực tế, khiến các phương pháp không giám sát trở thành lựa chọn phù hợp.
Để hỗ trợ việc này, các kỹ thuật như phân cụm và giảm chiều thường được áp dụng, thường là trên các đặc trưng trích xuất từ ảnh thay vì trên chính ảnh thô. Các phương pháp phân cụm, chẳng hạn như phân cụm k-means, nhóm các ảnh tương tự dựa trên quy luật chung; trong khi đó, các kỹ thuật giảm chiều như phân tích thành phần chính (PCA) đơn giản hóa dữ liệu bằng cách tập trung vào những đặc trưng quan trọng nhất.
Nhờ vậy, model dễ nhận diện các quy luật và cấu trúc có ý nghĩa trong những tập dữ liệu lớn, phức tạp. Ưu điểm chính của học không giám sát là hoạt động hiệu quả với dữ liệu không nhãn và có thể phát hiện những quy luật không dễ nhận thấy ngay. Tuy nhiên, phương pháp này khó đánh giá hơn và ít kiểm soát được đầu ra cuối cùng hơn so với học có giám sát.
Học tự giám sát và học bán giám sát trong thị giác máy tính#
Khi tìm hiểu về học có giám sát và học không giám sát, bạn có thể tự hỏi liệu có phương án trung gian nào giữa hai phương pháp hay không. Thú vị là học tự giám sát và học bán giám sát giúp thu hẹp khoảng cách giữa học có giám sát và học không giám sát.
Các phương pháp này giúp model học từ dữ liệu không nhãn hiệu quả hơn. Thay vì chỉ dựa vào các ví dụ có nhãn, model có thể tự tạo tác vụ học từ dữ liệu hoặc kết hợp một tập dữ liệu nhỏ có nhãn với một tập dữ liệu không nhãn lớn hơn.
Trong học tự giám sát, model học bằng cách giải quyết các tác vụ được tạo từ chính dữ liệu. Ví dụ, model có thể nhận một ảnh bị khuyết một phần và học cách dự đoán nội dung nên điền vào phần đó, hoặc học cách nhận diện các góc nhìn khác nhau của cùng một đối tượng. Cách này giúp model học được các đặc trưng hữu ích mà không cần gắn nhãn thủ công.
Mặt khác, trong học bán giám sát, một lượng nhỏ dữ liệu có nhãn được sử dụng cùng với một tập dữ liệu không nhãn lớn hơn để cải thiện hiệu suất. Trong một số trường hợp, model có thể tạo nhãn cho dữ liệu không nhãn rồi dùng những nhãn đó để tiếp tục học.
Lợi ích chính của các phương pháp này là giảm nhu cầu về tập dữ liệu có nhãn lớn, vốn thường tốn kém và mất thời gian để tạo. Tuy nhiên, so với các phương pháp hoàn toàn có giám sát, chúng có thể phức tạp hơn khi thiết kế và đánh giá.
Những khác biệt chính giữa học có giám sát và học không giám sát#
Khác biệt giữa học có giám sát và học không giám sát nằm ở cách model học và mục tiêu cần đạt. Học có giám sát dựa vào dữ liệu có nhãn và hướng dẫn rõ ràng để học các tác vụ cụ thể; còn học không giám sát hoạt động mà không cần đáp án xác định trước và tập trung khám phá quy luật, cấu trúc trong dữ liệu.
Ví dụ, trong hệ thống giám sát giao thông, model học có giám sát có thể được huấn luyện trên ảnh có nhãn để phát hiện phương tiện, người đi bộ hoặc đèn tín hiệu giao thông. Ngược lại, model không giám sát có thể phân tích lượng lớn video để nhóm các kiểu giao thông tương tự hoặc nhận diện sự kiện bất thường, chẳng hạn như ùn tắc đột ngột hoặc chuyển động khác thường, mà không cần được chỉ rõ phải tìm gì.
Khi nào nên dùng học có giám sát trong thị giác máy tính#
Học có giám sát là lựa chọn phù hợp cho các tác vụ thị giác máy tính có mục tiêu được xác định rõ ràng và cần model ánh xạ dữ liệu đầu vào thành đầu ra chính xác. Phương pháp này đặc biệt hiệu quả khi bạn có tập dữ liệu gắn nhãn đáng tin cậy và cần kết quả nhất quán, có thể dự đoán.
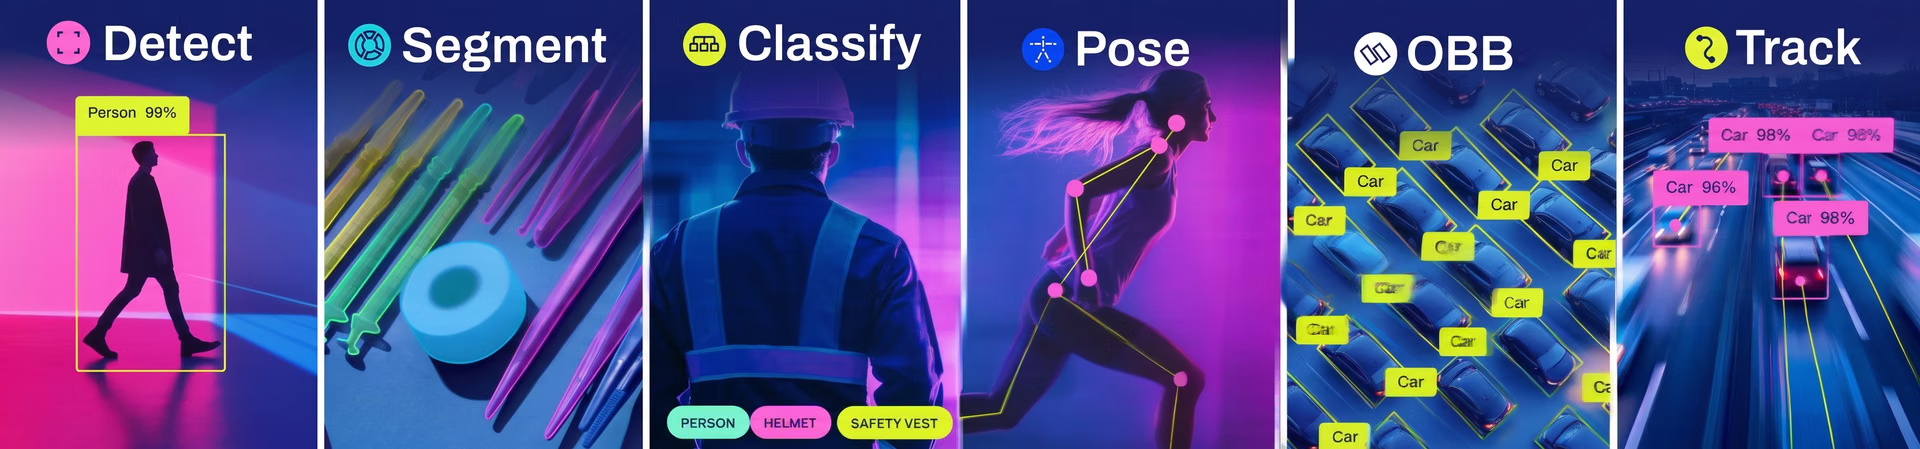
Hình 3. Các tác vụ thị giác máy tính sử dụng học có giám sát (Nguồn)
Phương pháp này thường được dùng cho các vấn đề đòi hỏi model phân biệt giữa những danh mục đã biết hoặc dự đoán kết quả cụ thể. Thay vì khám phá quy luật, trọng tâm là học các mối quan hệ chính xác từ dữ liệu có nhãn, giúp định hướng model tạo ra kết quả mong muốn dễ dàng hơn.
Một ưu điểm quan trọng khác là khả năng kiểm soát. Với học có giám sát, việc đo lường hiệu suất bằng các metric rõ ràng, tinh chỉnh model và đảm bảo hành vi ổn định khi triển khai sẽ dễ dàng hơn. Điều này khiến phương pháp phù hợp với các hệ thống cần tính nhất quán và độ tin cậy theo thời gian.
Tuy nhiên, phương pháp này cũng có sự đánh đổi. Model phụ thuộc nhiều vào chất lượng và quy mô của dữ liệu có nhãn, trong khi việc thu thập và gắn nhãn dữ liệu như vậy có thể tốn nhiều thời gian.
Ví dụ thực tế về thị giác máy tính có giám sát#
Các model AI thị giác như model Ultralytics YOLO sử dụng học có giám sát để thực hiện các tác vụ như phát hiện đối tượng với độ chính xác cao, đặc biệt trong ứng dụng thời gian thực. Dưới đây là một số trường hợp sử dụng thị giác thực tế phổ biến mà học có giám sát tạo nên khác biệt:
- Y tế và chẩn đoán hình ảnh: Bác sĩ có thể sử dụng hệ thống thị giác máy tính được huấn luyện trên ảnh chụp có nhãn như X-quang hoặc MRI, trong đó bộ phân loại được dùng để nhận diện các tình trạng như khối u hoặc gãy xương, hỗ trợ chẩn đoán nhanh và chính xác hơn.
- Kiểm tra chất lượng công nghiệp: Trong môi trường sản xuất, hệ thống thị giác được huấn luyện trên dữ liệu có nhãn có thể kiểm tra sản phẩm bằng cách phân tích nhiều đặc trưng liên quan đến chất lượng, như hình dáng, lỗi bề mặt, kết cấu và kích thước. Bằng cách học từ ví dụ về cả sản phẩm đạt chuẩn lẫn sản phẩm lỗi, các hệ thống này có thể nhận diện lỗi nhất quán và duy trì tiêu chuẩn sản xuất.
- Lái xe tự hành: Hệ thống tự lái dựa vào model được huấn luyện trên dữ liệu lái xe có nhãn để nhận diện làn đường, phương tiện, người đi bộ và biển báo giao thông, giúp xe di chuyển an toàn theo thời gian thực.
- Bán lẻ và hệ thống thanh toán: Cửa hàng sử dụng model được huấn luyện trên ảnh sản phẩm có nhãn để nhận diện mặt hàng trên kệ hoặc tại quầy thanh toán, cho phép tính tiền tự động và quản lý hàng tồn kho hiệu quả hơn. Khi kết hợp với dữ liệu bổ sung, các hệ thống này cũng có thể hỗ trợ những tác vụ như phân khúc khách hàng, giúp doanh nghiệp hiểu rõ hơn về hành vi mua sắm.
- Nông nghiệp và giám sát cây trồng: Nông dân có thể sử dụng model được huấn luyện trên ảnh có nhãn để phát hiện và phân loại cây trồng, chẳng hạn như nhận diện và đếm khoai tây khỏe mạnh và bị hư hỏng, qua đó cải thiện kiểm soát chất lượng và giảm tổn thất.
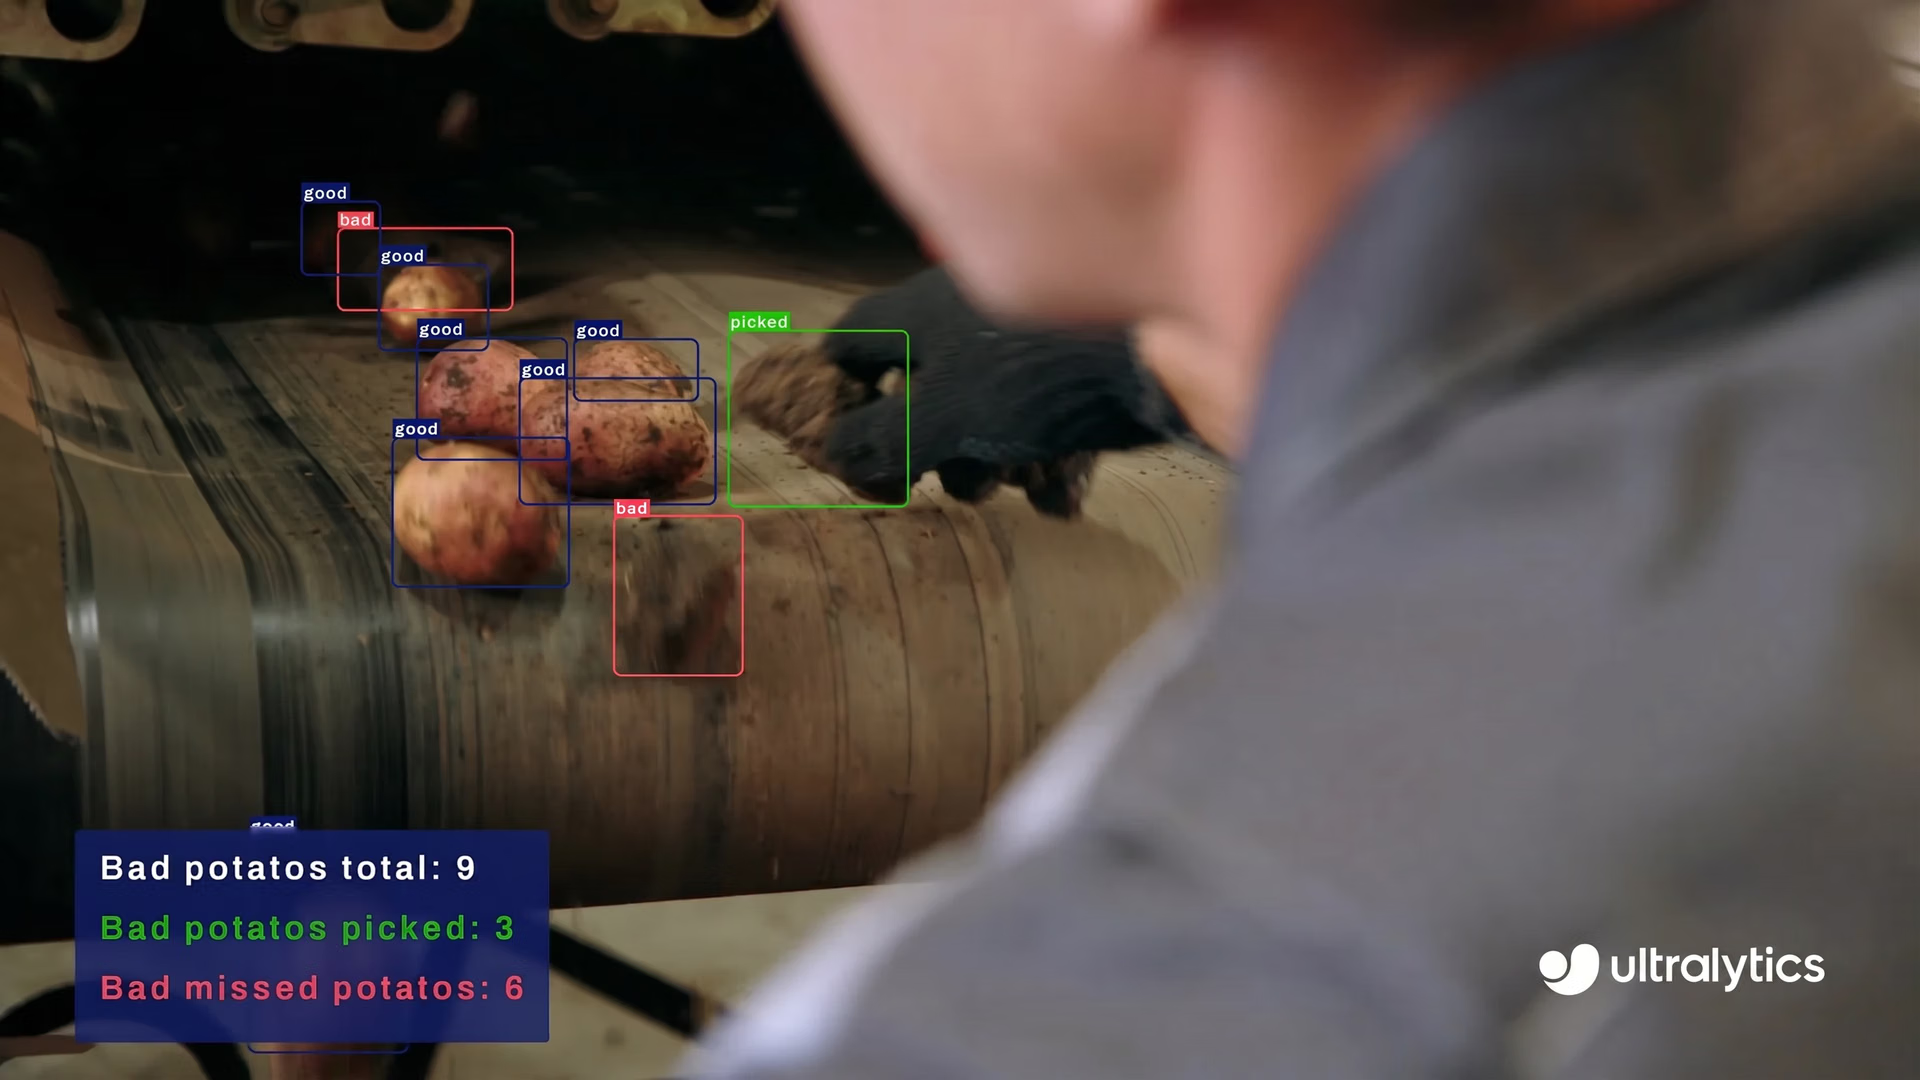
Hình 4. Dùng YOLO để phát hiện và đếm khoai tây khỏe mạnh và bị lỗi
Học không giám sát giải quyết được những loại vấn đề nào trong thị giác máy tính#
Học không giám sát hữu ích khi bạn không có đủ dữ liệu có nhãn hoặc dữ liệu không đi kèm đáp án rõ ràng. Trong những trường hợp này, mục tiêu không phải là đưa ra dự đoán chính xác mà là hiểu các quy luật và cấu trúc trong dữ liệu.
Phương pháp này thường được dùng khi lần đầu khám phá một tập dữ liệu không nhãn. Thay vì chỉ cho model biết cần tìm gì, bạn để model tự nhận diện điểm tương đồng, nhóm các ảnh có liên quan hoặc làm nổi bật những quy luật bất thường.
Với một bộ sưu tập ảnh lớn, phương pháp không giám sát có thể giúp nhóm các ảnh tương tự lại với nhau hoặc đánh dấu các ngoại lệ cần được xem xét thêm. Vì vậy, đây là điểm khởi đầu hữu ích cho các dự án khoa học dữ liệu.
Các model tạo sinh, bao gồm GAN, autoencoder biến phân và model khuếch tán, học phân phối cơ bản của ảnh để tạo ra những ảnh hoàn toàn mới. Các model này hỗ trợ những ứng dụng như tổng hợp ảnh, inpainting, siêu phân giải và chuyển đổi phong cách, đồng thời là nền tảng của các hệ thống AI tạo sinh ngày nay.
Trong phân đoạn không giám sát, một số phương pháp nhóm pixel hoặc vùng thành các phân đoạn nhất quán mà không dựa vào mask có nhãn; điều này hữu ích khi việc gắn nhãn quá tốn kém hoặc mục tiêu là khám phá cấu trúc thay vì khớp với các danh mục đã xác định trước.
Học không giám sát cũng rất hữu ích khi làm việc với các tập dữ liệu lớn mà việc gắn nhãn tốn nhiều thời gian hoặc không khả thi. Trong những trường hợp đó, phương pháp này cho phép bạn thu được thông tin hữu ích từ dữ liệu mà không cần dựa vào dữ liệu huấn luyện có nhãn.
Phương pháp này cũng thường được sử dụng trong các lĩnh vực như AI tạo sinh (model tạo dữ liệu mới như ảnh, văn bản hoặc âm thanh) và học biểu diễn (model học các đặc trưng hoặc quy luật hữu ích từ dữ liệu thô), nơi model học các đặc trưng tổng quát từ lượng dữ liệu lớn. Nhìn chung, nếu vấn đề của bạn liên quan đến khám phá, tìm quy luật hoặc làm việc với dữ liệu không nhãn, học không giám sát là một phương pháp linh hoạt và thiết thực đáng cân nhắc.
Ví dụ thực tế về học không giám sát trong thị giác máy tính#
Dưới đây là một số ví dụ về trường hợp sử dụng học không giám sát trong thị giác máy tính:
- Phát hiện bất thường trong sản xuất: Model có thể học hình dạng của sản phẩm bình thường và đánh dấu lỗi hoặc điểm bất thường mà không cần ví dụ có nhãn cho mọi lỗi có thể xảy ra.
- Sắp xếp và tìm kiếm ảnh: Các bộ sưu tập ảnh lớn, chẳng hạn như thư viện ảnh hoặc danh mục thương mại điện tử, có thể được tự động nhóm theo độ tương đồng hình ảnh, giúp nhà khoa học dữ liệu dễ dàng sắp xếp, khám phá và tìm kiếm trong các tập dữ liệu lớn.
- Giám sát và an ninh: Hệ thống có thể phân tích video để nhận diện quy luật hoặc hành vi bất thường như chuyển động đột ngột hoặc thay đổi đám đông mà không cần được huấn luyện tường minh trên các sự kiện có nhãn.
- Tiền xử lý và khám phá dữ liệu: Các phương pháp không giám sát thường được dùng để khám phá và cấu trúc dữ liệu ảnh thô trước khi huấn luyện model có giám sát, giúp cải thiện chất lượng dữ liệu và giảm công sức thủ công.
Những hạn chế thực tế của học có giám sát và học không giám sát#
Dù cả hai phương pháp học đều có ưu điểm, vẫn có một số hạn chế cần cân nhắc. Dưới đây là những yếu tố thực tế cần lưu ý khi xây dựng model thị giác máy tính:
- Overfitting trong model có giám sát: Trong học có giám sát, model có thể học quá sát dữ liệu huấn luyện thay vì học các quy luật tổng quát. Điều này thường xảy ra khi tập dữ liệu nhỏ hoặc chưa đủ đa dạng. Ví dụ, model được huấn luyện để phát hiện lỗi trên một loại sản phẩm có thể thất bại khi kiểm thử trên dữ liệu mới gồm các sản phẩm hơi khác biệt hoặc điều kiện chiếu sáng khác.
- Thách thức với thuật toán phân cụm: Trong học không giám sát, model có thể nhóm các điểm dữ liệu tương tự lại với nhau. Tuy nhiên, cách này có thể không hiệu quả khi dữ liệu nhiễu, không nhất quán hoặc thiếu cấu trúc rõ ràng. Chẳng hạn, trong tác vụ nhóm ảnh, những ảnh có màu sắc tương tự nhưng chứa các đối tượng khác nhau có thể bị nhóm nhầm.
- Tầm quan trọng của tiền xử lý phù hợp: Trước khi huấn luyện, dữ liệu cần được làm sạch và chuẩn bị. Việc này thường được thực hiện bằng các thư viện Python xử lý ảnh và chuyển đổi dữ liệu. Điều này đặc biệt quan trọng trong thị giác máy tính, nơi ảnh có thể khác nhau về kích thước, chất lượng hoặc điều kiện chiếu sáng. Nếu không tiền xử lý phù hợp, model có thể học từ nhiễu thay vì các quy luật có ý nghĩa, dẫn đến hiệu suất kém.
Điểm chính cần ghi nhớ#
Trong thị giác máy tính, cả học có giám sát và học không giám sát đều đóng vai trò quan trọng. Phương pháp phù hợp phụ thuộc vào loại dữ liệu bạn có, dữ liệu có nhãn hay không, vấn đề cần giải quyết và yêu cầu triển khai.
Nếu mục tiêu của bạn là độ chính xác cao và đầu ra được xác định rõ ràng, machine learning có giám sát thường là lựa chọn tốt hơn. Nếu bạn đang khám phá dữ liệu hoặc làm việc mà không có nhãn, học không giám sát có thể phù hợp hơn.
Bạn muốn tìm hiểu thêm về AI? Hãy xem cộng đồng và kho lưu trữ GitHub của chúng tôi. Khám phá các trang giải pháp để tìm hiểu về AI trong robot học và thị giác máy tính trong nông nghiệp. Tìm hiểu các lựa chọn cấp phép của chúng tôi và bắt đầu xây dựng với thị giác máy tính ngay hôm nay!









